


聊《LangChain并不难,难的是知道什么时候不该用》之前,先说一句实在的:别急着背概念,先看它在真实项目里到底解决什么问题。
摘要
前阵子帮一个朋友看他的项目,LangChain Agent跑得好好的,聊天机器人能回答问题、能查数据、能调工具,效果挺惊艳。结果让他往生产环境一部署,第一天就崩了。
问题不在模型,不在代码逻辑,而在三件事:权限没控、日志没记、异常没兜。
很多人学LangChain都是从官方教程开始,langchain.chat_models、langchain.prompts、langchain.chains,几行代码就能跑起来一个Demo。但Demo和上线之间,隔着一道很多人没意识到的墙。
我今天就把这个坑拆清楚,顺便用一个真实项目带你走一遍从Demo到上线的完整路径。
---
目录
- LangChain能解决什么问题
- 核心组件:别只背概念,先搞清楚它们的边界
- Prompt与Chain:从能跑到能稳定
- 工具调用:权限是上线的第一道门槛
- 项目实战:从Demo到上线的完整路径
- 适用边界:什么时候不该用LangChain
- 总结
LangChain能解决什么问题
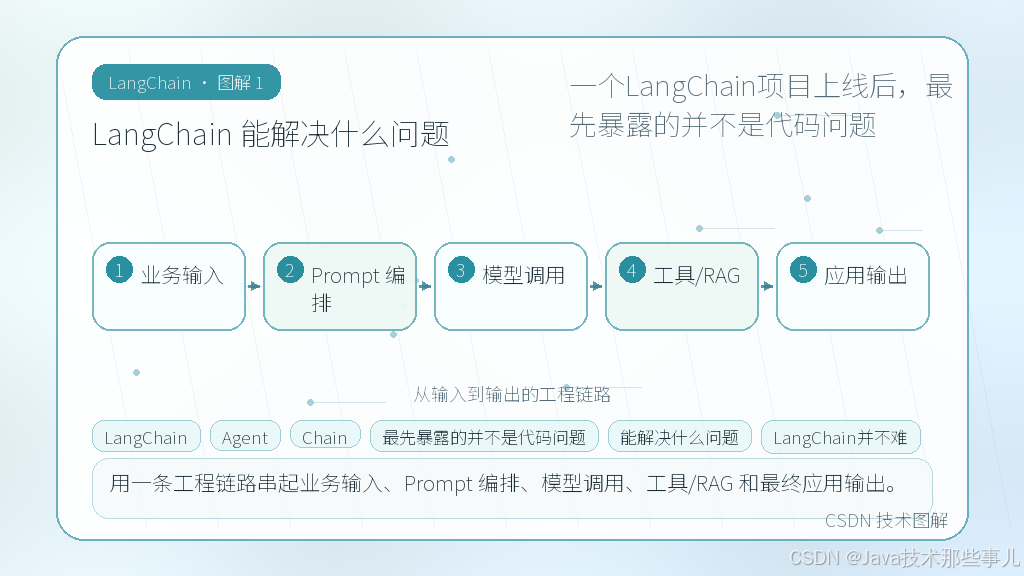
LangChain本质上是一个胶水层,帮你把大模型、工具、记忆、Prompt组合成一个可运行的Agent。它的价值在于降低了"把LLM接入业务"的门槛。
但门槛低不等于能直接上线。
我见过太多项目,Demo阶段用GPT-4跑得很顺,切到国产模型就翻车;或者本地测试没问题,一上服务器就超时、就报错、就失控。这些问题背后,往往是三个维度的缺失:
1. 可控性:Agent在做什么、为什么这么做,你能看到吗?
2. 可观测性:调用链、延迟、错误率,你有监控吗?
3. 兜底能力:模型挂了、工具超时、权限越界,你能回滚吗?
这三件事,LangChain官方文档里几乎不写,但生产环境里一件都不能少。
---
核心组件:别只背概念,先搞清楚它们的边界
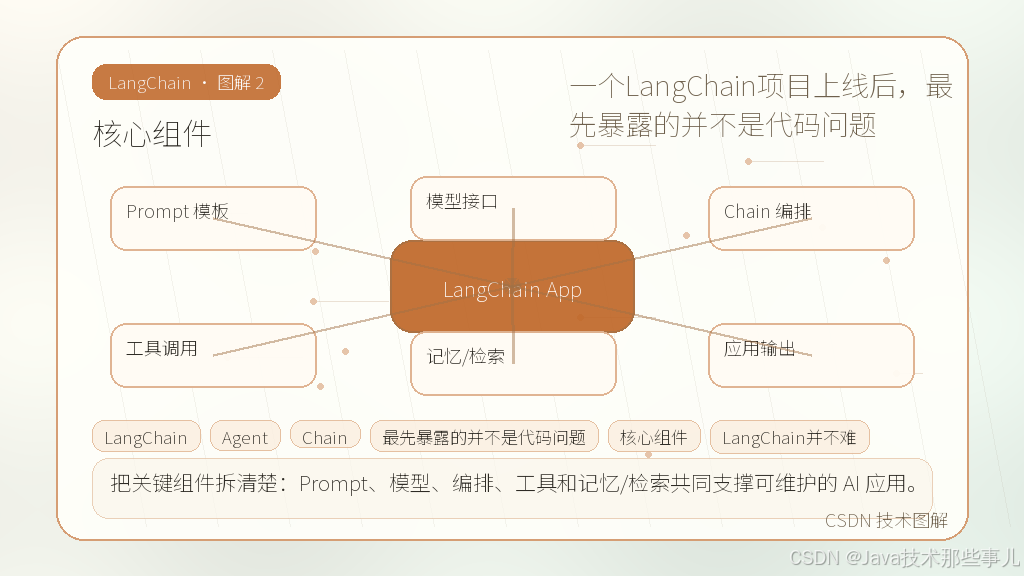
LangChain的核心组件就那几个:Model、Prompt、Chain、Tool、Memory。但每个组件都有它的适用边界和坑。
Model层:不同模型的输出格式不一致。GPT-4返回的JSON结构,换到Qwen或者DeepSeek上可能直接裂开。所以不要在Model层做硬编码假设。
Prompt层:Prompt工程是LangChain最容易被高估的部分。好的Prompt确实能提升效果,但Prompt的稳定性比创意更重要。一个在本地测试完美的Prompt,可能因为一个换行符、一个空格就失效。
Chain层:Chain是串联多个步骤的管道。但Chain一旦出错,整个链路就断了。所以Chain里必须有异常隔离,某个环节失败不能导致整个Agent崩溃。
Tool层:工具是Agent的"手"。但工具的权限必须严格管控。我见过一个项目,Agent调用了subprocess.run去执行命令,结果因为Prompt注入,直接删了生产数据库。这不是危言耸听,是真实发生过的。
Memory层:记忆是Agent的"脑"。但记忆有成本,有隐私风险,有上下文窗口限制。不要为了"有记忆"而加记忆,要问自己:这个场景真的需要记忆吗?
---
Prompt与Chain:从能跑到能稳定
Prompt和Chain是LangChain最基础也最容易踩坑的部分。
真实案例:客服工单系统
我做过的一个项目,是用LangChain构建一个客服工单分类Agent。用户输入问题,Agent判断属于哪个业务线,然后生成工单。
输入:用户自然语言描述的问题
步骤:
1. 解析用户输入
2. 调用分类模型
3. 匹配业务线
4. 生成工单
可观察结果:本地测试准确率92%,上线后掉到67%。
问题出在哪?出在Prompt的稳定性。
本地测试时,我用的是GPT-4,Prompt写得比较宽松,模型能"猜"对很多边界情况。上线后切到国产模型,模型的输出格式变了,导致解析失败。
更致命的是,没有异常兜底。当分类模型返回非预期格式时,整个Agent直接抛出异常,用户看到的是一个报错页面,而不是一个友好的提示。
排查过程
现象:上线后分类准确率大幅下降,部分请求直接报错。
验证动作:
1. 对比本地和生产环境的Prompt,发现生产环境的Prompt被自动截断,因为上下文窗口限制。
2. 检查模型输出,发现国产模型的JSON格式和GPT-4不一致,缺少某些字段。
3. 查看日志,发现异常没有被捕获,直接抛到上层。
排除结果:
- 不是模型能力问题,是Prompt适配问题。
- 不是代码逻辑问题,是异常处理缺失。
- 不是权限问题,是日志缺失导致无法定位。
代码解释
下面是我后来重构的Prompt处理代码,关键点是异常隔离和格式兜底:
from langchain.prompts import ChatPromptTemplate
from langchain.chat_models import ChatOpenAI
from langchain.chains import LLMChain
import json
import logging

logger = logging.getLogger(__name__)

# 定义分类Prompt模板
classify_prompt = ChatPromptTemplate.from_messages([
    ("system", "你是一个客服工单分类助手。请根据用户输入,判断工单所属的业务线。"),
    ("user", "{input}")
])

# 初始化模型,注意设置temperature和max_tokens
llm = ChatOpenAI(
    model="qwen-max",
    temperature=0.1,
    max_tokens=500,
    base_url="https://your-api-endpoint/v1"
)

# 构建Chain
chain = LLMChain(prompt=classify_prompt, llm=llm)

def classify_ticket(user_input: str) -> dict:
    """
    分类工单,包含异常兜底逻辑
    """
    try:
        # 调用Chain获取结果
        result = chain.run(input=user_input)

        # 解析JSON输出
        parsed = json.loads(result)

        # 验证关键字段
        if "category" not in parsed or "confidence" not in parsed:
            raise ValueError("Missing required fields in response")

        return {
            "status": "success",
            "category": parsed["category"],
            "confidence": parsed["confidence"]
        }

    except json.JSONDecodeError as e:
        # JSON解析失败,返回默认分类
        logger.error(f"JSON parse error: {e}, raw output: {result}")
        return {
            "status": "fallback",
            "category": "general",
            "confidence": 0.5
        }
    except Exception as e:
        # 其他异常,记录日志并返回错误
        logger.exception(f"Classification failed: {e}")
        return {
            "status": "error",
            "message": str(e)
        }
逐段解释:
1. Prompt模板定义:使用ChatPromptTemplate定义系统Prompt和用户Prompt。注意这里没有把格式要求写在Prompt里,而是放在代码层验证,这样更稳定。
2. 模型初始化:指定模型名称、temperature、maxtokens和baseurl。temperature设低是为了减少随机性,max_tokens要留足空间。
3. Chain构建:把Prompt和Model组合成Chain。
4. 异常兜底:classify_ticket函数包含三层异常处理:
- JSONDecodeError:模型输出格式不对,返回默认分类。
- ValueError:关键字段缺失,同样返回默认分类。
- 其他异常:记录完整日志,返回错误信息。
关键点:异常不能往上抛,必须兜底。用户不应该看到报错,应该看到一个合理的默认结果或者友好的提示。
---
工具调用:权限是上线的第一道门槛
工具调用是Agent最强大的能力,也是最危险的能力。
失败原因分析
我见过三类典型的工具调用失败:
1. 业务错误:工具逻辑本身有问题。比如查询数据库的工具,没有处理空结果的情况,导致返回None,下游代码直接崩了。
2. 配置错误:工具的参数配置不对。比如API的超时时间设得太短,网络波动就超时;或者API Key配置错误,直接返回401。
3. 环境错误:生产环境和测试环境不一致。比如测试环境能用内网访问数据库,生产环境需要走代理,结果工具调用直接失败。
如何区分这三类错误
- 业务错误:看工具的实现逻辑,是否有边界情况处理。
- 配置错误:对比测试和生产环境的配置,检查超时、密钥、地址等。
- 环境错误:检查网络连通性、权限配置、环境变量等。
工具调用的最佳实践
1. 权限最小化:工具能访问的资源,必须是最小必要集合。不要用高权限账号跑Agent。
2. 超时控制:每个工具调用都要设超时,防止卡死整个Agent。
3. 重试机制:网络波动是常态,工具调用要有重试,但要设最大重试次数。
4. 调用日志:每次工具调用都要记录输入、输出、耗时,方便排查问题。
---
项目实战:从Demo到上线的完整路径
下面用一个完整的客服工单系统项目,展示从Demo到上线的完整路径。
项目架构
customer-service-agent/
├── agents/
│   ├── classifier.py      # 分类Agent
│   ├── responder.py       # 回复Agent
│   └── tool_executor.py   # 工具执行Agent
├── tools/
│   ├── ticket_query.py    # 工单查询工具
│   ├── user_query.py      # 用户查询工具
│   └── api_call.py        # 通用API调用工具
├── config/
│   ├── settings.py        # 配置管理
│   └── prompts.py         # Prompt模板
├── monitoring/
│   ├── logger.py          # 日志配置
│   └── metrics.py         # 监控指标
├── tests/
│   ├── test_classifier.py
│   └── test_tools.py
└── main.py                # 入口
配置管理:别把密钥写死在代码里
# config/settings.py
import os
from dotenv import load_dotenv

load_dotenv()

class Settings:
    # 模型配置
    MODEL_NAME = os.getenv("MODEL_NAME", "qwen-max")
    MODEL_API_KEY = os.getenv("MODEL_API_KEY")
    MODEL_BASE_URL = os.getenv("MODEL_BASE_URL")

    # 超时配置
    TOOL_TIMEOUT = int(os.getenv("TOOL_TIMEOUT", "30"))
    LLM_TIMEOUT = int(os.getenv("LLM_TIMEOUT", "60"))

    # 日志配置
    LOG_LEVEL = os.getenv("LOG_LEVEL", "INFO")
    LOG_FILE = os.getenv("LOG_FILE", "agent.log")

    # 监控配置
    METRICS_ENABLED = os.getenv("METRICS_ENABLED", "true").lower() == "true"

settings = Settings()
关键点:
- 所有配置从环境变量读取,不要写死。
- 提供默认值,方便本地开发。
- 密钥类配置必须有校验,缺失时明确报错。
日志配置:可观测性的基础
# monitoring/logger.py
import logging
import os
from datetime import datetime

def setup_logger(name: str, log_file: str = None, level: str = "INFO") -> logging.Logger:
    """
    配置logger,支持文件和控制台输出
    """
    logger = logging.getLogger(name)
    logger.setLevel(getattr(logging, level.upper()))

    # 避免重复添加handler
    if logger.handlers:
        return logger

    formatter = logging.Formatter(
        "%(asctime)s - %(name)s - %(levelname)s - %(message)s",
        datefmt="%Y-%m-%d %H:%M:%S"
    )

    # 控制台输出
    console_handler = logging.StreamHandler()
    console_handler.setFormatter(formatter)
    logger.addHandler(console_handler)

    # 文件输出
    if log_file:
        log_dir = os.path.dirname(log_file)
        if log_dir and not os.path.exists(log_dir):
            os.makedirs(log_dir)
        file_handler = logging.FileHandler(log_file)
        file_handler.setFormatter(formatter)
        logger.addHandler(file_handler)

    return logger
关键点:
- 日志要同时输出到控制台和文件,方便本地调试和生产排查。
- 日志格式包含时间、模块名、级别、消息,方便过滤和搜索。
- 避免重复添加handler,这是常见的坑。
工具执行:带监控和兜底
# agents/tool_executor.py
import asyncio
import time
import logging
from typing import Any, Dict, Optional
from tools.ticket_query import query_ticket
from tools.user_query import query_user
from config.settings import settings

logger = logging.getLogger(__name__)

# 工具注册表
TOOL_REGISTRY = {
    "query_ticket": query_ticket,
    "query_user": query_user,
}

async def execute_tool(tool_name: str, arguments: Dict[str, Any]) -> Dict[str, Any]:
    """
    执行工具,包含超时控制、异常处理和监控
    """
    start_time = time.time()

    # 参数校验
    if tool_name not in TOOL_REGISTRY:
        return {
            "status": "error",
            "message": f"Unknown tool: {tool_name}"
        }

    tool_fn = TOOL_REGISTRY[tool_name]

    try:
        # 异步执行工具,带超时
        result = await asyncio.wait_for(
            asyncio.to_thread(tool_fn, **arguments),
            timeout=settings.TOOL_TIMEOUT
        )

        elapsed = time.time() - start_time

        # 记录调用日志
        logger.info(
            f"Tool executed: {tool_name}, "
            f"args: {arguments}, "
            f"elapsed: {elapsed:.2f}s"
        )

        return {
            "status": "success",
            "result": result,
            "elapsed": elapsed
        }

    except asyncio.TimeoutError:
        elapsed = time.time() - start_time
        logger.error(f"Tool timeout: {tool_name}, elapsed: {elapsed:.2f}s")
        return {
            "status": "timeout",
            "message": f"Tool {tool_name} timed out after {settings.TOOL_TIMEOUT}s"
        }
    except Exception as e:
        elapsed = time.time() - start_time
        logger.exception(f"Tool execution failed: {tool_name}, elapsed: {elapsed:.2f}s")
        return {
            "status": "error",
            "message": str(e)
        }
逐段解释:
1. 工具注册表:把所有工具集中管理,方便扩展和校验。新工具只需要在注册表里加一行。
2. 参数校验:工具名不存在时,直接返回错误,不执行。这是第一道防线。
3. 超时控制:用asyncio.wait_for包裹工具调用,防止工具卡死整个Agent。超时时间从配置读取。
4. 异常处理:分三类处理:
- TimeoutError:记录超时日志,返回timeout状态。
- 其他异常:记录完整异常栈,返回error状态。
- 成功:记录调用日志,返回结果。
5. 监控指标:记录每次工具调用的耗时,方便后续分析性能瓶颈。
---
适用边界:什么时候不该用LangChain
LangChain不是万能的。下面这些场景,不建议用LangChain:
1. 简单规则就能解决的问题:如果业务逻辑可以用if-else清晰表达,不要上Agent。Agent的复杂度和维护成本远高于规则系统。
2. 对延迟敏感的场景:Agent的调用链长,延迟高。如果用户期望毫秒级响应,Agent不是好选择。
3. 高可靠性要求的场景:Agent的输出有随机性,难以100%保证正确性。金融、医疗等场景需要谨慎。
4. 小团队、短周期项目:LangChain的学习曲线不短,如果项目周期短、团队小,直接调API可能更高效。
5. 模型调用量大的场景:Agent的调用链长,token消耗大。如果成本敏感,需要仔细评估。
---
总结
LangChain让Agent开发变得简单,但简单不等于容易。Demo和上线之间,隔着权限、日志、监控、兜底这四道坎。
我从这个项目里学到的最重要的一点是:不要急于上线,先在本地把异常路径跑通。
具体来说:
1. 权限管控:工具的最小权限原则,不要给Agent超越必要的权限。
2. 日志规范:每次模型调用、工具调用都要有日志,格式统一,方便排查。
3. 异常兜底:每个环节都要有兜底逻辑,不能让用户看到报错。
4. 监控指标:记录延迟、错误率、token消耗,方便后续优化。
LangChain是一个强大的工具,但它不是银弹。真正考验工程师能力的,不是能不能跑通Demo,而是能不能让Agent在生产环境里稳定运行。
如果你正在做LangChain项目,建议先问自己三个问题:
1. 我的Agent在什么情况下会失败?
2. 失败时,用户看到的是什么?
3. 失败时,我能多快定位问题?
如果这三个问题的答案你不清楚,那你的项目还离上线很远。
资料展示
下面是我整理的AI大模型学习资料和工具包预览,适合收藏后按主题逐步学习。
如果你想看完整资料目录,可以在评论区留言「资料」;也欢迎告诉我你更关注AI大模型里的哪类内容。
 2万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


