做过前端的人学大模型,哪些经验可以直接迁移?

振动能量采集技术:从原理到实战,破解物联网供电难题 能量采集技术旨在捕获环境中的废弃能量(如机械振动、热能、光能)并将其转化为电能,其核心原理在于通过压电、电磁、静电或摩擦电等物理效应实现能量形式的转换。这项技术的核心价值在于为物联网(IoT)中难以布线或更换电池的分布式传感器节点、植入式医疗设备等提供近乎永续的电力解决方案,从而解决物联网部署的“最后一米供电”瓶颈。其应用场景广泛覆盖工业预测性维护、结构健康监测、可穿戴设备及消费电子等领域。本文聚焦于振动能量采集这一细分方向,深入剖析了压电式、电磁式、电容式及摩擦纳米发电机(TENG)等主流技术路线的实战考 阅读详情

聊《做过前端的人学大模型,哪些经验可以直接迁移?》之前,先说一句实在的:别急着背概念,先看它在真实项目里到底解决什么问题。

摘要

去年这个时候,我还沉浸在 Vue 3 + TypeScript 的响应式世界里,觉得 DOM 操作和状态管理是程序员的“诗与远方”。今年,当我真正着手把几个 Agent Demo 推上生产环境时,才发现前端工程师的大模型转型,真正的坑不在模型调用,而在那些曾经被我们忽略的“后台脏活”。

很多人问我:前端转大模型有没有优势?我说有,但优势不在写 Prompt,而在对“用户体验”和“交互状态”的本能敏感。然而,这种优势在工程化面前会迅速贬值。最近一次联调失败,让我彻底清醒:在 Demo 阶段,界面丝滑就是好产品;在生产阶段,权限不清、日志缺失、链路不可观测,就是待爆的雷。

目录

  • 一、前端经验的“迁移”与“误导”
  • 二、一次联调失败:权限与日志的“血泪史”
  • 三、流式输出:不只是“打字机效果”
  • 四、多模态体验:从“看”到“懂”
  • 五、作品集方向:展示“工程化”能力
  • 六、总结:从“页面开发”到“产品工程”

一、前端经验的“迁移”与“误导”

文章插图 1

前端转 AI 应用开发,最容易犯的错误是过度关注“展示层”。

我们习惯了 v-if 控制显示,习惯了 loading 状态切换,习惯了用 CSS 动画掩盖异步等待的尴尬。但大模型应用的核心复杂度,远在 UI 之下。

可迁移的优势:
1. 流式体验设计:前端对 SSE(Server-Sent Events)和 WebSocket 的接受度最高。我们知道如何让打字机效果不卡顿,如何让 UI 在 Token 流式到达时保持响应。这是后端工程师普遍缺乏的“实时感”。
2. 错误边界的兜底思维:好的前端会预判网络超时、接口报错,并给出友好提示。这种“失败美学”在大模型应用中至关重要——模型可能幻觉、工具可能调用失败、超时可能随时发生。
3. 多模态交互直觉:大模型正在从纯文本走向多模态。前端工程师对图片、音频、视频的处理经验,能更快适应 RAG 中的文档解析、语音合成(TTS)等模块。

需要戒除的误区:

  • 以为调通 API 就完了:axios.post 成功返回 200,不代表业务成功。模型可能返回了空结果,或者触发了安全拦截。
  • 忽视上下文长度管理:前端常把整个对话历史发给后端,却不考虑 Token 消耗和上下文窗口溢出。
  • 把“可观测性”当运维的事:这是最致命的。在前端,埋点是基础;在大模型应用里,Trace 追踪、日志记录、权限审计是上线的门槛。

二、一次联调失败:权限与日志的“血泪史”
文章插图 2

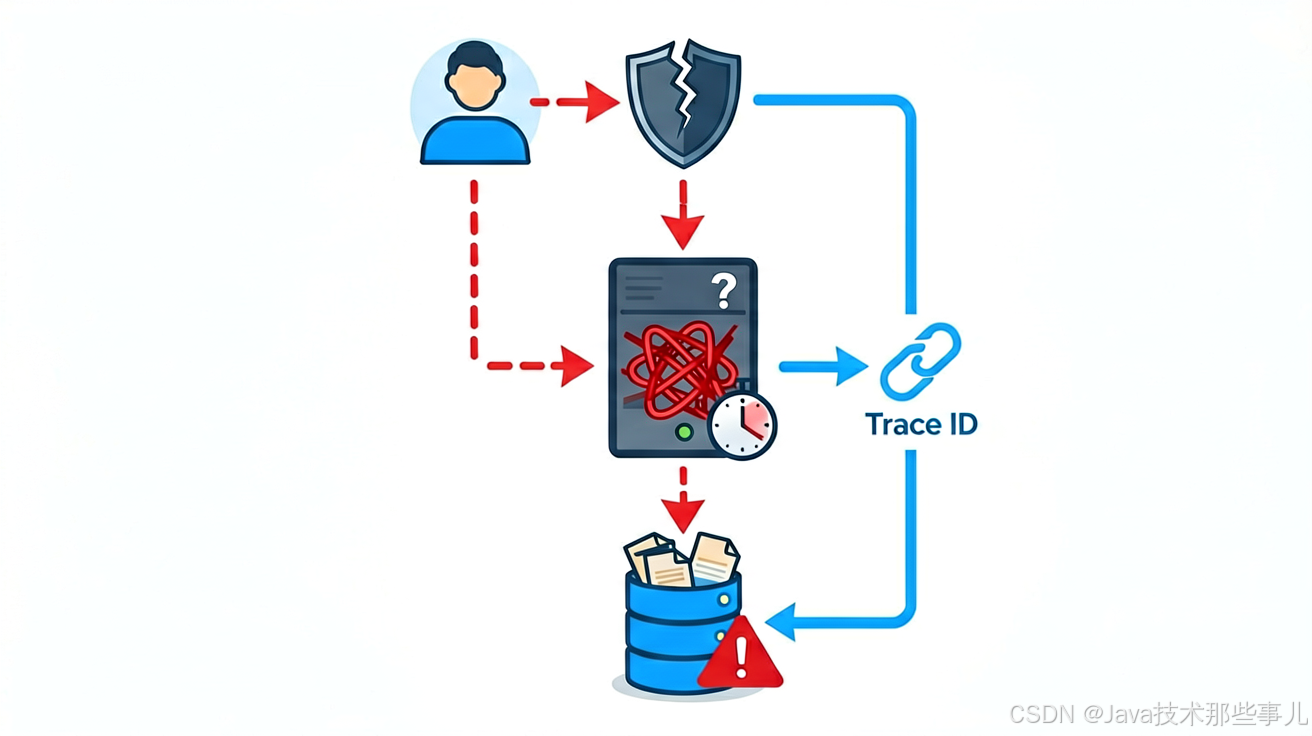
上周,我主导的一个内部知识库问答 Agent 联调。Demo 阶段跑得很顺,RAG 检索准确,回答流畅。但一上生产环境,立刻翻车。

现象:部分用户提问后,页面卡死,后端无响应,数据库里却多了大量未清理的临时文件。

排查路径:
1. 看日志:后端日志只打了 Error: timeout,没有堆栈,没有用户 ID,没有请求参数。
2. 查权限:发现某个子服务被调用时,鉴权中间件失效,导致非法请求穿透到了底层文件系统。
3. 追链路:由于缺少 Trace ID 贯穿前后端,无法定位是哪个环节超时。

责任边界:

  • 前端:负责发送请求、处理流式响应、展示错误状态。
  • 后端:负责鉴权、限流、日志记录、异常捕获。
  • 大模型层:负责 Prompt 执行、工具调用、结果返回。

这次事故的根本原因,是后端没有记录关键上下文,而前端没有对超时和异常做分级处理。我们互相甩锅,直到我把前端的请求日志(包括时间戳、Payload、Response Header)和后端的 Trace ID 对齐,才找到那个被漏掉的权限校验点。

教训:在大模型应用中,可观测性不是加分项,是必选项。没有日志,等于盲人摸象;没有权限控制,等于大门敞开。
优快云资料领取方式

三、流式输出:不只是“打字机效果”

前端转大模型,最直观的输出是流式渲染。但流式不等于简单。

常见坑:

  • Token 切割错误:直接按字符流式拼接,可能导致中文乱码或 HTML 标签断裂。
  • 状态不同步:流式响应中途失败,前端状态未及时重置,导致用户看到半截回答无法重发。
  • 内存泄漏:长时间对话中,未正确清理旧的 Stream 连接。

实战建议:
使用 ReadableStream 配合 TextDecoder 处理中文。封装一个统一的 useChat Hook,管理 messages、loading、error 状态,并确保在组件卸载时正确 abort 请求。

// 简化的流式处理示例
async function fetchStream(url: string, data: any) {
  const response = await fetch(url, {
    method: 'POST',
    headers: { 'Content-Type': 'application/json' },
    body: JSON.stringify(data),
  });

  if (!response.ok) throw new Error('Network error');

  const reader = response.body?.getReader();
  const decoder = new TextDecoder('utf-8');
  let result = '';

  while (true) {
    const { done, value } = await reader!.read();
    if (done) break;

    const chunk = decoder.decode(value, { stream: true });
    // 解析 SSE 格式或 JSON 流
    result += parseChunk(chunk);
    yield result; // 流式返回给 UI
  }
}

四、多模态体验:从“看”到“懂”

大模型正在进入视觉时代。前端工程师在处理图片上传、预览、压缩、OCR 预处理等方面有天然优势。

建议方向:

  • 图片预处理:在发送前对图片进行压缩、裁剪、格式转换,减少 Token 消耗。
  • 本地推理辅助:利用 WebAssembly 或浏览器 API,在客户端做简单的图像识别或文本清洗,减轻后端压力。
  • 多模态 UI 设计:设计支持图片、语音、文本混合输入的交互界面,提供直观的媒体预览和操作反馈。

五、作品集方向:展示“工程化”能力

现在面试大模型岗位,只会调 API 已经不够了。面试官更看重工程化思维和问题排查能力。

建议的项目方向:
1. 带完整日志的 RAG 应用:展示如何记录检索过程、Token 消耗、响应时间,并提供简单的可观测性面板。
2. 带权限控制的 Agent 工作流:模拟多角色场景,展示如何基于 RBAC 或 ABAC 控制不同用户对工具的使用权限。
3. 流式交互优化案例:展示如何解决流式输出中的卡顿、乱码、状态同步问题,提供性能对比数据。

简历亮点写法:

  • ❌ “使用 LangChain 构建了知识问答系统”
  • ✅ “设计并实现了基于 SSE 的流式问答接口,通过 Trace ID 串联前后端日志,将问题排查时间从小时级降至分钟级”

六、总结:从“页面开发”到“产品工程”

前端转大模型,不是换个框架那么简单。它要求我们跳出“UI 实现者”的角色,成为AI 产品的工程化负责人。

  • 优势:对交互体验、实时反馈、多模态处理的敏感度。
  • 挑战:权限控制、日志可观测性、链路追踪、异常兜底。
  • 核心:把 Demo 思维升级为生产思维,关注那些“看不见但至关重要”的基础设施。

大模型应用的下半场,拼的不是谁调模型更溜,而是谁能把 AI 能力稳定、安全、可观测地交付给最终用户。这恰好是前端工程师可以发挥长处的地方——我们一直擅长在复杂系统中,为用户构建清晰、可靠、友好的界面。现在,我们需要把这个能力延伸到系统的每一个角落。

如果你正准备转型,建议先从完善自己项目的日志和错误处理开始。这比学十个新框架,更能打动面试官。

总结

本文完成了关键概念、工程实践和落地建议的梳理。

资料展示

下面是我整理的AI大模型学习资料和工具包预览,适合收藏后按主题逐步学习。
AI大模型资料展示 1

AI大模型资料展示 2

AI大模型资料展示 3

AI大模型资料展示 4

如果你想看完整资料目录,可以在评论区留言「资料」;也欢迎告诉我你更关注AI大模型里的哪类内容。
优快云官方大礼包

【分布式系统学习】CAP原理详解 概述:互联网最重要任务莫过于海量数据处理,即大规模分布式系统,分布式是互联网的核心技术!!!如上所述,分布式系统是无法同时满足CAP三个特性的。1.Atomicity(原子性)一个事务中的所有操作,要么全部完成,要么全部不完成,不会在中间某个环节结束。事务在执行过程中发生错误,会被回滚到事务开始前的状态,就像这个事务从来没有执行过一样。2.Consistency(一致性)在事务开始之前和事务结束以后,数据库的完整性没有被破坏。3.Isolation(隔离性) 阅读详情

相关推荐

FPGA新手避坑指南:手把手教你搞定RTL8211千兆网PHY的时序配置(附Verilog代码)

本文详细解析了FPGA与RTL8211千兆网PHY芯片的时序配置问题,重点介绍了TXDLY/RXDLY引脚设置、FPGA发送端和接收端的Verilog实现,以及调试与验证的完整流程。通过硬件电路设计和代码示例,帮助开发者解决网络连接不稳定、丢包等常见问题,提升千兆网通信的稳定性。

weixin_28732953的博客 542

前端转大模型:用一次交付过程做复盘

先把这篇文章的目标说清楚:看完之后,你应该能判断这件事值不值得做,以及从哪里动手。摘要:很多前端同学转做大模型应用时,容易陷入“Prompt 调优”的单点迷恋,却忽略了工程化的底线。本文结合近期行业趋势,从 React/Vue 组件思维出发,拆解如何将 UI 交互经验迁移至 AI Agent 开发,重点讨论在 Demo 走向生产时,权限控制、日志追踪和流式响应如何处理,并提供具体的简历项目重构思路。---前端转大模型,不是换个语言写代码,而是换个视角做产品。

2601_96285276的博客 250

两张 300I Duo 部署 Qwen3.5‑32B

开发者成功使用两张华为300IDuo(共4颗Ascend310P3芯片)部署Qwen3/Qwen3.5的30B/32B模型,并公开详细步骤。关键点包括:硬件需两张300IDuo(每芯片44GB显存),软件需CANN≥24.1和MindIE2.3.0专用镜像。部署流程涵盖驱动安装、模型下载(需修改为FP16格式)、容器启动、张量并行配置(TP=4)等环节。实测显示每芯片显存占用20-35GB,系统稳定运行。该方案已在知乎等平台验证可行,适用于Qwen3.5-32B等同类模型。

evering的博客 2257

前端转大模型到底解决了什么问题?

去年我带过一个前端同学转大模型方向,简历写得挺漂亮:React、Vue、TypeScript、动画效果,还有两个基于 LangChain 的 Agent 项目。面试时我让他现场讲一个项目,他讲得头头是道,流式输出、RAG 检索、多轮对话全都有。我追问了一句:"如果这个 Agent 能调用公司 CRM 系统,权限怎么管?日志怎么打?崩了怎么回滚?"他沉默了十秒钟。这个场景不是个例。最近半年我看了不少前端转大模型的简历,普遍问题都一样:Demo 做得很炫,上线前检查几乎空白。

老男孩的架构路 143

线性分类器(Linear Classifier)

线性分类器 如上图所示,这是二维空间中的一个数据集,如果他正好能够被一条直线分成两类,那么我们称它为线性可分数据集,这条直线就是一个线性分类器。 在三维空间中,如果数据集线性可分,是指能够被一个平面分为两类。 在一维空间中,所有的点都在一条直线上,如果线性可分。可以理解为它们能够被一个点分开。 这里的直线、平面、点被分为决策边界。 一个 m 维空间中的数据集,如果能够被一个超平面一分为二,那么这个数据集就是线性可分的,这个超平面就是决策边界。 例如,这是二维平面上的一条直线, 它可以把平面切分成两

xuechanba的博客 1万+

ISP-全局色调映射(GTM)算法简单实现

色调映射算法,色彩空间转换LAB

notgoodenouf的博客 2242

前端转大模型:页面经验是优势,还是让你更难做出好产品的包袱?

前端转大模型应用开发,调API谁都会,但能把Demo变成真正可用的产品的人很少。这篇文章从真实项目复盘的角度,讲清楚前端经验哪些可以直接迁移、哪些反而会拖后腿,结合权限、日志、可观测这些生产级门槛,给出一份可执行的学习路径和作品集建议。前端转大模型应用开发,页面经验是优势,但优势不在"调API",而在"理解产品体验"。真正稀缺的不是会调API的人,而是能把权限、日志、可观测性这些工程细节都处理好的人。

2601_96285276的博客 348

人工智能---什么是Transformer?

Transformer是一种强大的神经网络架构,最初由Google的研究人员在论文《Attention is All You Need》中提出,用于自然语言处理任务,特别是在机器翻译方面取得了巨大成功。Transformer的核心思想是完全基于自注意力机制(self-attention mechanism)来实现序列到序列(sequence-to-sequence)的学习。它在自然语言处理(NLP)和其他序列到序列任务中表现出色,逐渐成为该领域的主流模型。近些年也逐渐在自动驾驶领域有所应用。

智能汽车人的博客 3955

前端转大模型,权限日志能救我的 Demo 吗?

摘要:从前端页面到 AI 产品工程师,很多人卡在 Demo 能跑、不敢上线。权限、日志、可观测——这些“老后端”经验,才是大模型应用落地的生死线。结合实战案例,聊聊怎么把一个“漂亮 Demo”变成“能交付的项目”。---前端转大模型,最大的误区是:把 AI 当“智能插件”,而不是“系统组件”。权限模型(谁可以调用哪个工具)日志体系(输入、输出、状态、耗时)可观测性(监控、告警、追踪)容错机制(重试、降级、熔断)这些不是“后端的事”,是“工程的事”。而工程,本就是前端的强项。

2601_96189167的博客 163

深入Scrapy ItemLoader:打造优雅高效的Python爬虫数据清洗流水线

ItemLoader是 Scrapy 提供的声明式数据加载工具。它的核心理念是:将数据提取(从response中取原始值)和数据清洗/验证(处理空值、格式转换、默认值等)分离开。你可以把它想象成一个工厂流水线:原始零件(selector提取的文本)进入,经过一道道工序(输入处理器),组装成最终产品(Item字段)。首先在items.py中定义清晰的数据结构。使用搭配类型注释(虽然Scrapy自身不强制,但对人和IDE友好)。

2201_76125261的博客 69

OpenMVS :用 colmap制作自己的数据集 重建(用colmap计算位姿,将位姿转为MVS需要的格式)

数据集制作主要是在windows进行,比较方便。

程序员,他们想的是什么?他们想的永远都是技术,他们崇尚的也永远都是技术。 3326

前端做AI应用很快,为什么上线后团队还是不敢接?

我见过太多前端同学转大模型应用开发,上手速度确实快。Prompt 怎么写、API 怎么调、前端怎么接流式响应,这些对他们来说几乎是本能。但真正到项目联调阶段,问题就来了——权限谁管?日志怎么记?错误怎么兜底?可观测性怎么搞?这些" boring 工程"恰恰是生产环境最硬的门槛。今天不聊虚的,结合我最近几个项目的实际踩坑,说说前端转大模型应用开发,哪些经验可以直接用,哪些坑必须补。前端转大模型应用开发,我的建议是:先补的:1. 流式响应的完整处理——不只是接数据,还要处理断连、超时、错误兜底。

2601_96189255的博客 224

ISO 21434汽车网络安全标准深度解读系列(十):标准实施总结与展望

ISO21434标准深度解读系列总结篇系统回顾了汽车网络安全标准的核心内容与实施要点。文章梳理了10篇系列文章的结构体系,提炼出标准的三大核心价值:系统性方法(全生命周期覆盖、多层次管理)、风险导向理念(威胁驱动、动态管理)和供应链协同机制。总结了实施经验中的关键要素,包括高层承诺、专业团队建设,并提出了分阶段实施路径建议。同时分析了当前面临的技术挑战(系统复杂性、新兴技术)和管理挑战(文化转变、资源投入)。最后展望了AI应用、零信任架构等技术发展趋势,以及标准未来的演进方向,为企业实施提供战略与执行层面的

VehSwHwDeveloper的博客 561

前端转大模型:从团队协作视角展开

去年我带的一个前端同学,做了个很漂亮的 RAG 问答 Demo,流式输出、Markdown 渲染、历史记录全都有,UI 甚至比公司现有产品还精致。业务方看完直接拍板上线。结果上线第三天,用户开始反馈"有时候回答莫名其妙"。我们排查后发现,问题不在模型,也不在提示词——是权限没控住,工具调用没有鉴权,某个 Agent 节点能访问到不该碰的数据库接口。更麻烦的是,日志链路不完整,出了问题只能靠用户截图反推。那次之后我彻底清醒:前端转大模型,最大的误区不是学不会 API,而是把 Demo 当产品。

m0_62051288的博客 377

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

前端转大模型:Demo能跑通就够了吗?权限日志才是真门槛

很多前端同学做了个ChatGPT风格的Demo就敢投简历,结果面试一问"你的项目怎么保证稳定上线"直接露馅。今天聊聊前端转大模型应用开发的真实路径,以及那些Demo阶段不会教、但上线必踩的坑。前端转大模型应用开发,优势在交互和体验,短板在工程化和稳定性。Demo 能跑通只是起点,不是终点。真正决定你能不能做好大模型应用的,是你对权限、日志、可观测性的理解,以及你在成本和体验之间做权衡的能力。我的建议是:1. 先扎实前端基础,流式输出、状态管理、异常处理这些基本功不能丢。

m0_62051288的博客 335

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

前端转大模型:把边界和取舍讲清楚

摘要:前端开发者转向大模型应用开发,最大的挑战不是模型调用或 Prompt 工程,而是权限、日志和可观测性。本文基于真实项目复盘,分析前端经验如何迁移,以及从 Demo 到产线的关键取舍。前端的转型优势AI 应用交互模式流式输出多模态体验作品集方向总结前端开发者转做大模型应用开发,最大的挑战不是技术本身,而是思维方式的转变。从关注页面效果到关注结果可靠性,从一次性交付到持续迭代,这些都需要重新思考。权限、日志和可观测性,是 AI 应用从 Demo 走向产线的关键,也是前端开发者需要重点关注的领域。

2601_96189255的博客 168

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

前端转大模型:Demo 跑通只是入场券,联调翻车才看清生产门槛

上个月组里接了个内部工具项目,用大模型做智能客服。我前端出身,接手的时候信心满满——调 API、写页面、对接流式输出,这些不都是熟手活儿吗?结果联调那天,第一个真实用户进来问权限相关的问题,模型返回了不该给的信息。运维同学当场脸色就变了。那一刻我才意识到,Demo 能跑和能上线,中间隔着一整套完全不同的东西。---这次联调翻车让我明白几件事:第一,前端经验是优势,但不是全部。交互设计、流式处理、状态管理这些可以直接复用,但权限、日志、可观测这些是新的必修课。

m0_62051288的博客 287

前端转大模型:业务提需求时,流式输出和权限隔离怎么取舍?

上个月接了个活,帮一个做知识管理的团队搭 AI 助手。业务方开场就说:要流式输出,要能读文档,还要能调内部接口改数据。流式输出,前端同学闭着眼都能写。权限隔离,说实话,我第一次做的时候差点翻车。这篇文章不是教你怎么调 API,而是复盘一次真实项目里,前端经验怎么用、哪里会踩坑、业务方提需求时你怎么判断优先级。---前端转大模型,优势在交互和状态管理,劣势在权限和安全意识。业务方提需求时,流式输出是基础,权限隔离是信任。你先要能跑通 Demo,才能谈生产级应用。

LLM_9528的博客 197

前端转大模型:为什么能跑通Demo,却上不了生产环境?

摘要:前端做AI应用有天然优势——交互设计、流式展示、用户体验。但Demo能跑和能上线是两回事。权限、日志、可观测才是生产环境的生死线。本文从前端视角拆解大模型应用开发的真实路径,结合近期行业趋势,给出可执行的作品集方向。---前端转大模型,优势在交互,瓶颈在生产化。你能快速做出好看的UI,能处理流式输出,能设计用户友好的交互。这些是后端同学需要补课的部分。但Demo能跑和能上线是两回事。权限、日志、可观测才是生产环境的生死线。这些是后端同学更熟悉的领域。

资料免费分享,点击名片 339

前端转大模型:用项目结果反推能力

摘要:很多前端同学转型做 AI 应用时,沉迷于调试 Prompt 和优化 UI 动效,却忽略了工程基建。本文结合从 Demo 到生产的真实踩坑经历,拆解为什么“权限控制”和“可观测性”才是区分玩具与产品的关键,并给出具体的代码实现建议。---前端转大模型,不是让你去研究 Transformer 的底层原理,而是利用你对用户体验和前端架构的理解,去填补大模型应用落地的最后一公里。记住,Demo 只是起点,权限和日志才是护城河。

2601_96120158的博客 353

前端转大模型:Demo跑通只是起点,权限日志才是简历的硬通货

去年我带过一个前端转大模型的同学,简历上写着"独立开发AI客服Agent,支持多轮对话",看着挺完整。面试时我让他现场演示,他给我开了个Demo链接,功能确实能用。但我问了一个问题:"这个Agent怎么判断用户有没有权限访问某个知识库?操作日志你存在哪?"他愣了一下,说"这个还没考虑"。不是他能力不行,是他的项目思维还停留在"把功能跑起来"。2026年了,大模型应用早就过了Demo阶段,团队接手的项目第一关就是权限、日志、可观测。

2601_96285279的博客 153

前端转大模型:Demo跑通容易,权限日志才是真正门槛

摘要:前端转大模型应用开发,调API谁都会,但真正让项目从Demo变成产品的,是权限控制、日志追踪和可观测性。这篇文章复盘我从前端转型过程中的真实踩坑经历,分享小团队如何避免过度设计,把有限资源投入到真正影响上线的部分。---目录前端的转型优势,别只看到表面AI 应用交互模式和页面开发的本质区别流式输出:前端的老本行,但有大模型特有的坑多模态体验:不只是图片识别,还有音频和文件作品集方向:Demo和产品的距离有多远总结:权限日志才是前端转大模型的真正门槛---

老男孩的架构路 213

前端转大模型:别只盯着 Prompt,权限与可观测才是生产环境的生死线

先把这篇文章的目标说清楚:看完之后,你应该能判断这件事值不值得做,以及从哪里动手。很多前端同学问我:“我想转大模型方向,是不是只要把 React/Vue 玩熟,再学个 LangChain 就能胜任?我的回答通常是:能拿到 Offer,但很难活过试用期。这两年,大模型应用的形态已经从早期的“聊天机器人 Demo”彻底转向了“工程化生产环境”。招聘 JD 里越来越频繁地出现对权限控制(RBAC/ABAC)、全链路日志追踪以及可观测性(Observability)的要求。

老男孩的架构路 310

前端转大模型:为什么你的 Agent 上线就崩?权限与日志才是 2026 的硬通货

先把这篇文章的目标说清楚:看完之后,你应该能判断这件事值不值得做,以及从哪里动手。很多前端同学想转型大模型应用开发,第一反应是学 LangChain、学 Prompt Engineering,觉得把 LLM API 调通就是胜利。但我最近复盘了几个从 Demo 到生产环境“翻车”的项目,发现了一个残酷的现实:代码写得再优雅,如果没有完善的权限控制和全链路可观测性,你的应用在生产环境里就是个定时炸弹。

资料免费分享,点击名片 304

前端转大模型:Demo 能跑,为何上线就崩?权限与日志才是护城河

先把这篇文章的目标说清楚:看完之后,你应该能判断这件事值不值得做,以及从哪里动手。很多前端同学转型大模型应用开发时,最大的误区在于“过度自信”。我们习惯了 React/Vue 的响应式世界,组件状态管理清晰,报错信息直白。当我们第一次用 LangChain 或 LLM SDK 写出一个可以对话的 Demo 时,那种快感是真实的:输入 Prompt,返回文本,完美。但现实是,当你要把这个 Demo 塞进生产环境,面对并发、安全性、合规性和调试需求时,你会发现之前的“顺滑”全是幻觉。

2601_96285276的博客 236

Web开发转Agent?3个顶尖大厂Offer经验分享,手把手教你学大模型开发!

本文作者分享了从Web开发背景转向Agent领域的经验,建议将LLM、RAG、Agent分阶段学习,推荐了MiniMind、RAG from Scratch、Hello-Agents等学习资源。强调工程能力的重要性,并推荐OpenCode、OpenClaw等开源项目帮助深入理解。最后指出,应注重解决实际问题,并通过量化指标来评估优化效果。

2401_85375151的博客 1107
上一篇: 大模型应用从Demo到上线,程序员凭什么拿到offer?
下一篇: 报表转 Agent 很香,但权限日志没兜底,上线就是灾难
Java技术那些事儿
博客等级 码龄5年 2306粉丝 2584原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值