前端转大模型:真实开发里的落地路径

STM32串口DMA双缓冲机制实战:提升数据传输效率的终极方案 本文深入解析了STM32串口DMA双缓冲机制的核心原理与实战配置。通过对比传统中断方式,阐述了双缓冲如何实现数据接收与处理的“无缝接力”,从而在工业传感器数据采集等高负载场景下,将CPU占用率降至极低水平并彻底避免数据丢失。文章提供了基于标准外设库的详细配置步骤、中断处理逻辑及性能实测数据,是提升嵌入式系统串口通信效率和可靠性的终极方案。 阅读详情

聊《前端转大模型:真实开发里的落地路径》之前,先说一句实在的:别急着背概念,先看它在真实项目里到底解决什么问题。

摘要

这篇面向想进入 AI 应用方向的前端开发者,但不会把“前端转大模型:真实开发里的落地路径”写成概念清单。我会按产品化视角的实战教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从初学者转型路线切入,重点写学习顺序和误区”展开,换一组场景和例子来讲。

目录

  • 前端的转型优势
  • AI 应用交互模式
  • 流式输出
  • 多模态体验
  • 作品集方向
  • 总结

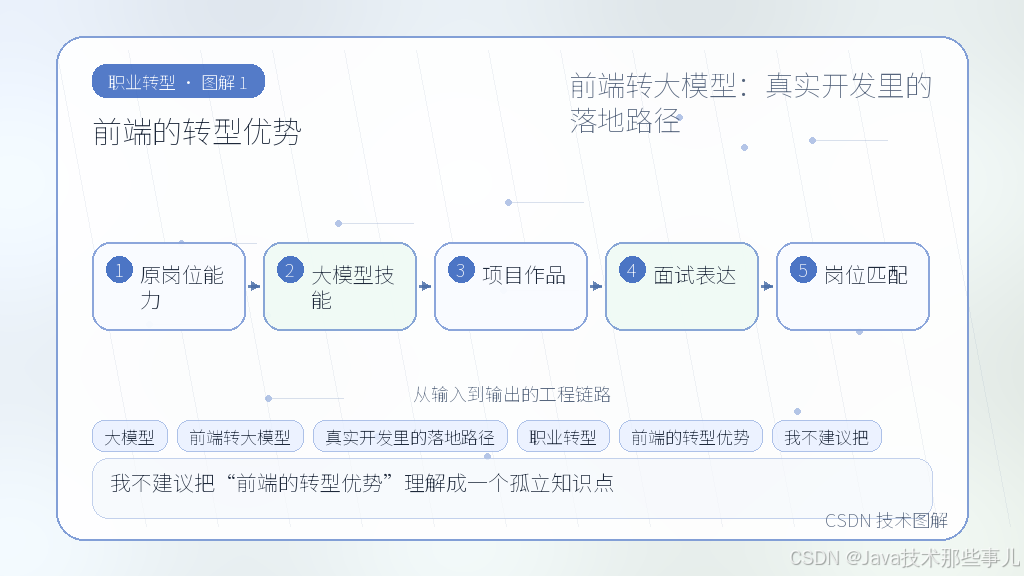
前端的转型优势

文章插图 1

我不建议把“前端的转型优势”理解成一个孤立知识点。它更像是“前端转大模型:真实开发里的落地路径”里的一段连接层:前面接需求,后面接实现,中间全是取舍。

实际开发时,我会先保留最朴素的版本,哪怕代码看起来没那么漂亮。等需求稳定、调用频率上来,再去做抽象。过早设计通常不是专业,很多时候只是给自己增加维护成本。

检查这部分有没有做好,可以看三个信号:别人能不能接手,线上出错能不能定位,需求变化时要不要大面积重写。

这一版我会把视角放在“从初学者转型路线切入,重点写学习顺序和误区”,所以这里更关注具体场景,而不是把同一套定义再复述一遍。

AI 应用交互模式
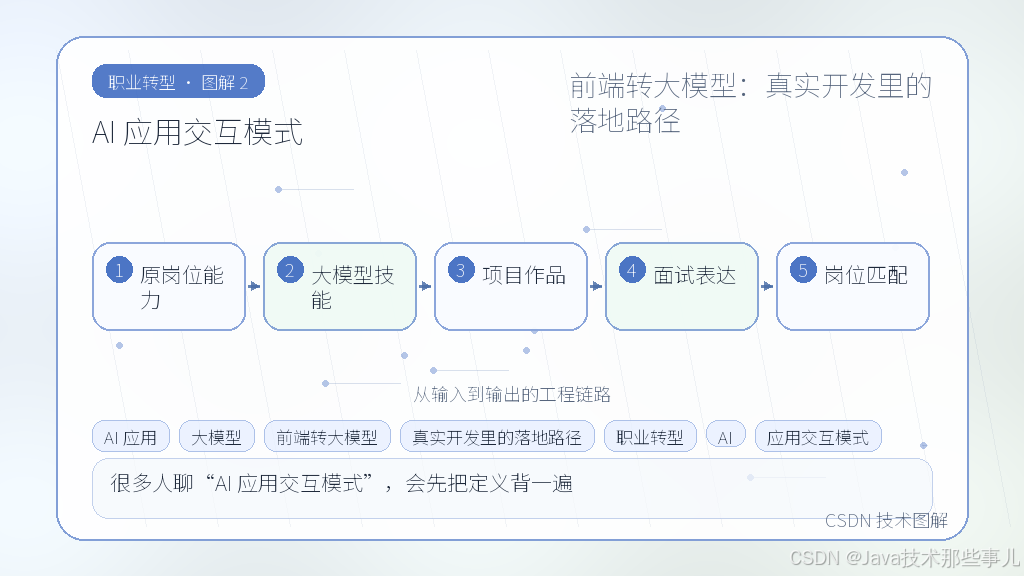
文章插图 2

很多人聊“AI 应用交互模式”,会先把定义背一遍。我的看法稍微不一样:从项目经验看,它必须能解释“前端转大模型:真实开发里的落地路径”里一个具体问题,否则就只是好听的词。

拿一个小项目来说,先别急着把框架、平台和插件全接上。我更愿意先画清楚输入是什么、输出给谁看、失败了怎么回滚。这三件事弄明白,后面的代码通常不会散。

这里最容易踩的坑,是把临时方案包装成通用架构。如果只是一次性脚本,就保持直白;如果要长期复用,再抽接口、加日志、补测试。

这一版我会把视角放在“从初学者转型路线切入,重点写学习顺序和误区”,所以这里更关注具体场景,而不是把同一套定义再复述一遍。

from collections.abc import Callable

def trace_call(name: str) -> Callable:
    def decorator(func: Callable) -> Callable:
        def wrapper(*args, **kwargs):
            print(f"start {name}")
            result = func(*args, **kwargs)
            print(f"finish {name}")
            return result
        return wrapper
    return decorator

@trace_call("calculate")
def calculate_score(values: list[int]) -> int:
    return sum(value * 2 for value in values)
优快云资料领取方式

流式输出

“流式输出”这块不适合只看教程截图。真正有用的学习方式,是把“前端转大模型:真实开发里的落地路径”拆成一个可以演示的小流程。

比如先做一个最小版本:一份输入数据,一个处理函数,一个可见结果。跑通以后再考虑缓存、权限、监控和异常处理。这样推进慢一点,但每一步都能留下证据。

如果你准备把它写进简历,也别只写“熟悉”。最好能说清楚你解决了什么问题、用了什么取舍、最后效果怎么验证。

这一版我会把视角放在“从初学者转型路线切入,重点写学习顺序和误区”,所以这里更关注具体场景,而不是把同一套定义再复述一遍。

在复杂度估算中,可以把一次批处理抽象为:

$$T(n)=O(n)+O(k)$$

其中 n 表示输入规模,k 表示固定的框架调度成本。这个表达式提醒我们,优化时既要关注算法,也要关注运行时环境。

多模态体验

我不建议把“多模态体验”理解成一个孤立知识点。它更像是“前端转大模型:真实开发里的落地路径”里的一段连接层:前面接需求,后面接实现,中间全是取舍。

实际开发时,我会先保留最朴素的版本,哪怕代码看起来没那么漂亮。等需求稳定、调用频率上来,再去做抽象。过早设计通常不是专业,很多时候只是给自己增加维护成本。

检查这部分有没有做好,可以看三个信号:别人能不能接手,线上出错能不能定位,需求变化时要不要大面积重写。

这一版我会把视角放在“从初学者转型路线切入,重点写学习顺序和误区”,所以这里更关注具体场景,而不是把同一套定义再复述一遍。

作品集方向

很多人聊“作品集方向”,会先把定义背一遍。我的看法稍微不一样:从项目经验看,它必须能解释“前端转大模型:真实开发里的落地路径”里一个具体问题,否则就只是好听的词。

拿一个小项目来说,先别急着把框架、平台和插件全接上。我更愿意先画清楚输入是什么、输出给谁看、失败了怎么回滚。这三件事弄明白,后面的代码通常不会散。

这里最容易踩的坑,是把临时方案包装成通用架构。如果只是一次性脚本,就保持直白;如果要长期复用,再抽接口、加日志、补测试。

这一版我会把视角放在“从初学者转型路线切入,重点写学习顺序和误区”,所以这里更关注具体场景,而不是把同一套定义再复述一遍。

总结

回到“前端转大模型:真实开发里的落地路径”这个主题,最重要的不是把名词背全,而是知道它该放在什么场景里用。能跑起来的小项目、说得清楚的技术取舍、能展示的结果,比泛泛而谈更有说服力。后面真做的时候,可以先挑一个小场景验证,再把代码、笔记和复盘整理成自己的作品集。

资料展示

下面是我整理的AI大模型学习资料和工具包预览,适合收藏后按主题逐步学习。
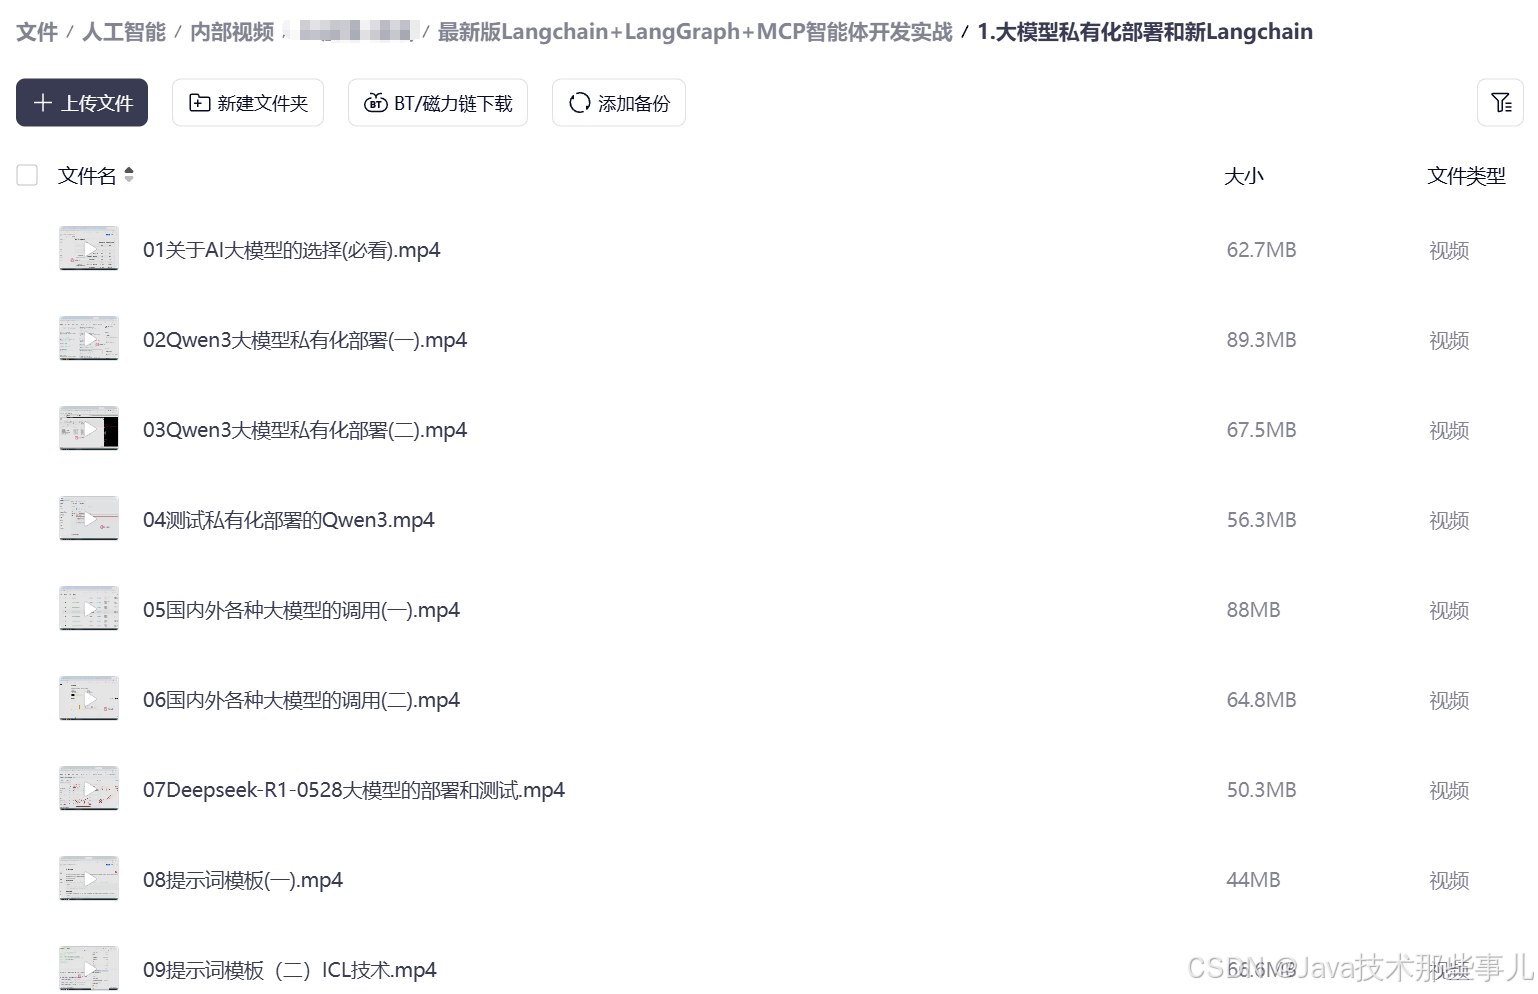
AI大模型资料展示 1

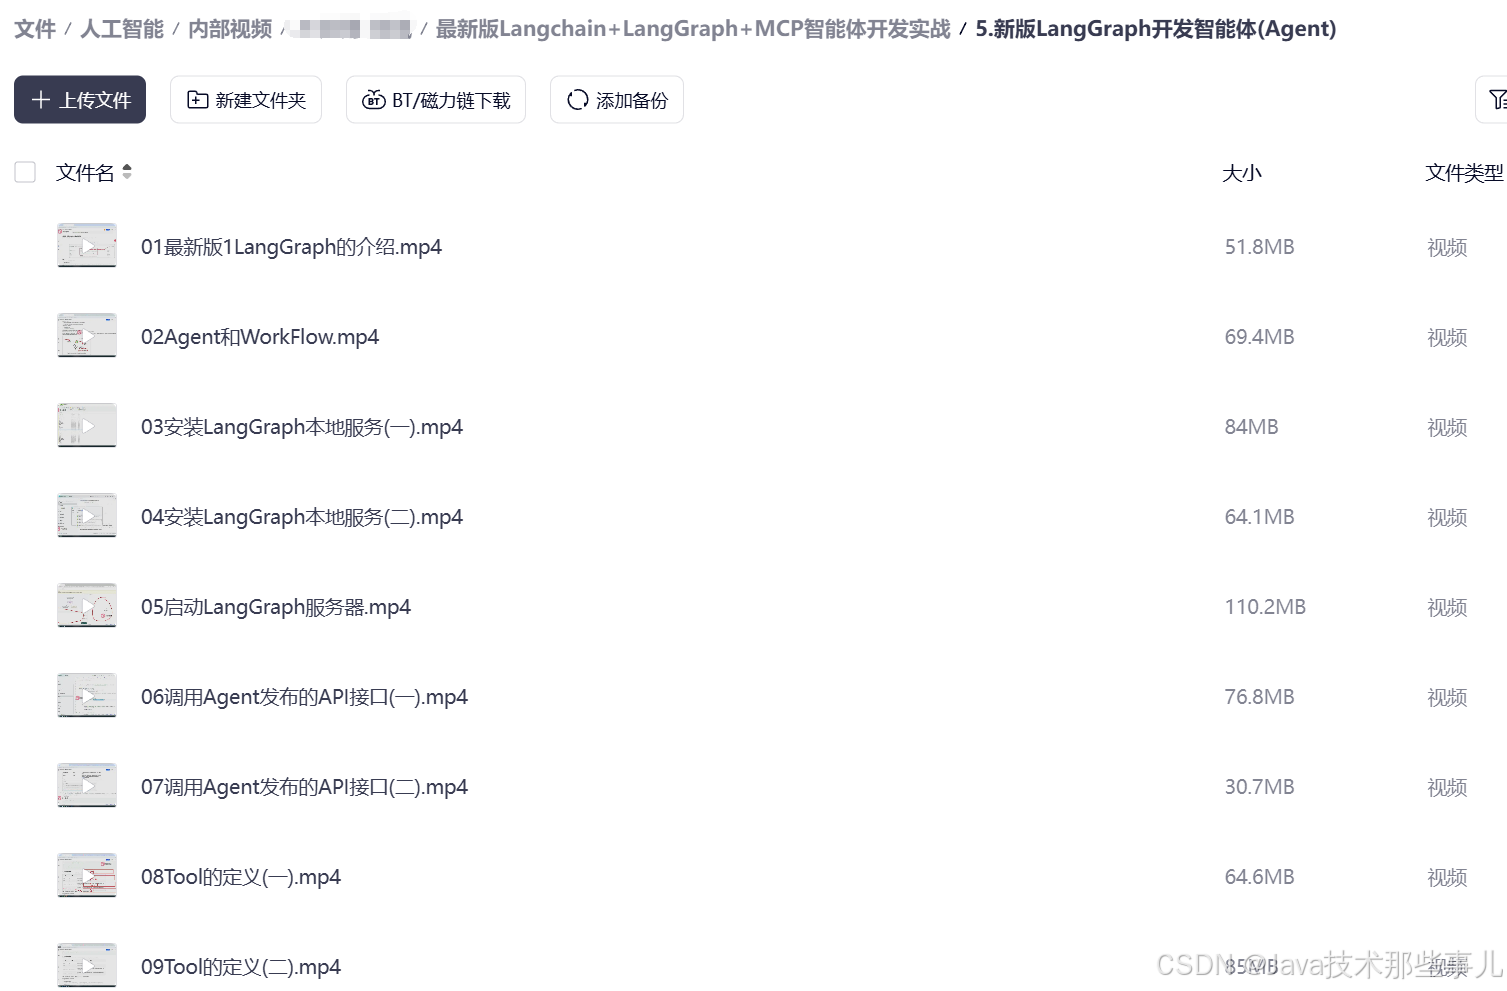
AI大模型资料展示 2

AI大模型资料展示 3

如果你想看完整资料目录,可以在评论区留言「资料」;也欢迎告诉我你更关注AI大模型里的哪类内容。
优快云官方大礼包

CISSP背书三次失败后的终极解决方案 本文分享了作者CISSP认证三次线上背书审核失败的经历与终极解决方案。针对(ISC)²官方审核的严格性,文章详细剖析了使用公积金证明、工作证明盖章签字等常见材料的误区,并最终提出了通过构建“官方邮件往来”证据链的核心策略,以动态、可验证的方式成功通过审核,为后来者提供了详实的避坑指南和实操清单。 阅读详情

相关推荐

Gromacs实战:从蛋白质-小分子对接到分子动力学模拟全流程解析

本文详细解析了使用Gromacs进行蛋白质-小分子对接和分子动力学模拟的全流程,包括文件准备、拓扑生成、复合物构建、溶剂化处理、能量最小化及平衡模拟等关键步骤。通过实战案例,帮助研究者验证药物分子与靶标蛋白的结合稳定性,提升分子动力学模拟的效率和准确性。

weixin_29216353的博客 385

让大模型画图表:自然语言转可视化配置的前端落地与校验

NL2Chart 把自然语言变成可交互图表,是 AI 前端的重要落地方向。落地建议:第一,用白名单与 Schema 对齐约束模型输出,阻断字段幻觉。第二,所有生成必须超时、可中断,失败统一降级为表格。第三,控制提示词体积,宽表场景只传字段结构。第四,高频意图缓存模板,保证体验一致性。最终在智能生成与稳定可控之间取得平衡。这条路在生产看板下能跑通,回报是值得的。

rain_sxr的博客 4647

UniApp 与 Taro 深度解析:如何根据项目需求选择最佳跨平台框架?

本文深度对比了UniApp和Taro两大主流跨平台开发框架。UniApp基于Vue生态,提供开箱即用的高效开发体验,尤其适合快速覆盖多端小程序;Taro则根植React范式,架构灵活,便于与现有React生态集成,更适合对性能和原生体验有高要求的复杂项目。文章结合团队技术栈、项目类型及性能需求,为开发者提供了清晰的选型指南。

snow3的博客 204

AI 大模型就业:真实开发里的落地路径

别被培训机构忽悠去学“微调大模型”了。现在的企业更缺能接 API、做 RAG 应用、把模型嵌入业务系统的工程人员。本文不谈虚的,只讲从传统后端转岗的真实路径、简历里该放什么 Demo、以及那些只有踩过坑才知道的技术选型细节。以前我们叫“后端开发”,现在这个头衔下面分出了两个主要方向:一个是传统的 CRUD 维护,另一个是 AI 工程化(LLM Engineer)。大部分公司并没有设立独立的"Prompt 工程师”岗位,因为纯调参没法解决业务逻辑漏洞。真正的机会在于“后端 + AI”。

老男孩的架构路 346

HA集群 执行 hdfs haadmin -transitionToActive 失败

最近把一个单NameNode集群变更为HA集群,过程中都很顺利,nn1和nn2两个NameNode都显示standby状态,但是把nn1或者nn2切换到active状态时就会报错抛异常。 查看master上namenode启动日志,如下: Incompatible clusterID for journal Storage Directory /home/hadoop-zero/bigdat...

qq_34727158的博客 1764

随机森林的可解释性分析(含python代码)

随机森林的“黑箱”特性逐渐凸显,这使得我们难以理解和解释模型内部的工作机制。对于许多应用场景而言,仅仅获得高准确率的预测结果是不够的;了解预测背后的逻辑同样重要,特别是在医疗诊断、金融风险评估等领域。因此,对随机森林进行可解释性分析变得尤为重要。

m0_59257547的博客 3848

前端如何进行大模型技术输出落地_前端接入大模型

最近一俩年,大模型实在卷的不行,以前我是觉得大模型和我一个干前端的没啥关系,可是在今年我的这个想法变了;身边的人都开始关心大模型的发展了,我们团队就开始发力去研究大模型了;我觉得是机遇来了,我们团队在研究了几个月后,还真的发现了不少的落地场景,其中不少还应用到了公司内部的业务,实现了为业务赋能的使命。今天我想给大家介绍的刚好是我们团队准备对外公开使用的大模型落地项目,是一个关于电商工具的垂直领域的工具,直接载体就是h5页面;

HJS123456780的博客 1448

完美解决unknown failed to transfer from http://0.0.0.0/ during a previous attempt的错误

完美解决unknown failed to transfer from http://0.0.0.0/ during a previous attempt的错误

念兮为美 2281

【保姆级教程】后端开发转大模型开发学习路径分享!

在AI技术席卷全球的今天,大模型(Large Language Models, LLMs)已成为科技行业的“新石油”。从ChatGPT到通义千问,从代码生成到智能客服,大模型正在重塑软件开发的边界。而作为长期深耕系统架构、服务开发的后端程序员,你是否曾想过:自己的技术积累,其实正是转型大模型工程师的绝佳跳板?

Android23333的博客 1423

java毕设:基于springboot的服装搭配推荐系统(springboot+layui+jq+html)1011

项目描述 基于springboot的服装搭配推荐系统: 基于天气服装搭配推荐系统为用户提供未来一周的天气预报情况,并根据预报天气和用户现有的服装进行着装搭配,以及显示未来6小时精确温度数据为用户提供更精确的天气信息便于用户在出行前对自己的着装进行调整,每日用户可以根据自己当日对系统推荐的着装搭配舒适度进行反馈,系统将根据用户的反馈对用户着装的保暖系数进行相应调整,通过多次的反馈和调整形成对用户着装的个体化和精确化的推荐。 本系统可以为用户提供以下服务: 1.未来五天的天气信息显示; 2.未来六小时内天气温度

qq_2537071370的博客 3647

DirectX function “GetDeviceRemovedReason“ failed with DXGI_ERROR_DEVICE_HUNG (“The GPU will not resp

游戏报错"DXGI_ERROR_DEVICE_HUNG"的解决方案 在使用RTX 40系显卡运行FIFA 23等游戏时,可能出现DirectX报错导致游戏崩溃。这主要由于最新显卡驱动与DirectX 12的兼容性问题。解决方法包括: 降级显卡驱动版本 修改游戏配置文件,将DIRECTX_SELECT设为1 在显卡控制面板中关闭垂直同步、抗锯齿、DLSS 3等功能 调整电源模式为性能优先 这些操作可以有效解决因驱动兼容性导致的游戏崩溃问题。

猿小白的博客 3893

前端转大模型:代码实践里的关键取舍

这篇面向想进入 AI 应用方向的前端开发者,但不会把“前端转大模型:代码实践里的关键取舍”写成概念清单。我会按产品化视角的实战教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从一次真实项目复盘切入,重点写取舍和踩坑”展开,换一组场景和例子来讲。回到“前端转大模型:代码实践里的关键取舍”这个主题,最重要的不是把名词背全,而是知道它该放在什么场景里用。能跑起来的小项目、说得清楚的技术取舍、能展示的结果,比泛泛而谈更有说服力。

资料免费分享,点击名片 256

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

前端转大模型:用真实问题串起路线

最近和几个做 React/Vue 的朋友聊天,发现一个很有意思的现象。很多人以为从“画页面”转到“搞 AI”,最大的门槛是学会写复杂的 Prompt 或者理解 Transformer 原理。结果真去面试或接项目时,被问倒的不是“怎么让模型回答更聪明”,而是“你的 Agent 怎么防止越权访问数据库?”、“日志怎么追踪用户意图漂移?”以及“流式响应断了怎么恢复?这就是典型的“Demo 陷阱”。我们在本地跑个 Gradio 或者 Streamlit,连上 OpenAI API,一切都很完美。

m0_62051288的博客 369

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

前端如何转 AI 应用开发

前端转 AI 应用开发,本质上不是换赛道重开,而是一次能力升级。你不需要马上去研究怎么训练大模型,也不需要把自己硬拧成算法工程师。站在前端已有的工程能力和产品思维上,学会接入模型、组织流程、连接数据、设计体验,最终做出真正有用的 AI 应用。未来真正值钱的人,往往不是最懂模型底层的人,而是那些能把 AI 能力稳定地落进业务场景、让用户真用起来的人。而这件事,前端工程师其实非常有优势。

相信自己,没有攀不过去的高山! 940

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

前端转大模型:把落地步骤拆成清单

上周有个前端朋友问我,想转大模型方向,是不是得先把 Transformer 论文啃完?我说不用,你先把一个需求从"业务方一句话"拆到"能上线"走一遍,比刷十篇论文有用。我做了几期大模型应用项目,从 Demo 到上线踩过不少坑。今天不聊模型原理,聊前端转大模型最实际的东西——怎么把"能跑"变成"能用"。---前端转大模型,第一道门槛不是算法,是产品思维。你会写页面,知道用户要什么;你会调 API,知道怎么把结果展示出来。缺的只是把 AI 能力集成到产品里的经验。

资料免费分享,点击名片 283

前端转大模型:把关键能力落到项目里

摘要:很多前端同学转做大模型应用时,习惯性地觉得最难的是调通 API 或写出完美的 Prompt。但当我把几个 Demo 项目推向真实生产环境时,发现真正的瓶颈完全变了:如何保证用户 A 看不到用户 B 的数据(权限),以及当 Agent 出错时,我们究竟是在哪里断掉的(可观测性)。本文结合一个从页面开发转向 AI 产品工程师的实战复盘,聊聊在小团队资源有限的情况下,如何避免过度设计,用工程化思维补齐 AI 应用的最后一块短板。目录前端的转型优势:从“像素还原”到“状态管理”

2601_96285279的博客 183

前端转大模型:从团队协作视角展开

去年我带的一个前端同学,做了个很漂亮的 RAG 问答 Demo,流式输出、Markdown 渲染、历史记录全都有,UI 甚至比公司现有产品还精致。业务方看完直接拍板上线。结果上线第三天,用户开始反馈"有时候回答莫名其妙"。我们排查后发现,问题不在模型,也不在提示词——是权限没控住,工具调用没有鉴权,某个 Agent 节点能访问到不该碰的数据库接口。更麻烦的是,日志链路不完整,出了问题只能靠用户截图反推。那次之后我彻底清醒:前端转大模型,最大的误区不是学不会 API,而是把 Demo 当产品。

m0_62051288的博客 377

2026年大模型从技术狂欢到真实落地的完全指南

2025年大模型技术从理论走向落地实践,分享了Dify部署、RAGFlow知识库构建等实战经验,揭示了效果、工程、成本和业务落地等核心挑战。2026年将开展真实应用调研,聚焦企业知识问答、智能客服等工作场景,针对RAG效果、私有化部署、成本控制等痛点问题,提供可复现的工程方案和优化经验,帮助实现大模型的业务价值。同时提供从入门到进阶的完整学习路径,包含系统设计、提示工程、平台开发等七大阶段,助力开发者掌握大模型全栈能力。

weixin_55154866的博客 629

前端转大模型:把学习路径落到证据

做前端这么多年,我习惯了用 Chrome DevTools 排查性能瓶颈,用 CSS Grid 解决布局对齐。但当我第一次尝试把公司内部的 CRM 系统接上大模型能力时,我发现以前那一套“组件化”思维完全失效了。之前的 Demo 跑得很顺,用户问什么答什么,界面丝滑。可一旦我们要把这个功能放到生产环境,给不同角色的销售用,问题就来了:实习生能不能看到客户的手机号?财务能不能通过 Chat 修改订单状态?如果模型幻觉胡编了一个订单号,我怎么知道是哪次请求导致的?

2601_96189167的博客 279

收藏!2026前端转行AI大模型应用开发:从0到1落地指南(附完整学习路线)

写了5年前端,转眼30岁,在无尽的框架迭代和内卷内耗里,我彻底放弃了“深耕前端就能破局”的幻想,毅然转向AI大模型应用开发。从下定决心转型,到顺利拿到心仪offer,这一路踩过不少坑,也积累了很多实操感悟,今天就掏心窝子跟还在犹豫的前端同行、想入门AI的小白程序员聊一聊,希望能帮你少走弯路。先跟大家说句实在话:别被前端圈的焦虑带着跑。2026年的前端市场,早已是红海一片,卷完Vue3卷React新特性,卷完性能优化卷跨端开发,很多人熬到30+,反而越来越没安全感。

youmaob的博客 287

前端转大模型开发:收藏这份实战干货,小白也能轻松入门!

这次去百度面试,给我最大的收获不是拿到了什么样的结果反馈,而是终于想通了一件事:大厂的门槛,一半是真实的工程门槛,另一半是我们自己脑补出来的恐惧。如果你也在纠结要不要转 Agent 方向,或者在犹豫要不要去冲大厂,别在“我到底够不够格”这个问题上反复内耗。先动起来,手搓一个包含流式交互、RAG 检索和状态兜底的真实项目,能力自然就练出来了。2026 年一晃已经过半,AI 大模型的热潮不仅没有降温,反而持续升温!

AI大模型的博客 565

前端转大模型:Demo能跑通容易,权限日志才是团队接手的真实门槛

前端工程师转大模型应用开发,最大的误区是以为学会调 API 就能上岗。我面试过十几个转行同学,也带过几个从前端转型的同事,发现一个规律:能做出 Demo 的人很多,能扛住生产联调的很少。最近这个岗位的需求明显在变化,JD 里"权限管理""可观测性""日志追踪"出现的频率越来越高。这篇文章不聊算法,只聊前端工程师转大模型的真实路径和那些容易被忽略的硬门槛。前端转大模型,不需要成为算法专家。你的优势在工程化和用户体验。但你需要补上的,不只是调 API 的能力,而是从 Demo 到生产的完整工程化能力。

2601_96285279的博客 182

前端转大模型:从排查路径看工程价值

摘要:前端转大模型应用开发,最大的陷阱不是学不会新框架,而是把 Demo 能跑当成产品能做。本文从一次真实的项目沟通切入,讲清楚流式输出、多模态交互、权限与日志这些"非前端"却决定项目生死的技术点,以及作品集应该怎么摆才能让人看到你的工程化思维。---前端转大模型,不是换赛道,是扩赛道。你的交互能力、状态管理能力、边界意识,在大模型应用里一样值钱。但你要补的课不是更多框架,而是工程化思维:权限、日志、可观测、成本控制。Demo 能跑是入门,能让 Demo 活下来才是本事。

2601_96189167的博客 238

前端转大模型:从页面开发到 AI 产品工程师

这篇面向想进入 AI 应用方向的前端开发者,但不会把“前端转大模型:从页面开发到 AI 产品工程师”写成概念清单。我会按产品化视角的实战教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从求职作品集角度切入,重点写可展示成果”展开,换一组场景和例子来讲。回到“前端转大模型:从页面开发到 AI 产品工程师”这个主题,最重要的不是把名词背全,而是知道它该放在什么场景里用。能跑起来的小项目、说得清楚的技术取舍、能展示的结果,比泛泛而谈更有说服力。

资料免费分享,点击名片 80

大模型入门到精通:揭秘前端转行大模型的原因,一篇搞定前端接入语言大模型!

“前端生态系统发展得如此之快,从某种程度上讲,前端工程师比其他任何人都更擅长将 AI 引入他们的工具集,因为他们习惯于掌握新工具,并弄清楚如何整合和使用这些工具来汇集所有不同工作流程的精华,”可观测性平台 Honeycomb 的工程副总裁 Nakashima 说。

2401_84494441的博客 1038
上一篇: LangGraph 工作流:从问题定位到方案成型
下一篇: 程序员职业规划:适合普通开发者的入门路线
Java技术那些事儿
博客等级 码龄5年 2306粉丝 2584原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值