使用亮数据工具抓取城市地铁数据实践

爬取高德地图中地铁站点数据 使用python爬取高德地图地铁站点数据,保存成excel或shp文件。 阅读详情

前言:

最近有个需求,需要抓取国内城市地铁数据,但是身为前端仔,没有爬过数据。就想图个方便好用的数据抓取工具,所以就去网上找了下技术方案,使用 Nodejs + puppeteer 来抓取数据,本着自己动手丰衣足食的原则,就采用该方案自己写了一个工具。

但是由于技术菜,各在线网站的抓取限制和其他成本原因导致效果实在是不理想

  • 1.抓取速度慢,数据量小
  • 2.抓取的数据不全

还遇到目标网站封锁 IP 的问题,导致抓取失败; 只能放弃自己实现抓取工具的方案;

转而寻求现有的抓取数据工具,问了一些大佬朋友,大佬说可以使用亮数据(Bright Data)的工具来抓取数据。

针对上面的数据规范抓取,IP 封锁的问题,亮数据的工具都有相应的解决方案。

所以就选择了亮数据(Bright Data)的工具来抓取数据。

亮数据工具介绍
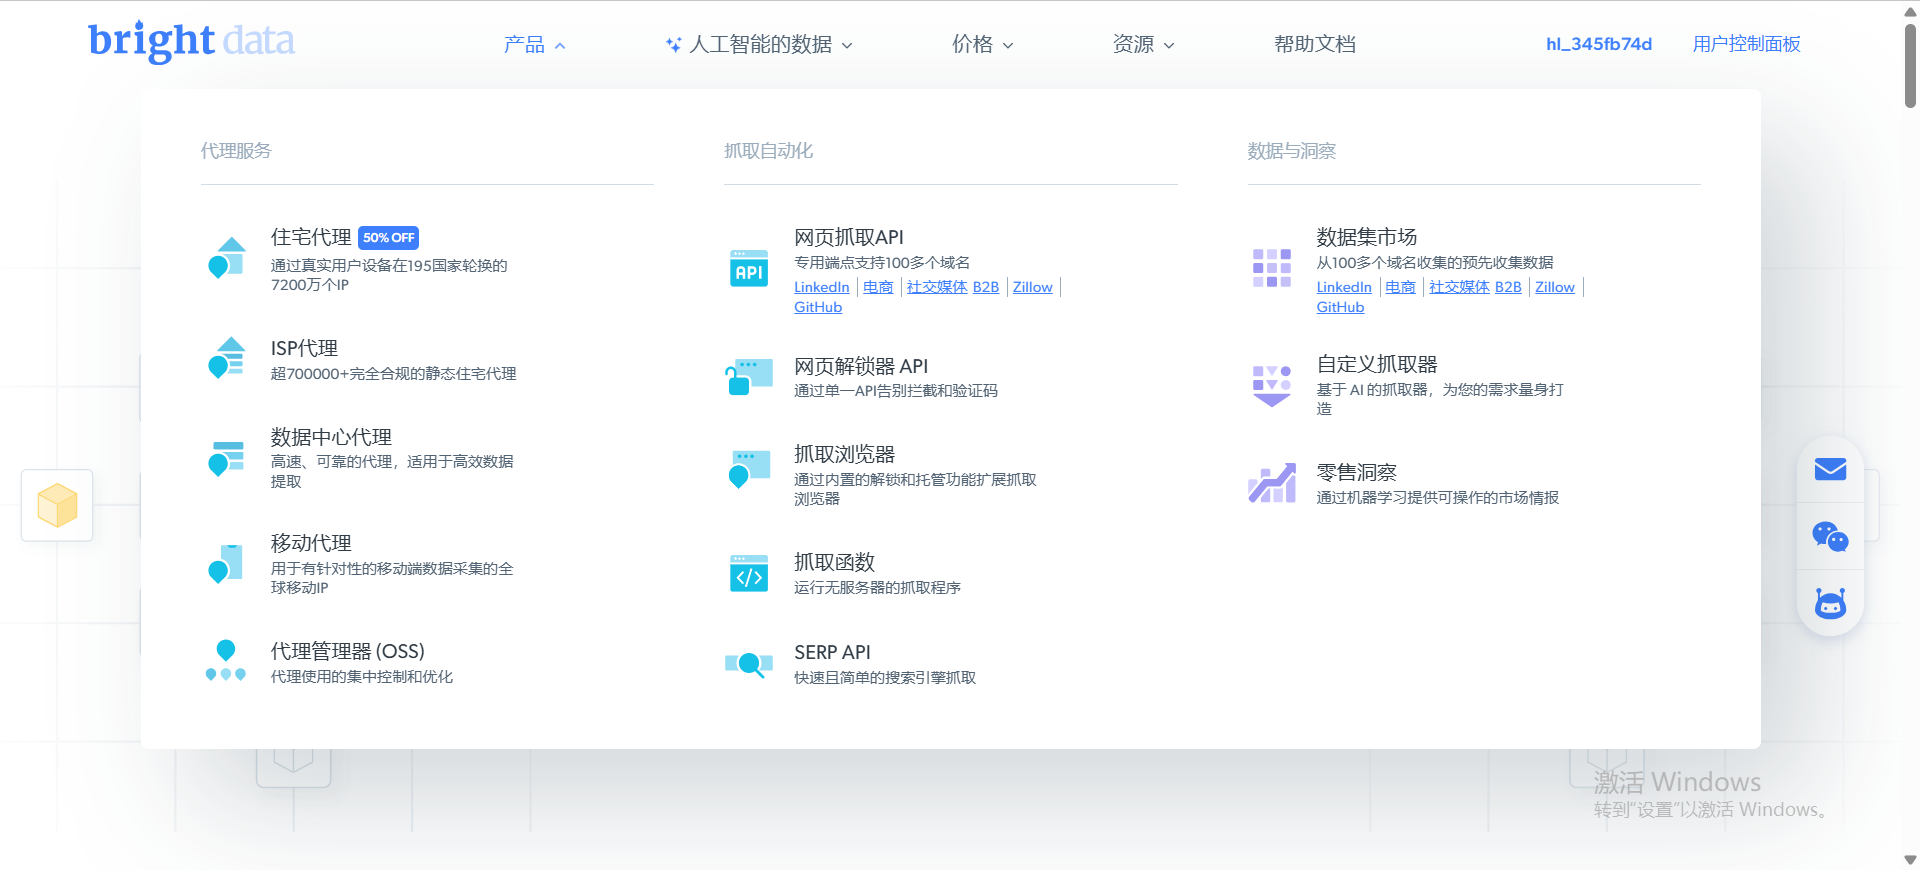
从上图可以看到,亮数据工具提供了许多的现成的成熟方案以及在线产品来满足我们抓取数据不同需求,解决在线网站的抓取限制的各种问题和其他成本问题

所有产品使用可参见 亮数据(BrightData)官方产品文档

比如:

  • 代理服务:使用代理 IP 来抓取数据,避免 IP 被封锁
  • 数据抓取:
    • 100+网站专用端点数据抓取 API
    • 亮数据专用抓取浏览器工具
    • 网站验证拦截和验证码限制规避
    • 无服务器抓取程序
  • 数据集市场:126+ 域名、共 210+ 数据集,涵盖各大通用公共网络数据网站现成的预收集数据

全方位的解决方案,满足我们抓取数据的各种需求

并且现在注册,即可获取免费使用福利
注册专属链接:亮数据-网络IP代理及全网数据一站式服务商

数据抓取实践

确定数据来源

要抓取数据,首先需要知道数据的来源

比如这次我想要的国内各城市地铁数据

来源就是国内某地图在线提供商的地铁数据

出于安全因素,不能提供网站的具体的 URL 地址

比如:某个城市的数据如下再页面中如下:
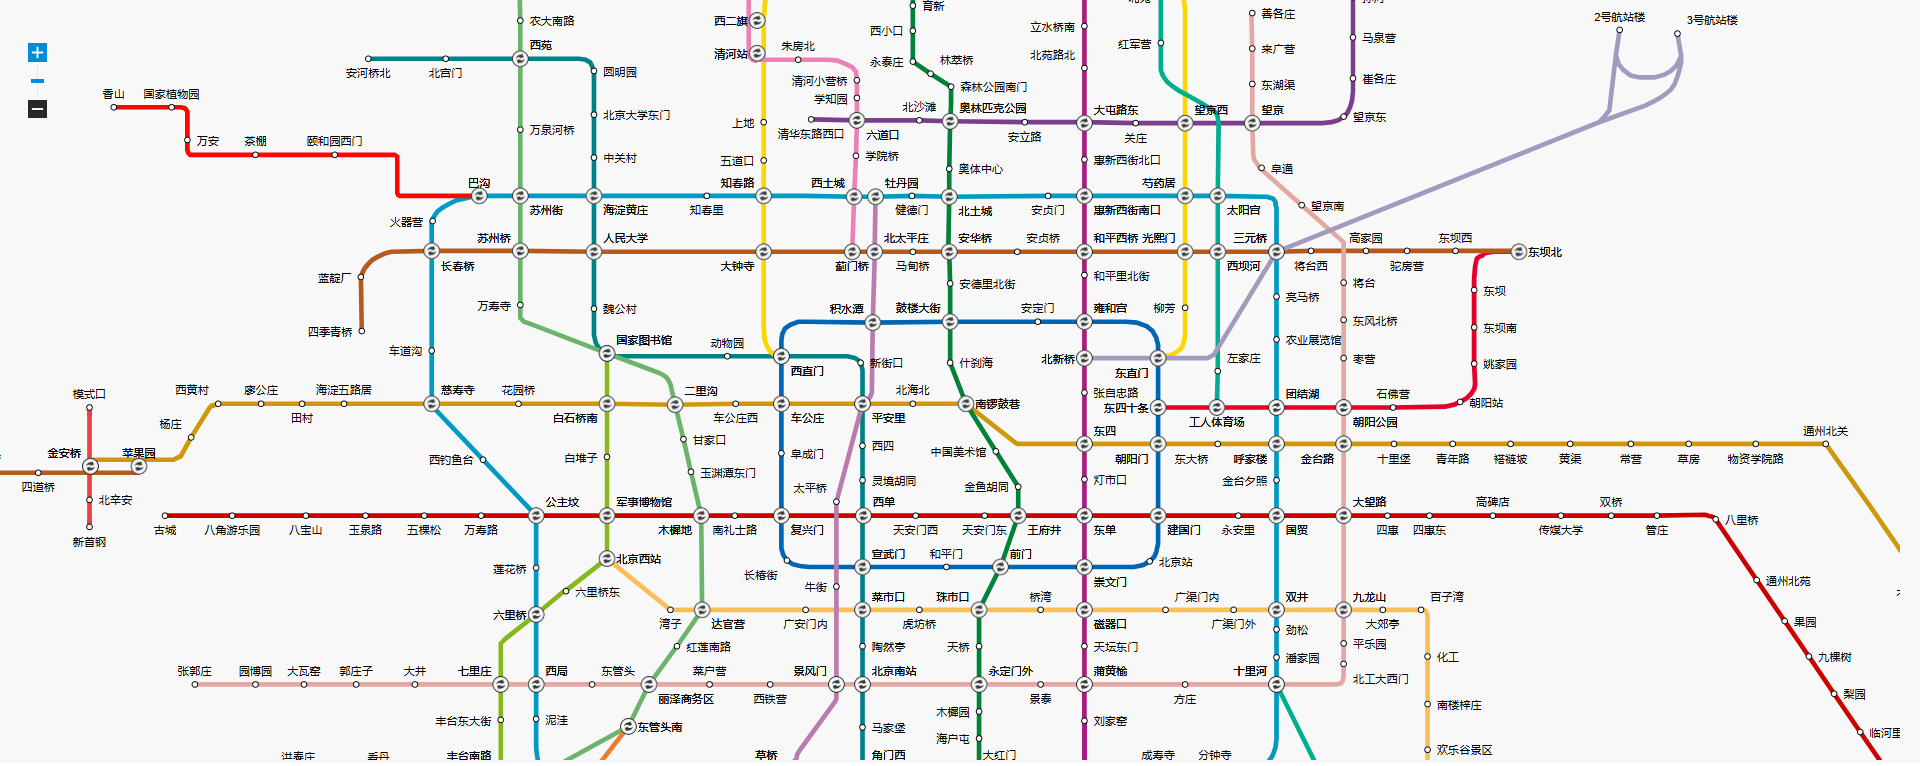
由于数据是公开的,所以可以直接通过 URL 来获取数据

但是我需要的是 JSON 数据,页面是 HTML 数据,但是没关系

先拿到所有的 HTML 数据之后,再通过正则表达式来提取数据即可

所以目前这一阶段我的需求是:

  • 获取所有城市的地铁数据的页面HTML数据

确定抓取工具

问题来了

但是我应该选择什么工具来抓取数据呢?

对于我来说最重要的:方便使用

尽量少的学习使用成本,尽量快的获取数据

查阅亮数据提供的爬取方案后,我发现了以下几种方案可以实现我的要求:

  • 1.网络解锁器
  • 2.SERP API
  • 3.抓取浏览器
  • 3.网页抓取 API

根据我的需求,并在阅读了亮数据的官方文档之后,我发现第一种比较合适

亮数据网络解锁器(Web Unlocker API)
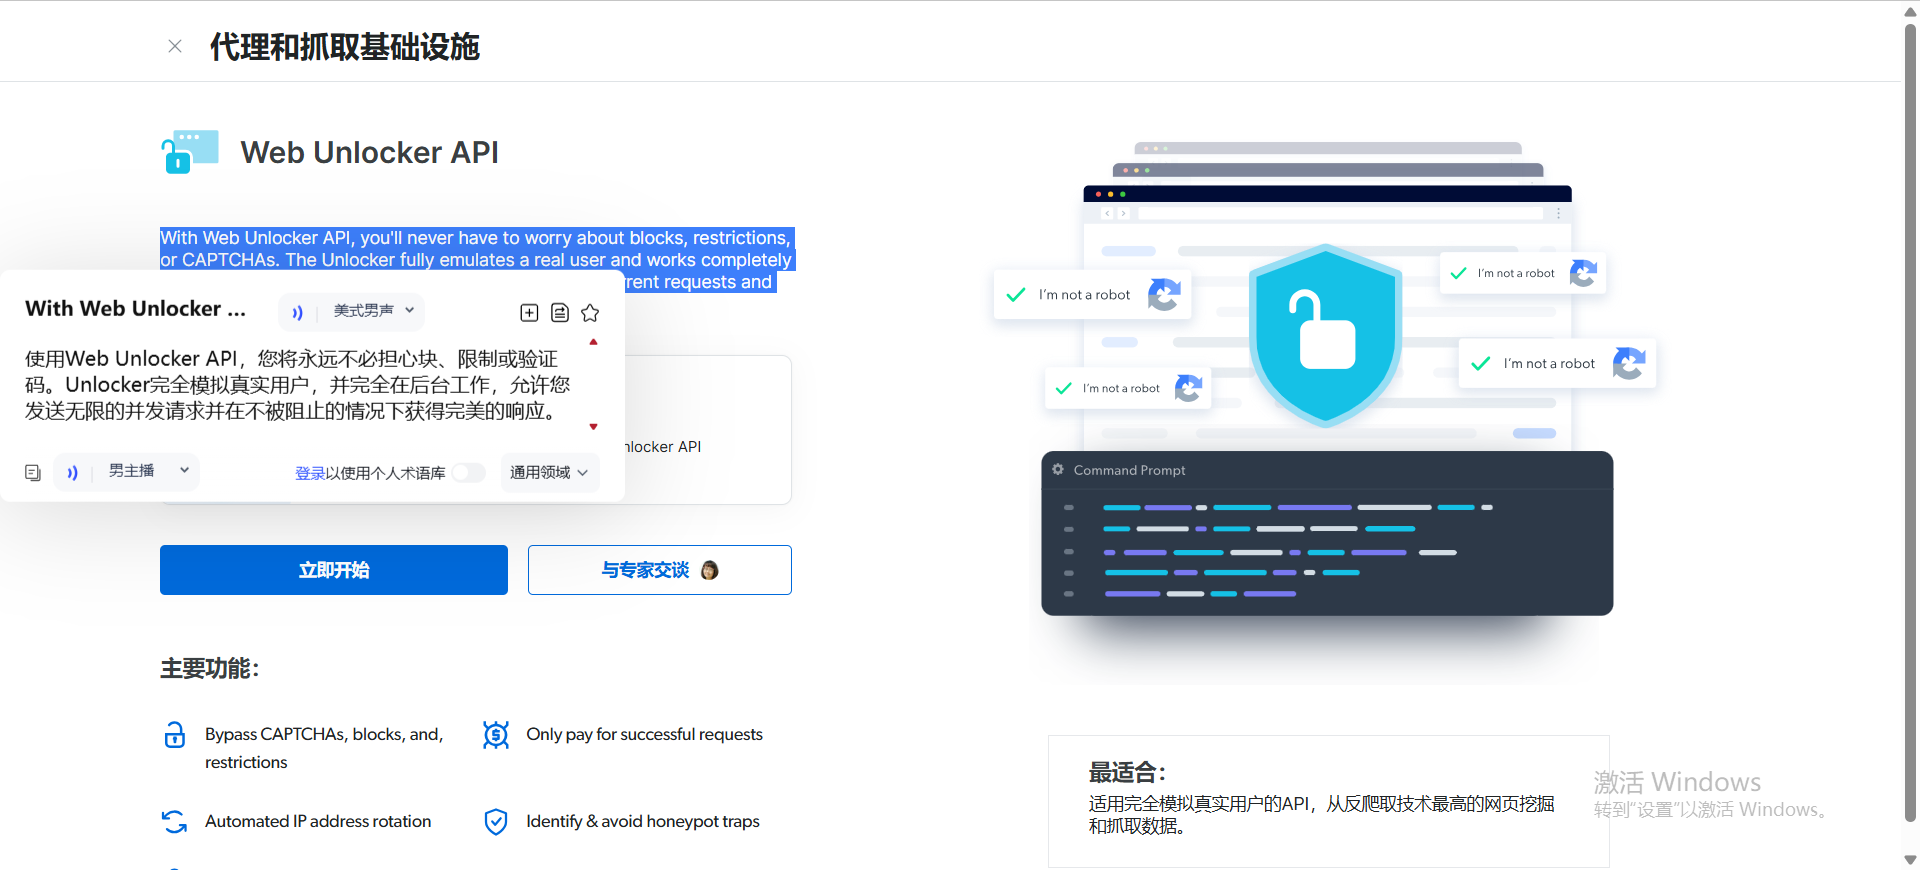
通过文档查看后到这句话:亮数据网络解锁器只需向目标网站发送一个代理请求,我们就会将干净的 HTML 和/或 JSON 数据交付给您 。就是这么简单!

结合由于数据来源是在线网站,需求评估之后,我发现了亮数据网络解锁器工具满足我的需要

  • 方便上手
  • 开箱即用
  • 返回 HTML 数据

来看看官方介绍

亮数据网络解锁器最适用于

  • 从任何网站抓取数据,不会被屏蔽
  • 模拟真实用户的网络行为,对使用复杂检测方法的网站也能进行抓取
  • 内部没有可扩展的解锁基础设施的团队
  • 只需为成功的请求付费

仅从上面的介绍中,我就可以看到它的使用场景满足了我的需求

当然除此之外,亮数据网络解锁器还有其他的一些优点如下:
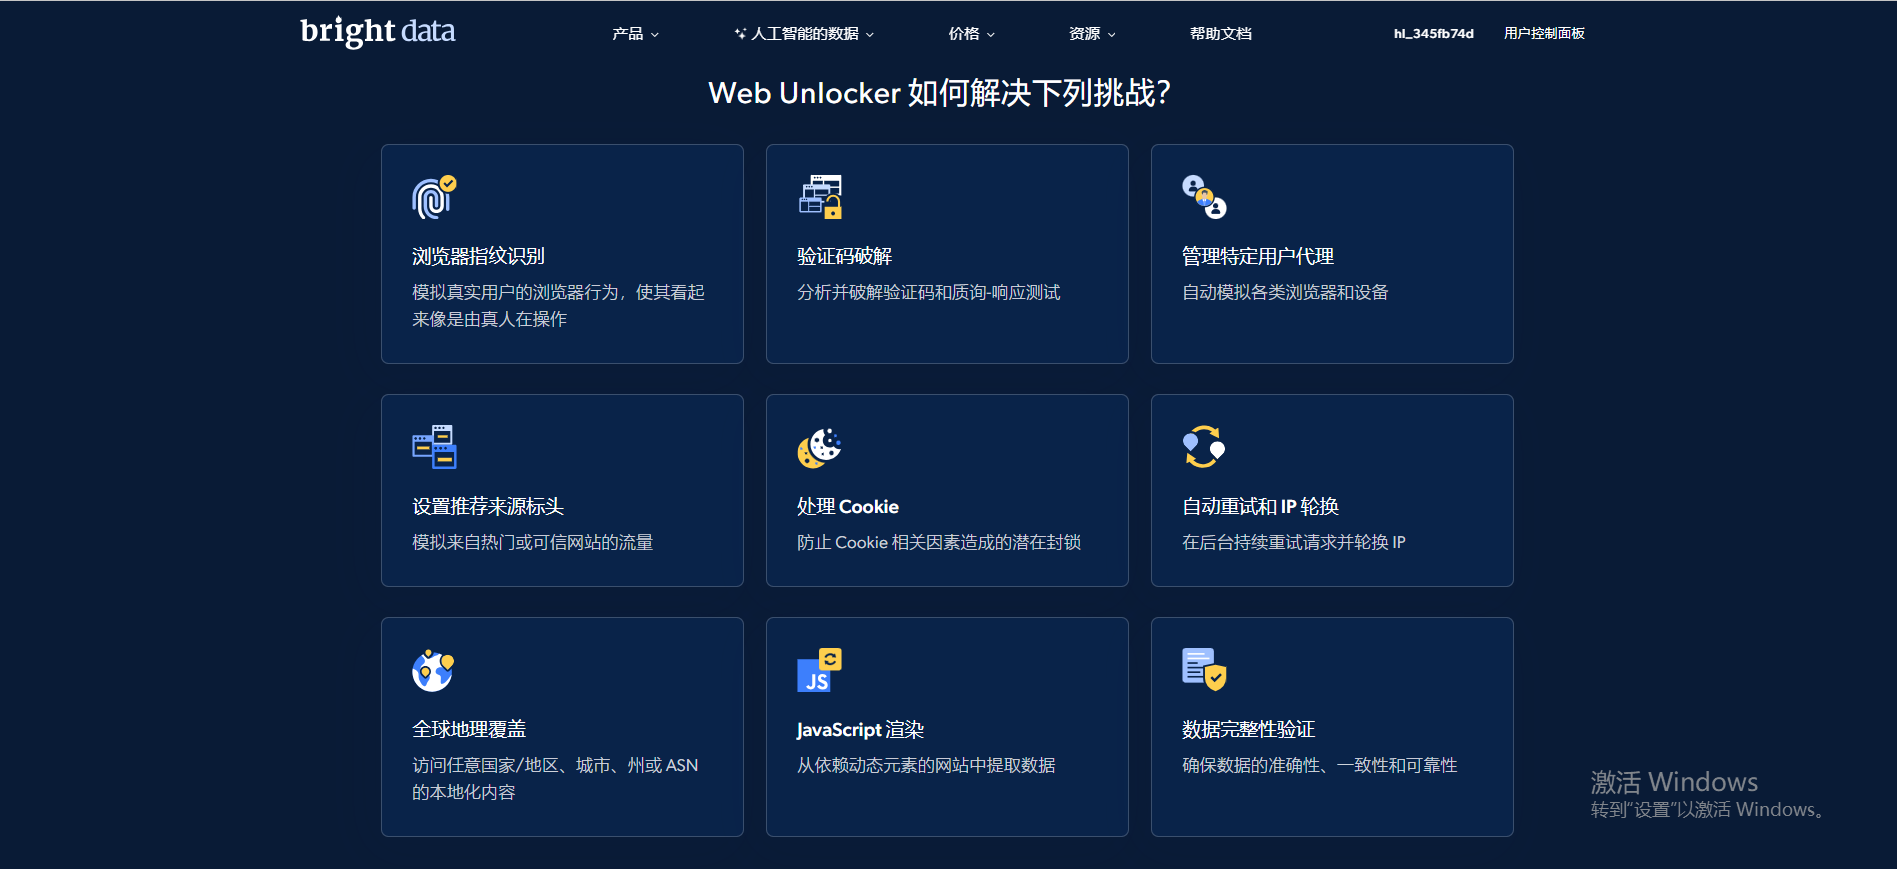
  • 浏览器指纹识别:模拟真实用户的浏览器行为,使其看起来像是由真人在操作
  • 处理 Cookie: 防止 Cookie 相关因素造成的潜在封锁
  • JavaScript 渲染:从依赖动态元素的网站中提取数据
  • 数据完整性验证: 确保数据的准确性、一致性和可靠性
  • 等

使用亮数据抓取工具

创建抓取任务

打开工作台,点击创建任务,选择网络解锁器,填写任务名称,选择目标网站,选择代理类型,点击创建任务
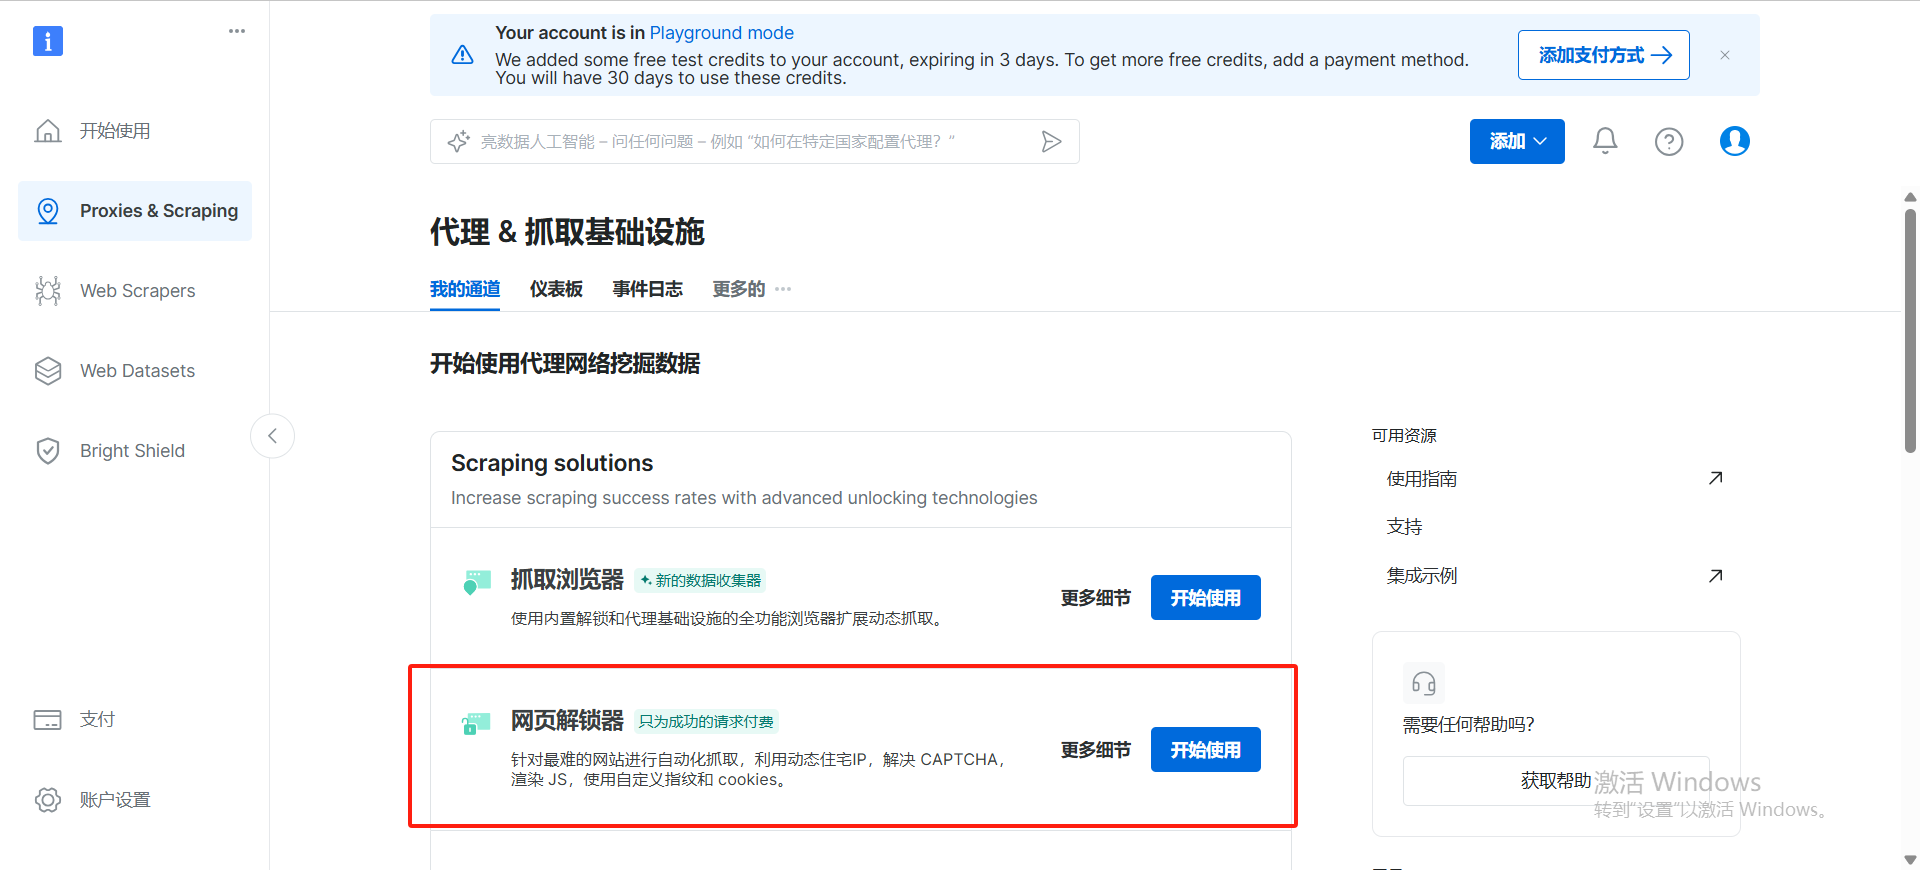
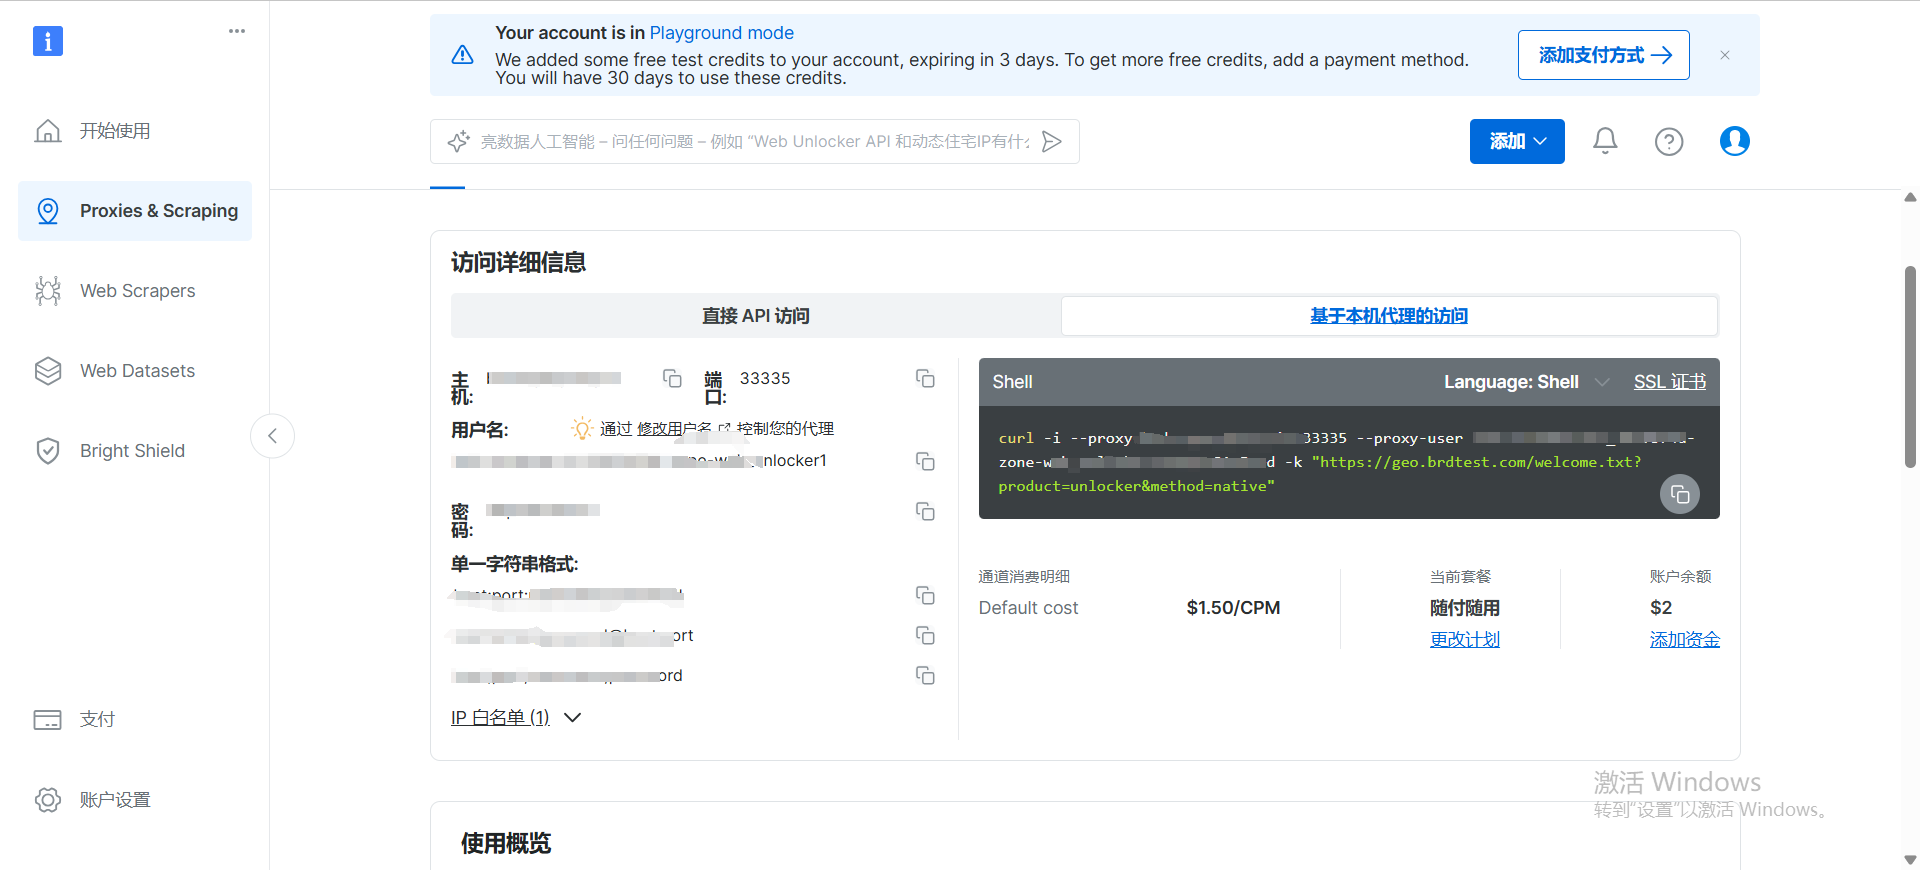
创建成功之后,我们就会得到一个 curl 请求,我们可以使用【直接 API 访问】或者 【基于本机代理的访问】curl 请求来获取数据如下:

# 直接API访问 示例

curl https://api.brightdata.com/request -H "Content-Type: application/json" -H "Authorization: Bearer [replace with API Key]" -d "{\"zone\": \"web_unlocker1\",\"url\": \"https://geo.brdtest.com/mygeo.json\", \"format\": \"raw\"}"

注意:
这里的 zone 是我们创建任务时选择的代理类型和类型

  • [replace with API Key] 是我们的 API Key (由亮数据提供)
  • zone 服务产品名称
  • url 是我们要抓取的目标网站
  • format 是我们要抓取的数据格式
    • raw 是原始数据
    • json 是 json 数据
    • html 是 html 数据
  • country 国家地区

但是这里我们可以不使用 curl 请求

由于我是使用 Nodejs 来抓取数据,所以找了一会文档

看到亮数据-API 文档

中提到可以使用js来执行请求,所以我就使用 js 来执行请求

使用curl API获取数据

我们可以使用 curl 请求来获取数据,也可以使用亮数据专用抓取浏览器工具来获取数据

但是数据量比较小,所以我直接使用 curl 请求在本机来获取数据

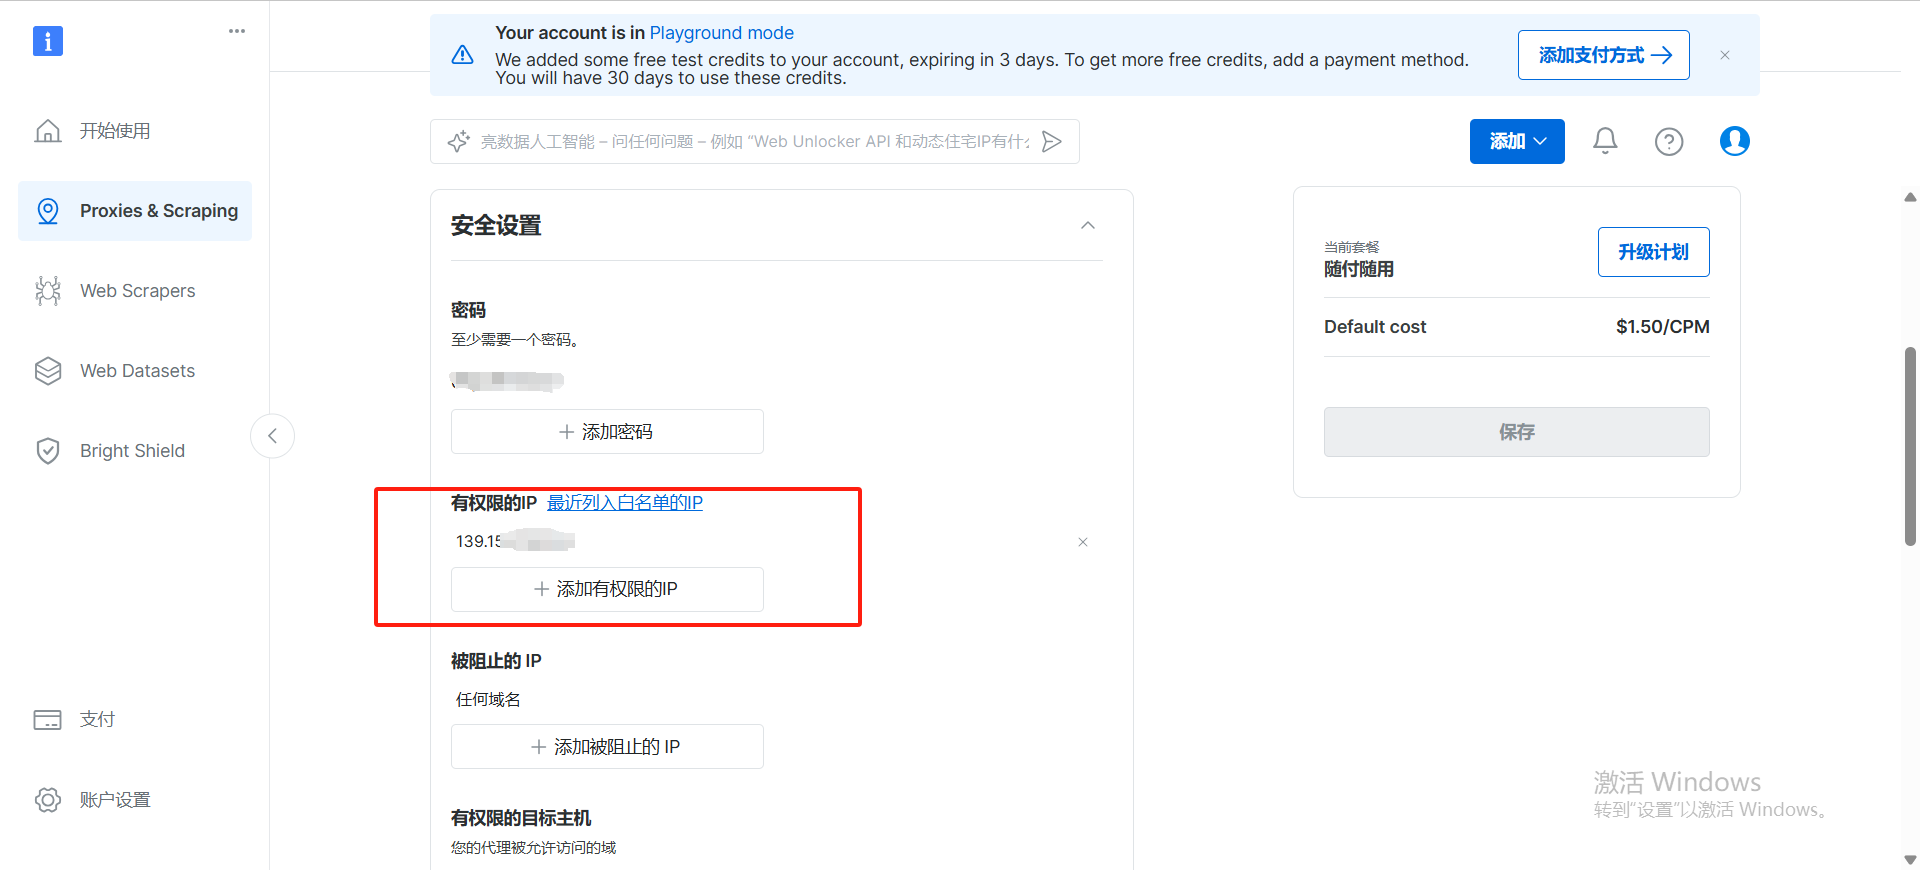
但是在此之前要配置 IP访问白名单

主要配置两项

  • 有权限的 IP
    • 就是你的服务器公网IP、或者宽度 IP
  • 有权限的目标主机(您的代理被允许访问的域)(即目标抓取网站的域名)
    • 这里配置测试网站域名 geo.brdtest.com
测试官方用例抓取数据

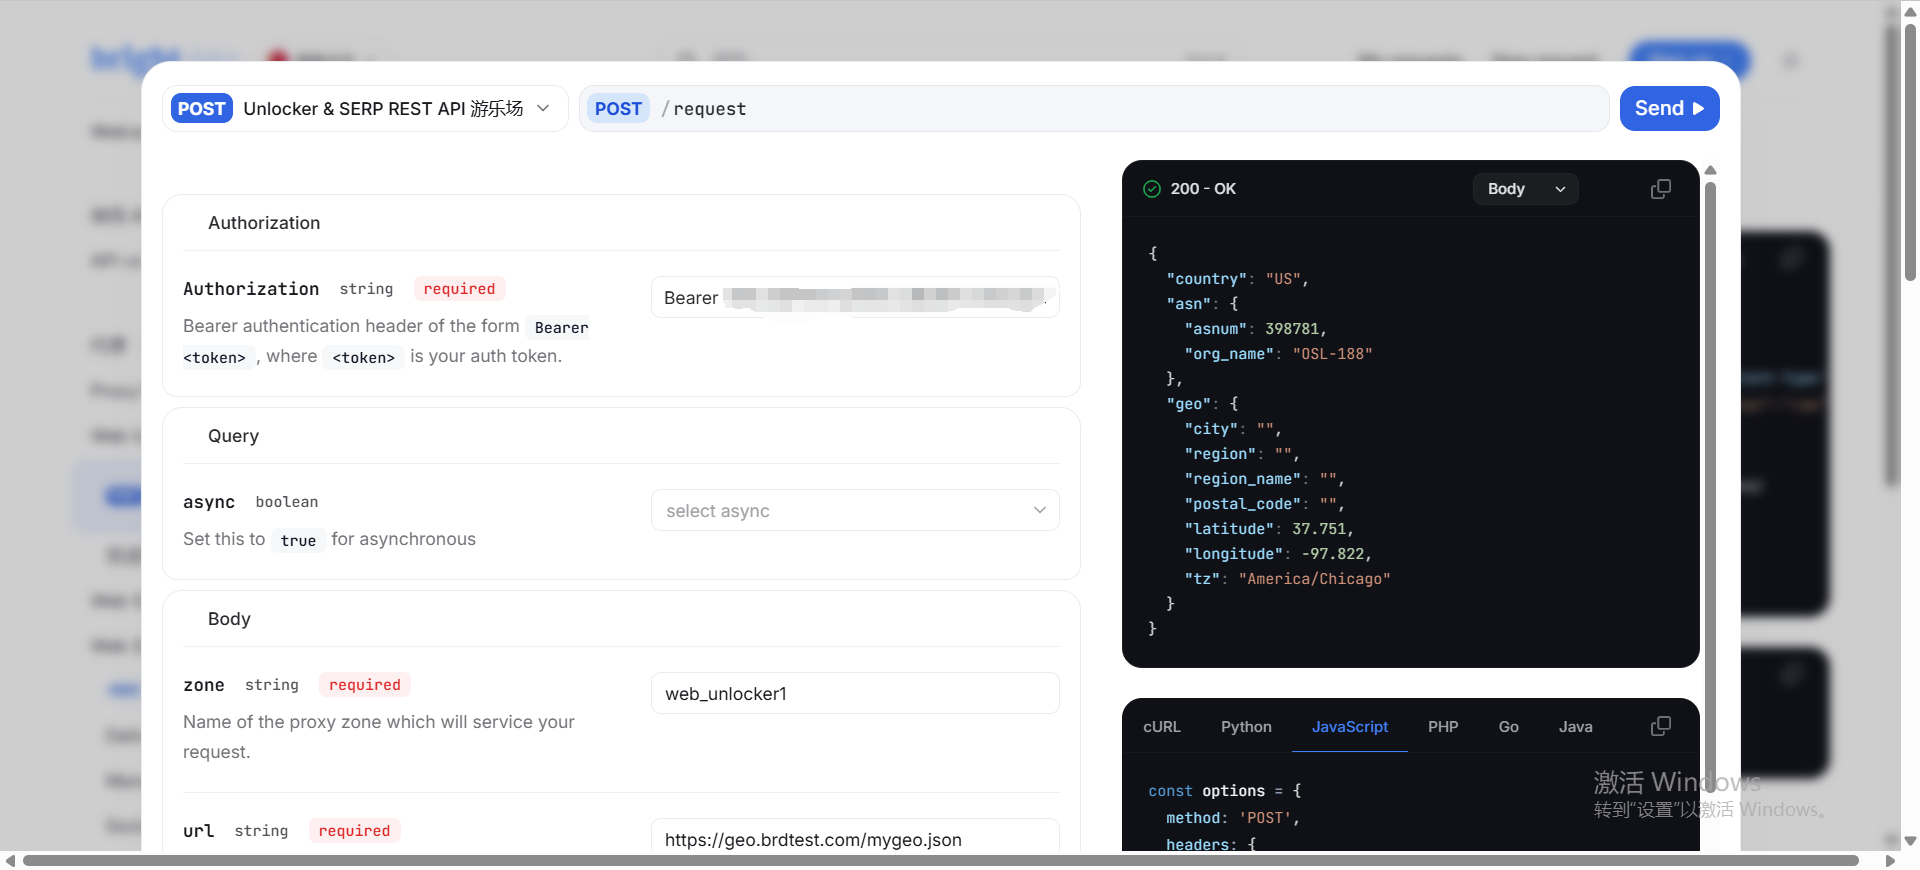
配置完成后,我到亮数据的在线接口实验场试用一下

playground 地址:Unlocker & SERP REST API 游乐场 - Bright Data Docs

返回结果如下:

{
  "country": "US",
  "asn": { "asnum": 398781, "org_name": "OSL-188" },
  "geo": {
    "city": "",
    "region": "",
    "region_name": "",
    "postal_code": "",
    "latitude": 37.751,
    "longitude": -97.822,
    "tz": "America/Chicago"
  }
}

数据爬取完美实现

地铁数据抓取实践

根据上面的测试案例,创建index.js

const axios = require("axios");

//#region ===== 请求函数封装
axios({
  url: "https://api.brightdata.com/request",
  timeout: 10000,
  method: "POST",
  headers: {
    Authorization: "Bearer [token]",
    "Content-Type": "application/json",
    "User-Agent":
      "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537.36",
  },
  data: {
    zone: "web_unlocker1",
    url: "https://[target domain].com/subway/index.html?&1100",
    format: "raw",
    method: "GET",
    // country: "<string>",
  },
})
  .then((response) => {
    const res = response.data;
    console.log(res);
  })
  .catch((err) => console.error(err));

注意:

  • [token] 是我们的 API Key (由亮数据提供)
  • url: "https://[target domain].com/subway/index.html?&1100", 是我们要抓取的目标网站
    • 这里?&1100参数表示 北京市地铁数据

然后CMD执行node index.js, 得到返回数据是html数据

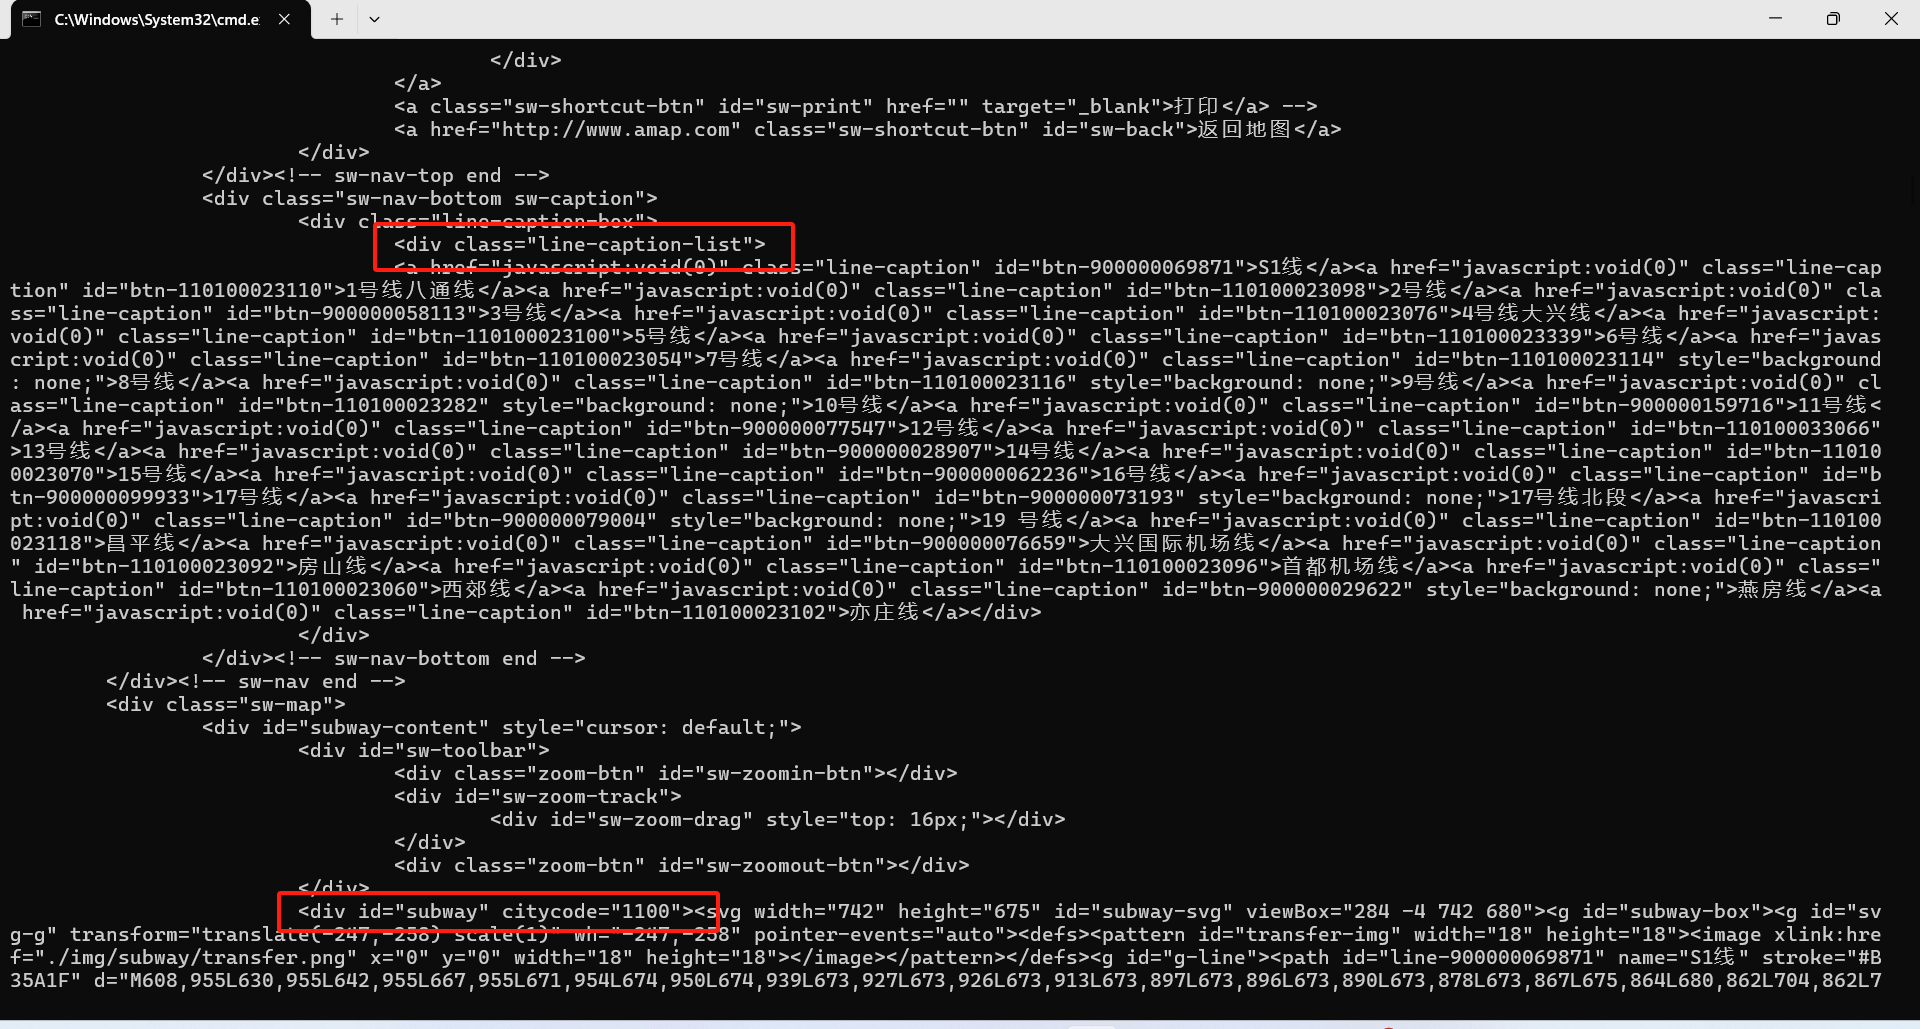
由于整个html数据过多,以下是数据中我们需要的部分

可以看到

html元素<div class="line-caption-list"> 下表示线路

html元素<div id="subway" citycode="1100"> 则依次展示了所有线路的站台数据

之后我们使用正则表达式提取对应数据得到

当这只是一个城市的数据提取,其他城市的数据提取即可更换参数,城市的对应地理代码即可

总结

  • 1.创建任务,选择网络解锁器,填写任务名称,选择目标网站,选择代理类型,点击创建任务
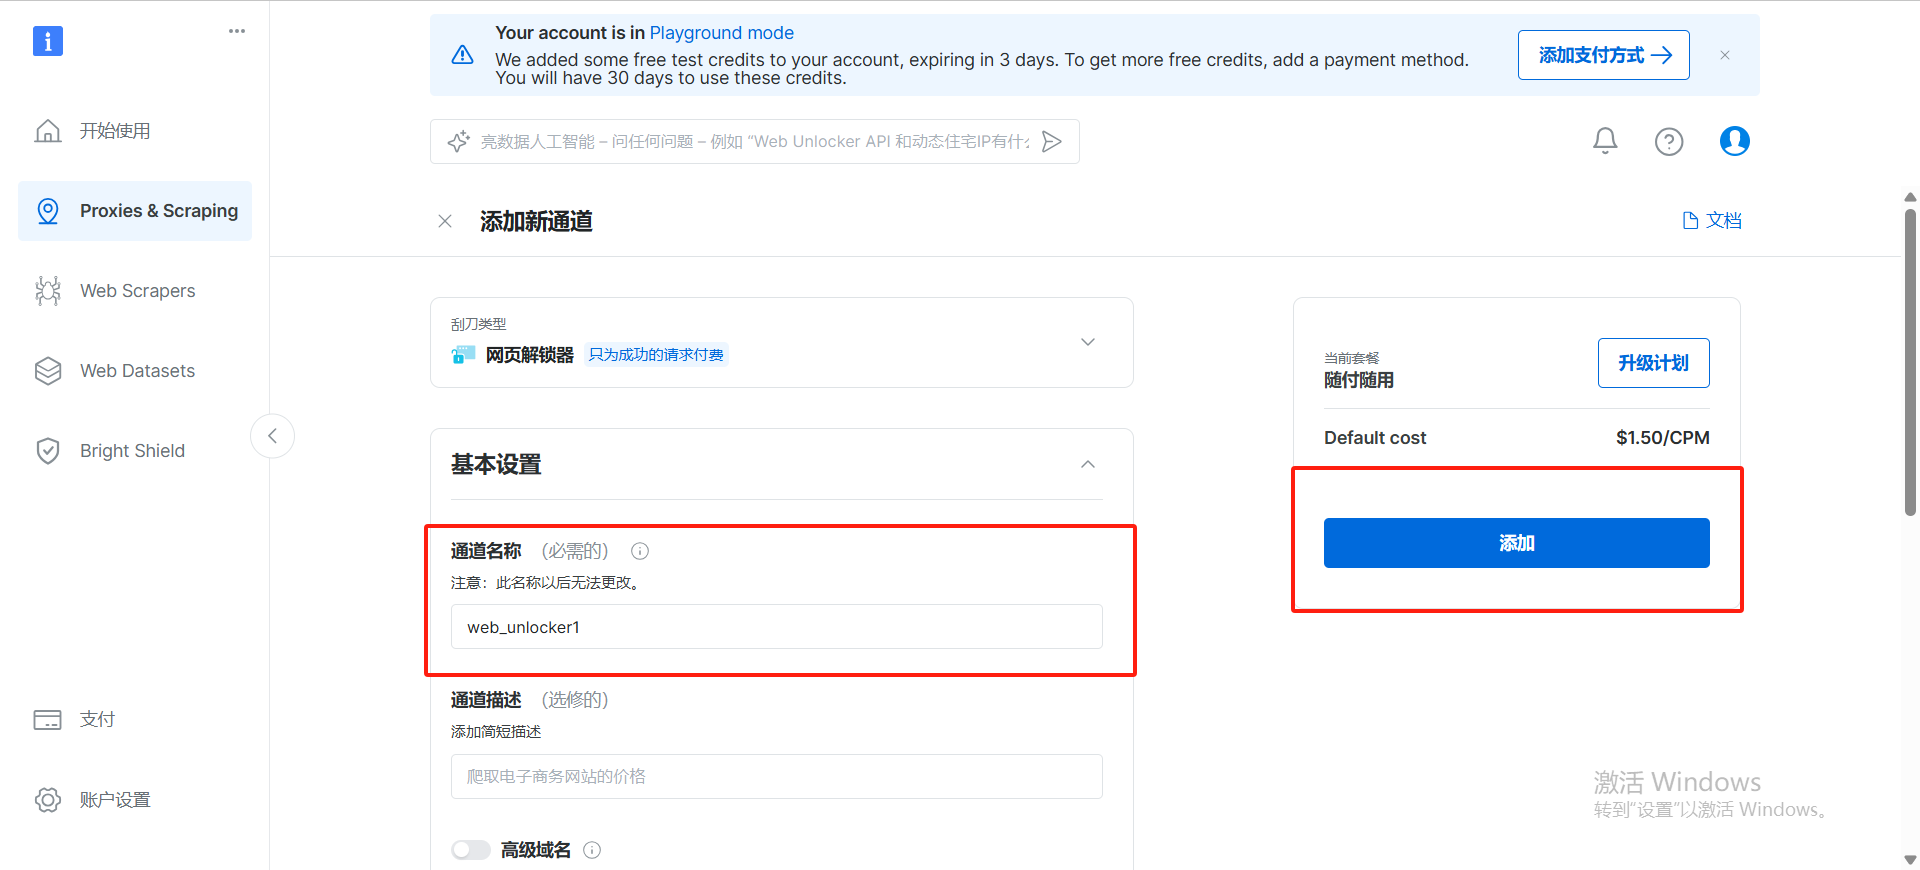
  • 2.只需要配置IP访问白名单和有权限的目标主机即可
  • 3.获取亮数据提供的代理API数据抓取接口, url 参数填入目标网站, 即可获取数据;根据需求设置 format 数据返回格式
  • 3.使用亮数据工具抓取数据,不需要学习使用成本,只需要使用亮数据专用抓取浏览器工具或者js来执行请求即可

总的来说亮数据(Bright Data)的工具是一个非常好的工具,解决了我们抓取数据的各种问题,
针对上面的数据规范抓取,IP 封锁的问题,亮数据的工具都有相应的解决方案
甚至有现成的成熟方案以及在线预收集数据集

现在注册,即可获取免费使用福利
注册专属链接:亮数据-网络IP代理及全网数据一站式服务商

如何用Python自动爬取全国30+城市地铁图数据? 首先分析全国各个城市地铁图的数据来源,无非就是百度或者高德,这次选择用高德作为数据来源。分析得知,xhr请求的接口数据便是我们需要的一部分数据(包含线路名称、线路名称坐标、线路轨迹、站点名称、站点定位坐标等),另一部分数据则是直接在Dom节点中(包含站点名称坐标),所以我们要爬取的数据便是。编码的过程中,遇到这样一个问题,有些城市的菜单在页面的『更多』里面,加载完页面后是隐藏的,python打开浏览器模拟点击的时候,会报一个找不到该元素的错误,经过google一番,总结了两个解决方案,亲测可用。 阅读详情

相关推荐

利用 Python 爬虫抓取各城市地铁线路站点信息

本文详细介绍了如何使用 Python 爬虫技术抓取各城市地铁线路和站点信息。我们通过 requests、BeautifulSoup、Selenium 等工具抓取地铁数据,并通过 pandas 进行数据清洗、存储和分析。最后,我们还展示了如何通过可视化技术帮助理解地铁站点的分布情况。

2201_76125261的博客 627

使用亮数据爬虫工具解锁复杂爬虫场景

在当今数据驱动型时代,数据采集和分析能力算是个人和企业的核心竞争力。然而,手动采集数据耗时费力且效率低下,而且容易被网站封禁。我之前使用过一个爬虫工具,亮数据(Bright Data) ,是一款低代码爬虫平台,既有现成的爬虫解锁框架,还提供IP代理服务。亮数据基于全球代理IP网络和强大数据采集技术的解决方案,可帮助轻松采集各种网页数据,如产品信息、价格信息、评论信息、社交媒体数据等。

分享Python、数据分析、人工智能前沿知识 1826

Python爬虫:抓取交通工具班次数据(公交、地铁等时刻表)

然而,由于这些信息并不总是以开放的API形式提供,因此爬虫技术成为了获取和分析这些数据的有效途径。然而,由于很多公交公司没有公开API,通常我们通过抓取其网页中的时刻表数据来获取信息。通过这些步骤,您可以轻松抓取交通工具的班次信息,并进行进一步的数据分析,辅助交通规划和出行推荐系统的建设。在这篇文章中,我们将演示如何使用Python爬虫技术抓取公交、地铁等交通工具的班次和时刻表数据。我们可以将公交和地铁的数据合并,进行综合分析。我们可以进一步分析地铁班次的发车频率,甚至可以比较不同地铁线路的班次。

2201_76125261的博客 954

亮数据,可视化数据采集强大利器

上述操作我们演示了正向获取数据的步骤,但是随着互联网的发展,各大网站都研究了反爬技术,阻止我们的爬数据机器人去获取他们的数据。这里给大家举个例子:假定每页数据100条,我们在2秒之内爬取完,数据总共有1600页,那么我们需要1600 * 2 = 3200秒时间完成这个工作。但这种假设只是理想状态,我们在常用的接口中都做了限流,同一个IP在长达1小时内,以固定的2秒钟频率访问1600次,可以判定此行为是机器人操作,从而跳出验证信息,需要人工操作解锁当前操作(这样的话,自动化程序就进行不下去了)。

陈橘又青的博客 1万+

从零组装一台会‘看’的无人机:手把手教你配置NUC机载电脑与D435深度相机(环境搭建篇)

本文详细介绍了如何从零开始组装一台具备视觉能力的智能无人机,重点讲解了NUC机载电脑与D435深度相机的配置方法。通过Ubuntu系统安装、ROS环境搭建、深度学习框架配置等步骤,帮助开发者实现无人机的自主避障和目标跟踪功能。文章还提供了性能优化和常见问题解决方案,是无人机视觉系统开发的实用指南。

weixin_30915275的博客 397

别再为域名备案发愁了!微信小程序后端调用,试试这个‘官方捷径’——云托管

本文介绍了微信小程序后端部署的新思路——利用微信云托管服务绕过域名备案难题。通过详细的环境准备、数据库配置、服务部署和小程序端调用方案,帮助开发者快速实现小程序与后端服务的无缝对接,大幅缩短上线周期并降低运维成本。

weixin_29243279的博客 674

亮数据爬取API爬取亚马逊电商平台实战教程

亮数据爬取API爬取亚马逊电商平台实战教程

乐于分享,共同成长 2369

HTML入门(详细教程),前端入门从这里开始

HTML基础教程,网页框架搭建,表单制作,了解HTML标签的基本用法,每个标签具备哪些属性。

wandertp的博客 1283

全国地铁数据爬取-python

介绍爬取全国地铁站点、地铁线路和发车时刻的方法。一、两种爬取方法概述 (一)html页面爬取   1、 为了收集全国地铁线路的发车时刻信息,刚开始尝试的方法如下:    (1)找到每个城市的地铁官网,如“广州地铁官方网站”    (2)在官网找到首尾班车时刻表,广州的发车时刻数据在http://cs.gzmtr.com/ckfw/fwsj/    (3)使用python爬取网页的表格数据  2、实...

jiang_qun的博客 1万+

数字电路实验避坑指南:如何正确搭建主从JK触发器测试电路(附Proteus仿真)

本文详细解析了主从JK触发器的工作原理及实验搭建指南,重点解决了常见的Catching Problem现象,并提供了Proteus仿真优化方案。通过元器件选型、电路连接步骤和常见错误排查,帮助读者正确搭建测试电路,确保数字电路实验的稳定性和可靠性。

weixin_30790841的博客 469

通信算法之264: DJI O2 协议物理层逆向工程解析

对于 DroneID,标志之间的间隙由循环前缀 (CP) 填充:每个标志末尾的副本附加在相应标志的开头。有了关于确切标志开始的信息,可以使用 FFT 将标志转移到频域 - 来自时域的 1024 个样本导致频域中的 1024 个子载波。使用比特流的解扰和涡轮解码,并将生成的数据映射到如上的DroneID 结构,通过逆向工程在无人机的固件中找到了它。注意到一些无人机(Mavic 2 和更早的 OcuSync 无人机)不发送第一个标志(标志 1),这导致更短的帧持续时间为 576 µs。//产品型号数字代号。

leegang12的专栏 3942

从零到一:如何使用亮数据代理快速收集训练数据打造自己的AIGC大模型

近年来,AIGC大模型火得一塌糊涂,大学的专业正好是人工智能专业,赶紧上车抓住风口,做一个电商AI识别大模型项目。项目使用PyTorch搭建卷积神经网络模型、训练模型和使用模型进行图像识别,使用Java+Selenium+ChromeDriver+Jsoup爬取数据集,并在爬取数据时做好分类。由于我们所需要的数据集非常多,所以还需要使用亮数据动态IP代理,解决单位时间内频繁访问来源网站、下载商品图片的问题。亮数据代理快速的收集训练数据集数据,打造自己的AIGC大模型。

Javascript_tsj的博客 7223

行业变革下的功能安全落地痛点3:高阶智驾安全责任转移 —— 从 “人为中心” 到 “机器主责” 的产业阵痛

文章围绕高阶智驾(L3 级)落地挑战,探讨安全责任从 “人控” 向 “机控” 转移的本质、技术短板导致的责任模糊、全球法规实践及技术 - 法规 - 保险的破局路径。

my9111526 126

爬虫实战:我国城市的地铁数据以及分析

本项目通过编写Python爬虫,自动化地从高德地图API获取数据,然后利用Pandas进行数据清洗和整理,最终通过Matplotlib和Seaborn进行数据的可视化分析,旨在揭示城市地铁网络的基本特征和潜在价值。从技术细节到实际应用,本文旨在提供一个实战示例,展示如何利用编程技能解锁城市地铁数据的潜力,为进一步的城市规划和交通管理研究提供数据支持。数据清洗后,我们可以开始对数据进行分析,以探索各城市地铁站的分布、地铁线路的数量等信息。首先,需要对爬取的数据进行清洗,确保数据的质量和可用性。

蓝色是天的博客 4335

Hermes接入IMA知识库全攻略:将知识库装进你的Hermes智能体

本文详细介绍了如何将IMA知识库功能接入Hermes Agent平台,实现一站式笔记管理和知识库操作。主要内容包括:获取IMA访问凭证、下载技能包、配置凭据(支持文件和环境变量两种方式)、验证配置有效性,以及实际应用演示(查询知识库列表、创建笔记并添加到知识库)。文章还提供了常见问题解决方案,如认证失败处理、版本更新等。通过该集成,用户可在Hermes中直接调用IMA的笔记创建、知识库管理等强大功能,提升工作效率。

小石头的专栏 641

【2025国赛C题】高教社杯全国大学生数学建模竞赛C题思路+代码+论文

【2025国赛C题】高教社杯全国大学生数学建模竞赛C题思路+代码+论文

订阅付费专栏Matlab(奶茶价版),可赠送奶茶价版付费专栏指定代码1份; 2902

获取各城市地铁站点及位置坐标-Python

快速使用python获取城市地铁站点及坐标

weixin_46357639的博客 1967

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

中国城市地铁站命名数据分析

随着城市化进程的加速,地铁作为现代城市的重要交通工具,其站点命名不仅反映了城市的地理和文化特征,还承载了历史记忆和社会变迁。本研究基于高德地图提供的全国5805个地铁站数据,通过详尽的数据分析,揭示了中国地铁站命名背后的规律与特点。

qsqx_H的博客 1920

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

Python 爬虫:抓取城市公共交通数据(公交、地铁等)

了解实时公交、地铁信息,不仅能帮助市民规划出行,还能为交通部门提供优化线路、调整车次等数据支持。本文将带您逐步学习如何通过 Python 爬虫抓取城市公共交通数据,并进行分析和可视化。我们可以将抓取的公交、地铁信息存入 SQLite 数据库,并进行进一步的数据分析。数据存储之前,我们需要清洗一下数据,例如去除无效数据、转换数据格式等。为了确保数据的实时性,我们可以设置定时任务,定期抓取公共交通数据。如果公交信息分布在多个页面,我们可以通过分页抓取所有数据。我们将使用类似的流程来抓取地铁信息。

2201_76125261的博客 1258

如何从高德获取地铁数据

概述 本文讲讲如何在高德获取地铁数据及后期处理,以北京为例。 实现 获取数据 打开高德地铁,按下F12打开调试模式,切换到network面板,如下: 点击右键,“Open in new tab”,在新窗口中打开。 将页面另存为json数据格式。 数据处理 将拿到的数据写代码转换成两个geojson数据,一个是站点数据,一个线路数据。 站点数据处理 $.get('data/subway.json', function (res) { var geojson = { 'type

LZUGIS 8695

利用Python自动爬取全国30+城市地铁图数据

数据来源首先分析全国各个城市地铁图的数据来源,无非就是百度或者高德,这次选择用高德作为数据来源。基本环境配置版本:Python3系统:Windows相关模块:安装请求库pip install requests安装DOM解析库pip install lxm安装自动化测试工具,需要浏览器来配合pip install selenium主要爬虫思路:1、获取数据从DOM节点获取所有地铁城市2、解释数据:页...

weixin_33853794的博客 964

python制作一线城市地铁运行动态图!赶地铁不怕做错车了!

前几天写了一篇制作公交线路图的文章,有朋友问我能不能做一下地铁的线路图,其实道理差不多,今天再带着大家做一下一线城市的地铁线路图 首先准备数据,以北京市为例,在高德地图地铁页面进行抓包,抓包地址为: http://map.amap.com/subway/index.html?&1100 北京市地铁信息接口为: http://map.amap.com/service/subway?_1599997789354=&srhdata=1100_drw_beijing.json 对j

pythonlaodi的博客 1238

Python爬虫练习:爬取高德地图地铁线路及站点数据

前言 本文的文字及图片来源于网络,仅供学习、交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理。 作者:Darcy频道 # coding=utf-8 import requests import time import json import ast import os import utils from lxml import etree PAGE_URL = 'http://map.amap.com/subway/index.html?&1100.

Python案例分享,B站视频教程:https://space.bilibili.com/523606542 4311

【免费下载】 基于Python的地铁数据可视化分析

基于Python的地铁数据可视化分析 【下载地址】基于Python的地铁数据可视化分析 - **目标**:构建一整套流程,从网络爬虫的编写到数据的可视化,全面解析中国主要城市的地铁布局。- **技术栈**:Python(含requests, BeautifulSoup, pandas, matplotlib, wordc...

gitblog_09746的博客 981

用Python爬虫对城市公交、地铁站点和线路数据采集

市公交、地铁数据反映了城市的公共交通,研究该数据可以挖掘城市的交通结构、路网规划、公交选址等。但是,这类数据往往掌握在特定部门中,很难获取。互联网地图上有大量的信息,包含公交、地铁等数据,解析其数据反馈方式,可以通过Python爬虫采集。闲言少叙,接下来将详细介绍如何使用Python爬虫爬取城市公交、地铁站点和数据。 首先,爬取研究城市的所有公交和地铁线路名称,即XX路,地铁X号线。可以通过图吧...

python学习者的博客 4389
上一篇: 【2024丨CSIG青年科学家会议 AI可信论坛】视觉内容安全技术的前沿进展与应用
下一篇: 提升搜索效率:深入了解Amazon Kendra的强大功能
热爱编程的小白白
热爱编程的小白白 新星计划导师 新星计划导师
博客等级 码龄5年 11万+粉丝 243原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

热爱编程的小白白

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值