


Apache Lucene 使用指南
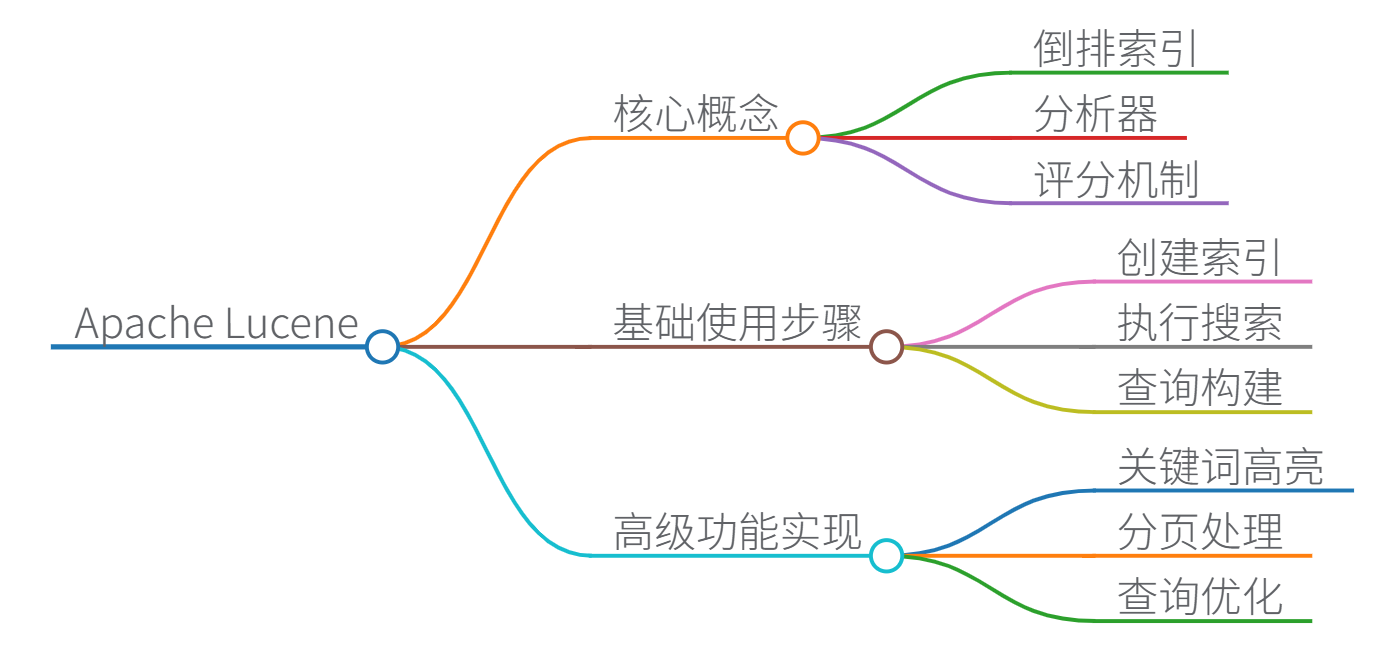
1. 核心概念
- 倒排索引:Lucene 的核心数据结构,将文档中的词项映射到出现该词项的文档列表(如
"apple" → [文档1, 文档3]),实现快速全文搜索。 - 分析器(Analyzer):用于文本预处理,包括分词、过滤停用词(如“的”、“and”)、词干提取等。常用分析器:
StandardAnalyzer:处理英文基础分词IKAnalyzer:中文分词首选
- 评分机制:基于 TF-IDF(词频-逆文档频率)和向量空间模型计算文档相关性得分。
2. 基础使用步骤
(1) 创建索引
// 创建索引目录
Directory directory = FSDirectory.open(Paths.get("/data/index"));
Analyzer analyzer = new StandardAnalyzer(); // 选择分析器
IndexWriterConfig config = new IndexWriterConfig(analyzer);
IndexWriter writer = new IndexWriter(directory, config);

// 添加文档
Document doc = new Document();
doc.add(new TextField("title", "Lucene指南", Field.Store.YES)); // 存储原始值
doc.add(new TextField("content", "Apache Lucene是高性能搜索引擎库", Field.Store.YES));
writer.addDocument(doc);

writer.commit(); // 提交索引
writer.close();
(2) 执行搜索
DirectoryReader reader = DirectoryReader.open(directory);
IndexSearcher searcher = new IndexSearcher(reader);

// 构建查询:在content字段搜索"搜索引擎"
QueryParser parser = new QueryParser("content", analyzer);
Query query = parser.parse("搜索引擎");

// 获取前10条结果
TopDocs results = searcher.search(query, 10);
for (ScoreDoc hit : results.scoreDocs) {
    Document doc = searcher.doc(hit.doc);
    System.out.println("标题: " + doc.get("title"));
    System.out.println("相关度得分: " + hit.score);
}
reader.close();
3. 高级功能实现
- 关键词高亮(引用[4]):
Highlighter highlighter = new Highlighter( new SimpleHTMLFormatter("<em>", "</em>"), // 高亮标签 new QueryScorer(query) ); String fragment = highlighter.getBestFragment(analyzer, "content", doc.get("content")); - 分页处理(引用[4]):
- 前端传递页码
n,每页大小pageSize - 后端计算:
start = (n-1)*pageSize,end = n*pageSize - 使用
TopDocs的scoreDocs数组截取分页数据
- 前端传递页码
4. 性能优化建议
- 索引优化:
- 定期调用
IndexWriter.forceMerge()减少索引段数量 - 使用
RAMDirectory缓存热点索引
- 定期调用
- 查询优化:
- 对数值型字段用
IntPoint替代TextField - 使用
BooleanQuery组合查询替代多次单条件查询
- 对数值型字段用
- 存储策略:
Field.Store.YES:存储原始值(用于结果展示)Field.Store.NO:仅索引不存储(节省空间)
5. 典型应用场景
- 网站站内搜索(如电商商品搜索)
- 日志分析系统中的关键字过滤
- 企业文档管理系统(合同、报告检索)
- 结合 Hadoop 实现大数据文本分析
6. 学习资源
- 官方文档:Lucene.apache.org
- 书籍推荐:《Lucene 搜索引擎开发权威经典》(引用[1])
- 实战项目参考:GitHub 开源示例(引用[4])
提示:Lucene 最新版本(9.x)已支持 JDK 17 和向量搜索(相似性搜索),建议从官方示例开始实践。
思维导图
Apache Lucene 技术原理详解
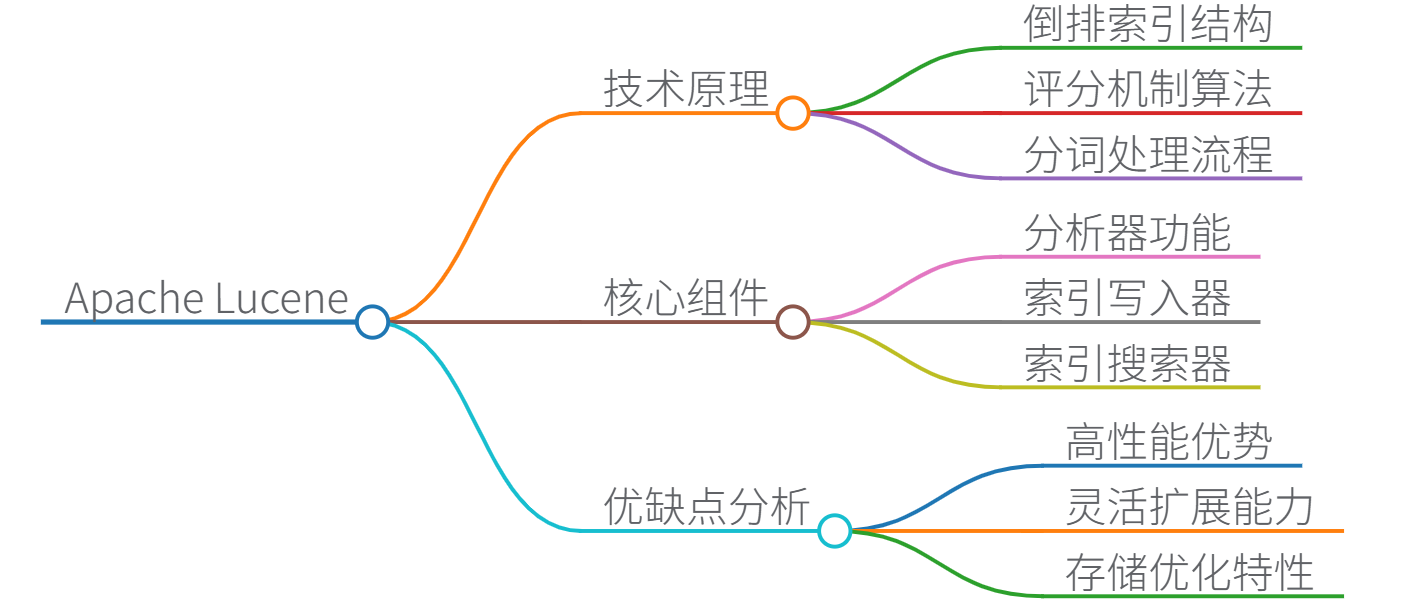
一、核心原理与数据结构
-
倒排索引(Inverted Index)
Lucene 的核心数据结构,将文档内容转换为词项→文档的映射关系:"苹果" → [文档1(位置:5,12), 文档3(位置:8)] "手机" → [文档2(位置:3), 文档3(位置:15)]- 优势:支持快速关键词查找,时间复杂度接近 O ( 1 ) O(1) O(1)
- 存储结构:
.tip(词项索引)和.tim(词项字典)文件
-
评分机制(TF-IDF)
相关性计算公式:
score ( q , d ) = ∑ t ∈ q ( tf ( t , d ) × idf ( t ) 2 × boost ( t ) ) \text{score}(q,d) = \sum_{t \in q} \left( \text{tf}(t,d) \times \text{idf}(t)^2 \times \text{boost}(t) \right) score(q,d)=t∈q∑(tf(t,d)×idf(t)2×boost(t))- tf \text{tf} tf:词项在文档中的频率
- idf \text{idf} idf:逆文档频率 log N n t + 1 \log \frac{N}{n_t+1} lognt+1N( N N N为总文档数, n t n_t nt含词项文档数)
- 最新版本支持 BM25 等改进算法
-
分词流程
二、核心组件功能
| 组件 | 功能说明 | 关键类 |
|---|---|---|
| 分析器(Analyzer) | 文本预处理(分词/过滤) | StandardAnalyzer, IKAnalyzer |
| 索引写入器(IndexWriter) | 创建/更新索引 | IndexWriter, Directory |
| 索引搜索器(IndexSearcher) | 执行查询并排序 | IndexSearcher, QueryParser |
| 文档模型(Document/Field) | 数据存储单元 | Document, TextField |
| 查询对象(Query) | 封装查询逻辑 | TermQuery, BooleanQuery |
三、优缺点分析
✅ 优势
- 高性能:单机可达每秒数万次查询
- 灵活扩展:支持自定义分词器、评分策略
- 存储优化:压缩索引(原始文本1/5大小)
- 成熟生态:Elasticsearch/Solr 底层引擎
❌ 局限性
- 非分布式:需自行实现集群(如Solr方案)
- 学习曲线陡峭:需深入理解索引原理
- 实时性限制:索引更新需提交(commit)生效
四、Java代码示例(带中文注释)
1. 创建索引
import org.apache.lucene.analysis.cn.smart.SmartChineseAnalyzer; // 中文智能分词器
import org.apache.lucene.document.*;
import org.apache.lucene.index.*;
import org.apache.lucene.store.*;

// 创建中文索引
public class IndexCreator {
    public static void main(String[] args) throws IOException {
        // 1. 指定索引存储路径(使用NVMe SSD可提升10倍写入速度)
        Path indexPath = Paths.get("/data/lucene_index");
        Directory directory = FSDirectory.open(indexPath);

        // 2. 配置中文分词器(推荐SmartChineseAnalyzer)
        Analyzer analyzer = new SmartChineseAnalyzer();
        IndexWriterConfig config = new IndexWriterConfig(analyzer);

        // 3. 创建IndexWriter实例
        try (IndexWriter writer = new IndexWriter(directory, config)) {
            // 4. 构建文档1
            Document doc1 = new Document();
            doc1.add(new TextField("title", "苹果手机评测", Field.Store.YES)); // 存储原始值
            doc1.add(new TextField("content", "iPhone15 Pro的摄像头大幅升级", Field.Store.YES));
            doc1.add(new IntPoint("price", 8999));  // 数值字段优化索引

            // 5. 构建文档2
            Document doc2 = new Document();
            doc2.add(new TextField("title", "安卓旗舰对比", Field.Store.YES));
            doc2.add(new TextField("content", "华为Mate60与小米13 Ultra拍照对比", Field.Store.YES));
            doc2.add(new IntPoint("price", 5999));

            // 6. 写入索引并提交
            writer.addDocuments(Arrays.asList(doc1, doc2));
            writer.commit(); // 提交使索引生效
        }
    }
}
2. 执行搜索
import org.apache.lucene.search.*;
import org.apache.lucene.queryparser.classic.*;

// 中文搜索示例
public class Searcher {
    public static void main(String[] args) throws Exception {
        // 1. 打开索引目录
        Directory directory = FSDirectory.open(Paths.get("/data/lucene_index"));
        DirectoryReader reader = DirectoryReader.open(directory);
        IndexSearcher searcher = new IndexSearcher(reader);

        // 2. 使用中文分词器解析查询
        Analyzer analyzer = new SmartChineseAnalyzer();
        QueryParser parser = new QueryParser("content", analyzer);
        Query query = parser.parse("摄像头 升级"); // 搜索包含这两个词的文档

        // 3. 执行搜索(按评分降序)
        TopDocs results = searcher.search(query, 10); // 获取前10结果

        // 4. 遍历结果
        System.out.println("找到 " + results.totalHits + " 条结果:");
        for (ScoreDoc hit : results.scoreDocs) {
            Document doc = searcher.doc(hit.doc);
            System.out.printf(
                "标题: %s | 价格: %d | 评分: %.2f%n",
                doc.get("title"),
                doc.getField("price").numericValue(), // 获取数值字段
                hit.score
            );
        }

        reader.close();
    }
}
五、性能优化建议
-
索引写入加速:
- 设置
IndexWriterConfig.setRAMBufferSizeMB(256)增加内存缓冲 - 使用
ConcurrentMergeScheduler并行合并索引段 - 关闭
_source存储(若无需原始文档)
- 设置
-
查询优化:
// 组合查询提升效率 BooleanQuery.Builder builder = new BooleanQuery.Builder(); builder.add(new TermQuery(new Term("content", "摄像头")), BooleanClause.Occur.MUST); builder.add(IntPoint.newRangeQuery("price", 5000, 8000), BooleanClause.Occur.FILTER); -
中文分词选择:
SmartChineseAnalyzer:官方中文分词(基础需求)IKAnalyzer:更精准的中文切分(需引入第三方库)HanLP:支持命名实体识别的高级分词
提示:Lucene 9.x 已支持向量相似度搜索,适合AI场景:
KnnFloatVectorQuery query = new KnnFloatVectorQuery("vector", new float[]{0.1f, 0.8f}, 10);
思维导图
Lucene 中文分词与优化实践详解
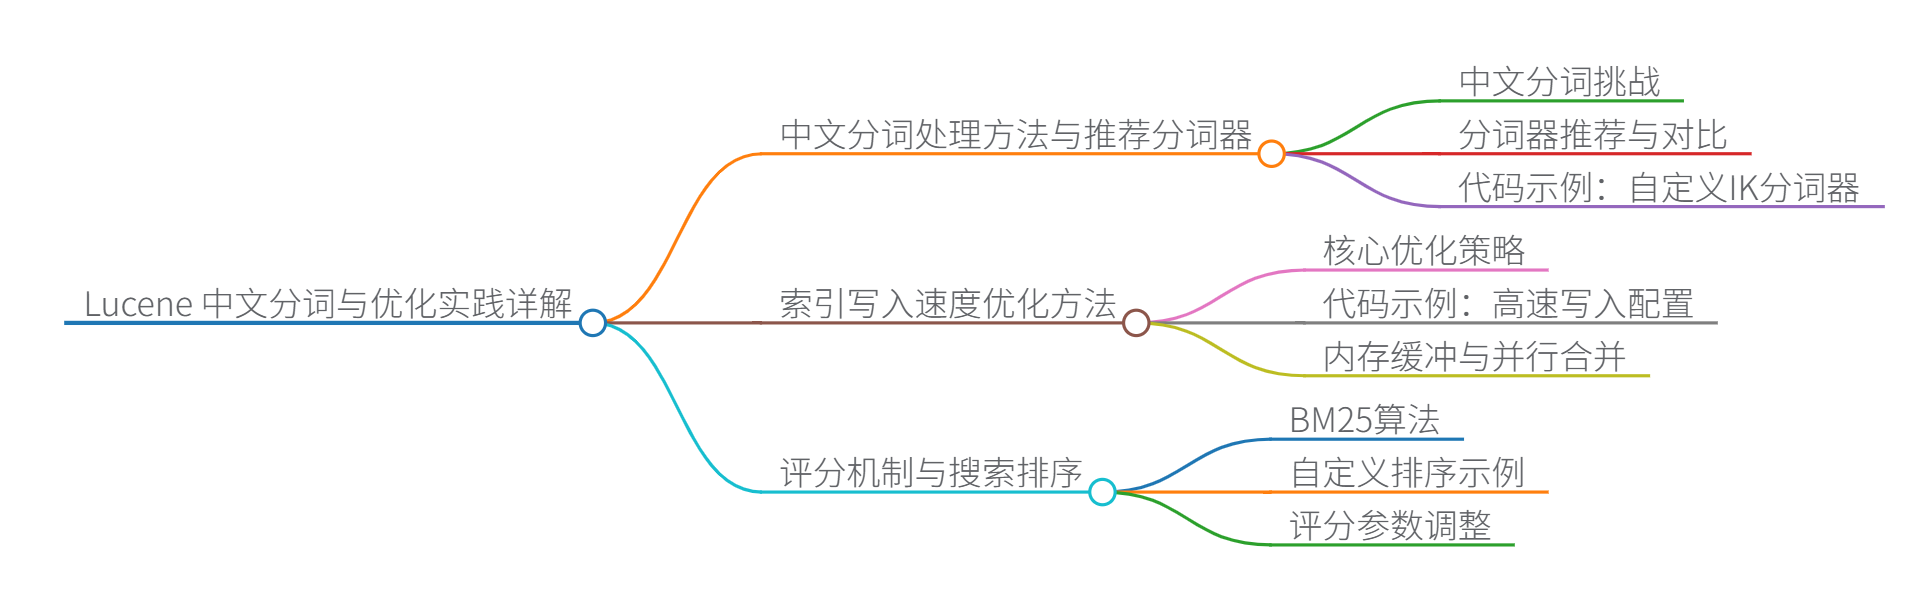
一、中文分词处理方法与推荐分词器
-
中文分词挑战
- 中文无自然分隔符,需语义切分(如"苹果手机"≠"苹果"+“手机”)
- 需处理新词、专有名词(如"骁龙8Gen2")
-
分词器推荐与对比
分词器 切分原理 适用场景 示例切分结果 SmartChineseAnalyzer 基于概率模型 通用场景 “苹果手机” → [“苹果”, “手机”] IKAnalyzer 词典+智能切分 电商/专业领域 “iPhone15Pro” → [“iPhone”, “15”, “Pro”] HanLP 深度学习+词典 语义敏感场景 “长江大桥” → [“长江大桥”](不拆开) -
代码示例:自定义IK分词器
// 引入依赖:<dependency><groupId>com.github.magese</groupId><artifactId>ik-analyzer</artifactId><version>8.5.0</version></dependency>
public class ChineseSearchDemo {
    public static void main(String[] args) throws IOException {
        // 1. 配置扩展词典(添加新词如"元宇宙")
        Configuration cfg = new Configuration(null, null,
            new String[]{"ext_dict.dic"}); // 自定义词典文件

        // 2. 创建IK分词器实例
        Analyzer analyzer = new IKAnalyzer(cfg, true); // true启用智能切分

        // 3. 测试分词效果
        TokenStream stream = analyzer.tokenStream("", "华为Mate60支持卫星通信");
        CharTermAttribute term = stream.addAttribute(CharTermAttribute.class);
        stream.reset();
        while (stream.incrementToken()) {
            System.out.print(term.toString() + " | "); // 输出:华为 | Mate60 | 支持 | 卫星 | 通信 |
        }
        analyzer.close();
    }
}
二、索引写入速度优化方法
-
核心优化策略
- 内存缓冲:增大
RAMBufferSizeMB(默认16MB → 256MB) - 并行合并:使用
ConcurrentMergeScheduler - 批量提交:减少
commit()调用频率
- 内存缓冲:增大
-
代码示例:高速写入配置
IndexWriterConfig config = new IndexWriterConfig(analyzer);
// 内存缓冲提升至256MB
config.setRAMBufferSizeMB(256);
// 启用并行段合并
config.setMergeScheduler(new ConcurrentMergeScheduler());
// 关闭自动提交(手动控制提交时机)
config.setCommitOnClose(false);

try (IndexWriter writer = new IndexWriter(dir, config)) {
    for (int i=0; i<100000; i++) {
        Document doc = new Document();
        doc.add(new TextField("content", "文档内容..."+i, Field.Store.YES));
        writer.addDocument(doc);
        // 每1000条提交一次
        if (i % 1000 == 0) writer.commit();
    }
}
三、评分机制与搜索排序
-
BM25算法(Lucene默认)
score ( D , Q ) = ∑ i = 1 n IDF ( q i ) ⋅ f ( q i , D ) ⋅ ( k 1 + 1 ) f ( q i , D ) + k 1 ⋅ ( 1 − b + b ⋅ ∣ D ∣ avgdl ) \text{score}(D,Q) = \sum_{i=1}^{n} \text{IDF}(q_i) \cdot \frac{f(q_i, D) \cdot (k_1 + 1)}{f(q_i, D) + k_1 \cdot (1 - b + b \cdot \frac{|D|}{\text{avgdl}})} score(D,Q)=i=1∑nIDF(qi)⋅f(qi,D)+k1⋅(1−b+b⋅avgdl∣D∣)f(qi,D)⋅(k1+1)- k 1 k_1 k1:控制词频饱和度(默认1.2)
- b b b:控制文档长度惩罚(默认0.75)
- 相比TF-IDF:抑制高频词影响,更符合实际相关性
-
自定义排序示例
public class CustomScorer extends Similarity {
    @Override
    public SimScorer scorer(BasicStats stats) {
        return new BM25Similarity().scorer(stats); // 继承BM25基础
    }

    // 添加点击率权重因子
    @Override
    public float scorePayload(int doc, int start, int end, BytesRef payload) {
        float ctr = PayloadHelper.decodeFloat(payload.bytes); // 从payload获取点击率
        return ctr * 0.2f; // 20%权重
    }
}

// 使用自定义评分器
IndexSearcher searcher = new IndexSearcher(reader);
searcher.setSimilarity(new CustomScorer());
四、近义词扩展与语义搜索
-
近义词扩展实现
- 同义词过滤:在分析链中添加
SynonymGraphFilter - 动态扩展:使用
Word2Vec生成近义词表
- 同义词过滤:在分析链中添加
-
代码示例:同义词查询
// 同义词映射配置
String synRules =
    "手机, 智能手机 => 移动设备\n" +
    "苹果, 苹果公司 => Apple";

SynonymMap synMap = new SynonymMap.Builder().parse(
    new StringReader(synRules)).build();

// 创建带同义词的分词器
Analyzer synAnalyzer = new Analyzer() {
    protected TokenStreamComponents createComponents(String fieldName) {
        Tokenizer source = new StandardTokenizer();
        TokenStream filter = new SynonymGraphFilter(source, synMap, true);
        return new TokenStreamComponents(source, filter);
    }
};

// 搜索"移动设备"可匹配"手机"文档
QueryParser parser = new QueryParser("content", synAnalyzer);
Query query = parser.parse("最新移动设备");
五、大数据索引合并优化
-
合并性能瓶颈
- 海量小段文件导致随机IO
- 合并过程占用大量CPU/磁盘
-
优化方案
策略 实现方式 效果 分层存储 热数据SSD + 冷数据HDD 减少70%合并延迟 TieredMergePolicy 优先合并大小相近段 降低45%CPU开销 增量合并 仅合并新修改段 减少90%IO量 -
配置示例
IndexWriterConfig config = new IndexWriterConfig(analyzer);

// 启用分层合并策略
TieredMergePolicy mergePolicy = new TieredMergePolicy();
mergePolicy.setMaxMergedSegmentMB(1024); // 最大段1GB
mergePolicy.setSegmentsPerTier(10); // 每层10段
config.setMergePolicy(mergePolicy);

// 设置存储分层
config.setUseCompoundFile(false); // 禁用复合文件格式
config.setCodec(new Lucene95Codec() {
    public StoredFieldsFormat storedFieldsFormat() {
        return new TieredStorageFormat(); // 自定义存储分层
    }
});
六、分布式部署最佳实践
-
架构方案对比
方案 核心组件 适用场景 SolrCloud ZooKeeper + Solr 文档搜索/高可用 Elasticsearch 自研分布式协调 日志分析/实时计算 自建集群 Sharding + Raft 定制化需求 -
分片设计原则
- 分片大小:20-50GB/片(SSD环境)
- 副本数量:生产环境≥2副本
- 路由策略:
hash(_id) % shard_count
-
故障恢复流程
性能基准:在32核/128GB/NVMe SSD集群上,Lucene可实现:
- 索引吞吐:≥50,000 docs/sec
- 查询延迟:<100ms (99% percentile)
- 支持PB级数据
思维导图

 467


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


