一文解析AI大模型Agent

一文彻底搞懂大模型 - Agent(智能体)2024最新知识 Agent是能够模拟独立思考过程,灵活调用各类工具,逐步达成预设目标。在技术架构上,Agent从面向过程的架构转变为面向目标的架构,旨在通过感知、思考与行动的紧密结合,完成复杂任务。** 阅读详情

前言

现在很多朋友都在研究AI大模型;对各个公司的大模型更是数如家珍。

“chatgpt、Claude、Gemini、Llama3、文心一言、千问…”

国外的、国内的、开源的、不开源的;只要出来一个大模型,就要注册,试一试效果。

但我想问的是:

你真正了解它们是如何工作的吗?

大家可以尝试回答下面这几个问题,就能知道自己是不是真懂,什么是LLM大语言模型了。

例如:

“为什么基于生成式的模型,可以模拟出聊天对话的样子?”

“为什么大语言模型,可以生成不同的、非固定的对话回复?”

“生成式的AI大模型,依赖的是Transformer中的哪一部分?”

“几乎所有的大模型的最后一层都是softmax层,它的作用是什么?”

“如何快速的在笔记本电脑上,部署大语言模型进行实验?”

看完今天的文章,上面的问题都会迎刃而解!

最后希望能帮助大家:

真正理解AI大模型的工作原理。

具体来说,我会从三个方面进行讲解:

1)文本生成的原理,怎样基于文本生成模拟对话。

2)基于llama模型的结构,讲解大模型的推理过程。

3)基于openai的GPT2模型,进行推理实验。

1.文本生成的原理
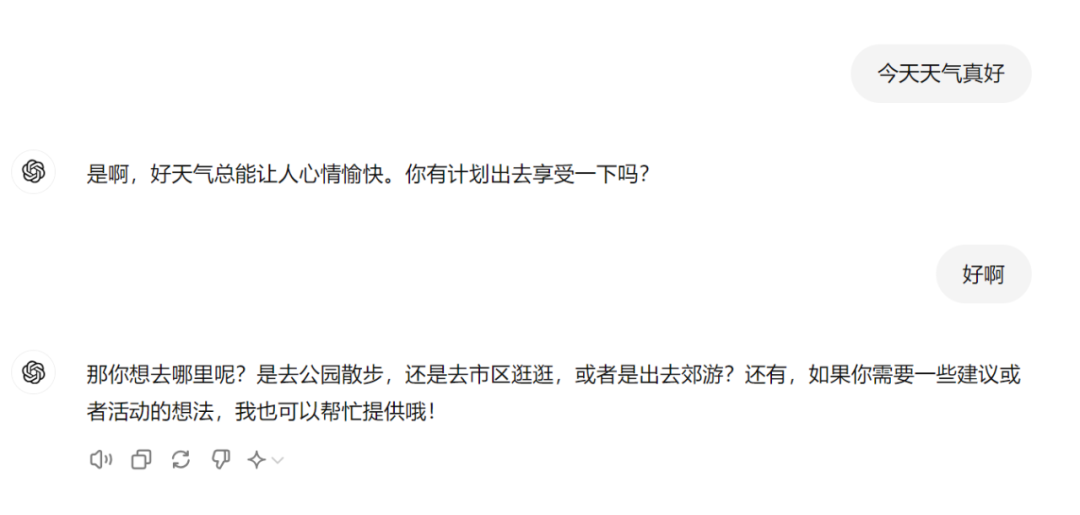
你是否困惑过,无论向chatgpt输入什么样的问题,它都能准确的回复。

并且,chatgpt还能参考过去的对话内容,生成符合历史对话的新回复。

不仅如此,如果我们觉得chatgpt回复效果不够好;

还可以让它重新生成一个、不同于之前的回复。

这究竟是什么样的原理呢?

实际上,我们看似是与chatgpt进行问答式的沟通与对话交流;

但对于gpt来说,它做的事情,仍然是文本生成。

也就是基于过去的数据,预测出下一个最有可能出现的单词。

下面我举两个例子,来说明这个问题。

1)到底什么是文本生成?

假如我们有一个AI大模型,比如GPT2。
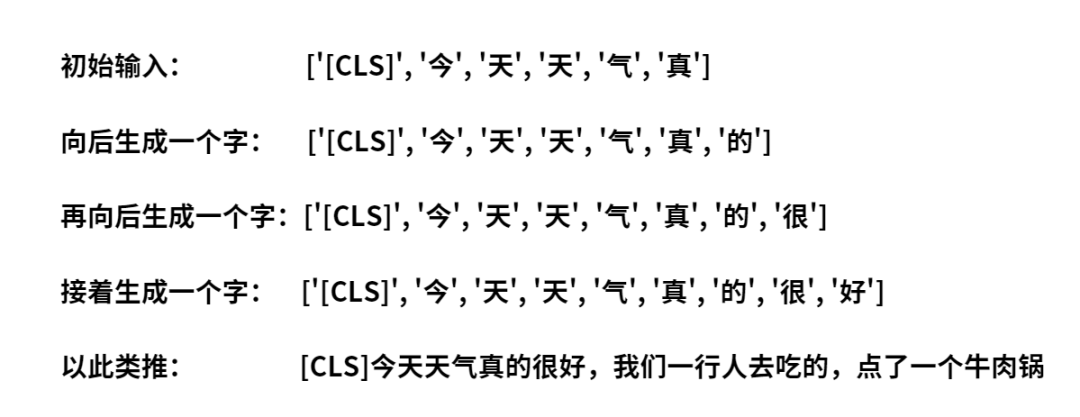
此时我们向模型输入,“[cls]、今、天、天、气、真”,一共6个字(单词)。

我们希望模型基于这6个字,生成第7个字。

此时,模型会输出第7个字,是“的”字。

这里要需要特殊说明:

最开始的[cls],是一个特殊标记;

它用于标记句子的起始位置;

模型需要基于一些特殊的标记来进行计算。

现在不太理解也没关系,可以暂时忽略这个cls标记。

接着,我们要生成第8个字。

对于第8个字的生成,就会依赖初始输入的6个字,与刚刚生成的第7个“的”字。

基于这7个字,模型会继续生成“很”字。

接着,我们可以再基于这8个字,再向后生成一个字;

也就是第9个字,模型会输出“好”字。

以此类推,接着往后生成“,我们一行人去吃的,我们点了一个牛肉锅”。

总结来说:

文本生成,就是使用前面的字作为输入,生成新的字。

而到底要生成多少内容,取决于我们希望生成多少内容。
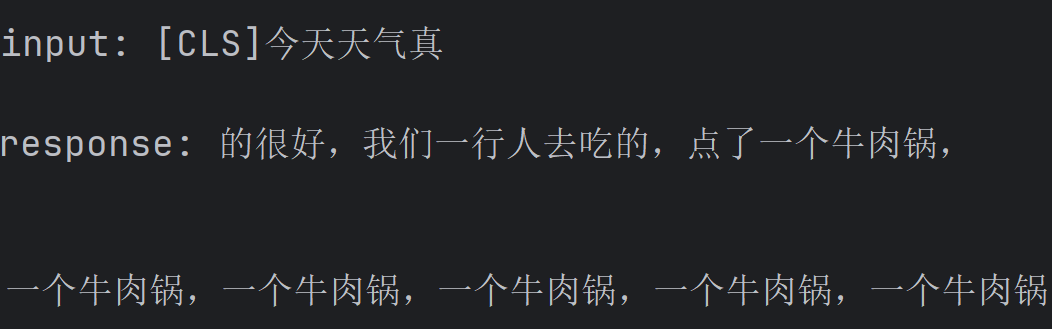
也就是,只要你愿意,大语言模型可以生成无穷无尽的文本。

2)chatgpt和文本生成又有什么关系?

chatgpt就是对话形式的文本生成。

假如此时,我们有一个经过对话数据微调的、中文GPT2大语言模型。
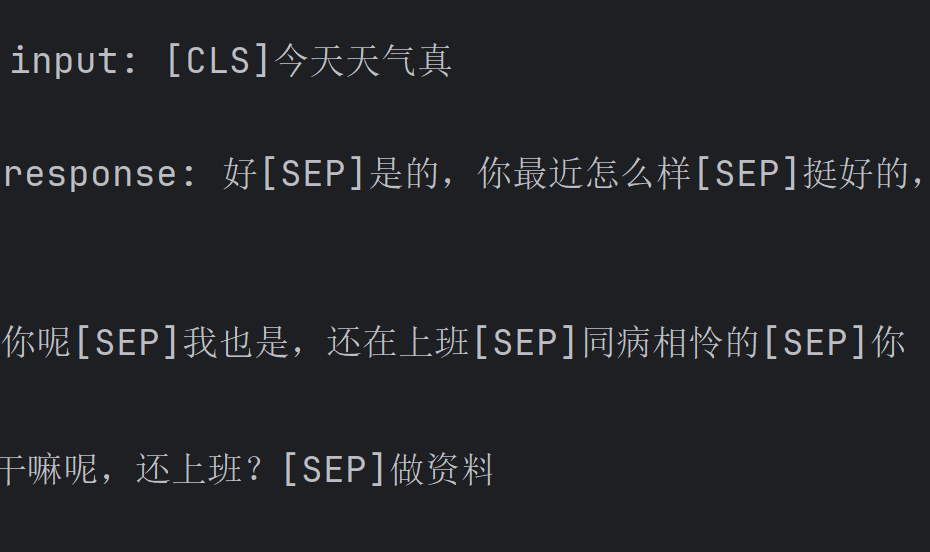
同样向这个模型输入“[cls]、今、天、天、气、真”,一共6个字。

这一次我们会发现,生成的下一个字是“好”;

然后是“[SEP]”;

接着是“是的,你最近怎么样[SEP]挺好的,你呢[SEP]”。

这又代表什么意思呢?

SEP分隔符

实际上,SEP就像一开始的[cls],是一种预定义的特殊字符;

SEP用于表示对话的分隔符。

我们可以将SEP看做是两个人对话的分隔标记。

模型专门输出这个特殊字符[SEP],来指示对话的结构。

例如,如果以SEP分割模型生成的文本,就会模拟出两个人的对话。

例如,我们可以将:

第1句“今天天气真好”看做是A说的;

第2句“是的,你最近怎么样”看做是B说的;

第3句“挺好的,你呢”,又是A说的;

第4句“我也是,还在上班”,又是B说的。

这样就得到了,对话形式的生成结果。

我们在使用模型的输出时,也就是chatgpt在展示结果的时候:
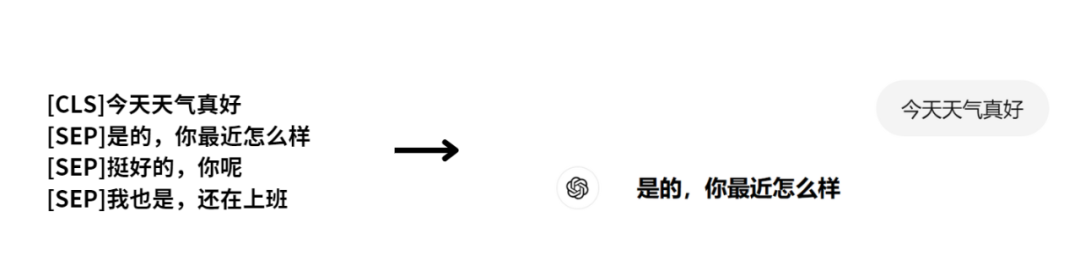
只需要展示、输出第1个SEP后与第2个SEP前的文本就可以了。

也就是说,chatgpt会回复:

“是的,你最近怎么样”,这样就可以了。

这之后的输出,对于此时的对话是没有意义的。

当看到SEP后,就代表了本次的回复结束了。

综合上面这两个例子:

我们就会发现:

chatgpt的本质,就是文本生成。

模型本身,并没有试图去理解对话本身的意义。

chatgpt仅仅是通过文本生成,模拟出对话的效果而已。

所以,大家会不会觉得:

AI大模型也不过如此呢?

2.如何推理计算出下一个字

如何基于已有的文本,计算出下一个字呢?

也就是:

到底如何基于“[cls]、今、天、天、气、真、”;

计算出下一个单词是“的”;

再下一个字是“很”;

再下一个是“好”呢?

下面我基于llama3模型,来说明这个问题。
简单介绍Llama3,它是Meta的开源AI大模型;

效果先放一边,最关键的是它的资料非常全面;

对于学习者来说,是难得的学习资源。

Llama3基于Transformer架构。
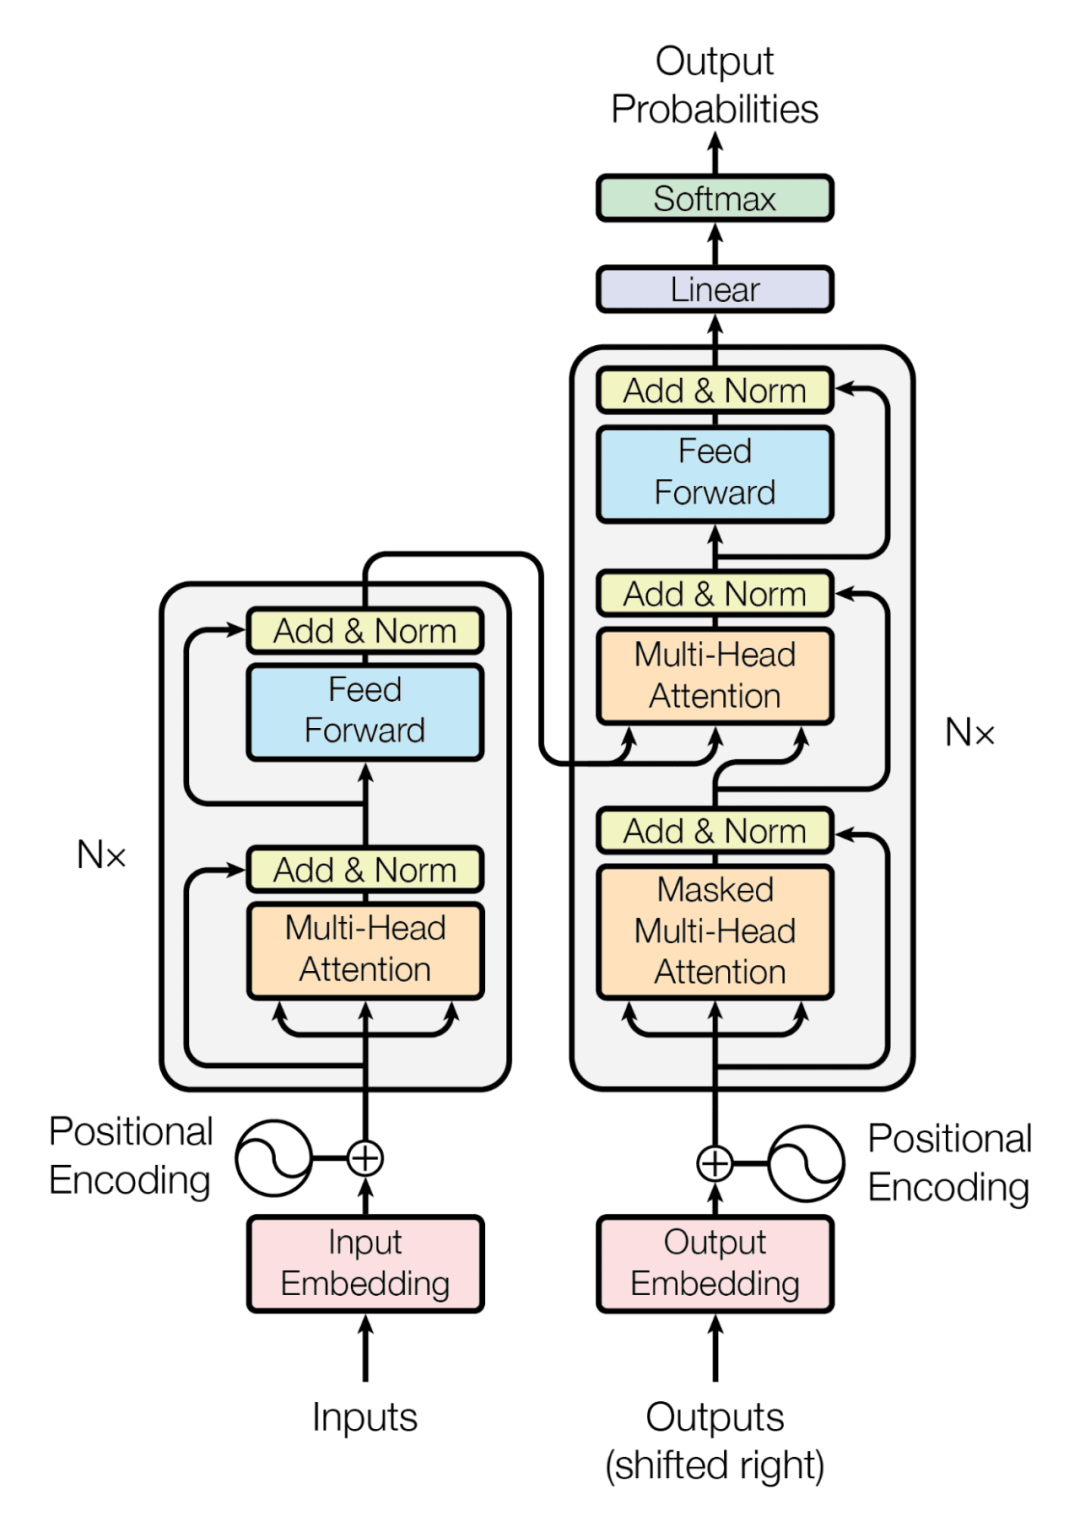
如果真想搞懂llama,肯定需要先理解Transformer。

下面我会基于Transformer和llama的模型结构图;来解释大语言模型的推理过程。

大家即使看着似懂非懂也没关系,关键是感受一下大模型是如何工作的。

下面进入正题!

1)模型的结构:
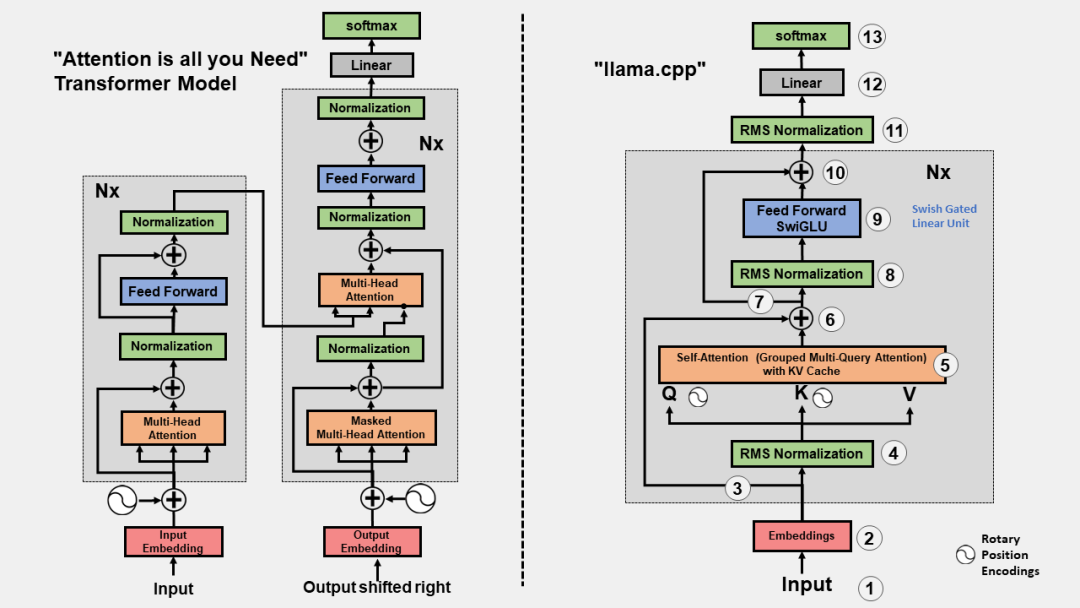
左图是Transformer结构图,右图是llama结构图。

Transformer中的左侧结构是编码器,右侧是解码器。对比观察这两个结构图可以看到,llama模型借鉴了Transformer的解码器。

实际上,生成式的AI大模型,都依赖Transformer的解码器架构。如果深入来看模型方框中的结构;Transformer的解码器和llama模型,同时都包括了:

  • 红色的embedding层

  • 绿色的标准化层

  • 橙色的自注意力机制

  • 蓝色的前馈神经网络

在模型的输出位置,又同时都有:

  • 一个灰色linear线性层

  • 一个绿色的softmax层

2)数据流的计算

输入数据Input标记为1,会从下方输入。

首先经过2号embedding,进行词嵌入,将单词序列转为向量序列。

接着进入N个transformer块,进行特征提取。

虚线框中的结构,编号3到10,都是Transformer块中的内容。

我们只需要知道,它们会将Input,转换为一个固定长度的向量。

接着,这个向量会被11号RMS-norm和12号Linear层处理。

3)预测下一个字

预测下一个字,就是使用Linear层+softmax层。

Linear层用于将特征向量的维度数,转换为字典中字的数量。

softmax层用于计算下一个字出现的概率,也就是预测下一个字。

这实际上是一个分类的过程!

假如在中文词汇表中,有1000个字:

那么它就是一个1000个类别的多分类任务。

具体来说:

给定的输入文本会被Transformer转为固定长度的向量:
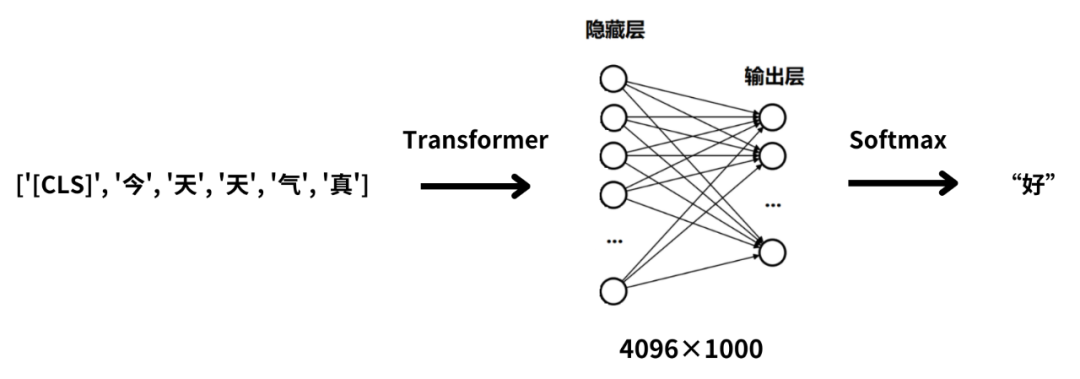
图中标记的4096,就是输入文本转换后的维度。

这个4096的向量会输入到Linear线性层:**通过Linear线性层:**我们可以将这个4096维的向量,转换为字典中字的个数的维度的向量;比如字典中有1000个字,那么就被转为1000维的向量。从而进行1000个类别的分类。分类的结果,就是具体的某一个字。将1000维的向量,继续输入到softmax层: softmax层会给出1000个字,每个字可能的概率。例如,对输入文本“今天天气真”进行“分类”,就得到“好”字。

4)如何选择输出结果

贪心方式选择:

如果我们选择概率最大的字作为下一个字,进行输出;

这是贪心的方式来选择结果。

例如,1000个字:“好”字的概率是0.67;“糟”字的概率是0.32;其他所有加一起是“0.01”。这时我们可以直接输出“好”字。这种选择结果的方式,虽然简单,但也存在弊端:因为直接输出概率最大的字,输出结果总是固定的。chatgpt的回复就没有多样性了。

基于概率分布选择:

我们可以基于概率分布,随机的取出下一个字作为输出。
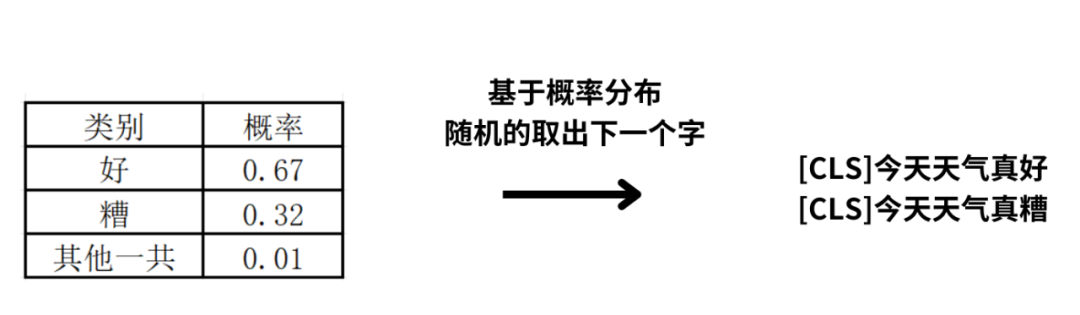
就像从一个黑箱中有放回的摸球,摸到哪个字,就输出哪个字;我们也不用担心摸到不常用的字;因为我们可以将概率过低的字进行丢弃。这时我们就会选择“好”字,或者“糟”字;从而生成出两不同的结果了。这就是为什么,chatgpt可以生成不同结果的原理。

3.GPT2模型的推理实验

最后我们在本地电脑,进行大模型的推理实验。

这里选择GPT2进行实验。
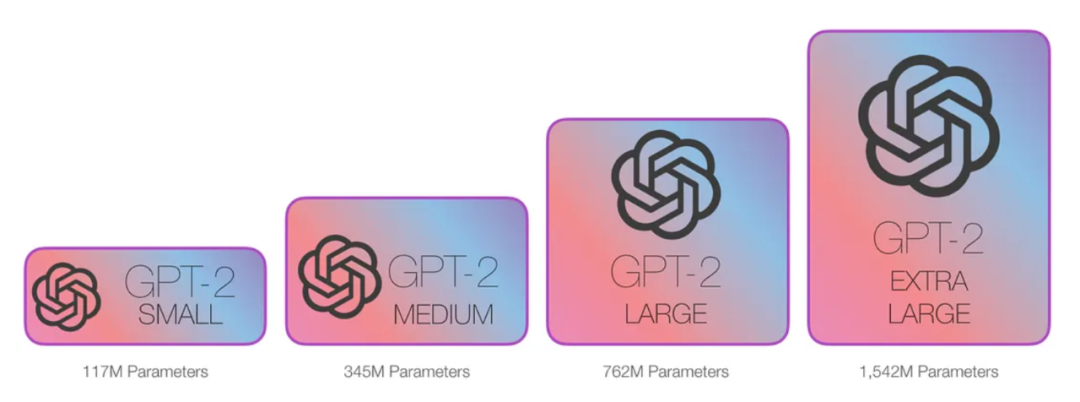
简单介绍GPT2:

它是GPT4的前身,是openai的最后一个开源版本。之所选择GPT2进行推理实验,是因为它所依赖的资源很少;

单机环境就可以运行大模型推理;并且对于初学者,如果你想学大语言模型;

GPT2就是最合适的!

因为它的资料,真的很多!

1)模型下载

gpt2的中文模型,可以从huggingface上下载。

我们选择其中的clue-corpus-small,这个版本。

为了部署模型,需要下载其中的3个关键文件:

模型的配置:config.json

模型本身:pytorch_model.bin

切词字典:vocab.txt

2)实验代码1

使用这个模型需要基于Transformer库。

主要需要使用Transformer库的切词组件与GPT2模型组件。下面在讲解代码时,我会基于代码的调试信息来说明。实验整体包括两个部分,分词部分和推理部分。

分词部分:
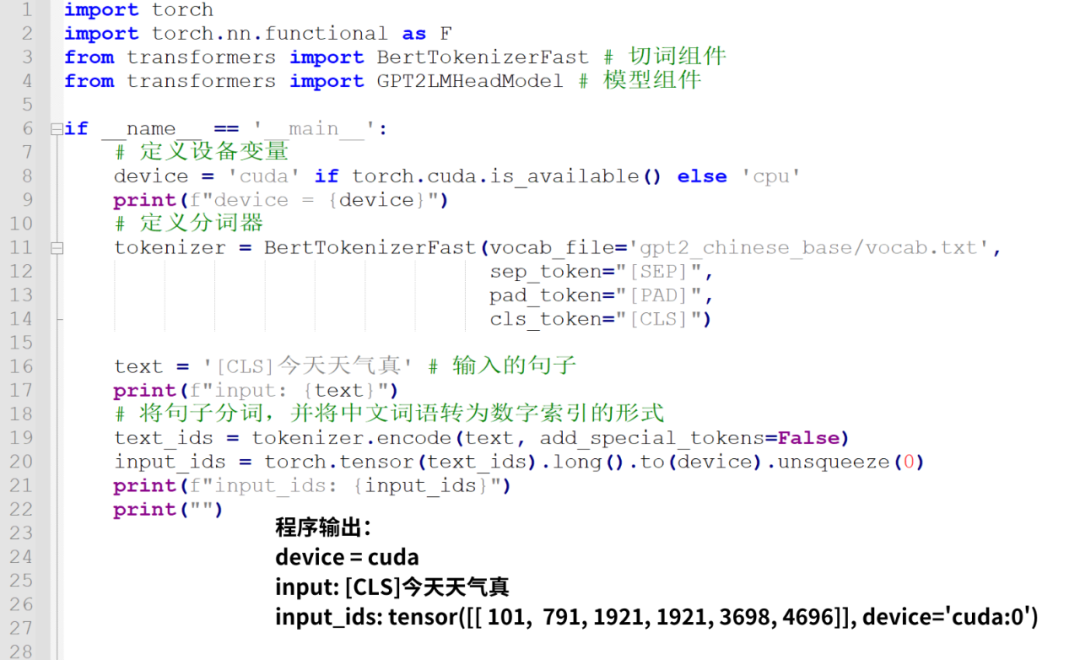
首先定义设备变量device,打印后会看到我们当前的设备是cuda,GPU设备。

定义分词器,BertTokenizerFast。使用分词器的encode函数,可以将句子分词,并将中文词语转为数字索引的形式。

例如,输入句子“[CLS]今天天气真”;它就会被转换为6个整数索引,分别是101、791等等。我们可以在字典vacab.txt中,找到这些词和对应的索引。

打开vacab.txt文件观察:
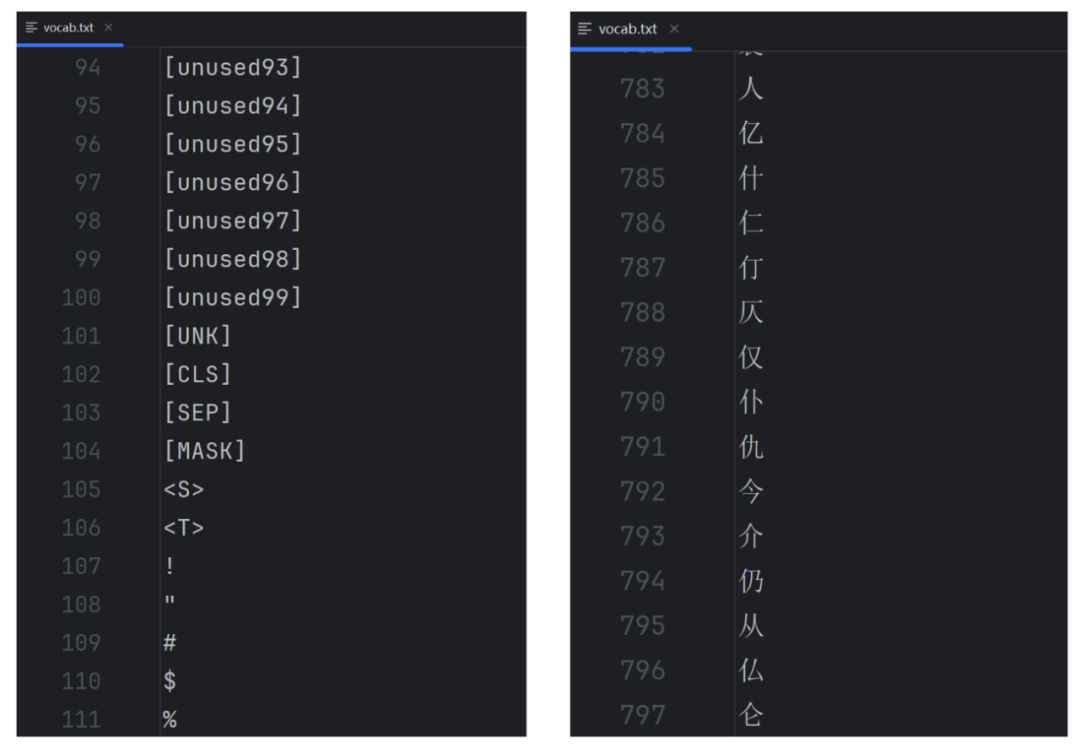
找到字典的第102行,就是[CLS]这个词。

找到字典的第792行,就是“今”这个字。

推理部分:
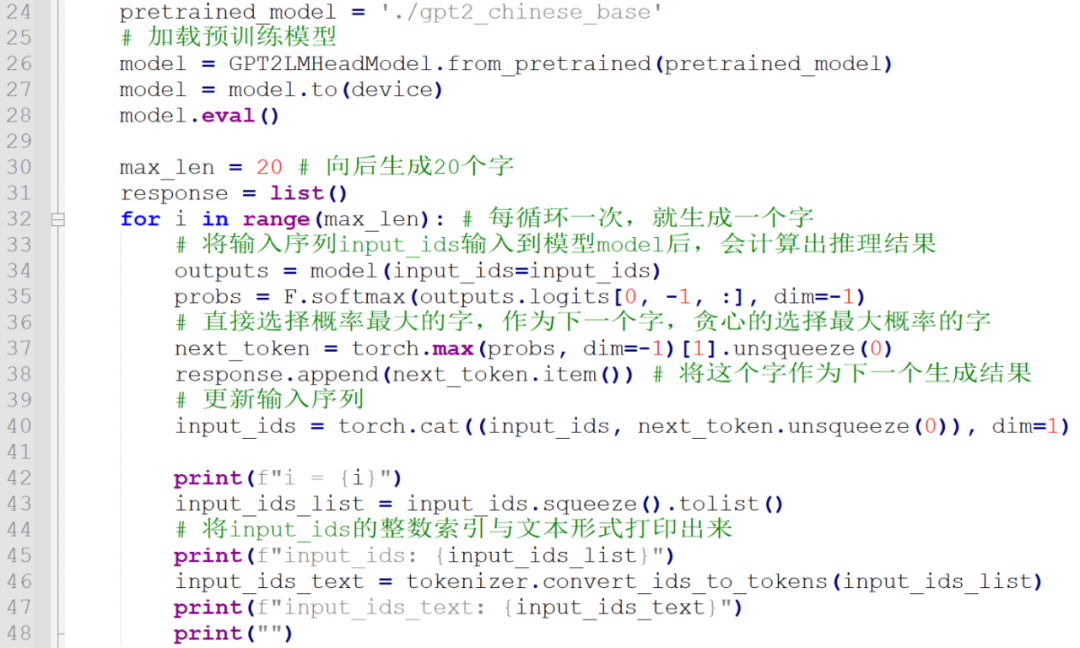
接着,我们使用接口from_pretrained,加载预训练模型。

定义max_len=20,表示向后生成20个字。

在循环中,每循环一次,就生成一个字。

将输入序列input_ids输入到模型model后,会计算出推理结果output。

这里我们直接选择概率最大的字,作为下一个字。

也就是使用softmax函数,计算出所有字出现的概率后;

使用torch.max,贪心的选择最大概率的字。

将这个字作为下一个生成结果,添加到response中。

然后更新输入序列input_ids,把新生成的next_token,cat到input_ids中。

接着我们将input_ids的整数索引与文本形式打印出来。

输出结果:
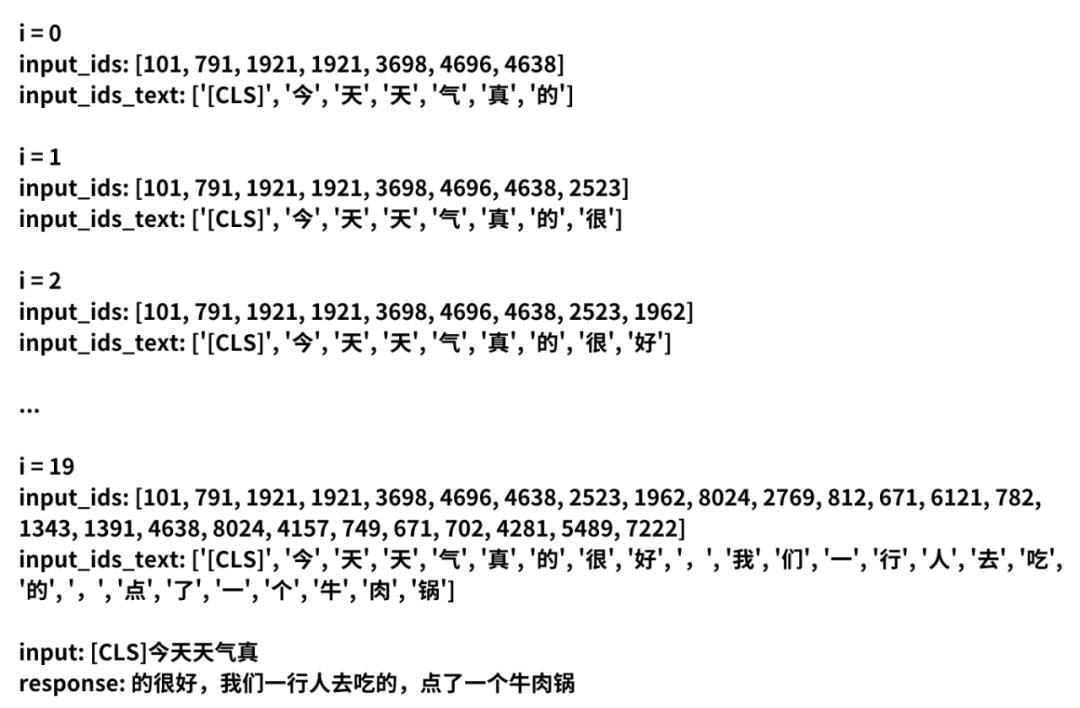
这时会看到,每一轮循环,都会生成一个字。

i=0时,生成了“的”字;

i=1时,生成了“很”字;

i=2时,生成了“好”字;

…

i=19时,就基于前面的19个字,就会生成最后一个“锅”字。

这样我们就基于“[CLS]今天天气真”;

生成了“的很好,我们一行人去吃的,点了一个牛肉锅”。

3)实验代码2:

实验代码1,是普通的文本生成;

实验代码2,是对话形式的文本生成。

这两个代码,只是加载的模型不同:
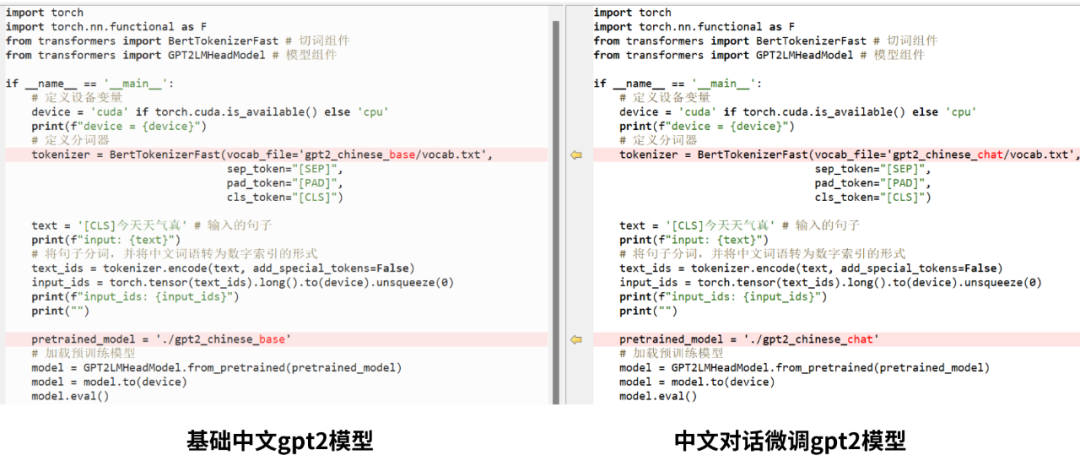
左侧是基础中文gpt2模型,右侧是中文对话微调的gpt2模型。

我们会发现,使用对话文本微调的gpt2模型,输出的结果包括了SEP分隔符。
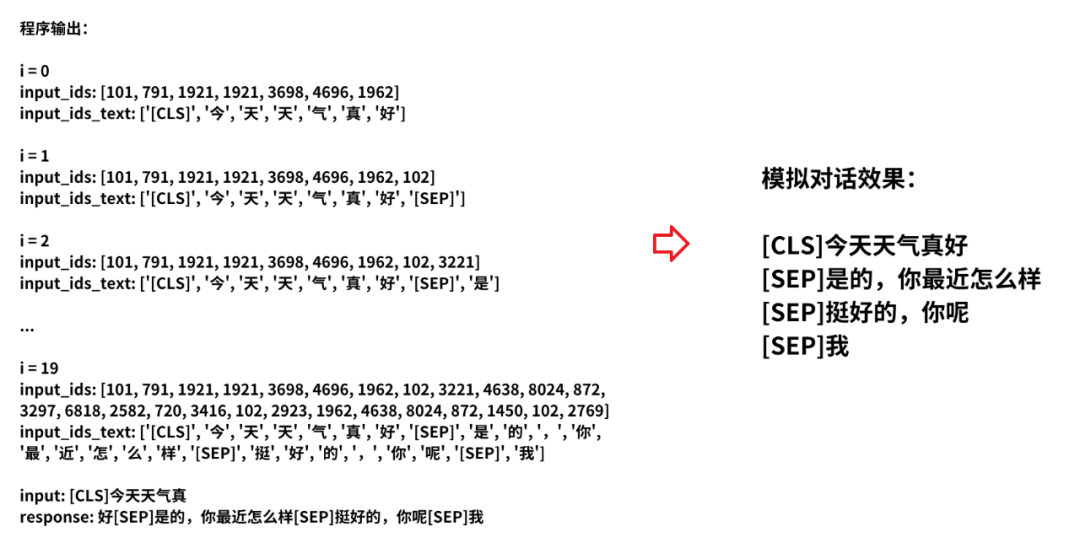
如果输入“[CLS]今天天气真”;

就会输出“好[SEP]是的,你最近怎么样”等等。

通过SEP分隔符,我们就可以模拟出对话的效果了。

以上就是AI大模型的基本工作原理。


优快云独家福利

最后,感谢每一个认真阅读我文章的人,礼尚往来总是要有的,下面资料虽然不是什么很值钱的东西,如果你用得到的话可以直接拿走:

大模型入门指南:基本技术原理与应用 本文探讨了大型神经网络模型的基本技术原理,包括深度神经网络、激活函数、损失函数、优化算法、正则化和模型结构等,并讨论了预训练与微调、模型压缩与加速、解释性与可解释性、隐私与安全等关键议题,旨在帮助读者更好地理解和利用大模型来解决实际问题。 阅读详情

相关推荐

第二章:AI大模型的基本原理2.3 AI大模型的关键技术2.3.1 Transformer

1. 背景介绍 在过去的几年里,人工智能领域取得了显著的进展,尤其是在自然语言处理(NLP)领域。这些进展的一个关键驱动力是Transformer模型的出现。Transformer模型是由Vaswani等人在2017年的论文《Attention is All You Need》中首次提出的,它为处理序列数据提供了一种全新的方法,摒弃了传统的循环神经网

AI天才研究院 206

大语言模型技术原理

总体来说,ChatGPT 在人工标注的prompts和回答里训练出SFT监督策略模型,再通过随机问题由模型给出多个答案,然后人工排序,生成奖励模型,再通过PPO强化训练增强奖励效果。最终ChatGPT能够更好理解指令的意图,并且按指令完成符合训练者价值观的输出。最后,大语言模型作为一个被验证可行的方向,其“大”体现在数据集广泛,参数和层数大,计算量大,其价值体现在通用性上,有广泛的应用场景。大语言模型能够发展,主要还是模型具备很好的并行扩展性,随着数据量和计算量的增加,主要挑战在工程和调优上。海外除了G

云原生智能数据管理平台 4749

本地化部署dify,使用Database插件实现dify直连数据库报错No module named ‘MySQLdb‘解决方案

网上查阅各种资料,有说修改/dify-main/docker/volumes/sandbox/dependencies目录下的python-requirements.txt文件,添加了如下两行,试验后无效。,看到有人是其他报错,但是URI配置如下(在mysql后面加了pymysql),尝试后果真成功了。按照系统提示设置完数据库URI后保存出现错误。在工具市场查询Database,点击后进行授权。最后在该插件的项目地址获得灵感。

qiaoxu1989的博客 4333

深度讲解AI大模型原理,它到底是如何工作的,零基础入门到精通,收藏这一篇就够了

假如我们有一个AI大模型,比如GPT2。此时我们向模型输入,“[cls]、今、天、天、气、真”,一共6个字(单词)。我们希望模型基于这6个字,生成第7个字。此时,模型会输出第7个字,是“的”字。这里要需要特殊说明:最开始的[cls],是一个特殊标记;它用于标记句子的起始位置;模型需要基于一些特殊的标记来进行计算。现在不太理解也没关系,可以暂时忽略这个cls标记。接着,我们要生成第8个字。对于第8个字的生成,就会依赖初始输入的6个字,与刚刚生成的第7个“的”字。

Python_0011的博客 2592

SDI-12协议与STM32 进行uart通信

其中DIR_OUT_SDI是一个IO引脚,控制UART_TX_SDI是否使能,U10是三态门IC,即拉低DIR_OUT_SDI使能stm32输出,拉高DIR_OUT_SDI失能输出,串口配置8位数据位,偶校验,1位停止位,1200波特率。示波器测试得到传感器的应答信号如下:第一个是唤醒信号,拉高电平13毫秒,之后保持20毫秒低电平,第二个数据帧是激活信号,即ascii码: "0!",第三个是传感器的应答信号:"0\r\n"

weixin_42186805的博客 4402

实战教程:用YOLOv11+PyQt5打造工地安全帽检测系统(附完整数据集)

本文提供了一份完整的实战指南,详细介绍了如何利用YOLOv11目标检测模型与PyQt5界面库,从零开始构建一个智能工地安全帽检测桌面应用。内容涵盖高质量数据集的准备与标注、YOLOv11模型训练与调优,以及如何使用PyQt5开发流畅、专业的图形用户界面,最终实现一个可实际部署的AI安全监控系统。

plum99的博客 738

一文打通AI认知闭环:大模型、RAG、Agent 全面解析

目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。

2401_85154887的博客 1840

RRAM/ Near Memory Computing (NMC) Survey - Reading Notes 0707

Reading Notes of Resistive Random Access Memory – Day 2 Chapter 3 RRAM Characterization and Modeling Overview of RRAM Physical Mechanism A general picture for the filamentary switching mechanism. Forming: 对本征RRAM样本,加电压VformingV_{forming}Vforming​,中间氧化层的O

Blog of Lucky H6 992

AI大模型与AI Agent关系深度解析:一文让你全面了解两者间的奥秘!

有粉丝后台私信问想了解到底什么是AI Agent?在这一波AI浪潮中,有两个词汇被频繁提及,它们分别是「AI大模型」和「AI Agent」。接下来我将用生动的比喻和贴近生活的例子,帮助AI零基础用户轻松理解这两个概念,并了解它们之间的关系。

2401_85379281的博客 1034

cadence capture CIS 之添加数据库

2021-08-20 cadence capture CIS 之添加数据库准备一、添加数据源 准备 1、数据库文件(*.mdb) 2、电脑上安装好 cadence 软件 一、添加数据源 打开“ ODBC数据源管理器” ( 路径:C:\Windows\SysWOW64\odbcad32.exe ) ...

weixin_42256550的博客 6055

Cesium 实战 19 - 使用 gltf-vscode 查看、预览以及编辑 glTF 和 GLB 模型

Cesium 实战 - 使用 gltf-vscode 查看、预览以及编辑 glTF 和 GLB 模型。

非科班Java出身GISer的博客 6435

Agent 技术解析:一文读懂 AI 大模型中的 Agent 是什么

本文将带你深入探索 Agent 的世界,从概念到原理,从分类到应用,帮助你全面理解并掌握 Agent 技术。

ytt0523_com的博客 1023

matlab 点云按高程进行赋色【2024最新版】

首先按照Z轴方向求取所在点云的高程极值(包括高程最大值与最小值),然后将高程归一化到0~255范围内,最后采用matlab中的colormap颜色渲染函数进行赋色并保存渲染结果到点云。

点云侠的博客 3341

一文看懂AI、大模型、LLM、Agent:小白也能秒懂的AI概念全解析

本文通过金字塔模型清晰解析了AI概念体系:AI是终极目标,机器学习是实现方法,深度学习是核心技术,大模型是规模化的产物,LLM是专门处理语言的大模型,Agent是将AI能力落地应用的架构。文章旨在帮助读者理解这些概念间的包含与演进关系,消除对AI术语的困惑。

2401_85343303的博客 735

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

AI大模型与AI Agent关系深度解析:一文让你详细了解两者之间的联系!

本文通过生动比喻解释了AI大模型与AI Agent的关系。AI大模型如同"智慧大脑",拥有海量知识和思考能力;AI Agent则是"智能手脚",能感知环境、规划行动并执行任务。两者相互赋能:大模型为Agent提供深度思考能力,Agent则将大模型的思考转化为实际行动。这种"思想家"与"实干家"的结合,推动AI从简单对话迈向能理解、思考、行动的新阶段。

m0_65555479的博客 784

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

大模型 AI Agent 全面解析:从核心概念到实际应用,一文吃透

大模型 AI Agent 全面解析:从核心概念到实际应用,一文吃透

weixin_59191169的博客 1260

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

全面解析 AI Agent,揭秘大模型如何拥有“手脚”,一文读懂 AI Agent 的核心机制与实战构建

本文将深入浅出地带你彻底搞明白这些问题,并通过具体的实例和代码,揭示 Agent 的神秘面纱。

2301_81940605的博客 692

AI大模型 | 一文详细解析AI Agent智能体全景技术图与Agent 架构设计模式

单智能体= 大语言模型(LLM) + 观察(obs) + 思考(thought) + 行动(act) + 记忆(mem)多智能体= 智能体 + 环境 + SOP + 评审 + 通信 + 成本多视角分析问题:虽然 LLM 可以扮演很多视角,但会随着 system prompt 或者前几轮的对话快速坍缩到某个具体的视角上;复杂问题拆解:每个子 agent 负责解决特定领域的问题,降低对记忆和 prompt 长度的要求;可操控性强:可以自主的选择需要的视角和人设;开闭原则。

Androiddddd的博客 2530

一文读懂大模型、RAG、Agent 等 9 大 AI 概念、区别与联系全解析

一文读懂大模型、RAG、Agent 等 9 大 AI 概念、区别与联系全解析

youmaob的博客 1494

一文读懂AI新世界:大模型、Agent、MCP、Skills全解析

当 ChatGPT 横空出世,当 AI Agent 开始替你工作,当 MCP 成为科技圈热词——你或许会问:这些到底是什么?和我有什么关系?

xx_nm98的博客 420

【强烈收藏】一文理清大模型、AIGC、RAG、Agent、MCP:AI技术关系全解析

文章系统介绍了AI领域关键技术及其关系:从单/多模态AIGC的基础概念,到解决其局限性的RAG检索增强技术和Function Calling工具调用能力,再到具备闭环思考能力的智能体Agent,最后详细解析了作为AI"USB-C接口"的MCP协议标准,展示了AI技术如何从简单生成进化为复杂智能体,以及MCP如何统一工具接入标准,为AI应用生态发展奠定基础。

2401_85154887的博客 1091

大模型AI Agent | 一文解析AI智能体系统5大关键技术

在行业内,曾出现过一种较为混乱的现象,即所有基于大模型的聊天机器人都被统称为 AI 智能体,也就是 AI Agent。无论是角色扮演类的应用程序,还是通过流程编排形成的大模型工作流,亦或是能够自主决策并运用工具完成任务的真正的 AI Agent,都被一概而论地归为 AI 智能体,这种做法其实是一种误区,也反映出了一种懒惰的态度。如今,很多人都在说2025年是 AI 智能体的元年,那么,澄清 AI 智能体的真正含义就显得尤为必要。

m0_56255097的博客 936

收藏必看!AI Agent智能体全面解析:从概念到产业链,一文掌握大模型新风口

本文全面解析了AI Agent智能体的概念、发展历程及核心模块(记忆、规划、工具、执行),详细介绍了其与LLM、RAG、Copilot的区别。文章分析了AI Agent的市场规模(预计2028年中国将达8520亿元)、产业链结构(上游基础设施、中游研发集成、下游应用)及未来发展前景。随着OpenAI等大厂布局,垂直领域AI Agent应用将迎来爆发,可能成为SaaS市场的10倍,重塑生产力格局。

2401_85154887的博客 1236
上一篇: 一文详解LLaMa系列模型:原理介绍、代码解读
下一篇: 大模型项目实战指南,一篇文章全掌握
大模型应用场景
博客等级 码龄5年 7648粉丝 1350原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值