首个Mamba+Transformer多模态大模型

多模态 + Mamba,这对 “CP” 直接锁死啦! 作为序列建模领域的革命性技术,Mamba以线性复杂度的长距离依赖建模能力,与多模态技术的跨维度信息整合优势形成化学反应,推动模型在准确性、鲁棒性和泛化性上实现跨越式突破。从医疗影像的多模态诊断到工业质检的跨模态缺陷检测,从智慧城市的多源数据融合到元宇宙的沉浸式交互,技术应用版图持续裂变。学术领域更是成果井喷,如ICASSP 2025最新成果DepMamba,在多模态视频理解任务中实现计算效率与准确率的双重突破。 阅读详情

扩展多模态大语言模型(MLLMs)的长上下文能力对于视频理解、高分辨率图像理解以及多模态智能体至关重要。这涉及一系列系统性的优化,包括模型架构、数据构建和训练策略,尤其要解决诸如随着图像增多性能下降以及高计算成本等挑战。
在这里插入图片描述

该团队将模型架构调整为 Mamba 和 Transformer 块的混合体,在数据构建中考虑多个图像之间的时间和空间依赖性,并采用渐进式训练策略。提出了首个混合架构多模态大语言模型 LongLLaVA,在效率和性能之间实现了更好的平衡。

LongLLaVA 不仅在各种基准测试中取得了有竞争力的结果,还保持了高吞吐量和低显存消耗,其可以在单个 A100 80GB GPU 上处理近千张图像,展现出了广阔的应用前景。

  • 论文地址:

https://arxiv.org/abs/2409.02889

  • 项目地址:

https://github.com/FreedomIntelligence/LongLLaVA

1. 简介

多模态大语言模型(MLLMs)的快速进步展示了它们在各个应用领域中的显著能力。然而,多图像理解场景仍然是一个重要但尚未充分探索的方面。特别是,将 MLLMs 的应用场景扩展到理解更长的视频、更高分辨率的图像以及基于更多历史信息的决策,对于提升用户体验和进一步拓展 MLLMs 的应用范围至关重要。

然而,将 MLLM 的上下文长度扩展以提高其可用性,面临着处理更多图像时性能下降和计算成本高昂的挑战。一些研究专注于构造包含多个图像的长上下文训练数据,以增强性能。其他研究探索了创新性的训练策略,以减轻性能下降。关于高计算成本的问题,LongVILA 通过降低通信成本在提高多节点效率方面取得了进展。然而,在管理更长的上下文时,加速计算这个问题本身仍有待解决。

为了解决上述挑战,该研究提出了 LongLLaVA 系统解决方案,采用混合架构进行加速。该解决方案在三个维度上进行了全面优化:多模态架构、数据构建和训练策略。

  • 对于多模态架构,采用结合 Transformer 和 Mamba 的混合架构,并提出了一种高效图像表示方法,该方法对图像 Token 应用 2D 池化以降低计算成本同时保持性能。

  • 对于数据构建,为不同的任务设计了独特的格式,使模型能够区分图像之间的时间和空间的依赖关系。

  • 在训练策略方面,采用了一种三阶段的多模态自适应方法 —— 单图像对齐、单图像指令调整和多图像指令调整 —— 以逐步提升模型处理多模态长上下文的能力。

实验结果表明,LongLLaVA 在高效理解多模态长上下文方面表现卓越。它在VNBench的检索、计数和排序任务中领先,并在单张 80GB GPU 上对 1000 张图像进行大海捞针评估时达到了近 100% 的准确率。从保证研究可复现和促进社区发展出发,团队将开源所有与 LongLLaVA 相关的模型、代码和数据集。

2. LongLLaVA: 将 LLaVA 扩展到更长的上下文

为了解决上述挑战并提高模型对长文本和多图像场景的适应性,团队从三个角度进行了改进:多模态模型架构,数据构造和训练策略。
2.1 多模态架构

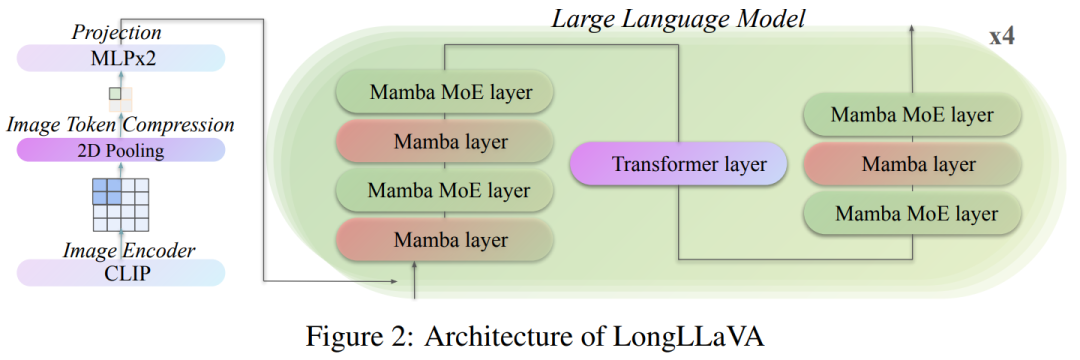
LongLLaVA 基于 LLaVA 的三个核心组件:视觉编码器、 映射器 和大语言模型。

视觉信息处理。团队使用 CLIP 作为视觉编码器来编码视觉信息,并采用两层 MLP 作为映射器,将视觉特征映射到适合 LLM 的文本嵌入空间。在映射之前,应用2D池化,有效地节省了训练和推理时间,同时保持了图像块之间的基本空间关系。

混合 LLM 架构。LongLLaVA 采用了一种混合 LLM 架构,将 Transformer 和 Mamba 层以 1:7 的比例集成,如图 2 所示。在每一层中还采用了混合专家(MoE)方法,使用 16 个专家,并为每个 Token 选择前两个专家。在层之间使用 RMSNorm 来增强归一化,但省略了位置嵌入。该模型集成了分组 Query 注意力(GQA)和 SwiGLU 激活函数,与其他大型语言模型相似。模型的总体参数数量为 530 亿,推理过程中的激活参数总数为 130 亿。
2.2 数据处理协议

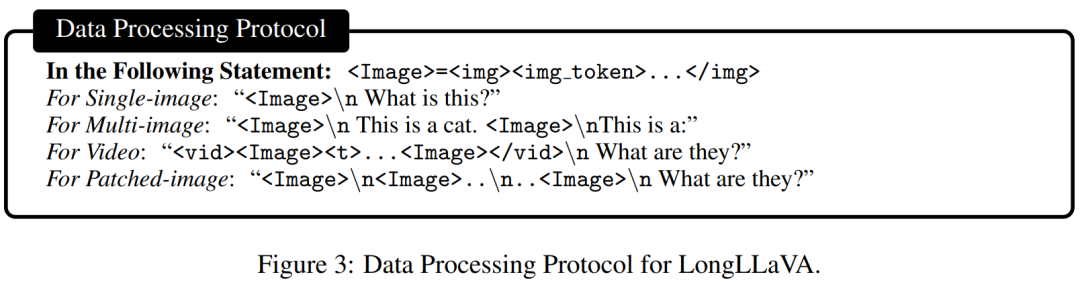
为确保模型在多图像场景中有效地区分图像之间的时序和空间依赖关系,并在各种任务中表现良好,团队细致地区分了不同场景下的特殊字符。如图 3 所示,这些特殊字符全面处理了不同情境下图像之间的各种关系,从而增强了模型对不同任务的适应性。

  • **常规单图和多图输入:**使用 帮助模型区分图像和文本 Token 。

  • **视频:**在不同的帧之间添加 ,以表示它们之间的时间依赖性。

  • **高分辨率图像:**使用换行符 “\n” 来区分主图像与其子图像。 对于子图像的排列,通过从左上角遍历到右下角的方式进行分割,在分割行之间添加"\n"以保留子图像的相对空间位置。

2.3 训练策略

团队逐步实现单模态和多模态的适配,将预训练语言模型转变为多模态长上下文模型。

**纯文本指令微调。**首先提升预训练语言模型在纯文本场景中遵循不同长度指令的能力。这是通过使用包含来自 Evol-instruct-GPT4、WildChat 和 LongAlign 的 278k 条纯文本条目的数据集实现的。
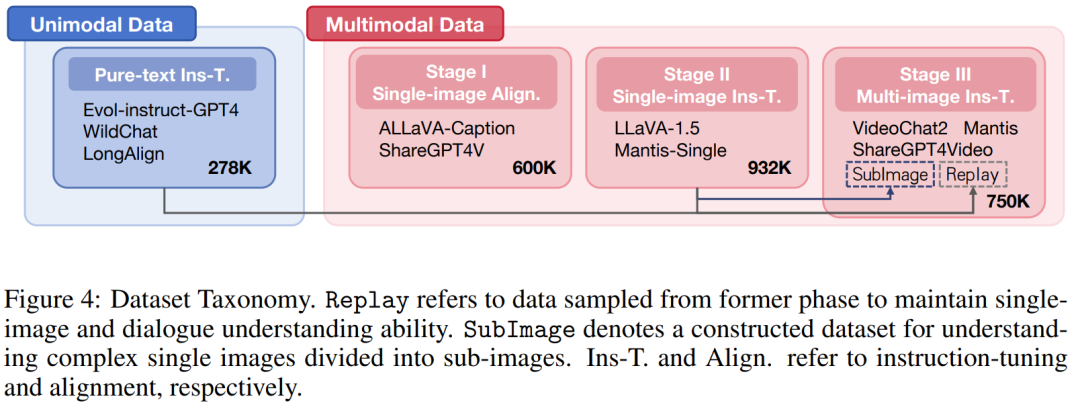
在多模态自适应方面,在 LLaVA 中 “单图像对齐” 和 “单图像指令微调” 阶段之后,团队引入了 “多图像指令微调” 阶段,逐步增强模型的多模态长上下文能力。采用渐进式训练不仅是为了更好地控制变量,也是为了增加模型的可重用性。具体的数据集使用情况如图 4 所示。

**第一阶段:单图像对齐。**这一阶段是为了将视觉模态特征与文本模态进行对齐。团队使用了 ALLaVA-Caption 和 ShareGPT4V 等数据集,这些数据集包含大约 600K 个高质量的图像 - 字幕对。在此阶段,仅训练映射器,同时冻结视觉编码器和 LLM 的参数。

**第二阶段:单图像指令微调。**这个阶段的目的是赋予模型多模态指令遵循能力。团队使用了 LLaVA-1.5 和 Manti-Single 等数据集,总共有约 932K 个高质量的问答对。在此过程中,只冻结了视觉编码器,而映射器和 LLM 部分进行训练。

**第三阶段:**多图像指令微调。在这一阶段,模型被训练以在多模态长文本场景中遵循指令。团队分别从 Mantis、VideoChat2 和 ShareGPT4Video 中采样 200K、200K 和 50K 数据项。为了保留模型的单图像理解和纯文本对话能力,团队将来自单图像指令微调和纯文本指令微调阶段的额外 200K 和 50K 数据项作为 Replay 部分。此外,为了提高模型解释复杂单图像(分割成多个子图像)的能力,团队从单图像指令微调阶段采样 50K 条数据,进行填充和分割,将原始图像分割成尺寸为 336x336 的子图像作为 SubImage 部分。

3. 评估结果

3.1 主要结果

如表 2 所示,LongLLaVA 在 MileBench 上表现出色,甚至超过了闭源模型Claude-3-Opus,尤其在检索任务方面表现出色。突显其在处理多图像任务方面的强大能力。
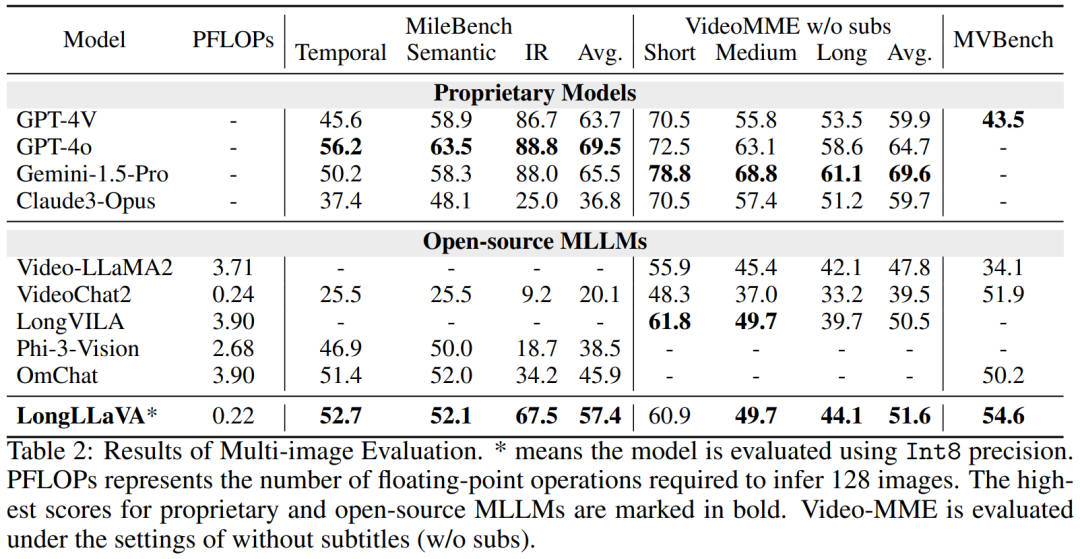
LongLLaVA 在涉及中等至长视频的任务中表现出色,超越了传统的视频模型,如 Video-LLaMA2 和 VideoChat2。在取得了这些令人印象深刻结果的同时,LongLLaVA 的 FLOPs 比其他模型少一个数量级。

3.2 长上下文大型语言模型的诊断评估

考虑到以前的评估不能充分捕捉 MLLM 在长语境下的能力,团队采用了一个新的诊断评估集 VNBench,以进一步分析模型在长语境下的原子能力。VNBench 是一个基于合成视频生成的长上下文诊断任务框架,包括检索、排序和计数等任务。
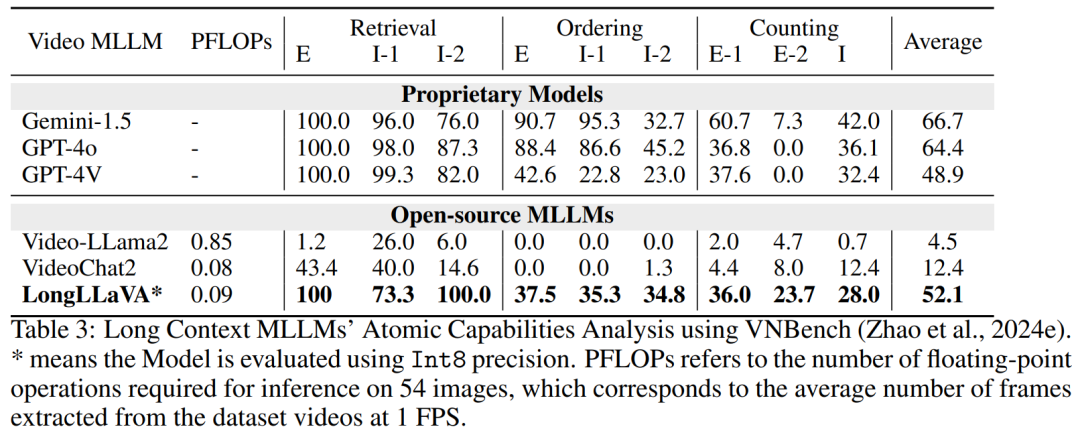
结果显示如表 3 所示,LongLLaVA 在跨语境检索、排序和技术能力等任务中的表现与领先的闭源模型相当,甚至在某些方面超过了 GPT-4V。在开源模型中,LongLLaVA 也展现出其卓越的性能。展示了 LongLLaVA 在管理和理解长上下文方面的先进能力。

3.3 消融实验
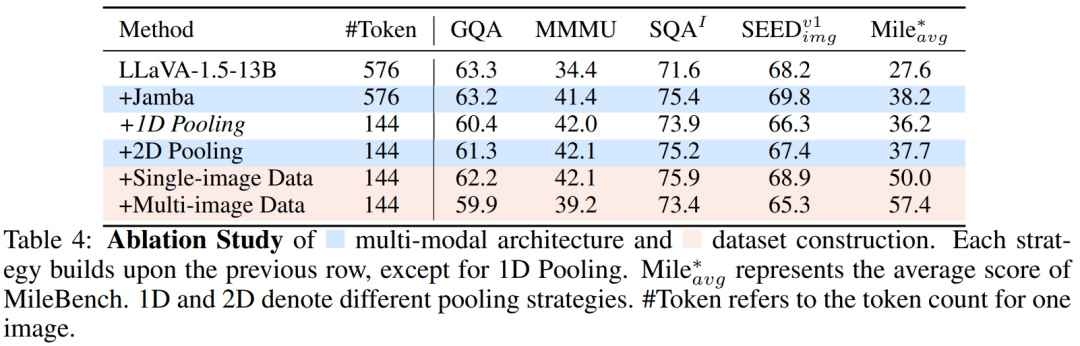
表 4 中显示,使用具有相同数据的混合 LLM 架构,在评估集中都观察到了显著的改进,证明了其在多模态场景中的潜力。对于 Token 压缩,选择了 2D 池化,这显著减少了计算负载,同时将性能下降控制在可接受范围内。与 1D 池化相比,2D 池化方法得到更好的结果。在数据构建方面,在训练团队的单图像数据后,模型在 SEEDBench 上的准确率提高了 1.5%,在 MileBench 上提高了 12.3%。随后的多图像训练使得 MileBench 上的准确率进一步提高了 7.4%,验证了数据集构建的有效性。

4. 更多分析

为了解 LongLLaVA 的内部工作原理和跨模态长文本处理能力,该团队进行了进一步分析。

4.1 关于混合架构的动机
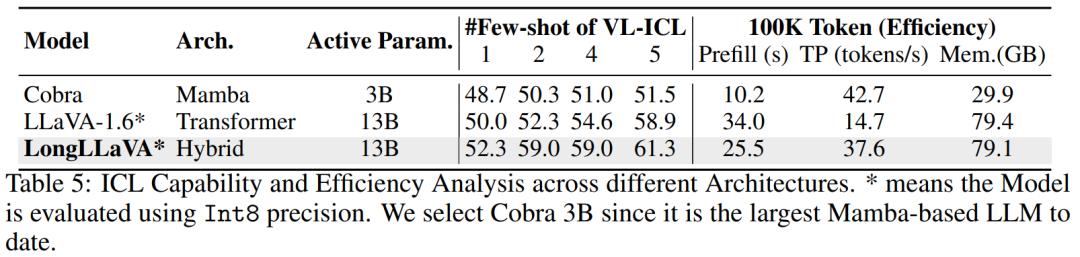
团队探讨了不同架构在 ICL 能力和推理效率方面的优缺点,强调了混合架构的平衡优势。

**ICL 分析。**团队评估了在 VL-ICL 基准测试中对多模态情境学习中匹配图像任务的性能。该任务的输入包含一个图像对,输出表示是否存在特定的关系。MLLM 需要从示例中学习关系。如表 5 所示,混合架构和 Transformer 架构随着示例数量的增加表现出快速的性能提升,而 Mamba 架构的提升较少,证实了其在情境学习方面的不足。

**效率分析。**团队关注三个方面:预填充时间(首次推理延迟)、吞吐量(每秒生成的下一个 Token 数)和内存使用。团队将输入文本长度控制在 100K,并测量生成 1 个 Token 和 1000 个 Token 的输出所需的时间和最大内存使用。吞吐量计算为。为了更好地模拟实际应用场景,使用 vLLM 框架和 Int8 量化评估了 Transformer 和混合架构。如表 5 所示,Mamba 架构具有最快的预填充时间,最高的吞吐量。与具有相似推理参数的 Transformer 架构相比,混合架构实现了 2.5 倍的吞吐量,75% 的预填充时间,并减少了内存使用。
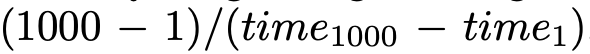
4.2 图像数量的缩放定律

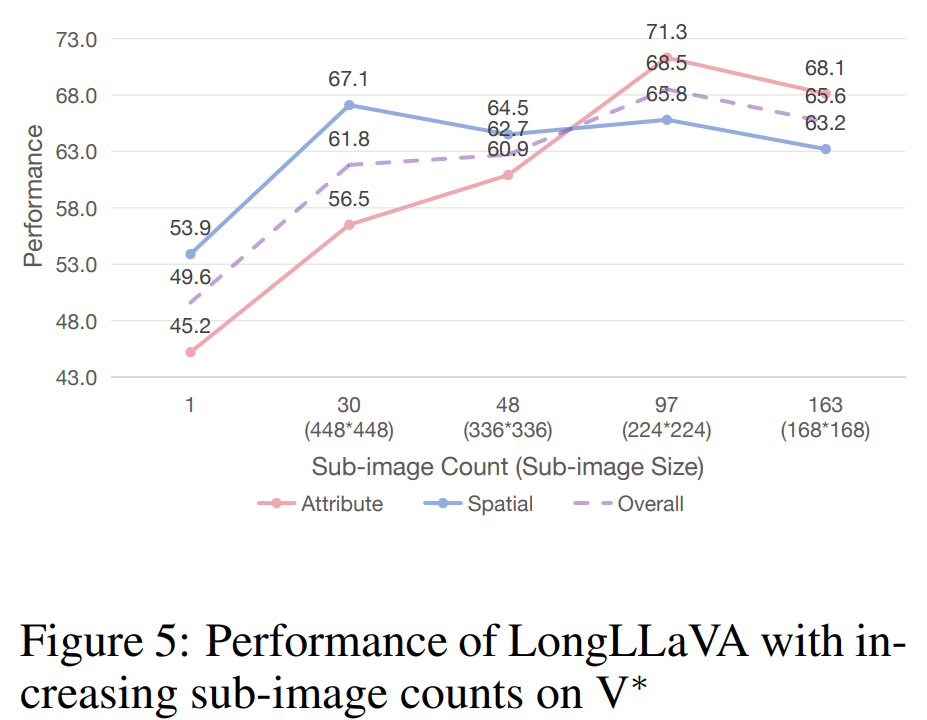
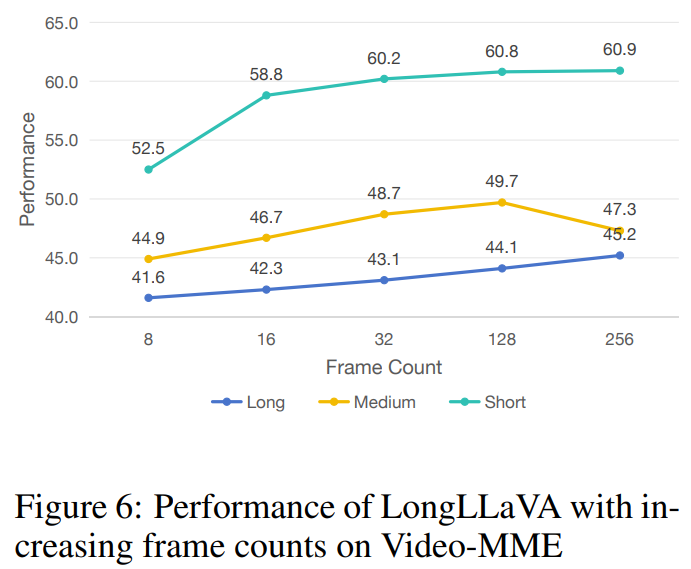
随着可处理图像数量的增加,模型能够支持更多图像块以进行高分辨率图像理解,以及使用更多视频帧进行视频理解。为了探索增加子图像和视频帧数量的影响,团队分别在 V* Bench 和 Video-MME 基准测试上评估了 LongLLaVA。

**增加子图像数量。**V* Bench 评估了一个模型在大型图像中定位小目标的能力。如图 5 所示,最初增加子图像的数量显著提高了模型性能,表明模型对图像细节的理解更好。然而,团队也发现,进一步增加子图像的数量略微降低了性能,这表明过多的子图像可能会干扰在此任务上的性能。
增加帧数规模。视频多模态编码器是一个测试模型从视频中提取信息能力的基准。从图 6 中可以看到,随着采样帧数的增加,模型在基准测试中的性能显著提高,当提取 256 帧时达到峰值。这表明模型能够有效地理解和利用额外采样帧中包含的信息,以提供更好的响应。
5. 进一步将图像数量扩大到 1000

利用 LongVA 中提出的 V-NIAH 评估框架,团队进行了 “大海捞针” 测试来评估模型性能。考虑到模型的训练序列长度限制为 40,960 个 token,采用 token 池化技术将原始 token 数量从 144 个减少到 36 个。这种调整能够高效地从大量数据集中检索相关信息。如图 7 所示,模型在 1000 张图像集上实现了近 100% 的检索准确率,而无需额外的训练。
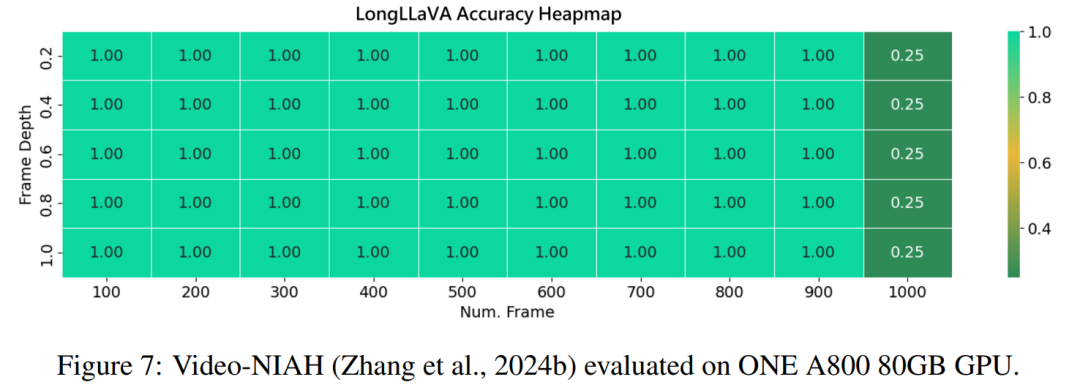
然而,当增加测试图像数量超过 1,000 张时,团队观察到检索准确率下降。这种性能下降可能是因为超出了模型的训练序列长度,这可能会影响其保持更多图像准确性的能力。在未来的工作中团队将延长训练序列长度至 140,000 Token,即 LongLLaVA 进行单卡推理的极限长度,以进一步释放模型潜力。

6. 结论

LongLLaVA(长上下文大型语言和视觉助手)这一创新性混合架构模型,在长上下文多模态理解方面表现出色。该模型集成了 Mamba 和 Transformer 模块,利用多个图像之间的时空依赖性构建数据,并采用渐进式训练策略。

LongLLaVA 在各种基准测试中表现出竞争性的性能,同时确保了效率,为长上下文多模态大型语言模型(MLLMs)设定了新的标准。

在这里插入图片描述

Transformer动画讲解 - 多模态 Transformer模型是一种基于自注意力机制的神经网络架构,广泛应用于自然语言处理任务,如机器翻译、文本摘要等。 阅读详情

相关推荐

关于Mamba和Mamba-2经典论文的学习笔记总结,以及Mamba和Transformer的对比总结,欢迎交流

分享一下Mamba的经典论文学习笔记,以及Mamba-2的提出,简单的对Mamba和Transformer的异同进行了归纳,本此分享从第一部分Mamba的提出背景和结构原理,第二部分Mamba与Transformer的异同,第三部分mamba-2的提出背景和结构原理,第四部分我的个人学习心得,这四个方面进行总结,欢迎交流

qq_66536007的博客 9961

极市平台 | 首个Mamba+Transformer混合架构多模态大模型来了,实现单卡千图推理

LongLLaVA(长上下文大型语言和视觉助手)这一创新性混合架构模型,在长上下文多模态理解方面表现出色。该模型集成了 Mamba 和 Transformer 模块,利用多个图像之间的时空依赖性构建数据,并采用渐进式训练策略。

csdn_xmj的博客 2050

“Transformer挑战者”-Mamba之最全详解图解

计算机领域顶会论文,CCF,SCI,EI,专利竞赛软著等1v1论文辅导!👇【立即咨询】一站式服务,短期快速投稿💥个性化的指导和顶尖的科研团队支持,助您攀登科研高峰对于计算机专业的硕博生来说,拥有一篇人工智能科研论文及专利软著竞赛是保研考研留学深造以及找工作的关键门票!!!🏃无论您是想申请研究生、博士生,还是渴望赴海外留学,或是立志进入大厂的核心岗位,一篇高质量的SCI/CCF论文是关键所在!我们的团队充满热情和专业知识,致力于为您提供卓越的科研指导和论文辅导服务。

DFCED的博客 7931

ViLT:最简单的多模态Transformer

之所以用这一篇作为多模态的开篇是因为这篇清楚的归纳了各种多模态算法,可以当成一个小综述来看,然后还提出了一种非常简单的多模态Transformer方法ViLT。先阐述一下4种不同类型的Vi...

weixin_40920183的博客 3879

Mamba线性时间序列框架超越Transformer模型?注意力机制如何翻身

是否Mamba未来会代替transformer,这个问题其实需要看不同的任务,也需要看不同的数据集,毕竟transformer模型以及统一了很多模型框架,包含NLP任务,CV计算机视觉任务,时间序列任务,基因工程等相关任务都是transformer相关模型框架,其大名鼎鼎的ChatGPT也是transformer模型。Mamba模型采用门控MLP单元,并与归一化残差连接组成新的Mamba基础模型,并使用此模型搭建整体的Mamba模型,整个模型框架并未采用transformer模型的注意力机制。

人工智能研究所的博客 1799

Windows环境下如何通过MCP Server实现MySQL安全连接与AI集成?

本文详细介绍了在Windows环境下如何通过MCP Server实现MySQL安全连接与AI集成。MCP Server作为大模型与MySQL之间的安全通道,提供权限控制、SSL加密和协议转换功能,显著提升查询性能。文章包含环境配置、安装指南、安全策略及实战案例,帮助开发者高效实现AI与数据库的安全交互。

hill8的博客 721

首个Mamba+Transformer混合架构多模态大模型来了!

多模态大语言模型(MLLMs)的快速进步展示了它们在各个应用领域中的显著能力。然而,多图像理解场景仍然是一个重要但尚未充分探索的方面。特别是,将 MLLMs 的应用场景扩展到理解更长的视频、更高分辨率的图像以及基于更多历史信息的决策,对于提升用户体验和进一步拓展 MLLMs 的应用范围至关重要。然而,将 MLLM 的上下文长度扩展以提高其可用性,面临着处理更多图像时性能下降和计算成本高昂的挑战。一些研究专注于构造包含多个图像的长上下文训练数据,以增强性能。其他研究探索了创新性的训练策略,以减轻性能下降。

weixin_72959097的博客 920

Xiaojie雷达之路---毫米波雷达基础知识---角度估计

本篇文章主要介绍毫米波雷达的基础知识中的角度估计,对于本篇文章主要回答5个问题 1.在雷达的前方,如何估计前方一个物体的角度 2.角度测量的准确性 3.如何测量多个物体的角度 4.雷达可测的角度的视场最大值为多少 5.角度分辨率取决于什么因素 文章目录估计雷达前面一个物体的角度角度测量的准确性雷达的最大角视场测量雷达前方多个距离和速度相同的物体角度分辨率角度估计的流程 估计雷达前面一个物体的角度 估计一个物体的角度,最少需要两根接收天线 发射天线发送一个chirp,经过物体发射后信号,信号分别被第一根天

XiaoJie的博客 1万+

LongLLaVA:首个Mamba+Transformer混合架构多模态大模型来了,实现单卡千图推理

多模态大语言模型(MLLMs)的快速进步展示了它们在各个应用领域中的显著能力。然而,多图像理解场景仍然是一个重要但尚未充分探索的方面。特别是,将 MLLMs 的应用场景扩展到理解更长的视频、更高分辨率的图像以及基于更多历史信息的决策,对于提升用户体验和进一步拓展 MLLMs 的应用范围至关重要。然而,将 MLLM 的上下文长度扩展以提高其可用性,面临着处理更多图像时性能下降和计算成本高昂的挑战。一些研究专注于构造包含多个图像的长上下文训练数据,以增强性能。其他研究探索了创新性的训练策略,以减轻性能下降。

Java_rich的博客 1416

论文笔记:基于对比学习的半监督分类学习方法

论文阅读笔记_CCSSL

weixin_46224126的博客 3319

从车机到广告屏:CS5523芯片在5大显示场景的应用方案全解析

本文全面解析了CS5523芯片在车载显示、数字广告机、医疗设备和工业HMI等五大场景的应用方案。作为高性能MIPI转eDP芯片,CS5523凭借出色的兼容性和低功耗特性,成为国产替代方案的优选。文章详细介绍了芯片架构、核心技术及实际应用中的设计要点,为工程师提供全面的技术参考。

julia4scientist的博客 905

首个Mamba+Transformer混合架构多模态大模型来了!实现单卡千图推理!

点击下方卡片,关注“CVer”公众号AI/CV重磅干货,第一时间送达点击进入—>【Mamba/多模态/扩散】交流群添加微信号:CVer111,小助手会拉你进群!扫描下方二维码,加入CVer学术星球!可以获得最新顶会/顶刊上的论文idea和CV从入门到精通资料,及最前沿应用!发论文/搞科研/涨薪,强烈推荐!转载自:机器之心本文作者来自于香港中文大学深圳和深圳大数据研究院。其中第一作者为香港中文...

阿木寺的博客 525

python模拟银行交易流水

模拟自动生成银行交易流水,其中包括:入账账号、出账账号、交易金额、交易余额、交易时间、出入表示关键字段

qq_31823889的博客 2911

【AI大模型】Mamba2,比Transformer速度提高了8倍!

大家好,今天为大家介绍一篇Mamba最新研究论文。本文提出了一个新框架Structured State Space Duality (SSD),通过结构化矩阵的视角,统一了State Space Model (SSM)和注意力机制。基于该框架设计的Mamba-2,其核心是对Mamba中SSM进行了改进,在与Transformer表现相当的同时,速度提高了2-8倍。

AGI_GGbond的博客 2229

MiniMax H3本地部署实战:ComfyUI整合包安装与提速插件验证指南

在AIGC工具链快速演进的当下,本地部署内容生成模型成为许多创作者和开发者的关注焦点。本地部署意味着数据不出本机、可按需定制工作流,还能规避云端排队与外部依赖,其核心价值在于为内容生产提供可控、私密且可编程的生成环境。ComfyUI作为模块化节点式AI绘画工具,凭借灵活的工作流编排和API接口能力,成为承载这类模型的热门平台。MiniMax H3作为支持文本、参考图等多种输入的内容生成模型,与ComfyUI结合后,既适合个人进行概念验证,也能用于团队私有化流程搭建。实际落地过程中,中文整合包显著降低了环境配

weixin_29042035的博客 298

PrimeTime low power-多电压设计流程(2)

get_power_switches`、`get_supply_nets` 和 `get_supply_ports` 命令的操作方式类似,并具有类似的命令选项。PrimeTime 根据 UPF 命令构建电源供应网络,包括 create_power_domain、create_supply_net、create_supply_set、create_supply_port、set_domain_supply_net 和 connect_supply_net。电源集句柄是为电源域隐式创建的一个抽象电源集。

QRBQ 713

Mamba+Transformer混合架构多模态大模型

多模态大语言模型(MLLMs)的快速进步展示了它们在各个应用领域中的显著能力。然而,多图像理解场景仍然是一个重要但尚未充分探索的方面。特别是,将 MLLMs 的应用场景扩展到理解更长的视频、更高分辨率的图像以及基于更多历史信息的决策,对于提升用户体验和进一步拓展 MLLMs 的应用范围至关重要。然而,将 MLLM 的上下文长度扩展以提高其可用性,面临着处理更多图像时性能下降和计算成本高昂的挑战。一些研究专注于构造包含多个图像的长上下文训练数据,以增强性能。其他研究探索了创新性的训练策略,以减轻性能下降。

aolan123的博客 1515

【异常】Cursor IDE 扩展主机超时错误处理文档The agent execution provider did not respond within 4 seconds.

该错误通常是 Cursor IDE 的临时性问题,不影响项目代码。大多数情况下,重新加载窗口或重启 IDE 即可解决。如果问题持续,可按上述进阶方案排查。重新加载窗口(最快)重启 IDE检查系统资源清理缓存检查扩展更多关于 AI+教育领域的干货,可以关注我的微信公众号第一时间获取哦~

奶爸的编程之路,也就一周冷个三天 2713

一文通透想颠覆Transformer的Mamba:从SSM、HiPPO、S4到Mamba(被誉为Mamba最佳解读)

如本文开头所说,mamba论文的一作Albert Gu多年来一直在推动SSM的发展他在SSM的基础上,通过此篇论文《》首次提出了结构化状态空间S4(这里有关于S4的更多论文),但这篇论文的可读性比较差当然,作者在YouTube上有一个关于这篇S4论文的精彩解读,比S4论文的可读性提高很多,且本文中也应用了其中的部分PPT截图,但还可以更加通俗易懂。

结构之法 算法之道 44万+

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

看懂Mamba,Transformer最强竞争者(三)让 Mamba 适应多样化的数据

AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!

star_nwe的博客 2250

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

Mamba vs Transformer:架构之争全解析

Mamba与Transformer架构对比分析 本文系统比较了Mamba和Transformer两种架构的核心差异。Transformer基于自注意力机制,擅长全局依赖建模但存在O(N²)复杂度问题;Mamba采用选择性状态空间模型,实现O(N)线性复杂度,适合超长序列处理。Transformer在机器翻译等需要全局上下文的任务中表现优异,而Mamba在基因组分析、实时流数据处理等场景更具优势。文章详细分析了两者在计算效率、建模能力、训练优化等方面的差异,并指出未来可能出现的融合架构趋势。

weixin_60048148的博客 3751

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

Mamba介绍,和Transformer对比

之后,又进一步提出了 Mamba-2,其中的结构化空间状态对偶(SSD/Structured Space-State Duality)构建了一个将结构化 SSM 与多种形式的注意力连接起来的稳健的理论框架,可将原本为 Transformer 开发的算法和系统优化技术迁移用于 SSM。表 1 分类总结了相关研究。然而,正如每枚硬币都有其两面,Transformer的注意力机制在赋予其卓越性能的同时,也带来了计算复杂度的显著上升,特别是当面对超长文本序列时,这种二次增长的计算需求成为了制约其应用的一大瓶颈。

u014546828的博客 4907
上一篇: 多模态大语言模型相关论文整理
下一篇: 十分钟学会微调大语言模型
大模型应用场景
博客等级 码龄5年 7683粉丝 1350原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值