这对CP太猛了!Mamba+Transformer狂刷顶会,引领AI新浪潮!

推理速度暴增,Mamba终结Transformer的统治 !! 在这篇关于 Mamba 的文章中,我们来探索这个创新的状态空间模型(state-space model,SSM)如何在序列建模领域带来革命性的变革。Mamba 是由 Albert Gu 和 Tri Dao开发的,因其在语言处理、基因组学、音频分析等领域的复杂序列时表现出色而受到关注。Mamba 采用线性时间序列建模和选择性状态空间,因此在这些不同的应用领域都展现出了卓越的性能。本文,我们将深入了解 Mamba 是如何解决传统 Transformer 在处理长序列时遇到的计算挑战的。 阅读详情

人工智能领域正迎来一场革命性的变革,Mamba与Transformer的强强联合成为学界新宠。

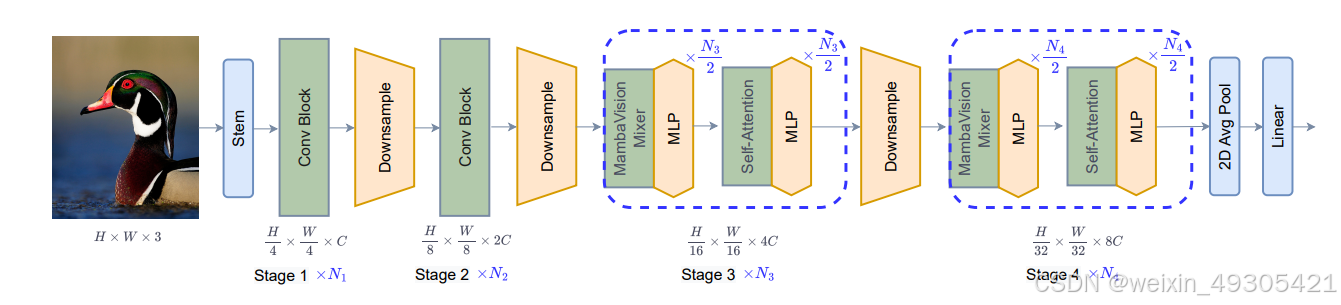
在计算机视觉前沿,英伟达团队打造的MambaVision惊艳亮相CVPR 2025。该模型采用创新的四阶段分层架构:前两阶段依托CNN层实现高分辨率特征快速提取,后两阶段巧妙融合Mamba与Transformer模块。研究团队对Mamba模块进行深度改造,用常规卷积替代因果卷积,并创新性地引入对称分支结构。这一突破性设计使MambaVision在Top-1精度和图像吞吐量上双双刷新纪录,树立了新的性能标杆。

自然语言处理领域。腾讯推出的Hunyuan-TurboS作为全球首款超大规模混合Transformer-Mamba MoE模型,开创性地解决了传统Transformer在长文本处理中的效率瓶颈。该模型充分发挥Mamba的长序列处理优势和Transformer的上下文理解能力,在训练优化和奖励机制方面均有重大创新。

这两项突破性研究开创了Mamba与Transformer融合的新范式,在各自领域树立了新的里程碑。

当前该领域研究热度持续升温,成果频出。我精选12篇前沿论文,为研究者深入理解这一技术趋势提供有力参考。

【论文精读】MambaVision:混合视觉骨干网络新标杆
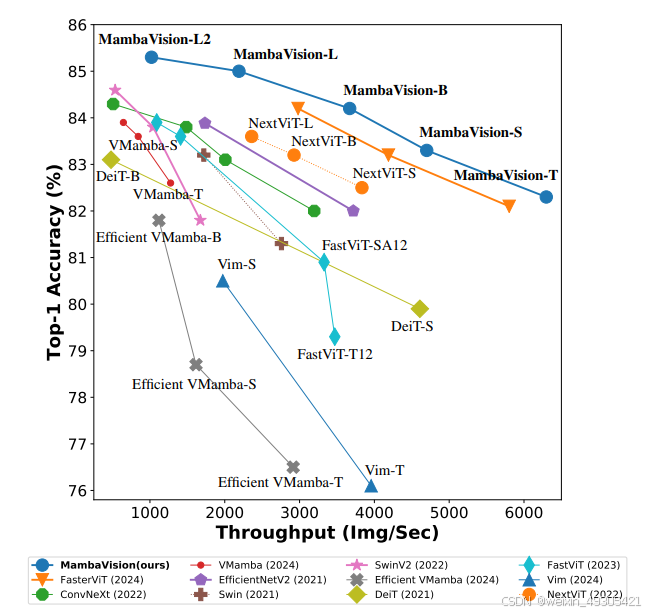
ImageNet-1K数据集上的Top-1精度与图像吞吐量对比

1. 创新架构解析

MambaVision分层模型架构

MambaVision采用独特的四阶段分层架构:

  • 前两阶段:基于CNN层实现高分辨率特征快速提取,采用特定残差块公式
  • 后两阶段:创新融合MambaVision与Transformer模块
  • 特征处理:图像输入转换为重叠补丁并投影至嵌入空间
  • 分辨率优化:通过批归一化的3×3 CNN层实现阶段间下采样

关键技术突破:

  • Mamba模块重构:用常规卷积替代因果卷积,新增无SSM对称分支
  • 特征融合:采用通用多头自注意力机制,显著提升视觉任务性能

2. 核心创新亮点
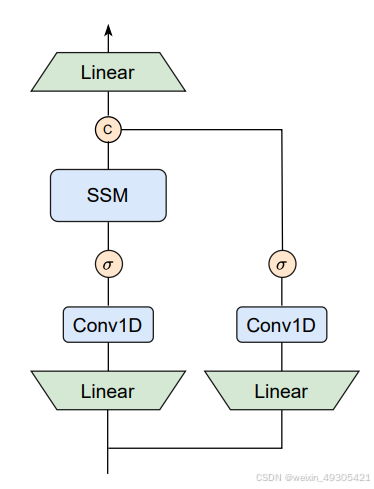
MambaVision模块架构

  • Mamba模块重构:优化原始架构,专为视觉任务定制,实现精度与吞吐量双提升
  • 混合架构探索:系统研究Mamba与Transformer集成模式,发现后期融入自注意力模块可显著增强全局上下文捕捉能力
  • 性能突破:在ImageNet-1K数据集上实现Top-1准确率和图像吞吐量双SOTA,全面超越Mamba、CNN和ViT模型

论文链接:https://arxiv.org/pdf/2407.08083

【腾讯重磅发布】Hunyuan-TurboS:超大规模混合Transformer-Mamba MoE模型

1. 技术架构解析
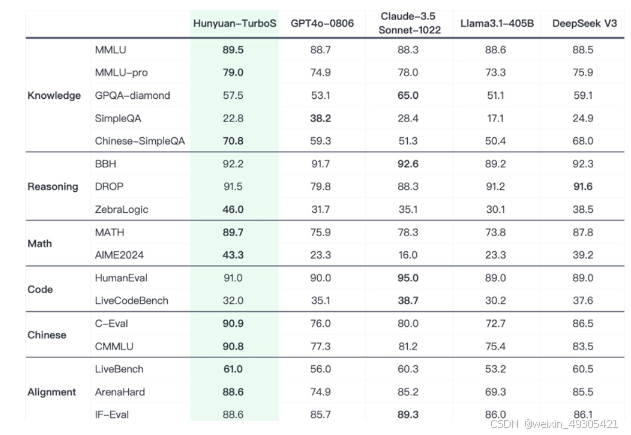
Hunyuan-TurboS模型架构

Hunyuan-TurboS开创多项原创性技术:

  • 架构创新:融合Mamba与Transformer优势,Mamba将长文本处理复杂度降至O(n),显著降低缓存占用,Transformer确保上下文深度理解
  • 训练优化:引入慢思考机制提升数理推理能力,通过精细化指令调优增强人机交互体验
  • 奖励机制:创新性整合规则评分、代码沙箱反馈和生成式奖励,确保输出质量

2. 创新亮点
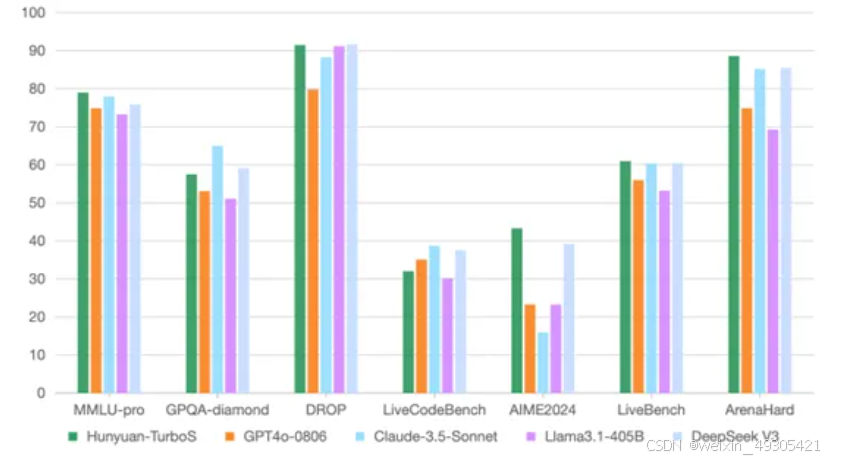
模型创新特性

架构创新
  • 混合架构:开创性融合Mamba与Transformer,实现显存与计算效率双优化
  • MoE机制:采用动态专家混合机制,长文处理成本降低超60%
训练优化
  • 慢思考集成:整合混元T1慢思考模型数据,显著提升数学、编程和推理任务表现
  • 指令调优:精细化指令调优增强模型对齐性,优化Agent执行能力
  • 英语优化:针对性英语训练优化,提升全球场景适用性
奖励系统
  • 规则评分:基于规则的评分验证机制确保输出可靠性
  • 代码沙箱:引入代码沙箱反馈,显著提升STEM领域准确性
  • 生成式奖励:创新性采用生成式奖励优化问答与创意任务

项目链接:https://x.com/TXhunyuan/status/1899105803073958010

【Mamba和Transformer的关系】 Mamba 和 Transformer 都是深度学习模型架构,用于处理序列数据(如自然语言、时间序列等),但它们的核心机制和计算方式有所不同。KV 缓存(Key-Value Cache):为了优化推理时的计算量,Transformer 会缓存已计算的 key 和 value,但仍然受到存储和计算限制。计算复杂度 O(N²):注意力机制的计算量随着序列长度 N 的增加呈二次增长,因此在处理超长序列时成本高昂。Mamba 不是 Transformer 的直接替代,而是对长序列任务的一种更高效的架构选择。 阅读详情

相关推荐

Mamba深度革命:线性序列建模的终极杀器——5倍于Transformer的速度,开启长文本处理新纪元

Mamba是一种​​基于状态空间模型(SSM)的序列建模架构​​,通过​​动态token选择机制​​实现线性时间复杂度,彻底解决Transformer的二次方复杂度瓶颈。其核心是​​"选择性记忆"​​:像人脑一样动态决定记住或忽略哪些信息。​​输入处理​嵌入层将10万Token的文档动态压缩:2万关键Token(如专业术语、实体名词)分配512维8万普通Token(如介词、连词)分配64维​​Mamba块处理​​​关键Token路径​​:SSM建模跨段落依赖(如论点之间的逻辑关系)

qq_43664407的博客 2781

一文通透想颠覆Transformer的Mamba:从SSM、HiPPO、S4到Mamba(被誉为Mamba最佳解读)

如本文开头所说,mamba论文的一作Albert Gu多年来一直在推动SSM的发展他在SSM的基础上,通过此篇论文《》首次提出了结构化状态空间S4(这里有关于S4的更多论文),但这篇论文的可读性比较差当然,作者在YouTube上有一个关于这篇S4论文的精彩解读,比S4论文的可读性提高很多,且本文中也应用了其中的部分PPT截图,但还可以更加通俗易懂。

结构之法 算法之道 44万+

Vmware Vcenter7.0证书web续期发生错误

生成证书,选择第三个(PS,如果没有域名的,一定要写IP,不然很容易卡在85%,服务不能起来)这里大概率可能是证书里面的FQDN和主机不匹配,又或者是主机解析FQDN有问题。vCenter _MACHINE_CERT快到期了,通过web界面更新证书失败。vSphere Client 版本 7.0.2.00200。登陆ssh到vcenter,重新生成证书。先关掉HA,不然证书管理会报错。第一步先这样,重新续订一下证书。

m0_74823595的博客 3944

挑战Transformer:全新架构Mamba详解!

作者|绝密伏击 编辑|汽车人原文链接:https://zhuanlan.zhihu.com/p/684231320点击下方卡片,关注“自动驾驶之心”公众号戳我-> 领取自动驾驶近15个方向学习路线>>点击进入→自动驾驶之心『Mamba』技术交流群本文只做学术分享,如有侵权,联系删文背景“屹立不倒的 Transformer 迎来了一个强劲竞争者。自 2017 年被提出以来...

CV_Autobot的博客 8186

BUCK 电路详解

参考内容: 手撕Buck!Buck公式推导过程 电力电子的基础应用 《精通开关电源设计(第二版)》 Buck电源芯片输出有问题?检查这几样 原来PWM这么简单! BUCK 电路构建 根据高中所学习的物理知识可以很容易的想到,使用一个滑动变阻器即可实现降压和稳压的效果。当负载波动时,通过改变滑动变阻器的阻值,可以调节负载所获得的电压。但是使用滑动变阻器的劣势也很明显,大量的耗能会导致器件温度快速升高。 上面所提到的电路主要缺点在于导通器件(变阻器或三极管)本身存在耗能,那么有没有不会耗能的导通器件呢?

Guanngxu的博客 3985

SRv6第二弹:SRv6基本概念

在SRv6网络编程中,不同的转发行为由不同的Function来标识,例如在RFC中定义了公认的End、End.X、End.DX4、End.DX6等。例如:R3使用报文的IPv6目的地址FC03::3查找Local SID表,命中到End SID,随后R3将报文SL减1,同时将SL=1的SID做为报文目标IPv6地址,并查路由表转发出去。SID支持静态配置或者动态分配,end-op、end、end.x、end-dt4、end-dt6、end-dx2推荐静态配置 ,便于网络运维,其他的SID可以动态分配。

wbyyy的博客 4247

Mamba VS Transformer,谁主沉浮?

点击蓝字关注我们AI TIME欢迎每一位AI爱好者的加入!Transformer作为当前序列建模领域的主导模型,取得了巨大的成功。但是,随着技术的发展,一些全新的架构也开始崭露头角,其中最引人注目的便是Mamba。那么,Mamba能否真正颠覆Transformer的地位?它的优势和不足又是什么?2024年4月11日,AI TIME举办的第19期PhD Debate活动邀请了上海交通大学人工智能教育...

AITIME_HY的博客 5300

Android 10.0 任务栏音乐播放器后台播放杀进程功能实现

在10.0的系统rom定制化开发过程中,在某些情况下在安装第三方播放器以后,播放音乐的时候,在最近任务栏recents列表中,点击全部清除,发现音乐播放器还在播放音乐,导致出现bug,完整的 解决方法,肯定是需要点击全部清除以后,音乐播放器也被杀掉进程,接下来看下这个问题怎么解决

安卓兼职framework和app工程师的博客 651

【论文笔记】Mamba:挑战Transformer地位的新架构

Mamba的论文笔记

qq_41234663的博客 5742

训练救星!EMA多尺度注意力让YOLOv11轻松攻克自定义数据集不涨点难题

在目标检测模型训练中,自定义数据集不涨点是阻碍算法落地的核心痛点之一。传统训练策略在数据分布特殊、样本量有限的场景下极易陷入收敛停滞,而 EMA(指数移动平均)结合多尺度注意力的方案,在自定义数据集上实现mAP 提升 6.5%,同时让训练曲线从“平缓停滞”转为“持续攀升”,彻底解决创新点在自有数据上的性能瓶颈。本教程将带你从原理到实践,通过 EMA 多尺度注意力为 YOLOv11 注入训练稳定性,让你的自定义数据集模型训练实现质的飞跃。EMA 衰减率:小样本数据集建议将decay。

FJN110的博客 160

ZED双目相机环境配置

ZED SDK 安装文件夹中有一个 Python 脚本(get_python_api.py),可以自动检测操作系统、CUDA 和 Python 版本并下载相应的预编译 Python API 包(pyzed)。安装SDK成功后,我们进入ZED SDK文件夹中的tools子文件夹,运行ZED Explorer.exe 以及 ZED Depth Viewer.exe,查看ZED相机是否能正常启用工作。在本例中,我们简单地检索ZED相机的序列号:打开 ZED相机,然后打印其序列号,然后关闭相机。

qq_53545309的博客 2136

Mamba+Transformer,可实现超Transformer5倍吞吐量!

Mamba-Transformer专家模型:提出了一个多尺度混合Mamba-Transformer专家模型(SST),通过结合Mamba和Local Window Transformer(LWT)来分别处理长时序的全局模式和短时序的局部变化。综合性能提升:在多个领域和任务中,SSMs展现出与Transformer竞争的性能,特别是在语言领域任务中,SSMs在标准回归上下文学习(ICL)任务中表现出色,与Transformer相比,在稀疏奇偶性学习任务中表现更优。

2401_88556812的博客 2423

恒玄BES调试笔记-BES2500如何Dump Anc Audio数据

从YP的4M flash改HP3的2M flash只需要改: 原工程:target.mk的export FLASH_SIZE ?= 0x200000和common.mk里的KBUILD_CPPFLAGS += -DNEW_IMAGE_FLASH_OFFSET=0x100000 OTA工程:target.mk的NEW_IMAGE_FLASH_OFFSET ?= 0x100000和FLASH_SIZE ?= 0x200000 ...

leezs的博客 1672

Transformer详解(李沐大神文字版,干货满满!)

使用图和文字记录下了李沐大神的Transformer论文逐段精度视频,方便大家后续快速复习。

qq_42068614的博客 6913

回归预测 | MATLAB实现MPR多元多项式回归

回归预测 | MATLAB实现MPR多元多项式回归

机器学习之心的博客,关注并私信文章链接,获取对应文章源码和数据。 1645

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

颠覆Transformer!新架构Mamba引爆AI圈!

点击下方卡片,关注“CVer”公众号AI/CV重磅干货,第一时间送达点击进入—>【视觉和Transformer】微信交流群扫码加入CVer知识星球,可以最快学习到最新顶会顶刊上的论文idea和CV从入门到精通资料,以及最前沿项目和应用!发论文,强烈推荐!在CVer微信公众号后台回复:Mamba,即可下载论文pdf和代码链接!快学起来!转载自:机器之心 |编辑:张倩、蛋酱屹立不倒的 Tran...

阿木寺的博客 732

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

一文看懂Mamba,Transformer最强竞争者

来源:机器之心Mamba虽好,但发展尚早。深度学习架构有很多,但近些年最成功的莫过于 Transformer,其已经在多个应用领域确立了自己的主导地位。如此成功的一大关键推动力是注意力机制,这能让基于 Transformer 的模型关注与输入序列相关的部分,实现更好的上下文理解。但是,注意力机制的缺点是计算开销大,会随输入规模而二次增长,也因此就难以处理非常长的文本。好在前段时间诞生了一种颇具潜力...

weixin_40920183的博客 1053

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

Mamba vs Transformer:架构之争全解析

Mamba与Transformer架构对比分析 本文系统比较了Mamba和Transformer两种架构的核心差异。Transformer基于自注意力机制,擅长全局依赖建模但存在O(N²)复杂度问题;Mamba采用选择性状态空间模型,实现O(N)线性复杂度,适合超长序列处理。Transformer在机器翻译等需要全局上下文的任务中表现优异,而Mamba在基因组分析、实时流数据处理等场景更具优势。文章详细分析了两者在计算效率、建模能力、训练优化等方面的差异,并指出未来可能出现的融合架构趋势。

weixin_60048148的博客 3739

Mamba架构第一次做大!混合Transformer,打败Transformer

丰色 发自 凹非寺量子位 | 公众号 QbitAI精彩精彩,第一个把爆火Mamba架构真正扩展到足够大的工作来了。520亿参数,还是Mamba+Transformer混合架构。它的名字叫Jamba。取两种架构之长,模型质量和效率兼得,要吞吐量有吞吐量,要低内存有低内存。初步跑分显示:Jamba性能总体接近Mixtral 8x-7B,处理128k长上下文时吞吐量却是其3倍。一共支持256k上下文,而...

量子位 363

Mamba详细介绍和RNN、Transformer的架构可视化对比

看完这篇文章,我希望你能对Mamba 和状态空间模型有一定的了解,最后我们以作者的发现为结尾:作者发现模型与相同尺寸的Transformer模型的性能相当,有时甚至超过了它们!作者:Maarten Grootendorst。

deephub 1万+

Mamba:能取代Transformers吗?

SSM是Mamba的核心,因此了解它们的工作方式很重要。我们可以将它们视为变压器中自注意机制的替代品。状态空间模型(SSM)提供了一种有效表示和分析序列的结构化方法。在神经网络的上下文中,SSM可以用作处理序列的层,其核心概念是将输入信号映射到潜在状态,然后映射到输出信号。SSM的更新和输出方程为:在这里,A,B,C和D是定义系统动力学的矩阵,其中A表示状态的演变,B表示输入对状态的影响,C表示状态如何转化为输出,D表示输入到输出的直接传递。

数智笔记 2115

Mamba介绍,和Transformer对比

之后,又进一步提出了 Mamba-2,其中的结构化空间状态对偶(SSD/Structured Space-State Duality)构建了一个将结构化 SSM 与多种形式的注意力连接起来的稳健的理论框架,可将原本为 Transformer 开发的算法和系统优化技术迁移用于 SSM。表 1 分类总结了相关研究。然而,正如每枚硬币都有其两面,Transformer的注意力机制在赋予其卓越性能的同时,也带来了计算复杂度的显著上升,特别是当面对超长文本序列时,这种二次增长的计算需求成为了制约其应用的一大瓶颈。

u014546828的博客 4902

2025年,Mamba 与 Transformer “联姻”,视觉领域迎来了大动作!

【AI架构革新:Mamba与Transformer融合引领2025新趋势】计算机视觉与自然语言处理领域迎来重大突破:英伟达团队提出的MambaVision混合架构入选CVPR2025,通过CNN与改进型Mamba-Transformer的层级组合,在保持高精度的同时提升处理速度;腾讯Hunyuan-TurboS成为首款结合两种架构的MoE模型,突破长序列处理瓶颈。Dimba等创新模型采用交替堆叠设计,实现线性复杂度与全局注意力的优势互补。研究显示,混合架构在图像生成(FID指标)和语义理解(T2I-Comp

2501_91624122的博客 1550

Transformer、RNN和Mamba的联系!

本文深入探讨了Transformer、循环神经网络(RNN)和状态空间模型(SSM)之间的潜在联系。文章首通过这些分析,展示了看似不同的模型架构之间存在深层联系,为未来模型设计和跨架构思想交流提供了新的视角和可能性。​。

xxue345678的博客 1022

Mamba vs Transformer:为什么这个新模型在长文本处理上更胜一筹?

本文深入探讨了Mamba模型在长文本处理上的技术突破,相比传统Transformer架构,Mamba通过选择性状态空间模型(SSM)和选择性扫描算法,将计算复杂度从二次方降为线性,显著提升了处理效率和性能。文章通过基准测试和实际案例展示了Mamba在长文本理解、代码生成等任务中的优势,并提供了技术实现和优化策略的详细分析。

weixin_42523711的博客 265

太能打了!Mamba+Transformer,仅用一半时间准确率提升12%!

CVPR'2025谷歌DeepMind提出的分层协同混合架构创新性地结合Transformer与Mamba优势,突破长序列处理瓶颈:在256K文本分析中实现3倍吞吐提升,1024×1024卫星图像分割速度提高8倍,工业视频异常检测耗时缩减83%且准确率提升12%。同时,跨模态领域涌现新突破——MHAFF方法通过多头注意力融合CNN与Transformer特征,将牛只识别准确率推至99.88%;水稻病害检测研究则证实ResNet50结合迁移学习优于ViT和传统方法。这些进展为工业质检、农业智能

m0_73122726的博客 555
上一篇: 全局+局部特征融合杀疯了!HCF-Net与DVLO双雄并起!
下一篇: 高效涨点神器!时间序列+KAN,成科研圈顶流组合,刷爆SOTA!
AI十八式
博客等级 码龄2年 377粉丝 56原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值