5个高效的数据科学Python库

python保存数据方法总结 python保存数据的不同方法 阅读详情

简介

数据科学既鼓舞人心又具有挑战性。对数据进行预处理、清洗,并通过绘制各种图表从数据中生成洞察力,以及微调模型以获得最佳结果都是相当艰巨的工作。

在本文中,将介绍五个能够自动化这些过程的Python库,从而节省时间并提高工作效率。

只需几行代码,就可以生成全面的报告、调整超参数,甚至部署机器学习模型。言归正传,接下来开始阅读本文。

为了进行数据分析和模型搭建,本文将使用鸢尾花数据集。可以在如下链接中找到数据。本文将使用如下存储库来预览HTML文件。

【鸢尾花数据集】:https://www.kaggle.com/datasets/uciml/iris

【存储库】:https://github.com/htmlpreview/htmlpreview.github.com

# 导入pandas库
import pandas as pd

# 加载数据
data = pd.read_csv('Iris.csv')

以下是提高工作效率的五个库:

SweetViz

这是一个开源的Python库,主要用于探索性数据分析(EDA)。只需几行代码,该库就能生成带有图表和可视化的全面报告。

这些报告以HTML或Jupyter Notebook格式生成,便于查看和分享。此外,报告还包括相关性分析(HeatMaps)、直方图和各种其他可视化效果。

还可以通过指定目标变量、更改图表类型甚至改变布局来自定义报告。此外,还可以比较两个不同的数据集,并生成有用的洞察。

要安装该库,请在命令提示符中输入以下代码:

pip install sweetviz

要为数据集生成报告,可以使用analyze函数。

# 导入SweetViz
import sweetviz

# 生成报告
report = sweetviz.analyze(data)

# 要保存报告的HTML格式,请使用以下代码:
report.show_html()

# 要在Jupyter Notebook中查看报告,请使用以下代码:
report.show_notebook()

HTML报告的样式如下:
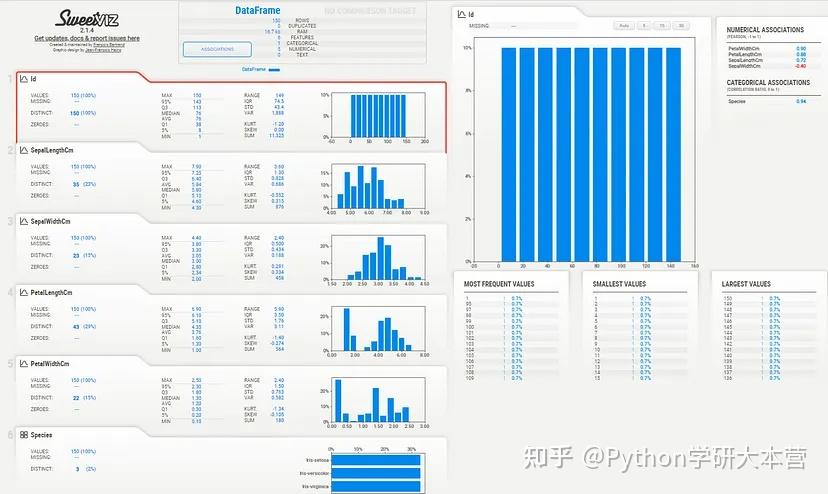
SweetViz HTML报告

要了解更多关于该库及其功能的信息,可以查看如下链接的文档。

【文档】:https://pypi.org/project/sweetviz/

Pandas Profiling

Pandas库提供了各种函数用于分析数据,包括data.info()、data.isnull()、data.describe()等。然而,逐个应用这些函数可能需要相当长的时间。

通过使用Pandas Profiling库将这些过程自动化,可以仅凭几行代码就生成全面的报告。该库与SweetViz非常相似,但它提供了更多的功能。

要安装该库,请在命令提示符中输入以下代码:

pip install pandas-profiling

可以使用ProfileReport生成报告。

# 导入ProfileReport
from pandas_profiling import ProfileReport

# 生成报告
report = ProfileReport(data)

报告分为多个部分,包括:

  1. 概述部分:

在这个部分,可以找到变量的类型、重复行、缺失值以及观测值的总数等信息。

  1. 警报部分:

在这一部分,可以了解到变量的分布、变量之间的相关性以及与数据集相关的问题。

  1. 重现:

它提供了有关分析开始和结束日期的信息。此外,它还告诉我们执行整个分析所花费的时间。

  1. 变量:

在这个部分,可以对所选的任何特征执行单变量分析。它提供了有关特征的信息,如平均值、中位数、不同值的数量等。

  1. 交互:

此部分的目的是执行双变量分析。使用它,可以绘制任意两个特征之间的散点图。

  1. 相关性:

这个部分包括一个热力图,显示两个变量之间的相关性。

  1. 缺失值:

在这个部分,展示了一个缺失值矩阵,可以可视化数据集中的缺失值。

  1. 样本:

允许查看数据集的前10行和后10行,类似于data.head(10)和data.tail(10)。

要了解更多关于该库及其功能的信息,可以使用如下链接查看文档。

【文档】:https://ydata-profiling.ydata.ai/docs/master/index.html

LazyPredict

在某些情况下,希望对数据集应用不同的机器学习模型,并确定哪个模型能提供最佳结果。手动导入模型并对其进行训练可能是一个费时费力的过程。在这种情况下,LazyPredict库非常有用。

LazyPredict是一个自动机器学习的开源Python库,可以在不调整超参数的情况下对各种模型进行比较。只需几行代码,就可以训练和比较各种机器学习模型。它既可用于分类问题,也可用于回归问题。

要安装该库,请在命令提示符中输入以下代码:

pip install lazypredict

使用该库,找到Iris数据集的最佳模型:

# 分离目标变量和其他数据
y = data['Species']
data.drop('Species',inplace=True,axis=1)
X = data

# 将数据集拆分为训练数据和测试数据
X_train, X_test, y_train, y_test = train_test_split(X, y,test_size=.5,random_state =1)

clf = LazyClassifier(verbose=0,ignore_warnings=True, custom_metric=None)

# 训练模型
models,predictions = clf.fit(X_train, X_test, y_train, y_test)

# 输出结果
models
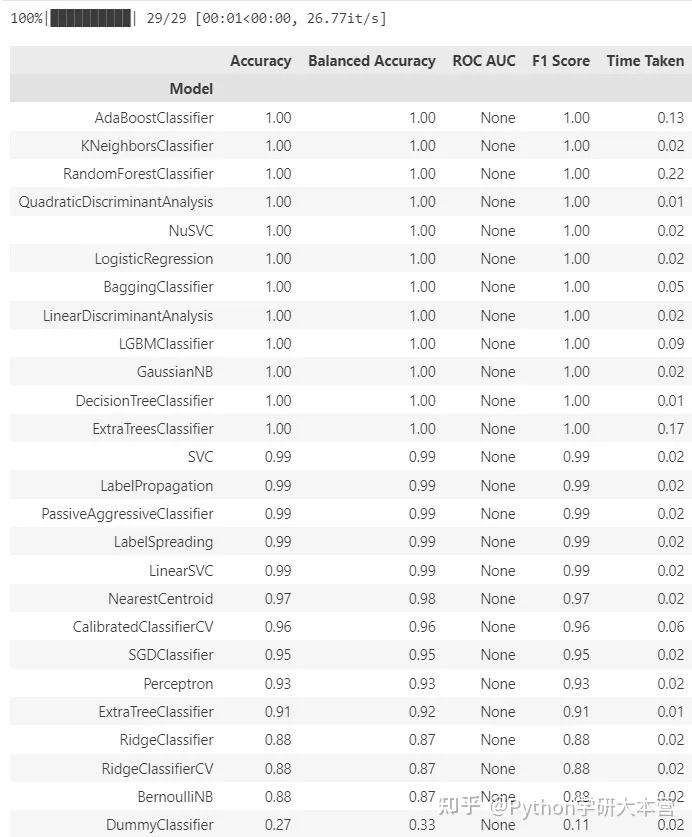
LazyPredict输出

它根据多种指标对模型进行比较,包括准确率、F1分数和执行时间等。

要了解更多关于该库及其功能的信息,可以查看如下GitHub存储库。

【GitHub存储库】:https://github.com/shankarpandala/lazypredict

FLAML

与LazyPredict类似,FLAML允许比较不同的机器学习模型,但它也能帮助调整超参数并选择最佳模型。

FLAML是由微软开发的,使用了微软研究院开发的超参数优化和模型选择系统。

在FLAML中,默认模型为LightGBM、XGBoost、随机森林等。用户还可以添加模型并指定训练模型的时间限制。

要安装该库,请在命令提示符中输入以下代码:

pip install flaml

使用FLAML寻找最佳模型:

from flaml import AutoML
from sklearn.preprocessing import LabelEncoder
from sklearn.model_selection import train_test_split

# 分离目标变量和其他数据
y = data['Species']
data.drop('Species',inplace=True,axis=1)
X = data

# 使用Label Encoder将分类变量转换为数值变量
label_endcoder = LabelEncoder()
y = label_endcoder.fit_transform(y)

# 将数据集拆分为训练数据和测试数据
X_train, X_test, y_train, y_test = train_test_split(X, y,test_size=.5,random_state =1)

automl = AutoML()

# 训练模型
automl.fit(X_train, y_train, task="classification")

要找出最佳模型,请使用以下代码:

automl.best_estimator

在这种情况下,最佳模型是xgb_limitdepth。

要获取最佳模型的超参数信息,请输入以下代码:

automl.best_config

外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传

最佳模型的超参数信息

要了解有关该库及其功能的更多信息,请点击如下链接查看文档。

【文档】:https://microsoft.github.io/FLAML/

PyCaret

开发PyCaret的初衷是减少编码时间,将更多时间用于分析数据。它是一款端到端的模型管理工具,可以帮助实现机器学习流程的自动化。

PyCaret可自动完成特征工程、缺失值估算、超参数调整甚至部署模型。

作为数据准备过程的一部分,PyCaret允许执行归一化、缩放、使用主成分分析(PCA)进行特征选择、离群值去除以及许多其他功能。

在训练阶段,可以添加和移除模型,指定时间限制,比较不同的模型,并绘制各种图表,例如ROC曲线。

该模型可以部署在AWS、Google Cloud Platform(GCP)或Microsoft Azure上。还可以将转换流程和训练后的模型对象保存为pickle文件,并随时检索它们。

要安装该库,请在命令提示符中输入以下代码:

pip install pycaret

准备数据:

from pycaret.classification import *

# 加载数据,定义目标变量,并使用z-score对数据进行归一化处理
clf = setup(data = data, target = 'Species',normalize=True,
             normalize_method='zscore'))

外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传

设置数据

寻找最佳模型:

# 比较模型
compare_models()

最佳模型

绘制逻辑回归的ROC曲线:

lr = create_model('lr')

# 绘制ROC曲线
plot_model(lr, plot = 'auc')
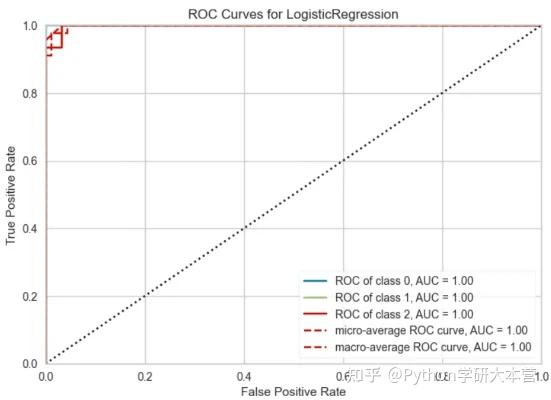
ROC曲线

保存模型:

# 将模型保存为pikle文件(pipeline.pkl)
save_model(lr,'pipeline')

保存模型

要了解更多关于该库及其功能的信息,可以点击如下链接查看文档。

【文档】:https://pycaret.gitbook.io/docs/

关于Python学习指南

学好 Python 不论是就业还是做副业赚钱都不错,但要学会 Python 还是要有一个学习规划。最后给大家分享一份全套的 Python 学习资料,给那些想学习 Python 的小伙伴们一点帮助!

包括:Python激活码+安装包、Python web开发,Python爬虫,Python数据分析,人工智能、自动化办公等学习教程。带你从零基础系统性的学好Python!

👉Python所有方向的学习路线👈

Python所有方向路线就是把Python常用的技术点做整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。(全套教程文末领取)

在这里插入图片描述

👉Python学习视频600合集👈

观看零基础学习视频,看视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。

在这里插入图片描述

温馨提示:篇幅有限,已打包文件夹,获取方式在:文末

👉Python70个实战练手案例&源码👈

光学理论是没用的,要学会跟着一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。

在这里插入图片描述

👉Python大厂面试资料👈

我们学习Python必然是为了找到高薪的工作,下面这些面试题是来自阿里、腾讯、字节等一线互联网大厂最新的面试资料,并且有阿里大佬给出了权威的解答,刷完这一套面试资料相信大家都能找到满意的工作。

在这里插入图片描述

在这里插入图片描述

👉Python副业兼职路线&方法👈

学好 Python 不论是就业还是做副业赚钱都不错,但要学会兼职接单还是要有一个学习规划。

在这里插入图片描述

👉 这份完整版的Python全套学习资料已经上传,朋友们如果需要可以扫描下方优快云官方认证二维码或者点击链接免费领取【保证100%免费】

高效Python库:加速数据科学工作流的8个利器 通过合理选用这些工具,可将典型数据科学项目的开发效率提升40%以上,同时降低代码维护成本。建议从1-2个库开始试点,逐步构建自动化工作流。在数据科学项目中,编码和计算时间往往是主要瓶颈。本文精选8个Python库,助你自动化流程、减少重复代码,显著提升效率。:从Terality/PyCaret开始,逐步掌握高级优化工具。:PyCaret可作为基础框架,配合其他库增强特定环节。 阅读详情

相关推荐

用Seurat和ComplexHeatmap绘制单细胞marker基因热图:从数据处理到可视化全流程

本文详细介绍了使用Seurat和ComplexHeatmap绘制单细胞marker基因热图的全流程,涵盖从数据处理、基因筛选、平均表达矩阵计算到高级可视化与注释添加。重点解析了如何利用ComplexHeatmap生成发表级热图,并整合热词信息,解决单细胞数据可视化中的常见问题,提升科研图表质量。

weixin_29048775的博客 530

【数据科学】Python开源库数据集大全(附代码)

还在发愁找不到合适的数据集嘛? 本文介绍了数据科学中常用的数据集库及加载代码,包括scikit-learn、NLTK、TensorFlow Datasets、Keras Datasets、Statsmodels、Seaborn等。

WHYbeHERE的博客 6760

告别Keil!用VSCode+PlatformIO玩转STC单片机(附自动下载配置)

本文详细介绍了如何从Keil迁移到VSCode+PlatformIO进行STC单片机开发,包括环境搭建、自动下载配置等实用技巧。通过对比传统IDE与现代工具链的差异,展示了VSCode+PlatformIO在代码编辑体验、跨平台支持和开发效率上的优势,帮助开发者实现更流畅的STC单片机开发流程。

weixin_27252001的博客 458

数据分析常用的 10 个 python 库

不管你是处理杂乱无章的数据、将洞见转化为可视化展示,还是构建预测模型,这些工具都能为你在数据分析师的职业道路上取得卓越成就提供所需的一切。先从一些小项目练起,不久之后,你就能轻松应对现实世界中的各种数据难题。数据分析的 10 个最佳 Python 库-阿里云开发者社区。

w929358532的博客 7542

Apache-Plc4x-Modbus-Tcp学习记录(一)

Apache-Plc4x-Modbus-Tcp学习记录(一)

weixin_45325423的博客 6988

PTA 7-8 暴力小学(二年级篇)-求出4个数字 (10分)java

PTA 7-8 暴力小学(二年级篇)-求出4个数字 (10分)java 小博是新城小学二年级学生,这孩子人很老实,数学、语文成绩都是中等。不过一旦坐在电脑前,写起代码来,则有些霸气侧漏,尤其擅长各种暴力方法。本题就是数学莫老师的题目之一,请你和小博一起暴力求解吧。 输入格式: 第一行给出这个和N(图中例子的和N为2000)。 输出格式: 第一行输出所有解的数目K,随后K行按照DCBA 4位数字从...

qryzhfj的博客 2188

盘点数据科学最流行的29个Python库,数据分析必看

导读: 我们都着眼于如何使用现有的库来避免重复工作,从而使程序开发工作事半功倍。 通常,开发大量原始代码是一个费时费力的工作,为了避免这种情况,我们会尽可能多地使用库中已有的类来创建对象,通常仅需要一行代码。 因此,库能够帮助我们使用适量的代码执行重要的任务。 本文介绍数据科学中会经常使用多种Python标准库、数据科学库和第三方库。 01 Python标准库 16 / 29 Python标准库提供了丰富的功能,包括文本/二进制数据处理、数学运算、函数式编程、文件/目录访问、数据持久

码农黑羽的博客 2040

虚幻UE 增强输入-触发器

输入触发器(UInputTrigger): 使用经过修饰器修改的输入值,或者使用其他输入动作的输出值,来确定是否激活输入动作。

UE成长之路,欢迎大家的关注! 5464

Python数据分析必学的8个核心库

Python所有方向路线就是把Python常用的技术点做整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。

2401_85428892的博客 1845

【任何电机可使用的七段式s曲线-----包括matlab代码和simulink仿真】

S形加加速(T1)→>匀加速(T2)→减加速(T3)→>匀速(T4 )>加减速(T5)>匀减速(T6)-→>减减速(T7)

weixin_44312889的博客 6309

自动驾驶传感器选型实战:摄像头、激光雷达与毫米波雷达融合策略

自动驾驶感知系统的核心在于多传感器协同,而非单一技术优劣。摄像头擅长语义识别但受光照和天气制约;激光雷达提供高精度测距却面临成本、温漂与多径干扰等物理瓶颈;毫米波雷达则以全天候鲁棒性与精准测速成为安全底线的守门人。三者融合不是简单叠加,而是基于场景约束(如暴雨、强光、高速跟车)、成本边界(BOM控制)与时间窗口(量产节奏)的工程权衡。真实量产方案中,‘纯视觉’实为视觉主责+毫米波兜底,‘激光雷达上车’本质是用硬件真值加速算法迭代,而传统车企更倾向以毫米波为仲裁者协调冲突。理解这些底层原理,才能在传感器选型、

weixin_32495691的博客 276

发掘数据科学的5款宝藏Python库:提升效率的隐藏利器

许多优秀的库可能在Pandas、Scikit-learn、Seaborn等流行库的光芒下默默无闻。事实上,在某些特定场景下,这些隐藏的宝藏库甚至比主流库表现得更好。 本文将带你探索5个鲜为人知但实用性极高的数据科学Python库,助力你的数据科学工作更上一层楼。

Xianxiancq的博客 653

Microsemi Libero系列教程(全网首发)

关于Libero IDE和Libero SoC Libero分为Libero IDE和Libero SoC,Libero IDE最新版本是v9.2 SP3(2016年4月4日)已经不再更新维护了,而Libero SoC是Libero IDE的升级版,官方推荐的开发工具,文中的Libero指的是Libero SoC。 Libero SoC Libero® SoC是Microsemi(美高森美)官方...

whik1194的博客 2万+

独家 | 数据科学家应该了解的5个 Python库(附链接)

作者:Artem Shelamanov 翻译:陈之炎 校对:赵茹萱 本文约2800字,建议阅读5分钟 本文介绍了机器学习库,并掌握了模型架构之后,便可以训练模型解决现实问题。如果你是一位初级或中级的机器学习工程师或数据科学家,这篇文章非常适合你。在选定了你偏爱的机器学习库,如PyTorch或TensorFlow,并掌握了模型架构之后,便可以训练模型解决现实问题。在本篇博文中,我会介绍我认...

数据派THU 135

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

机器学习算法那些事 | 数据算法工程师必须掌握的5个Python库

如果你是一名初学者或中级机器学习工程师或数据科学家,这篇文章非常适合你。你已经选择了自己喜欢的机器学习库,比如PyTorch或TensorFlow,并且掌握了选择模型正确架构的技巧。你还能够训练模型并解决现实世界的问题。但接下来呢?

csdn_xmj的博客 996

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

python爬虫库是什么意思最近那么火_大数据分析必备的5款Python爬虫库分别是什么?优缺点分别是什么?...

“大数据”是一种新的处理模型,具有更强大的决策能力,洞察力和流程优化功能,适应大规模,高增长和多样化的信息资产。在数据科学或人工智能领域,除算法外,最重要的是数据。甚至可以说,最终确定模型准确性的不是算法,而是数据。实际上,缺乏足够的数据已成为数据分析师获得出色模型的主要障碍。值得庆幸的是,现在Web爬虫技术已经相当成熟,合格的数据分析师或人工智能模型设计人员或多或少会精通几种Web爬虫技术。Py...

weixin_28756347的博客 314

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

数据科学入门与实战1(numpy)

一 导学 数据科学工作流(IOSEMN): Inquire(调查) Obtain(获取,python) Scrub(清洗,numpy、pandas) Explore(探索,matplotlib) Model(模型,TensorFlow、scikit-learn) iNterpret(展示,boken) 使用工具,anaconda平台和jupyter-notebook编译器 数据科学...

zongzhengyingzhe的博客 470

8个可以提高数据科学工作效率并节省宝贵时间的Python库

这种不同的方法意味着它不是无意义的地尝试每一个值,而是在尝试之前寻找最佳候选者,这样可以节省时间,否则这些时间会花在尝试没有希望的替代品上。

一个爱折腾的玩家 19

「Python数据科学」数据科学的概念及Python常用数据科学库

本文简单介绍了数据科学的含义,强调了“跨学科”的特性;介绍了数据科学的主要工作内容;最后介绍了Python中常用的数据科学的库。需要说明的是,应当将数据科学作为一项具有加乘作用的新能力,而非一门新的学科。

南宫理的日知录 939

python数据科学库_3个用于数据科学的顶级Python库

python数据科学库 Python的许多吸引力(例如效率,代码可读性和速度)使它成为数据科学爱好者的首选编程语言。 对于想要升级其应用程序功能的数据科学家和机器学习专家而言,Python通常是首选。 (例如,Andrey Bulezyuk使用Python编程语言创建了一个了不起的机器学习应用程序 。) 由于Python的广泛使用,它拥有大量的库,这些库使数据科学家更容易完成复杂的任务,而没...

cumo3681的博客 611

数据科学不可或缺的10个Python库,让你事半功倍

在快速发展的数据科学领域,Python已经成为通用语言,得益于其简洁性、易读性和多功能的库生态系统。然而,在像NumPy、Pandas和Scikit-Learn这样广受欢迎的库之外,还存在着一批鲜为人知但能够显著提升数据科学能力的Python宝藏库。本文旨在揭示这些隐藏的宝藏库,重点介绍实际应用和行业最佳实践。这些库在简化工作流程和增强分析能力方面起到了重要作用。因此,让我们来探索一下这些被低估但非常强大的Python库,你可能还没有使用过,但绝对应该使用。

weixin_42924914的博客 1046

数据科学必备的Python前端库Top-5

Python中有许多前端库,每个库都有其独特的优势和缺点。那么应该选择哪一个呢?无论你是数据科学家、数据工程师、机器学习工程师还是Python开发者,都必须至少了解一个前端库。它可以在许多方面帮助你,比如创建个人项目、成为全栈开发者、创建仪表板,甚至在日常生活中提供帮助。在这里,我将介绍5种不同的前端库,每种库都具有独特的功能、优势和缺点。

2301_82000445的博客 1838

数据科学家都应该了解的5个Python库

作为数据科学家免不了会使用一些Python库用于项目和研究,Python之所以能成为世界上最受欢迎的编程语言之一,与其整体及其相关库的生态系统密不可分,这些强大的库让Python保持着生命力和高效力。除去那些常见的库,还有很多库能够增强你的数据科学研究能力。本文将介绍五大难懂的Python库,可能不太好理解但只要弄懂它们你就能功力大增! 1. Scrapy 每位数据科学家的项目都是从处理数据开始的,而互联网就是最大、最丰富、最易访问的数据库。但可惜的是,除了通过pd.read_html函数.

m0_49079037的博客 482

数据科学家必备的20个Python库

公众号:尤而小屋作者:Peter编辑:Peter大家好,我是Peter~小屋里面一直在输出关于数据科学领域的文章,绝大部分都是基于Python,少量的MySQL(MySQL存储数据用)。本文重点给大家介绍Python中科学领域常用的20个库。

尤尔小屋 1296

python的三个库_3 个用于数据科学的顶级 Python 库

使用这些库把 Python 变成一个科学数据分析和建模工具。Python 的许多特性,比如开发效率、代码可读性、速度等使之成为了数据科学爱好者的首选编程语言。对于想要升级应用程序功能的数据科学家和机器学习专家来说,Python 通常是最好的选择(比如,Andrey Bulezyuk 使用 Python 语言创造了一个优秀的机器学习应用程序)。由于 Python 的广泛使用,因此它拥有大量的库,使得...

weixin_33699211的博客 751
上一篇: Python数据分析入门速成路线梳理
下一篇: Python学习进阶必备:从新手到高手的100个模块
壹只小小码农
博客等级 码龄5年 8101粉丝 1334原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值