


经过对Mysql的学习自身得出一些总结和重点内容
mysql的curd
insert into table () values ()
delete from table
update table set ?=?
select distinct ? from table where not between and in or (like group by having order by limit)
SELECT
    category,
    SUM(amount) AS total_sales,
    COUNT(order_id) AS order_count
FROM orders
WHERE
    -- 时间范围筛选
    order_date BETWEEN '2023-01-01' AND '2023-12-31'
    -- 地区多值匹配
    AND region IN ('华东', '华南', '华北')
    -- 状态逻辑组合(OR)
    AND (status = '已完成' OR status = '已发货')
    -- 金额过滤
    AND amount > 1000
    -- 类别模糊匹配(排除"电子配件")
    AND category LIKE '电子%'
    AND category NOT LIKE '%配件%'
GROUP BY category
HAVING
    -- 分组后过滤
    SUM(amount) > 50000
ORDER BY
    total_sales DESC
LIMIT 10;  -- 限制返回行数
order by desc 降序
union和join的区别
union更多是处理水平分表 列数不变行数变 两张表最好是相同的 两张表不相同的话查询的字段个数要相同 查到的数据按个数排序
Union 前后都是要select语句 select * from test UNION ALL select * from test2
union和union all的区别 all是没去重 单独的union去重
连表查询
join更多是处理两张有关系的表 一般都是有外键的表 两张表不同的 行不变列变
inner join/join 内连接 左右两个表需要符合条件的才输出 没有条件则笛卡尔积
外连接
left join/ left outer join on 左表全部输出 右表符合条件的才输出
right join/right outer join on 右表全部输出 左表符合条件才输出
和on连用
where having on这三者都是条件过滤 使用时期不同
on是和join一起用 优先级高于where
having 是和group by一起使用 having 聚合字段
where 就是条件过滤 不能使用聚合函数
SELECT department, COUNT(*) AS emp_count
FROM employees
WHERE salary > 5000  -- 先过滤工资
GROUP BY department
HAVING COUNT(*) > 10;  -- 再过滤部门人数
范式
三大范式
字段是不可分割的单元
存在主键 依赖主键
非主键之间不互相依赖
mysql执行流程
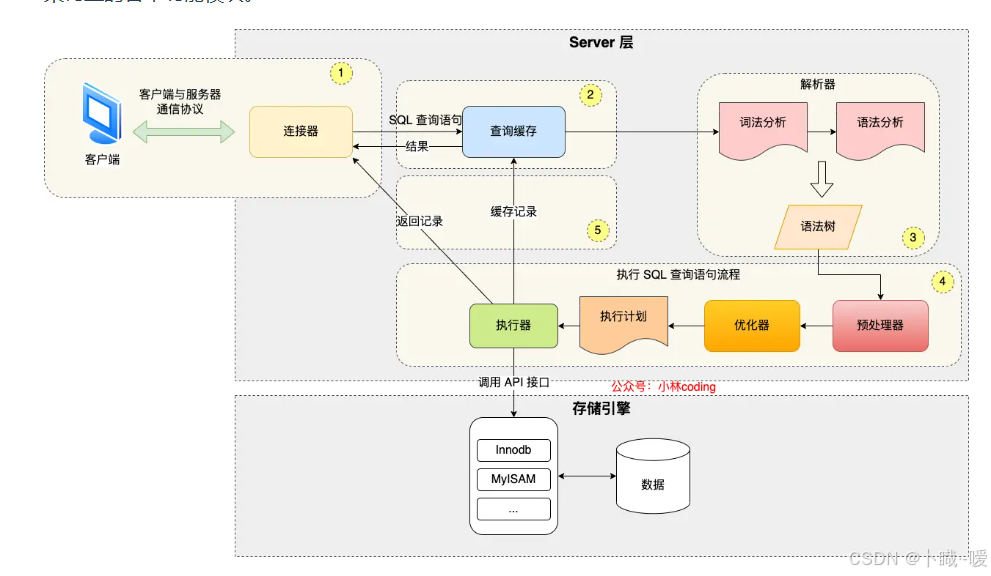
查询缓存这个在mysql8.0后被废弃了
词法分析找出关键字和非关键字
语法分析判断是否符合mysql的语法
预处理器判断对应的字段和表是否存在
优化器处理下where 的字段的顺序
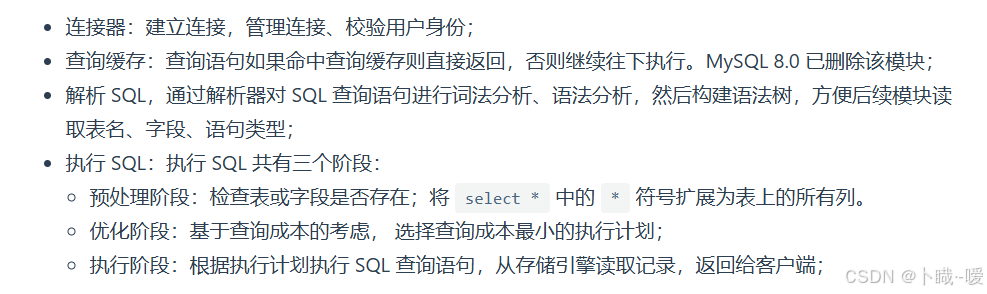
架构和引擎
主要是innodb 有时用myisam(以读为主,会记录数据的数量)
MyISAM 与 InnoDB两种引擎中索引的区别
MyISAM的索引方式都是“非聚簇”的,主键索引和二级索引的叶子节点都是关键字加数据的地址 没有回表的说法
InnoDB包含1个聚簇索引 主键索引是聚集索引 二级索引的叶子节点是关键字加主键值 然后回表查询找到对应的数据
在InnoDB存储引擎中,我们只需要根据主键值对聚簇索引进行一次查找就能找到对应的记录
InnoDB的数据文件本身就是索引文件,而MyISAM索引文件和数据文件是分离的,索引文件仅保存数据记录的地址。
InnoDB的非聚簇索引data域存储相应记录主键的值,而MyISAM索引记录的是地址。换句话说,InnoDB的所有非聚簇索引都引用主键作为data域。
MyISAM的查找数据是十分快速的,因为是拿着地址偏移量直接到文件中取数据的,反观InnoDB是通过获取主键之后再去聚簇索引里找记录,虽然说也不慢,但还是比不上直接用地址去访问。
InnoDB要求表必须有主键(MyISAM可以没有)。如果没有显式指定,则MySQL系统会自动选择一个可以非空且唯一标识数据记录的列作为主键。如果不存在这种列,则MySQL自动为InnoDB表生成一个隐含字段作为主键,这个字段长度为6个字节,类型为长整型。
Inndb支持外键 事务 行锁 myisam不支持
存储过程和函数
函数有返回值 funtion为标识符 不可单独使用 例如 max() min()
存储过程有In out inout参数 procedure为标识符 是用户定义的一系列sql语句的集合 可单独使用 call()
索引和优化
索引分为:
主键索引(不为null)
一般索引
唯一索引
组合索引(最左匹配原则)
全文索引(myisam)
索引说白了就是空间换时间 多占用存储空间换取查询的速度
好处就是加快了查询 坏处就是多用存储空间 并且修改数据时索引也需要修改 修改数据时时间增加
聚簇索引和非聚簇索引
主键索引 叶子结点中有关键字和值
其他索引一般是非聚簇索引 叶子结点只有关键字和主键 找到主键后回表查询主键索引
索引覆盖
叶子结点的关键字和值刚好是要查询的数据 不用回表
索引下推
非主键索引查询到关键字和值后 根据查询条件先筛选一波后再回表 而不是先回表再筛选
索引结构
索引的底层一般用b+树 也有hash
b树和b+树的区别
b树是每个结点都有关键字和值
b+树的非叶子结点只有关键字
叶子结点中有全部的关键字和值 并且用链表链接 方便范围查询
非叶子结点只有关键字所以可以存多点关键字 一个结点就需要一次io
区别
MySQL为什么使用B+树?B+树和B树的区别_为什么mysql用b+树不用b树-优快云博客
分析explain
ID
代表执行 select 子句或操作表的顺序,如果包含子查询,则会出现多个 ID。值越大,优先级越高,越先被执行。值相同的按照由上至下的顺序执行。
select_type(查询类型)
查询类型主要用于区别普通查询、联合查询以及子查询等复杂查询。
table
查询的表
type
查询扫描情况,最好到最差依次是:system>const>eq_ref>ref>range>index>All,一般情况下至少保证达到 range 级别,最好能达到 ref。
- system: 表中只有一条数据, 这个类型是特殊的 const 类型。
- const: 针对主键或唯一索引的等值查询扫描,表示通过索引一次就找到了,最多只返回一行数据。 const 查询速度非常快, 因为它仅仅读取一次即可。例如下面的这个查询,它使用了主键索引,因此 type 就是 const 类型的:explain select * from user_info where id = 2;
- eq_ref: 唯一性索引扫描此类型通常出现在多表的 join 查询,表示对于前表的每一个结果,都只能匹配到后表的一行结果。并且查询的比较操作通常是 =,查询效率较高。例如:explain select * from user_info, order_info where user_info.id = order_info.user_id;
- ref: 此类型通常出现在多表的 join 查询,针对于非唯一或非主键索引,或者是使用了 最左前缀 规则索引的查询。例如下面这个例子中, 就使用到了 ref 类型的查询:explain select * from user_info, order_info where user_info.id = order_info.user_id AND order_info.user_id = 5
- range: 表示使用索引范围查询,通过索引字段范围获取表中部分数据记录。这个类型通常出现在 =, <>, >, >=, <, <=, IS NULL, <=>, BETWEEN, IN() 操作中。例如下面的例子就是一个范围查询:explain select * from user_info where id between 2 and 8;
- index: 表示全索引扫描(full index scan),和 ALL 类型类似,只不过 ALL 类型是全表扫描,而 index 类型则仅仅扫描所有的索引, 而不扫描数据。index 类型通常出现在:所要查询的数据直接在索引树中就可以获取到, 而不需要扫描数据。当是这种情况时,Extra 字段 会显示 Using index。
- ALL: 表示全表扫描,这个类型的查询是性能最差的查询之一。通常来说, 我们的查询不应该出现 ALL 类型的查询,因为这样的查询在数据量大的情况下,对数据库的性能是巨大的灾难。 如一个查询是 ALL 类型查询, 那么一般来说可以对相应的字段添加索引来避免。
- NULL: MySQL在优化过程中分解语句,执行时甚至不用访问表或索引
possible_keys
显示可能应用在这张表中的索引,一个或多个。查询到的索引不一定是真正被使用。
key
实际使用的索引,如果为 null 则表示没有使用索引。因此会出现 possible_keys 列有可能被用到的索引,但是 key 列为 null。
key_len
表示索引中使用的字节数,在不损失精确性的情况下长度越短越好。key_len 显示的值为索引字段的最大可能长度,并非实际使用长度。即 key_len 是根据表定义计算而来。
ref
显示索引的哪一列被使用了,如果可能的话是一个常数,哪些列或常量被用于查找索引列上的值。
rows
根据表统计信息及索引选用情况,估算出找到所需的记录所需要读取的行数。
Extra
索引失效
1ike 以%开头,索引无效;当like前缀没有%,后缀有%时,索引有效;
2or 语句前后没有同时使用索引。当 or 左右查询字段只有一个是索引,该索引失效,只有左右查询字段均为索引时,才会生效;
3联合索引不使用第一列,索引失效;或者不按照从左到右使用列则失效 并且在第一个范围查询后的字段失效 当前范围查询还是用到索引
4数据类型出现隐式转化。如 varchar 不加单引号的话可能会自动转换为 int 型,使索引无效,产生全表扫描;
5在索引列上使用 IS NULL 或 IS NOT NULL操作。最好给列设置默认值。
6在索引字段上使用not,<>,!=。不等于操作符是永远不会用到索引的,因此对它的处理只会产生全表扫描。 优化方法: key<>0 改为 key>0 or key<0。
7对索引字段进行计算操作、字段上使用函数。
8当 MySQL 觉得全表扫描更快时(数据少);
【MySQL 进阶之路】索引失效的11种情况_mysql索引失效的几种情况-优快云博客
表数据存储结构
表空间由段(segment)、区(extent)、页(page)、行(row)组成
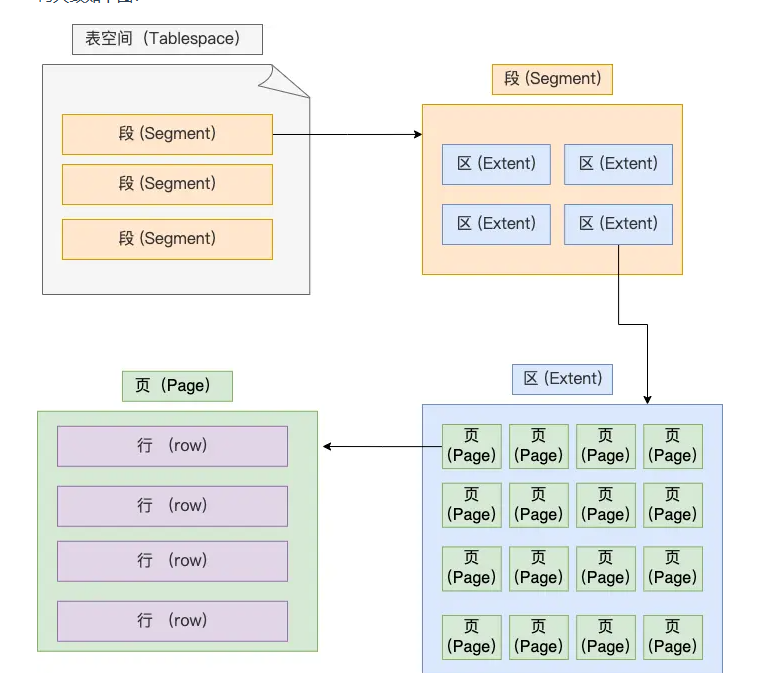
1、行(row) 数据库表中的记录都是按行(row)进行存放的,每行记录根据不同的行格式,有不同的存储结 构。
2、页(page) 记录是按照行来存储的,但是数据库的读取并不以「行」为单位,否则一次读取(也就是一次 I/O 操作)只能处理一行数据,效率会非常低。 因此,InnoDB 的数据是按「页」为单位来读写的,也就是说,当需要读一条记录的时候,并不是 将这个行记录从磁盘读出来,而是以页为单位,将其整体读入内存。 默认每个页的大小为 16KB,也就是最多能保证 16KB 的连续存储空间。 页是 InnoDB 存储引擎磁盘管理的最小单元,意味着数据库每次读写都是以 16KB 为单位的,一次 最少从磁盘中读取 16K 的内容到内存中,一次最少把内存中的 16K 内容刷新到磁盘中。 页的类型有很多,常见的有数据页、undo 日志页、溢出页等等。数据表中的行记录是用「数据 页」来管理的
3、区(extent) 我们知道 InnoDB 存储引擎是用 B+ 树来组织数据的。 B+ 树中每一层都是通过双向链表连接起来的,如果是以页为单位来分配存储空间,那么链表中相 邻的两个页之间的物理位置并不是连续的,可能离得非常远,那么磁盘查询时就会有大量的随机 I/O,随机 I/O 是非常慢的。 解决这个问题也很简单,就是让链表中相邻的页的物理位置也相邻,这样就可以使用顺序 I/O 了,那么在范围查询(扫描叶子节点)的时候性能就会很高。 那具体怎么解决呢? 在表中数据量大的时候,为某个索引分配空间的时候就不再按照页为单位分配了,而是按照区 (extent)为单位分配。每个区的大小为 1MB,对于 16KB 的页来说,连续的 64 个页会被划为一 个区,这样就使得链表中相邻的页的物理位置也相邻,就能使用顺序 I/O 了。
4、段(segment) 表空间是由各个段(segment)组成的,段是由多个区(extent)组成的。段一般分为数据段、索引段和回滚段等。 索引段:存放 B + 树的非叶子节点的区的集合; 数据段:存放 B + 树的叶子节点的区的集合; 回滚段:存放的是回滚数据的区的集合
锁
类型区分
读锁 写锁
读锁与读锁不互斥 读锁和写锁互斥
写锁和读锁写锁互斥
在读未提交 读已提交 可重复读级别下 查询语句不加读锁 修改语句加写锁
在串行化级别下 查询语句加读锁 修改语句加写锁
查询语句也可手动加锁
select ... lock in share mode; 加读锁
select ... for update;加写锁
事务a加了读锁 那么事务a只可以读 不可以修改数据 事务b也可以加读锁 不可以修改数据
事务a加了写锁 那么事务a可读可修改 不可以加读锁 事务b不可以加读锁和修改数据
mysql中修改数据都是加写锁的
粒度区分
表锁:给整个表加锁 行锁:给某行或者多行数据加锁
表锁
单纯的表锁
元数据锁(mdl)
mysql自动加 对表里的数据做curd时加mdl读锁 修改表结构时加mdl写锁
意向锁
给表里的行数据加行读锁时同时也会加意向读锁
给表里的行数据加行写锁同时也会加意向写锁
意向锁之间和行锁不会有冲突 只会跟单纯的表锁有冲突 主要是为了加表锁时加快效率(某一时刻给表加写锁时 需要遍历所有的行数据是否有加读锁或者写锁 现在有了意向锁 直接看有没有意向锁就可以了)
auto-inc锁
主键递增锁 插入数据时加锁 执行完语句就解锁
行锁
记录锁(行锁):record lock,即锁住一条记录
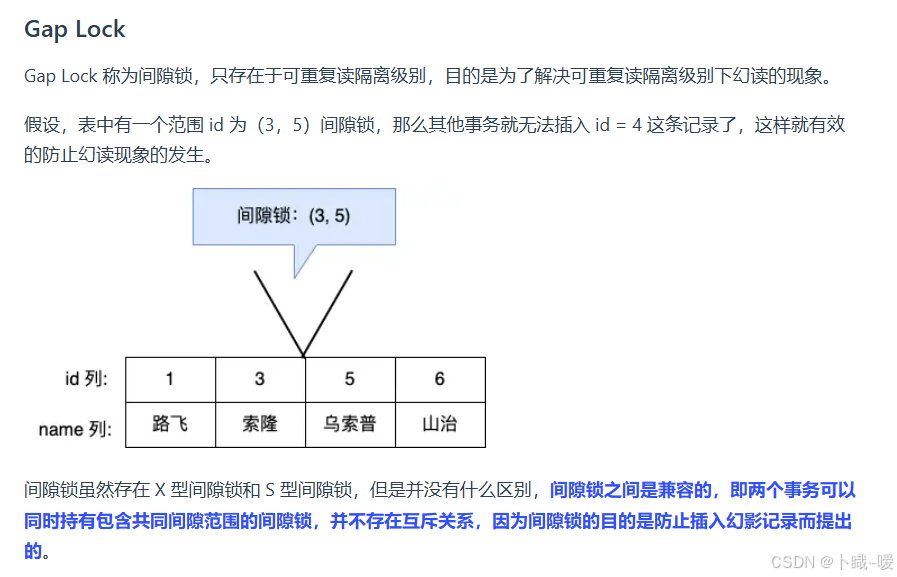
间隙锁:gap lock,即锁定一个区间,左开右开
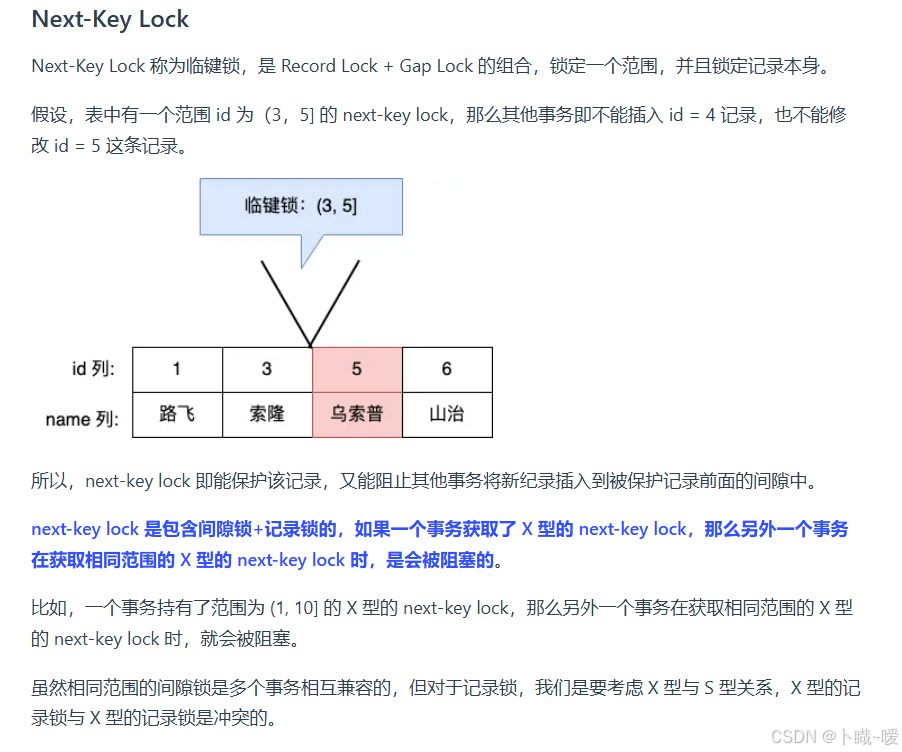
临键锁:next-key lock 记录锁+间隙锁锁定的区间,左开右闭
varchar和char的区别
char是定长的
varchar是不定长的
事务
事务遵循acid原则
原子性 一致性 隔离性 持久性
个人理解事务就是一堆的sql语句 有点像存储过程 但事务不同在于要遵循acid原则
每个事务类似于线程 事务结束线程就消亡 但是事务会操作数据库数据 相当于操作全局变量
golang语言中可以运用channel或者mutex之类处理 mysql运用的就是锁处理修改数据的操作 不过mysql事务是结束事务时自动释放写锁 在读的时候根据隔离级别使用mvcc或者读锁
隔离级别
事务隔离级别分成四个
读未提交read-uncommitted
读已提交read-commtted
可重复读repeatable-read
串行化serializable
隔离级别不同会有不同的影响
存在的问题
脏读 不可重复读 幻读
根据测试
读未提交时 两个事务在读的时候都没做处理 写时加了写锁(行锁)提交后释放
有脏读 不可重复读 幻读的问题
读已提交时 两个事务在读的时候都没做处理 (mvcc) 写时加了写锁(行锁)提交后释放
有不可重复读 幻读的问题
可重复读 两个事务在读的时候都没加锁 用了 (mvcc) 写时加了写锁(行锁)提交后释放
很多程度上避免了幻读 但还是有幻读的问题
主要矛盾在于select是快照读 修改语句和select ... for update是当前读
当前读是可以读到其他事务已经提交了的最新数据
串行化 两个事务在读的时候都加了读锁(行锁)提交后释放 写时加了写锁(行锁)提交后释放
在读未提交时和可重复读使用mvcc版本控制 也可以叫乐观锁
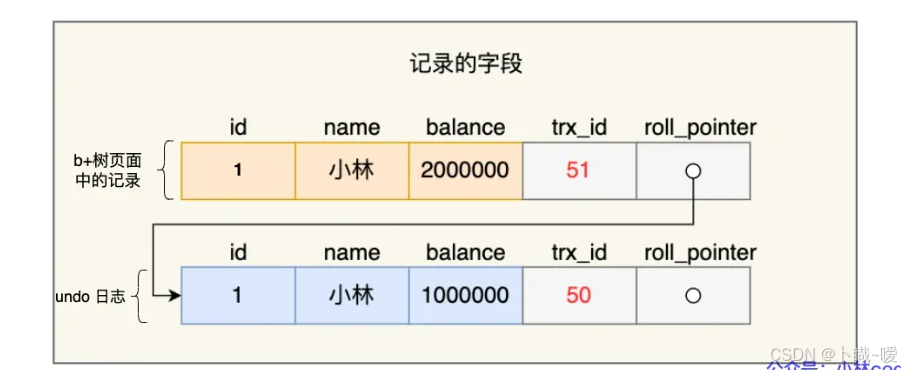
undolog中给每个记录加上了隐藏列 上一次修改的事务id(有可能小的事务id在最新的位置 大的事务id在之前历史的位置), 删除这条数据的事务id 上一个版本的指针
每个事务开始时都会获得一个唯一的事务id 由系统分配 分配后递增
使用mvcc时 当前事务第一次select时会生成一个readview 会记录当前活跃的事务id 系统将要分配的事务id 当前最小的事务id
然后去查找记录中undolog中的 判断上一次修改的事务id不属于当前活跃的事务id和小于系统将要分配的事务id 则可见 否则不可见就要根据上一个版本的指针去寻找
读未提交时和可重复读的不同在于
读未提交时每次select时都会生成新的readview
可重复读只在第一次select时生成readview
undolog中在事务未提交时的修改也会有记录 因为当前只可能有一个事务可以对记录进行修改 所以对回滚不会有影响
读取数据分为快照读和当前读
增删改都是当前读 特殊的查也是当前读
读已提交和可重复读隔离级别都是快照读 快照读就是读历史数据并不是当前的数据
select 不加锁 快照读
select .... lock in share mode 加读行锁
select ..... for update 当前读 加写间隙锁
修改语句 加写行锁
慢日志查询
set global slow_query_log='ON';
select * from mysql.slow_log;
slow_query_log 查看耗时长的语句
show profile 分析这个语句的性能
集群
设置一个主mysql 对应一个或者多个从mysql
主从复制
主从复制能实现读写分离 容灾 备份
在my.ini设置服务器id
然后主mysql开启binlog日志记录了所有sql语句 允许从mysql连接 从mysql去连接主mysql
主mysql的有个线程更新操作(Insert delete update)会写入到binlog中 每个从mysql都在主mysql有一个线程发送 binlog内 容
从mysql有个Io线程读取主Mysql的binlog 并把内容写入到relaylog中
再启一个线程将relaylog中的应用到本身的数据库中
分为
异步复制 半同步复制 同步复制
默认的主从复制方式就是异步复制
- 异步复制:主库提交事务后无需等待从库确认,可能导致数据滞后。
- 半同步复制:主库等待至少一个从库确认,以减少数据丢失风险。
- 半同步复制需要主mysql收到至少一个从mysql返回确认 mysql写入到relaylog就会返回
- 同步复制:所有从库必须确认后才提交事务,延迟较大
问题
主数据丢失 用半同步解决
主从同步会有延迟 从数据库只有一个sql thread 复制可能延迟
并行复制:从库多线程apply binlog
mysql和redis一致性
1延迟双删
2canal
3kafka
4只修改redis然后redis更新到Mysql
5先更新mysql再删redis
Mysql连接和权限
mysql -u root -p连接 在用户中设置权限
日志
mysql一共有这些日志
重做日志(redo log):物理日志
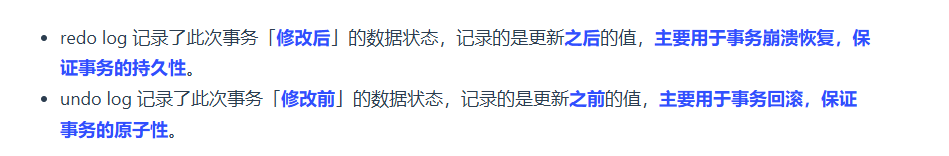
作用是确保事务的持久性。 redo 日志记录事务执行后的状态,用来恢复未写入 data file 的已提交事务数据。
回滚日志(undo log):逻辑日志
作用是保证数据的原子性。 保存了事务发生之前的数据的一个版本,可以用于回滚,同时可以提供多版本并发控制下的读(MVCC),也即非锁定读。
二进制日志(binlog):逻辑日志
常用于主从同步或数据同步中,也可用于数据库基于时间点的还原。
错误日志(errorlog)
记录着 MySQL 启动和停止,以及服务器在运行过程中发生的错误的相关信息。在默认情况下,系统记录错误日志的功能是关闭的,错误信息被输出到标准错误输出。
普通查询日志(general query log)
记录了服务器接收到的每一个命令,无论命令语句是否正确,因此会带来不小开销,所以也是默认关闭的。
慢查询日志(slow query log)
记录执行时间过长和没有使用索引的查询语句(默认 10s),同时只会记录执行成功的语句。
中继日志(relay log)
在从节点中存储接收到的 binlog 日志内容,用于主从同步
undolog:
保证原子性 记录的是数据的值 引擎生成的日志 undolog的修改会修改buffer pool中的undo 页
buffer pool中的数据变成
b
redolog:
保证持久性 记录的是数据的值 引擎生成的日志
redo log 是循环写,日志空间大小是固定,全部写满就从头开始,保存未被刷入磁盘的脏页日 志。
binlog:
二进制文件 主从复制 根据配置可记录数据的值或者sql语句
binlog 是追加写,写满一个文件,就创建一个新的文件继续写,不会会覆盖以前的日志,保存的是全量 的日志
undolog记录的东西 事务id就是实现mvcc的关键
buffer pool 中有 undo 页,对 undo 页的修改也都会记录到 redo log。redolog 会每秒刷盘,提 交事务时也会刷盘,数据页和 undo 页都是靠这个机制保证持久化的。
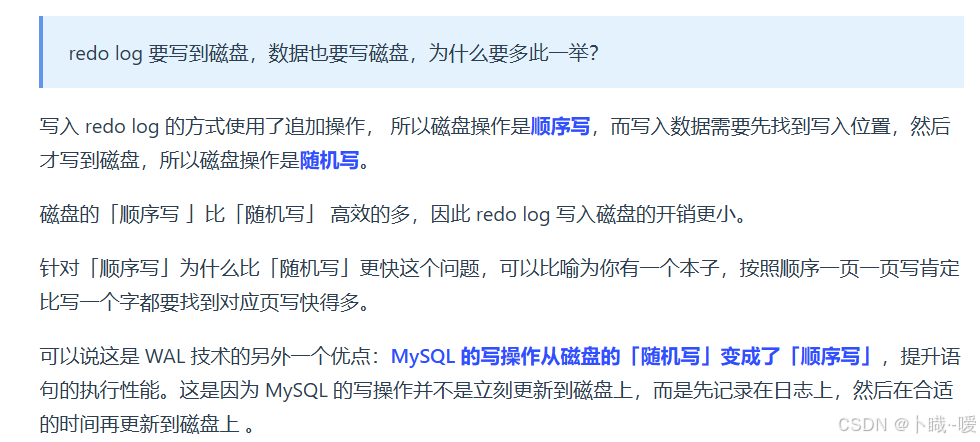
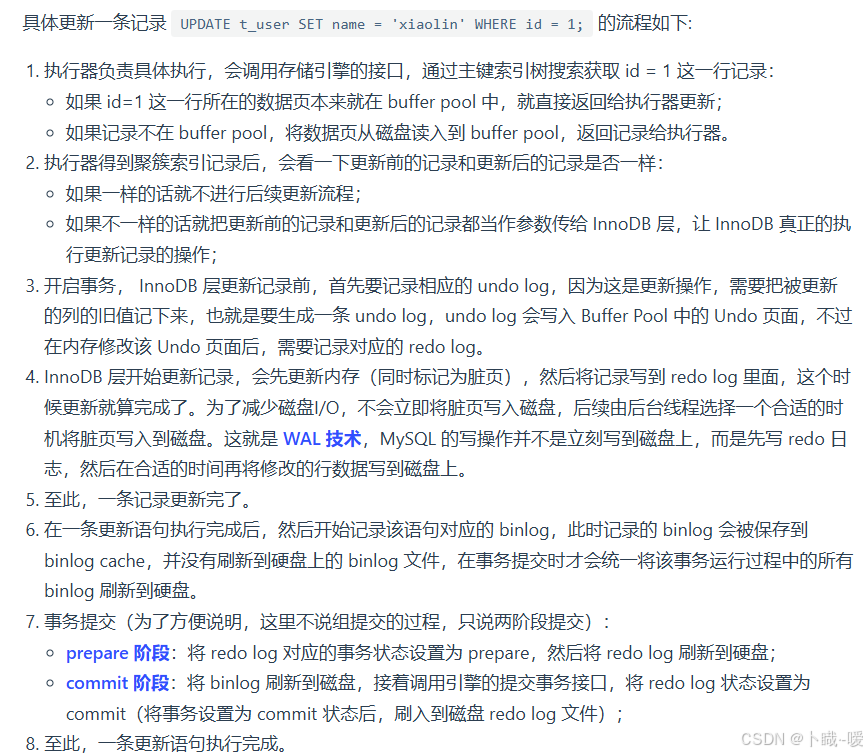
事务执行时log的操作顺序
事务开始
undolog写入
redolog写入undolog的修改 刷盘
执行操作语句
mysql缓存区存在脏页
写入redolog
redolog 设置为prepare落盘
binlog数据落盘
提交事务
redolog设置为commit落盘
buffer pool
Innodb 存储引擎设计了一个缓冲池 (Buffer Pool), 来提高数据库的读写性能
Buffer Pool 以页为单位缓冲数据,可以通过 参数调整缓冲池的大小,默认是 innodb_buffer_pool_size 128 М.
Innodb 通过三种链表来管理缓页:
Free List (空闲页链表), 管理空闲页;
Flush List (脏页链表), 管理脏页;
LRU List, 管理脏页 + 干净页,将最近且经常查询的数据缓存在其中,而不常查询的数据就淘汰出
InnoDB 对 LRU 做了一些优化,我们熟悉的 LRU 算法通常是将最近查询的数据放到 LRU 链表的头部,而 InnoDB 做 2 点优化:
将 LRU 链表分为 young 和 old 两个区域,加入缓冲池的页,优先插入 old 区域;页被访问时,才进入 young 区域,目的是为了解决预读失效的问题。
当 **「页被访问」且「old 区域停留时间超过 innodb_old_blocks_time 阈值 (默认为 1 秒)」 时,才 会将页插入到 young 区域,否则还是插入到 old 区域,目的是为了解决此量数据访问,大量热数据淘 汰的问题。
可以通过调整 参数,设置 young 区域和 old 区域比例。
innodb_old_blocks_pct 在开启了慢 SQL 监控后,如果你发现「偶尔」会出现一些用时稍长的 SQL, 这可因为脏页在刷新到磁盘 时导致数据库性能抖动。如果在很短的时间出现这种现象,就需要调大 Buffer Pool 空间或 redo log 日志 的大小。
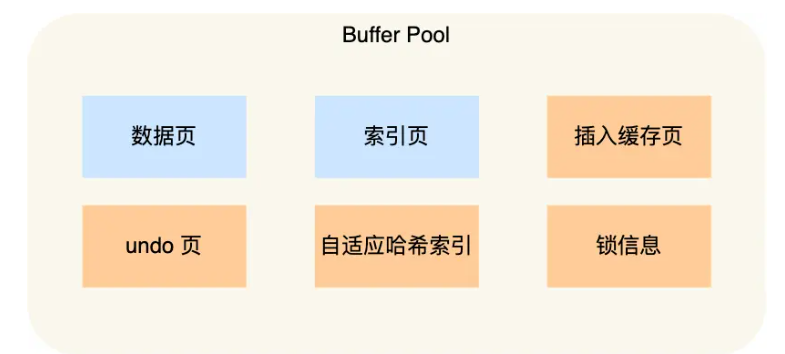
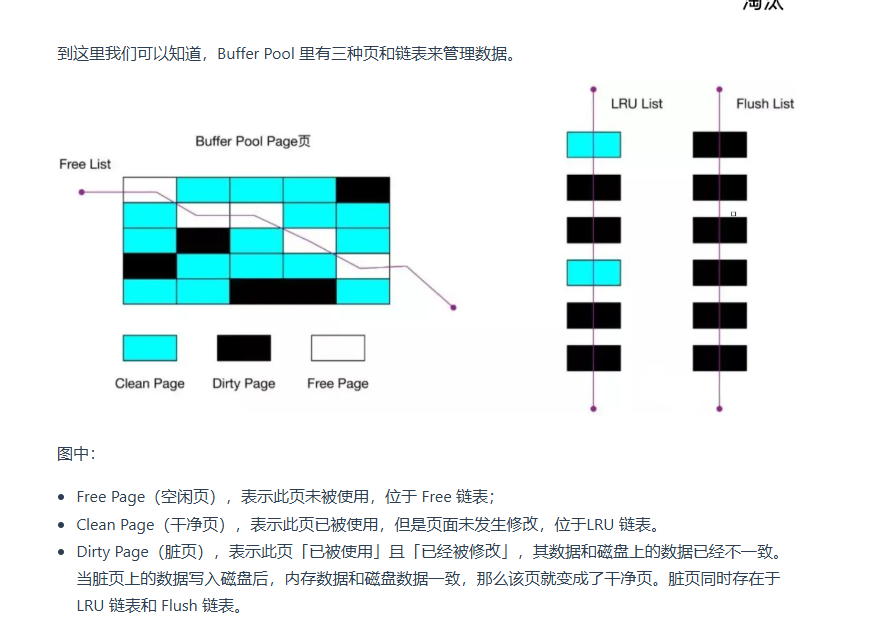
问题
假如脏页没写入mysql挂了怎么办
InnoDB 的更新操作采用的是 WriteAhead Log 策略,即先写日志,再写入磁盘,通过 redolog 日志让 MySQL 拥有了崩溃恢复能力。
下面几种情况会触发脏页的刷新:
当 redolog 日志满了的情况下,会主动触发脏页刷新到磁盘;
Buffer Pool 空间不足时,需要将一部分数据页淘汰掉,如果淘汰的是脏页,需要先将脏页同步到磁 盘;
MySQL 认为空闲时,后台线程会定期将适量的脏页刷入到磁盘;
MySQL 正常关闭之前,会把所有的脏页刷入到磁盘;
mysql线上扩容
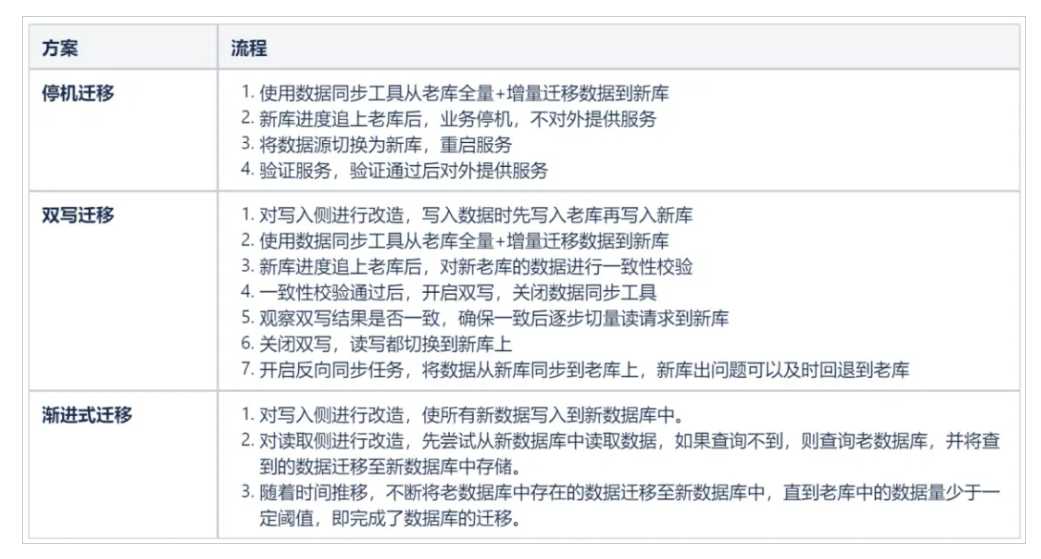
线上分表
在不停机的情况下进行数据迁移,需要采用增量迁移和双写同步策略,确保数据的一致性
先全量迁移
在全量数据迁移过程中,业务系统仍在不停地写入数据,因此需要对新增的数据进行增量迁移。这可以通过以下方式实现:
- 时间戳记录:在全量迁移开始时,记录下当前的最大时间戳。完成全量迁移后,将该时间戳之后的数据迁移到分表中。
- 双写策略:在全量迁移后,修改业务逻辑,使得新数据同时写入旧表和分表。这样可以保证即使在迁移过程中有新数据写入,也不会丢失。
全量迁移后 开启增量迁移和双写
这样能保证再全量迁移期间的数据通过增量迁移过来
同时在增量迁移期间的数据通过双写过来
 4687


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


