python 爬虫爬取网易新闻 网易排行榜

python爬取新闻网站内容,python爬取新闻内容报告 在命令行窗口下面 创建一个crawl爬虫模板(注意在文件的根目录下面,指令检查别输入错误,-t 表示使用后面的crawl模板),会在spider文件夹生成一个news163.py文件然后看一下这个‘crawl’模板和一般的模板有什么区别,多了链接提取器还有一些爬虫规则,这样就有利于我们做一些深度信息的爬取系统的介绍会在爬虫专项里面进行讲解,这里介绍一些基础性的可以用在这个项目里面的知识点,,正则表达式是由字符和操作符组成的,常见的语法如下图。 阅读详情

爬取新浪新闻的链接:

https://blog.youkuaiyun.com/Iv_zzy/article/details/107535041

爬取中国新闻网的链接

https://blog.youkuaiyun.com/Iv_zzy/article/details/107537295

与获取新浪新闻思路不同,新浪新闻的获取是先把所有的链接存入csv文件,再统一对所有的链接解析。本人对网易新闻的获取采用边解析链接、边获取链接的内容(本人尽可能提供不同的方法,若需要,对照修改使用即可)

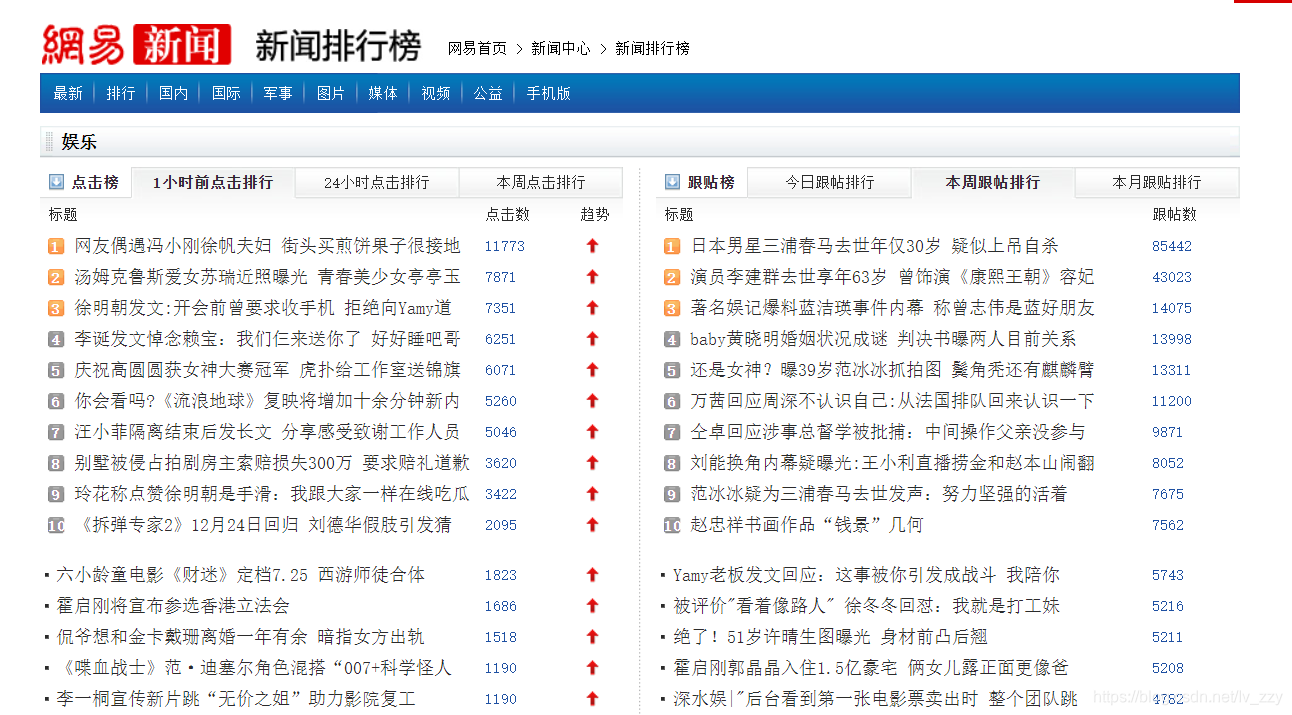
网易排行榜如下图所示
在这里插入图片描述
以娱乐新闻为例,点击娱乐,到了这个界面
在这里插入图片描述网页链接为:

http://news.163.com/special/0001386F/rank_ent.html

1、首先,从网页上获取带有链接的title
此处是返回一个list

def Initpage(url, headers):
    res = requests.get(url, headers = headers) 
    res.content.decode('gb18030','ignore') #原网页gbk
    soup = BeautifulSoup(res.text, 'html.parser')
    #print(soup.prettify())
    titles = soup.find('div', 'area-half left').find('div', 'tabContents active')

Python网络爬虫之基本项目:爬取网易新闻排行榜 一些说明: 使用urllib2或requests包来爬取页面。 使用正则表达式分析一级页面,使用Xpath来分析二级页面。 将得到的标题和链接,保存为本地文件。 阅读详情

相关推荐

爬虫基本介绍 && python3 爬虫爬取网易新闻排行榜

爬虫基本介绍 1. 什么是爬虫? 爬虫是请求⽹网站并提取数据的⾃自动化程序 2. 爬虫的基本流程 发起请求 通过HTTP库向目标站点发起请求,即发送一个Request,请求可以包含额外的headers等信息,等待服务器器响应。 解析内容 如果服务器能正常响应,会得到一个Response,Response的内容便是所要获取的页面内容,类型可能有HTML,Json字符串,二进...

淡淡 1971

python 爬虫爬取中国新闻网

中国新闻网的新闻种类较多、而且新闻比较丰富,如果需要获取大量新闻的话,中国新闻网是个不错的选择。 界面是这样的: 从url不难发现,改变日期就能获取不同日期的新闻 那么,正文开始。。。 1、获取某一个链接的新闻详情页信息 import requests from bs4 import BeautifulSoup url = 'http://www.chinanews.com/auto/2019/01-30/8743035.shtml' res = requests.get(url) res.encodi

Iv_zzy的博客 6195

网易云音乐排行榜爬虫

网络爬虫是一种自动抓取网页信息的程序,主要用于搜索引擎、数据挖掘、舆情分析等领域。其工作流程包括确定URL、发送请求、解析内容、存储数据和处理链接。以网易云音乐热歌榜为例,通过发送请求获取页面,用正则表达式提取歌曲ID和标题,再循环下载音频文件并保存。整个过程需注意反爬机制、异常处理和文件命名规范。

qq_63237596的博客 992

Scrapy爬虫框架抓取网易新闻

一. 环境安装 依赖库的安装: 1.

weixin_45861518的博客 663

python爬虫实战(1)--爬取新闻数据

python爬虫实战

BUG猿的博客 4573

python爬虫爬取新闻示例.zip

爬虫(Web Crawler)是一种自动化程序,用于从互联网上收集信息。其主要功能是访问网页、提取数据并存储,以便后续分析或展示。爬虫通常由搜索引擎、数据挖掘工具、监测系统等应用于网络数据抓取的场景。 爬虫的工作流程包括以下几个关键步骤: URL收集: 爬虫从一个或多个初始URL开始,递归或迭代地发现新的URL,构建一个URL队列。这些URL可以通过链接分析、站点地图、搜索引擎等方式获取。 请求网页: 爬虫使用HTTP或其他协议向目标URL发起请求,获取网页的HTML内容。这通常通过HTTP请求库实现,如Python中的Requests库。 解析内容: 爬虫对获取的HTML进行解析,提取有用的信息。常用的解析工具有正则表达式、XPath、Beautiful Soup等。这些工具帮助爬虫定位和提取目标数据,如文本、图片、链接等。 数据存储: 爬虫将提取的数据存储到数据库、文件或其他存储介质中,以备后续分析或展示。常用的存储形式包括关系型数据库、NoSQL数据库、JSON文件等。 遵守规则: 为避免对网站造成过大负担或触发反爬虫机制,爬虫需要遵守网站的robots.txt协议,限制访问频率和深度,并模拟人类访问行为,如设置User-Agent。 反爬虫应对: 由于爬虫的存在,一些网站采取了反爬虫措施,如验证码、IP封锁等。爬虫工程师需要设计相应的策略来应对这些挑战。 爬虫在各个领域都有广泛的应用,包括搜索引擎索引、数据挖掘、价格监测、新闻聚合等。然而,使用爬虫需要遵守法律和伦理规范,尊重网站的使用政策,并确保对被访问网站的服务器负责。

凤凰娱乐新闻爬虫

搭好python环境和需要的类库后直接运行即可,可自动翻页直到页面无法显示则停止

[官方培训]19-物理模拟 Epic 肖月 笔记

物理引擎全局解算精度的设置,帧率越高,子步越多得到的模拟结果就越精确。引擎默认情况下是以变化的帧率运行的,但是对于Chaos物理引擎来说。一般子步越小,帧率越固定,效果就会更好更稳定一些。图示的分步选项就是依据下方的最长子步时长和最大步数对动态变化的帧率,进一步的做拆分来保证物理效果。对于影视项目建议都开启分步选项。红色框内有三个迭代次数的设置,这是Chaos基于位置的约束求解算法专用的一个设置,可以简单理解为迭代次数越高,当前帧一个子步内得到的结果就越精确。

Tcohneyn的博客 1546

C语言实战:最小二乘法在传感器数据校准中的应用(附完整代码)

本文详细介绍了如何使用C语言实现最小二乘法,对传感器数据进行线性校准。通过模拟带噪声的传感器数据,手把手演示了从核心算法实现、参数计算到效果验证的完整流程,并提供了可直接编译运行的完整源码,帮助嵌入式开发者解决传感器数据不准的常见问题,提升系统测量精度。

weixin_28025327的博客 516

get_seed协议

【代码】get_seed协议。

a545958498的博客 912

⭐️【2024年新版教程】vmware tools安装步骤(Windows、Linux、MacOS版本)

VMware Tools是VMware提供的一套实用工具,它可以增强虚拟机与宿主机之间的交互性能,如改进显示性能、优化鼠标和键盘性能、提供时间同步功能等。无论是在Windows、Linux还是MacOS虚拟机上,安装VMware Tools都可以提高虚拟机的使用体验。以上就是在不同操作系统上安装VMware Tools的步骤,希望对您有所帮助。

Python老吕的博客 6万+

我用 Python 把 Claude 变成了 “代码审查员“:每次提交前 AI 先 Review,Bug 漏网率降了 80%

这是成败的关键。我们需要给 Claude 立规矩,让它像一个严格的架构师那样思考。你是一名资深的首席软件架构师和安全专家。请审查以下 Git Diff 代码变更。你的任务是:1. **安全性检查**:寻找 SQL 注入、XSS、硬编码密钥、敏感信息泄露等。2. **潜在 Bug**:空指针、资源未关闭、竞态条件、逻辑死循环。3. **代码质量**:命名规范、冗余代码、可读性差、缺乏注释。4. **性能优化**:不必要的数据库查询、低效算法。

BUG猿的博客 144

YOLOv11改进策略【Neck】| GSConv+Slim Neck:混合深度可分离卷积和标准卷积的轻量化网络设计

实时检测器架构的轻量级设计GsConv。

Limiiiing的博客 2311

opencode : 无法将“opencode”项识别为 cmdlet、函数、脚本文件或可运行程序的名称 解决方案

本文主要介绍了opencode : 无法将“opencode”项识别为 cmdlet、函数、脚本文件或可运行程序的名称解决方案,希望能对使用opencode的同学们有所帮助。 文章目录 1. 问题描述 2. 解决方案

weixin_43178406的博客 11万+

使用微信小程序开发制作一个简单的在线问答应用

以上就是一个简单的在线问答小程序的开发过程。其中包括前端界面的布局和逻辑,后端接口的设计和实现,以及部署和测试的步骤。通过以上步骤,你可以自己尝试开发一个类似的在线问答应用。

2401_85258012的博客 798

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

上一篇: python[爬虫]爬取百万条新浪新闻 新浪滚动新闻中心(多进程)
下一篇: python 爬虫爬取中国新闻网
Mooney安
博客等级 码龄9年 92粉丝 48原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值