


前言
HashMap在Java和Android开发中非常常见- 而
HashMap 1.8相对于HashMap 1.7更新多 - 今天,我将通过源码分析
HashMap 1.8,从而讲解HashMap 1.8相对于HashMap 1.7的更新内容,希望你们会喜欢。- 本文基于版本
JDK 1.8,即Java 8 - 关于版本
JDK 1.7,即Java 7,具体请看文章Java:手把手带你源码分析 HashMap 1.7
- 本文基于版本
目录

1. 简介
- 类定义
public class HashMap<K,V>
         extends AbstractMap<K,V>
implements Map<K,V>, Cloneable, Serializable- 主要简介

HashMap的实现在JDK 1.7和JDK 1.8差别较大- 今天,我将对照
JDK 1.7的源码,在此基础上讲解JDK 1.8中HashMap的源码解析请务必打开
JDK 1.7对照看:Java:手把手带你源码分析 HashMap 1.7
2. 数据结构:引入了 红黑树
2.1 主要介绍

关于 红黑树 了解:http://blog.youkuaiyun.com/v_july_v/article/details/6105630

2.2 存储流程
注:为了让大家有个感性的认识,只是简单的画出存储流程,更加详细 & 具体的存储流程会在下面源码分析中给出

2.3 数组元素 & 链表节点的 实现类
-
HashMap中的数组元素 & 链表节点 采用Node类 实现与
JDK 1.7的对比(Entry类),仅仅只是换了名字 -
该类的源码分析如下
具体分析请看注释
/**
  * Node  = HashMap的内部类,实现了Map.Entry接口,本质是 = 一个映射(键值对)
  * 实现了getKey()、getValue()、equals(Object o)和hashCode()等方法
  **/

  static class Node<K,V> implements Map.Entry<K,V> {

        final int hash; // 哈希值,HashMap根据该值确定记录的位置
        final K key; // key
        V value; // value
        Node<K,V> next;// 链表下一个节点

        // 构造方法
        Node(int hash, K key, V value, Node<K,V> next) {
            this.hash = hash;
            this.key = key;
            this.value = value;
            this.next = next;
        }

        public final K getKey()        { return key; }   // 返回 与 此项 对应的键
        public final V getValue()      { return value; } // 返回 与 此项 对应的值
        public final String toString() { return key + "=" + value; }

        public final V setValue(V newValue) {
            V oldValue = value;
            value = newValue;
            return oldValue;
        }

      /**
        * hashCode()
        */
        public final int hashCode() {
            return Objects.hashCode(key) ^ Objects.hashCode(value);
        }

      /**
        * equals()
        * 作用:判断2个Entry是否相等,必须key和value都相等,才返回true
        */
        public final boolean equals(Object o) {
            if (o == this)
                return true;
            if (o instanceof Map.Entry) {
                Map.Entry<?,?> e = (Map.Entry<?,?>)o;
                if (Objects.equals(key, e.getKey()) &&
                    Objects.equals(value, e.getValue()))
                    return true;
            }
            return false;
        }
    }
2.4 红黑树节点 实现类
HashMap中的红黑树节点 采用TreeNode类 实现
 /**
  * 红黑树节点 实现类:继承自LinkedHashMap.Entry<K,V>类
  */
  static final class TreeNode<K,V> extends LinkedHashMap.Entry<K,V> {

    // 属性 = 父节点、左子树、右子树、删除辅助节点 + 颜色
    TreeNode<K,V> parent;
    TreeNode<K,V> left;
    TreeNode<K,V> right;
    TreeNode<K,V> prev;
    boolean red;

    // 构造函数
    TreeNode(int hash, K key, V val, Node<K,V> next) {
        super(hash, key, val, next);
    }

    // 返回当前节点的根节点
    final TreeNode<K,V> root() {
        for (TreeNode<K,V> r = this, p;;) {
            if ((p = r.parent) == null)
                return r;
            r = p;
        }
    }
3. 具体使用
3.1 主要使用API(方法、函数)
与
JDK 1.7基本相同
V get(Object key); // 获得指定键的值
V put(K key, V value);  // 添加键值对
void putAll(Map<? extends K, ? extends V> m);  // 将指定Map中的键值对 复制到 此Map中
V remove(Object key);  // 删除该键值对

boolean containsKey(Object key); // 判断是否存在该键的键值对;是 则返回true
boolean containsValue(Object value);  // 判断是否存在该值的键值对;是 则返回true

Set<K> keySet();  // 单独抽取key序列,将所有key生成一个Set
Collection<V> values();  // 单独value序列,将所有value生成一个Collection

void clear(); // 清除哈希表中的所有键值对
int size();  // 返回哈希表中所有 键值对的数量 = 数组中的键值对 + 链表中的键值对
boolean isEmpty(); // 判断HashMap是否为空;size == 0时 表示为 空
3.2 使用流程
与
JDK 1.7基本相同
-
在具体使用时,主要流程是:
- 声明1个
HashMap的对象 - 向
HashMap添加数据(成对 放入 键 - 值对) - 获取
HashMap的某个数据 - 获取
HashMap的全部数据:遍历HashMap
- 声明1个
-
示例代码
import java.util.Collection;
import java.util.HashMap;
import java.util.Iterator;
import java.util.Map;
import java.util.Set;

public class HashMapTest {

    public static void main(String[] args) {
      /**
        * 1. 声明1个 HashMap的对象
        */
        Map<String, Integer> map = new HashMap<String, Integer>();

      /**
        * 2. 向HashMap添加数据(成对 放入 键 - 值对)
        */
        map.put("Android", 1);
        map.put("Java", 2);
        map.put("iOS", 3);
        map.put("数据挖掘", 4);
        map.put("产品经理", 5);

       /**
        * 3. 获取 HashMap 的某个数据
        */
        System.out.println("key = 产品经理时的值为:" + map.get("产品经理"));

      /**
        * 4. 获取 HashMap 的全部数据:遍历HashMap
        * 核心思想:
        * 步骤1:获得key-value对(Entry) 或 key 或 value的Set集合
        * 步骤2:遍历上述Set集合(使用for循环 、 迭代器(Iterator)均可)
        * 方法共有3种:分别针对 key-value对(Entry) 或 key 或 value
        */

        // 方法1:获得key-value的Set集合 再遍历
        System.out.println("方法1");
        // 1. 获得key-value对(Entry)的Set集合
        Set<Map.Entry<String, Integer>> entrySet = map.entrySet();

        // 2. 遍历Set集合,从而获取key-value
        // 2.1 通过for循环
        for(Map.Entry<String, Integer> entry : entrySet){
            System.out.print(entry.getKey());
            System.out.println(entry.getValue());
        }
        System.out.println("----------");
        // 2.2 通过迭代器:先获得key-value对(Entry)的Iterator,再循环遍历
        Iterator iter1 = entrySet.iterator();
        while (iter1.hasNext()) {
            // 遍历时,需先获取entry,再分别获取key、value
            Map.Entry entry = (Map.Entry) iter1.next();
            System.out.print((String) entry.getKey());
            System.out.println((Integer) entry.getValue());
        }


        // 方法2:获得key的Set集合 再遍历
        System.out.println("方法2");

        // 1. 获得key的Set集合
        Set<String> keySet = map.keySet();

        // 2. 遍历Set集合,从而获取key,再获取value
        // 2.1 通过for循环
        for(String key : keySet){
            System.out.print(key);
            System.out.println(map.get(key));
        }

        System.out.println("----------");

        // 2.2 通过迭代器:先获得key的Iterator,再循环遍历
        Iterator iter2 = keySet.iterator();
        String key = null;
        while (iter2.hasNext()) {
            key = (String)iter2.next();
            System.out.print(key);
            System.out.println(map.get(key));
        }


        // 方法3:获得value的Set集合 再遍历
        System.out.println("方法3");

        // 1. 获得value的Set集合
        Collection valueSet = map.values();

        // 2. 遍历Set集合,从而获取value
        // 2.1 获得values 的Iterator
        Iterator iter3 = valueSet.iterator();
        // 2.2 通过遍历,直接获取value
        while (iter3.hasNext()) {
            System.out.println(iter3.next());
        }

    }


}

// 注:对于遍历方式,推荐使用针对 key-value对(Entry)的方式:效率高
// 原因:
   // 1. 对于 遍历keySet 、valueSet,实质上 = 遍历了2次:1 = 转为 iterator 迭代器遍历、2 = 从 HashMap 中取出 key 的 value 操作(通过 key 值 hashCode 和 equals 索引)
// 2. 对于 遍历 entrySet ,实质 = 遍历了1次 = 获取存储实体Entry(存储了key 和 value )- 运行结果
方法1
Java2
iOS3
数据挖掘4
Android1
产品经理5
----------
Java2
iOS3
数据挖掘4
Android1
产品经理5
方法2
Java2
iOS3
数据挖掘4
Android1
产品经理5
----------
Java2
iOS3
数据挖掘4
Android1
产品经理5
方法3
2
3
4
1
5
下面,我们按照上述的使用过程,对一个个步骤进行源码解析
4. 基础知识:HashMap中的重要参数(变量)
- 在进行真正的源码分析前,先讲解
HashMap中的重要参数(变量) HashMap中的主要参数 同JDK 1.7,即:容量、加载因子、扩容阈值- 但由于数据结构中引入了 红黑树,故加入了 与红黑树相关的参数。具体介绍如下:
 /**
   * 主要参数 同  JDK 1.7
   * 即:容量、加载因子、扩容阈值(要求、范围均相同)
   */

  // 1. 容量(capacity): 必须是2的幂 & <最大容量(2的30次方)
  static final int DEFAULT_INITIAL_CAPACITY = 1 << 4; // 默认容量 = 16 = 1<<4 = 00001中的1向左移4位 = 10000 = 十进制的2^4=16
  static final int MAXIMUM_CAPACITY = 1 << 30; // 最大容量 =  2的30次方(若传入的容量过大,将被最大值替换)

  // 2. 加载因子(Load factor):HashMap在其容量自动增加前可达到多满的一种尺度
  final float loadFactor; // 实际加载因子
  static final float DEFAULT_LOAD_FACTOR = 0.75f; // 默认加载因子 = 0.75

  // 3. 扩容阈值(threshold):当哈希表的大小 ≥ 扩容阈值时,就会扩容哈希表(即扩充HashMap的容量)
  // a. 扩容 = 对哈希表进行resize操作(即重建内部数据结构),从而哈希表将具有大约两倍的桶数
  // b. 扩容阈值 = 容量 x 加载因子
  int threshold;

  // 4. 其他
  transient Node<K,V>[] table;  // 存储数据的Node类型 数组,长度 = 2的幂;数组的每个元素 = 1个单链表
  transient int size;// HashMap的大小,即 HashMap中存储的键值对的数量


  /**
   * 与红黑树相关的参数
   */
   // 1. 桶的树化阈值:即 链表转成红黑树的阈值,在存储数据时,当链表长度 > 该值时,则将链表转换成红黑树
   static final int TREEIFY_THRESHOLD = 8;
   // 2. 桶的链表还原阈值:即 红黑树转为链表的阈值,当在扩容(resize())时(此时HashMap的数据存储位置会重新计算),在重新计算存储位置后,当原有的红黑树内数量 < 6时,则将 红黑树转换成链表
   static final int UNTREEIFY_THRESHOLD = 6;
   // 3. 最小树形化容量阈值:即 当哈希表中的容量 > 该值时,才允许树形化链表 (即 将链表 转换成红黑树)
   // 否则,若桶内元素太多时,则直接扩容,而不是树形化
   // 为了避免进行扩容、树形化选择的冲突,这个值不能小于 4 * TREEIFY_THRESHOLD
   static final int MIN_TREEIFY_CAPACITY = 64;
- 此处 再次详细说明 加载因子
同
JDK 1.7,但由于其重要性,故此处再次说明
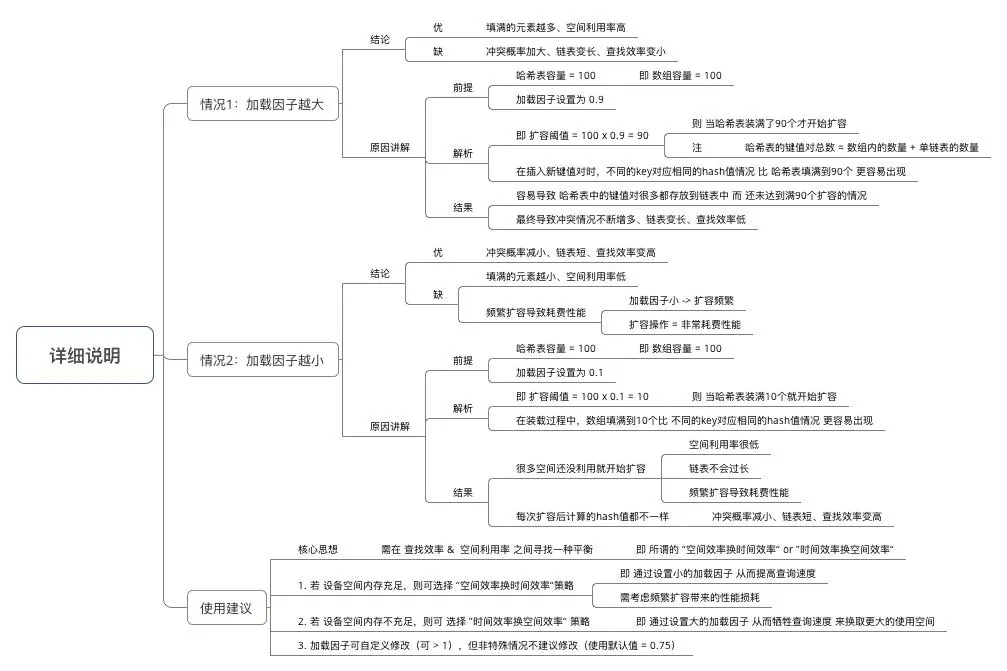
- 总结 数据结构 & 参数方面与
JDK 1.7的区别

5. 源码分析
- 本次的源码分析主要是根据 使用步骤 进行相关函数的详细分析
- 主要分析内容如下:

- 下面,我将对每个步骤内容的主要方法进行详细分析
步骤1:声明1个 HashMap的对象
此处主要分析的构造函数 类似
JDK 1.7
/**
  * 函数使用原型
  */
  Map<String,Integer> map = new HashMap<String,Integer>();

 /**
   * 源码分析:主要是HashMap的构造函数 = 4个
   * 仅贴出关于HashMap构造函数的源码
   */

public class HashMap<K,V>
    extends AbstractMap<K,V>
    implements Map<K,V>, Cloneable, Serializable{

    // 省略上节阐述的参数

  /**
     * 构造函数1:默认构造函数(无参)
     * 加载因子 & 容量 = 默认 = 0.75、16
     */
    public HashMap() {
        this.loadFactor = DEFAULT_LOAD_FACTOR;
    }

    /**
     * 构造函数2:指定“容量大小”的构造函数
     * 加载因子 = 默认 = 0.75 、容量 = 指定大小
     */
    public HashMap(int initialCapacity) {
        // 实际上是调用指定“容量大小”和“加载因子”的构造函数
        // 只是在传入的加载因子参数 = 默认加载因子
        this(initialCapacity, DEFAULT_LOAD_FACTOR);

    }

    /**
     * 构造函数3:指定“容量大小”和“加载因子”的构造函数
     * 加载因子 & 容量 = 自己指定
     */
    public HashMap(int initialCapacity, float loadFactor) {

        // 指定初始容量必须非负,否则报错
         if (initialCapacity < 0)
           throw new IllegalArgumentException("Illegal initial capacity: " +
                                           initialCapacity);

        // HashMap的最大容量只能是MAXIMUM_CAPACITY,哪怕传入的 > 最大容量
        if (initialCapacity > MAXIMUM_CAPACITY)
            initialCapacity = MAXIMUM_CAPACITY;

        // 填充比必须为正
        if (loadFactor <= 0 || Float.isNaN(loadFactor))
            throw new IllegalArgumentException("Illegal load factor: " +
                                           loadFactor);
        // 设置 加载因子
        this.loadFactor = loadFactor;

        // 设置 扩容阈值
        // 注:此处不是真正的阈值,仅仅只是将传入的容量大小转化为:>传入容量大小的最小的2的幂,该阈值后面会重新计算
        // 下面会详细讲解 ->> 分析1
        this.threshold = tableSizeFor(initialCapacity);

    }

    /**
     * 构造函数4:包含“子Map”的构造函数
     * 即 构造出来的HashMap包含传入Map的映射关系
     * 加载因子 & 容量 = 默认
     */

    public HashMap(Map<? extends K, ? extends V> m) {

        // 设置容量大小 & 加载因子 = 默认
        this.loadFactor = DEFAULT_LOAD_FACTOR;

        // 将传入的子Map中的全部元素逐个添加到HashMap中
        putMapEntries(m, false);
    }
}

   /**
     * 分析1:tableSizeFor(initialCapacity)
     * 作用:将传入的容量大小转化为:>传入容量大小的最小的2的幂
     * 与JDK 1.7对比:类似于JDK 1.7 中 inflateTable()里的 roundUpToPowerOf2(toSize)
     */
    static final int tableSizeFor(int cap) {
     int n = cap - 1;
     n |= n >>> 1;
     n |= n >>> 2;
     n |= n >>> 4;
     n |= n >>> 8;
     n |= n >>> 16;
     return (n < 0) ? 1 : (n >= MAXIMUM_CAPACITY) ? MAXIMUM_CAPACITY : n + 1;
}- 注:(同
JDK 1.7类似)- 此处仅用于接收初始容量大小(
capacity)、加载因子(Load factor),但仍无真正初始化哈希表,即初始化存储数组table - 此处先给出结论:真正初始化哈希表(初始化存储数组
table)是在第1次添加键值对时,即第1次调用put()时。下面会详细说明
- 此处仅用于接收初始容量大小(
至此,关于HashMap的构造函数讲解完毕。
步骤2:向HashMap添加数据(成对 放入 键 - 值对)
- 在该步骤中,与
JDK 1.7的差别较大:

下面会对上述区别进行详细讲解
- 添加数据的流程如下
注:为了让大家有个感性的认识,只是简单的画出存储流程,更加详细 & 具体的存储流程会在下面源码分析中给出

- 源码分析
 /**
   * 函数使用原型
   */
   map.put("Android", 1);
        map.put("Java", 2);
        map.put("iOS", 3);
        map.put("数据挖掘", 4);
        map.put("产品经理", 5);

   /**
     * 源码分析:主要分析HashMap的put函数
     */
    public V put(K key, V value) {
        // 1. 对传入数组的键Key计算Hash值 ->>分析1
        // 2. 再调用putVal()添加数据进去 ->>分析2
        return putVal(hash(key), key, value, false, true);
    }
下面,将详细讲解 上面的2个主要分析点
分析1:hash(key)
   /**
     * 分析1:hash(key)
     * 作用:计算传入数据的哈希码(哈希值、Hash值)
     * 该函数在JDK 1.7 和 1.8 中的实现不同,但原理一样 = 扰动函数 = 使得根据key生成的哈希码(hash值)分布更加均匀、更具备随机性,避免出现hash值冲突(即指不同key但生成同1个hash值)
     * JDK 1.7 做了9次扰动处理 = 4次位运算 + 5次异或运算
     * JDK 1.8 简化了扰动函数 = 只做了2次扰动 = 1次位运算 + 1次异或运算
     */

      // JDK 1.7实现:将 键key 转换成 哈希码(hash值)操作  = 使用hashCode() + 4次位运算 + 5次异或运算(9次扰动)
      static final int hash(int h) {
        h ^= k.hashCode();
        h ^= (h >>> 20) ^ (h >>> 12);
        return h ^ (h >>> 7) ^ (h >>> 4);
     }

      // JDK 1.8实现:将 键key 转换成 哈希码(hash值)操作 = 使用hashCode() + 1次位运算 + 1次异或运算(2次扰动)
      // 1. 取hashCode值: h = key.hashCode()
      // 2. 高位参与低位的运算:h ^ (h >>> 16)
      static final int hash(Object key) {
           int h;
            return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
            // a. 当key = null时,hash值 = 0,所以HashMap的key 可为null
            // 注:对比HashTable,HashTable对key直接hashCode(),若key为null时,会抛出异常,所以HashTable的key不可为null
            // b. 当key ≠ null时,则通过先计算出 key的 hashCode()(记为h),然后 对哈希码进行 扰动处理: 按位 异或(^) 哈希码自身右移16位后的二进制
     }

   /**
     * 计算存储位置的函数分析:indexFor(hash, table.length)
     * 注:该函数仅存在于JDK 1.7 ,JDK 1.8中实际上无该函数(直接用1条语句判断写出),但原理相同
     * 为了方便讲解,故提前到此讲解
     */
     static int indexFor(int h, int length) {
          return h & (length-1);
          // 将对哈希码扰动处理后的结果 与运算(&) (数组长度-1),最终得到存储在数组table的位置(即数组下标、索引)
}- 总结 计算存放在数组 table 中的位置(即数组下标、索引)的过程
- 此处与
JDK 1.7的区别在于:hash值的求解过程中 哈希码的二次处理方式(扰动处理) - 步骤1、2 =
hash值的求解过程
- 此处与
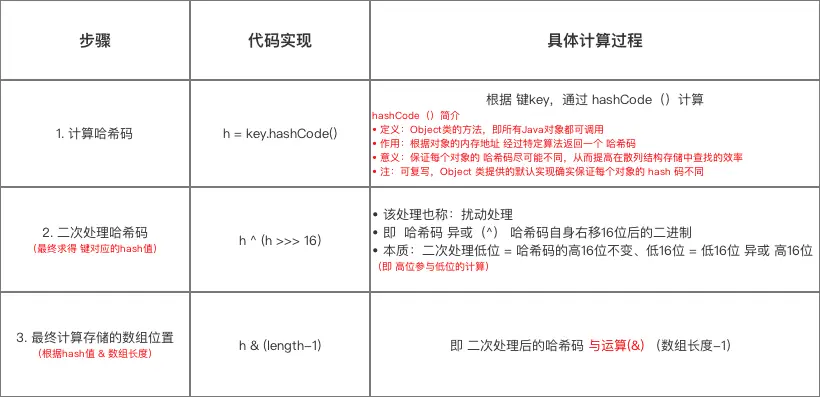
- 计算示意图

在了解 如何计算存放数组table 中的位置 后,所谓 知其然 而 需知其所以然,下面我将讲解为什么要这样计算,即主要解答以下3个问题:
1. 为什么不直接采用经过hashCode()处理的哈希码 作为 存储数组table的下标位置?
2. 为什么采用 哈希码 与运算(&) (数组长度-1) 计算数组下标?
3. 为什么在计算数组下标前,需对哈希码进行二次处理:扰动处理?
在回答这3个问题前,请大家记住一个核心思想:
所有处理的根本目的,都是为了提高 存储
key-value的数组下标位置 的随机性 & 分布均匀性,尽量避免出现hash值冲突。即:对于不同key,存储的数组下标位置要尽可能不一样
问题1:为什么不直接采用经过hashCode()处理的哈希码 作为 存储数组table的下标位置?
- 结论:容易出现 哈希码 与 数组大小范围不匹配的情况,即 计算出来的哈希码可能 不在数组大小范围内,从而导致无法匹配存储位置
- 原因描述

- 为了解决 “哈希码与数组大小范围不匹配” 的问题,
HashMap给出了解决方案:哈希码 与运算(&) (数组长度-1),即问题3
问题2:为什么采用 哈希码 与运算(&) (数组长度-1) 计算数组下标?
-
结论:根据HashMap的容量大小(数组长度),按需取 哈希码一定数量的低位 作为存储的数组下标位置,从而 解决 “哈希码与数组大小范围不匹配” 的问题
-
具体解决方案描述

问题3:为什么在计算数组下标前,需对哈希码进行二次处理:扰动处理?
-
结论:加大哈希码低位的随机性,使得分布更均匀,从而提高对应数组存储下标位置的随机性 & 均匀性,最终减少Hash冲突
-
具体描述

至此,关于怎么计算 key-value 值存储在HashMap数组位置 & 为什么要这么计算,讲解完毕。
分析2:putVal(hash(key), key, value, false, true);
此处有2个主要讲解点:
- 计算完存储位置后,具体该如何 存放数据 到哈希表中
- 具体如何扩容,即 扩容机制
主要讲解点1:计算完存储位置后,具体该如何存放数据到哈希表中
由于数据结构中加入了红黑树,所以在存放数据到哈希表中时,需进行多次数据结构的判断:数组、红黑树、链表
与
JDK 1.7的区别:JDK 1.7只需判断 数组 & 链表

   /**
     * 分析2:putVal(hash(key), key, value, false, true)
     */
     final V putVal(int hash, K key, V value, boolean onlyIfAbsent,
               boolean evict) {

            Node<K,V>[] tab; Node<K,V> p; int n, i;

        // 1. 若哈希表的数组tab为空,则 通过resize() 创建
        // 所以,初始化哈希表的时机 = 第1次调用put函数时,即调用resize() 初始化创建
        // 关于resize()的源码分析将在下面讲解扩容时详细分析,此处先跳过
        if ((tab = table) == null || (n = tab.length) == 0)
        n = (tab = resize()).length;

        // 2. 计算插入存储的数组索引i:根据键值key计算的hash值 得到
        // 此处的数组下标计算方式 = i = (n - 1) & hash,同JDK 1.7中的indexFor(),上面已详细描述

        // 3. 插入时,需判断是否存在Hash冲突:
        // 若不存在(即当前table[i] == null),则直接在该数组位置新建节点,插入完毕
        // 否则,代表存在Hash冲突,即当前存储位置已存在节点,则依次往下判断:a. 当前位置的key是否与需插入的key相同、b. 判断需插入的数据结构是否为红黑树 or 链表
        if ((p = tab[i = (n - 1) & hash]) == null)
        tab[i] = newNode(hash, key, value, null);  // newNode(hash, key, value, null)的源码 = new Node<>(hash, key, value, next)

    else {
        Node<K,V> e; K k;

        // a. 判断 table[i]的元素的key是否与 需插入的key一样,若相同则 直接用新value 覆盖 旧value
        // 判断原则:equals()
        if (p.hash == hash &&
            ((k = p.key) == key || (key != null && key.equals(k))))
            e = p;

        // b. 继续判断:需插入的数据结构是否为红黑树 or 链表
        // 若是红黑树,则直接在树中插入 or 更新键值对
        else if (p instanceof TreeNode)
            e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value); ->>分析3

        // 若是链表,则在链表中插入 or 更新键值对
        // i.  遍历table[i],判断Key是否已存在:采用equals() 对比当前遍历节点的key 与 需插入数据的key:若已存在,则直接用新value 覆盖 旧value
        // ii. 遍历完毕后仍无发现上述情况,则直接在链表尾部插入数据
        // 注:新增节点后,需判断链表长度是否>8(8 = 桶的树化阈值):若是,则把链表转换为红黑树

        else {
            for (int binCount = 0; ; ++binCount) {
                // 对于ii:若数组的下1个位置,表示已到表尾也没有找到key值相同节点,则新建节点 = 插入节点
                // 注:此处是从链表尾插入,与JDK 1.7不同(从链表头插入,即永远都是添加到数组的位置,原来数组位置的数据则往后移)
                if ((e = p.next) == null) {
                    p.next = newNode(hash, key, value, null);

                    // 插入节点后,若链表节点>数阈值,则将链表转换为红黑树
                    if (binCount >= TREEIFY_THRESHOLD - 1)
                        treeifyBin(tab, hash); // 树化操作
                    break;
                }

                // 对于i
                if (e.hash == hash &&
                    ((k = e.key) == key || (key != null && key.equals(k))))
                    break;

                // 更新p指向下一个节点,继续遍历
                p = e;
            }
        }

        // 对i情况的后续操作:发现key已存在,直接用新value 覆盖 旧value & 返回旧value
        if (e != null) {
            V oldValue = e.value;
            if (!onlyIfAbsent || oldValue == null)
                e.value = value;
            afterNodeAccess(e); // 替换旧值时会调用的方法(默认实现为空)
            return oldValue;
        }
    }

    ++modCount;

    // 插入成功后,判断实际存在的键值对数量size > 最大容量threshold
    // 若 > ,则进行扩容 ->>分析4(但单独讲解,请直接跳出该代码块)
    if (++size > threshold)
        resize();

    afterNodeInsertion(evict);// 插入成功时会调用的方法(默认实现为空)
    return null;

}

    /**
     * 分析3:putTreeVal(this, tab, hash, key, value)
     * 作用:向红黑树插入 or 更新数据(键值对)
     * 过程:遍历红黑树判断该节点的key是否与需插入的key 相同:
     *      a. 若相同,则新value覆盖旧value
     *      b. 若不相同,则插入
     */

     final TreeNode<K,V> putTreeVal(HashMap<K,V> map, Node<K,V>[] tab,
                                       int h, K k, V v) {
            Class<?> kc = null;
            boolean searched = false;
            TreeNode<K,V> root = (parent != null) ? root() : this;
            for (TreeNode<K,V> p = root;;) {
                int dir, ph; K pk;
                if ((ph = p.hash) > h)
                    dir = -1;
                else if (ph < h)
                    dir = 1;
                else if ((pk = p.key) == k || (k != null && k.equals(pk)))
                    return p;
                else if ((kc == null &&
                          (kc = comparableClassFor(k)) == null) ||
                         (dir = compareComparables(kc, k, pk)) == 0) {
                    if (!searched) {
                        TreeNode<K,V> q, ch;
                        searched = true;
                        if (((ch = p.left) != null &&
                             (q = ch.find(h, k, kc)) != null) ||
                            ((ch = p.right) != null &&
                             (q = ch.find(h, k, kc)) != null))
                            return q;
                    }
                    dir = tieBreakOrder(k, pk);
                }

                TreeNode<K,V> xp = p;
                if ((p = (dir <= 0) ? p.left : p.right) == null) {
                    Node<K,V> xpn = xp.next;
                    TreeNode<K,V> x = map.newTreeNode(h, k, v, xpn);
                    if (dir <= 0)
                        xp.left = x;
                    else
                        xp.right = x;
                    xp.next = x;
                    x.parent = x.prev = xp;
                    if (xpn != null)
                        ((TreeNode<K,V>)xpn).prev = x;
                    moveRootToFront(tab, balanceInsertion(root, x));
                    return null;
                }
            }
}- 总结

主要讲解点2:扩容机制(即 resize()函数方法)
- 扩容流程如下

- 源码分析
   /**
     * 分析4:resize()
     * 该函数有2种使用情况:1.初始化哈希表 2.当前数组容量过小,需扩容
     */
   final Node<K,V>[] resize() {
    Node<K,V>[] oldTab = table; // 扩容前的数组(当前数组)
    int oldCap = (oldTab == null) ? 0 : oldTab.length; // 扩容前的数组的容量 = 长度
    int oldThr = threshold;// 扩容前的数组的阈值
    int newCap, newThr = 0;

    // 针对情况2:若扩容前的数组容量超过最大值,则不再扩充
    if (oldCap > 0) {
        if (oldCap >= MAXIMUM_CAPACITY) {
            threshold = Integer.MAX_VALUE;
            return oldTab;
        }

        // 针对情况2:若无超过最大值,就扩充为原来的2倍
        else if ((newCap = oldCap << 1) < MAXIMUM_CAPACITY &&
                 oldCap >= DEFAULT_INITIAL_CAPACITY)
            newThr = oldThr << 1; // 通过右移扩充2倍
    }

    // 针对情况1:初始化哈希表(采用指定 or 默认值)
    else if (oldThr > 0) // initial capacity was placed in threshold
        newCap = oldThr;

    else {               // zero initial threshold signifies using defaults
        newCap = DEFAULT_INITIAL_CAPACITY;
        newThr = (int)(DEFAULT_LOAD_FACTOR * DEFAULT_INITIAL_CAPACITY);
    }

    // 计算新的resize上限
    if (newThr == 0) {
        float ft = (float)newCap * loadFactor;
        newThr = (newCap < MAXIMUM_CAPACITY && ft < (float)MAXIMUM_CAPACITY ?
                  (int)ft : Integer.MAX_VALUE);
    }

    threshold = newThr;
    @SuppressWarnings({"rawtypes","unchecked"})
        Node<K,V>[] newTab = (Node<K,V>[])new Node[newCap];
    table = newTab;

    if (oldTab != null) {
        // 把每个bucket都移动到新的buckets中
        for (int j = 0; j < oldCap; ++j) {
            Node<K,V> e;
            if ((e = oldTab[j]) != null) {
                oldTab[j] = null;

                if (e.next == null)
                    newTab[e.hash & (newCap - 1)] = e;
                else if (e instanceof TreeNode)
                    ((TreeNode<K,V>)e).split(this, newTab, j, oldCap);

                else { // 链表优化重hash的代码块
                    Node<K,V> loHead = null, loTail = null;
                    Node<K,V> hiHead = null, hiTail = null;
                    Node<K,V> next;
                    do {
                        next = e.next;
                        // 原索引
                        if ((e.hash & oldCap) == 0) {
                            if (loTail == null)
                                loHead = e;
                            else
                                loTail.next = e;
                            loTail = e;
                        }
                        // 原索引 + oldCap
                        else {
                            if (hiTail == null)
                                hiHead = e;
                            else
                                hiTail.next = e;
                            hiTail = e;
                        }
                    } while ((e = next) != null);
                    // 原索引放到bucket里
                    if (loTail != null) {
                        loTail.next = null;
                        newTab[j] = loHead;
                    }
                    // 原索引+oldCap放到bucket里
                    if (hiTail != null) {
                        hiTail.next = null;
                        newTab[j + oldCap] = hiHead;
                    }
                }
            }
        }
    }
    return newTab;
}- 扩容流程(含 与
JDK 1.7的对比)

此处主要讲解: JDK 1.8扩容时,数据存储位置重新计算的方式
- 计算结论 & 原因解析

- 结论示意图

- 数组位置转换的示意图

JDK 1.8根据此结论作出的新元素存储位置计算规则 非常简单,提高了扩容效率,具体如下图这与
JDK 1.7在计算新元素的存储位置有很大区别:JDK 1.7在扩容后,都需按照原来方法重新计算,即
hashCode()->> 扰动处理 ->>(h & length-1))
总结
- 添加数据的流程

- 与
JDK 1.7的区别

至此,关于 HashMap的添加数据源码分析 分析完毕。
步骤3:从HashMap中获取数据
- 假如理解了上述
put()函数的原理,那么get()函数非常好理解,因为二者的过程原理几乎相同 get()函数的流程如下:

- 源码分析
/**
   * 函数原型
   * 作用:根据键key,向HashMap获取对应的值
   */
   map.get(key);


 /**
   * 源码分析
   */
   public V get(Object key) {
    Node<K,V> e;
    // 1. 计算需获取数据的hash值
    // 2. 通过getNode()获取所查询的数据 ->>分析1
    // 3. 获取后,判断数据是否为空
    return (e = getNode(hash(key), key)) == null ? null : e.value;
}

/**
   * 分析1:getNode(hash(key), key))
   */
final Node<K,V> getNode(int hash, Object key) {
    Node<K,V>[] tab; Node<K,V> first, e; int n; K k;

    // 1. 计算存放在数组table中的位置
    if ((tab = table) != null && (n = tab.length) > 0 &&
        (first = tab[(n - 1) & hash]) != null) {

        // 4. 通过该函数,依次在数组、红黑树、链表中查找(通过equals()判断)
        // a. 先在数组中找,若存在,则直接返回
        if (first.hash == hash && // always check first node
            ((k = first.key) == key || (key != null && key.equals(k))))
            return first;

        // b. 若数组中没有,则到红黑树中寻找
        if ((e = first.next) != null) {
            // 在树中get
            if (first instanceof TreeNode)
                return ((TreeNode<K,V>)first).getTreeNode(hash, key);

            // c. 若红黑树中也没有,则通过遍历,到链表中寻找
            do {
                if (e.hash == hash &&
                    ((k = e.key) == key || (key != null && key.equals(k))))
                    return e;
            } while ((e = e.next) != null);
        }
    }
    return null;
}
至此,关于 “向 HashMap 获取数据 “讲解完毕。
步骤4:对HashMap的其他操作
即 对其余使用
API(函数、方法)的源码分析
-HashMap除了核心的put()、get()函数,还有以下主要使用的函数方法
void clear(); // 清除哈希表中的所有键值对
int size();  // 返回哈希表中所有 键值对的数量 = 数组中的键值对 + 链表中的键值对
boolean isEmpty(); // 判断HashMap是否为空;size == 0时 表示为 空

void putAll(Map<? extends K, ? extends V> m);  // 将指定Map中的键值对 复制到 此Map中
V remove(Object key);  // 删除该键值对

boolean containsKey(Object key); // 判断是否存在该键的键值对;是 则返回true
boolean containsValue(Object value);  // 判断是否存在该值的键值对;是 则返回true
- 关于上述方法的源码的原理 同
JDK 1.7,此处不作过多描述感兴趣的同学可以参考文章 第5小节 进行类比。
至此,关于 HashMap的底层原理 & 主要使用API(函数、方法)讲解完毕。
6. 源码总结
下面,用3个图总结整个源码内容:
总结内容 = 数据结构、主要参数、添加 & 查询数据流程、扩容机制
- 数据结构 & 主要参数

- 添加 & 查询数据流程

- 扩容机制

7. 与 JDK 1.7 的区别
HashMap 的实现在 JDK 1.7 和 JDK 1.8 差别较大,具体区别如下
JDK 1.8的优化目的主要是:减少Hash冲突 & 提高哈希表的存、取效率- 关于
JDK 1.7中HashMap的源码解析请看文章:Java:手把手带你源码分析 HashMap 1.7
7.1 数据结构

7.2 获取数据时(获取数据 类似)

7.3 扩容机制

8. 额外补充:关于HashMap的其他问题
- 有几个小问题需要在此补充

- 具体如下
8.1 哈希表如何解决Hash冲突

8.2 为什么HashMap具备下述特点:键-值(key-value)都允许为空、线程不安全、不保证有序、存储位置随时间变化
- 具体解答如下

-
下面主要讲解
HashMap线程不安全的其中一个重要原因:多线程下容易出现resize()死循环
本质 = 并发 执行put()操作导致触发 扩容行为,从而导致 环形链表,使得在获取数据遍历链表时形成死循环,即Infinite Loop -
先看扩容的源码分析
resize()关于resize()的源码分析已在上文详细分析,此处仅作重点分析:transfer()
/**
   * 源码分析:resize(2 * table.length)
   * 作用:当容量不足时(容量 > 阈值),则扩容(扩到2倍)
   */
   void resize(int newCapacity) {

    // 1. 保存旧数组(old table)
    Entry[] oldTable = table;

    // 2. 保存旧容量(old capacity ),即数组长度
    int oldCapacity = oldTable.length;

    // 3. 若旧容量已经是系统默认最大容量了,那么将阈值设置成整型的最大值,退出
    if (oldCapacity == MAXIMUM_CAPACITY) {
        threshold = Integer.MAX_VALUE;
        return;
    }

    // 4. 根据新容量(2倍容量)新建1个数组,即新table
    Entry[] newTable = new Entry[newCapacity];

    // 5. (重点分析)将旧数组上的数据(键值对)转移到新table中,从而完成扩容 ->>分析1.1
    transfer(newTable);

    // 6. 新数组table引用到HashMap的table属性上
    table = newTable;

    // 7. 重新设置阈值
    threshold = (int)(newCapacity * loadFactor);
}

 /**
   * 分析1.1:transfer(newTable);
   * 作用:将旧数组上的数据(键值对)转移到新table中,从而完成扩容
   * 过程:按旧链表的正序遍历链表、在新链表的头部依次插入
   */
void transfer(Entry[] newTable) {
      // 1. src引用了旧数组
      Entry[] src = table;

      // 2. 获取新数组的大小 = 获取新容量大小
      int newCapacity = newTable.length;

      // 3. 通过遍历 旧数组,将旧数组上的数据(键值对)转移到新数组中
      for (int j = 0; j < src.length; j++) {
          // 3.1 取得旧数组的每个元素
          Entry<K,V> e = src[j];
          if (e != null) {
              // 3.2 释放旧数组的对象引用(for循环后,旧数组不再引用任何对象)
              src[j] = null;

              do {
                  // 3.3 遍历 以该数组元素为首 的链表
                  // 注:转移链表时,因是单链表,故要保存下1个结点,否则转移后链表会断开
                  Entry<K,V> next = e.next;
                 // 3.3 重新计算每个元素的存储位置
                 int i = indexFor(e.hash, newCapacity);
                 // 3.4 将元素放在数组上:采用单链表的头插入方式 = 在链表头上存放数据 = 将数组位置的原有数据放在后1个指针、将需放入的数据放到数组位置中
                 // 即 扩容后,可能出现逆序:按旧链表的正序遍历链表、在新链表的头部依次插入
                 e.next = newTable[i];
                 newTable[i] = e;
                 // 访问下1个Entry链上的元素,如此不断循环,直到遍历完该链表上的所有节点
                 e = next;
             } while (e != null);
             // 如此不断循环,直到遍历完数组上的所有数据元素
         }
     }
}从上面可看出:在扩容resize()过程中,在将旧数组上的数据 转移到 新数组上时,转移数据操作 = 按旧链表的正序遍历链表、在新链表的头部依次插入,即在转移数据、扩容后,容易出现链表逆序的情况
设重新计算存储位置后不变,即扩容前 = 1->2->3,扩容后 = 3->2->1
- 此时若(多线程)并发执行
put()操作,一旦出现扩容情况,则 容易出现 环形链表,从而在获取数据、遍历链表时 形成死循环(Infinite Loop),即 死锁的状态,具体请看下图:
初始状态、步骤1、步骤2


注:由于 JDK 1.8 转移数据操作 = 按旧链表的正序遍历链表、在新链表的尾部依次插入,所以不会出现链表 逆序、倒置的情况,故不容易出现环形链表的情况。
但
JDK 1.8还是线程不安全,因为 无加同步锁保护
8.3 为什么 HashMap 中 String、Integer 这样的包装类适合作为 key 键

8.4 HashMap 中的 key若 Object类型, 则需实现哪些方法?

至此,关于HashMap的所有知识讲解完毕。
9. 总结
- 本文主要讲解
Java的HashMap源码 & 相关知识 - 下面我将继续对
Java、Android中的其他知识 深入讲解 ,有兴趣可以继续关注Carson_Ho的安卓开发笔记

 284


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


