从海量互联网视频中检索人类操作示范,英伟达联合莱斯大学发布RoboTok,提升下游机器人任务成功率

RoboTok:从互联网视频检索机器人操作示范的解析 机器人操作学习长期受困于示范数据的获取成本:遥操作采集昂贵,仿真数据存在sim-to-real gap,开源数据集又难以覆盖长尾任务。一个自然的新思路是从海量互联网视频中挖掘人类操作示范,将其作为可扩展的示范数据库。但是互联网视频粒度粗、语义杂、相关性难判定,直接训练端到端模型既昂贵又不可控。RoboTok采用检索增强的思路,利用CLIP等跨模态模型将任务文本与视频片段映射到同一向量空间,配合向量索引与混合检索,把“找示范”变成高效可计算的问题,并输出对机器人策略训练真正有用的示范片段。这种做法提高了示范数 阅读详情

过去几年,具身智能快速升温。从机械臂到人形机器人,从工业装配到家庭服务,越来越多机器人开始尝试从感知走向决策,再进一步完成真实世界中的复杂操作。

广泛且多样化的示范数据对于机器人学习至关重要,然而,采集这类示范数据的成本依然高昂,并且难以扩展到现实世界中数量庞大的长尾任务、物体和环境。从现有数据中进行检索,为这一问题提供了一种颇具潜力的替代方案,使学习系统能够识别与特定任务相关的示范数据,而无需反复采集新的机器人数据。其中,互联网视频尤其具有吸引力,因为其中包含了海量且持续增长的人类操作行为,覆盖多样化的场景、物体和视角。

互联网中的人类示范视频尤其适用于人形机器人和仿生灵巧手,然而挑战在于,网络视频本质上是非结构化的,其拍摄视角、场景以及遮挡情况都具有高度不确定性。更为根本的是,视觉或语义上的相似性并不一定意味着底层操作行为具有相似性。因此,一个能够在互联网规模上运行的数据引擎,必须能够自动地从异构视频中识别并筛选与操作相关的行为,而不能依赖任务标签、视觉外观或特定的摄像机配置。

在此背景下,来自莱斯大学和英伟达的研究团队提出了一种面向互联网规模数据的人类示范非参数检索数据引擎 RoboTok,能够为下游机器人操作策略提供与任务相关的、基于轨迹的训练数据。与构建一个固定的数据集不同,RoboTok 能够持续对网络视频进行索引,将其作为一种可不断扩展的示范数据来源;给定一段示范视频作为查询,RoboTok 能够检索出具有相似操作行为的视频示例。

研究人员在检索基准测试以及下游机器人策略性能两方面,将 RoboTok 与现有的机器人数据检索方法进行了对比评估,结果表明,RoboTok 能够检索到相关性更高的操作示范数据,并进一步提升下游机器人任务的成功率。

相关研究成果以「RoboTok: An Internet-Scale Data Engine for Human Demonstration Retrieval and Dexterous Manipulation Learning」为题,已发布预印本于 arXiv。

研究亮点:

* RoboTok 是首个专门设计用于从互联网人类视频中挖掘数据、服务于灵巧操作学习的检索框架

* 即使行为主体本身并未直接出现在视频画面中,本研究提出的方法依然能够有效工作,并使系统能够跨越不同拍摄视角以及示范过程中的各种遮挡情况

* RoboTok 能够从持续扩张的互联网人类视频数据中,发现并筛选出与操作行为高度相关的示范数据,为灵巧机器人学习提供了一种可持续扩展的数据来源

图片

论文地址:
https://hyper.ai/papers/2609.03199

互联网人类示范视频中海量且持续增长的操作行为数据

近年来,机器人学习的发展越来越依赖于大规模、多样化的示范数据集。Octo、OpenVLA、SpatialVLA 和 CLIP-RT 等视觉-语言-动作模型(Vision-Language-Action, VLA)以及机器人基础模型,通过在包含不同任务、环境和机器人本体的数据集合上进行训练,学习通用的机器人操作技能。

与上述路线不同,RoboTok 探索了一种互补的数据来源——互联网人类示范视频中海量且持续增长的操作行为数据。互联网视频能够提供所需的数据多样性,但不同视频在摄像机视角、场景外观以及行为主体可见程度等方面存在显著差异。因此,研究人员首先对候选视频片段进行筛选,然后重建具有真实尺度的三维手部姿态,最后将不同视频中的轨迹规范化到一个统一的、以行为主体为中心的参考坐标系中,以便进行基于运动的比较和监督。

完整的数据处理流程如下图所示:

图片

对互联网视频进行筛选,保留其中手部清晰可见且摄像机基本保持静止的视频片段。随后,从每个视频片段中提取手部运动轨迹,并将其重建为具有真实尺度的三维轨迹

数据来源与视频片段筛选

为收集用于训练 RoboTok 检索编码器的数据,研究人员从大规模互联网视频语料库 Action100M 中处理视频片段。这些视频此前已经经过预筛选,确保其中包含人类行为。随后,进一步通过自动化方式筛选候选片段,仅保留时长为 4–8 秒、摄像机基本保持静止,且能够保持一定程度手部可见性的视频。每个视频片段最多包含一只左手和一只右手。对于剩余的相互重叠的视频片段,采用贪心策略进行去重,优先保留时长更长的视频片段。

手部姿态提取与真实尺度构建:

对于每一个保留下来的视频片段,使用 WiLoR 以 5 fps 的频率估计三维手部关键点,并通过在不同视频帧之间关联手部检测结果,对左右手的身份进行稳定追踪;对于缺失的手部姿态,则使用 HaWoR 进行补全。

经过上述处理后,将得到一个由长度不一的三维手部姿态序列构成的视频语料库。

一种面向互联网规模数据的数据引擎

在数据基础之上,RoboTok 真正的创新集中在其检索模型。研究人员的目标是学习一个嵌入空间(embedding space),使其能够近似由 DTW 定义的操作行为相似度,同时支持在大规模数据集上进行高效的最近邻检索(见下图)。

图片

每条自我中心轨迹都会被编码一次,并映射到 RoboTok 学习得到的运动嵌入空间中

编码器(Encoder)

RoboTok 检索模型采用一种轻量级轨迹编码器,直接处理以自我中心坐标表示的三维手部轨迹。对于轨迹中的每一帧,模型首先进行位置编码(positional encoding),随后通过一个轻量级的交叉注意力网络(cross-attention network)对序列信息进行聚合,最终生成一个经过归一化的嵌入向量。由于输入数据本身已经编码了手部运动的时空姿态信息,因此编码器被有意设计得较为轻量,其主要作用是根据操作行为相似度对不同轨迹进行组织和排列。

批次构建(Batch Construction)

在 RoboTok 的训练语料规模 (N=100,000) 下,如果随机采样一个大小为 (b=196) 的训练批次,那么其中包含与某条轨迹在 DTW 判据下高度相似轨迹的概率非常低,因此研究人员采用以锚点为中心的分组方式(anchor-centered groups)来构建训练批次。对于每个锚点,随机采样两条轨迹作为正样本(positives),同时从相关集合之外紧邻的位置选择一条轨迹作为边界负样本(boundary negative),由此形成一个分组,每个训练批次包含 49 个这样的分组,总计得到 196 条轨迹。

训练目标(Objective)

训练目标由两部分组成:

集合损失(set loss):鼓励 DTW 判据下排名前 (K) 的邻居,其得分高于边界轨迹和负样本轨迹;

排序损失(rank loss):鼓励采样得到的正样本之间的相对排序,与 DTW 所确定的相似度排序保持一致。

其中,集合损失决定哪些轨迹能够进入检索得到的邻域,而排序损失则决定这些轨迹在邻域内部的相对排序。二者结合,使模型学习到能够复现局部 DTW 邻域结构的嵌入空间,同时重点优化实际检索过程中最为重要的那部分相似度排序。

推理与检索(Inference)

RoboTok 的检索过程分为离线和在线两个阶段:在离线阶段,每一条自我中心轨迹只需要通过编码器进行一次编码,并将生成的嵌入向量存储到内积索引(inner-product index)中。当用户输入一段查询视频后,在线阶段可以直接在该索引中进行余弦相似度最近邻搜索,从而获得最相近的示范轨迹,而无需针对整个数据集逐一计算 DTW。这种设计将计算成本较高的轨迹比较过程转移到了训练阶段,同时使实际检索过程能够随着数据集规模的增长保持较高的效率。

此外,新采集的视频片段也可以直接通过编码器生成嵌入向量,并加入现有索引,无需重新训练模型。因此,RoboTok 能够作为一种具有持续扩展能力的互联网规模机器人示范数据引擎,不断吸收新增的人类操作视频,并为机器人学习提供可持续增长的示范数据。

RoboTok 能够检索到相关性更高的操作示范数据

为了评估 RoboTok 轨迹编码器的检索质量,并将其与基线示范检索方法进行比较,研究人员采用两个数据语料库开展实验。参与对比的基线方法包括 Random(随机检索视频片段)、FlowRetrieval(Flow)、HAND 和 STRAP,此外还报告了 DTW 判据的排序结果,将其作为理论上的性能上限。

检索质量评估

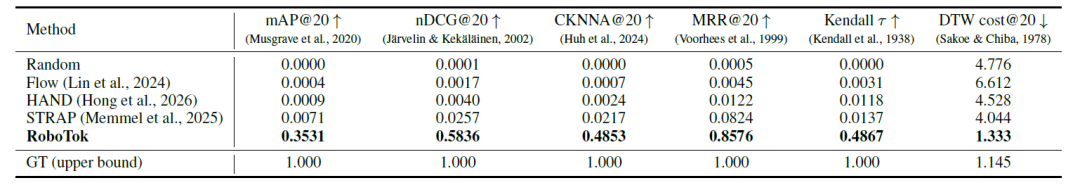
研究首先在 RoboTok 自身的评估语料库上测试检索能力——在以 DTW 伪真实标签为标准的评估中,Flow、HAND 和 STRAP 的检索性能都非常有限(见下表)。其中表现最好的基线方法 STRAP,其 mAP@20 仅为 0.007,Recall@20 为 0.12;FlowRetrieval 和 HAND 的表现则基本接近随机水平。
图片

RoboTok 评估语料库上的未见数据检索质量

相比之下,RoboTok 达到了 mAP@20 = 0.353、Recall@20 = 0.996。这意味着,对于几乎所有查询视频,RoboTok 都能够在排名前 20 的结果中找到一个真正的 DTW 邻居。与此同时,其 Kendall’s (\tau) 达到 0.487,表明 RoboTok 不仅能够将相关示范检索出来,而且能够对这些示范进行相对正确的排序,而不是仅仅将相关样本混入检索结果。

为了进一步测试 RoboTok 能否迁移到其训练语料库之外的数据,研究人员在 AssemblyHands 数据集上重复进行了检索实验。如下表所示,各方法的最终排名与前述实验基本保持一致,RoboTok 在所有评估指标上均取得最佳表现。其 mAP@5 达到 0.261,明显高于 STRAP 的 0.133。

图片

在 AssemblyHands 双手装配视频语料库上测量的检索质量

在平均 DTW 代价方面,RoboTok 检索结果为 1.095 m;真实邻居的平均 DTW 代价为 0.966 m,即 RoboTok 的结果仅比最优结果高 13%。相比之下,随机检索视频的平均 DTW 代价达到 1.911 m。

与在 RoboTok 自有评估语料库上的结果相比,AssemblyHands 上的性能差距有所缩小,这也是跨数据集迁移条件下较为自然的现象。不过,实验仍然表明,RoboTok 在不同数据域中都能够持续检索出与目标操作运动更加匹配的人类示范,整体表现稳定优于现有基线方法。

基于示范引导的下游策略评估

只有当检索得到的示范视频能够真正改善下游机器人策略时,这些示范数据才具有实际价值。为验证这一点,研究人员在 VTDexManip 这一灵巧操作仿真基准上,评估由检索示范数据引导训练得到的机器人策略。在原始任务设置下,使用 RoboTok 检索结果进行引导的策略,在 6 个任务中的 5 个任务上超过了基准测试中表现最佳的预训练方法(见下表)。

图片

原始 VTDexManip 任务设定下所有任务的成功率(%)

综合全部 6 个任务来看,与已公布结果中的最佳基线相比,RoboTok 在已见物体上的平均成功率提高了 7.45%,在未见物体上的平均成功率提高了 5.83%。

在难度更高的任务设置中——即不再限制手部保持静态位置,同时移除大量人工设计的稠密奖励——由 RoboTok 检索示范进行引导的策略,则大幅领先于由其他基线方法检索结果引导的模型(见下表)。

图片

在修改后的高难度 VTDexManip 任务设定(Liu 等,2025)下,不同检索方法所检索示范数据引导的 PPO 策略在各项任务中的成功率(%)

在 BottleCap Turning 任务中,RoboTok 在已见物体上的成功率达到 77.3%,比排名第二的 HAND 提高 17.8 个百分点。

在 Faucet Screwing 任务中,RoboTok 达到 44.8%,比下一最佳方法 HAND 提高 38.0 个百分点。

在 Lever Sliding 任务中,RoboTok 在已见物体上的成功率达到 79.3%,比 HAND 提高 59.8 个百分点。

结语

更广泛而言,本研究证明了一个重要方向:互联网视频可以成为机器人获取操作数据的一种可规模化、持续增长的数据来源。与完全依赖固定、专门构建的机器人数据集不同,随着网络视频内容不断增长,RoboTok能够持续从中挖掘新的人类操作示范,从而使机器人能够接触到范围更加广泛的任务、物体和环境。

未来,研究团队计划进一步将 RoboTok 扩展至由运动摄像机拍摄的视频,包括第三人称视角和自我中心视角的示范视频。研究团队认为,这一方向有望进一步缓解机器人学习长期面临的数据采集瓶颈,并使机器人能够充分利用互联网中已经存在的、规模庞大且高度多样化的人类操作示范数据。

RoboTok:用互联网视频检索突破机器人操作数据瓶颈 人工智能的三大支柱中,数据决定了模型能力的上限。与文本和图像数据不同,机器人操作数据难以规模化获取,这成为模仿学习落地的关键瓶颈。检索增强生成(RAG)在语言模型中已被验证为有效的知识扩展方案,其核心思想是“先检索,再生成”。RoboTok将这一理念引入机器人领域,通过细粒度视频理解与对比学习,从海量人类操作视频中定位到特定动作片段,为策略模型提供外部操作记忆。该方案可显著提升复杂任务的成功率,并降低对遥操作采集数据的依赖。在工业分拣、家庭服务等长程操作场景中,检索增强为小样本学习提供了可行路径,正成为机器 阅读详情

相关推荐

RoboTok:用检索增强从互联网视频中挖掘机器人示范数据

互联网视频中蕴藏着海量人类操作知识,但如何将这些非结构化数据转化为机器人可用的示范信息,一直是具身智能与模仿学习领域的难点。RoboTok 提出一种检索增强的解决思路:通过跨模态语义检索,将自然语言任务指令与视频片段映射到同一向量空间,并借助时间定位精准截取有效动作片段,从而为下游策略提供高质量参考示范。其技术价值在于把庞大的视频库变成可按需调用的外部记忆,无需重新训练模型即可持续积累新技能,显著降低对真实遥操作数据的依赖。这种方案适用于桌面操作、家务整理、工业换型等场景,尤其适合缺乏大规模采集团队的高校实

weixin_32487557的博客 43

RoboTok:用视频检索让机器人从互联网示范中学会操作

机器人操作学习对数据的依赖极为挑剔,传统遥操作与仿真数据难以满足规模化需求。互联网上海量的人类示范视频蕴含丰富的任务语义与交互先验,但如何将其转化为机器人可用的训练信号,是模仿学习与具身智能领域的核心挑战。RoboTok提出了一种以检索为核心的流水线,通过场景理解、跨视频推理与条件视频生成,将非结构化视频压缩为下游策略可消费的示范信息,从而显著提升任务成功率。本文从概念、原理到技术价值层层展开,解析RoboTok如何利用视频检索增强模仿学习,并探讨其在现实工程中的应用与边界,为研究者提供可迁移的数据利用思路

weixin_29051811的博客 157

三菱CNC数据采集实战:从SDK安装到C#代码调试全流程(附完整资源包)

本文为C#开发者提供了三菱CNC数据采集的完整实战指南。详细介绍了从获取并安装核心A2协议SDK、配置Visual Studio开发环境,到理解COM接口文档、封装C#通信类,并构建具备多设备连接与定时采集功能的WinForms应用程序的全流程。文章重点分享了网络调试、异常处理及性能优化等关键实战经验,帮助开发者高效打通工业自动化数据采集链路。

oauth7security的博客 707

RoboTok:从互联网视频检索人类示范,破解机器人模仿学习的数据难题

在机器人操作领域,模仿学习依赖大量高质量示范数据,但人工采集成本高昂,仿真迁移又存在物理差异。如何从海量互联网视频中提取可用的操作示范,成为具身智能落地的关键问题。RoboTok提出一种视频-语言-动作三元对齐的检索增强方法,利用跨模态语义匹配,将任务描述与视频片段在向量空间中对齐,再作为条件输入注入策略网络,显著提升下游任务成功率。这种检索增强生成思想源于NLP,却在机器人领域展现出独特价值,尤其适合家庭服务、柔性制造等开放场景。本文从技术动机、核心架构、工程落地三个维度拆解RoboTok,并讨论数据流水

weixin_29038155的博客 248

四自由度SCARA机器人的运动学和动力学MATLAB建模与仿真

本文介绍了四自由度SCARA机器人的运动学和动力学建模,使用MATLAB进行了相应的建模与仿真。通过正运动学和动力学分析,可以了解机器人在不同状态下的运动特性和力学特性。这为后续的控制算法设计和性能优化打下了基础。希望本教程对学习SCARA机器人有帮助。

小蜗牛的珍贵百宝箱 3638

硬件工程师的蜗牛成长路

1、《模拟电路课程》R/L/C/继电器/光耦/二极管/三极管/MOS管磁珠/ESD/TVS/肖特基二极管/稳压二极管/保险丝/GDT/TSS/光耦/MOS/运放/BJT比较器/面板开关/按键开关/拨码开关/BUCK/LDO/电源防护器件LM5069单输出PLL/多路输出PLL/单端晶振/差分晶振/晶体(这方面不熟悉,待以后补充)1)速度传感器2)温度传感器3)倾斜角传感器4)火焰传感器5)红外传感器6)呼吸心跳采集chaunganqi1)数字隔离 电平转换芯片/磁隔离/专用隔离芯片。

caozhaokun的博客 1982

RoboTok:从海量互联网视频中自动检索机器人操作示范数据

机器人操作学习的关键瓶颈往往不在模型结构,而在于高质量训练数据的获取。互联网视频虽数量庞大,但真正目标明确、动作清晰、过程完整的操作片段却混杂在大量噪声中。如何从这些非结构化视频里自动筛选出可用的示范数据,成为提升机器人学习效率的核心问题。视频检索与动作识别技术的结合,为这一问题提供了新的解决思路:通过粗粒度文本筛选与细粒度动作语义对齐,系统能够在海量视频中定位到与任务描述匹配的动作片段,并输出结构化的时间边界与动作标签。这种数据侧的自动化管线,极大降低了人工标注成本,也让互联网视频成为机器人训练资料的可持

weixin_32678995的博客 126

复旦微实现串口在线升级BOOT.BIN

将该 demo 生成的 app(升级用)和 fsbl、最简化 bit 文件(可选)打包成 BOOT.BIN,作为 golden image 烧写在 qspi flash 偏移 0 地址开始的位置,其中最简化 bit 文件为在线升级功能提供必要的物理通道(如果不需要,可以不打包该文件),golden image 一旦发布基本不需要进行升级,由该 golden image 负责和上位机进行通信交互,完成业务 app、业务 bit 文件、uboot 以及操作系统 image 等文件在线升级,在qspi flash

wangjie36的博客 3174

RoboTok解读:互联网视频如何变成机器人操作示范库,提升下游任务成功率

在机器人操作学习中,示范数据的规模与质量直接决定模型泛化上限,而传统人工采集与仿真生成方式始终难以兼顾成本与真实多样性。与此同时,互联网上存在海量人类操作视频,如何将其转化为机器人可用的示范信息,成为行业关注的核心问题。多模态检索与跨本体对齐技术的演进,使得从视频中定位任务片段并映射为机器人语义参考成为可能。这类检索增强方法无需重训策略模型,即可通过动态注入相关示范来提升模仿学习与VLA模型在长尾任务上的表现,广泛应用于机械臂操作、家庭服务、工业装配等场景。本文以RoboTok为例,系统梳理了从视频检索、时

weixin_29029995的博客 288

用 SNC 和 SAP Single Sign-On Secure Login 把 SAP 登录这件小事,变成一件安全又不用输密码的事

在传统的 SAP 系统里,登录这件事看起来很朴素:用户打开 SAP GUI,输入一个 SAP 用户名,再输入一个 SAP 密码,点回车,进系统,开始干活。表面上没毛病,但从安全角度看,这种老办法问题很大。默认情况下,这些用户名和密码在网络上传输时是明文,也就是不加密传输。攻击者如果在公司网络里做监听,理论上可以直接截取到口令信息,这种风险对今天任何一家合规要求高、审计严格的企业来说,基本是不可接受的。(SAP Help Portal)SAP 给出的答案叫做 ,全称是 。SNC 做的事情可以概括成两类:一类是

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 376

【异常】Cursor 模型服务地域访问限制报错的完整排查与解决方案This model provider doesn‘t serve your region

其本质是:Cursor客户端依赖的上游大语言模型服务提供商,基于自身服务的合规运营范围,对客户端发起的请求进行了来源地域权限校验;当系统检测到请求的网络来源地域,不在该模型服务商官方授权提供服务的地域范围内时,会触发服务访问拦截策略,拒绝响应本次模型调用请求,最终在客户端抛出该报错。合规声明:本文所提供的所有方案,均仅用于技术问题排查与解决,请您在使用过程中严格遵守当地法律法规,以及对应软件与模型服务提供商的用户协议与合规要求。更多关于AI+教育领域的干货,可以关注我的微信公众号一时间获取哦~

奶爸的编程之路,也就一周冷个三天 1134

RoboTok:用互联网视频检索破解机器人学习的数据难题

机器人操作学习长期受困于高质量示范数据稀缺且采集成本高昂的瓶颈。具身智能领域的研究者开始将目光投向互联网上海量的操作视频,希望从中挖掘可复用的行为知识。跨模态检索技术为此提供了关键路径,它能够根据自然语言任务描述,在海量非结构化视频中精准定位与目标动作高度相关的片段,实现从“以量取胜”到“以准取胜”的转变。这种思路借鉴了检索增强生成(RAG)的范式,先筛出高价值示范,再引导策略模型完成动作语义到机器人控制指令的映射,从而显著降低训练成本并提升任务成功率。无论是模仿学习、多模态理解还是机器人数据工程,这一“任

weixin_28678151的博客 258

R语言机器学习算法实战系列(十五)随机森林生存预后模型+SHAP值 (Random Survival Forest + SHAP)

本教程运用随机森林生存分析筛选与患者生存状态显著相关特征。该方法借随机森林这一强大机器学习算法,构建多棵决策树并集成结果,以提高生存分析准确性,识别关键生物标志物。接着,利用选定特征构建风险得分,将多个特征转化为单一数值,量化患者风险水平。之后,依据风险得分将患者分为高、低风险亚型,为临床治疗提供个性化指导。最后,通过分析时间依赖的 ROC 曲线评估模型长期预测能力。此曲线计算不同阈值下的真正例率与假正例率,在多个时间点评估,全面展现模型长期稳定性与准确性。。并且增加了SHAP值评估特征重要性

专注生信领域 2623

案例 | 高精度具身时序数据标注:澳鹏如何支撑头部机器人企业模型迭代

具身智能落地面临高质量时序标注数据瓶颈,某头部企业与澳鹏合作,通过多基地协同、双语专家团队、标准化SOP及自研MatrixGo平台,实现5,000+小时高精度具身时序数据标注与10,000+小时审核,攻克双语语义理解、0.1秒级时间戳精度与工具缺失难题,构建可复用的数据闭环体系,显著提升模型泛化能力与数据集质量。

Appen_China的博客 236

第十二章 供水管网水力模型软件介绍

本文介绍了国内外主要供水管网建模软件及其特点,重点分析了某高建模软件V14的创新功能。国际主流软件包括开源的EPANET、商业软件InfoWorksWS、WaterGEMS和MIKEURBAN,各具特色但存在应用局限。某高V14软件实现了管网GIS与模型一体化管理,采用一G多网、一网多模、一模多案、网模合一技术路线,支持全信息模型建立和动态数据更新。其创新点包括水量分配理念革新(精确/模糊匹配、三种用水模式)和首创Web服务功能。通过并发计算、GPU加速等技术优化性能,具有较高性价比。

weixin_45258875的博客 208

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

把 Agent 搬进飞书:飞书 Agent 机器人演示

本文展示下如何将 Agent 搬进飞书,协助提高日常的工作效率。

分享 Go、云原生、AI Infra 相关技术 273

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

智能化机器人系统的模块化设计自动化!

智能化机器人系统的模块化设计自动化,本质上是将系统工程中的“设计决策权”从人类专家部分转移给AI。它不是一个单一的工具,而是一套集成了建模、搜索、生成、验证的闭环工程方法论。短期:建立标准化的模块接口规范(如基于ROS 2的IDL),并编写脚本实现半自动代码生成。中期:引入知识图谱管理模块库,实现基于规则的模块推荐与组合检查。长期:探索强化学习+仿真,让系统自主探索和发现新的、非直觉的高效模块组合方式。

m0_65595995的博客 175

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

从单机到柔性岛:工业连接器如何让机器人真正实现“一机多用”?

如今,一台机器人往往不只承担一道工序。搬运、焊接、涂胶、装配,末端工具在不同工序间快速切换,正在把传统的“专机+专用工位”带向更紧凑的柔性岛。但现场很快会发现:让机器人把工具取下来、再装上去,并不算难;真正难的是,工具切换后,动力、控制、反馈和介质能否同步、稳定地到位。一次连接如果不可靠,轻则需要人工复位,重则影响整段工艺节拍。对于自动化集成商和机器人应用端而言,工业连接器已不再是被动附件,而是把“工具可换”转化为“工艺可切”的基础接口。

SHQT888888的博客 327

环视同步与拼接的工程改法:从车规到机器人

重叠区的形状也要看:横向窄、纵向长的重叠,和四四方方的重叠,能提供的约束不一样,前者在俯仰变化时更脆弱。务实做法是给相机支架足够的刚性,把易变的安装点做成可重复定位的结构,再配一套快速校验手段。支架刚性也不是越硬越好,而是要在刚度、重量、成本之间取平衡:机器人末端对重量敏感,一味加厚支架会影响运动性能,这时更该把可重复定位和快速校验做扎实。动态范围的处理没有银弹。拼接错了,标定也救不回来:重叠区不足时,匹配点不够,任何算法都只能猜。相机装在哪里,要看机器人在典型任务中的姿态,而不是看它在展厅里站着的样子。

gunser的博客 200

语音机器人方言识别效果差怎么优化?本地小店场景调优指南(2026)

内容基于门店语音接待配置和方言场景排障的实际过程整理。ASR 热词权重机制、置信度分级、方言模型覆盖范围等描述,参考主流云 ASR 和语音机器人平台的通用设计思路;文中 CER、意图准确率、澄清次数、兜底率等阈值为本地实测经验值,第七节案例样本量有限(50 通录音),数字仅作方向性参考,不构成对任何方言或地区的普适结论。具体参数以平台文档和本地实测结果为准,文中配置片段为示意,不构成具体产品配置指南。

weixin_47312655的博客 315

手术机器人薄膜开关的5项医疗级验证:从消毒剂兼容到寿命测试的工程落地指南

A:电气安全 IEC 60601-1 / GB 9706.1,生物相容性 ISO 10993-1,EMC 按 IEC 60601-1-2,ESD 按 IEC 61000-4-2,供应商体系要求 ISO 13485。如果你正在做手术机器人或医疗设备的整机设计,欢迎在评论区交流面板选型、消毒流程定义和防护结构设计中的实际问题。手术室常用 75% 酒精、含氯消毒液、过氧化氢湿巾反复擦拭,面板的油墨、面涂和背胶都要经得住。:接触放电常见 ±8 kV、空气放电 ±15 kV,面板的接地层和面涂要配合整机设计。

BSD_HY的博客 367

率能半导体 SS6944T四路半桥驱动芯片:60V/2.5A,覆盖纺织机械、工业自动化、办公自动化、机器人四大应用场景

率能半导体SS6944T是一款面向工业与自动化领域的四路独立半桥驱动芯片,支持8V–60V宽电压、2.5A峰值电流及双电源供电(±30V),集成浮动接地与内置3.3V LDO,可灵活驱动两个直流电机、一个步进电机或四个螺线管。其低导通电阻(440mΩ)、ETSSOP28封装带散热焊盘,兼顾高效率与紧凑布局。具备过流、过温、欠压保护及nFAULT故障输出,支持快慢衰减模式与输出并联,适用于纺织机械、工业自动化、办公设备与机器人等多场景,是高母线电压下多路电机驱动的理想解决方案。

2501_92263958的博客 147

将物理先验嵌入机器人学习:从经典力学到 VLA 与 WAM

本文综述了将物理先验嵌入机器人学习的三条路径:数据与表示、模型架构、训练损失,强调其位置决定约束效力。通过夹取软物体案例,阐明运动学、动力学、接触与材料特性在任务中的分层作用。指出物理先验非万能,需匹配实际条件;强约束可加速学习,但误用会引入偏差。提出“有效刚度”等概念,强调主动探测与参数辨识的重要性,并警示仅靠单一方法无法保障安全执行,需结合在线验证与控制闭环。

lovely_yoshino的博客 891

用于医疗的磁驱动柔性微机器人研究进展!

磁驱动柔性微机器人已从“能动的小软虫”走向器官适配、诊疗一体、可释药可成像的原型系统,下一步竞争焦点是体内闭环控制、材料长期安全性与临床级系统集成。你想先深入哪条技术线:磁化编程制造、体内闭环控制,还是具体器官(脑/胃/心/血管)应用?

m0_65595995的博客 190

数字孪生如何支持具身智能?从Real2Sim、机器人训练到Sim2Real闭环

真正的技术升级,是把过去用于“看世界、管空间”的数字孪生能力,进一步转化为机器人能够使用的场景重建、空间语义、物理仿真、虚拟验证、训练评测和运营环境。验证成熟的仿真平台等基础软硬件还应进一步扩大应用。从AES等数字孪生技术基础进一步发展到AperOne的选型评测、仿真训练和运营闭环,可以看作这一技术路线的具体实践:数字孪生不再只是描述现实世界,而开始成为机器人理解、验证和进入现实世界的中间层。**核心关键词:**数字孪生、具身智能、机器人仿真、场景重建、Real2Sim、Sim2Real、机器人评测。

Luckytiger09的博客 319

Super Odometry 2.0:相机与激光雷达退化后,机器人如何继续估计运动

Super Odometry 2.0提出四层自适应机制,应对黑暗、重复走廊、浓烟等退化场景下的运动估计挑战。系统通过特征层筛选可靠观测,方向层识别弱约束方向,引擎层动态调整因子图融合策略,最终在外部感知失效时启用学习式IMU里程计。其核心为因子图与神经网络间的双向反馈——正常时用真实位姿训练模型,退化时由模型提供运动先验,实现互惠融合。实测验证覆盖200公里、800小时,单次路线2966米端点漂移仅20厘米,展现了强鲁棒性与实用性。

lovely_yoshino的博客 923
上一篇: 在线教程 | 68k stars,微软开源零基础课程 AI for Beginners,12周/24课系统掌握人工智能核心技术
下一篇: 扰动实验+迁移学习,MIT团队推出IRIS,用「指纹」重建单细胞信号传导历史
HyperAI超神经
博客等级 码龄7年 8872粉丝 1753原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值