在线教程丨一句话生成完整歌曲,MiniMax Music 3搞定作曲/编曲/人声

MiniMax发布最新音乐模型Music 2.0,帮你玩转歌曲创作 Music2.0模型是MiniMax团队推出的AI音乐生成工具,支持通过文本提示创作包含人声、旋律和编曲的完整音乐片段(最长5分钟)。该模型在人声情感表达(支持多种演唱风格)、旋律结构设计(自动规划主副歌)和音质处理(44100Hz采样率)方面表现突出。提供网页版和API两种使用方式,适合音乐爱好者快速创作demo或开发者集成到项目中。测试显示其在流行、爵士等风格上效果良好,可作为创作灵感来源,但复杂节奏仍需人工微调。该工具显著降低了音乐创作门槛,为中文AI音乐生态提供了实用解决方案。 阅读详情

从一句文字描述到一首完整歌曲,MiniMax Music 3 正在推动 AI 音乐创作走向更加高效、开放的新阶段。

由 MiniMax 团队于 2026 年 8 月开源的 MiniMax Music 3,是一款基于歌词与音乐描述的生成模模型。其可根据创意描述和可选歌词,在单次生成中完成作曲、编曲、演唱/演奏及完整歌曲制作,最长支持生成 5 分钟的音乐。模型重点提升了对创作者表达意图的理解和长程一致性,并增强乐器音色的清晰度与真实感,以及人声演唱的自然度。

技术上,MiniMax Music 3 重新设计了从音乐描述、语言建模到音频渲染的完整生成流程,引入细粒度时序描述、Global–Local Hybrid-LM、多层残差向量量化(RVQ)、隐藏状态融合、Flow Matching 和 Flow-VAE 等技术,以联合建模歌曲的长程结构与声学细节,从而实现更准确的创作意图表达、更完整多样的编曲,以及更清晰自然的音频生成效果。

功能上,MiniMax Music 3 覆盖完整的音乐生成流程,不仅支持根据文本描述生成匹配风格的音乐,还能根据歌词自动创作旋律、节奏并生成完整歌曲。模型支持流行、古典、电子、爵士、民谣等多种音乐风格,并能够生成包含前奏、主歌、副歌、间奏、尾声等完整结构的作品。同时,模型具备高质量人声合成功能,可生成男女声演唱以及多声部和声效果,让 AI 生成音乐更加接近真实制作流程。

目前,MiniMax Music 3 可应用于音乐创作者快速制作 Demo、短视频背景音乐生成、游戏与影视配乐原型设计,以及音乐教育和生成式 AI 研究等多个领域,为不同类型的创作者提供更低门槛的音乐生产工具。

HyperAI 教程板块已上线「MiniMax Music 3:基于歌词与音乐描述的音乐生成模型」,快来开启你的音乐创作吧!

在线运行:

https://go.hyper.ai/dbIoO

更多在线教程:

https://hyper.ai/notebooks

图片

demo 页面

Demo 运行

1.进入 hyper.ai 首页后,选择「教程」页面,或点击「查看更多教程」,选择「MiniMax Music 3:基于歌词与音乐描述的音乐生成模型」,点击「运行此教程」。

2.页面跳转后,点击右上角「Clone」,将该教程克隆至自己的容器中。

注:页面右上角支持切换语言,目前提供中文及英文两种语言,本教程文章以英文为例进行步骤展示。

图片

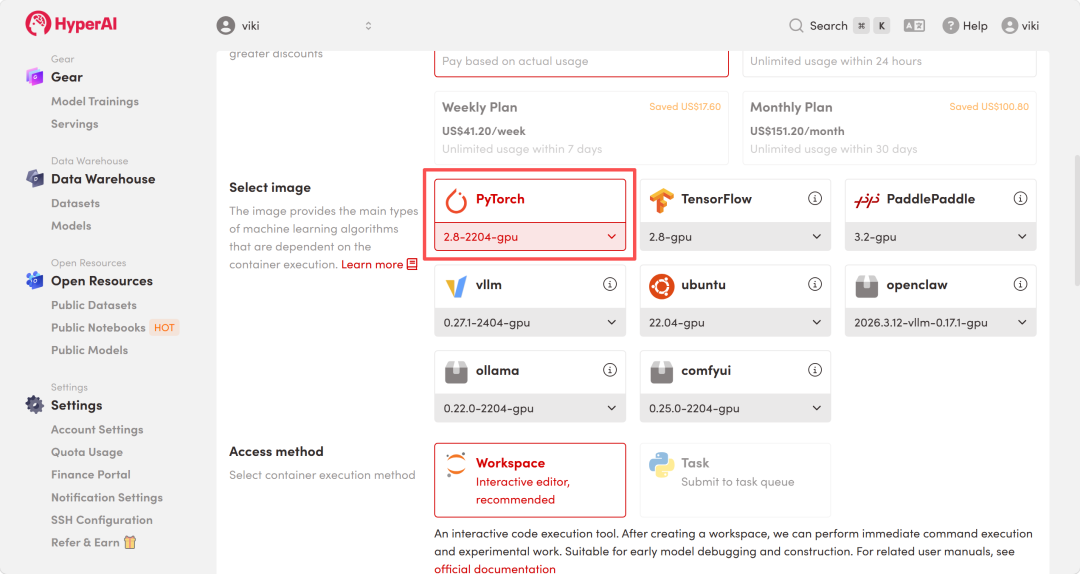
3.选择「NVIDIA RTX 5090」以及「PyTorch」镜像,点击「Continue job execution(继续执行)」。

图片

图片

4.等待分配资源,当状态变为「Running(运行中)」后,点击「Open Workspace」进入 Jupyter Workspace。

图片

效果展示

1.页面跳转后,点击左侧 README 文件,进入后点击上方 Run(运行)。

图片

图片

2.待运行完毕后,点击右侧 API 地址即可在浏览器中访问 demo 界面。

MiniMax Music 3本地部署实战:从环境配置到完整歌曲生成 AI音乐生成是当前人工智能应用的热门方向,开源模型让创作者能够本地化部署并生成带人声的完整歌曲。MiniMax Music 3作为一款支持歌词输入和结构控制的开源音乐生成模型,其本地部署需要GPU环境、依赖配置和模型权重下载。本文从音乐生成技术原理出发,介绍文本描述到音频输出的转换逻辑,阐述其工程价值与适用场景,并围绕模型部署、参数调试、API封装与批量任务等实践要点展开,帮助开发者在本地搭建歌词配曲流水线,实现可控、可复用的音乐创作工具链。 阅读详情

相关推荐

开源音乐生成模型 MiniMax Music 3 本地部署实战指南

生成式AI技术正加速渗透到音频创作领域,音乐生成模型作为其重要分支,能够基于文本描述或参考音频生成完整乐曲。其原理是通过深度神经网络学习旋律、节奏与和声的联合分布,而本地部署则让创作者在数据私密、成本可控的前提下实现批量生成与二次开发。对于需要将AI音乐融入工作流的开发者而言,掌握本地推理环境搭建、模型权重管理与生成参数调优成为关键技能。本文以开源音乐生成模型MiniMax Music 3为例,聚焦其本地部署的完整链路:从硬件评估、依赖安装到ComfyUI节点与CLI脚本两种主流方案,并给出高频报错排查思路

weixin_34268753的博客 1247

如何用 MiniMax Music 3 生成5分钟完整歌曲:长程一致性与段落结构的7个进阶技巧

> 一句话导读:MiniMax Music 3 是一款能把"歌词 + 音乐描述"变成**最长 5 分钟完整歌曲**的 AI 音乐生成模型。本文用 7 个进阶技巧,帮你告别"只有半首歌"的尴尬,获得段落结构清晰、情绪连贯的成品级音乐。 ## MiniMax Music 3 是什么?为什么它能生成完整的5分钟歌曲 很多 AI 音乐工具只能输出几十秒的片段,段落之间像"拼贴画"一样缺乏连贯性。Min

gitblog_00675的博客 739

MiniMax Music 3开源音乐模型本地部署实战指南

音乐生成是AIGC领域的热门方向,但开源模型往往难以兼顾人声、乐器与结构完整性。文本到音乐生成技术通过自然语言描述直接合成完整歌曲,其核心在于语义理解与声学建模的协同。掌握这类模型的本地部署,能帮助创作者摆脱闭源平台的限制,自由生成定制化配乐。MiniMax Music 3作为开源音乐模型的代表,在人声质感、多乐器分离和长时长结构稳定性上表现突出,适合独立音乐人、游戏音频设计师及AI Agent开发者。本文从环境配置、模型下载到推理脚本编写,完整演示了在本地GPU上运行该模型的流程,并提供了常见问题的排查思

weixin_33882452的博客 403

教程上新丨从文字到成曲,MiniMax Music 3一键搞定作曲、编曲与人声

从一句文字描述到一首完整歌曲,MiniMax Music 3 正在推动 AI 音乐创作走向更加高效、开放的新阶段。其可根据创意描述和可选歌词,在单次生成中完成作曲、编曲、演唱/演奏及完整歌曲制作,最长支持生成 5 分钟的音乐。模型重点提升了对创作者表达意图的理解和长程一致性,并增强乐器音色的清晰度与真实感,以及人声演唱的自然度。

OpenBayes的博客 190

win10自动修复-无限循环【通用完美】超简单解决办法

2020.02.14今个我的笔记本电脑(Thinkpad Carbon 7 X1)(win10)早晨起来发现蓝屏,上面显示自动修复失败,重启后依然自动修复失败,不断手动重启,始终是修复失败。然后上网开始搜集资料找解决办法。 前边介绍关闭自动修复,如何找出错文件的方法;如果想看最终解决办法,直接看第三部分 上网就会发现这种现象很常见,同时是电脑自动安装系统更新,或者安装某些驱动出现。解决办法也大...

y15941300574的博客 19万+

网口电路/Bob Smith电路思考及测试

上表中的数据为实际数据,此时可以看出在结果比对中,分别为以上三种时,结果基本上变化很小,且网口一致性指标都是测试通过的,而且如果真的Bob Smith电路是有阻抗变换的作用的,我的以上操作(保留阻容、去掉电阻、去掉电阻电容)完全破环了阻抗平衡,但是实际上对网口一致性指标没有多大的影响,这是我认为该电路不具有阻抗变换的第一个原因。网口变压器的共模电感,就是电流型中的T10、T14、T17、T18,我们知道辐射超标一般都是共模电流导致的,而共模电感就是来消耗差分线路中的共模电流的,而对差模电流基本无影响。

domen_pan的博客 6057

如何安装MiniMax-Music3-mxfp4:Apple Silicon本地AI作曲环境的完整入门指南

如果你有一台搭载 M 系列芯片的 Mac,现在就能把它变成一间"个人 AI 录音棚"。**MiniMax-Music3-mxfp4** 是专为 Apple Silicon 优化的**本地 AI 作曲**模型,它把 MiniMax Music 3 的完整作曲能力压缩进约 8.3GB 的权重文件,让你不依赖云端服务、不需要 NVIDIA 显卡,仅凭一句风格描述加一段歌词,就能生成 44.1kHz 立体

gitblog_00155的博客 780

本地部署Llama 3中文版:Ollama量化配置与调优指南

大模型本地部署正在成为数据敏感场景下的主流选择。本地运行开源大模型,既能保护隐私又能降低调用成本,但中文能力往往成为瓶颈。以Llama 3为代表的开源模型,需借助中文微调与量化技术,才能在消费级显卡上流畅运行。量化通过压缩模型权重减小显存占用,配合Ollama等推理框架,可快速搭建私有中文AI服务。该方案适用于知识库问答、内容生成、离线助手等场景,并可通过OpenAI兼容接口无缝对接Dify等应用平台。本文从硬件选型、量化等级到Modelfile配置,系统梳理本地部署中文大模型的全链路实战方法与排错思路,帮

weixin_29035405的博客 82

AI 歌曲生成!MiniMax Music3 实现带人声完整歌曲生成全流程

MiniMax推出端到端音乐生成模型Music3,可同时完成歌词解析、编曲、人声演唱合成,摆脱传统旋律与人声分离的流水线。它能自动区分主副歌、输出wav音频,并支持自定义曲风、BPM、人声音色等,让流行、民谣、古风、摇滚等歌曲生成自然流畅。这标志着AI音乐从纯背景音乐走向直接可用的完整歌曲Demo。

XLionXxxx的博客 191

STM32F103中GPIO_Remap1_CAN1与GPIO_Remap2_CAN1的配置差异与应用场景解析

本文深入解析了STM32F103中GPIO_Remap1_CAN1与GPIO_Remap2_CAN1的配置差异与应用场景。通过剖析AFIO_MAPR寄存器,明确了两者在引脚映射(PB8/PB9 vs PD0/PD1)和适用封装上的区别,并提供了详细的配置步骤、常见陷阱排查及基于项目需求的选型指南,帮助开发者高效完成CAN引脚重映射。

u6v7w8x的博客 394

《YOLO11魔术师专栏》专栏介绍 & 专栏目录

【原创自研模块】【多组合点优化】【注意力机制】【主干篇】【neck优化】【卷积魔改】 【block&多尺度融合结合】【损失&IOU优化】【上下采样优化】【小目标性能提升】【前沿论文分享】【训练实战篇】

①答疑群聊服务;②YOLO大模型知识问答系统;③计算机视觉论文生成智能体; 1万+

MiniMax Music 3 快速上手指南:10分钟生成你的第一首完整AI歌曲

想找一款能把歌词变成完整歌曲的 AI 歌曲生成工具?**MiniMax Music 3** 就是这样一款开源的 AI 歌曲生成模型:只需输入一段歌词和一句音乐描述,就能生成最长 **5 分钟**、带人声、有完整编曲的立体声歌曲,输出为 32kHz 的 WAV 文件。本指南面向零基础新手,带你 10 分钟跑通全流程,生成你的第一首 AI 歌曲。 [![MiniMax Music 3 AI歌曲生成模

gitblog_00902的博客 268

【LLC快速上手系列】如何在LLC谐振里优雅地调死区时间?

用示波器死盯Vds波形,找到ZVS临界点;别听“经验值”,亲自调才准;死区时间并非越短越好,也不是越长越稳,而是要“刚刚好”;用热成像看MOSFET温升变化,ZVS调好了,温度马上掉2~5℃;轻载难ZVS?适当提升频率 or 降低Lr可破!

weixin_43199439的博客 493

深入浅出 MiniMax Music 3 架构:Hybrid-LM 双模型如何协作生成完整歌曲

MiniMax Music 3 是一款能够直接生成**长达 5 分钟完整歌曲**的 AI 音乐生成模型,它的核心竞争力来自独特的 Hybrid-LM 双模型协作架构。本文用通俗易懂的方式,拆解 Global LLM 与 Local LLM 如何分工配合,再结合 Flow Matching 与 Flow-VAE 连续合成模块,带你理解"从一句歌词到一首完整歌曲"的完整技术链路。即使你不懂代码,也能看

gitblog_01159的博客 668

060、模型蒸馏:把扩散模型压进单步的魔法

《端侧文生图模型蒸馏实战:从32步到1步的优化之道》摘要:针对边缘设备部署难题,本文分享了扩散模型蒸馏的核心经验。通过重构损失函数(感知损失+对抗训练+KL散度)、优化采样轨迹截取策略和改造学生模型架构,成功将Stable Diffusion压缩至单步推理。关键发现包括:小批量训练更有效、标签平滑保障生成多样性、双模型策略平衡质量与速度。在Cortex-A53芯片上实现300ms内生成,内存占用控制在200MB以下。特别强调工业部署需权衡压缩率与稳定性,建议保留迭代模式开关以适配不同场景需求。

2601_95651806的博客 150

[HBM] RAM Cell Self Repair | 内存单元自我修复

对抗错误的大都是冗余,内存颗粒在设计的时候也考虑增加冗余。具体的说:添加冗余或备用的存储单元行和列,及时将测试中的故障进行修复和替换,存储器修复包括行修复,列修复或两者的组合。

串起点滴 785

MiniMax Music 3 提示词增强指南:用music-caption-rewriter一键升级专业级音乐描述

同样一段歌词,随手写一句"来首伤感的情歌"和给出一份专业级音乐描述,MiniMax Music 3 生成出来的歌曲质量天差地别。MiniMax Music 3 是 MiniMax 开源的 AI 音乐生成模型,支持生成最长 5 分钟、32kHz 立体声的完整歌曲,而提示词增强(Prompt Enhancement)正是让模型发挥全部实力的关键。本文将带你认识官方提供的 music-caption-r

gitblog_00767的博客 936

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

低显存运行 MiniMax Music 3:8GB显卡生成完整AI歌曲的终极优化方案

MiniMax Music 3 是 MiniMax 开源的 AI 歌曲生成模型,只要输入歌词和音乐风格描述,就能生成最长 5 分钟的完整歌曲,包含人声、伴奏、和声与段落起伏。很多新手以为这类大模型必须配备 24GB 显存的高端显卡,其实借助 CPU 显存卸载与逐层流式加载,8GB 显卡同样可以低显存运行 MiniMax Music 3,生成结构完整的 AI 歌曲。本文就是一份面向新手的终极优化方案

gitblog_01040的博客 511

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

Minimax Music开源,配套神器已开源,继AI视频自由后,AI音乐也自由了!

摘要: MiniMax-Music3开源音乐模型正式发布,支持本地生成5分钟带人声的完整歌曲(含中文/日文),效果达开源领域顶级水平。配合T8更新的ComfyUI V18整合包,用户可一键部署,无需配置环境。教程涵盖模型下载、安装步骤及核心玩法:需结构化提示词(流派/BPM/乐器等)和分段歌词输入,推荐使用官方Skill生成描述。硬件要求24GB显存(RTX4090),实测3分钟歌曲生成约219秒,整合包支持低显存适配。常见问题包括音质(32kHz)、纯音乐生成方法等,相关资源已汇总。🎵 (字数:150)

apple_69265885的博客 1194

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

MiniMax Music 3 对比 Suno 与 Udio:三款AI音乐生成模型谁更适合你?

AI音乐生成正在以前所未有的速度改变普通人创作音乐的方式。本文聚焦三款主流 AI音乐生成模型——MiniMax Music 3、Suno 与 Udio,从生成能力、音质表现、控制精度、使用成本四个维度展开全面对比,帮你找到最适合自己的 AI写歌工具。无论你是音乐小白还是资深创作者,这份对比都能让你少走弯路。 ## 三款 AI 音乐生成模型:一分钟速览 🎵 | 模型 | 一句话特点 | 适合人

gitblog_00046的博客 496

MiniMax Music 3 深度评测:5分钟完整AI歌曲一键生成,音乐创作进入新时代?

过去几年,AI音乐生成工具层出不穷,但大多数只能生成几十秒的片段,很难撑起一首结构完整的歌曲。**MiniMax Music 3** 正是冲着这个痛点而来——这是一款能一键生成最长**5分钟完整AI歌曲**的开源音乐生成模型,支持歌词+音乐描述双输入,输出 32kHz 立体声 WAV。本文将带新手和普通用户深度体验这款 AI 写歌工具,看看它能否真正让音乐创作进入新时代。 [![MiniMax

gitblog_00777的博客 297

进阶玩法:用Python API调用MiniMax-Music3-mxfp4搭建批量AI作曲工作流

MiniMax-Music3-mxfp4 是一个可在 Apple Silicon 上本地运行的 AI 作曲模型,它是 MiniMax Music 3 的 MLX MXFP4 量化版本,只需输入风格描述和歌词,就能直接生成 44.1kHz 立体声歌曲。本文将以 Python API 为主线,一步步教你用 MiniMax-Music3-mxfp4 搭建一套属于自己的批量 AI 作曲工作流,把灵感变成歌

gitblog_00993的博客 389

MiniMax-Music-3 完整安装教程:模型文件下载、目录放置与 ComfyUI 环境配置

MiniMax-Music-3 是一款强大的 **AI 音乐生成模型**,只需输入一句文字描述,就能生成带人声与伴奏的完整歌曲。本文提供一份 **MiniMax-Music-3 完整安装教程**,手把手带你完成模型文件下载、目录放置与 ComfyUI 环境配置,即使是零基础的新手,也能在 10 分钟内让「文字转音乐」的 AI 作曲模型在你的电脑上跑起来。😎 ## MiniMax-Music-3

gitblog_00269的博客 1055

MiniMax-Music3-mxfp4参数调优全解析:duration、steps与seed如何影响AI作曲效果

MiniMax-Music3-mxfp4参数调优是AI作曲爱好者绕不开的进阶话题。这款模型是MiniMax Music 3的MLX MXFP4量化版本,专为Apple Silicon芯片优化,仅需约8.3GB磁盘空间,就能在本地完成歌词到成曲的完整AI作曲流程,输出44.1kHz立体声WAV。在mlx-audio框架中,`duration`(时长)、`steps`(采样步数)与`seed`(随机种

gitblog_00901的博客 367

如何为MiniMax-Music3-mxfp4写出高质量歌曲描述:风格、BPM与乐器的提示词秘籍

想用 MiniMax-Music3-mxfp4 生成一首真正好听的歌?秘诀往往不在模型本身,而在于你写给它的那一段"歌曲描述"(caption)。MiniMax-Music3-mxfp4 是 MiniMax Music 3 的 MLX 量化版本,通过 mlx-audio 在 Apple Silicon 上实现"歌词 + 描述 → 音乐"的生成,而一段包含风格、BPM 与乐器的提示词,正是决定成品质

gitblog_01187的博客 449

如何为 MiniMax-Music-3 写出高质量音乐提示词:5大核心技巧与30个实战案例

> 想让 **MiniMax-Music-3** 生成媲美专业制作人的音乐?答案就藏在你的**音乐提示词**里。MiniMax-Music-3 是 MiniMax 推出的文本生成音乐模型,已通过 ComfyUI 生态提供完整开箱工作流,只需一段自然语言描述,就能生成带人声、配器完整的歌曲。但很多用户发现:提示词写得好不好,生成的音乐天差地别。本文将从模型原理出发,为你总结 **5 大核心提示词技巧

gitblog_00888的博客 912
上一篇: 覆盖11个学科/60项科研任务,清华/MIT/哈佛等提出ASI-Bench测试AI自主科研能力
下一篇: 27B AI 科学家论文复现能力超越 GPT-5.5/Claude Opus 4.8,Faraday 探索长程科学创新
HyperAI超神经
博客等级 码龄7年 8872粉丝 1753原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值