


Muse-Glimmer-30B 由 Meta 超级智能实验室推出,是一款面向智能体任务打造的 300 亿参数因果语言模型,通过 Muse Spark 蒸馏与专用感知编码器设计,将多步推理、工具调用、多模态理解和任务恢复能力融合于单一模型中。模型无需依赖云端基础设施或网络连接,即可在本地完成长周期任务执行,并在 DeepSearch QA、MCP-Atlas 和 SWE-Bench 等评测中展现出较强性能。同时,Muse-Glimmer-30B 支持文本与图像交错输入,可理解截图、图表、文档等复杂信息,并针对智能体框架优化工具调用能力,为本地 AI 助手、代码智能体和多模态应用提供了新的解决方案。
目前,HyperAI超神经官网已上线了「Muse-Glimmer-30B:多模态视觉语言模型」,快来试试吧~
在线使用:Muse-Glimmer-30B: Multimodal Vision-Language Model | Notebooks | HyperAI
8 月 14 日- 8 月 20 日,hyper.ai 官网更新速览:
* 优质公共数据集:3 个
* 优质教程精选:18 个
* 社区文章解读:1 篇
* 热门百科词条:5 条
* 8 月截稿顶会:2 个
访问官网:hyper.ai
公共数据集精选
1. MatrAIx Persona 1M 人物画像数据集
MatrAIx Persona 1M 是由 MatrAIx 发布的角色画像数据集,旨在为合成数据生成、人群建模、个性化对话、仿真与评测等场景提供细粒度、多样化的人物画像数据。 该数据集共包含 999,847 个角色画像,其中 599,847 个角色源自真实记录,400,000 个角色为全 DAG 合成的角色。每个画像由 1,290 个分类属性描述,覆盖人口统计、语言、专业、技能、个性、价值观、兴趣、行为、健康与开发者特征等维度,且 18 岁以下记录已移除。
在线使用:MatrAIx Persona 1M Portrait Dataset | Datasets | HyperAI
2. Vehicle-Level Temporal Image Sequences 车辆图像序列数据集
Vehicle-Level Temporal Image Sequences 是一个车辆图像序列数据集,旨在为危险驾驶行为识别(急刹挑衅、强行切入、急刹车、蛇形行驶)与车辆级视频时序分类研究提供标准化数据,主要用于支持智能交通系统、高级驾驶辅助及类别不平衡学习等方向的研究。 该数据集包含 434 个车辆级时序图像序列,涵盖正常驾驶和危险驾驶行为,按照 94 个内部标识的源视频组进行组织,每个序列对应一辆被跟踪的车辆,并配套行为标签元数据文件。
在线使用:Vehicle-Level Temporal Image Sequences Dataset | Datasets | HyperAI
3. Dual-modal Roadside Traffic 双模态路侧交通目标检测数据集
Dual-modal Roadside Traffic 是一个双模态路侧交通目标检测数据集,通过空间标定、时间同步的 RGB 相机与事件相机采集路侧交通数据,旨在为 RGB 与事件多模态融合、事件相机感知以及恶劣光照与运动条件下的鲁棒交通场景理解提供标准化数据支撑。该数据集分为已对齐数据和原始数据,已对齐数据中的每组样本均包含空间和时间一一对应的 RGB 图像、事件表征与目标标注三种模态,并被划分为训练集、验证集和测试集。
在线使用:Dual-modal Roadside Traffic Object Detection Dataset | Datasets | HyperAI
公共教程精选
1. Muse-Glimmer-30B:多模态视觉语言模型
Muse-Glimmer-30B 是 Meta 超级智能实验室推出的 300 亿参数本地智能体模型,基于 Muse Spark 蒸馏并配备专用感知编码器,融合多步推理、工具调用、多模态理解和任务恢复能力。模型无需依赖云端服务,即可在消费级硬件上执行复杂智能体任务,并支持截图、文档、图表等多模态信息理解,为本地 AI 助手、代码开发和自动化任务提供新的选择。
在线运行:Muse-Glimmer-30B: Multimodal Vision-Language Model | Notebooks | HyperAI

Demo 页面
2. Datamol:简化分子处理过程
Datamol 是由 Hadrien Mary / Valence Discovery 团队推出的分子处理开源库,基于 RDKit 构建,旨在简化化学信息学工作流程。该工具提供简洁易用的 Python API,封装常见分子操作,并支持自动并行计算、高效文件处理和大规模分子数据处理。Datamol 可广泛应用于虚拟筛选、药物研发、分子数据清洗、化学信息分析与可视化等场景。
在线运行:Datamol: Simplifying Molecular Processing | Notebooks | HyperAI
3. AI for Beginners:人工智能入门系列教程
微软 AI for Beginners 是一套面向初学者的系统化人工智能学习课程,共包含 12 周、24 节课程,覆盖从传统符号 AI 到现代深度学习的完整知识体系。课程结合 Jupyter Notebook 实践案例与测验,涵盖神经网络、计算机视觉、自然语言处理、强化学习等核心方向,并提供基于 PyTorch 和 TensorFlow 的可运行代码,适用于 AI 自学、高校教学辅助及企业技术培训。
4. 文本预处理入门
该教程系统介绍 NLP 任务中的文本预处理流程,涵盖从原始文本清洗到标准化处理的关键技术。课程围绕降低文本噪声、提升模型输入质量展开,详细讲解大小写转换、标点与停用词去除、词干提取、词形还原、表情与 URL 处理、HTML 清理、聊天用语转换及拼写检查等 17 类常用方法,帮助学习者构建更高质量的文本数据处理流程。
在线运行:Getting Started With Text Preprocessing | Notebooks | HyperAI
5. 语音表征与数据探索
该教程基于 Kaggle 作者 DavidS 发布的 TensorFlow Speech Recognition Challenge 实践案例,使用 Speech Commands v0.01 数据集开展语音识别分析。课程围绕语音分类任务,介绍从原始波形、频谱图到 MFCC 特征的可视化方法,并涵盖静音检测、音频裁剪、降采样、特征提取及数据分布统计分析等流程,适合作为语音命令识别、音频特征工程和语音数据探索分析的入门教程。
在线运行:https://go.hyper.ai/ndnf9
6. 基于 RAPIDS 与手工规则的推荐候选重排序
Candidate ReRank Model 是 Kaggle Grandmaster Chris Deotte 于 2022 年 11 月发布的推荐系统方案,基于 OTTO Recommender System 竞赛数据构建。该模型结合 GPU 加速的共现矩阵计算与人工规则重排序策略,通过 RAPIDS cuDF 在 GPU 上高效生成用户行为关联特征,并根据点击、加购、购买等历史行为设计排序规则,实现候选商品精准推荐。该方案适用于电商推荐、会话式推荐系统及大规模用户行为数据分析等场景。
在线运行:Re-ranking of Recommendation Candidates Based on RAPIDS and Manual Rules | Notebooks | HyperAI
7. 声音事件检测入门:基于 PANNs 的 AudioSet 预训练模型
该教程介绍声音事件检测(Sound Event Detection, SED)的基本概念与实践方法。与仅判断音频类别的声音分类不同,SED 能够识别音频中的声音事件,并定位其发生的起止时间。课程基于预训练音频神经网络 PANNs,利用 AudioSet 大规模音频数据训练的 CNN14 模型,实现帧级声音预测与弱标签检测,可应用于城市噪声监测、工业异常检测、生物声学分析和智能家居声音识别等场景。
在线运行:https://go.hyper.ai/HOoPr
8. XGBoost Starter - 信用卡违约预测教程
AMEX Default Prediction 信用卡违约预测方案基于 Kaggle 用户 Chris Deotte 的 XGBoost Starter Notebook 构建,在竞赛中取得 CV 0.792、LB 0.793 的成绩。方案围绕特征工程、模型训练和预测展开,通过聚合用户历史数据生成统计特征,利用 XGBoost 的 GPU 加速训练与五折交叉验证提升效率,并结合 AMEX 专属评估指标优化模型表现。该方法适用于金融风控、信用评估等机器学习预测任务。
在线运行:XGBoost Beginner's Guide – Credit Card Default Prediction Tutorial | Notebooks | HyperAI
9. 计算机视觉入门:从 CNN 原理到图像分类实战
Intro-Computervision 是由 Cezanne Camacho 开源的计算机视觉入门项目,基于 MIT 许可证发布,面向深度学习初学者系统讲解卷积神经网络(CNN)原理。项目通过可视化方式展示卷积、池化等操作如何提取图像特征,并以 FashionMNIST 数据集为例完成图像分类实践。内容覆盖数据加载、模型训练、效果评估等完整流程,适用于计算机视觉学习、课程教学及目标检测与图像分割的基础入门。
10. 乳腺癌风险预测:机器学习实战系列教程
Breast Cancer Risk Prediction 是基于 UCI Machine Learning Repository 中 Wisconsin Breast Cancer Diagnostic 数据集构建的机器学习诊断项目,由 Jean Njoroge 发布。项目通过对比多种机器学习分类算法,并结合 GridSearchCV 进行超参数优化,实现超过 98% 的诊断准确率。内容覆盖数据加载、探索分析、模型构建、评估与优化完整流程,利用细胞核图像提取的 30 项特征预测乳腺癌风险,为医学数据分析与机器学习实践提供参考。
11. TileLang Puzzles:用 10 个 Puzzle 学习 GPU Kernel 编程
TileLang 是由 Tile-AI 团队开发的高性能 GPU Kernel 编程领域专用语言(DSL),旨在降低 GPU 内核开发门槛。TileLang Puzzles 通过 10 个难度递进的练习,带领学习者从基础 Copy 操作入手,逐步掌握 GEMM、FlashAttention 等现代 GPU Kernel 的编程方法。其提供 `@tilelang.jit` 装饰器和 `T.copy`、`T.gemm`、`T.Parallel` 等高级算子,可简化底层线程调度与内存管理,适合 GPU 编程与高性能计算入门。
在线运行:https://go.hyper.ai/1UJuc
12. 用自定义数据训练 YOLOv8
YOLOv8 是 Ultralytics 于 2023 年 1 月发布的统一视觉模型,支持目标检测、实例分割、姿态估计和图像分类四类任务。模型通过 ultralytics Python API 和 yolo CLI 统一训练、验证、推理及模型导出流程,使用更加便捷。其架构引入 C2f 主干模块、Anchor-Free 解耦检测头,并在训练末期停止 Mosaic 数据增强,在保持高效推理的同时提升视觉任务表现。
在线运行:Training YOLOv8 With Custom Data | Notebooks | HyperAI
13. NVIDIA NemotronLabs VoiceChat 11B:端到端实时语音全双工对话模型
NVIDIA NemotronLabs VoiceChat 是一款 110 亿参数端到端全双工语音模型,采用统一架构实现实时语音理解与生成,响应延迟低至约450毫秒。模型支持自然打断、轮流对话及语音 Function Calling,突破传统 ASR+LLM+TTS 流程限制,可用于智能助手、语音 Agent 等实时交互场景。
在线运行:https://go.hyper.ai/hW6ZK

Demo 页面
14. Qwen3.8-27B-FP8:原生视觉语言模型
Qwen3.8-27B-FP8 是阿里云通义千问团队推出的 Qwen3.8 系列紧凑型旗舰模型,基于 Qwen3.5 架构打造,集成原生视觉语言能力与 270 亿参数规模。在 FP8 精细量化加持下,模型保持接近 BF16 版本的性能,同时大幅降低显存占用,适合多 GPU 部署。模型支持超长上下文、多模态理解、灵活推理控制和工具调用,可用于代码开发、专业任务处理、科研分析及复杂 Agent 工作流。
在线运行:Qwen3.8-27B-FP8: Native Vision-Language Model | Notebooks | HyperAI
15. IEEE-CIS 欺诈检测:完整探索性数据分析 (EDA)
IEEE-CIS Fraud Detection 是 Kaggle 经典金融风控竞赛,围绕在线交易欺诈识别展开。该任务需要在超过 7GB 的大规模数据中,处理高基数类别特征、极端类别不平衡以及时间序列信息,并通过 AUC-ROC 指标评估模型排序能力。相关方法可迁移至支付安全、风险控制等真实业务场景,也是学习不平衡分类与金融数据分析的经典案例。
在线运行:https://go.hyper.ai/KDfkP
16. MiniMax Music 3:基于歌词与音乐描述的音乐生成模型
MiniMax Music 3 是 MiniMax 团队于 2026 年 8 月推出的文本生成音乐模型,可根据歌词与音乐描述自动创作最长 5 分钟的完整歌曲。模型采用多组件生成架构,结合 Qwen3-8B 长程结构建模、Flow Matching Transformer 与 Flow-VAE 声码器,实现富有表现力的人声、动态编曲以及稳定的长音频质量。支持 32kHz 双声道输出,可广泛应用于歌曲创作、背景音乐生成和 AI 音乐研究等场景。
在线运行:MiniMax Music 3: A Lyrics-Driven and Descriptive Music Generation Model | Notebooks | HyperAI
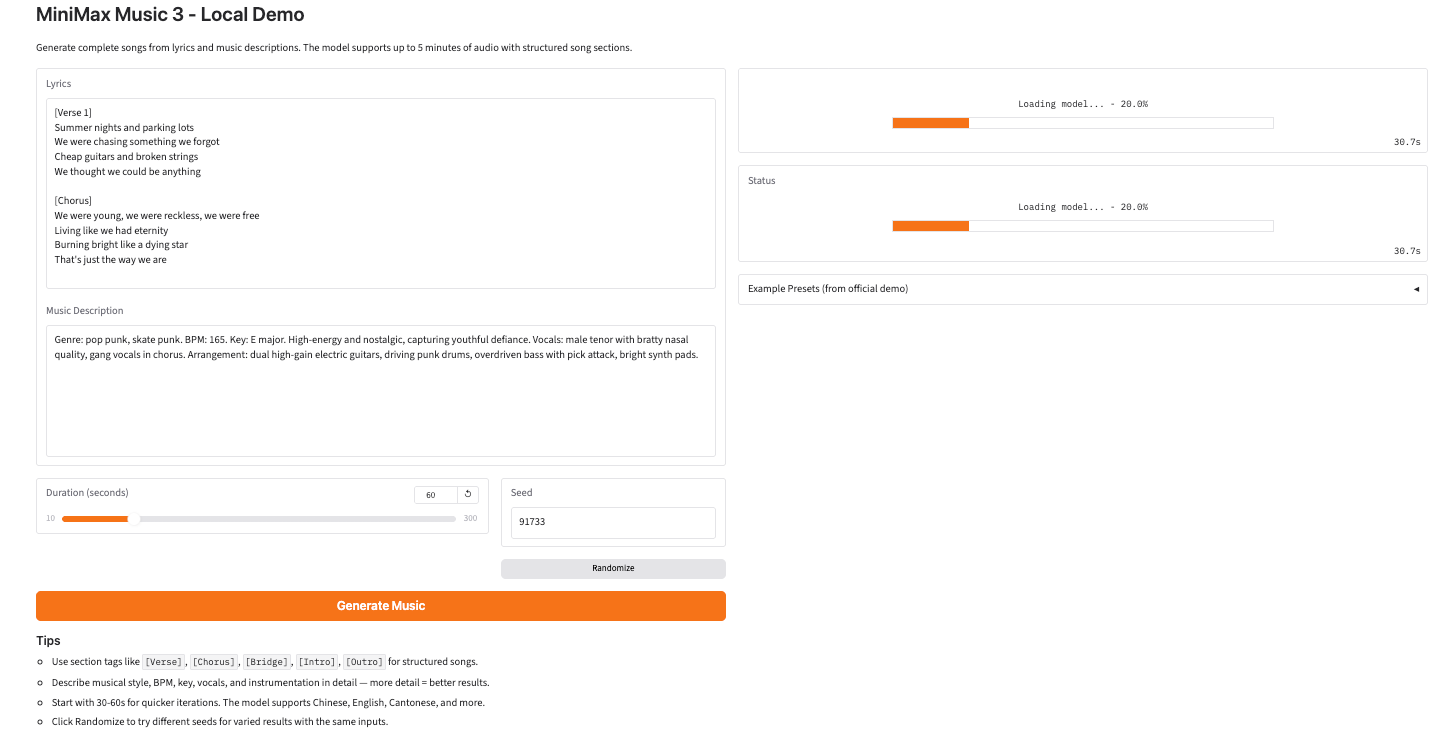
Demo 页面
17. LSTM 天气预测:基于 Jena 气候数据集的时间序列预测
本教程源自 DigitalOcean Community,由 Adil Lheureux 编写,基于 LSTM(长短期记忆网络)构建天气预测模型。教程使用德国耶拿地区历史气象数据,通过温度、气压、湿度、蒸汽压、风速和空气密度等 6 类特征,利用过去 72 小时(432 条记录)的数据预测未来 6 小时气温变化。该案例适合作为时间序列预测入门实践,可应用于短期天气预报、气象数据分析等场景。
在线运行:https://go.hyper.ai/ONbnQ
18. 几何图神经网络入门教程
几何图神经网络(Geometric Graph Neural Networks, GNNs)是几何深度学习领域的重要方向,旨在通过设计满足数据内在对称性与不变性的网络结构,提升模型对空间关系的理解能力。本教程基于剑桥大学 Chaitanya K. Joshi 等人的 geometric-gnn-dojo 项目,使用 PyTorch Geometric(PyG)实践不变性与等变性验证,并结合分子三维坐标、距离等几何信息构建高性能图神经网络。该方法可应用于分子性质预测、药物研发、材料结构分析和三维点云建模等场景。
在线运行:https://go.hyper.ai/r9stc
社区文章解读
1. 分析效率提升超 200 倍!阿贡国家实验室提出基于无监督训练的纳米光束衍射分析方法,DONUT 准确提取材料特征
DONUT(Diffraction with Optics for Nanobeam by Unsupervised Training)是美国能源部阿贡国家实验室团队提出的一种无监督物理感知神经网络,用于快速解析扫描式 X 射线衍射显微(SXDM)数据。该方法无需标注数据或预训练模型,可自动分离光束形状与局域晶格信息之间的耦合关系,突破传统拟合方法计算成本高、依赖预处理的限制。实验表明,DONUT 能准确提取纳米尺度结构特征,分析效率较传统方法提升超过 200 倍,为材料结构表征提供了新的智能化方案。
在线运行:https://go.hyper.ai/I00f5
热门百科词条精选
1. 光学字符识别 OCR
2. 世界动作模型 WAM
3. 遥感 Remote Sensing
4. 故障词元 Glitch Token
5. 生成型预训练变换模型 GPT
这里汇编了数百条 AI 相关词条,让你在这里读懂「人工智能」:
8 月截稿顶会

* 截稿时间为 AoE 时间
一站式追踪人工智能学术顶会:Events | HyperAI
以上就是本周编辑精选的全部内容,如果你有想要收录 hyper.ai 官方网站的资源,也欢迎留言或投稿告诉我们哦!
下周再见!

 43


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


