在线教程丨英伟达开源LocateAnything,3B模型可实现图像+视频的目标指向/开放词汇目标检测/指代表达定位/OCR文本定位等功能

实战指南:在英伟达NX开发板上高效部署目标检测模型的完整流程 本文详细介绍了在英伟达NX开发板上高效部署目标检测模型的完整流程,涵盖系统烧录、环境配置、模型优化等关键步骤。特别针对YOLOv5、SSD等主流算法在NX开发板上的性能优化和问题排查提供实用解决方案,帮助开发者在边缘计算场景实现高效AI模型部署。 阅读详情

随着视觉语言模型(VLM)持续向 Agent、多模态交互和现实世界任务演进,「看懂图片」已经不再是终点,更重要的是「准确找到目标在哪里」。无论是开放词汇目标检测、GUI Agent 的界面操作、文档理解,还是机器人与自动驾驶系统中的环境感知,都对视觉定位(Visual Grounding)能力提出了越来越高的要求。

然而,现有主流视觉语言模型在处理定位任务时普遍采用「坐标 Token 生成」方案,即将一个二维目标框拆分为多个一维坐标 Token,再逐个生成和解码。这种方式不仅难以充分保持目标框内部几何结构的一致性,还会因为严格的顺序生成机制限制推理速度。当模型需要同时处理大量目标时,定位效率和精度往往难以兼顾。

针对这一长期存在的瓶颈,NVIDIA 于近期开源了 Eagle VLM 系列中的新成员——LocateAnything-3B。这是一款拥有 30 亿参数的视觉语言定位模型,支持开放词汇目标检测、指代表达定位、OCR 文本定位、GUI 元素定位以及图像和视频中的目标指向等多种任务,旨在构建统一的视觉定位与检测框架。

LocateAnything-3B 的核心创新来自一种名为 Parallel Box Decoding(PBD,并行框解码)的新机制。与传统方法逐个生成坐标 Token 不同,PBD 可以将边界框、关键点等几何元素作为完整结构一次性并行预测。这样的设计不仅保留了目标框内部的几何一致性,也显著提升了解码吞吐量,使模型能够在保持高精度定位能力的同时实现更快的推理速度。

除了架构创新,NVIDIA 还围绕该模型构建了大规模训练体系。研究团队开发了可扩展的数据引擎,并推出包含超过 1.38 亿训练样本的 LocateAnything-Data 数据集,覆盖自然场景、机器人、自动驾驶、GUI 交互、文档理解以及 OCR 等多个领域,大幅提升了模型在复杂场景下的泛化能力。

实验结果显示,LocateAnything 在多个视觉定位基准测试中同时实现了更高的定位质量和更快的解码速度,推动统一视觉定位模型突破传统速度与精度之间的权衡。对于正在快速发展的 GUI Agent、自动标注系统以及下一代多模态智能体而言,这种高效且精准的空间理解能力,正在成为基础设施级别的关键能力。

目前,HyperAI 官网(hyper.ai)的教程版块已经上线了「LocateAnything-3B:快速高质量视觉语言定位模型」,以 Notebook 的形式降低部署门槛。

在线运行:https://go.hyper.ai/4l9jB

Demo 示例

更多在线教程:

Notebooks | HyperAI

欢迎登录官网查看更多内容:

https://hyper.ai

Demo 运行

1.进入 hyper.ai 首页后,选择「教程」页面,或点击「查看更多教程」,选择「LocateAnything-3B:快速高质量视觉语言定位模型」,点击「运行此教程」。

2.页面跳转后,点击右上角「Clone」,将该教程克隆至自己的容器中。

注:页面右上角支持切换语言,目前提供中文及英文两种语言,本教程文章以英文为例进行步骤展示。

3.选择「NVIDIA RTX 5090」以及「PyTorch」镜像,点击「Continue job execution(继续执行)」。

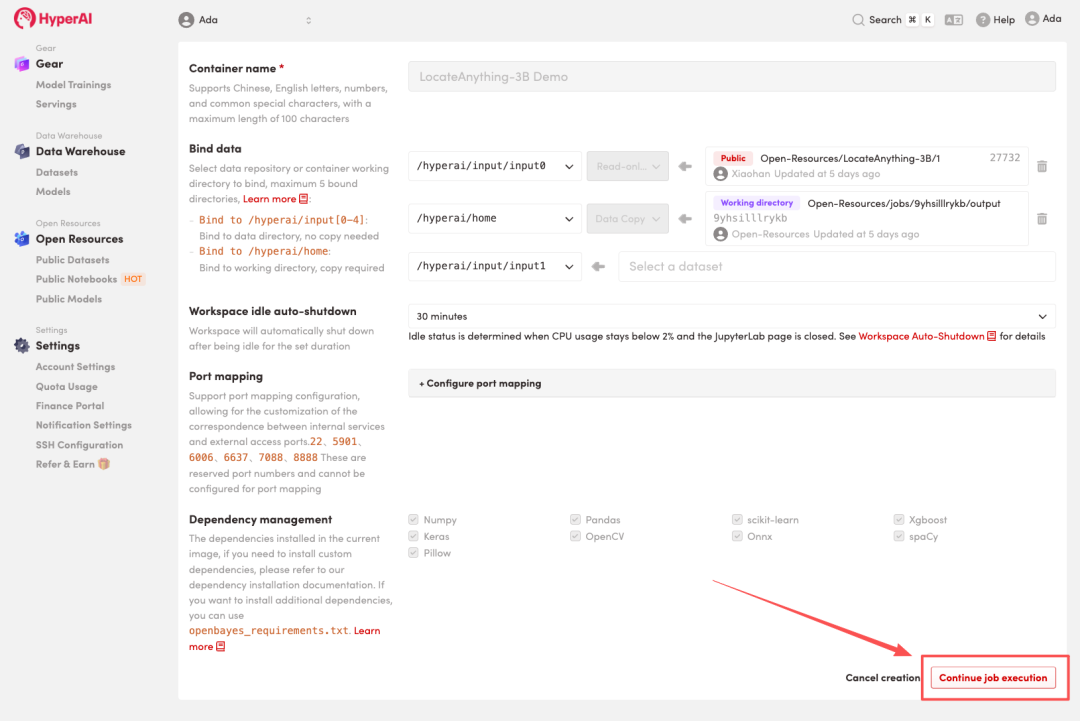
4.等待分配资源,当状态变为「Running(运行中)」后,点击「Open Workspace」进入 Jupyter Workspace。

效果展示

1.页面跳转后,点击左侧 README 文件,进入后点击上方 Run(运行)。

2.待运行完成后,即可点击右侧 API 地址跳转至 demo 页面。

windows中通过docker部署LocateAnything-3B模型 阅读详情

相关推荐

英伟达开源神器 LocateAnything:3B模型也能精准定位目标,demo测试;

NVIDIA于2026年5月26日开源LocateAnything视觉语言定位模型,依托并行边界框解码技术,解决传统模型推理慢、定位精度不足的问题。该模型基于1.38亿标注样本训练,支持文本引导定位、目标检测、UI识别、文本定位四大任务,兼容图文与视频输入、中英文指令。轻量版LocateAnything-3B可在16GB显存消费级GPU上部署,提供fa

优快云_DU666666的博客 4612

重磅开源!LocateAnything 一站式搞定全场景视觉定位,解码速度暴涨 10 倍

重磅开源!LocateAnything 一站式搞定全场景视觉定位,解码速度暴涨 10 倍

阿旭的博客 1311

Mamba-YOLO训练前必看:从环境配置到数据集调整的完整流程

本文详细介绍了Mamba-YOLO目标检测框架的完整训练流程,包括环境配置、数据集优化和模型调参。从硬件准备到依赖安装,再到数据增强和超参数调整,提供了一系列实用技巧和常见问题解决方案,帮助开发者高效训练Mamba-YOLO模型,避免常见踩坑记录。

tech5的博客 827

NVIDA开源视觉定位神器:LocateAnything

LocateAnything全称为LocateAnything: Fast and High-Quality Vision-Language Grounding(并行框解码视觉语言定位模型)。开源了 LocateAnything-3B(30 亿参数)。模型定位:通用开放词汇视觉定位基座,一句话文本指令→图像自动输出目标包围框,统一开放域检测、指代定位、UI 控件拾取、OCR 文字框选四大任务,主打高速 + 高精度,面向机器人抓取、AI 智能体、工控视觉、自动 GUI 操作场景。非商用免费开源,商用需联系英伟

weixin_46747526的博客 1542

【四季发财中线】通达信炒股指标副图指标使用图文教程,短线紫色柱线操作,与中线短柱线共振抓牛股妖股主升浪

如上图标记位置,对应的是副图指标的紫色柱线开始的位置,这个紫色柱线信号开始出现,也是短线进场做多的信号,紫色柱线的持续出现和加长,可以持股待涨,或行情继续上涨的可以在分时行情中逢低进场短线顺势做多。如上图标记部分,指标的主要部分信号,三行柱线-ZR-ZC -ZM,当出现这三行信号时,中线或波段看多做多,信号持续则中线顺势做多和持股待涨。不论是跟踪信号的出现先后进场和持股,或是在中线多头的行情中,找到短线转多信号进场做安全的短线操作机会,都是非常好的指标信号和辅助操作功能。

weixin_69760830的博客 1602

解锁笔记智能对话:手把手配置 Obsidian Copilot 插件与硅基流动模型

本文详细介绍了如何为Obsidian笔记软件配置Copilot插件,并接入硅基流动AI模型,从而为个人知识库添加智能对话能力。通过手把手教程,指导用户完成插件安装、API Key获取、模型配置及索引构建,最终实现基于个人笔记内容的深度语义问答,提升知识管理效率。

corn8的博客 613

LocateAnything:基于并行框解码的快速高质量视觉语言定位

视觉语言模型(VLM)通常将视觉定位和检测形式化为坐标令牌生成问题,将每个2D框序列化为多个1D令牌,这些令牌被学习并很大程度上独立解码。这种逐令牌解码与框几何的耦合结构不匹配,并且由于严格的顺序生成而产生了实际的推理瓶颈。我们提出了LocateAnything,一个基于并行框解码(PBD)的统一生成式定位与检测框架。通过将几何元素(如边界框和点)作为原子单元一步解码,LocateAnything保持了框内几何一致性并释放了显著的并行性。我们展示了PBD既提高了解码吞吐量又提高了定位精度。

AI浩 910

用户视角下的vfsglobal预约困境:从注册到登录的全流程避坑指南

本文详细解析了vfsglobal签证预约系统从注册到登录的全流程操作,帮助用户避开常见技术陷阱。针对IP限制、DNS解析、浏览器缓存等登录障碍提供实用解决方案,并揭示账号管理的隐藏规则与支付环节的延时处理技巧,助力用户高效完成签证预约。

ol78901234的博客 871

LocateAnything解读

由 NVIDIA 联合香港理工大学、普林斯顿大学、南京大学等多所高校与企业研究者共同完成,核心作者包含 Shihao Wang、Shilong Liu、Zhiding Yu 等,是视觉语言模型(VLM)领域顶尖联合团队。,基于现有主流 VLM 架构轻量化改造,核心仅替换解码层为并行框解码(PBD),兼容现有视觉编码器、跨模态融合模块,迁移成本极低。系统性应用于视觉定位与检测任务。两类简单几何单元,尚未针对语义分割、实例分割、3D 视觉框等复杂几何结构做适配,向分割、3D 视觉领域拓展的有效性仍需验证。

年轻即出发, 718

利用ORCAD/pspice 仿真分析电路的幅度相位谱

利用ORCAD的pspice仿真分析电路的相位谱1.介绍2.搭建电路原理图3.建立仿真文件,进行交流分析4.仿真、查看输出5.总结 1.介绍 orcad配合pspice一直是电路原理图绘制和仿真的主要工具,pspice工具提供了诸如暂态分析、直流分析、交流分析等多个工具。学校主要教的是multisim,对orcad讲得很少,最进要利用orcad对运放构成的电路的频响、相移特性进行分析,发现资料幅度...

qq_40011737的博客 1万+

MLNX_OFED 5.4-3.7.5.0 驱动安装:银河麒麟V10SP2 ARM 内核升级后编译避坑 3 步

本文详细介绍了在银河麒麟V10SP2 ARM环境下安装MLNX_OFED 5.4-3.7.5.0驱动的完整流程,包括内核升级后的驱动兼容性挑战、编译环境准备、分步编译与安装流程以及性能优化与故障排查。特别针对国产化ARM服务器(如华为Atlas系列)提供了实用的解决方案和常见问题处理建议,帮助用户顺利完成mlnx网卡驱动的安装与配置。

weixin_29184075的博客 403

教程上新丨英伟达开源 LocateAnything,3B 模型可实现图像 + 视频的目标指向 / 开放词汇目标检测/指代表达定位 / OCR 文本定位等功能

NVIDIA开源LocateAnything-3B模型,革新视觉定位技术。该30亿参数模型采用创新的ParallelBoxDecoding机制,突破传统坐标Token生成方式的局限,实现目标框等几何结构的并行预测,在保持高精度的同时显著提升解码速度。配套发布的1.38亿样本LocateAnything-Data数据集覆盖多领域场景,增强模型泛化能力。测试显示其在多项视觉定位任务中同步实现质量与速度突破,为GUIAgent、自动标注等应用提供基础设施级支持。OpenBayes平台已上线教程,用户可通过云端快速

OpenBayes的博客 205

3D Gaussian Splatting的使用

Gaussian splatting 快速生成自己屋子的模型

gootyking的博客 1万+

LocateAnything 视觉-语言定位推理 多GPU并行大批量图片目标检测的实现

flyfish

二分掌柜的 1083

【四足机器人项目实战】MIT无刷电机FOC硬件电路设计

系列文章目录 提示:这里可以添加系列文章的所有文章的目录,目录需要自己手动添加 TODO:写完再整理 文章目录系列文章目录前言一、MCU最小系统--STM32F446RE1.usb串口通讯连接口+程序下载连接口2.MCU电源滤波二、磁编码器角度传感器三、三相驱动桥四、CAN通讯收发器电路五、温度ADC检测六、电源滤波及分压电路1、DC电源输入端2、DC电源滤波电路3、DC电源分压电路4、三相绕线接线端总结参考资料 前言 认知有限,望大家多多包涵,有什么问题也希望能够与大家多交流,共同成长! 本文先对

qq_35635374的博客 7062

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

手把手教你部署 NVIDIA 视觉定位模型 LocateAnything

NVIDIA 开源的视觉定位(Visual Grounding)模型支持用文字描述在图片中精准定位物体特点:速度快、精度高、支持多种定位方式。

CJisOP0的博客 1877

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

【亲测】LocateAnything使用教程与6大应用示例【附源码】

【亲测】LocateAnything使用教程与6大应用示例【附源码】

阿旭的博客 1644

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

AI一周事件 · 2026-05-13 至 2026-05-26

(本文借助 AI 大模型及工具辅助整理)

:: Dotnet Fantasy :: 794

每日 AI 研究简报 · 2026-05-27

今日AI研究聚焦自主Agent进化、多模态感知突破与端侧模型优化,同时揭示AI对齐的新风险。

:: Dotnet Fantasy :: 677

LocateAnything-3B:让多模态模型不只“看懂”,还能“找准”

NVIDIA 发布 LocateAnything-3B!面向视觉定位任务的 3B 级视觉语言模型。

OpenCSG的博客 395

LocateAnything-3B在机器人领域的应用:视觉定位如何赋能物理AI

LocateAnything-3B是一款由NVIDIA开发的3B参数视觉定位模型,专为需要从自然语言指令中实现快速精确视觉定位的应用场景设计。该模型通过强大的空间 grounding能力,正在机器人领域掀起一场感知革命,让AI系统能够像人类一样理解物理世界中的空间关系。 ## 为什么机器人需要精准的视觉定位能力? 在工业4.0和智能服务的浪潮中,机器人正从单一重复任务向复杂环境交互演进。传统机

gitblog_00128的博客 896

LocateAnything-3B 在线体验地址

在线体验地址:https://www.modelscope.cn/studios/nv-community/LocateAnything

学亮编程手记 399

AAAI25|Locate Anything on Earth: 半自动化构建LAE-1M数据集,推动遥感开放词汇目标检测新突破...

关注公众号,发现CV技术之美本篇分享 AAAI2025 论文Locate Anything on Earth: Advancing Open-Vocabulary Object Detection for Remote Sensing Community,提出通过半自动化的方式,构建一个大规模的遥感目标检测数据集 LAE-1M,该数据集包含100万个标注实例。会议:39th Annual AAAI...

我爱计算机视觉 831

云平台一键部署【nvidia/LocateAnything-3B】视觉定位推理服务

NVIDIA推出的LocateAnything模型创新性地采用并行框解码(PBD)技术,将完整边界框作为单元一步预测,突破传统自回归解码限制,实现2.5倍速度提升同时保持精度。该模型支持三种推理模式(快速/慢速/混合),适用于开放集检测、多目标定位、自动化标注等场景,已在趋动云平台上线,提供一键部署体验。用户可通过社区项目快速启动,包含视频教程和使用说明,需注意及时关闭环境以避免费用产生。

m0_49711991的博客 264

微调LocateAnything-3B 实现超高密度的目标检测

本文介绍如何微调NVIDIA LocateAnything-3B模型,应对300+密集重叠种子的精准定位难题。依托并行框解码(PBD)与半监督Pipeline(点标注→SAM2转框→YOLO伪标→定向微调),大幅降低人工成本,实现高精度、可落地的密集目标检测方案。

deephub 1215

LocateAnything-3B社区资源汇总:从Hugging Face到GitHub的完整生态

LocateAnything-3B是一款由NVIDIA开发的高效视觉语言定位模型,作为Eagle VLM模型家族的重要成员,它采用创新的Parallel Box Decoding技术,实现了快速且高质量的视觉语言接地能力,支持精确的物体定位、密集检测和基于点的定位等多种任务。 ## 🌟 核心资源平台 ### Hugging Face生态 LocateAnything-3B在Hugging

gitblog_00405的博客 929
上一篇: 研发周期缩短70%以上!新加坡国立大学提出AI-计算化学协同流程,加速糖尿病创面愈合药物重定位研发
下一篇: Free CPU教程丨西湖大学张岳团队开源科研插图神器AutoFigure,可精准理解长篇科学文本
HyperAI超神经
博客等级 码龄7年 8872粉丝 1753原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值