溶血性预测准确率提升350%,港中文/浙大/澳门理工等团队提出通用框架Bi-TEAM,融合生物学语义与化学精度

深度学习之Encoder-Only原理与实战 【代码】深度学习之Encoder-Only原理与实战。 阅读详情

在生物化学与分子工程领域,表征学习正逐渐成为解析分子功能、推动治疗性分子发现的关键技术。嵌入特征的质量,往往决定了肽性质预测与从头设计等下游任务的性能上限。作为连接生物功能与化学特性的核心分子,肽的结构与功能建模在药物研发中具有重要价值。近年来,非经典氨基酸的引入显著拓展了肽的功能空间,并提升了其稳定性与生物利用度,但复杂的化学修饰也给传统建模方法带来了新的挑战。如何在模型中同时整合生物进化信息与化学合理性,正成为该领域亟待突破的关键问题。
 

目前,肽建模主要沿两条技术路径展开。一方面,以 ESM、ProtT5 为代表的蛋白质语言模型通过大规模序列预训练捕捉生物上下文与进化信息,为下游任务提供可迁移的生物表征。另一方面,为应对非经典氨基酸的修饰问题,研究人员基于化学语言模型,通过原子级分词捕捉化学细节,弥补了蛋白质模型在化学层面的不足。
 

然而,两类模型均存在固有局限。蛋白质语言模型受限于天然氨基酸字符表,难以处理非经典残基,现有近似或扩展词汇的方法常引入偏差或导致语义稀疏。化学语言模型则忽略全局生物上下文,且密集分词易超出上下文窗口,难以适配长序列建模,通用模型还存在领域偏差。
 

针对上述问题,香港中文大学联合澳门理工大学、浙江大学、中南大学湘雅第二医院、中国电子科技大学等提出了一种选择性融合建模范式,基于「化学变异是对生物语义空间的局部扰动」这一认知,设计了将局部化学变异注入全局蛋白质背景的通用框架 Bi-TEAM。

该框架以生物表征为语义主干,通过自适应注入化学信号,实现生物进化信息与化学合理性的有效融合。在多项任务上,Bi-TEAM 持续超越最先进的基线模型:在基于骨架相似性的严格数据划分下,马修斯相关系数提升高达 66%;在溶血预测任务中,准确性提升 350%。
 

相关研究成果以「Bi-TEAM: A Unified Cross-Scale Representation Learning Framework for Chemically Modified Biomolecules」为题,已发表预印本于 arXiv。

研究亮点:

* Bi-TEAM 框架既能自适应整合多尺度生化性质,也能作为高保真的先验模型,实现高效的肽设计

* 研究人员将 Bi-TEAM 在 3 个生化领域的 10 个多样化数据集上进行了全面评估,在 7 个关键预测任务中达到了 SOTA 级别

* 该模型在预测与生成任务中实现双重突破,严格的骨架相似性划分下 MCC 提升 66%,同时将细胞穿透环肽的设计成功率提升至近 4 倍

图片


论文地址:
https://arxiv.org/abs/2603.01873
关注公众号,后台回复「Bi-TEAM」获取完整 PDF

覆盖三大生化领域,10 个多样化数据集进行全面评估

该研究从性质预测与引导生成两个维度展开评估,覆盖修饰肽、翻译后修饰(PTMs)以及天然蛋白三大研究领域,共涉及 10 个数据集。
 

在修饰肽领域,研究重点评估模型的膜通透性预测能力。核心训练数据来自 ProPAMPA 数据库,该数据集中环原子数范围为 12–46,序列长度分布近似正态,但在两端存在明显长尾;同时包含大量天然与非经典氨基酸残基,体现出较高的化学多样性,经 RDKit 去重后,共包含 6,876 条非共轭环肽序列。
 

为评估模型的泛化能力,研究进一步引入 3 个外部湿实验数据集:ProCacoPAMPA、CycPeptMPDB v1.2 以及 Rezai 数据集。这些数据集覆盖不同长度与结构类型的环肽样本。其中:

ProCacoPAMPA:从既有研究中整理得到所有长度为 6 和 10 的跨膜环肽序列,并统一构建为标准化数据集合。

CycPeptMPDB v1.2:目前公开规模最大的非经典环肽膜通透性数据库的最新版本,整合自 56 篇文献,共包含 8,466 条记录。在本研究中,研究人员去除了与 ProPAMPA 数据集重复的样本,最终获得包含 1,230 个数据点的精炼子集。

Rezai:则包含 11 条环肽的被动膜通透性数据,这些数据通过 PAMPA 实验测得,常被用于小样本条件下的模型外部验证。

为进一步验证模型的成药性和疾病关联性,研究人员在 PTM 数据集上开展了成药性预测任务。所使用的数据包括成药性数据集和疾病关联数据集两类。前者以较长蛋白序列为主,修饰位点呈现明显的长尾分布特征;后者主要来源于 dbPTM、全基因组关联研究(GWAS)等数据库,其修饰位点分布与前者相似,但序列长度范围更广,从而提供了更加多样化的结构背景。
 

在天然蛋白领域,研究人员重点评估模型在溶解度预测与溶血性预测任务中的表现,以探究肽类溶血过程及蛋白溶解度变化的关键机制。所采用的数据集主要包括溶血、抗污染以及溶解度三类。其中:

溶血数据来源于 DBAASP v3 数据库,共包含 9,316 条由 L 型经典氨基酸组成的序列。

抗污染数据集则主要由短肽序列构成,长度集中在 5–10 个氨基酸残基之间,其 LogP 分布近似正态,样本在特征空间中表现出较好的聚类结构。

溶解度数据集来源于 PROSO II 注释的蛋白序列,其标签基于蛋白质结构计划(Protein Structure Initiative)的回顾性分析所得。

Bi-TEAM:用于化学修饰生物分子的统一跨尺度表征学习框架

Bi-TEAM 旨在解决现有单模态模型难以同时捕捉全局生物进化信息(evolutionary biological space)与局部化学结构细节(fine-grained chemical space)的问题。如下图所示,其核心思路是构建一种双视角表征体系,将进化生物空间与化学结构空间进行深度融合,从而为包含非经典氨基酸的肽序列提供更精准的建模能力。
 

图片


Bi-TEAM 探索统一的蛋白质表示空间
 

在整体架构上,模型以蛋白质语言模型构建的生物空间作为语义主干,充分利用其在大规模天然序列中学习到的进化规律与上下文关联。同时,引入化学语言模型(CLM)以捕捉原子层面的结构信息,弥补蛋白质语言模型(PLM)在处理化学修饰时的天然局限。两类模型在表征层面形成互补,共同拓展输入序列的表达能力。
 

图片


Bi-TEAM 的网络架构
 

在处理含修饰的肽序列时,Bi-TEAM 通过两条互补的信息流进行编码:一条为生物序列流(biological sequence),将修饰氨基酸映射为结构最接近的天然氨基酸,从而避免分词表膨胀,并保留可用于建模的进化语义;另一条为类 SELFIES 表征流(SELFIES-like representation),用于在原子层面精确描述修饰残基的官能团变化与化学键结构,为化学语言模型提供稳定的结构信息。

完成双流编码后,模型通过由位置感知修饰提示引导的双门控残差机制进行融合:以生物表征为语义主干,利用门控单元筛选并注入关键化学信号,同时保留生物特征的残差连接,从而在保持训练稳定性的同时,使模型能够在全局序列约束与局部化学变化之间建立有效关联。

在应用层面,Bi-TEAM 具有良好的通用性。当处理不含修饰的天然蛋白序列时,模型可以直接省略映射与定位步骤,无需调整整体架构即可适配常规蛋白任务。

训练策略上,研究采用「预训练-微调」的两阶段框架:首先分别在天然蛋白序列和小分子化学语料上对两类基础编码器进行领域适配预训练;随后通过多任务联合微调,使模型学习不同任务场景下生物特征与化学特征的融合规律,从而进一步提升整体泛化能力。

Bi-TEAM 在穿透性环肽设计取得突破,成功率提升 4.6 倍

为验证 Bi-TEAM 在未知化学空间中的应用能力,该研究以无创药物递送为场景,聚焦靶向新生血管性年龄相关性黄斑变性(nAMD)治疗的细胞穿透性非经典环肽设计,系统开展「预测-引导-分析」的全流程实验,评估模型在属性引导型分子设计中的表现。
 

nAMD 是老年人不可逆失明的重要原因,其核心病理为 VEGF 驱动的脉络膜新生血管与渗漏。目前临床主要依赖玻璃体内注射大分子抗 VEGF 药物(如 Aflibercept,115 kD),但该类药物难以穿透眼部生理屏障,长期注射也存在并发症与依从性问题。如果能够设计既能特异性结合 Aflibercept、又能促进其跨屏障转运的肽结合剂,将为无创滴眼液疗法提供新的可能。相比易降解、半衰期短的线性肽,结构更稳定、通透性更强的环肽被认为是更理想的递送载体,这也是研究人员聚焦环肽设计的主要动机。
 

该研究首先开展细胞穿透肽(CPPs)预测评估,为后续生成任务提供基础。数据集按照 pLM4CPP 标准方案构建,整合 CPPsite2.0、C2Pred、CellPPD 等数据库,经筛选去重后得到 1,399 个阳性样本(实验验证的穿透肽)和 4,080 个阴性样本。对比模型包括 SeqVec、ESM2、ProtT5 等主流蛋白嵌入模型,评估指标涵盖 ACC、BACC、Sn、Sp、MCC 和 AUC。

结果表明,Bi-TEAM 在所有指标上均取得最佳表现:ACC 较 SeqVec 提升 5.52%,BACC 较 ESM2-480 提升 5.88%,Sn 提升 12.58%,Sp 较 ProtT5-XL BFD 提升 1.45%,MCC 较 SeqVec 提升 14.68%,AUC 较 ESM2-480 提升 8.45%。其中灵敏度与 MCC 的显著提升,表明模型在识别真实穿透肽方面具有明显优势。
 

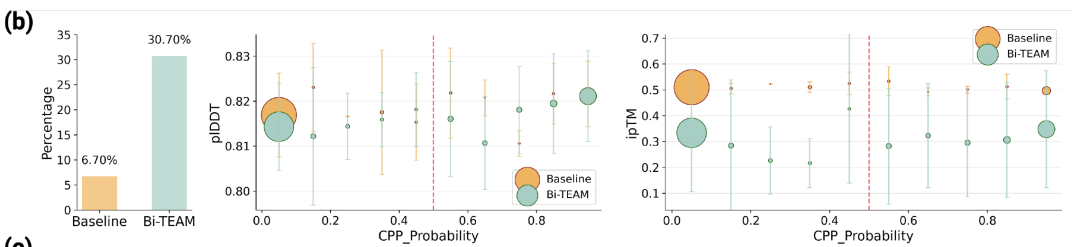
在此基础上,研究进一步开展属性引导的环肽生成实验。以 BoltzDesign1 为基线框架,在两种条件下分别生成 1,000 条长度为 10-20 的环肽:一类仅采用默认结构约束,另一类在生成过程中引入 Bi-TEAM 作为额外梯度引导。

以 Bi-TEAM 预测对数几率大于 0.5 为成功标准。结果显示,传统方法生成具有细胞穿透性的环肽成功率仅为 6.7%,而在 Bi-TEAM 引导下提升至 30.7%。同时结构质量并未下降:生成的肽-Aflibercept 复合物平均 pLDDT 超过 0.82,说明模型在提升穿透性的同时仍保持了良好的结构置信度和结合界面稳定性。
 

图片


生成 1000 个样本的成功率
 

为理解引导机制,研究人员进一步分析生成序列的残基模式。已有研究表明,由色氨酸(W)、苯丙氨酸(F)和酪氨酸(Y)构成的疏水三联体,以及精氨酸(R)、赖氨酸(K)等正电荷残基,是细胞穿透肽实现膜转运的关键特征。

分析发现,在 Bi-TEAM 引导下,生成序列中疏水三联体与两个正电荷残基的共现频率显著提高,残基数量分布也呈现一致趋势。这一富集模式与已知的穿透肽结构—功能规律高度一致,说明 Bi-TEAM 不仅能够捕捉相关生物机制,还能在生成过程中显著提高具有膜穿透特性的序列出现概率。控制变量分析进一步排除了肽长度(10–20 残基)的影响,表明模型确实将采样分布引导至更有利于膜转运的化学—生物联合空间。
 

图片


左:模型性能雷达图;

中:关键疏水残基丰度与穿透概率关系;

右:环肽长度与穿透概率关系
 

最后,该研究通过案例研究对结果进行了结构层面的验证。研究人员首先展示了 Aflibercept 二聚体的三维结构,并根据静电势对其分子表面进行着色;随后利用 AlphaFold3 预测设计环肽与 Aflibercept 的复合物结构。分析识别出两个潜在的环肽结合口袋:一个为由三个环构成的疏水腔体,另一个由环结构与 β 折叠片段共同形成。这些结构信息为后续环肽优化及潜在临床应用提供了重要依据。
 

图片


Aflibercept 在静电表面电位图中的显示情况

聚焦多肽药物研发领域的技术创新

在肽科学领域,从基础研究到临床转化,全球范围内的一众科研机构均在为攻克重大疾病而积极探索新的技术路径与治疗方案。
 

例如,英国布里斯托大学生物化学学院的结构生物学团队,利用冷冻电镜和 X 射线晶体学等先进技术解析免疫系统的精细结构,并在此基础上开展结构引导的肽类药物设计。他们尝试通过设计能够精准激活人体补体系统的环肽分子,开发用于自身免疫疾病治疗的下一代候选药物。
 

与此同时,伦敦国王学院与萨格勒布大学合作开展的 ToxiCode 项目,则探索从动物毒液中发现新药的独特路径。项目结合人工智能与合成生物学,通过构建混合 AI 系统学习肽序列模式及其结构—活性关系,快速设计针对癌症、神经系统疾病和感染性疾病的新型生物活性肽,为可持续且符合伦理的药物发现提供了新的方法框架。
 

由此可见,多肽药物研发正逐渐形成一种新的研究范式:结构生物学、人工智能与化学生物学不断交汇,基础研究与产业开发之间的边界也愈发模糊。新的分子往往诞生于跨学科的技术组合之中,而真正决定其能否走向临床的,则是从实验室发现到产业化体系之间那条逐步被打通的转化路径。在这一过程中,多肽分子因其介于小分子与大分子之间的独特属性,正被重新认识,并在越来越多的疾病领域中展现出新的应用空间。

参考链接:
1.https://www.bristol.ac.uk/news/2025/november/bristol-researcher-awarded-over-850000-to-develop-new-treatments.html
2.https://www.kcl.ac.uk/news/kings-to-collaborate-in-venom-based-drug-discovery-project
3.https://mp.weixin.qq.com/s/X67D1qrUzclwOsJ9cKUtZg

深度学习之Seq2Seq原理与实战 【代码】深度学习之Seq2Seq原理与实战。 阅读详情

相关推荐

深度学习之TF-IDF原理与实战

【代码】深度学习之TF_IDF原理与实战。

yumiwangzi30的博客 187

深度学习0:数学知识:正态分布1

步骤内容结果1引入e−x2e^{-x^2}e−x2钟形曲线2算它的面积I∫−∞∞e−x2dxI∫−∞∞​e−x2dx3平方变成二重积分I2I^2I24换极坐标简化计算5算出I2πI^2 = \piI2πIπIπ​6代入σ\sigmaσ和μ\muμ做变量替换得到σ2πσ2π​7除以它归一化得到正态分布公式2π2π​不是随便写的,它来自高斯积分∫−∞∞e−x2。

tellmewhoisi的博客 196

深度学习之LoRA(低秩适配)原理与实战

【代码】深度学习之LoRA(低秩适配)原理与实战。

yumiwangzi30的博客 258

图解循环神经网络(RNN)

RNN(循环神经网络)就是“带记忆的网络”:让网络拥有一块“记忆”,在处理当前数据时,能同时参考之前看过的内容;它不一次性看完全部输入,而是像人读书一样,一个字一个字地读,每读一个字就更新一次脑子里的记忆,然后用这份记忆去理解当前这个字。但便签一直在被改写,新信息不断挤占旧信息,传到第 40 步时,“巴黎”的痕迹已经淡得几乎没了。读到“贵”的时候,网络并没有重新去查“好看”这个词——但“好看”的影响已经融在了便签里(那个 1.5)。这三个困难的共同点:答案不在当前这一个字里,而在“前面那串东西”里。

技术管理两手抓,两手都要硬. 359

深度学习之词袋(Bag-of-Words, BoW)原理与实战

【代码】深度学习之词袋(Bag-of-Words, BoW)原理与实战。

yumiwangzi30的博客 224

深度学习之LSTM原理与实战

【代码】深度学习之LSTM原理与实战。

yumiwangzi30的博客 130

【原创深度学习项目】基于深度学习的建筑工地防护装备检测系统|安全帽与反光衣检测系统(RT-DETR-L 模型)

本文设计并实现了一套基于RT-DETR-L的建筑工地防护装备检测系统,采用Django+Vue前后端架构,实现对安全帽、反光背心等7类装备及“无PPE”“未戴安全帽”等缺失状态的精准识别。系统支持图片、视频、摄像头实时检测,具备参数可调、数据可视化与统计分析功能,有效解决小目标漏检、误检及管理难问题,助力智慧工地安全管理落地。文末可获取源码。

qq_1445749146的博客 215

AI对战五子棋——深度学习策略网络

在本篇博文中,我们完成了:✔ 构建一个 CNN 五子棋策略网络✔ 让神经网络输出落子概率✔ 使用 Policy Gradient 强化学习训练 AI✔ 让 AI 实现人与 AI、AI 自对弈博弈。

X2829352498的博客 25

神经网络入门指南:从 CNN、RNN 到 Attention

神经网络的学习,本质是“预测—比较—纠错”的循环;CNN 通过局部连接与权重共享理解图像;RNN 通过隐藏状态传递上下文;LSTM 和 GRU 用门控机制管理记忆;Encoder–Decoder 把理解与生成拆成两个阶段;Attention 则让模型在每一步都能主动寻找最相关的信息。到这里,我们已经走完了从普通神经网络到 Attention 的完整路线。下一篇将正式进入 Transformer,看看它如何摆脱 RNN 的顺序计算,又如何让每个 Token 直接找到与自己相关的信息。

爱敲代码的小黄 354

逆向学习:从已上线微信小游戏反推Cocos工程结构(以切水果跑酷为例)

本文以“切水果跑酷”为例,详细介绍了如何通过逆向分析已上线的微信小游戏,反推其基于Cocos Creator的原始工程结构。文章深入拆解了编译后的目录骨架、资源加载逻辑与依赖关系,并重点解析了微信平台API的调用特征,为开发者提供了一种高效学习游戏架构与设计模式的实用方法。

kk1234的博客 1073

Redis架构演进:从主从、哨兵到集群,如何支撑亿级流量的秒杀场景?

本文深入探讨了分布式缓存Redis的三种核心高可用模式:主从复制、哨兵模式与集群模式。以高并发的电商秒杀业务为切入点,我们分析了每种模式的优缺点和适用场景,并最终选择Redis集群模式作为最佳解决方案。文章提供了基于Spring Boot和Spring Data Redis的完整实现代码,详细展示了如何配置和使用Redis集群来应对高并发、高可用的挑战,旨在帮助开发者在实际项目中做出正确的技术选型和架构设计。

lingRJ777的博客 723

基于深度学习的垃圾分类系统的设计与实现

本系统是一个基于 Flask Web 框架与 PyTorch 深度学习模型的垃圾分类智能识别平台。系统面向垃圾图像分类场景,能够对上传图片中的玻璃、纸张、纸板、塑料、金属、其他垃圾等六类垃圾进行自动识别与置信度评估,并提供识别历史、数据统计、模型在线训练与记录导出等完整功能。系统使用 TrashNet 公开垃圾分类数据集进行模型训练,管理员可手动发起模型训练,训练完成后自动加载新权重。启动服务不会自动训练。

aiyuanma_vip的博客 385

Atlas 300I Pro推理卡性能深度测试:对比业界同类产品的能效比与算力表现

本文对昇腾Atlas 300I Pro推理卡进行了深度性能评测,重点对比了其与业界同类产品的能效比与算力表现。实测数据显示,该卡在运行BERT等模型时展现出高达39.6句子/秒/瓦的卓越能效比,电力成本可降低40%以上,同时其达芬奇架构和硬件加速特征检索能力,为高密度在线推理和向量检索场景提供了强大支撑。

weixin_29031161的博客 579

CNN 卷积神经网络深度解析:卷积、池化与特征提取的底层原理

卷积核(Kernel),也叫滤波器(Filter),本质上是一个可以训练的权重矩阵。1 0 -11 0 -11 0 -1这个卷积核可以对图像中的局部像素进行加权计算。不同的卷积核能够提取不同类型的特征:水平边缘特征垂直边缘特征纹理特征角点特征局部形状特征在传统图像处理中,滤波器通常由人工设计。而在 CNN 中,卷积核的权重通过训练数据和反向传播自动学习得到。这也是 CNN 能够自动提取图像特征的关键。# 第一层卷积padding=1# 第二层卷积padding=1。

2503_90237586的博客 240

Mediapipe姿态估计——用坐标计算手指关节弯曲角度并实时标注

利用mediapipe搭建姿态检测模型;mediapipe人体标注节点坐标;mediapipe计算手指弯曲角度并实时渲染;mediapipe计算关节弯曲角度。mediapipe手势识别;mediapipe姿态检测模型;mediapipe学习。

kalakalabala的博客 1万+

FPGA串口通信----uart(一)

通过PLL锁相环IP的使用,可以输入时钟进行分频,倍频,也可以产生多路时钟输出信号。外部提供晶振的原因:①Fpga电路大多数需要时序分析②晶振在Fpga内部占空间大,所以放置于外部PCB板上Uart异步传输速率不能很快的原因:考虑到工程实际问题,假如时钟周期大(传输速率慢的话),采取到数据电平变化的边沿时刻的概率会小很多,这样数据也很准确,通常uart适用于2M.

mvpkuku的博客 970

图解常用深度学习优化器

来隐式构造 Hessian 逆的近似,从而直接估计出“谷底在哪”,而非仅仅判断“哪边最陡”。即SGD/Adam 主要看“当前坡度”,LBFGS 还会看“最近几步坡度怎么变”,像用局部地形图来规划路线。训练 Transformer 时,有些层梯度大,有些层梯度小。如果用 Adam + L2,梯度大的参数反而可能被“少衰减”,正则效果不稳定;:你要下山,但每次迈步前都要派侦察兵把整座山的每一个坡面都测量一遍,算出“绝对最陡”的方向才走一步。:还是下山,但这次你只问身边一个路人“哪边最陡”,然后就走。

技术管理两手抓,两手都要硬. 200

Yolov5自定义图片训练测试及模型调优(详细过程)

Yolov5自定义数据训练及测试1. 图像数据获取、标注2. 数据集划分及准备3. 配置训练参数,准备训练:3.1 修改data/训练配置xxx.yaml文件:3.2 修改models模型配置xxx.yaml文件4. 开始训练5. 测试训练后的模型: 1. 图像数据获取、标注 如果自定义训练自己的数据集,首先需要数据标注,至于数据来源可以是下载现有的开发数据集、拍照、爬虫等等。 如果是拍照、爬虫等获取的数据图片,需要进行数据标注,这个过程可以使用工具来做,但也需要一些手动操作 。。并且图片越多越好,如果

HowieXue 薛永浩的博客 10万+

证件阅读机如何用多光谱光学成像、端到端深度学习 OCR 与 MRZ 解析、13.56MHz 射频芯片认证三层能力,把单证核验压缩到 1–2 秒

"说走就走"的外国游客多了,酒店前台的压力也就跟着一起"入境"了。复印件在红外图里会丢掉层次,屏幕翻拍件在紫外图里会暴露像素网格和屏幕的摩尔纹,PS 改过的资料页在红外和可见光的交叉比对下常常"对不上"。客人只觉得"这家酒店办入住挺快",前台只觉得"今天没被催",店长只觉得"这个月没收到整改通知"。三只眼睛和一个 AI 大脑在 1–2 秒里跑完的一整套核验,被压缩成了体验里那句轻飘飘的"好的,您的房卡"。有意思的是,真正在缓解这个压力的,不是多招几个前台,而是柜台上多了一台巴掌大的小设备——证件阅读机。

智能图像识别 346

Android16 rk3576添加触摸点数上限到40个点

本文介绍了在Android 16系统上实现40点触摸支持的修改方案。相比Android 15,Android 16对API添加有更严格的要求,需要在MotionEvent.java中添加@FlaggedApi批注。主要修改包括:1)在input_framework.aconfig中定义flag;2)在MotionEvent.java中添加40个AXIS_GENERIC轴常量并添加批注;3)将32位指针ID处理改为64位适配;4)更新相关API文档。修改涉及多个核心文件,包括PointerController

tzj1058756809的博客 382

YOLOv11改进策略【SPPF】| 将特征金字塔池化修改为:SPPCSPC,提升模型的特征提取能力和计算效率。

本文记录的是。YOLOv7中的SPPCSPC(Spatial Pyramid Pooling Cross Stage Partial Connections)模块是一种结合了(SPP)和(CSP)的改进结构,本文将其添加到YOLOv11中,

Limiiiing的博客 1821

基于深度学习的猫图像目标检测方法研究:YOLOv8s模型海选、多种子对比训练与Django+ONNX部署实现详解

本课题基于深度学习研究猫图像目标检测问题。数据集含1000张猫图像、1188个标注框,按固定比例划分并冻结清单;训练前在多个候选族中短训海选,确定YOLOv8s为主模型,经学习率搜索与显存标定后完成150轮训练,验证集mAP50达到0.92,并以7个随机种子的对比实验验证稳定性。最优权重导出为ONNX接入Django系统,提供图片、视频、摄像头三种识别方式,配套识别记录管理与统计大屏,形成从训练到应用的完整闭环。

WEIXIN_JSJBSZDS的博客 168

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

深度学习0:数学知识:正态分布2(积分,幂函数积分公式)

积分符号∫(\int∫= 把无数个极窄的小矩形面积(高度×dx(\times dx×dx))“拼接”起来。dx(dxdx= 无穷小的宽度。定积分的结果= 曲线下方的总面积(一个具体的数字)。不定积分= 寻找求导前的那个原函数。这就是“积分求面积”最朴素的意思!

tellmewhoisi的博客 210

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

无人机巡检道路路面异常检测数据集 深度学习 目标检测 无人机巡检 道路病害 路面异常 YOLO格式 数据集发布9028期

无人机巡检道路路面异常检测数据集 深度学习 目标检测 无人机巡检 道路病害 路面异常 YOLO格式 数据集发布9028期

qq_2529413168的博客 181

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

基于深度学习的肌肉骨骼X光骨折分类方法研究——数据清洗、ResNet50训练与Django部署全流程

本文介绍基于深度学习的肌肉骨骼X光骨折分类方法研究。课题基于公开FracAtlas数据集,先做错标清洗与分层划分,再以ResNet50迁移学习训练二分类模型,通过类别权重与早停应对类别不平衡,模型导出ONNX后配合能量分数与近邻阈值实现域外拒识。系统采用Django与Vue实现,包含图片识别、识别历史管理与可视化大屏等功能,全流程可复现,适合作为计算机专业毕业设计的参考方向。

WEIXIN_JSJBSZDS的博客 401

【深度学习实验】—— YOLOv12 添加 SE 注意力机制:实现、训练与水果检测对比

本次实验在 YOLOv12n 中接入 SE(Squeeze-and-Excitation)通道注意力,使用已有四类水果数据集,完成模块编写、模型解析器注册、前向与梯度检查、模型训练和最佳权重评估。项目本次设置与结果模型YOLOv12n 基线 / YOLOv12n SE 替换版任务四类水果目标检测数据集200 张图片,594 个标注框划分训练 160 张 / 验证 20 张 / 测试 20 张训练两组各 2 轮,batch=2,imgsz=640,seed=0,随机初始化。

weixin_65899656的博客 216
上一篇: 在线教程丨免费CPU资源快速部署,覆盖Qwen3.5/DeepSeek-R1/Gemma 3/Llama 3.2等热门开源模型
下一篇: 基于2.5万临床数据,斯坦福大学发布首个原生3D腹部CT视觉语言模型,Merlin在752类任务中全面领先
HyperAI超神经
博客等级 码龄7年 8873粉丝 1753原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值