性能远超SAM系模型,苏黎世大学等开发通用3D血管分割基础模型

告别反复格式化!用Ventoy制作2025年终极启动盘,Windows/Linux/macOS一网打尽 本文详细介绍了如何使用Ventoy制作2025年终极多系统启动盘,彻底告别反复格式化U盘的烦恼。Ventoy通过创新的引导加载器架构,允许用户在一个U盘内同时存放并直接启动Windows、Linux、macOS等多种系统镜像和WePE等维护工具,实现真正的非破坏性管理和极高的U盘利用率。文章涵盖从安装配置、镜像库构建到安全启动设置等全流程实战指南。 阅读详情

如果把人的身体比作一座庞大的城市,那么血管无疑就是这座城市的「道路」,动脉、静脉以及毛细血管对应着高速公路、城市道路以及乡间小道,它们相互协作,通过血液将营养物质、氧气等输送到身体各处,从而维持着这座「城市」的高效、稳定运行。而当这些道路出现问题时,人们的身体自然也会随之发生病变。

血管分割是检查这些「道路」是否存在问题的重要手段,如同城市建设中通过交通影像发现问题一般,它是医学图像处理中的一项关键任务。血管分割可以从医学图像中精准识别和提取血管的结构,从而应用于各种血管疾病的分析、诊断和治疗,例如在心血管疾病方面,对冠状动脉血管的分割有助于医生评估血管的狭窄程度,从而为患者制定合适的治疗方案。

近些年,血管分割在计算机和医学影像技术的加持下已经取得了显著进步。然而,当面对特定任务的成像时,准确和稳健的分割全连接的血管仍是一个具有挑战性的问题,尤其是在 3D 血管分割中。一方面是血管自身原因所限,复杂微小的血管几何形状带来的分割难度的陡然增长;另一方面是由成像方式和协议所限,特定的信噪比、血管模式、成像伪影以及背景组织的变化引起的显著域间隙。

虽然目前出现了多种基于基础模型的医学影像分割方法,如 SAM(Segment Anything Model)以及针对 3D 医学图像的 SAM-Med3D、VISTA3D 等,但这些模型在血管分割任务中仍存有局限性。因此,3D 血管分割对于医护人员和研究人员而言仍然是一项劳动密集型的工作,需要进行大量手动的体素级注释才能进一步实现准确的血管图像分析。

针对于此,来自苏黎世大学、苏黎世联邦理工学院和慕尼黑工业大学的团队提出了一个专为 3D 血管分割而设计的基础模型 vesselFM。该模型在一个大规模数据集(Dreal)及通过域随机化(Ddrand)和基于流匹配的生成模型(Dflow)生成的合成数据上进行训练,能够在零样本、单样本和少样本场景中实现优于现有先进模型的分割能力和泛化能力。

相关研究以「vesselFM: A Foundation Model for Universal 3D Blood Vessel Segmentation」为题发表,并入选了 CVPR 2025。

研究亮点:

* 研究提出了一种具有零样本、泛化能力的 3D 血管分割通用基础模型,可供研究人员和医护人员「开箱即用」

* 团队策划了最大的 3D 血管分割数据集,包括经过精心处理的真实 3D 血管图像和匹配的体素级注释

* 研究提出了一种针对 3D 血管分割的精细领域随机化策略,同时将流匹配引入 3D 医学图像生成当中。
图片

论文地址:
https://go.hyper.ai/lVad9
 

数据集:3 个异构数据源

研究人员使用了 3 个异构数据源对其进行训练,首先是一个内含不同真实数据的数据集 Dreal(Diverse Real Data);其次为 2 个合成数据源,分别是领域随机数据集 Ddrand(Domain Randomization)以及从基于流匹配的生成模型中采集的数据 Dflow(Flow Matching-Based)。

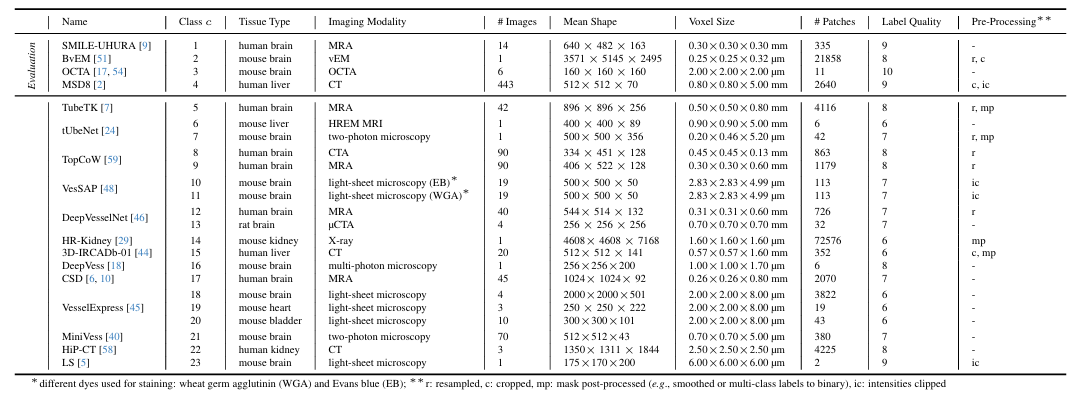
其中,Dreal 是迄今为止应用于 3D 血管分割任务中最大的真实数据集,涵盖来自不同生物体的各种解剖区域的广泛成像模式,包含了 17 个注释来源的超 115,000 个形状为 128³ 的 3D patches。具体来说,其广泛的临床成像包括 MRA、CTA、X 光片、双光子显微镜以及 vEM 等,生物样本来自人类、实验鼠的大脑、肾脏和肝脏等,这为研究提供了不同结构和功能特性的血管模式。如下图所示。
图片

Dreal 数据集总览(23 个数据集统计信息,包括 4 个验证数据集)

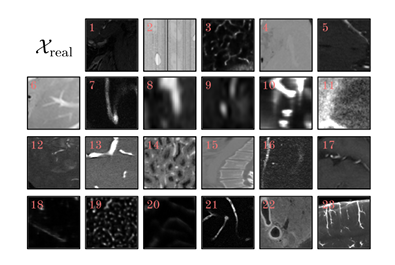
随后,研究人员又根据组织类型、成像方式以及协议,进一步将 Dreal 划分为了 23 个数据集,并且对每个数据集进行了预处理,最后从图像及其相应的标签中提取目标形状为 128³ 的 patches。
图片

数据示例图

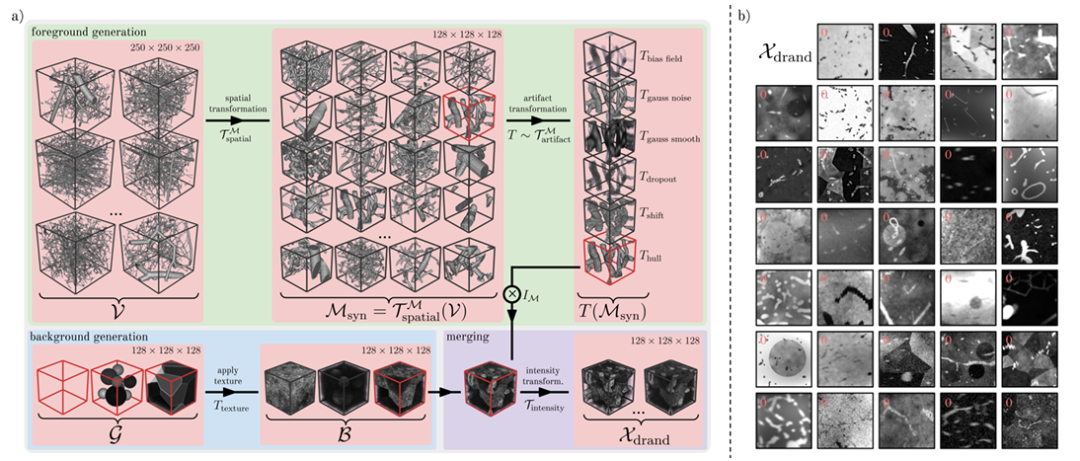
研究人员引入了域随机化策略创建了 Ddrand,如下图所示。该方法通过在真实血管数据上施加一系列的空间变换和人工伪影,生成大量具有多样性的合成图像-掩码对,以此提升模型对真实数据的鲁棒性。具体来说可分为 3 步,即前景生成、背景生成和背景融合。
图片

图 a 为用于生成 Ddrand 的领域随机生成管道的示意图;图 b 为示例图

在前景生成阶段,研究人员利用 Wittmann 等提供的 1,137 个形状为 250³ 的血管板块 v 作为合成掩码的基础,这些血管斑块来自于腐蚀铸型的图形表示,具有高保真性。

研究人员采用的主要方法是通过空间变换,如随机裁剪、翻转、扩张和缩放、随机弹性变形以及二元平滑来实现生成广泛的真实血管模式。接下来,研究人员又通过选择伪影变换,如偏置场、高斯噪声、高斯平滑、dropout、偏移、模糊等来模拟真实血管图像中存在的各种前景伪影。

在背景生成阶段,研究人员对包含不同纹理的各种背景几何形状的背景图像进行了建模,主要包括 3 种变体:球体(非重叠球体)、多面体(使用 Voronoi 将图像分割成多个多面体区域)以及不包含任何背景的几何图像。

在背景融合阶段,研究人员通过体素加减法或用掩模强度值替换背景强度值,将前景合并到背景中。为了扩大图像域,研究人员连续通过随机偏置场增强、添加高斯噪声、在 k 空间中应用随机局部峰值、随机调整图像对比度,对所有空间维度的个体或共享 σ 值执行高斯平滑、添加 Rician 噪声和 Gibbs 噪声、执行随机高斯锐化,并随机变换强度直方图,最终得到合成图像 Xdrand(如上图 b 中所示)。

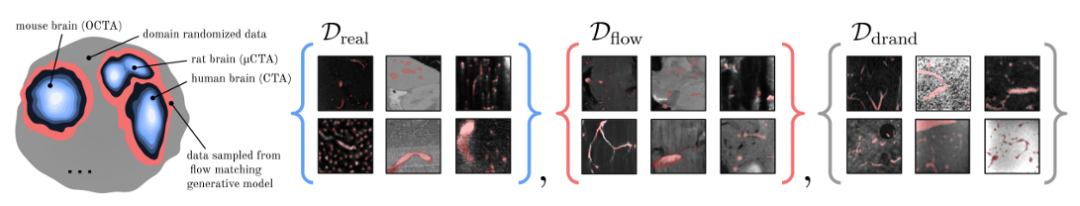
为了进一步丰富真实数据 Dreal 的分布,研究人员进一步训练并采样了一个基于 Flow Matching 的条件生成模型 F,生成了第三个数据源 Dflow。如下图所示。
图片

3 个数据源 Dreal(蓝色阴影)、Dflow (红色阴影)以及 Ddrand (灰色阴影)分布示意图

模型架构:引入深度生成模型和域随机化策略

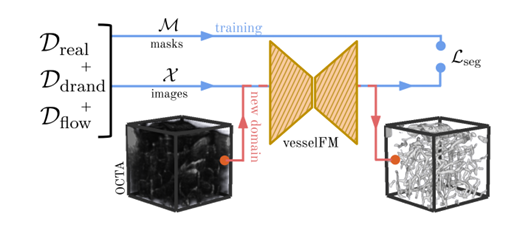
总体而言,vesselFM 是一个专门为 3D 血管分割而设计的通用基础模型,能够在各种模式和组织类型中精准分割 3D 血管系统。在模型的设计过程中,研究人员通过 3 个异构数据源对其进行训练,实现了其强大的分割能力和泛化能力。
 

图片

vesselFM 的训练及应用概览

在这一过程,研究人员引入了 2 个关键步骤,分别是深度生成模型和域随机化策略。上文数据集介绍部分详细阐述了域随机化策略,本部分着重介绍生成 Dflow 数据集所使用的深度生成模型。

深度生成模型是合成医学图像生成的重要手段,以扩散模型(Diffusion Model)为主,用于生成大量高保真合成数据。为了将这些数据进行分割任务,需要精确匹配图像-掩码对,比如 Med-DDPM、SegGuidedDiff 等方法,就是为了应对这一挑战而设计。它们通过通道级联分割掩码到模型输入来整合语义条件,从而产生符合一致解剖约束的图像掩码对。前者为 3D 脑成像合成量身定制,后者为 2D 乳腺 MRI 和腹部 CT 生成而设计。

在本研究中,研究人员采用了不同于扩散模型的方法,使用 Flow Matching 的生成模型方法。它通过学习数据从一个已知分布到目标分布的连续变换过程,从而生成新的样本,相比于扩散模型,后者在自然图像上显示出了更卓越的性能。

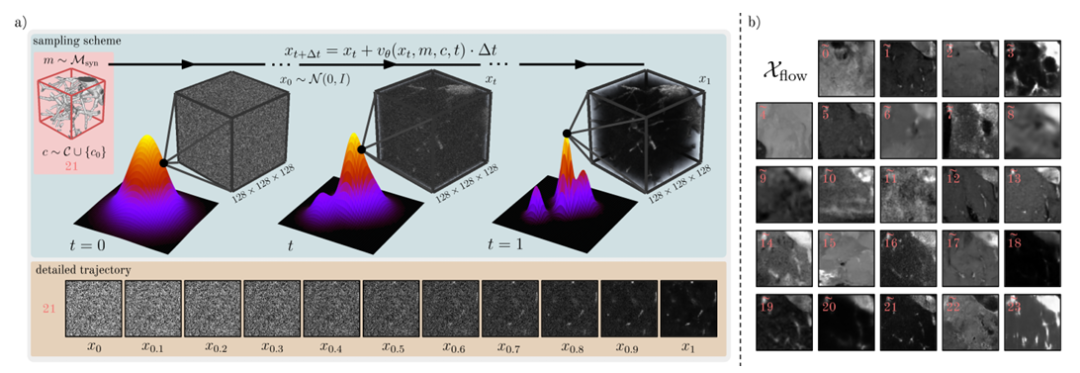
具体在研究中,生成模型 F 利用一个 θ 参数化的网络,表示一个学习与时间相关的速度场 v,然后通过常微分方程(Ordinary Differential Equation, ODE)将样本 x₀~N(0,I)映射到数据分布的样本 x₁。同时,为了训练模型 F,研究人员还优化了流匹配目标,使预测速度与采样真值速度在时间刻度上的损失最小化。

此外,训练模型 F 还采用了掩码和类别条件,通过将掩码通道与输入图像连接 xₜ 来实现掩码调理。研究人员将类嵌入加入到时间嵌入中来合并类信息,然后通过加法注入到中间特征层中。为了生成 Dflow,研究人员最终通过欧拉积分(Euler integration)对 x₁ 进行离散化,从而对大量图像 Xflow 进行采样,如下图所示。
图片

图 a 为基于 Flow Matching 的采样过程;图 b 为示例图

实验结果:性能优于当前最先进模型

为了验证 vesselFM 的有效性和可靠性,研究人员通过对比的方式进行了评估,并展示了其在零样本、单一样本以及少样本场景下的分割能力。

具体来说,验证阶段采用了 4 个临床数据集:SMILE-UHURA、MSD8、OCTA 和 BvEM。研究人员从这些评估数据集中提取形状为 128³ 的 3 个 patches,并利用其将单一样本和少样本分割任务定义为在其中一个或全部三个数据块上,以便对模型进行微调。其余数据用于测试和验证。对于零样本评估,模型将直接应用测试数据而无需预先微调。

同时将 4 款专门为 3D 血管分割而设计的基础模型作为比较对象,分别为:tUbeNet、VISTA3D、SAM-Med3D 和 MedSAM-2。

研究人员使用单卡 NVIDIA RTX A6000 GPU,从模型 F 中采样了 1 万个图像掩码,在 3 天时间内生成 Dflow。同时为了管理 Ddrand,研究人员从域随机化生成管道中抽取了 50 万个图像掩码对,每个图像掩码对的形状均为 128³。所使用的 3 个数据源权重大致根据其大小来设置,分别为 Ddrand(70%)、Dreal(20%)和 Dflow(10%)。

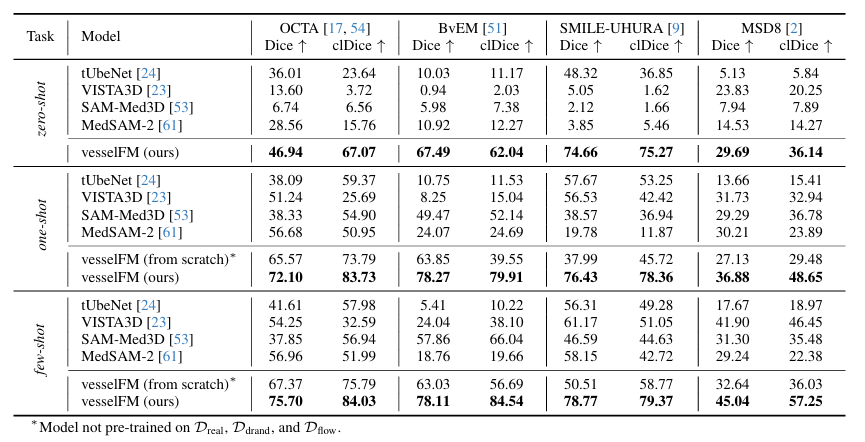
具体结果如下图所示。vesselFM 在所有 4 个数据集和任务上都展示了卓越的泛化能力和优秀性能。其中零样本任务中,在 MSD8 数据集上,vesselFM 的 Dice 得分比 VISTA3D 高出 5.86 分(VISTA3D 在 11,454 个 CT 数据上进行训练,本身包括来自 MSD8 的数据),这更加凸显了 vesselFM 强大的归纳偏置。
图片

在 4 个验证集上的对比结果

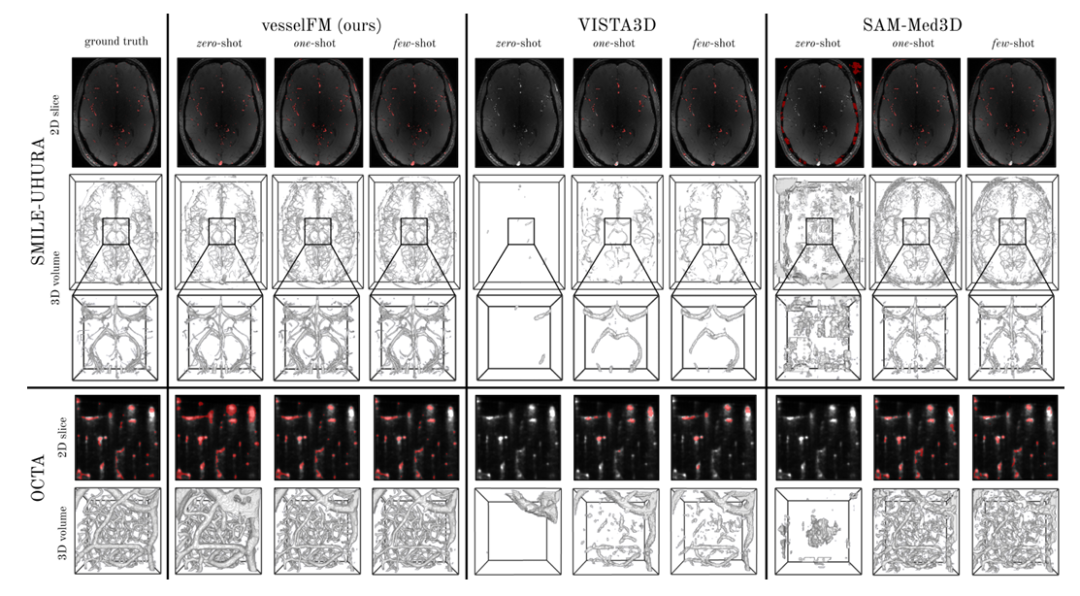
相比之下,通用 3D 血管分割模型 tUbeNet 在更复杂的成像模态中表现并不佳,另外 2 个通用分割模型 SAM-Med3D 和 MedSAM-2 在零样本设置下均无法分割血管。值得一提的是,在 SMILE-UHURA 数据集上,vesselFM 在零样本场景下的 Dice 和 clDice 得分甚至超过了基线模型在少样本场景下的得分。定性结果表明了 vesselFM 在零样本下卓越的泛化能力,且不存在注释者特定的偏差。如下图所示。
图片

部分验证集上的可视化结果

深度学习开启血管分割研究的新道路

综上而言,vesselFM 的相关研究无疑推动了 3D 血管分割研究的进步,为血管类疾病的治疗和研究提供了全新的道路,有望促进新的先进工具诞生和应用,并最终实现造福患者的目标。

而值得庆幸的是,vesselFM 并非一次孤单尝试。随着深度学习技术的发展和医疗数据的日益丰富,通过人工智能的方式处理医学图像已经是现代医疗变革的一个重要方向。越来越多的实验室和研究机构都将注意力放到了这一领域,并希望通过自己的研究来解决人类所面临的血管类疾病挑战。

比如中国科学院的团队曾发表过一篇题为「VesselSAM: Leveraging SAM for Aortic Vessel Segmentation with LoRA and Atrous Attention」的研究。研究提出了一种增强版本的 SAM,命名为 VesselSAM,专门用于主动脉血管分割。该模型集成空洞注意力模块和低秩适应(LoRA),解决了 SAM 的关键局限性,增强了其捕捉医学图像中复杂的层次特征的能力。

论文地址:

https://arxiv.org/abs/2502.18185

来自中国上海交通大学的团队联手上海第一人民医院、贝尔法斯特女王大学和路易斯安娜州立大学等团队,发表题为「Self-Supervised Vessel Segmentation via Adversarial Learning」的研究。该研究提出通过对抗学习来训练 2 个生成器,一个是注意力引导生成器,一个是分割生成器,让它们分别合成假血管、从冠状动脉血管造影图像中分割血管,从而学习血管的特征表示。该论文还入选了 CVPR 2021。

论文地址:

https://openaccess.thecvf.com/content/ICCV2021/papers/Ma_Self-Supervised_Vessel_Segmentation_via_Adversarial_Learning_ICCV_2021_paper.pdf

来自葡萄牙里斯本大学的团队联合葡萄牙天主教大学的团队同样也在血管分割方面发表了相关研究,他们提出了一种基于深度学习开发的 3D 视网膜血管网络自动分割和定量软件 3DVascNet。该软件不仅实现了对血管的精准分割,同时还可以量化血管形态测量参数,如血管密度、分支长度、血管半径和分支点密度等。更重要的是,该软件为一款免费软件,同时其强大泛化能力又进一步促进了医护人员研究三维血管网络的能力。相关研究以「3DVascNet: An Automated Software for Segmentation and Quantification of Mouse Vascular Networks in 3D」为题发表。

论文地址:

https://www.ahajournals.org/doi/10.1161/ATVBAHA.124.320672

总而言之,血管分割作为医学图像处理中一项关键而又兼具挑战性的任务,仍然有诸多难题亟待解决,但科研人员们的一次又一次尝试无疑让我们看到了这些难题正在土崩瓦解。更令人相信的是,在不久的将来,或许血管类疾病将也将会随着人工智能应用的加深,而被逐渐攻克。

Transformer-LSTM预测 | 基于Transformer-LSTM的多变量单步时间序列预测(Matlab) 阅读详情

相关推荐

MTK眼中6G物理层与无线协议的进化之路

提议统一波束和小区级的测量、报告和切换框架/流程,进一步减少移动性切换过程中的中断,采用可扩展框架/流程,允许在不同移动性场景中进行部分用户设备配置更新以实现快速切换,支持用户设备发起的移动性(同步/切换)以降低延迟和因信令交换导致的失败,设计移动性RS以实现空闲状态下的节能和连接状态下的无缝用户体验,实现5G/6G间的无缝互操作移动性,为固定无线接入(FWA)提供潜在增强,构建统一的跨层移动性框架以降低复杂度、减少中断和失败。为适应多样化的流量类型,需要灵活的帧结构和高层时间对齐。

asd199086的博客 1751

论文阅读:Deep Learning–Based Segmentation andQuantification in Experimental Kidney Histopathology

实验性肾脏组织病理学中基于深度学习的分割和量化 一.实验对象 健康小鼠、五种小鼠疾病模型和临床前研究中使用的其他物种的周期性酸-希夫染色肾组织。 分割六个主要的肾脏结构:肾小球簇、包括鲍曼囊在内的肾小球、小管、动脉、动脉腔和静脉。 量化:间质扩张、肾小管扩张和萎缩以及肾小球大小的变异性 二.数据准备 1.使用石蜡包埋的肾组织固定在福尔马林或甲基卡诺溶液中。 2.厚度为1-2mm的切片用PAS染色,并用苏木精复染。 3.使用320物镜的全玻片扫描仪NanoZoomerHT2(日本滨松光电公司)

Qingkaii的博客 471

树莓派视觉小车实战:OpenCV驱动的智能物体追踪系统

本文详细介绍了如何从零开始构建一个基于树莓派的智能视觉小车,实现物体跟踪功能。通过OpenCV进行图像处理,结合颜色与轮廓识别算法,让小车能够实时锁定并追踪特定目标。内容涵盖硬件搭建、软件环境配置、核心代码解析及运动控制逻辑,为创客和开发者提供了完整的实战指南。

weixin_29047545的博客 146

IEEE-TMI:张孝勇团队开发小鼠精细脑结构自动分割的深度学习算法

作为最重要的模式生物之一,小鼠在神经科学、肿瘤学和药学等领域发挥着不可替代的作用,是实现基础研究到临床应用转化的重要桥梁。由于小鼠和人类大脑在进化上具有保守性,小鼠大脑已被证明是理解人类大脑的重要基石之一。

u011661076的博客 1277

自定义串口通讯协议

自定义串口通讯协议的实现方法

qq_44826038的博客 2173

STM32实战:5分钟搞定MXL90614红外测温模块的I2C驱动(附完整代码)

本文提供了一份快速集成MLX90614红外测温模块的STM32实战指南。通过详细的软件I2C驱动代码,重点解析了SMBus通信协议、CRC校验及温度数据转换,帮助开发者避开常见陷阱,实现5分钟内完成模块驱动并读取准确温度值。

wasm7browser的博客 354

性能远超SAM系模型,苏黎世大学等开发通用3D血管分割基础模型,入选CVPR 2025

如果把人的身体比作一座庞大的城市,那么血管无疑就是这座城市的「道路」,动脉、静脉以及毛细血管对应着高速公路、城市道路以及乡间小道,它们相互协作,通过血液将营养物质、氧气等输送到身体各处,从而维持着这座「城市」的高效、稳定运行。更令人相信的是,在不久的将来,或许血管类疾病将也将会随着人工智能应用的加深,而被逐渐攻克。具体来说,其广泛的临床成像包括 MRA、CTA、X 光片、双光子显微镜以及 vEM 等,生物样本来自人类、实验鼠的大脑、肾脏和肝脏等,这为研究提供了不同结构和功能特性的血管模式。

数据派THU 609

【自然语言处理】【聚类】TELL:可解释神经聚类

超越分类的XAI:可解释神经聚类 《XAI Beyond Classification: Interpretable Neural Clustering》 论文地址:https://www.jmlr.org/papers/volume23/19-497/19-497.pdf 一、简介 ​ 本文研究了可解释AI(XAI\text{XAI}XAI)和数据聚类这两个挑战性问题。第一个问题是如何设计一种具有固定可解释性的神经网络,而不是给出一个黑盒模型的事后解释。第二个问题是,使用可微分神经网络来实现离散的k-me

bqw的博客 4142

从零样本到少样本:vesselFM如何重塑3D血管分割的泛化能力边界

本文探讨了vesselFM模型如何通过创新的数据策略和流匹配技术,在3D血管分割领域实现从零样本到少样本的突破。该模型在医学影像分析中展现出卓越的泛化能力,解决了传统方法面临的数据饥渴、模态依赖和域偏移敏感等问题,为临床罕见病例分析和跨机构协作提供了全新可能。

blockchain9miner的博客 1067

STM32玩转C++:从Arduino库到HAL库的封装思路(Clion环境配置指南)

本文介绍了如何在STM32开发中使用C++封装HAL库,从Arduino风格过渡到更高效的开发方式。通过Clion环境配置指南和详细的代码示例,展示了如何利用C++的面向对象特性简化GPIO、UART等外设操作,提升代码可读性和开发效率。特别适合嵌入式开发者和从Arduino转向STM32的开发者。

weixin_33737134的博客 336

置顶必读(3) |《滚雪球学SpringBoot》· 高质量专栏介绍,你值得拥有!

《滚雪球学SpringBoot》 并不是普通的技术讲解合集,它是专为开发者精心设计的系统化学习路径。通过不断“滚动学习”,我们将带领你从基础入门到高阶应用,从理解每一行代码到设计和优化大规模分布式系统,最终帮助你成长为一位精通 spring架构 的工程师。

**My Coding Family** 15万+

经纬管网三维建模系统MagicPipe3D V3.8.2发布,支持PBR材质导出

经纬管网建模系统MagicPipe3D,基于二维矢量管线管点数据本地离线参数化构建地下管网三维模型(包括管道、接头、井篦、附属设施等),输出标准3DTiles、Obj模型等格式,广泛支持Cesium、Unreal、Unity、飞渡科技等引擎加载进行三维可视化、语义查询、专题分析!详见:https://blog.youkuaiyun.com/Giser_3D/article/details/154820844?"1、支持Pbr材质,可以设置粗糙和金属系数",

专注空间智能,构建梦幻之城 191

<IBM DB2>《DB2 官方监控脚本 2022版本》

DB2 监控脚本

Else 的博客 676

【3D仿真数据集】从“能生成”到“能用”:面向工业仿真的3D资产自治自愈流水线全链路落地

AI生成的GLB、URDF、3DGS资产普遍存在原点偏移、法线反转、贴图失效、关节超限、渲染瑕疵等天然缺陷,导致“生成一百个,能用不到一半”。通过离线入库预检 + 运行时动态自愈双层防护体系,实现多格式资产(GLB/URDF/SPZ)自动化质检、缺陷修复、全链路溯源、故障沉淀、评测基准自生长,真正解决「AI生成3D不可用、仿真易崩坏、人工治理成本高」的行业痛点。缺少一套覆盖多资产格式、事前+事后双层防护、可自治巡检、可自愈修复、可沉淀评测基准的完整3D生产流水线。

weixin_67195547的博客 643

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

Cesium 建筑单体化、3DTiles 分类、楼层显隐、分户高亮(BIM + 倾斜孪生高频)

拿到 batchId,读取 BatchTable 里面的名称、面积、户主、房间用途,弹出信息面板,孪生项目标配。Revit 导出 3DTiles 常用工具:FME、CesiumLab、ifc2tiles;扩展业务:做多层勾选(多选楼层),shader 里面用。,否则 BatchTable 为空,前端无法筛选。很多人单体化失败就是字段名大小写不匹配。直接丢弃不在目标楼层的片元;

On the way 237

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

虚拟仿真实训基地的技术实现路径:从3D采集、资源库到仿真平台的完整链路

本文提出“五段式”虚拟仿真实训链路——采集、建模、资源、平台、展示,破解职业教育实训资源持续产出难题。通过设备选型、AI建模、统一管理与过程留痕,实现教学资源标准化、可复用、可更新。强调元数据规范、轻量化处理与验收指标,避免“只采不建”“仿真脱节”等五大工程陷阱,确保基地长效运行,支撑岗位技能对接与教学改革。

Jmyd0123的博客 376

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

单细胞免疫组库分析3:从 scBCR-seq 序列到 3D 结构-IgFold 与 PyMOL 全流程深度解析

本文手把手教程基于scBCR-seq数据,利用IgFold预测抗体Fv区三维结构,并结合PyMOL完成从序列着色、CDR注释到氢键网络可视化与SCI级高颜值出图的全流程。重点解决Windows下IgFold安装难题,通过Annotate_v插件精准标注互补决定区,借助界面分析与半透明表面渲染,实现抗体-抗原结合位点的精细解析,助力免疫学研究与高水平论文发表。

三兔测序学社的博客 323

AI生成的3D场景只想改一处,用重新生成、自然语言编辑还是DCC手修?按5类改动选

AI 生成的 3D 场景出现问题后,该重新生成、用自然语言编辑,还是进入 Blender 手修?本文从错误范围、精度要求、依赖关系、回退能力和目标端验收五个角度判断,针对整体体量、局部造型、重复部件、拓扑与 UV、绑定与制造结构给出选择矩阵,并用三轮小样验证方法,帮助创作者控制返工成本。

Solange__的博客 502

陕西园区 IBMS集成 3D 数字孪生平台DDC楼宇自控:和 IBMS 有什么区别

交通枢纽是最考验“空间感”的建筑:航站楼、换乘通道、行李系统、机房、管廊,动辄几十万平方米,设备藏在吊顶里、竖井里、夹层里。映射关系是核心工作:每一个点位要绑定到模型里的对应设备或空间,比如“三层东区 AHU-3-2 送风温度”要落到那台机组的三维位置上。培训价值:新员工在模型里熟悉设备位置与系统关系,比翻图纸、跑现场快得多,尤其适合人员流动大的物业。模型与台账同步:设备更换后模型与档案一起更新,否则三维画面会逐渐“失真”,一年之后没人敢信它。可分期建模:先做重点区域与关键系统,再逐步补全,不必一次做完。

y_a_c_h_u_a_n的博客 195

3D建筑导出后总绕错位置旋转?用5步检查原点、放置锚点与交付范围

3D 建筑导出后绕错位置旋转、放置偏移或缩放离地,未必只是原点设置错误。本文区分对象原点、操作枢轴与放置锚点,通过冻结交付范围、检查锚点、追踪父级变换、执行三类操作测试,以及源软件、空场景回读和目标端核对,定位首次出现差异的环节,并提供最小交付记录表,避免用拖动补偿掩盖坐标问题。

Martina_0321的博客 356

AI建筑白模交给客户、设计师和开发者,网页链接、GLB还是DCC源文件怎么选?

AI 建筑白模交给客户、设计师和开发者,不宜只发同一种交付物。本文按接收任务区分网页评审副本、GLB 等轻量交换文件和 DCC 源工程,分别说明版本定位、单位轴向、对象映射、材质依赖与编辑上下文的验收方法,并介绍如何从同一审核母版派生成果,避免多版本失配。附交付对照表与检查清单,明确 “能查看”“能集成”“能继续编辑” 的区别,以及白模不能替代正式工程资料的边界。

Solange__的博客 311

百炼 CLI 生成物流主题 3D 视觉概念图教程:一个关键词出主视角/鸟瞰/特写/风格变体一套图,含默认开关与水印坑实测

做物流投标配图、方案配图的人经常遇到同一个需求:手里只有一个关键词,交付物却是一整套 3D 视觉概念图。本文以「无人仓储中心」为例,用百炼命令行的两条命令搭一条两段式生图链路,一个关键词产出主视角、鸟瞰、设备特写与风格变体成套图,并把四条可选路线的等待时间、画面文字注入情况和成套一致性一次测完,给出可直接抄的接法与参数。

weixin_43540568的博客 112

机器视觉 3D 相机与机器人引导全解析:四大成像原理、手眼标定与七步落地流程

3D 视觉的精度上限,80% 取决于。

2501_94699871的博客 229

项目选型 3D 相机推荐:光学体制匹配与视锥核算实战指南

项目选型 3D 相机推荐的第一决策变量不是分辨率或标称精度,而是。工程实测表明,抛光金属件评估 450nm 蓝光激光振镜体制,利用窄带滤波从物理层切除镜面反射过曝;深筐大件则必须按“最远工作距离下的 Z 向重复精度”反向倒推视锥覆盖,而非先选相机再看视野是否“差不多够用”。光学体制选错导致的点云缺失,后续任何算法都无法补全。

加搜科技观察 378

OpenViking 上线原生 3D 内容理解模型

OpenViking 作为业内首个理解三维世界的 Agent 上下文数据库产品,后续将陆续支持dxf、iges、sldprt、sldasm 等更多格式的导入与理解。现在接入,后续上线无需额外操作,即刻使用。🚀上手试用,前 50 文档免费🌟 开源 OpenViking:访问GitHub 仓库,为我们点亮一颗 Star!❓三分钟测出你是哪种 Agent 饲养员选择属于你的 OpenViking。

bytedanceospo的博客 227

考古遗址怎么用AI生成3D分期复原?从证据台账、构件白模到网页时间轴

考古遗址的复原画面完整,不代表历史证据完整。本文介绍从资料授权、证据台账、现状白模到分期方案和网页时间轴的工作流程,区分现存事实、学术推断、教学简化与艺术想象,说明如何用稳定构件 ID 和版本映射避免阶段错绑,并提供三轮审核与上线清单,让 AI 辅助生成的候选可追溯、不确定性可辨识。

Solange__的博客 537
上一篇: 【TVM 教程】使用 TVMC Micro 执行微模型
下一篇: 【Triton 教程】triton.heuristics
HyperAI超神经
博客等级 码龄7年 8873粉丝 1753原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值