TMI 2025 | 通过细粒度差分学习桥接MRI跨模态合成和多对比度超分辨率

[TMI 2025] DSCA: A Digital Subtraction Angiography Sequence Dataset and Spatio-Temporal Model for Ce DSA动态序列能清晰显示脑血管血流,但单帧分割易受低对比度血管和颅骨残留干扰。本文构建DSCA数据集,并提出DSANet模型:通过TEB捕捉多帧动态信息,SEB提取MinIP图像的空间特征,结合TemporalFormer与STF模块融合时空特征。实验表明,DSANet Dice达0.9033,优于20+基线模型,显著抑制误分割。 阅读详情

Bridging MRI Cross-Modality Synthesis and Multi-Contrast Super-Resolution by Fine-Grained Difference Learning

10.1109/TMI.2024.3445969

这篇文章主要围绕多模态磁共振成像(MRI)中目标模态的推算或重建问题展开,核心内容总结如下:

问题背景:

在多模态 MRI 中,推算或重建目标模态的任务面临着精确建模细粒度模态间差异的挑战。这些差异源于粗配准后残留的空间不对齐,以及模态特定信号表现产生的结构差异。同时,难以同时获取多种模态的高分辨率 MRI 图像,一些难以获取的模态常以低分辨率采集甚至不采集,为此出现了跨模态合成(CMS)和多对比度超分辨率(MCSR)任务,目标是在同一坐标系下逼近高分辨率目标模态图像。

现有方法不足:

CMS 方法主要利用条件生成模型,但基于 Pix2Pix 的方法对空间不对齐更敏感,基于 CycleGAN 的方法在准确性上稍逊一筹;MCSR 方法之前多为纯重建方法,近期引入生成方法但缺乏细粒度调节机制,且现有方法很少提及模态特定结构问题,对于这些独特结构的恢复存在消失或过度模糊问题,传统方法虽引入结构差异概念但计算成本高且恢复精度不足。

解决方法:

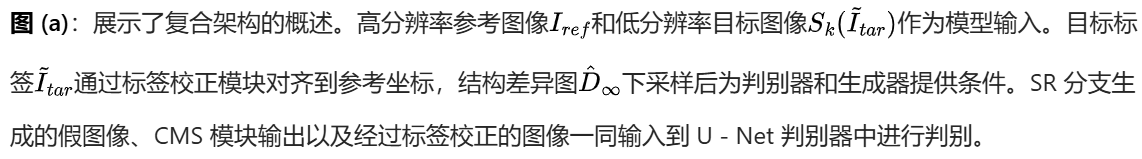
将 CMS 和 MCSR 的研究轨迹整合在统一框架中,通过广义下采样比率连接,提出复合网络架构,包括标签校正模块(对齐多模态训练对的坐标)、CMS 模块(作为基础模型)、SR 分支(处理目标输入)和差异投影鉴别器(用于以结构差异为中心的对抗训练)。在训练 SR 分支作为生成器时,通过差异感知增量调制增强对抗学习,且 SR 分支集成可变形卷积以在特征级别解决跨模态空间不对齐问题。

引言:

与单模态SR相比,引入另一种模态的关键问题是模态间关系建模。

最近,基于生成先验 [22] 和扩散模型 [23] 的生成方法被引入到多对比度超分辨率(MCSR)领域中。然而,这些方法缺少一种细粒度的调节机制,无法在精确的结构恢复和视觉真实性之间取得平衡。

详细解释

基于生成先验和扩散模型的生成方法:在 MCSR 任务中,这些是比较新引入的技术手段。生成先验是指模型依据已有的知识或模式,预先设定一些生成数据的规则或条件;扩散模型则是通过逐渐添加噪声再去噪的过程来生成数据。在 MCSR 里,它们的目的是将低分辨率、高度退化的目标模态图像超分辨率处理成高分辨率图像。例如,在处理医学的多模态磁共振图像时,利用这些方法尝试从低分辨率的图像中恢复出高分辨率的图像,以更好地显示解剖结构。

缺乏细粒度调节机制:细粒度调节机制类似于精准的 “调节器”,可以对生成过程中的各种细节进行精细的控制。但这些新引入的方法缺少这样的机制。例如在绘制一幅精细的建筑图纸时,没有精准的工具来微调线条的粗细、角度,以及各个建筑结构之间的比例关系。

精确的结构恢复和视觉真实性难以平衡:精确的结构恢复是指生成的高分辨率图像能够准确呈现出原始图像中物体或结构的形状、位置和相互关系;视觉真实性则是指生成的图像在视觉上看起来自然、逼真,符合人眼的视觉习惯。由于缺乏细粒度调节机制,这些方法在生成图像时,要么过于注重结构的准确性,导致图像看起来生硬、不自然,像一幅只注重几何形状的草图;要么过于追求视觉上的自然,却牺牲了结构的精确性,使得图像中的物体结构出现偏差,比如超分辨率后的医学图像中器官的形状和位置不准确,影响诊断。
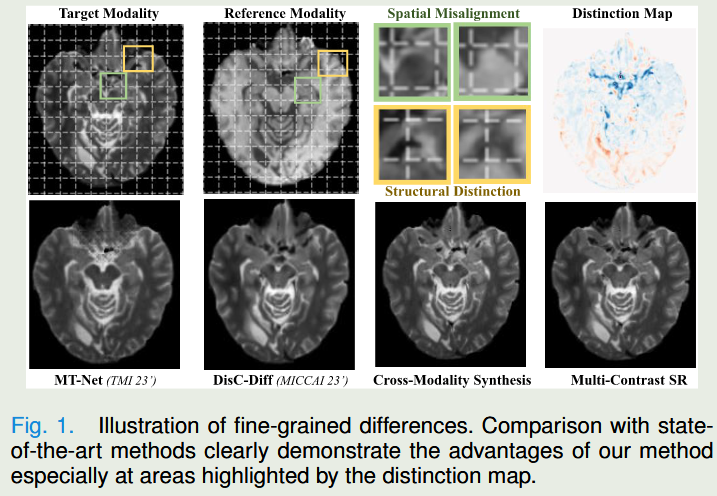
图1。细粒度差异的说明。与最先进的方法进行比较,可以清楚地证明我们的方法的优势,特别是在区分图突出显示的区域。
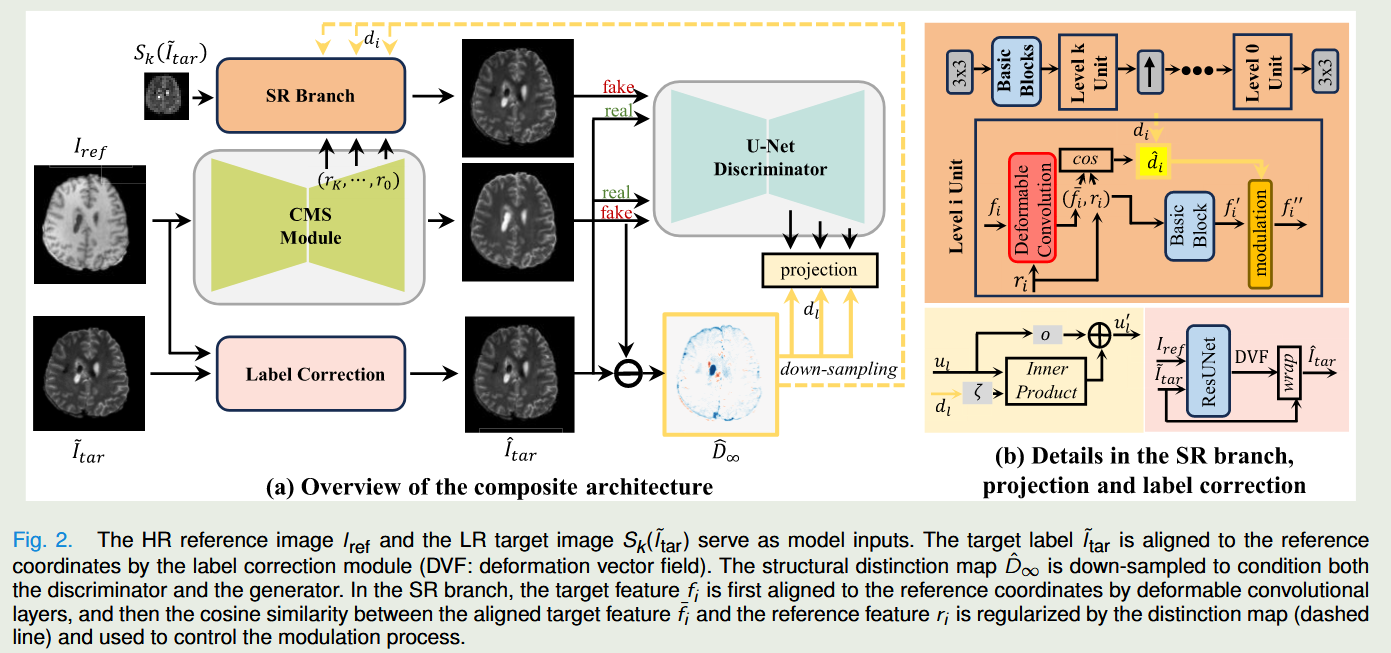
研究方法总结

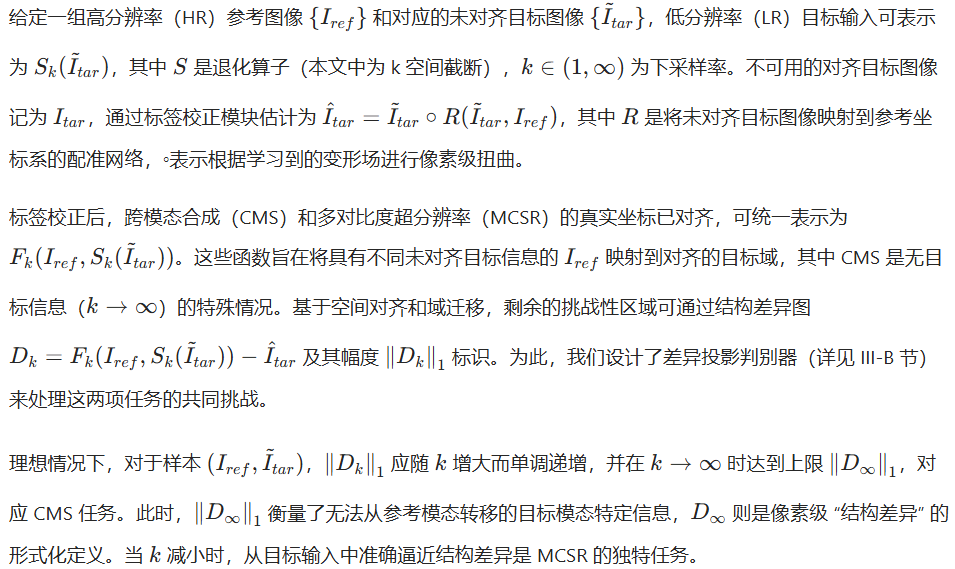
数据处理与任务统一:对高分辨率参考图像和未对齐低分辨率目标图像进行处理,通过标签校正模块将两者坐标对齐,统一描述 CMS 和 MCSR 任务,利用结构差异图衡量任务中的挑战区域。

网络架构构建:建立基础网络估计结构差异图,在此基础上发展 SR 分支。SR 分支利用可变形卷积处理目标图像与参考图像的空间不对齐问题,通过正则化跨模态特征相关性表征结构差异,并采用增量调制方案引导独特结构的生成。

差异投影判别器:结合投影机制和 U 形判别器架构,使用结构差异图D进行多尺度投影,应用相对论 GAN 损失,在 cGAN 框架内更新判别器,分两阶段训练模型,先更新 CMS 模块,再固定更新 SR 分支,以有效表征多级别细粒度数据分布,尤其是独特区域的数据分布。

方法

A. 问题表述与整体架构
B. 差异投影判别器

结构差异图突出了输入条件不足的目标区域,恢复这些结构是 CMS 和 MCSR 的主要挑战。现有 MCSR 方法多基于判别网络,确保公共结构的准确性但模糊独特结构;CMS 方法则依赖生成模型,擅长合成符合目标分布的细节但不确定性较高。本文结合两者优势,在条件生成对抗网络(cGAN)框架内引入精细化生成技术,通过差异投影机制为判别器提供条件。

受投影判别器启发,本文设计差异投影判别器,结合多尺度结构差异图进行高维像素级投影。判别器包含 L 级编码器 \(U_{enc}\) 和解码器 \(U_{dec}\),采用相对论 GAN 损失(Relativistic GAN loss)提升稳定性和真实感。解码器处理 \(F_{k}(I_{ref}, S_{k}{I}_{tar}))\) 与 \(\hat{I}_{tar}\) 的多级判别,利用下采样的差异图 \(d_{l}\) 更新解码器输出,强化对差异区域的关注。

两阶段训练中,首先更新 CMS 模块、标签校正模块和差异投影判别器,利用 \(L_{1}\) 损失、多尺度 SSIM 损失和相对论 GAN 损失约束重建结果与对齐目标的一致性;第二阶段固定 CMS 模块,通过特征正则化损失 \(L_{D}\) 更新 SR 分支。差异投影判别器在两阶段中持续优化,有效刻画多尺度细粒度数据分布,确保生成过程的忠实性和真实感。

C. SR 分支的差异学习

  1. 特征级对齐的可变形卷积 现有方法通过额外配准网络扭曲参考图像至目标坐标,导致病态问题和高计算成本。本文在 SR 分支的基础处理单元中引入可变形卷积,根据学习到的偏移量动态调整标准卷积的采样位置,实现多尺度特征级对齐。给定多尺度参考特征 r_{i},目标特征 f_{i} 在输入融合块前通过可变形卷积层进行扭曲,其中偏移量 Delta p_{j} 由多模态特征f_{i}, r_{i} 预测。

可变形卷积通过 \(n^2\) 个独立空间变形结合 3D 卷积,在端到端框架内实现灵活多样的多级对齐,避免了单变形场估计的局限性,有效处理输入间的空间错位。

  1. 结构差异的表征 直接预测差异图会引入额外参数且训练困难,本文提出通过多尺度跨模态特征的相关性逐步建模差异图。在 SR 分支中,LR 输入经 k 级处理单元,目标特征 f_{i} 先对齐至参考特征 r_{i} 得到 {f}_{i},然后对每对特征图{f}_{i}, r_{i}\}\),利用下采样的差异图 d_{i}最小化特征正则化损失 L_{D},通过余弦相似性预测像素级差异,鼓励目标分支挖掘 CMS 模块忽略的信息,强化差异区域的强度变化方向约束。
  2. 细粒度增量调制 特征调制通过学习仿射变换实现条件特征去归一化,本文提出从差异图学习空间可变的增量,叠加到原始仿射参数以微调残差细节。在 SR 分支中,对经过实例归一化的特征 (f_{i},通过 Delta \sigma 和 Delta \mu 调整其均值和标准差,其中 Delta sigma和 Delta \mu 由卷积层从近似差异图预测。该调制方案确保 SR 分支作为生成器时,能条件化地增量生成差异结构,平衡结构忠实性和视觉真实感。

实验细节

  1. 数据集
    • BraTSReg:脑胶质瘤患者多模态 MRI 数据,包含 T1w 和 T2w 模态,280 例样本。
    • IXI:健康人脑部 MRI 数据,T1w 和 T2w 模态,577 例样本。
    • FastMRI:膝关节 PDw 和 FS-PDw 模态数据,1054 例样本。
    • 任务:以 T1w/PDw 为参考模态,T2w/FS-PDw 为目标模态,分别进行跨模态合成(CMS)和多对比度超分辨率(MCSR)。
  2. 数据准备
    • 通过 k 空间截断生成低分辨率(LR)目标图像
  1. 实验结果

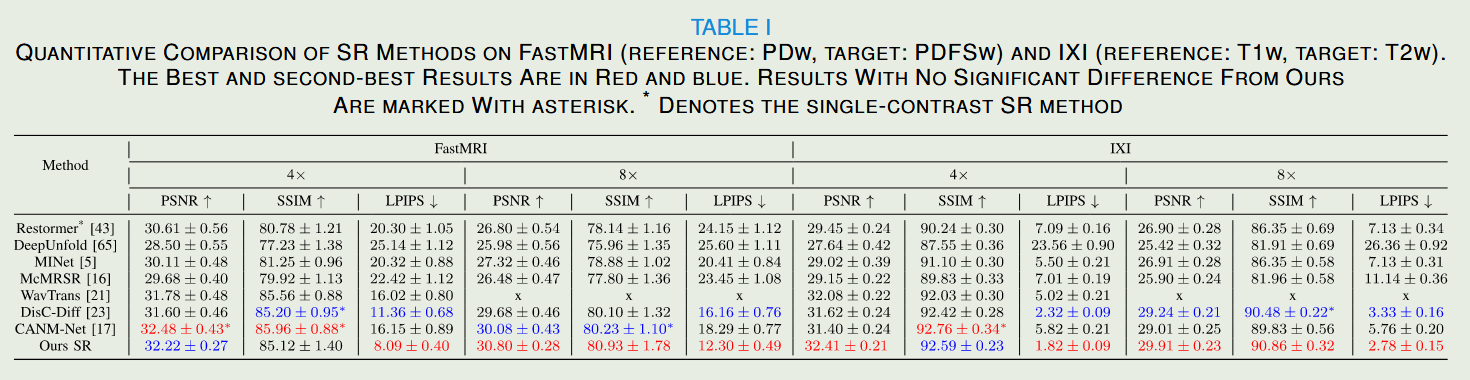
MCSR 在 FastMRI 和 IXI 数据集的 PSNR/SSIM/LPIPS 结果,CMS 在 FastMRI 和 IXI 数据集的 PSNR/SSIM/LPIPS 结果(表一,表二)

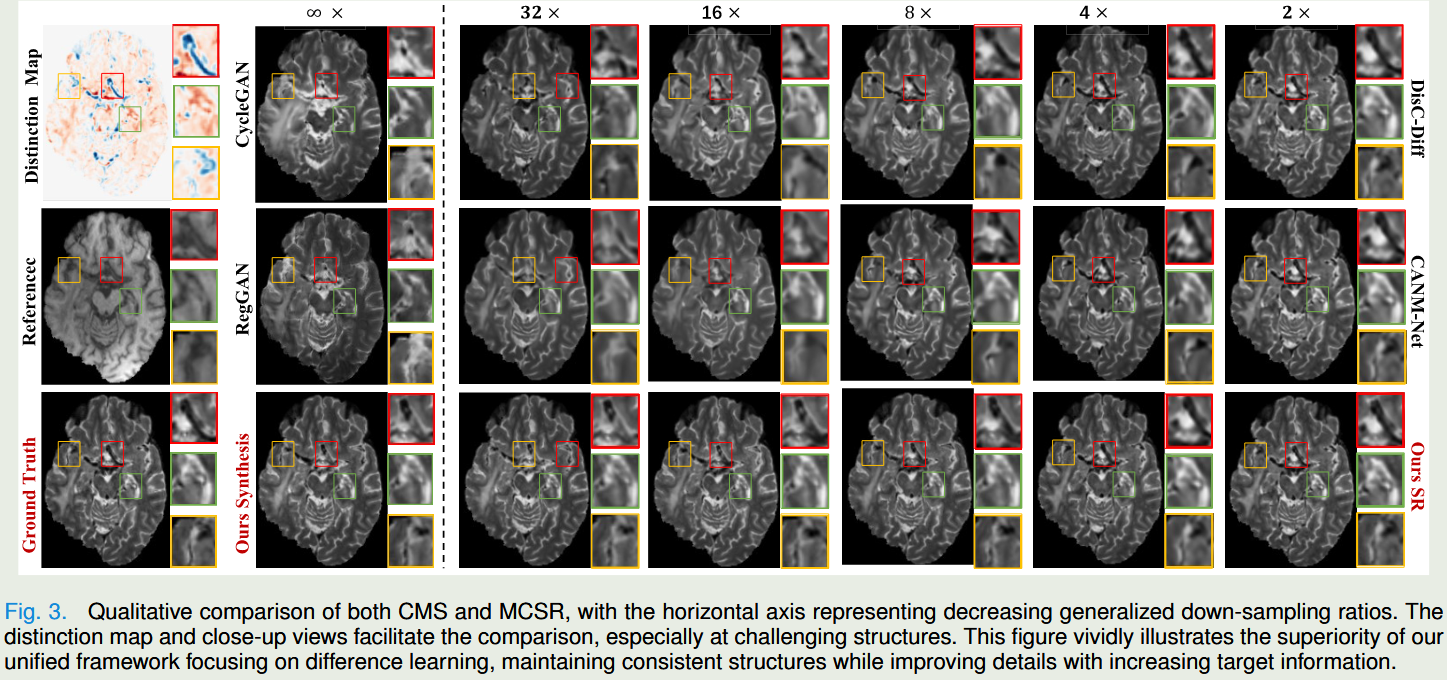
不同方法在结构差异区域的视觉效果对比(含差异图放大)
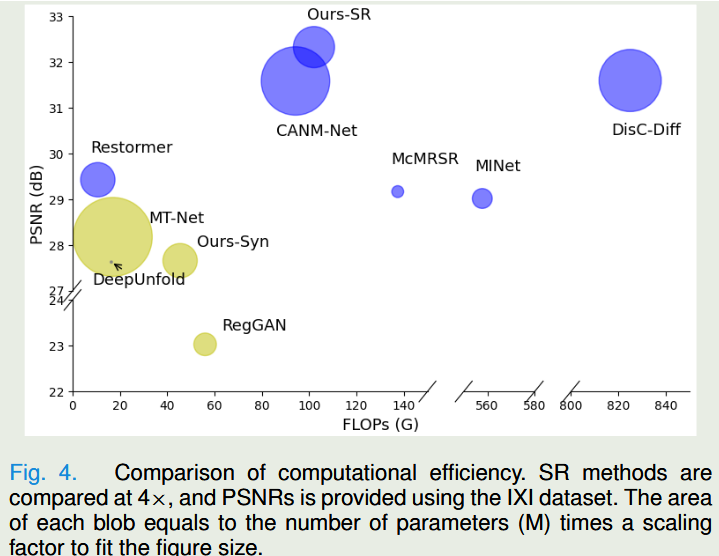
参数量(M)和计算量(FLOPs)对比,本文方法更轻量
 

不同下采样率(2× 至 32×)的性能曲线,本文方法稳定性最优
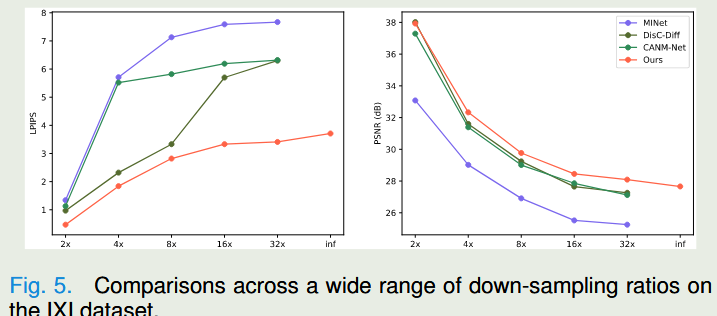
 表I显示了4×和8×中间下采样率下的定量比较结果。与所有其他方法相比,我们的方法和DisC-Diff这两种生成方法在视觉质量(LPIPS)方面始终表现出优越的结果,同时在PSNR和SSIM方面仍保持可比的性能。如图5所示,我们还将我们的方法与主要竞争对手MINet、DisC-Diff和CANM-Net在IXI数据集上的各种下采样率下进行了比较。各种方法之间的性能差距最小,为2×。然而,随着下采样率的增加,我们的方法的性能曲线平滑地接近界限(CMS),逐渐扩大了与其他方法的差距。我们的方法的独特特征可以在图3中更清楚地观察到。在一个统一的框架内,我们的方法捕获了底部独特结构的形状和位置,其中下采样率接近无穷大。随着目标信息的增加,我们的方法在恢复结构差异方面逐渐取得了更准确的结果,而其他方法则受到这些关键信号失真或丢失的影响,在不同的下采样率下显示出不确定的模式。

【核磁共振成像】部分傅里叶重建 本文为《核磁共振成像》的部分傅里叶重建部分,主要讲解部分傅里叶重建和部分傅里叶重建算法 阅读详情

相关推荐

【医学顶刊TMI 2025】Mamba-Sea:一种基于 Mamba 的框架,结合全局到局部序列增强的可推广医学图像分割方法

背景:医疗图像分割在存在分布差异(domain shift)时面临挑战。问题:现有DG方法多基于CNN或ViT,存在局限。方法:提出Mamba-Sea,引入。亮点GVA:全局模拟外观变化LSA:局部连续子序列风格扰动成果:首次在Prostate数据集Dice超过90%,刷新SOTA。模块作用目标(a) GVA整体外观增强模拟不同医院采集条件(b) 语义一致性训练保持增强前后输出一致抗扰动泛化© VSSDG改良版SSM模块融合局部增强(d) LSA局部子序列风格扰动。

吾在学习路的博客 2251

ICCV 2023 超分辨率(super-resolution)方向上接收论文总结

SISR 领域中,接收的文章大部分都基于Transformer结构,展现出蹭热点的重要性。接收文章中提出了多个新数据集,集中在某些特殊场景(如burst,Scene text,Reference-Based等),有利于SR领域的进一步发展,也挖下了坑。轻量化超分文章比例大,展现出更偏实用化的研究趋势,在医学和高光谱等领域也涌现了相关研究。

yyywxk的博客 3671

IXI数据集 3d切片——适用所有医学3d图像切片

将多模态医学3d图像转成2d

qq_41174671的博客 2927

ICCV 2023 超分辨率(Super-Resolution)论文汇总

1. McASSR | Rethinking Multi-Contrast MRI Super-Resolution: Rectangle-Window Cross-Attention Transformer and Arbitrary-Scale Upsampling(浙大)1. LMR: A Large-Scale Multi-Reference Dataset for Reference-Based Super-Resolution(自动化所 张兆翔团队,百度)

不要给自己设限,尝试更多可能(思所向 皆可往) 5177

多任务学习之MRI重建(Reconstruction)与超分辨率(Super-Resolution)论文阅读

多任务学习论文阅读Task Transformer Network for Joint MRI Reconstruction and Super-Resolution

道阻且长 6877

MRI工具包

[更新 ] 此版本的新功能: 将代码重新组织为两个主要类别:MRTQuant(预处理/ DTI / DKI)和MRTrack(与术式相关) 支持自动光纤群集(请参阅下面的参考资料) 早期支持与Python集成(需要以上几点) 支持VTK多边形数据4.2和5.1(集群也需要) 为GRL / mFOD反卷积添加了可靠的选项 最初支持存储NIFTI Q / S表单(以提高与尚未使用的其他工具的互操作性) 与CAT12集成 它是什么? MRIToolkit是一组和一个MATLAB(R)工具箱/库,用于处理(扩散)磁共振成像(MRI)数据。 即将提供命令行版本的二进制文件! MRIToolkit的想法是将与现有的(扩散)MRI处理的最新方法相结合。 我在哪里找到它? 在MATLAB(R)工具箱可Github上! 编译后的即将上载! 探索主要功能: 首次引用了该工具箱 。 此

医学顶刊TMI 2024!首个研究医疗AI算法公平性的眼科图像分类数据集

点击下方卡片,关注“CVer”公众号AI/CV重磅干货,第一时间送达点击进入—>【Mamba和医学影像】微信交流群添加微信:CVer5555,小助手会拉你进群!扫描下方二维码,加入CVer学术星球!可以获得最新顶会/顶刊上的论文idea和CV从入门到精通资料,及最前沿应用!发论文/搞科研/涨薪,强烈推荐!在这里和大家分享一波我们TMI 2024中稿的工作 “Harvard Glaucoma ...

阿木寺的博客 1082

机械臂控制的基础知识

在现代工业中,机械臂的自动化控制已经成为智能制造的重要一环。控制机械臂涉及多个学科,包括机械设计、运动学、控制理论和编程等。本文将从以下几个方面介绍机械臂控制的核心知识点:机械臂的构成、运动学分析、动力学建模、控制方法及编程实现。

qq_45728381的博客 5470

智慧医疗领域TMI期刊2025年3月研究热点解析

本推文对2025年3月《IEEE Transactions on Medical Imaging》期刊论文的研究热点进行了深入分析,希望能为智慧医疗及相关领域的研究人员提供有价值的参考。

audyxiao001的博客 3368

GitLab中国区注册终极解决方案:绕过+86手机验证的实战技巧(2023最新)

本文详细解析了GitLab中国区注册时绕过+86手机验证的三种实战技巧,包括开发者工具调试方案、使用国际号码的变通方案以及本地化部署替代方案。通过技术分析和实践验证,帮助开发者顺利注册GitLab账号,提升团队协作效率。

rl6adventurer的博客 1499

从ADRV9002到ADRV9003:手把手教你移植FPGA驱动,避开那些官方没说的坑

本文详细介绍了从ADRV9002到ADRV9003的FPGA驱动移植实战指南,重点解析了两者在硬件架构上的关键差异,如通道配置和DPD功能的移除。通过提供完整的移植步骤、调试技巧和性能优化建议,帮助工程师避开官方文档未提及的常见陷阱,实现高效驱动开发。

weixin_28738397的博客 177

TMI 2025 | 最新医疗图像分割模型:Zig-RiR,精准分割二维、三维医疗图像

在二维ISIC数据集和三维ACDC, Synapse数据集上,Zig-RiR都表现出极高的分割性能,表明它在提取目标的边界和区域时非常准确。Zig-RiR模型通过创新的嵌套结构和锯齿状扫描设计,成功实现了对二维、三维医疗图像的高效率且精准的分割,为该领域提供了先进的解决方案。,提出一种新颖的医疗图像分割模型 Zigzag RWKV-in-RWKV (Zig-RiR),可用于精准分割二维、三维的医疗图像。Transformer的自注意力机制导致二次方级别的计算复杂度,限制了模型在高分辨率图像上的应用。

我爱计算机视觉 2287

海康门禁二次开发实战:用Java实现员工考勤系统的人脸权限管理

本文详细介绍了如何利用Java技术栈进行海康威视门禁系统的二次开发,实现员工考勤系统的人脸权限管理。从开发环境准备、SDK集成到设备连接、人脸数据批量处理,再到权限管理与异常处理,全面解析了海康门禁对接开发的关键步骤和最佳实践,助力企业构建高效、安全的智能考勤系统。

weixin_29191669的博客 262

2024-04-22-医学图像IXI数据集处理

摘自:2023-CIBM-Multi-Stage Hybrid Attention Network for MRI reconstruction and SR。

qq_40723205的博客 1392

SVG文件上传漏洞实战:从XSS攻击到防御策略

本文深入剖析了SVG文件上传漏洞的成因与危害,揭示了攻击者如何利用SVG的XML本质构造恶意文件,绕过常规检查实现存储型XSS攻击。文章通过实战复现演示了完整的攻击链,并提供了从严格内容检查、安全解析过滤到设置CSP策略等多层次的纵深防御方案,帮助开发者从根本上加固文件上传功能。

weixin_29230805的博客 395

USB设备识别码VID和PID详解:如何查询和自定义你的设备ID

本文详细解析了USB设备识别码VID和PID的核心作用、查询方法及自定义配置技巧。VID(供应商识别码)和PID(产品识别码)是USB设备的唯一身份证,用于驱动匹配和功能识别。文章提供了Windows和Linux系统下的查询方法,并探讨了如何合法获取和自定义VID/PID,适合硬件开发者和DIY爱好者参考。

weixin_29168675的博客 1468

【免费下载】 brainreg:强大的脑部图像配准工具

`brainreg` 是一个用于脑部图像配准的开源工具,旨在将模板脑(如来自 [Allen Reference Atlas](https://mouse.brain-map.org/static/atlas))与样本图像进行配准。通过这一过程,任何其他在模板空间中的图像(如区域注释)都可以与样本图像对齐。此外,模板到样本的变换也可以被反转,从而允许样本图像在通用坐标空间中对齐。`brainreg`

gitblog_00192的博客 1243

ESP32-IDF开发之旅 网络篇⑩ Web配网

本文介绍了基于ESP32S3的Web配网实现方案。作者通过移植开源项目,在ESP32S3上实现了WiFi配置功能,包括AP模式创建、HTTP服务器搭建、NVS存储读写等核心功能。文章详细解析了代码结构,包含WiFi初始化、事件处理、NVS存储管理和HTML页面服务等关键模块。实现方案采用AP+STA双模式,支持通过网页扫描WiFi并保存配置信息,适用于物联网设备的网络配置场景。代码中使用了FreeRTOS任务、ESP-IDF事件组等技术,并提供了完整的错误处理和日志记录功能。

单片机菜鸟哥的博客 351

MRI成像中的K空间:为什么它决定了你的图像质量?

本文深入解析了MRI成像中K空间的核心原理及其对图像质量的决定性作用。K空间作为原始信号的数学空间,其中心区域决定图像对比度,外围区域决定分辨率。通过理解其对称性、填充顺序与轨迹,技师可以优化扫描协议、抑制伪影并应用并行采集等加速技术,从而主动提升诊断图像质量。

weixin_29304985的博客 377

无监督学习与互信息

在机器学习中,获取大量高质量标注数据成本高昂。为解决此问题,无监督学习利用丰富的无标注数据成为研究重点。其中,互信息是衡量两个随机变量之间依赖关系的关键指标,能够捕捉非线性统计关联,非常适合处理非结构化数据。通过最大化神经网络中变量间的互信息,可以有效地从无标注数据中提取有用信息,提升模型在下游任务(如分类)的性能。互信息与熵密切相关,其值等于联合分布与边缘分布乘积间的KL散度,也可通过熵与条件熵的差值得出,具有对称性,并反映了已知一个变量后另一个变量不确定性的减少。

盼小辉丶的博客 3556

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

医学图像常用数据集介绍

是一个由伦敦大学学院(University College London, UCL)和其他合作机构收集的医学影像数据集,主要用于脑部MRI图像的研究。这个数据集包含多个模态的MRI扫描(如T1加权、T2加权、FLAIR等),并且包含了健康的成年人以及一些老年人群体。IXI数据集广泛应用于脑部结构和功能成像、图像配准、分割、分析等方面的研究。:主要包含T1加权MRI图像,部分数据集也包含了其他模态,如PET图像。:主要用于脑部图像分析,特别是在老年痴呆症、阿尔茨海默病的研究中。

m0_67878192的博客 2174

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

DFT计算基本要素(2)-截断能、赝势

赝势的基本介绍

weixin_46465199的博客 5682

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

BraTS数据集处理详解(附代码详解)

目录数据集详解功能快捷键合理的创建标题,有助于目录的生成如何改变文本的样式插入链接与图片如何插入一段漂亮的代码片生成一个适合你的列表创建一个表格设定内容居中、居左、居右SmartyPants创建一个自定义列表如何创建一个注脚注释也是必不可少的KaTeX数学公式新的甘特图功能,丰富你的文章UML 图表FLowchart流程图导出与导入导出导入 数据集详解 BraTS 数据集是脑肿瘤分割比赛数据集,brats 2018中的训练集( training set) 有285个病例,每个病例有四个模态(t1、t2、f

weixin_43953722的博客 3万+

增量学习的理解(迁移学习,fit_genrtor区别)

近日看到了有关增量学习的理解,一开始以为增量学习就是Keras中的fit_genetor,相当于分批次进行学习,防止数据量太大造成内存崩溃而无法学习,并且增量学习可以结合pandas中每次读取一定数目的数据的功能来进行传统机器学习(SVM,lightgbm等)和神经网络的学习。 后来了解到增量学习分为三种:增量学习可以分为3类:样本增量学习(SIL),类别增量学习(CIL),特征增量学习(F...

herr_kun的博客 6423

深度学习之细粒度分类

细粒度分类-实现局部特征细微差异识别

egowell的博客 4363

使用Voxelmorph配准IXI:数据预处理之颅骨去除及仿射对齐

本文是在原链接https://blog.youkuaiyun.com/qq_38302885/article/details/94045126 的基础上,增加的一些补充,对新入门的同学可能有一些启发。 关于freesurfer的具体安装和使用,可以参考 https://blog.youkuaiyun.com/uinglin/article/details/79541063 使用Freesurfer进行头骨去除和仿射对齐 ...

u014776464的博客 6302
上一篇: 盲超分-双循环对比学习退化网络(蒸馏)
下一篇: (ICCV) 2023 矩形窗口交叉注意力变换器和任意尺度上采样
开心市民小麦
博客等级 码龄6年 293粉丝 30原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值