pandas技能总结

csdn最新出炉的Python内容---用Python的pandas读取excel文件中的数据 目录 一、前言 二、读取Excel文件 三、DataFrame对象的结构 四、用values方式获取数据 五、用loc和iloc方式获取数据 一、前言 hello呀!各位铁子们大家好呀,我叫凃九一个在软件测试行业摸爬滚打十几年的老江湖了,今天呢来和大家聊一聊用Python的pandas读取excel文件中的数据。 二、读取Excel文件 使用pandas的read_excel()方法,可通过文件路径直接读取。注意到,在一个excel文件中有多个sheet,因此,对excel文件的读取实 阅读详情

pandas是数据分析的必备工具,操作非常方便,效率也非常高。在机器学习的特征工程阶段十分常用,起到事半功倍的效果。

1 pandas常用数据读取

pandas可以读取各种格式的数据文件,比如常见的csv,excel和数据库等数据文件,还能读取粘贴板里的数据。

  • 读取csv文件
    import pandas as pd
    df = pd.read_csv('filename')
    
  • 读取excel文件
    df = pd.read_excel('filename')
    
  • 读取数据库文件
    con = pymysql.connect(host="***", user="***", password="***", db="***")
    df = pd.read_sql("sql语句", con)
    
  • 读取粘贴板里的数据
    df = pd.read_clipboard()
    

读取的数据将以DataFrame格式返回,进行后续操作。


2 查看数据信息

  • df.info(): 返回每列数据的缺失值情况以及类型。
  • df.index:返回DataFrame索引值。
  • df.columns:返回DataFrame列名。
  • df.dtypes:查看每列数据类型。
  • df.values:查看数据值(以array形式返回)

3 创建Series

Series本质就像一个dict一样,可通过key取数据。

s = pd.Series([7, 'Beijing', 3.14, -123, 'Happy'])

pandas会默认从0到n来作为series的index(如上面的例子),但是我们也可以自己去指定index。index我们可以把它理解成dict当中的key。

s = pd.Series([7, 'Beijing', 3.14, -123, 'Happy'], index=['A','B','C','D','E'])

也可以用一个dict初始化一个Series

cities = {'Beijing':55000, 'Shanghai':60000, 'Shenzhen':50000, 'Hangzhou':30000, 'Guangzhou':45000, 'Suzhou':None}
my_series = pd.Series(cities, name='salary')

4 创建DataFrame

一个DataFrame就像是一个Excel当中的表格一样,Series就是一个一维数组,DataFrame是一个2维数组,你可以把DataFrame看做一组Series的组合。DataFrame的一列为一个Series。

  • 传入字典创建
    data = {'country':['aaa','bbb','ccc'],
               'population':[10,12,14]}
    df = pd.DataFrame(data)
    
  • 指定索引和列名
    df = pd.DataFrame([[1,2,3],[4,5,6]], index=['a','b'], columns['A','B','C'])
    
  • 用几个Series创建
    cities = {'Beijing':55000, 'Shanghai':60000, 'Shenzhen':50000, 'Hangzhou':30000, 'Guangzhou':45000, 'Suzhou':None}
    my_series = pd.Series(cities, name='salary')
    cars = pd.Series([300000,250000,200000,350000,250000,200000], index=['Beijing', 'Guangzhou', 'Hangzhou', 'Shanghai', 'Shenzhen', 'Tianjin'])
    df = pd.DataFrame({'salary':my_series, 'cars':cars})
    

5 常用数据分析操作

  • df.set_index()设置索引,可传入某一列名,将返回以该列名为索引的df。
    # 以Name列作为索引值
    df = df.set_index('Name')
    
  • df.describe()返回最大值、最小值、均值等统计值。
5.1 pandas数据索引
  • 索引某几列数据的某几行
    # 索引age和fare两个字段的前5条数据
    df[['age', 'fare']][:5]
    
  • df.iloc:通过num值来索引
    # 索引前5条数据的第2列和第3列数据
    df.iloc[0:5, 1:3]
    
  • df.loc通过label索引,一般为字符串(索引,列名)
    # 获取Mike的身高
    df.loc['Mike', 'height']
    # 也能切片处理
    df.loc['Mike':, 'height':]
    #  也可以传入list
    drop_list = [695,2703,251,340]  # list为不同的index
    disease_score.loc[drop_list]  # 返回这4个索引对应4条数据的DataFrame
    
5.2 groupby操作

groupby能够对数据按照列进行分组,能够依照一列进行分组,也能够依照多列进行分组。

  • 第一种写法,用内置的sum(),mean(),median(),size()
    df.groupby('key').sum()  # 对key字段分组求和
    df.groupby('sex')['age'].mean()   # 统计男女的年龄均值
    ...
    
  • 第二种,借助agg
    import pandas as pd
    salaries = pd.DataFrame({'name':['BOSS','David','David','Han','BOSS','BOSS','Han','BOSS'],
                           'Year':[2016,2016,2016,2016,2017,2017,2017,2017],
                           'Salary':[9999999,20000,25000,3000,9999999,9999999,3500,9999999],
                           'Bonus':[1000000,200000,250000,5000,2000000,2500000,3000,40000000]})
    group_by_name = salaries.groupby('name')
    group_by_name[['Bonus','Salary']].agg(['sum','mean','median','size'])  # 同时执行这几个统计操作,size为统计每个分组的记录
    # 也可以使用numpy的操作这样写
    group_by_name.agg([np.sum, np.mean, np.std])
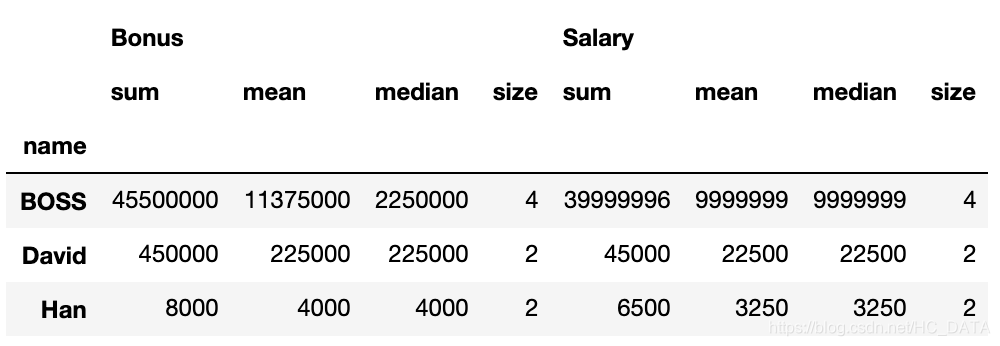
    
    结果如下:
    在这里插入图片描述
    对每一列可以采用不同的aggregate操作
    # 以字典形式指定每列执行的操作
    group_by_name.agg({"Bonus": np.sum, "Salary": np.sum, "Year": (lambda x: list(x)[0])})
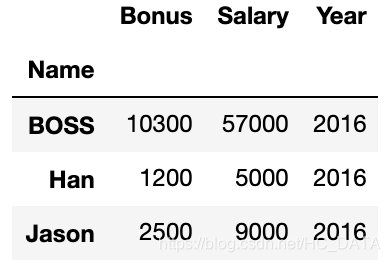
    
    在这里插入图片描述
  • 依照多列进行分组
    group_by_name_year = salaries.groupby(['name','Year'])
    group_by_name_year.sum()
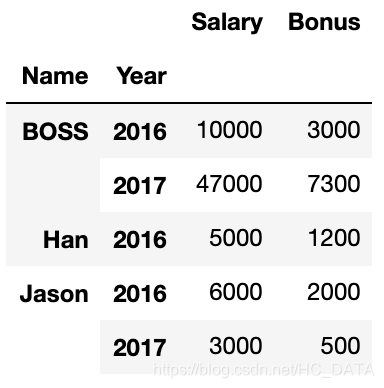
    
    在这里插入图片描述
    分组之后可以接agg,也可以接describe去看每个组的统计分布
  • 查看分组详情
    # 遍历查看所有组
    for name,group in group_by_name:
        print(name)
        print(group)
    # 选择一个组
    group_by_name.get_group('David')
    
  • 数据处理transform
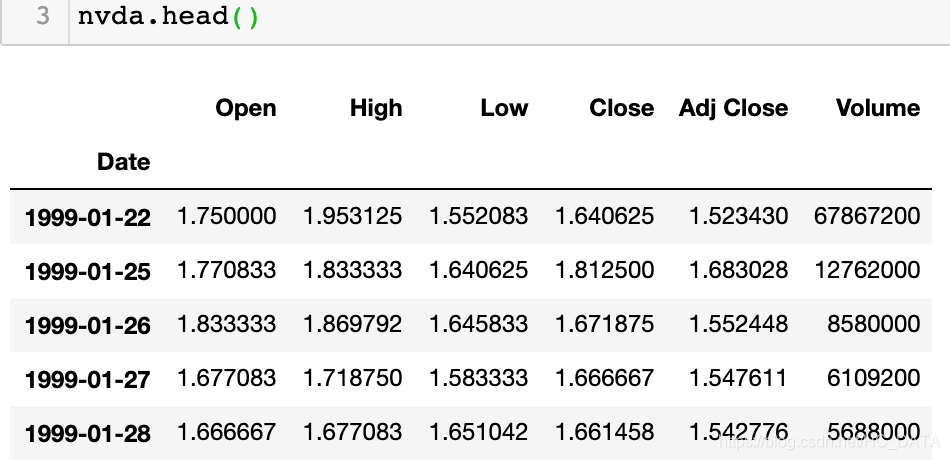
    下图为一份英伟达数据:
    在这里插入图片描述
    # groupby可以接收函数返回值
    nvda.groupby(lambda x:x.year).mean()
    # 上面也可写成
    nvda.groupby(nvda.index.year).mean()
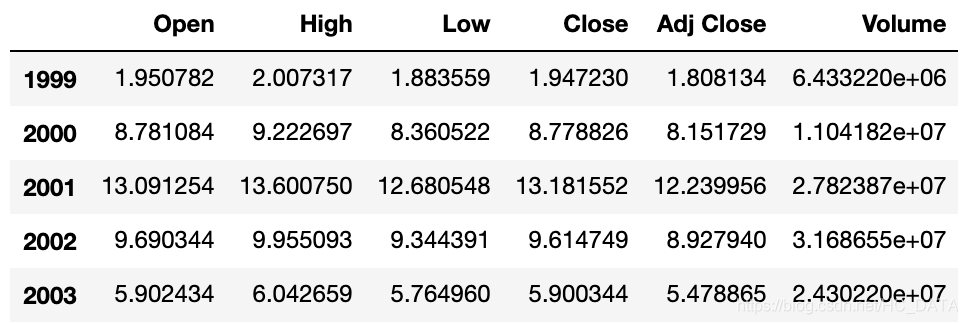
    
    运行结果如下:
    在这里插入图片描述
    transform操作
    my_transform = lambda x:(x-x.mean())/x.std()
    # 按照年份分组后,对每列进行transform操作
    transform = nvda.groupby(nvda.index.year).transform(my_transform)
    transform.head()
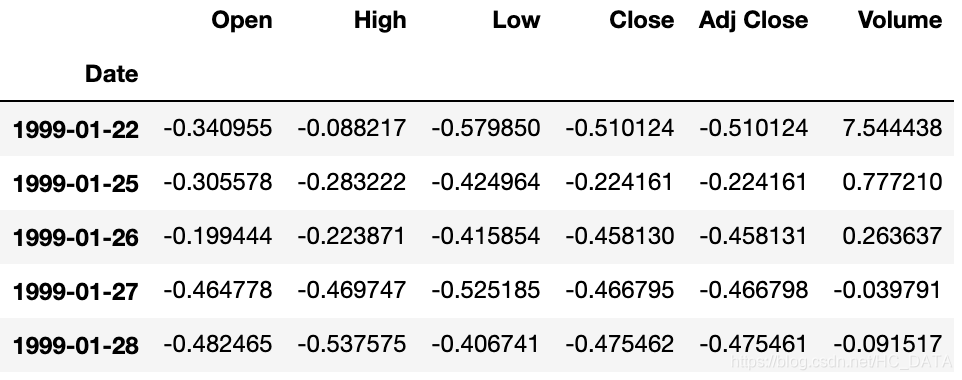
    
    在这里插入图片描述
5.3 数值运算
df.sum(axis=1)   # 按行求和,默认axis=0,按列求和
df.mean()
df.max()
df.min()
df.median()
df.cov()    # 返回特征之间的协方差
df.corr()   # 返回特征之间的相关系数
df['age'].value_counts()  # 统计不同年龄值的人数
df['age'].value_counts(ascending=True)  # 指定升序排列
df['age'].value_counts(ascending=True, bins=5)  # 将年龄平均划分为5组统计
df['age'].count()   # 统计age列有多少非空值 
5.4 对象操作
  • Series结构的增删改查
    data = [10,11,12]
    index = ['a','b','c']
    s = pd.Series(data=data, index=index)  # 创建就series
    # 索引方式和dataframe类似
    s[0:2]   # 返回a,b两条数据
    mask = [True,False,True]
    s[mask]  # 返回a,c两条数据
    s.loc['b']  # 索引b的值
    s.iloc[1]  # 返回11
    s1 = s.copy()  # 拷贝一份
    s1['a'] = 100  # 将a的值改为100
    s1.replace(to_replace=100, value=101, inplace=True) # 将100替换为101
    s1.index = ['a','b','d']  # 修改索引
    s1.rename(index=['a':'A'], inplace=True) # 将索引a改为A
    s2 = pd.Series([100,500], index=['g','h'])
    s1.append(s2)  # s2添加到s1中
    s1.append(s2, ignore_index=False) # 等于False保留原来的索引,True生成新的索引方式
    del s1['A']  # 删除s1中的A记录
    s1.drop(['b','d'],inplace=True) # 删除多条记录采用drop
    
  • DataFrame结构的增删改查
    data = [[1,2,3],[4,5,6]]
    index = ['a','b']
    columns = ['A','B','C']
    df = pd.DataFrame(data=data, index=index, columns=columns)
    # 查操作是类似的
    df['A']   # 查看A列
    df.loc['a']   # 查看a条记录
    # 改操作
    df.loc['a']['A'] = 150    # 改某个值
    df.index = ['f','g']  # 改索引
    # 增操作
    df.loc['c'] = [1,2,3]  # 增加索引为c的记录
    df2 = pd.DataFrame(data=[[1,2,3],[4,5,6]], index=['j','k'], columns=['A','B','C'])
    df3 = pd.concat([df,df2])    # 按照样本进行纵向,指定axis=1进行横向拼接
    df['D'] = [10,11]   # 增加D列
    df4 = pd.DataFrame([[10,11],[12,13]], index=['j','k'], columns=['D','E']) 
    df5 = pd.concat([df2,df4], axis=1)   # 此时增加了D和E两列数据
    # 删操作
    df5.drop(['j'], axis=0, inplace=True)   # 删除第j行样本
    del df5['D']    # 删除D列
    df5.drop(['A','B','C'], axis=1, inplace=True)    # s删除ABC三列
    

5.5 多表合并与拼接

  • concat

    df1 = pd.DataFrame({'apts': [55000, 60000],
                       'cars': [200000, 300000],},
                      index = ['Shanghai', 'Beijing']
                      )
    df2 = pd.DataFrame({'cars': [150000, 120000],
                        'apts': [25000, 20000],
                       },
                      index = ['Hangzhou', 'Nanjing'])
    df3 = pd.DataFrame({'apts': [30000, 10000],
                       'cars': [180000, 100000],'mar': [180000, 100000]},
                      index = ['Guangzhou', 'Chongqing'])
    result = pd.concat([df1,df2,df3])
    result
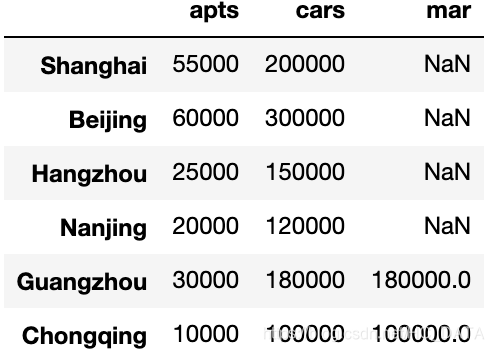
    

    在这里插入图片描述
    在concat的时候可以指定keys,这样可以给每一个部分加上一个Key。
    以下的例子就构造了一个hierarchical index。

    result2 = pd.concat([df1,df2,df3], keys=['x', 'y', 'z'], sort=False)
    result2
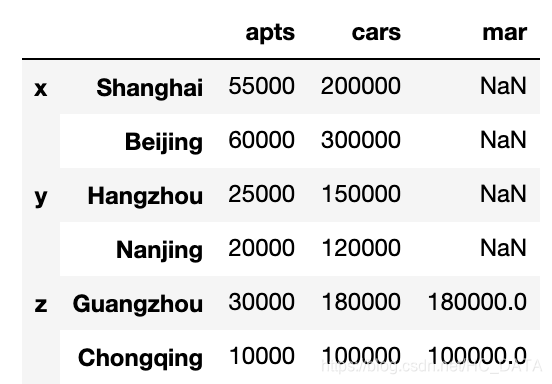
    

在这里插入图片描述
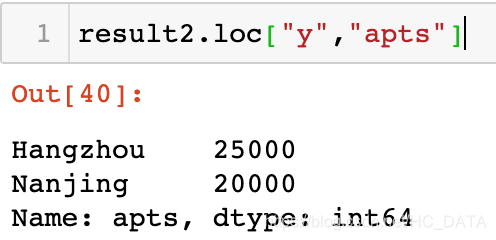
随后我们可以根据key获取对应数据:
在这里插入图片描述
指定axis=1可以做横向拼接

df4 = pd.DataFrame({'salaries': [10000, 30000, 30000, 20000, 15000]},
                  index = ['Suzhou', 'Beijing', 'Shanghai', 'Guangzhou', 'Tianjin'])
result3 = pd.concat([result, df4], axis=1, sort=False)
result3
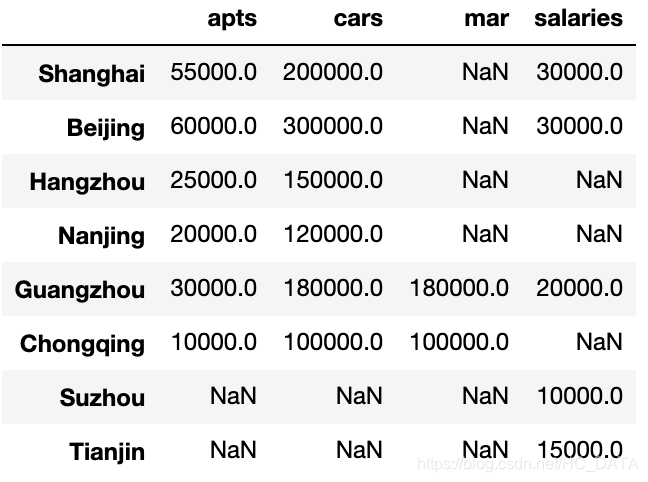
在这里插入图片描述
用inner可以去掉NaN,也就是说如果出现了不匹配的行就会被忽略

result3 = pd.concat([result, df4], axis=1, join='inner')
result3
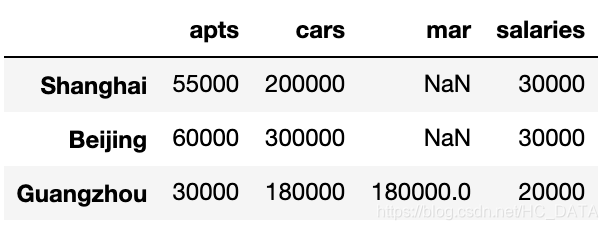
在这里插入图片描述
Series和DataFrame还可以被一起concatenate,这时候Series会先被转成DataFrame然后做Join,因为Series本来就是一个只有一维的DataFrame。

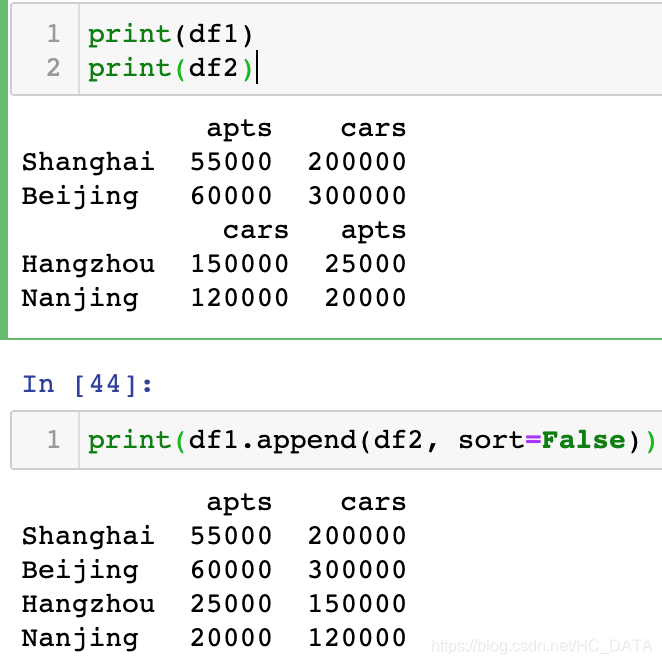
  • append
    在这里插入图片描述
  • merge
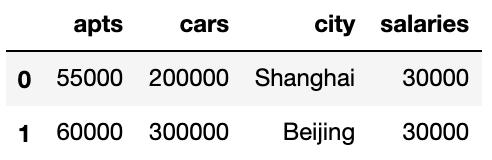
    df1 = pd.DataFrame({'apts': [55000, 60000, 58000],
                   'cars': [200000, 300000,250000],
                  'city': ['Shanghai', 'Beijing','Shenzhen']})
    df4 = pd.DataFrame({'salaries': [10000, 30000, 30000, 20000, 15000],
                  'city': ['Suzhou', 'Beijing', 'Shanghai', 'Guangzhou', 'Tianjin']})
    result = pd.merge(df1, df4, on='city')
    result
    
    在这里插入图片描述
    如果不指定on的对象,pandas也会寻找两个表相同列名去merge
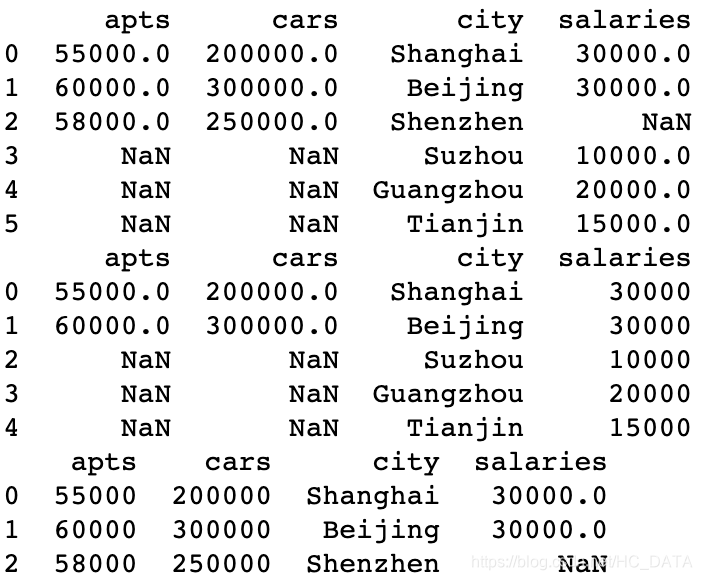
    how可以指定不同方式
    print(pd.merge(df1, df4, on='city', how='outer'))
    print(pd.merge(df1, df4, on='city', how='right'))
    print(pd.merge(df1, df4, on='city', how='left'))
    

在这里插入图片描述
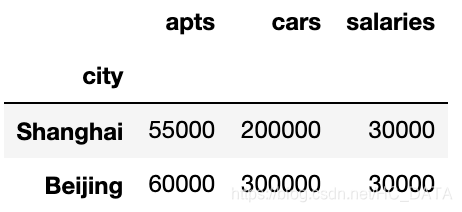
如果要用concat做同样的事情

pd.concat([df1.set_index("city"), df4.set_index('city')], sort=False, axis=1, join="inner")
在这里插入图片描述

5.6 缺失值处理

dropna默认是删掉行,如果想删掉一列,就要声明一下axis参数

# how='all'表示删除全部是缺失值的行或列,默认是行,指定axis=1,会删除全是缺失值的列
bikes.dropna(how="all", axis=1).head()

Python pandas 各类 操作 备忘 >>> import pandas as pd >>> factors={'2021':36.45,'2020':35.43,'2019':34.65,'2018':33.9,'2017':33.14} # 必须加index,index中是列表,列表个数,即为记录数。 # 下面是以关键字为列名,共5列 >>> df = pd.DataFrame(factors,index=[1]) # 结果如下: 2021 2020 2019 2... 阅读详情

相关推荐

从零开始学Pandas:数据分析必备技能速成

在 Pandas 中,Series和DataFrame是核心数据结构。Series是一维数组,包含数据和索引,适合存储单列数据,如数值或字符串。DataFrame是二维表格,由多个Series组成,每列是一个Series,具有共享的行索引,适合处理多列数据,如表格或数据库结构。DataFrame是Series的集合,每列都是一个Series对象。例如,DataFrame中可以通过列名提取Series,也可以将多个Series合并成一个DataFrame。因此,Series是构成DataFrame的基础。

weixin_52582573的博客 2725

Pandas的基本功能

Pandas的基本功能 一、Pandas的常用32个方法和功能 DataFrame() 创建一个DataFrame对象 df.values 返回ndarray类型的对象 df.shape 返回行列数 df.index 获取行索引 df.set_index 设置索引 df.reset_index 重制索引 df.columns 获取列索引 df.rename 重新设置列名 df.dtypes 查看每列数据类型 df.axes 获取行及列索引 df.T 行与列对调 df.info() 打印DataFrame对象

xiaoliu的博客 1907

LightGBM参数调优实战:从基础到高级技巧

本文深入探讨了LightGBM参数调优的实战技巧。文章从理解其Leaf-wise生长策略的核心逻辑出发,系统性地介绍了分层调参策略:首先调整控制模型结构的参数(如num_leaves),其次优化学习能力参数(如learning_rate),最后通过正则化与随机化参数提升泛化能力。文中还提供了从建立基线到最终微调的完整实战流程与高级避坑指南,帮助读者高效提升模型性能。

i8j9k0l1的博客 264

python必知必会的数据处理知识1(pandas))

1. 简介 数据的处理的软件包有很多,在python中主要应用Pandas来进行处理。Pandas是一个十分成熟的数据处理包,熟练掌握可以高效并且方便地将数据进行转换和清洗,本节主要是pandas的一些基本技能和实用技巧。 数据科学家经常和表格形式的数据(比如.csv、.tsv、.xlsx)打交道。Pandas可以使用类似SQL的方式非常方便地加载、处理、分析这些表格形式的数据。 2. 数据结构 Series:用index和values分别规定索引和值。如果不规定索引,会自动创建 0 到 N-1 索引。 S

miya的博客 4866

深入解析Uplift模型评估:AUUC指标的计算与应用

本文深入解析了Uplift模型评估的核心指标AUUC。针对传统响应模型无法区分用户真实转化动因的痛点,AUUC通过量化模型对用户增益(Uplift)的排序能力,有效衡量营销干预的增量收益。文章详细拆解了AUUC的计算逻辑,从构建Qini曲线到Python代码实战,并强调了其在预算约束下的精准营销等场景的应用价值与常见陷阱。

weixin_29254029的博客 482

1.3-----Simplify 3D切片软件:从新手困惑到高效打印的进阶设置指南

本文详细介绍了Simplify 3D切片软件在大型模型打印中的高效设置技巧,包括切片效率、支撑结构智能生成和精细参数调节等核心优势。通过实战案例和进阶参数设置指南,帮助用户从新手快速进阶到高效打印,显著提升3D打印质量和效率。

weixin_42552716的博客 426

pandas 学习笔记

一、基本操作 1导入pandas库,读入csv文件,.read_csv()函数 #导入pandas库 import pandas as pd #读取csv文件 df = pd.read_csv('泰坦尼克号数据.csv')

2287

EtherCat 从站开发中遇到的问题分享

EtherCat从站 AX58100

yu_arius的博客 2061

python之pandas常用技能

文章偷自https://www.jb51.net/article/136360.htm

qq_21735341的博客 254

别再手动调时间了!用Windows自带的tzutil命令,1分钟搞定时区错误

本文介绍了如何使用Windows自带的tzutil命令快速解决时区错误问题。通过简单的命令行操作,用户可以一键切换时区、查看全球时区代码库,并实现自动化时区同步。相比传统GUI设置,tzutil更可靠且高效,特别适合企业环境批量部署。

weixin_42531494的博客 316

SAPIEN ManiSkill3 入门教程(一)

请注意,table.set_pose(pose) 设置的是演员在世界帧中的坐标系姿势。移除的实体可以再次添加到场景中,但已在场景中的实体则不能再次添加。显示器可以是物理的(如显示器),也可以是虚拟的(如 VNC)。我们可以通过 get_pose()、get_linear_velocity() 和 get_angular_velocity()获取演员的运动量(姿势、线速度、角速度)。现在,让我们创建一个斜坡。例如,您可能需要一个简单的碰撞形状来进行快速模拟,但却需要一个复杂的视觉形状来进行逼真的渲染。

机器人控制与仿真应用 3081

pandas常用小技能

pandas是数据处理中常用的第三方库,有很多小技能可以方便的实现一些功能。 1,字符替换 replace 举例:df = df.replace(regex={’#’: ‘’}) 可以将文件中的‘#’替换为空。 replace的基本结构是:df.replace(to_replace, value) 前面是需要替换的值,后面是替换后的值 对部分列进行替换: df[‘col_name’].replac...

Anakin6174的博客 453

电商平台系统需求规格说明书(示例)

​​电商系统​​:指本文件所描述的集商品展示、销售、支付、物流跟踪、用户管理等功能于一体的综合性在线购物平台。​​API​​:应用程序编程接口(Application Programming Interface),用于实现系统各模块之间或与外部系统之间的数据交互和功能调用。

跟佟格湾一起学习计算机知识吧~ 1269

Pandas选择行列的十大技能

感谢博主,转载自: https://blog.csdn.net/qq_38328378/article/details/81166518 http://www.datastudy.cc/article/ec8c50baa8fd93ea85432eb85fb34eee 目录 技能1、选择一列 技能2、选择多列 技能3、根据一个行索引,选择出一行 技...

呆萌的代Ma 2107

leetcode134 加油站

题目如下 在一条环路上有 N 个加油站,其中第 i 个加油站有汽油 gas[i] 升。 你有一辆油箱容量无限的的汽车,从第 i 个加油站开往第 i+1 个加油站需要消耗汽油 cost[i] 升。你从其中的一个加油站出发,开始时油箱为空。 如果你可以绕环路行驶一周,则返回出发时加油站的编号,否则返回 -1。 说明: 如果题目有解,该答案即为唯一答案。 输入数组均为非空数组,且长度相同。 输...

ayang818 's blog 234

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

如何快速掌握pandas数据处理技能:Joyful Pandas完整学习指南

想要在数据分析领域脱颖而出?pandas数据处理技能是每个数据分析师必备的核心能力。Joyful Pandas作为pandas官方推荐的社区教程,提供了从基础到高级的完整学习路径,帮助初学者和专业人士快速提升数据分析和处理能力。🎯 ## 为什么选择Joyful Pandas学习pandas技能 Joyful Pandas不仅仅是一个教程,它是一个完整的学习生态系统。该项目被pandas官方选

gitblog_01081的博客 1094

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

如何通过Pandas实战练习项目快速掌握Python数据分析技能

如果你正在寻找一个系统化的Pandas学习路径,那么GitCode上的pandas_exercises项目正是为你准备的终极实践指南。这个精心设计的Pandas练习项目通过10个核心主题、30多个真实数据集,帮助你从零基础到数据分析高手。无论你是Python数据分析的新手,还是希望系统巩固技能的从业者,这个项目都能为你提供宝贵的实战经验。 ## 🎯 项目核心优势:为什么选择pandas_exe

gitblog_00116的博客 805

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

Pandas练习题 - 提高你的数据分析技能

整理 | 人工智能头条(ID:AI_Thinker)本文总结了 pandas 的常用操作,并做成练习题,练习题附答案,并且有完整数据集,建议读者把练习题完成。作者认为,做...

Python大本营的博客 3007

Pandas数据分析实战:轻松掌握数据处理核心技能

想要快速提升数据分析能力却不知从何入手?Pandas作为Python数据分析的核心工具,能够帮助你高效处理各种数据问题。本文将为你提供一套实用的Pandas数据分析解决方案,让你在短时间内掌握数据处理的关键技能。 ## 为什么你的数据分析总是效率低下? 很多数据分析新手在处理数据时常常遇到效率瓶颈。经过大量实践观察,我们发现主要问题集中在三个方面:数据导入不规范、清洗流程混乱、分析方法单一。这

gitblog_00749的博客 406

pandas这么多实用又常用的技能,还不快快收藏起来

自从我整理完这两篇关于pandas的博文之后,我从博文的阅读以及收藏的数据中不难得知,大家对于这类实用性的博文的认可,同时我自己在工作中有时也会发现,即使我整理了这么多有关于pandas的内容,但或多或少还是会遗漏一些知识点,毕竟pandas实在是太多实用的功能了。 那么今天这篇博文呢,我进一步整理了前面这两篇博文没有提到的或者说讲的不够具体的实用技能,大家赶紧收藏起来吧,我保证你们迟早会用到。

w0714的博客 4万+

Pandas练习题-提高你的数据分析技能

本文总结了pandas的常用操作,并做成练习题,练习题附答案,并且有完整数据集,建议读者把练习题完成。作者认为,做完练习题,pandas的基本操作没有问题了,以后碰到问题也可以查这些习题...

fengdu78的博客 2087

100-pandas-puzzles:掌握数据分析核心技能的终极实战指南

想要真正精通pandas数据分析技能,仅仅学习理论是远远不够的。**100-pandas-puzzles**项目为Python数据分析从业者提供了一个完整的实战训练平台,通过100个精心设计的pandas练习题,系统性地提升你的数据处理能力。这个开源项目涵盖了从基础操作到高级技巧的完整pandas技能栈,是每个数据分析师必备的实战训练资源。 ## 🎯 项目核心价值:为什么你需要100-pand

gitblog_00472的博客 868

Pandas 练习题 - 提高你的数据分析技能

本文总结了 pandas 的常用操作,并做成练习题,练习题附答案,并且有完整数据集,建议读者把练习题完成。作者认为,做完练习题,pandas 的基本操作没有问题了,以后碰...

优快云人工智能头条 1724

Python之Pandas的常用技能【写入数据】

pandas对excel和数据的写入操作总结

学习python 1万+

pandas分组计算平均值_Pandas必备技能之“分组聚合操作”

TUSHARE金融与技术学习兴趣小组翻译整理 | 一只小绿怪兽在处理数据的过程中,知道如何对数据集进行分组、聚合操作是一项必备的技能,能够大大提升数据分析的效率。分组是指根据一个或多个键将数据拆分为多个组的过程,这里的键可以理解为分组的条件。聚合指的是任何能够从数组产生标量值的数据转换过程。分组、聚合操作一般会同时出现,用于计算分组数据的统计值或实现其他功能。本文会介绍如何利用Pa...

weixin_32924159的博客 2478

【机器学习】Pandas练习题-提高你的数据分析技能

本文总结了pandas的常用操作,并做成练习题,练习题附答案,并且有完整数据集,建议读者把练习题完成。作者认为,做完练习题,pandas的基本操作没有问题了,以后碰到问题也可以查这些习题。...

fengdu78的博客 930
上一篇: 机器学习常用可视化系列(一)
下一篇: VGG论文精读笔记
hcML
博客等级 码龄9年 19粉丝 10原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值