


前言:
接着上篇介绍经典卷积神经网络模型的博文,这两天又发现一类仿生特性的视觉注意机制模型在近两年中逐渐被提出。其中比较有代表性的模型有在2017年ImageNet中获得分类组关键的SENet,以及2018年结合了空间和通道双注意机制的CBAM模型。
毕竟灵感来自人眼的感知,所以在正式介绍模型前增加了一段人眼视觉感知的背景内容。
目录标题
人眼视觉感知中的注意力特性
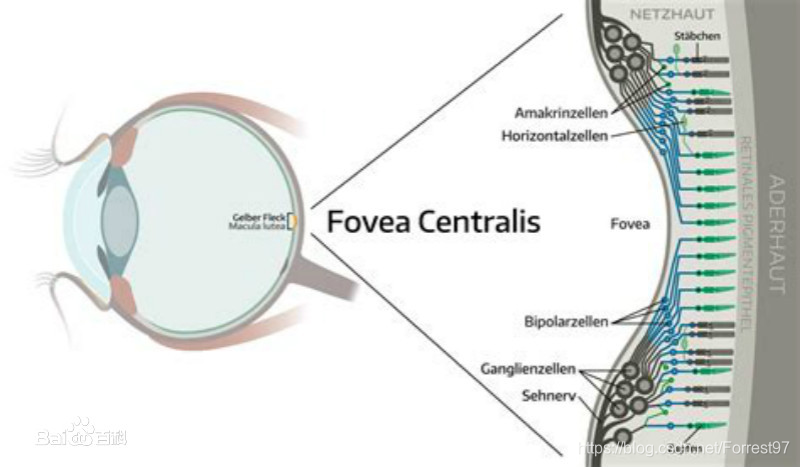
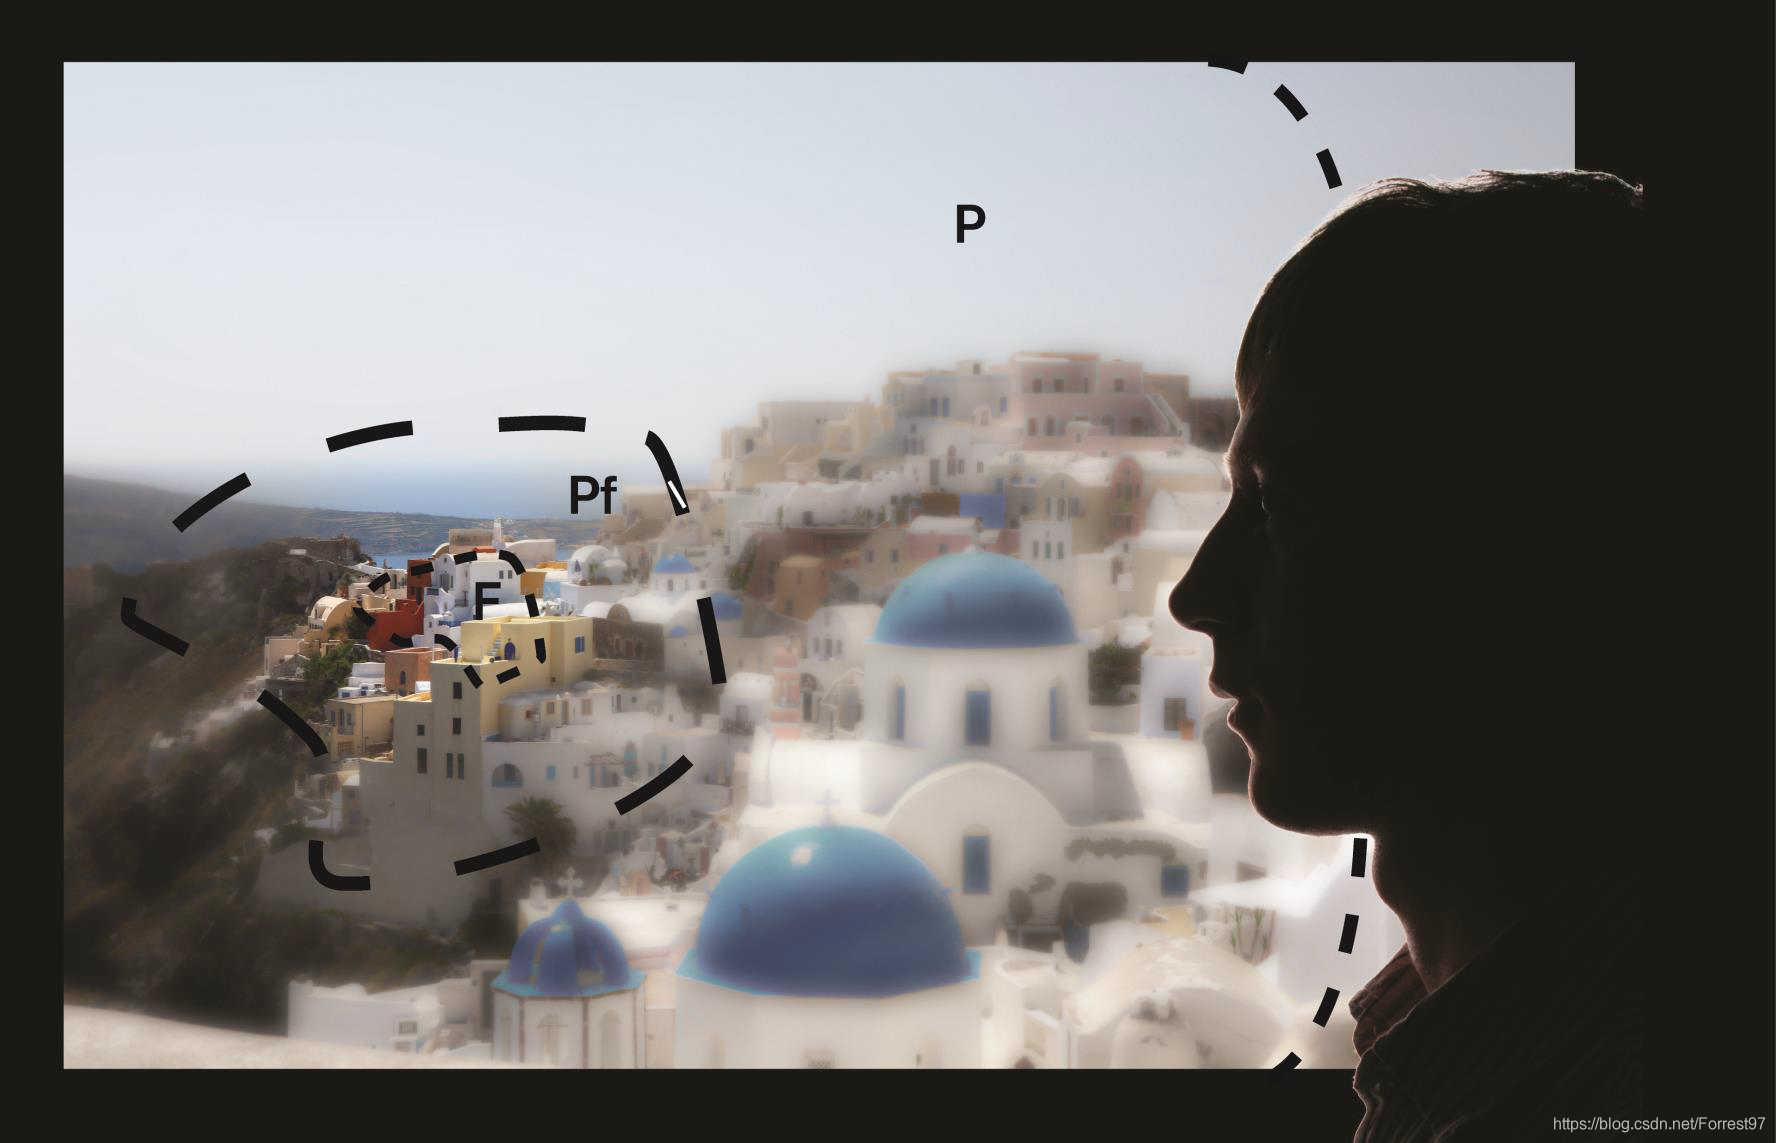
中央凹(foveal)
感觉光暗的杆状细胞和感觉色彩的锥状细胞在视网膜表面并不是平均分布的,在感知中起重要作用的锥细胞大部分集中在视网膜中的一小片称为黄点的地方。因此我们在观看景物和阅读时,注意力只是集中在视野范围一半不到的区域。
黄斑中央凹陷称中央凹,是视网膜中视觉(辨色力、分辨力)最敏锐的区域。此处视网膜最薄,只有色素上皮细胞和视锥细胞两层细胞,双极细胞和节细胞均斜向周围排列。此处视锥细胞与双极细胞均一对一联系,故视觉最为敏锐而精确,称中心视觉。
参考:https://baike.baidu.com/item/%E4%B8%AD%E5%A4%AE%E5%87%B9/1365085?fr=aladdin
https://baike.baidu.com/item/%E8%A7%86%E8%A7%89%E6%84%9F%E7%9F%A5/1473317?fr=aladdin
人眼视域(Field of View)
顾名思义就是视力可见区域,需要拆成横向和纵向两种来看。人有两只眼睛,两眼视物(Binocular Vision)系统的优点之一是视域更宽,人类横向视域最大接近190度。但空间感知、颜色识别最好的区域只有50到60度。
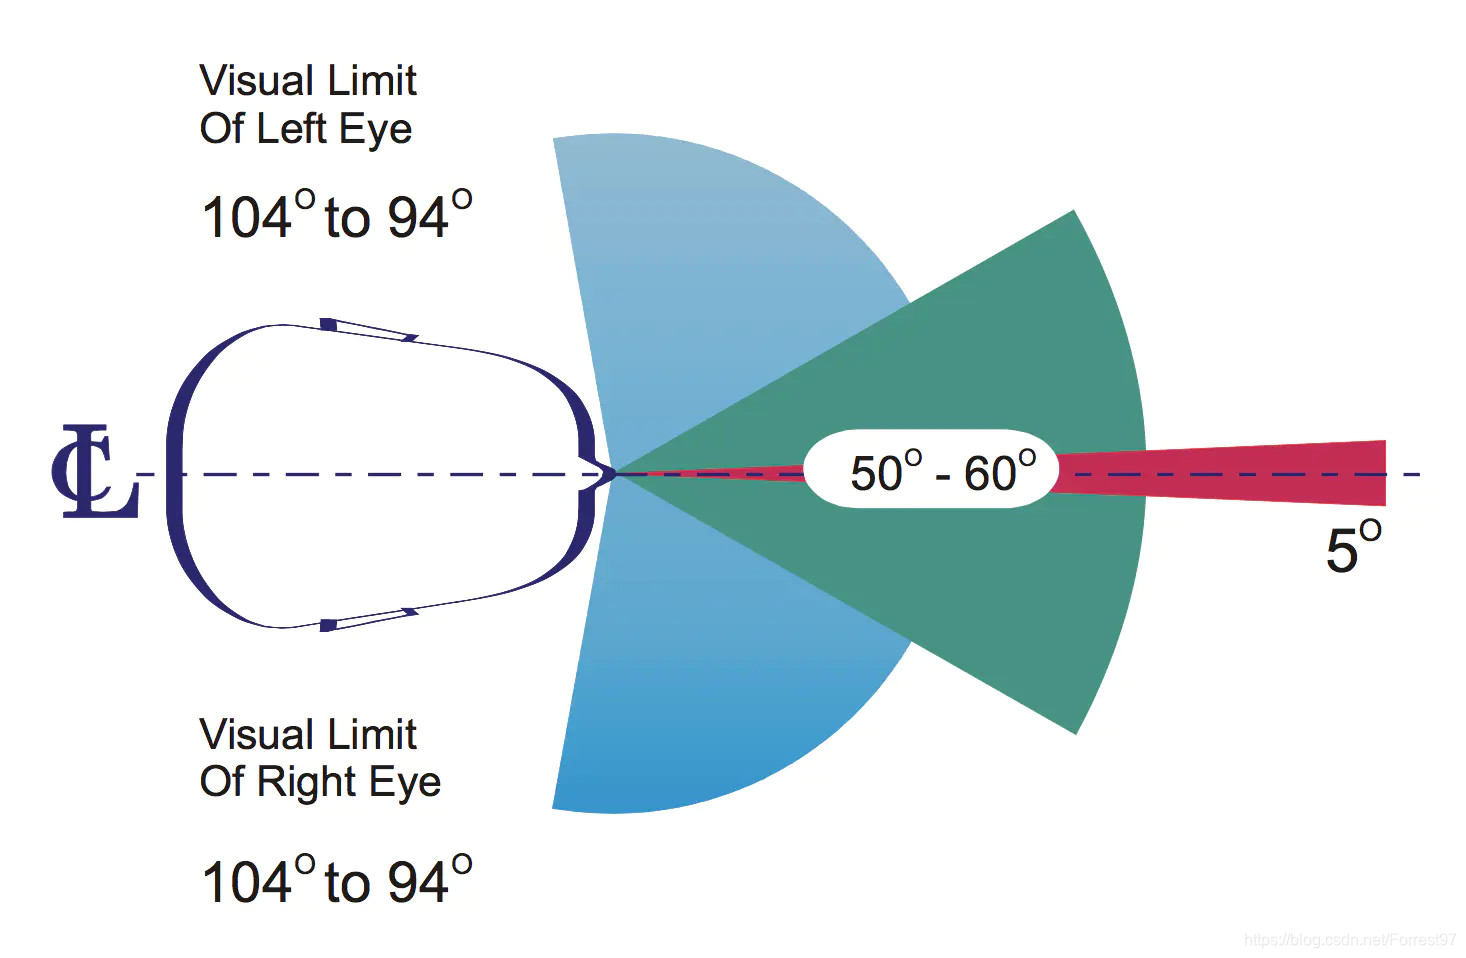
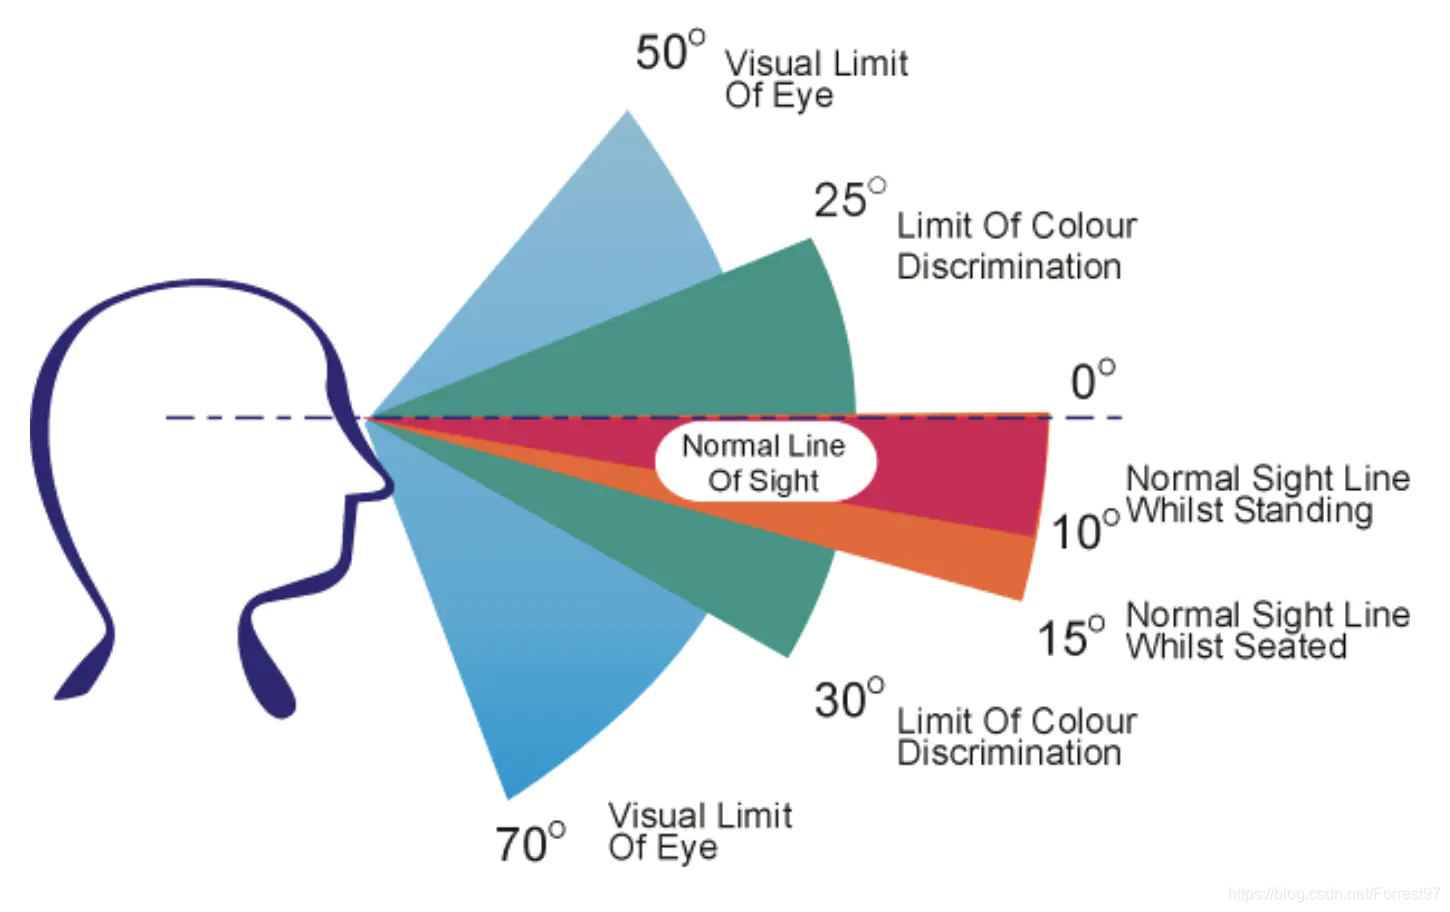
纵向视域如上图所示最大接近120度,颜色识别界限在55度左右。站立情况下视线会低于水平10度;坐着时低于水平15度。
参考:https://www.jianshu.com/p/5312677111e3
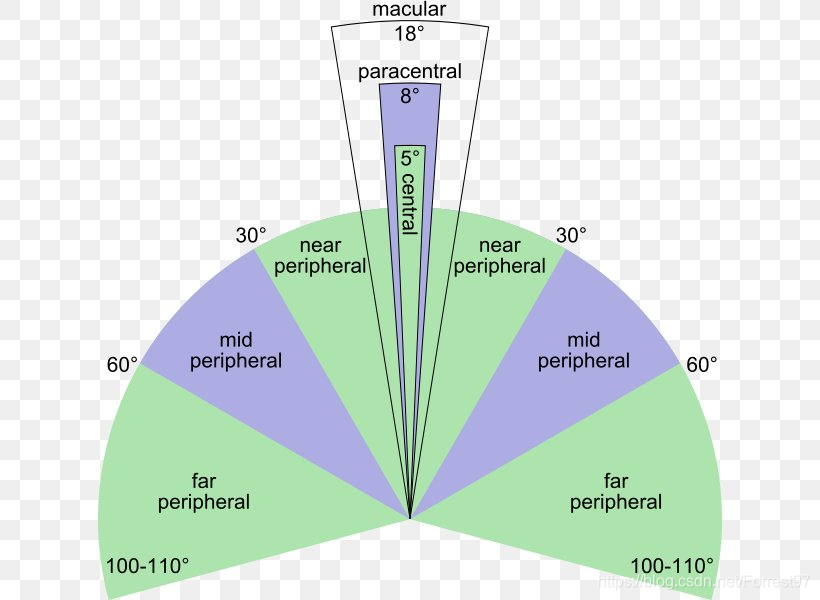
当我们要看清一件对象时,我们会转动眼球,直至影像聚焦在视野的中央凹上。离开中央凹越远,感光细胞越少,影像越不清晰。如影像聚焦在黄斑以外的地方,我们可看见一件对象的存在,但未必知道这件对象是甚么。
计算机视觉感知中的注意特性
SENet:Squeeze-and-Excitation Networks
背景
卷积神经网络由一系列卷积层、非线性层和下采样层构成,这样它们能够从全局感受野上去捕获图像的特征来进行图像的描述。而卷积核作为卷积神经网络的核心,通常被看做是在局部感受野上,将空间上(spatial)的信息和特征维度上(channel-wise)的信息进行聚合的信息聚合体。已经有很多工作在空间维度上来提升网络的性能, 如 Inception 结构中嵌入了多尺度信息,聚合多种不同感受野上的特征来获得性能增益;在 Inside-Outside 网络中考虑了空间中的上下文信息;还有将 Attention 机制引入到空间维度上。
网络是否可以从其他层面来考虑去提升性能,比如考虑特征通道之间的关系?我们的工作就是基于这一点并提出了 Squeeze-and-Excitation Networks(简称 SENet)。在我们提出的结构中,Squeeze 和 Excitation 是两个非常关键的操作,所以我们以此来命名。我们的动机是希望显式地建模特征通道之间的相互依赖关系。另外,我们并不打算引入一个新的空间维度来进行特征通道间的融合,而是采用了一种全新的「特征重标定」策略。具体来说,就是通过学习的方式来自动获取到每个特征通道的重要程度,然后依照这个重要程度去提升有用的特征并抑制对当前任务用处不大的特征。
网络框架
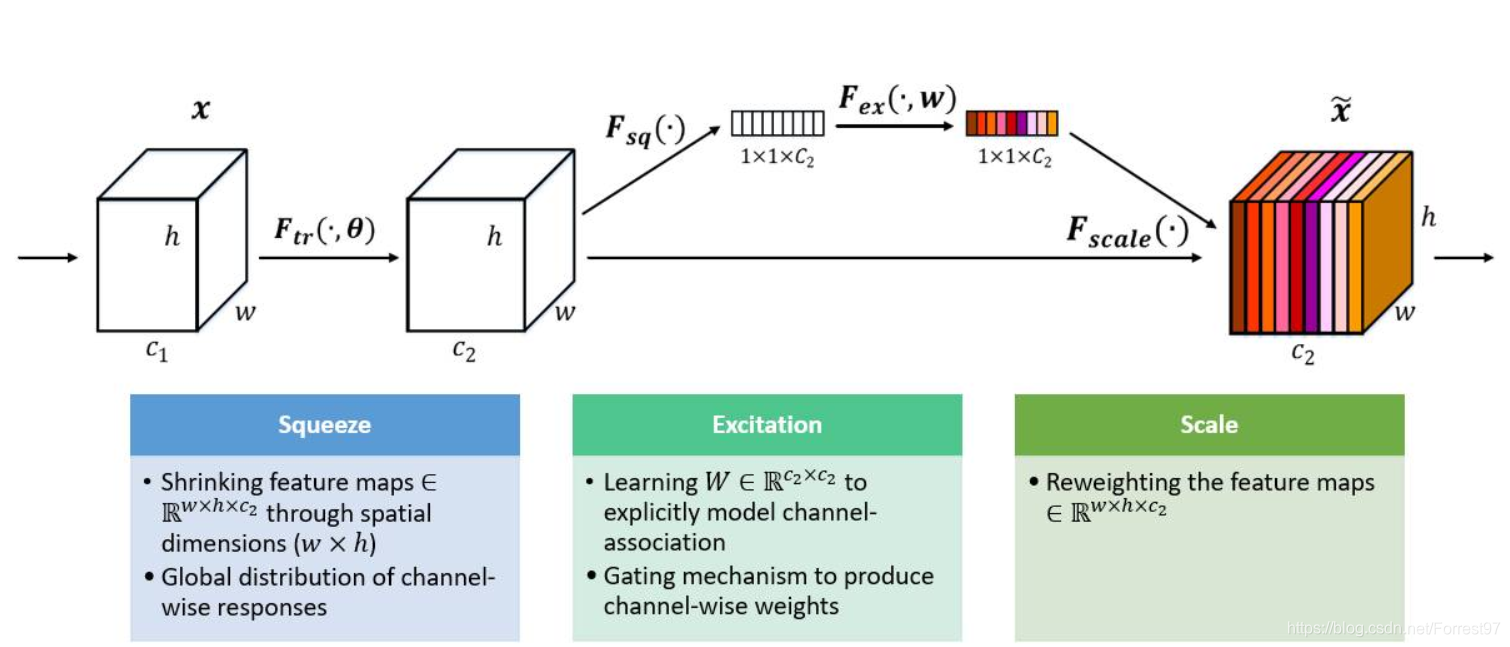
上图是我们提出的 SE 模块的示意图。给定一个输入 x,其特征通道数为 c_1,通过一系列卷积等一般变换后得到一个特征通道数为 c_2 的特征。与传统的 CNN 不一样的是,接下来我们通过三个操作来重标定前面得到的特征。
首先是 Squeeze 操作,我们顺着空间维度来进行特征压缩,将每个二维的特征通道变成一个实数,这个实数某种程度上具有全局的感受野,并且输出的维度和输入的特征通道数相匹配。它表征着在特征通道上响应的全局分布,而且使得靠近输入的层也可以获得全局的感受野,这一点在很多任务中都是非常有用的。
其次是 Excitation 操作,它是一个类似于循环神经网络中门的机制。通过参数 w 来为每个特征通道生成权重,其中参数 w 被学习用来显式地建模特征通道间的相关性。
最后是一个 Reweight 的操作,我们将 Excitation 的输出的权重看做是进过特征选择后的每个特征通道的重要性,然后通过乘法逐通道加权到先前的特征上,完成在通道维度上的对原始特征的重标定。
Tensorflow 2.0代码实现:
Squeeze 操作: 全局池化将每个Channel 上的二维维度压缩成一个单一值
Excitation 操作:两个全连接层和一个sigmoid
Reweight 的操作:维度增加与每个对应特征图相乘
def SE_moudle(input_xs,reduction_ratio = 16.):
    shape = input_xs.get_shape().as_list()
    se_module = tf.reduce_mean(input_xs,[1,2])
    se_module = tf.keras.layers.Dense(shape[-1]/reduction_ratio,activation=tf.nn.relu)(se_module)
    se_module = tf.keras.layers.Dense(shape[-1], activation=tf.nn.relu)(se_module)
    se_module = tf.nn.sigmoid(se_module)
    se_module = tf.reshape(se_module,[-1,1,1,shape[-1]])
    out_ys = tf.multiply(input_xs,se_module)
return out_ys
嵌入ResNet

由于存在sigmoid层,attention加在scale后面,避免梯度消散的情况
def identity_block(input_xs, out_dim, with_shortcut_conv_BN=False):

    if with_shortcut_conv_BN:
        pass
    else:
        shortcut = tf.identity(input_xs)
    input_channel = input_xs.get_shape().as_list()[-1]
    if input_channel != out_dim:
        pad_shape = tf.abs(out_dim - input_channel)
        shortcut = tf.pad(shortcut, [[0, 0], [0, 0], [0, 0], [pad_shape // 2, pad_shape // 2]], name="padding")
    conv = tf.keras.layers.Conv2D(filters=out_dim // 4, kernel_size=1, padding="SAME", activation=tf.nn.relu)(input_xs)
    conv = tf.keras.layers.BatchNormalization()(conv)
    conv = tf.keras.layers.Conv2D(filters=out_dim // 4, kernel_size=3, padding="SAME", activation=tf.nn.relu)(conv)
    conv = tf.keras.layers.BatchNormalization()(conv)
    conv = tf.keras.layers.Conv2D(filters=out_dim // 4, kernel_size=1, padding="SAME", activation=tf.nn.relu)(conv)
    conv = tf.keras.layers.BatchNormalization()(conv)
    shape = conv.get_shape().as_list()
    se_module = tf.reduce_mean(conv, [1, 2])
    se_module = tf.keras.layers.Dense(shape[-1] / 16, activation=tf.nn.relu)(se_module)
    se_module = tf.keras.layers.Dense(shape[-1], activation=tf.nn.relu)(se_module)
    se_module = tf.nn.sigmoid(se_module)
    se_module = tf.reshape(se_module, [-1, 1, 1, shape[-1]])
    se_module = tf.multiply(input_xs, se_module)
    output_ys = tf.add(shortcut, se_module)
    output_ys = tf.nn.relu(output_ys)
    return output_ys
参考
论文:Squeeze-and-Excitation Networks.
GitHub: https://github.com/hujie-frank/SENet
推荐blog:https://www.cnblogs.com/bonelee/p/9030092
https://blog.youkuaiyun.com/paper_reader/article/details/81082351
CBAM: Convolutional Block Attention Module
背景
SENet在feature map的通道上进行attention生成,然后与原来的feature map相乘。这篇文章指出,该种attention方法只关注了通道层面上哪些层会具有更强的反馈能力,但是在空间维度上并不能体现出attention的意思。
CBAM作为本文的亮点,将attention同时运用在channel和spatial两个维度上,CBAM与SE Module一样,可以嵌入了目前大部分主流网络中,在不显著增加计算量和参数量的前提下能提升网络模型的特征提取能力。
近几年,随着CNN的兴起,很多结构新颖、有效的网络结构被提出,比如ResNet、ResNext等;最近,大部分论文证明了在网络结构中引入attention机制可以提升网络模型的特征表达能力。attention不止能告诉网络模型该注意什么,同时也能增强特定区域的表征。本文的CBAM在channel和spatial两个维度上引入了attention机制。
两个主要维度的有意义的特征:通道和空间轴。这样每个分支都可以分别在通道和空间轴上学习到"what"和"where"。
1.我们提出了一种简单而有效的注意力模块(CBAM),可以广泛应用于提高CNN的表示能力。
2.我们通过广泛的消融研究验证了我们注意力模块的有效性。
3.我们通过插入轻量级模块,验证多个基准(ImageNet-1K,MS COCO和VOC 2007)的各种网络性能得到了极大提升。
网络框架


Channel Attention
构造形式与SENet类似:二维特征压缩一位,到全连接,最后sigmoid。存在maxpool和 AvgPool两个通道
算法公式:


为了有效地计算通道注意力,我们压缩输入特征图谱的空间维度。为了聚集空间信息首先将feature map在spatial维度上进行压缩,得到一个一维矢量以后再进行操作。对输入feature map进行spatial维度压缩时,a使用的是average pooling(平均池化)和max pooling(最大值池化),通过两个pooling函数以后总共可以得到两个一维矢量,这样做的好处是:average pooling有效地学习目标物体,而最大池化收集了关于独特对象特征的另一个重要线索,以推断出通道方面的注意力。此外,我在网上学习时看到过另一种说法:average pooling对feature map上的每一个像素点都有反馈,而 max pooling在进行梯度反向传播计算只有feature map中响应最大的地方有梯度的反馈,能作为GAP的一个补充。
在得到两个一维矢量后,将其放入一个共享网络中,共享网络是由一个隐藏层和多层感知机(MLP)组成。为了减少参数开销,隐藏的激活大小设置为 ,其中r是压缩率。在将共享网络应用于矢量之后,我们使用逐元素求和来合并输出特征向量。其中σ表示Sigmoid函数,即再经过激活函数后最后得到的结果

Spatial Attention
首先沿通道轴应用平均池化和最大池化操作(此处注意点:这里的压缩变成了通道层面上的压缩,不再是最开始的feature map,这里面的F=Mc),接着对输入特征分别在通道维度上做了avg和max操作。最后得到了两个二维的feature,将其按通道维度拼接在一起得到一个通道数为2的feature map,之后使用一个包含单个卷积核的隐藏层对其进行卷积操作,要保证最后得到的feature在spatial维度上与输入的feature map一致。
算法公式:


其中σ表示sigmoid函数,f7×7表示卷积操作,卷积核大小为7×7
Tensorflow 2.0代码实现:
def cbam_module(input_xs, reduction_ratio=0.5):
    batch_size, hidden_num = input_xs.get_shape().as_list()[0], input_xs.get_shape().as_list()[3]
    # channel attention
    maxpool_channel = tf.reduce_max(tf.reduce_max(input_xs, axis=1, keepdims=True), axis=2, keepdims=True)
    avgpool_channel = tf.reduce_mean(tf.reduce_mean(input_xs, axis=1, keepdims=True), axis=2, keepdims=True)
    maxpool_channel = tf.keras.layers.Flatten()(maxpool_channel)
    avgpool_channel = tf.keras.layers.Flatten()(avgpool_channel)
    mlp_1_max = tf.keras.layers.Dense(units=int(hidden_num * reduction_ratio), activation=tf.nn.relu)(maxpool_channel)
    mlp_2_max = tf.keras.layers.Dense( units=hidden_num)(mlp_1_max)
    mlp_2_max = tf.reshape(mlp_2_max, [-1, 1, 1, hidden_num])
    mlp_1_avg = tf.keras.layers.Dense(units=int(hidden_num * reduction_ratio), activation=tf.nn.relu)(avgpool_channel)
    mlp_2_avg = tf.keras.layers.Dense(units=hidden_num, activation=tf.nn.relu)(mlp_1_avg)
    mlp_2_avg = tf.reshape(mlp_2_avg, [-1, 1, 1, hidden_num])
    channel_attention = tf.nn.sigmoid(mlp_2_max + mlp_2_avg)
    channel_refined_feature = input_xs * channel_attention
    # spatial attention
    maxpool_spatial = tf.reduce_max(channel_refined_feature, axis=3, keepdims=True)
    avgpool_spatial = tf.reduce_mean(channel_refined_feature, axis=3, keepdims=True)
    max_avg_pool_spatial = tf.concat([maxpool_spatial, avgpool_spatial], axis=3)
    conv_layer = tf.keras.layers.Conv2D(filters=1, kernel_size=(3, 3), padding="same",activation=None)(max_avg_pool_spatial)
    spatial_attention = tf.nn.sigmoid(conv_layer)
    refined_feature = channel_refined_feature * spatial_attention
    output_layer = refined_feature + input_xs
return output_layer
并行或顺序方式放置两个模块。我们发现顺序排列比并行排列能得到更好的结果。对于顺序过程的安排,我们的实验结果表明,通道的第一顺序略好于空间第一顺序。
参考
论文: CBAM: Convolutional Block Attention Module
GitHub模型: https://github.com/zhangkaifang/CBAM-TensorFlow2.0
参考博文:https://blog.youkuaiyun.com/qq_14845119/article/details/81393127
由于博主能力有限,内容大多引自网络博客,并未严格考证如有错误之处望予以指出,后续也会逐步修正和补充一些实现后的代码。


 419


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


