


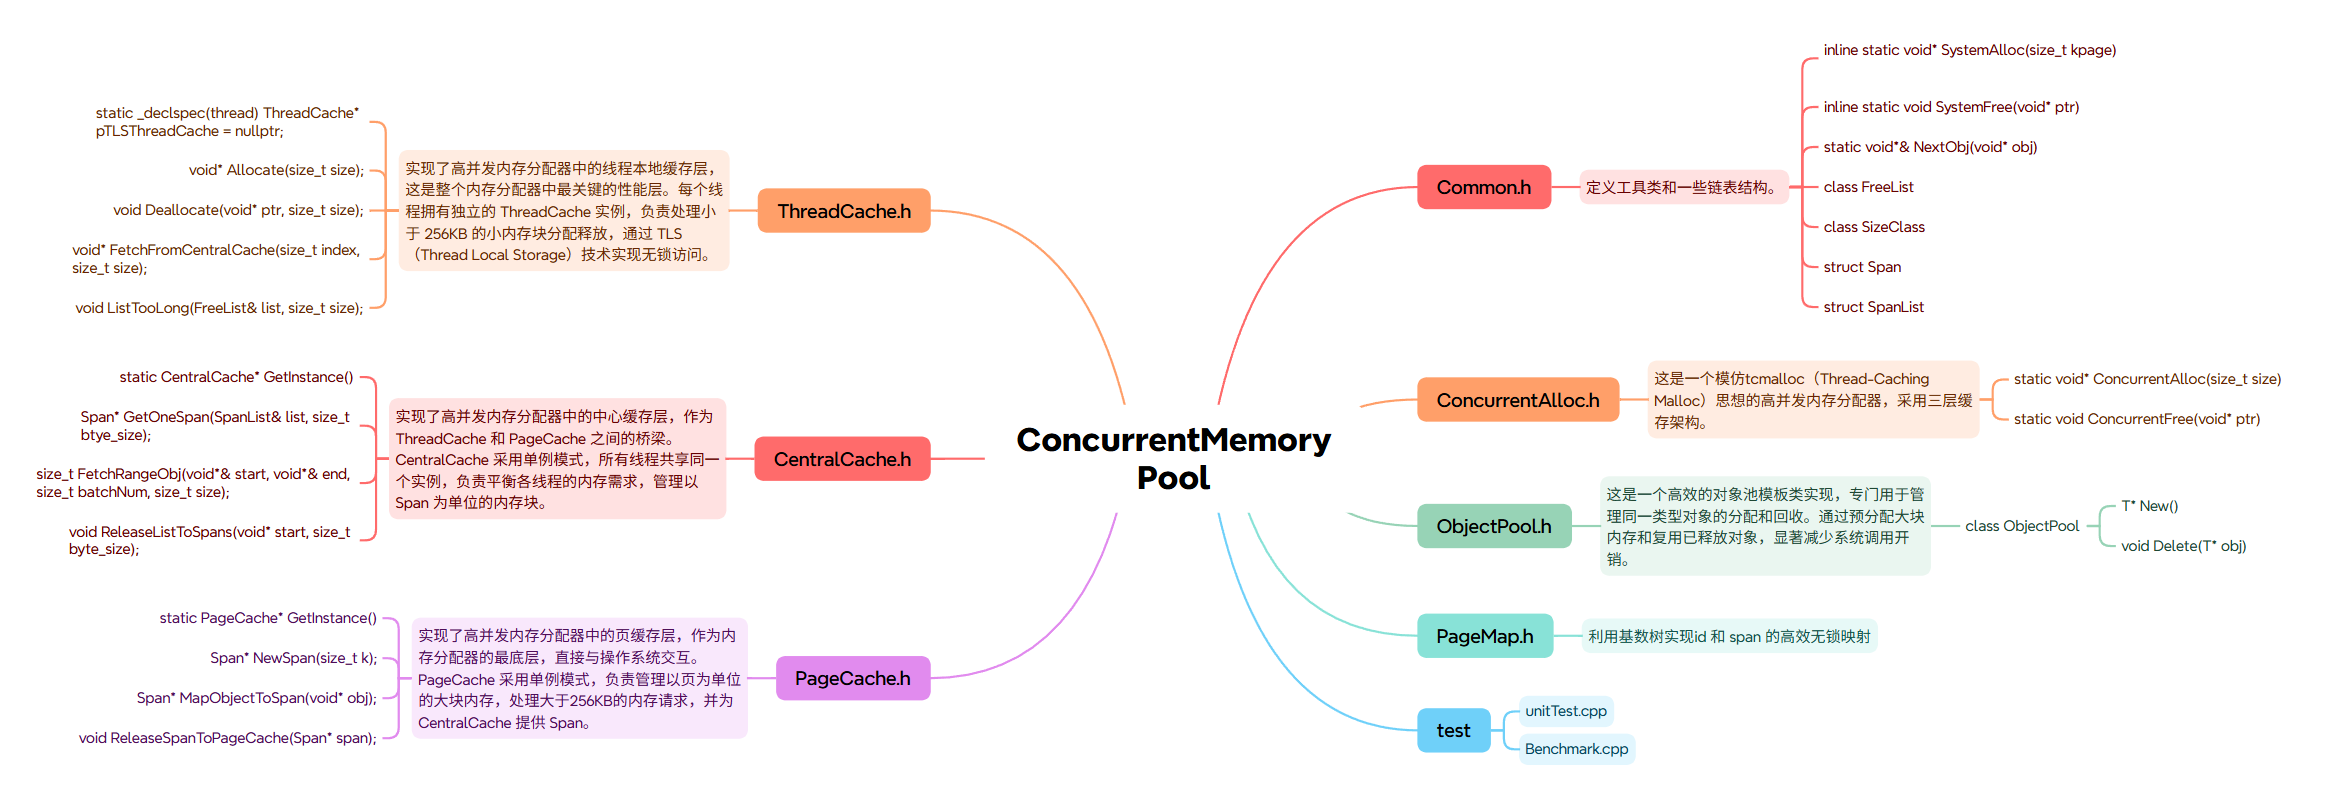
一.项目介绍
1.这个项目做的是什么?
本项目旨在实现一个高并发内存池,其原型是 Google 的开源项目 "tcmalloc"。tcmalloc 全称 Thread-Caching Malloc,即线程缓存的 malloc,它实现了高效的多线程内存管理,用于替代系统的内存分配相关函数(如 malloc、free)。本项目将 tcmalloc 最核心的框架简化后提取出来,模拟实现一个自己的高并发内存池,目的是学习 tcmalloc 的精华部分,而非完全照搬。
tcamlloc源码: tcmalloc: TCMalloc (google-perftools) 是用于优化C++写的多线程应用,比glibc 2.3的malloc快。这个模块可以用来让MySQL在高并发下内存占用更加稳定。 https://gitee.com/mirrors/tcmalloc
2.这个项目的要求的知识储备
2.1什么是内存池
“池化技术”是一种通过预先向系统申请并维护一定数量资源,以提升程序运行效率的优化策略。由于某些资源的申请和释放过程开销较大,频繁操作会影响性能,因此池化技术会在初始化阶段提前获取超过当前需要的资源量,并统一管理,形成资源池。当程序需要使用资源时,直接从池中获取,用完后归还,避免重复申请和释放的系统开销,从而显著提高响应速度和处理效率。
在计算机系统中,池化技术应用广泛,除了内存池之外,还包括连接池、线程池、对象池等。以服务器中的线程池为例,其工作机制是:系统预先创建多个线程并使其处于等待状态;当接收到客户端请求时,从线程池中分配一个空闲线程来处理该请求;请求处理完成后,线程并不销毁,而是再次回到池中等待下一次任务,从而避免线程频繁创建与销毁的开销,提升系统整体性能和资源利用率。
2.2.内存池
内存池是一种内存管理优化策略。其核心思路是程序在启动时,预先向操作系统申请一大块连续的内存区域进行统一管理。此后,当程序内部需要分配内存时,并非每次都直接调用系统的内存分配函数,而是由内存池从其预先申请的大块内存中快速划出一部分来满足需求;同样,当程序释放内存时,也并非真正将内存交还给操作系统,而是将其标记为空闲并回收到内存池中,供后续分配使用。直到程序运行结束或到达特定时机(如内存池销毁时),才会将最初申请的那一整块内存整体归还给操作系统。
这种机制通过减少程序运行期间频繁向操作系统申请和释放内存的次数,有效避免了系统调用带来的开销和可能产生的内存碎片,从而显著提升了内存分配与回收的效率,并使得程序的内存使用行为更加稳定和可控。
2.3.内存池主要解决的问题
内存池的设计主要旨在解决两个核心问题:分配效率和内存碎片。
1. 提升分配效率
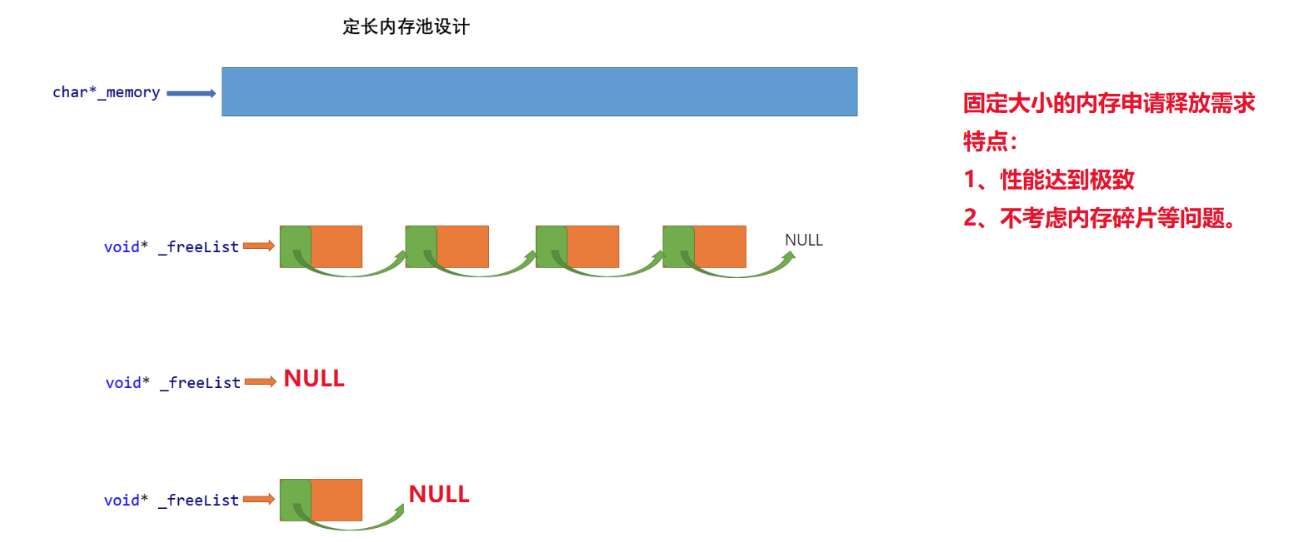
这是内存池最直接的目标。通过预先向操作系统批量申请一大块内存并自行管理,程序在运行时的内存分配与释放操作,就由原本昂贵的系统调用,转变为在用户态内存块中进行简单的指针移动或链表操作,从而大幅降低了每次分配的开销。
2. 缓解内存碎片
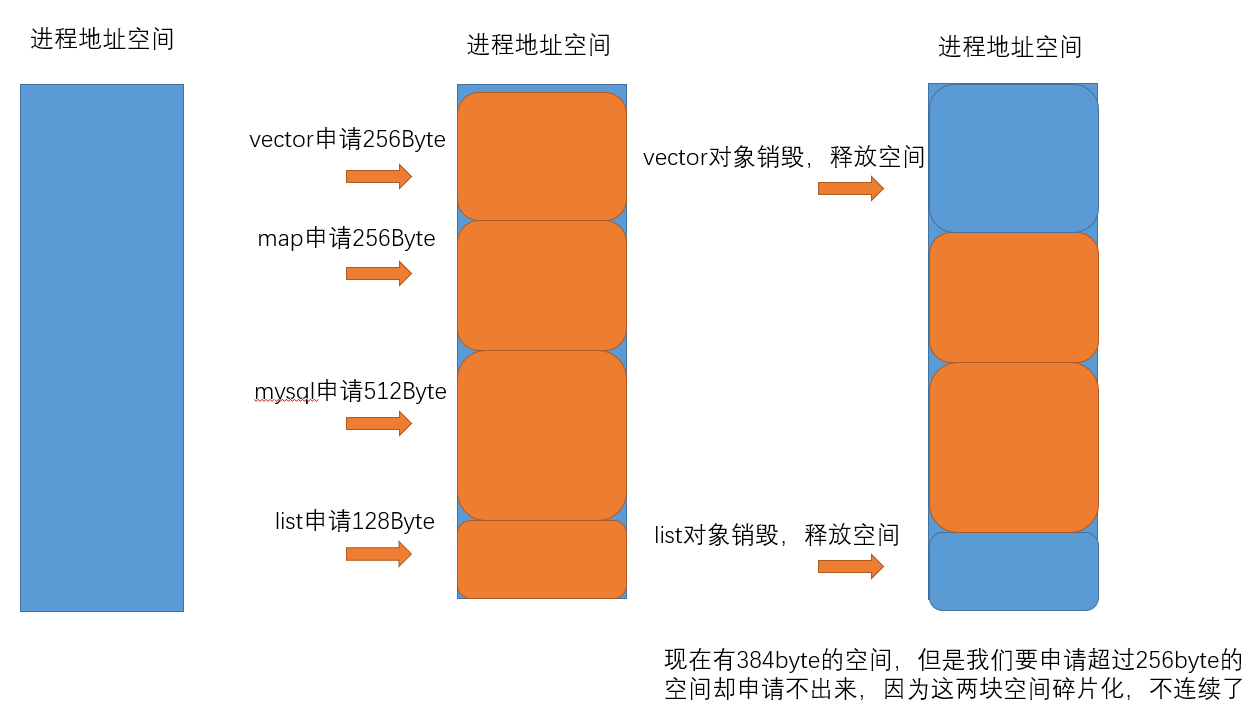
这是从系统内存分配器视角看的重要优势。内存碎片分为两种类型:
-
外部碎片:指系统中存在许多分散的、不连续的小块空闲内存。尽管这些空闲内存的总量可能足够大,但由于它们彼此不连续,无法合并成一个足以满足较大分配请求的连续空间,从而导致分配失败。内存池通过 “批发” 一大块连续内存并“零售”给程序使用,在池子内部进行分配管理,可以有效隔离程序内部的分配模式,减少对系统全局内存布局的冲击,从而显著降低外部碎片的产生。
-
内部碎片:指分配器为了满足内存对齐等要求,实际分配给程序的内存块尺寸略大于其请求的大小。这多出来的、已被分配但无法被程序实际使用的内存空间,就是内部碎片。内部碎片的产生与分配器的实现策略(如固定大小块、对齐值)紧密相关。在我们的后续项目中,将会具体观察到内存池实现中内部碎片的成因和表现,届时可以更直观地理解这一概念。
总而言之,内存池通过在用户空间建立一层中间管理层,以空间(预先占用内存)换时间(分配速度),并优化内存布局,从而系统性地改善了内存使用的性能与健康度。
2.4.malloc
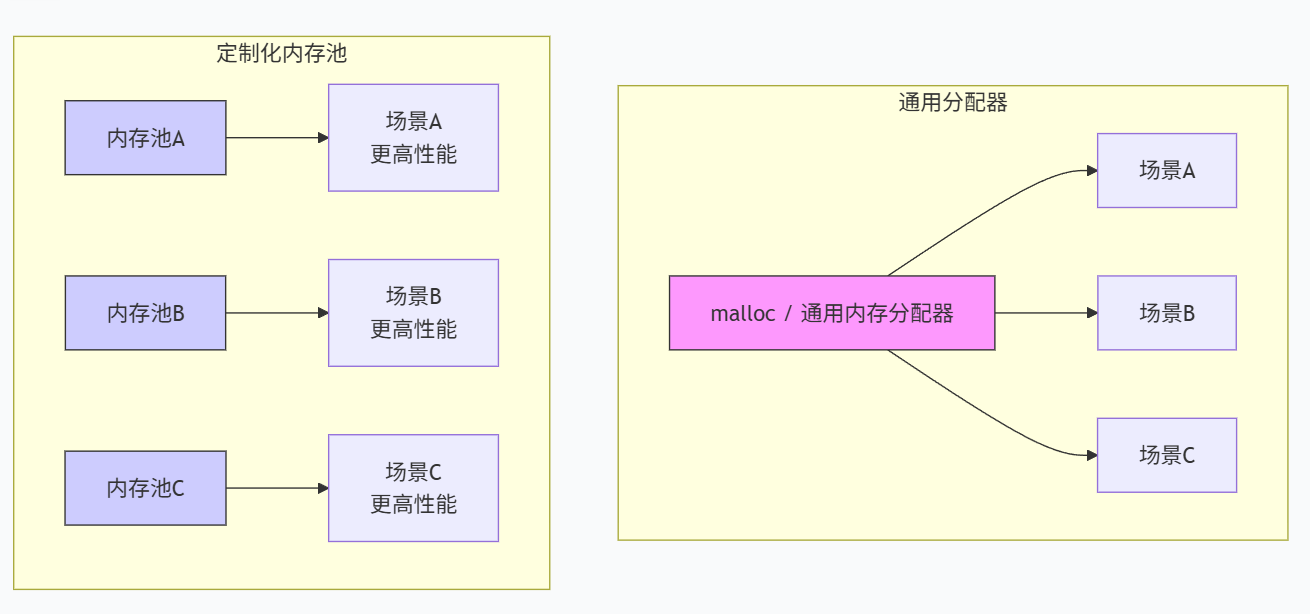
在C/C++中,我们通常使用 "malloc"来动态申请内存,但这并不意味着每次调用 `malloc` 都会直接从操作系统的堆中获取内存。实际上,"malloc" 本身就是一个高度优化、功能完整的内存池管理器。
我们可以把它理解为一个高效的“内存批发零售商”:它首先向操作系统“批发”一大块连续的内存区域作为库存。当程序需要分配内存时,"malloc" 并不是每次都去向操作系统“进货”,而是优先从其内部管理的“库存”(即内存池)中“零售”出所需大小的内存块给程序使用。只有当其内部库存无法满足需求(例如内存不足,或遇到了一个特别大的分配请求)时,它才会再次向操作系统申请扩充库存。同样,当程序调用 "free"释放内存时,内存通常只是被回收到 "malloc"的内部池中,以备后续重用,而非立即归还给操作系统。
不同平台和编译器环境下的 "malloc" 实现各不相同,它们都是经过深度优化的独立内存分配器。例如,Windows平台上Visual Studio使用的是微软自行实现的分配器;而在Linux系统下,GCC套件通常依赖glibc库中的 ptmalloc(pthreads malloc) 作为其默认分配器。这些分配器虽然核心思想相通,但在具体管理策略、多线程支持、性能和碎片处理上各有特点。
了解这些底层分配器(如ptmalloc)的设计,对于深入理解内存管理、性能调优和系统编程非常有帮助。在完成我们当前的内存池项目后,如果你对"malloc"如何高效地处理多线程竞争、减少碎片等细节感兴趣,可以进一步研究ptmalloc等工业级分配器的实现原理。
一文了解,Linux内存管理,malloc、free 实现原理 - 知乎

2.5 先设计⼀个定长的内存池
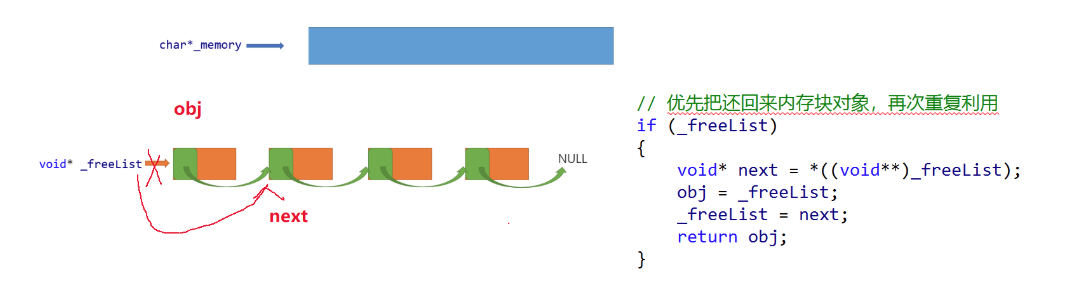
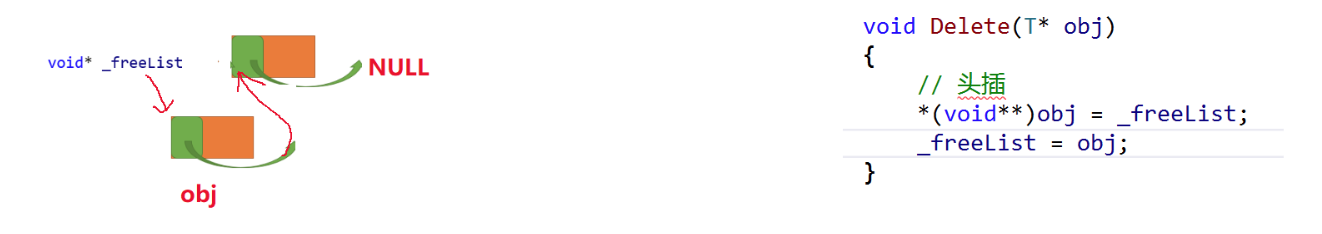
2.5.1 ObjectPool.h
#pragma once
#include "Common.h"

// 定长内存池
//template<size_t N>
//class ObjectPool
//{};

template<class T>
class ObjectPool
{
public:
	T* New()
	{
		T* obj = nullptr;

		// 优先把还回来内存块对象,再次重复利用
		if (_freeList)
		{
			void* next = *((void**)_freeList);
			obj = (T*)_freeList;
			_freeList = next;
		}
		else
		{
			// 剩余内存不够一个对象大小时,则重新开大块空间
			if (_remainBytes < sizeof(T))
			{
				//#ifdef _WIN64
				//	_remainBytes = 1048576; //1MB
				//#elif _WIN32
				//	_remainBytes = 128 * 1024;//128 kb
				//#endif
				//_memory = (char*)malloc(_remainBytes);


				_remainBytes = 128 * 1024; // 默认给 128KB
				if (sizeof(T) > _remainBytes) {

					// 如果对象本身超过 128KB,按对象大小申请
					_remainBytes = sizeof(T);
				}
				_memory = (char*)SystemAlloc(_remainBytes >> 13);
				if (_memory == nullptr)
				{
					throw std::bad_alloc();
				}
			}

			obj = (T*)_memory;
			size_t objSize = sizeof(T) < sizeof(void*) ? sizeof(void*) : sizeof(T);
			_memory += objSize;
			_remainBytes -= objSize;
		}

		// 定位new,显示调用T的构造函数初始化
		new(obj)T;

		return obj;
	}

	void Delete(T* obj)
	{
		// 显示调用析构函数清理对象
		obj->~T();

		// 头插
		*(void**)obj = _freeList;
		_freeList = obj;
	}

private:
	char* _memory = nullptr; // 指向大块内存的指针
	size_t _remainBytes = 0; // 大块内存在切分过程中剩余字节数

	void* _freeList = nullptr; // 还回来过程中链接的自由链表的头指针
};

//struct TreeNode
//{
//	int _val;
//	TreeNode* _left;
//	TreeNode* _right;
//
//	TreeNode()
//		:_val(0)
//		, _left(nullptr)
//		, _right(nullptr)
//	{}
//};
//
//void TestObjectPool()
//{
//	// 申请释放的轮次
//	const size_t Rounds = 5;
//
//	// 每轮申请释放多少次
//	const size_t N = 100000;
//
//	std::vector<TreeNode*> v1;
//	v1.reserve(N);
//
//	size_t begin1 = clock();
//	for (size_t j = 0; j < Rounds; ++j)
//	{
//		for (int i = 0; i < N; ++i)
//		{
//			v1.push_back(new TreeNode);
//		}
//		for (int i = 0; i < N; ++i)
//		{
//			delete v1[i];
//		}
//		v1.clear();
//	}
//
//	size_t end1 = clock();
//
//	std::vector<TreeNode*> v2;
//	v2.reserve(N);
//
//	ObjectPool<TreeNode> TNPool;
//	size_t begin2 = clock();
//	for (size_t j = 0; j < Rounds; ++j)
//	{
//		for (int i = 0; i < N; ++i)
//		{
//			v2.push_back(TNPool.New());
//		}
//		for (int i = 0; i < N; ++i)
//		{
//			TNPool.Delete(v2[i]);
//		}
//		v2.clear();
//	}
//	size_t end2 = clock();
//
//	cout << "new cost time:" << end1 - begin1 << endl;
//	cout << "object pool cost time:" << end2 - begin2 << endl;
//}
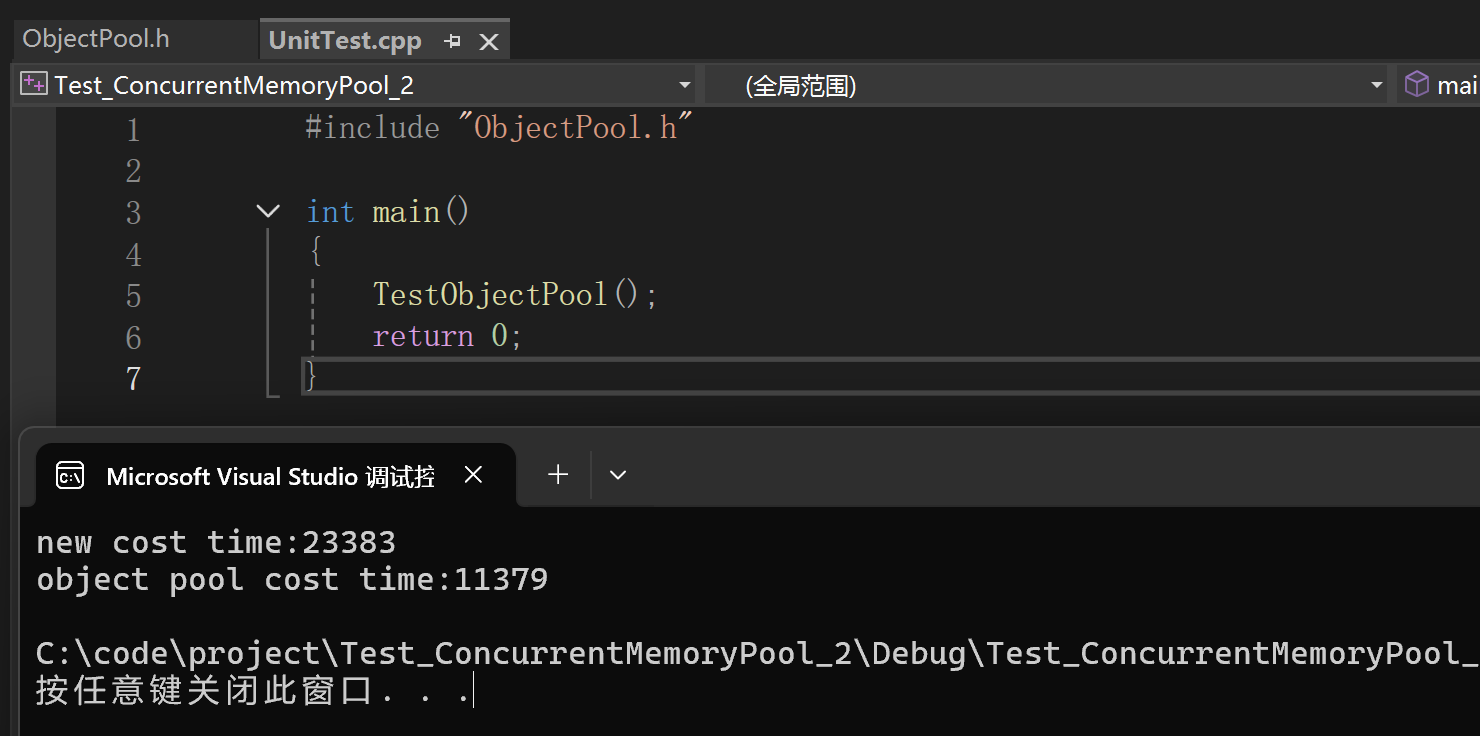
2.5.2 unitTest.cpp
#include "ObjectPool.h"

int main()
{
	TestObjectPool();
	return 0;
}
二.高并发内存池整体框架设计
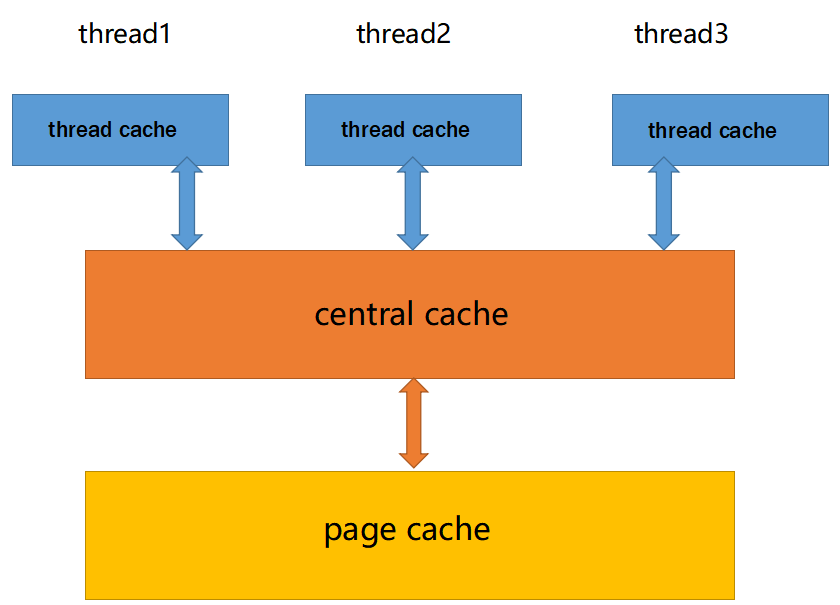
1. 线程缓存(Thread Cache)
线程缓存是每个线程独享的内存缓存层,专门负责分配小于256KB的小内存块。由于每个线程都拥有自己独立的缓存,因此线程在此层级申请内存时无需加锁,极大地提高了高频小内存分配的效率,这是整个高并发内存池性能优异的关键设计。
2. 中心缓存(Central Cache)
中心缓存是所有线程共享的一层缓存,作为线程缓存的上游供给源。当线程缓存中的内存不足时,会以批次为单位向中心缓存申请补充。同时,中心缓存也会在适当时机(例如线程缓存空闲对象过多时)回收部分内存,以实现不同线程之间的内存负载均衡,避免出现单个线程过度占用内存资源的情况。中心缓存存在线程竞争,因此访问时需要加锁,但通过桶锁(每个内存大小规格独立加锁) 以及低频的交互(仅在线程缓存不足时访问),锁竞争的激烈程度得以有效控制。
3. 页缓存(Page Cache)
页缓存是更底层的缓存,以系统内存页为单位进行内存的管理与分配。当中心缓存需要补充内存时,页缓存会分配若干连续的页(组成一个Span)给中心缓存,由中心缓存将其进一步切割成特定大小的小块内存对象。页缓存的核心作用之一是合并物理相邻的空闲页。当中心缓存中某个Span的所有内存块都被归还后,页缓存会回收该Span,并尝试将其与相邻的空闲页合并,形成更大的连续内存空间,从而有效减少外部内存碎片,提升大块连续内存的可用性。
这种三层递进式结构(Thread Cache → Central Cache → Page Cache)共同构成了一个兼顾线程局部效率与全局内存均衡的高并发内存管理体系。
三.Thread cache
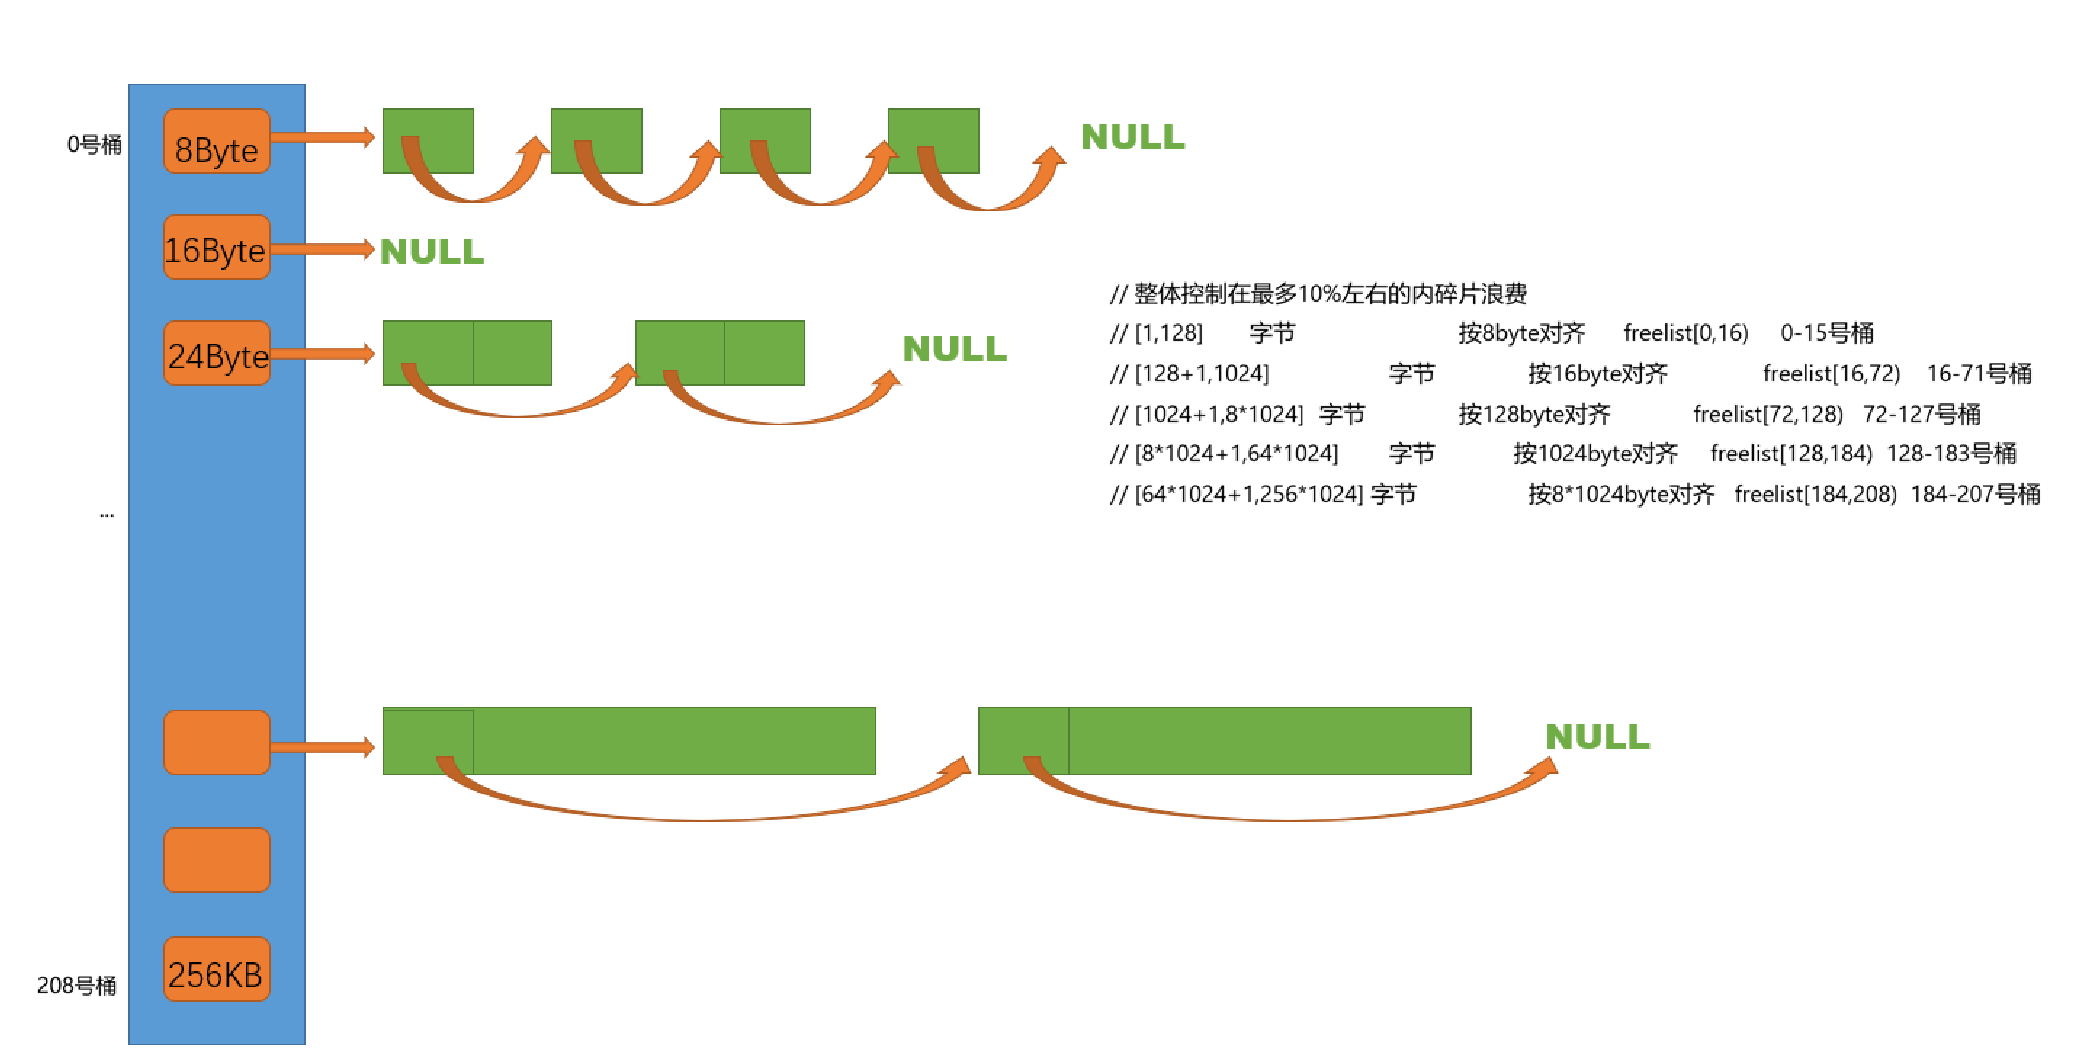
1.FreeList
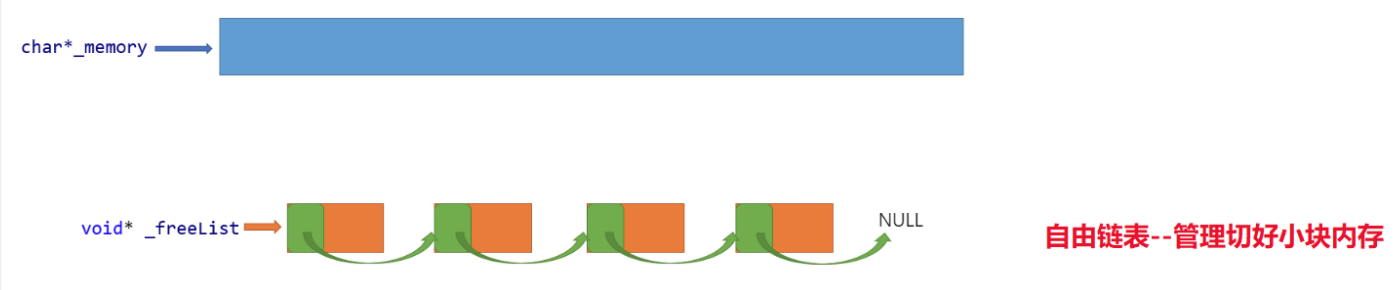
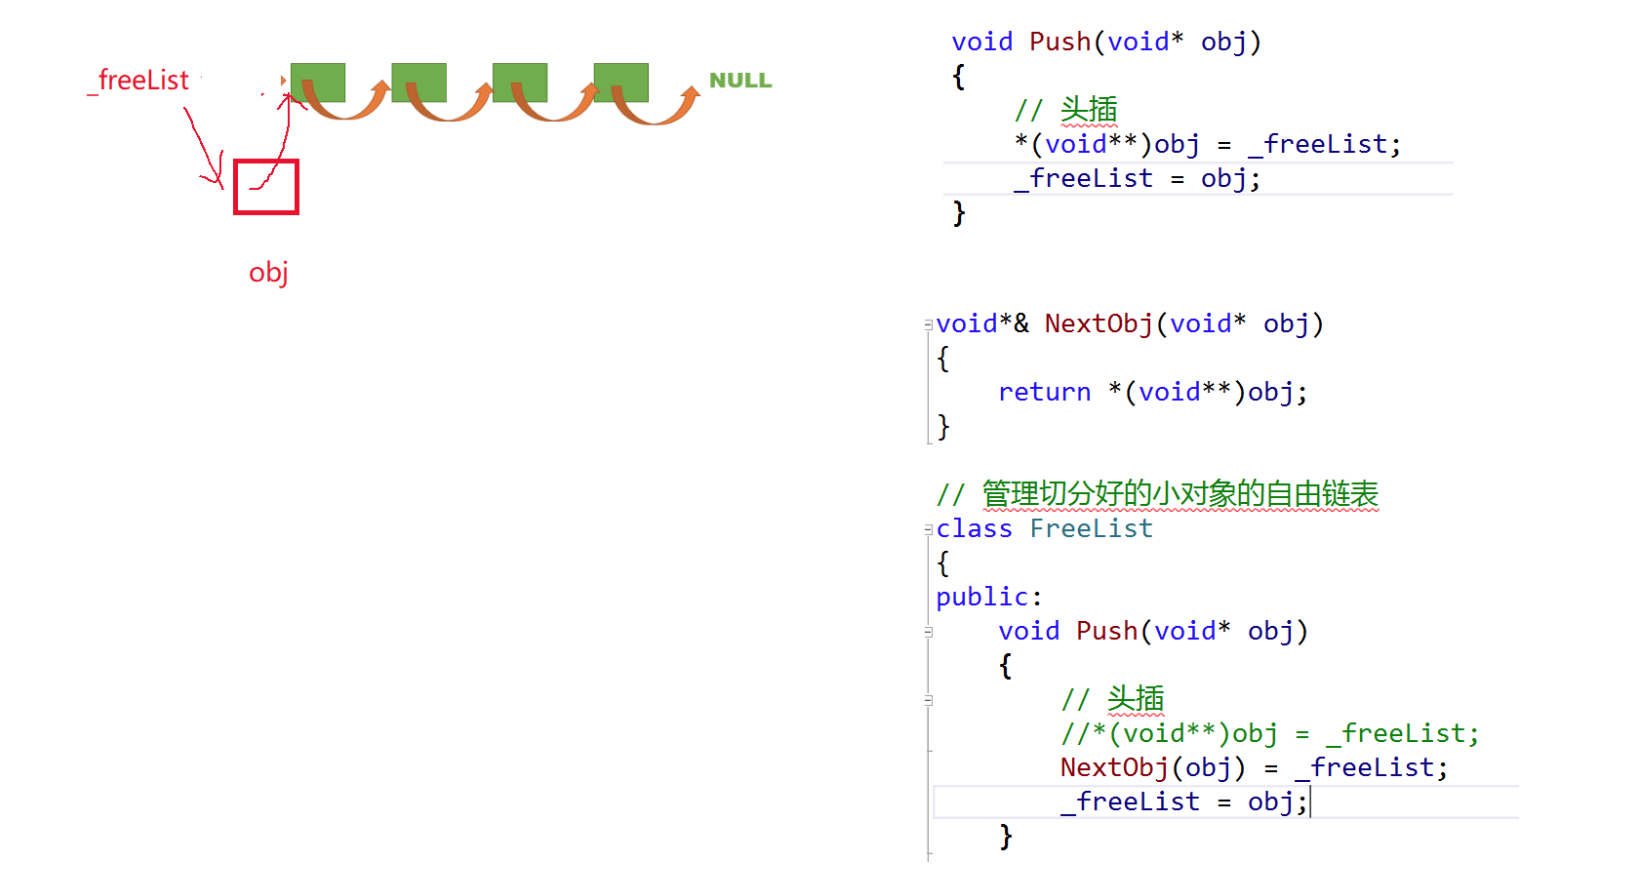
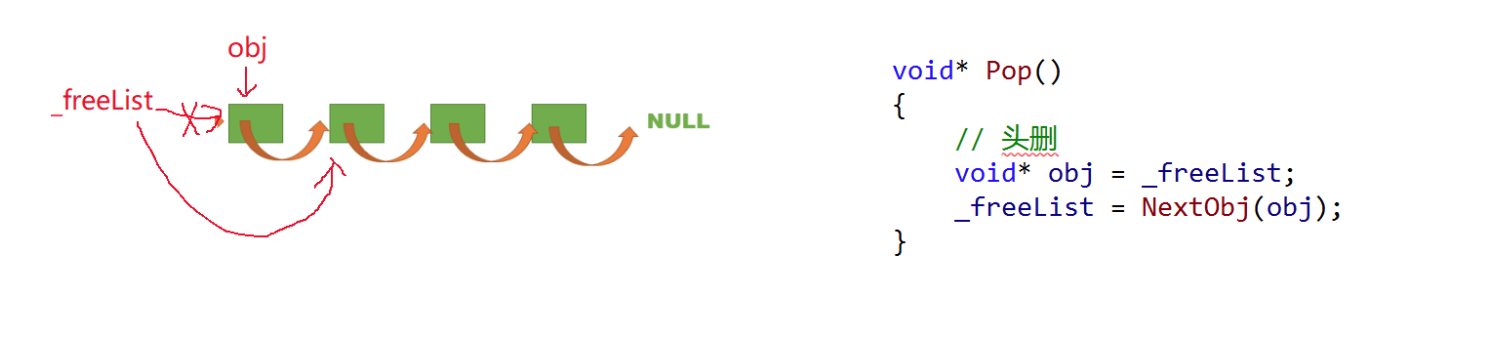
//管理切分好的小对象的自由链表
class FreeList
{
private:
	void* _freeList = nullptr;
	size_t _maxSize = 1;
	size_t _size = 0;
public:
	void Push(void* obj)
	{
		assert(obj);
		//头插
		//*((void**)obj) = _freeList;
		NextObj(obj) = _freeList;
		_freeList = obj;
		++_size;
	}

	void PushRange(void* start, void* end, size_t n)
	{
		NextObj(end) = _freeList;
		_freeList = start;
		_size += n;
	}
	void PopRange(void*& start, void*& end, size_t n)
	{
		assert(n <= _size);
		start = _freeList;
		end = start;

		for (size_t i = 0; i < n - 1; ++i)
		{
			//end往后移动
			end = NextObj(end);
		}
		_freeList = NextObj(end);
		NextObj(end) = nullptr;
		_size -= n;
	}
	void* Pop()
	{
		assert(_freeList);
		//头删
		void* obj = _freeList;
		_freeList = NextObj(obj);
		--_size;
		return obj;
	}
	bool Empty()
	{
		return _freeList == nullptr;
	}
	size_t& MaxSize()
	{
		return _maxSize;
	}
	size_t Size()
	{
		return _size;
	}
};
2.申请内存
void* ThreadCache::Allocate(size_t size)
{
	//size 必须小于 256kb
	assert(size <= MAX_BYTES);
	//对齐大小
	size_t alignSize = SizeClass::RoundUp(size);
	//对应哪个桶
	size_t index = SizeClass::Index(size);

	//如果⾃由链表_freeLists[i]中有对象,则直接Pop⼀个内存对象返回
	if (!_freeLists[index].Empty())
	{
		return _freeLists[index].Pop();
	}
	//如果_freeLists[i]中没有对象时,则批量从central cache中获取⼀定数量的对象,插⼊到⾃由链表并返回⼀个对象(当对象释放内存时候才会放入)
	else
	{
		return FetchFromCentralCache(index, alignSize);
	}
}
3.释放内存
void ThreadCache::Deallocate(void* ptr, size_t size)
{
	assert(ptr);
	assert(size <= MAX_BYTES);

	//找到对应映射的_freeList[index],将对象插入_freeList
	size_t index = SizeClass::Index(size);
	_freeLists[index].Push(ptr);

	//当链表长度大于一次批量申请的内存时候就开始还一段区间的对象给 central Cache
	if (_freeLists[index].Size() >= _freeLists[index].MaxSize())
	{
		ListTooLong(_freeLists[index], size);
	}
}


void ThreadCache::ListTooLong(FreeList& list, size_t size)
{
	void* start = nullptr;
	void* end = nullptr;
	list.PopRange(start, end, list.MaxSize());

	CentralCache::GetInstance()->ReleaseListToSpans(start, size);
}
4.利用TLS——thread local storage:
TLS 是一种机制,是一种变量的存储方法,这个变量在它所在的线程内是全局可访问的,但是不能被其他线程访问到,这样就保证了数据的线程独立性。
static _declspec(thread) ThreadCache* pTLSThreadCache = nullptr;
用法详细介绍:Thread Local Storage(线程局部存储)TLS - 知乎
4.1 TLS
TLS 是一种变量的存储机制,它使变量在每个线程中都有一个独立的实例。
普通全局变量:所有线程共享同一个变量,访问时必须加锁排队,否则会出现竞态条件。
TLS 变量:每个线程都拥有一份该变量的拷贝。线程 A 修改自己的 TLS 变量,线程 B 完全感知不到。这意味着访问 TLS 变量不需要加锁。
通常在 ( ConcurrentAlloc.h 或类似的头文件中)可以看到类似这样的定义:
// 典型的 TLS 定义方式 (Windows 环境)
static _declspec(thread) ThreadCache* pTLSThreadCache = nullptr;-
_declspec(thread):这是 MSVC 编译器提供的关键字,告诉操作系统和链接器,pTLSThreadCache指针是线程私有的。 -
初始化逻辑:当一个线程第一次申请内存(调用
ConcurrentAlloc)时,它会检查pTLSThreadCache是否为空。如果为空,则new一个ThreadCache对象赋值给它。
4.1.1 核心作用
(1) 实现“无锁化”申请内存
这是 TLS 最大的功劳。在没有 TLS 的情况下,所有线程申请内存都要去 CentralCache 或 PageCache 找一个全局链表加锁申请。 有了 TLS 后,每个线程都有自己的 ThreadCache:
-
线程申请小块内存时,直接从自己的
pTLSThreadCache对应的自由链表(FreeList)里取。 -
全过程无锁:因为这个
ThreadCache只有当前线程能访问,不存在竞争,速度极快。
(2) 解决“谁申请,谁拥有”的问题
通过 TLS,不需要在调用接口时显式传递 ThreadCache* 对象的指针。
-
用户只需要调用
ConcurrentAlloc(size)。 -
函数内部通过 TLS 自动识别当前线程对应的那个
ThreadCache。这使得内存池的接口(API)非常简洁,和标准的malloc一样。
4.1.2 底层原理
1. 内存布局原理:从“共有”到“私有”
在传统的编程模型中,全局变量存放在数据段(Data Segment),所有线程看到的地址空间是同一份。
-
普通全局变量:像是一个公共食堂,所有人(线程)必须在同一个窗口排队取饭(加锁)。
-
TLS 变量:操作系统在每个线程启动时,会在其控制块(TCB, Thread Control Block)中预留一块区域,专门存放该线程私有的变量副本。这就像是给每个员工都发了一个私有的微波炉,大家各自加热自己的饭菜,完全不需要排队。
2. 底层实现原理:段偏移寻址
在 x86/x64 架构下,TLS 的实现依赖于 CPU 的段寄存器(如 FS 或 GS 寄存器)。
-
当你声明
_declspec(thread)时,编译器并不会给它分配一个固定的全局内存地址。 -
相反,编译器会生成一段特殊的汇编指令:它首先读取
GS(64位下)寄存器中的基地址(这是当前线程的 TLS 基址),然后加上该变量在这个线程私有数据区中的偏移量。 -
即使代码里写的是同一个变量名
pTLSThreadCache,由于每个线程的GS寄存器指向的基地址不同,最终计算出的物理地址也不同。
3. 项目中的协同原理:生命周期绑定
TLS 在你代码中的具体运作逻辑如下:
-
惰性初始化: 当某个线程第一次调用
ConcurrentAlloc时,它会读取pTLSThreadCache指针。由于是该线程第一次读取,结果为nullptr。随后,该线程会new一个ThreadCache对象并存入这个私有地址。 -
无锁访问: 后续该线程再申请内存时,直接通过 TLS 获取到自己的
ThreadCache指针。因为这个指针只有当前线程能看到,所以它在操作内部的FreeList(自由链表)时,不需要使用任何std::mutex。这就是项目高性能的秘密。 -
回收机制: 在 Windows 系统下,当线程销毁时,操作系统会遍历该线程的 TLS 槽位。虽然你使用了原始指针,但可以通过线程退出时的清理回调来触发
ThreadCache的析构,将缓存的内存还给CentralCache。
总结 TLS 的“性能经”
-
原子性:TLS 将复杂的同步问题转化成了简单的地址偏移计算。
-
缓存友好性:每个线程的
ThreadCache数据在内存中是连续存放的,极大提高了 CPU 的缓存命中率。 -
低开销:访问 TLS 变量的开销仅比普通全局变量多一两行汇编指令,远远低于互斥锁(Mutex)或原子操作(Atomic)的开销。
一句话总结: TLS 原理就是利用硬件寄存器为每个线程开辟了一块“地址暗房”,让 ThreadCache 成了线程的“私人管家”,从而在分配内存的第一层彻底消灭了竞争。
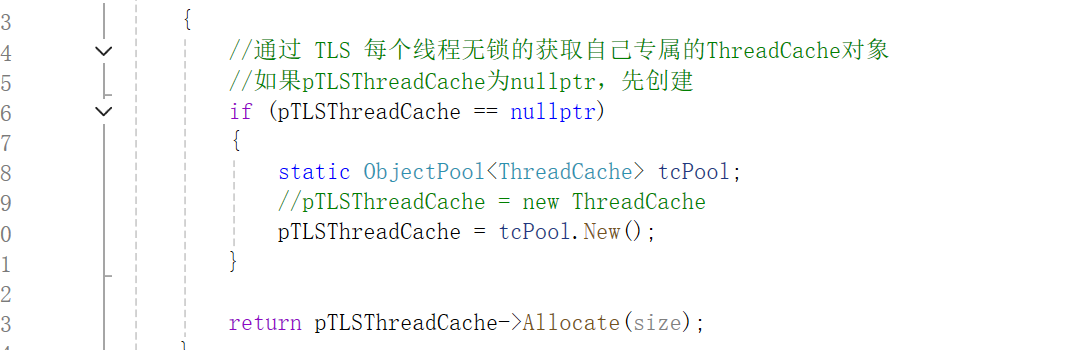
2.ConcurrentAlloc
3.ConcurrentFree
四.Central Cache
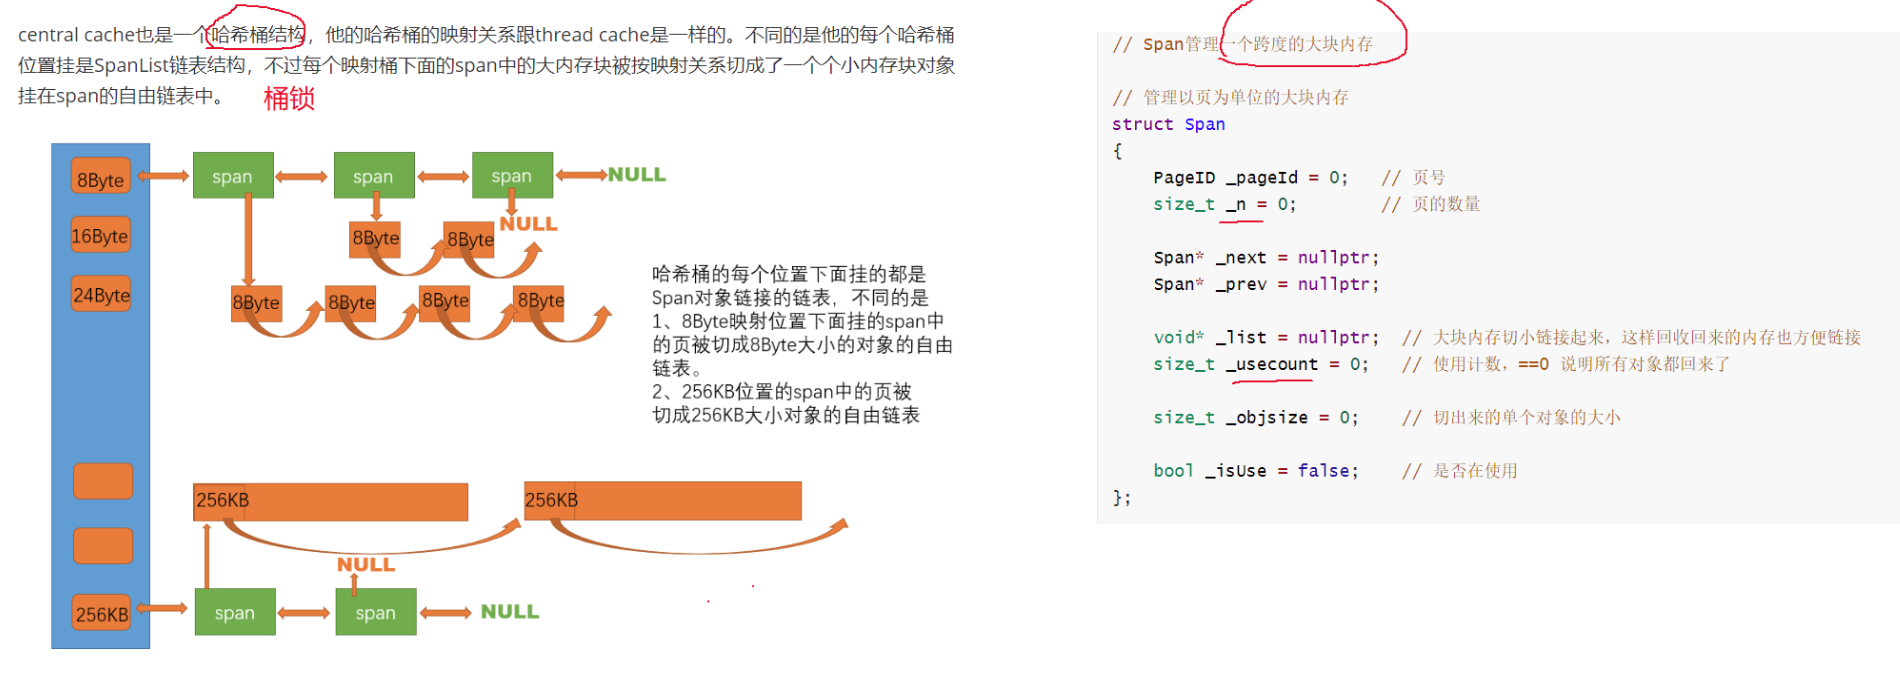
1.Span
//管理多个连续页大块内存跨度结构
struct Span
{
	PAGE_ID _pageId = 0;   //大块内存的起始页页号
	size_t _n = 0;		   //页的数量

	Span* _next = nullptr; // 双向链表结构
	Span* _prev = nullptr;

	size_t _objSize = 0;   //切好的小对象的大小
	size_t _useCount = 0;  //切好的小块内存,被分配给thread cache 的计数 便于回收
	void* _freeList = nullptr; //切好的小块内存的自由链表

	bool _isUse = false;   //是否在被使用
};
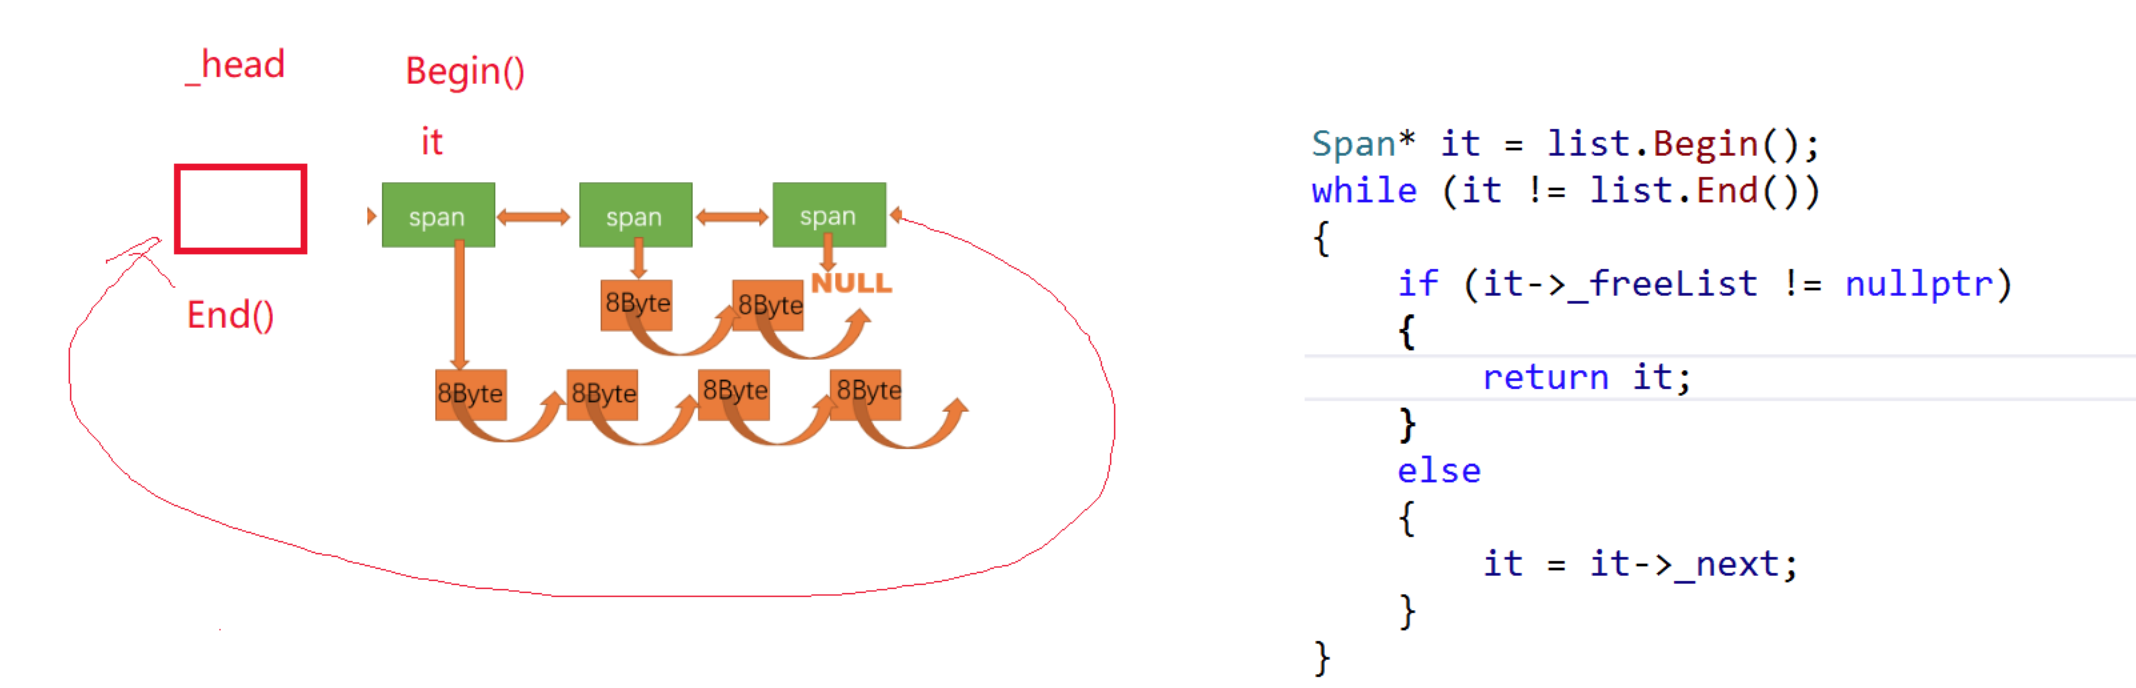
2.SpanList
// 带头双向循环链表
class SpanList
{
public:
	SpanList()
	{
		_head = new Span;
		_head->_next = _head;
		_head->_prev = _head;
	}

	Span* Begin()
	{
		return _head->_next;
	}

	Span* End()
	{
		return _head;
	}

	bool Empty()
	{
		return _head->_next == _head;
	}

	void PushFront(Span* span)
	{
		Insert(Begin(), span);
	}

	Span* PopFront()
	{
		Span* front = _head->_next;
		Erase(front);
		return front;
	}

	void Insert(Span* pos, Span* newSpan)
	{
		assert(pos);
		assert(newSpan);

		Span* prev = pos->_prev;
		// prev newspan pos
		prev->_next = newSpan;
		newSpan->_prev = prev;
		newSpan->_next = pos;
		pos->_prev = newSpan;
	}

	void Erase(Span* pos)
	{
		assert(pos);
		assert(pos != _head);

		Span* prev = pos->_prev;
		Span* next = pos->_next;

		prev->_next = next;
		next->_prev = prev;
	}

private:
	Span* _head;
public:
	std::mutex _mtx; // 桶锁
};
3.申请内存
3.1慢启动的策略
//一次给 thread cache 多少个内存块
static size_t NumMoveSize(size_t size)
{
	assert(size > 0);

	//[2, 512] 一次批量移动多少个对象的(慢启动)上限值
	//小对象一次批量上限高
	//大对象一次批量上限低
	int num = MAX_BYTES / size;
	if (num < 2)
		num = 2;
	if (num > 512)
		num = 512;
	return num;
}3.2 GetOneSpan
//获取一个非空的span
Span* CentralCache::GetOneSpan(SpanList& list, size_t size)
{
	//首先查看当前 spanlist 中是否还有未分配对象的 span
	//遍历当前spanlist

	Span* it = list.Begin();
	while (it != list.End())
	{
		if (it->_freeList != nullptr)
		{
			// 如果 span 当前的 _freeList != nullptr
			// 返回当前 span

			return it;
		}
		else
		{
			//继续往后遍历

			it = it->_next;
		}
	}

	//当前 spanlist 中没有空闲的 span , 只能找 Page Cache 申请
	//PageCache 加锁
	PageCache::GetInstance()->_pageMtx.lock();
	//PageCache NewSpan
	Span* span = PageCache::GetInstance()->NewSpan(SizeClass::NumMovePage(size));
	//span->_isUse 设置为 true
	span->_isUse = true;
	//记录 span->_objSize
	span->_objSize = size;

	//PageCache 解锁
	PageCache::GetInstance()->_pageMtx.unlock();

	//对获取的 span 进行切分 (不需要加锁,因为其他线程不会访问到这个span)
	//计算 span 的大块内存的起始地址
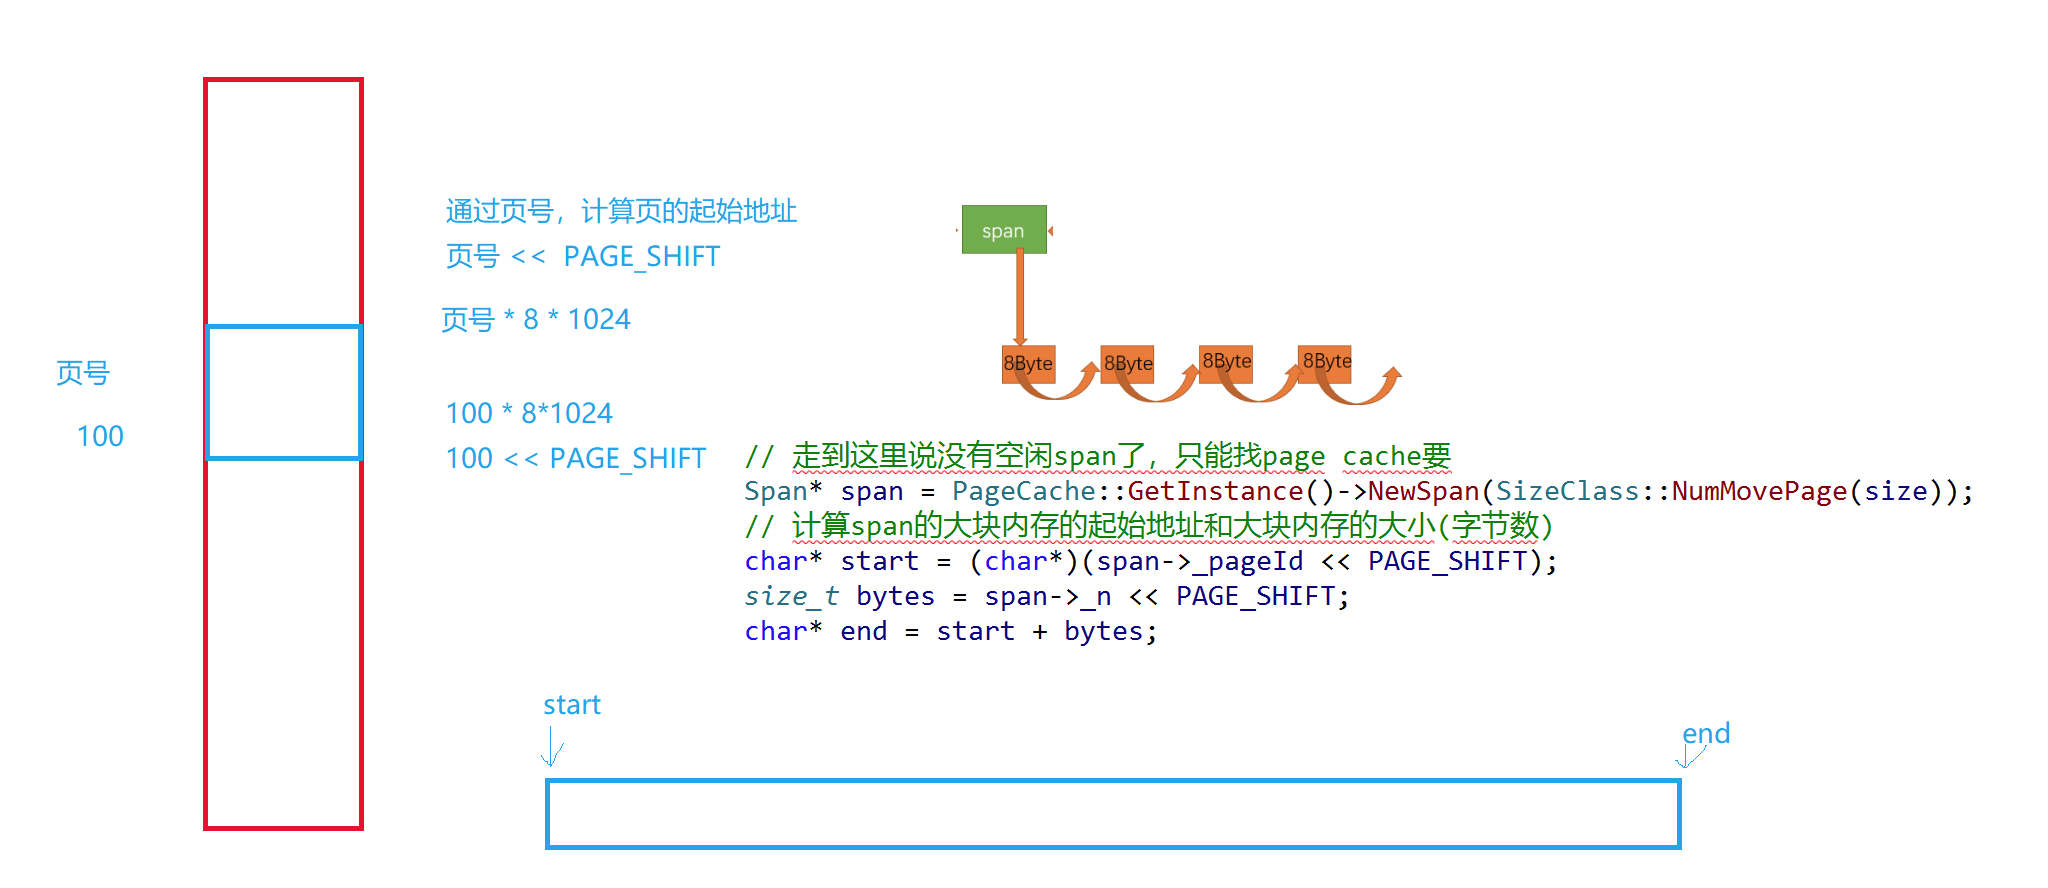
	char* start = (char*)(span->_pageId << PAGE_SHIFT);
	//计算 span 的大块内存的大小(字节数)
	size_t bytes = span->_n << PAGE_SHIFT;
	//计算 span 的大块内存的结束地址
	char* end = start + bytes;

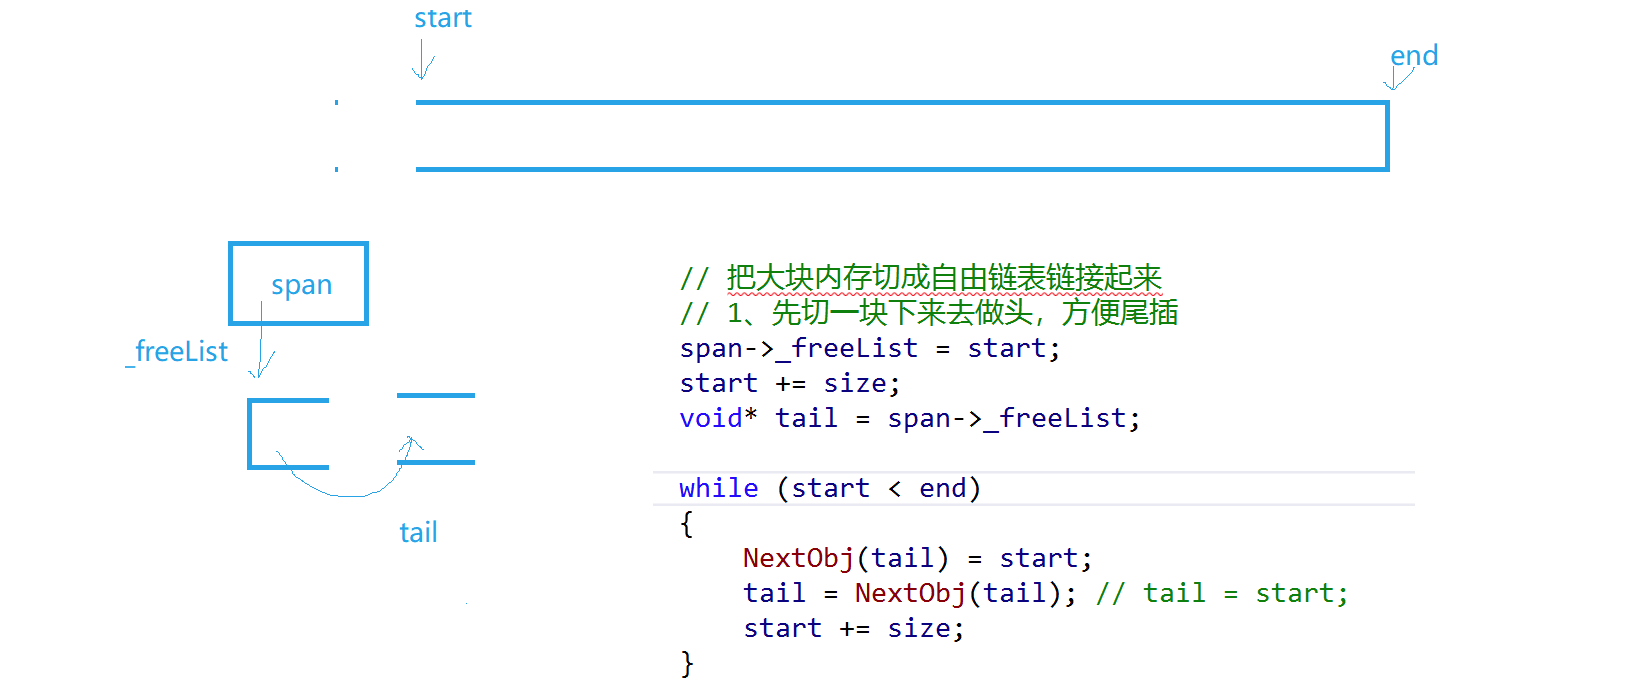
	//把大块内存切成自由链表链接起来
	//1.先切一块下来做头,方便尾插
	span->_freeList = start;
	start += size;
	void* tail = span->_freeList;
	int i = 1;//调试观察切了多少块
	while (start < end)
	{
		++i;
		NextObj(tail) = start;
		tail = NextObj(tail);
		start += size;
	}
	NextObj(tail) = nullptr;


	list.PushFront(span);
	//返回 span
	return span;
}
3.3 FetchRangeObj to the thread cache
//给一定数量的对象分配给 thread cache
size_t CentralCache::FetchRangeObj(void*& start, void*& end, size_t batchNum, size_t size)
{
	//计算映射位置
	size_t index = SizeClass::Index(size);
	//加锁获得一个span
	_spanLists[index]._mtx.lock();
	Span* span = GetOneSpan(_spanLists[index], size);
	//断言span 和 span->_freeList 一定存在
	assert(span);
	assert(span->_freeList);

	//从 span 中获取 batchNum 个对象
	//如果不够 batchNum个,有多少拿多少
	start = span->_freeList;
	end = start;
	size_t i = 0;
	//定义actualNum
	size_t actualNum = 1;
	//循环取对象
	while (i < batchNum - 1 && NextObj(end) != nullptr)
	{
		end = NextObj(end);
		++i;
		++actualNum;
	}
	//循环结束后 end 的 next 作为 span->_freeList 新的头
	span->_freeList = NextObj(end);
	//把 end 的 next 置成空
	NextObj(end) = nullptr;
	//span->_useCount增加
	span->_useCount += actualNum;

	//_spanLists 该位置解锁
	_spanLists[index]._mtx.unlock();
	//返回 actualNum
	return actualNum;
}
4.释放内存
1. 当 thread_cache 过长或者线程销毁,则会将内存释放回 central_cache 中。释放回来时--use_count,当 use_count 减到 0 时则表示所有对象都回到了 span,则将 span 释放回 page_cache,page_cache 中会对前后相邻的空闲页进行合并。

五.Page Cache
1.申请内存
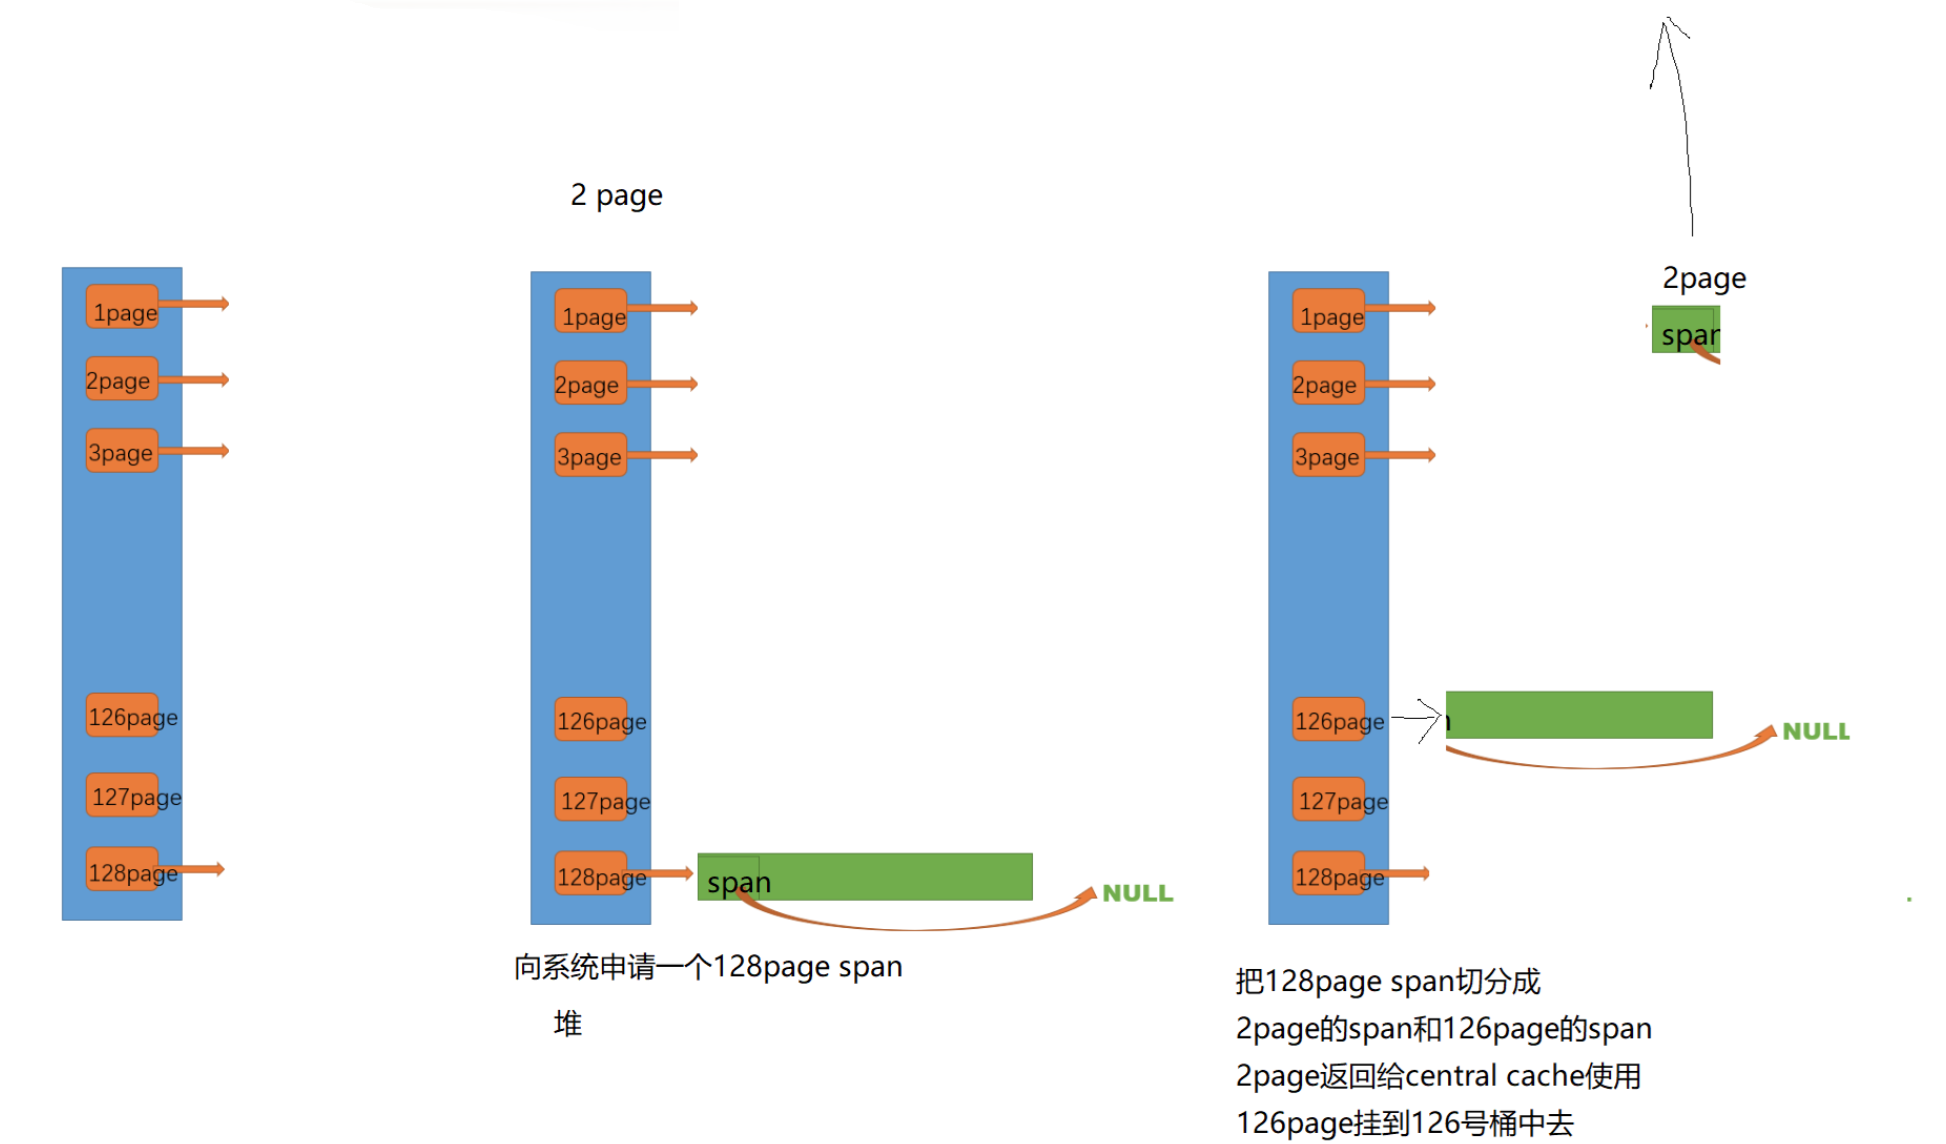
1. 当 central cache 向 page cache 申请内存时,page cache 先检查对应位置有没有 span,如果没有则向更大页寻找一个 span,如果找到则分裂成两个。比如:申请的是 4 页 page,4 页 page 后面没有挂 span,则向后面寻找更大的 span,假设在 10 页 page 位置找到一个 span,则将 10 页 page span 分裂为一个 4 页 page span 和一个 6 页 page span。
2. 如果找到 _spanList[128] 都没有合适的 span,则向系统使用 mmap、brk 或者是 VirtualAlloc 等方式申请 128 页 page span 挂在自由链表中,再重复 1 中的过程。
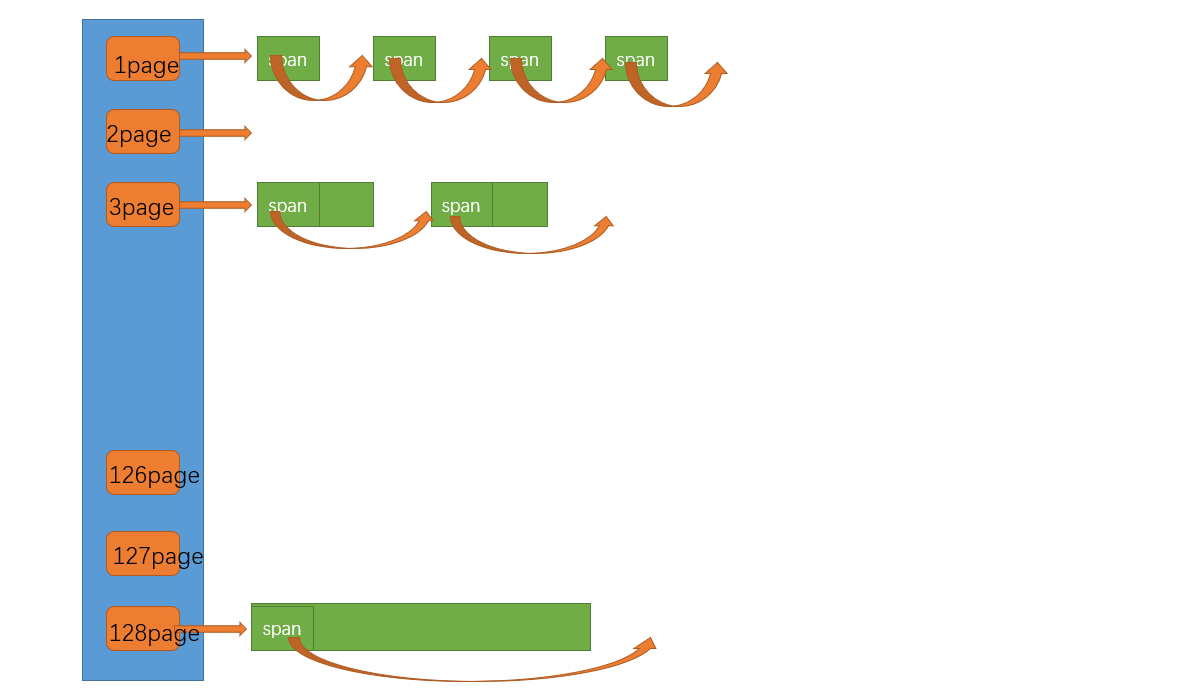
3. 需要注意的是 central cache 和 page cache 的核心结构都是 spanlist 的哈希桶,但是他们是有本质区别的,central cache 中哈希桶,是按跟 thread cache 一样的大小对齐关系映射的,它的 spanlist 中挂的 span 中的内存都被按映射关系切好链接成小块内存的自由链表。而 page cache 中的 spanlist 则是按下标桶号映射的,也就是说第 i 号桶中挂的 span 都是 i 页内存。
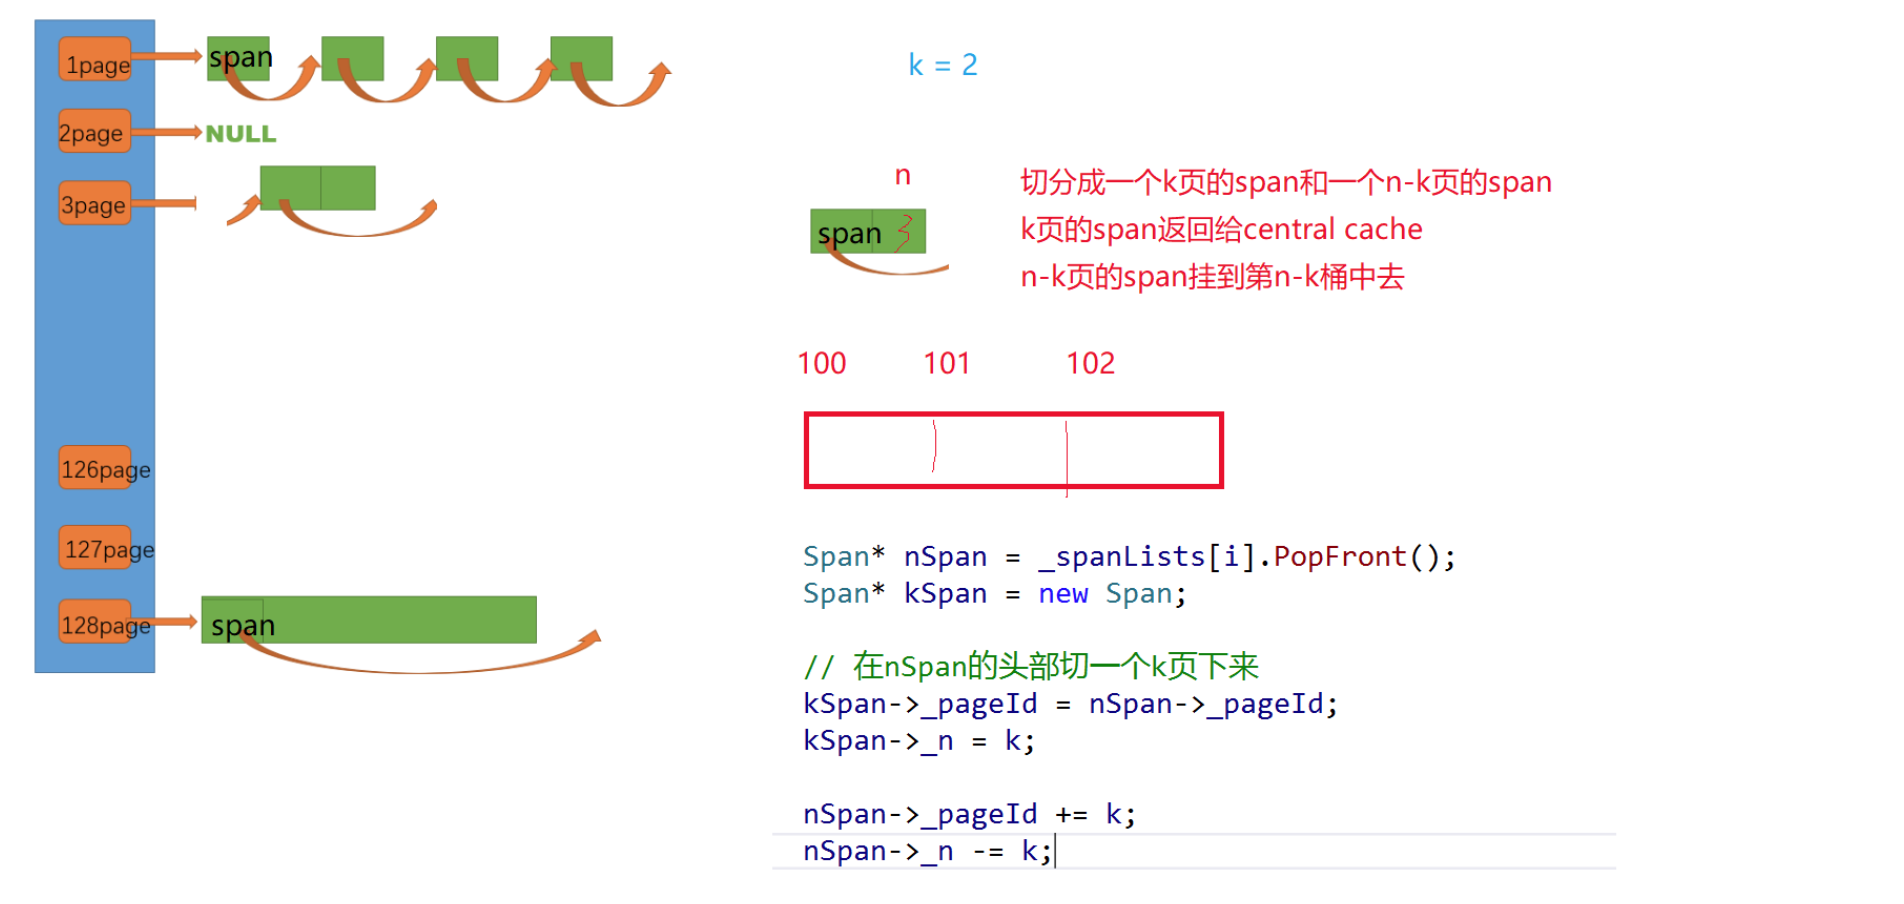
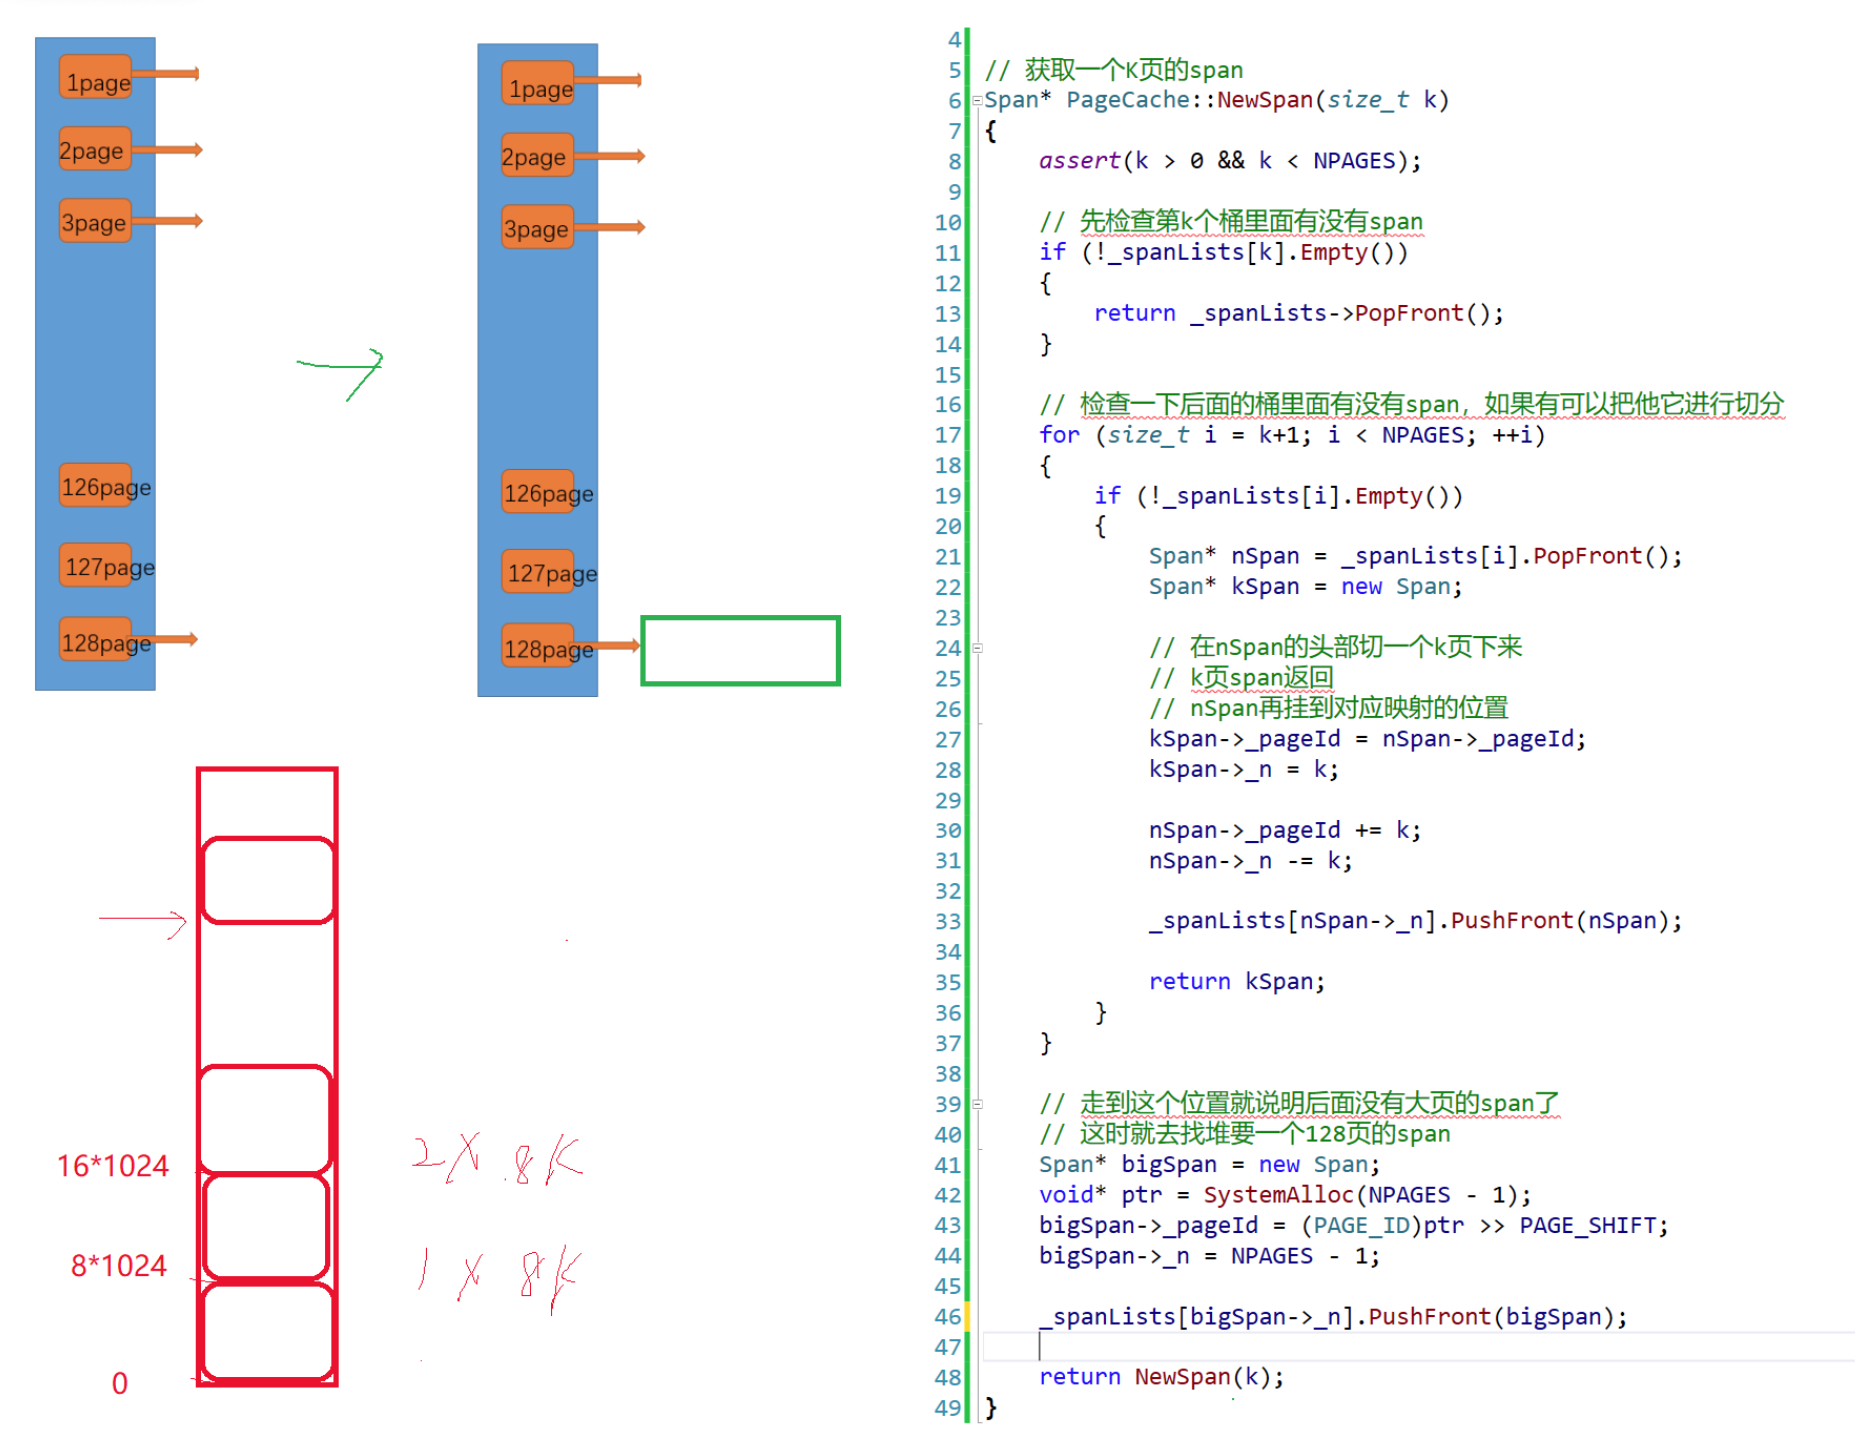
1.1 NewSpan
Span* PageCache::NewSpan(size_t k)
{
	assert(k > 0);

	//先检查第k个桶里面有没有span
	if (!_spanLists[k].Empty())
	{
		//如果有,弹出_spanLists[k]
		Span* kSpan = _spanLists[k].PopFront();
		return kSpan;
	}

	//遍历整个桶 , 检查后面的桶里面有没有 span ,如果有可以把它进行切分
	for (size_t i = k + 1; i < NPAGES; ++i)
	{
		if (!_spanLists[i].Empty())
		{
			//如果有 , 弹出 _spanLists[i]
			Span* nSpan = _spanLists[i].PopFront();
			Span* kSpan = new Span;

			//在 nSpan 的头部切 k 页下来
			// k 页 span 返回
			// nSpan 再挂到对应的映射位置
			//改变 kSpan->_pageId 和 kSpan->_n

			kSpan->_pageId = nSpan->_pageId;
			kSpan->_n = k;

			nSpan->_pageId += k;
			nSpan->_n -= k;

			_spanLists[nSpan->_n].PushFront(nSpan);

			return kSpan;

		}

	}

	//走到这个位置说明没有大页的span了
	//这时候就要去找堆要一个128页的span
	Span* bigSpan = new span;
	void* ptr = SystemAlloc(NPAGES - 1);
	bigSpan->_pageId = (PAGE_ID)ptr >> PAGE_SHIFT;
	bigSpan->_n = NPAGES - 1;

	//将 bigSpan 推入 _spanLists 中
	_spanLists[bigSpan->_n].PushFront(bigSpan);

	//递归 NewSpan
	return NewSpan(k);
}
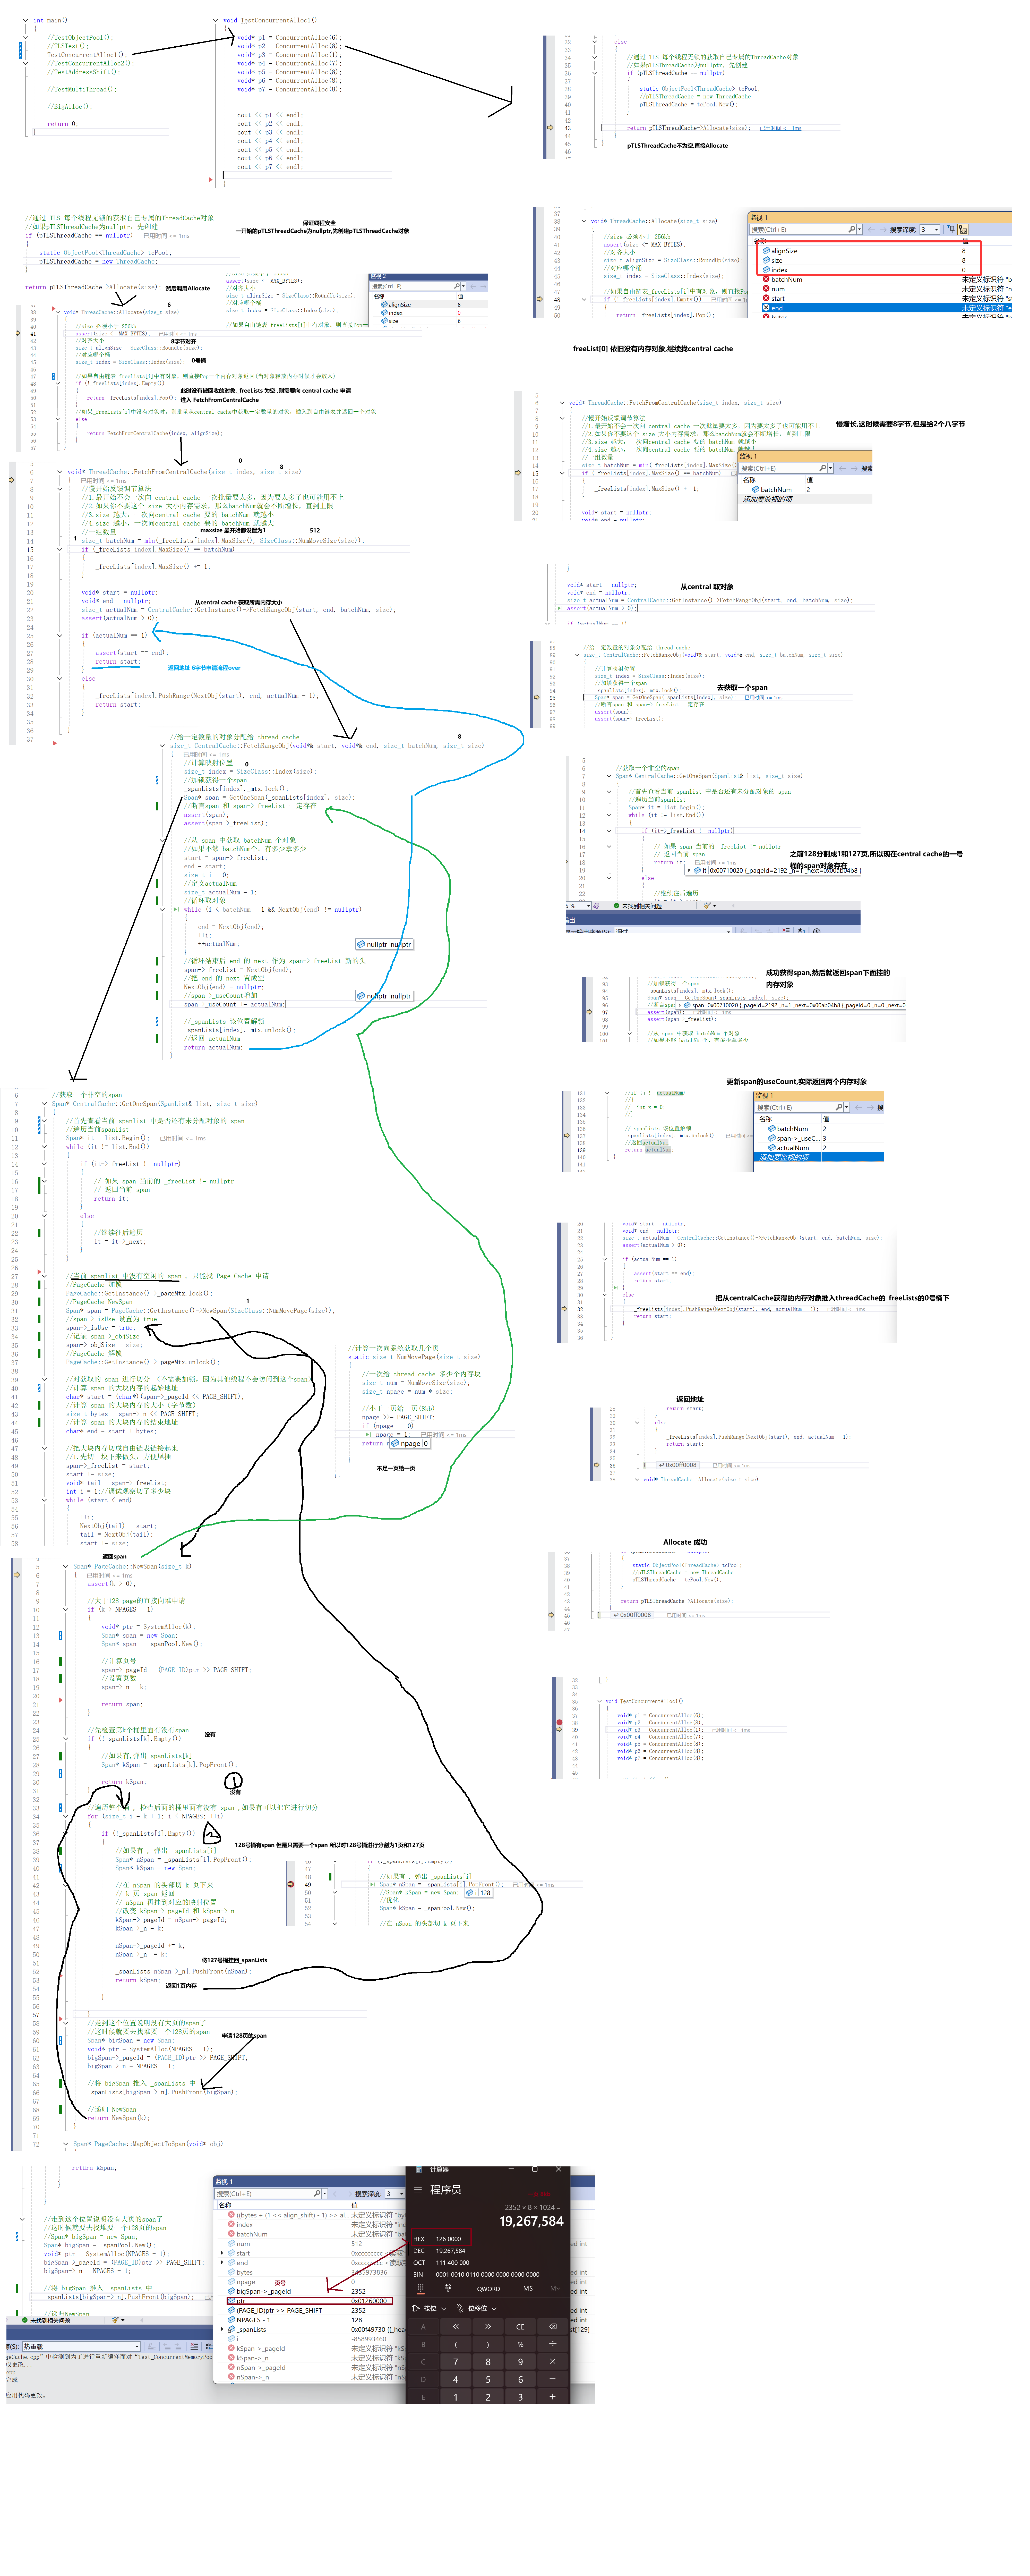
1.2 申请流程全过程调试测试
2.释放内存
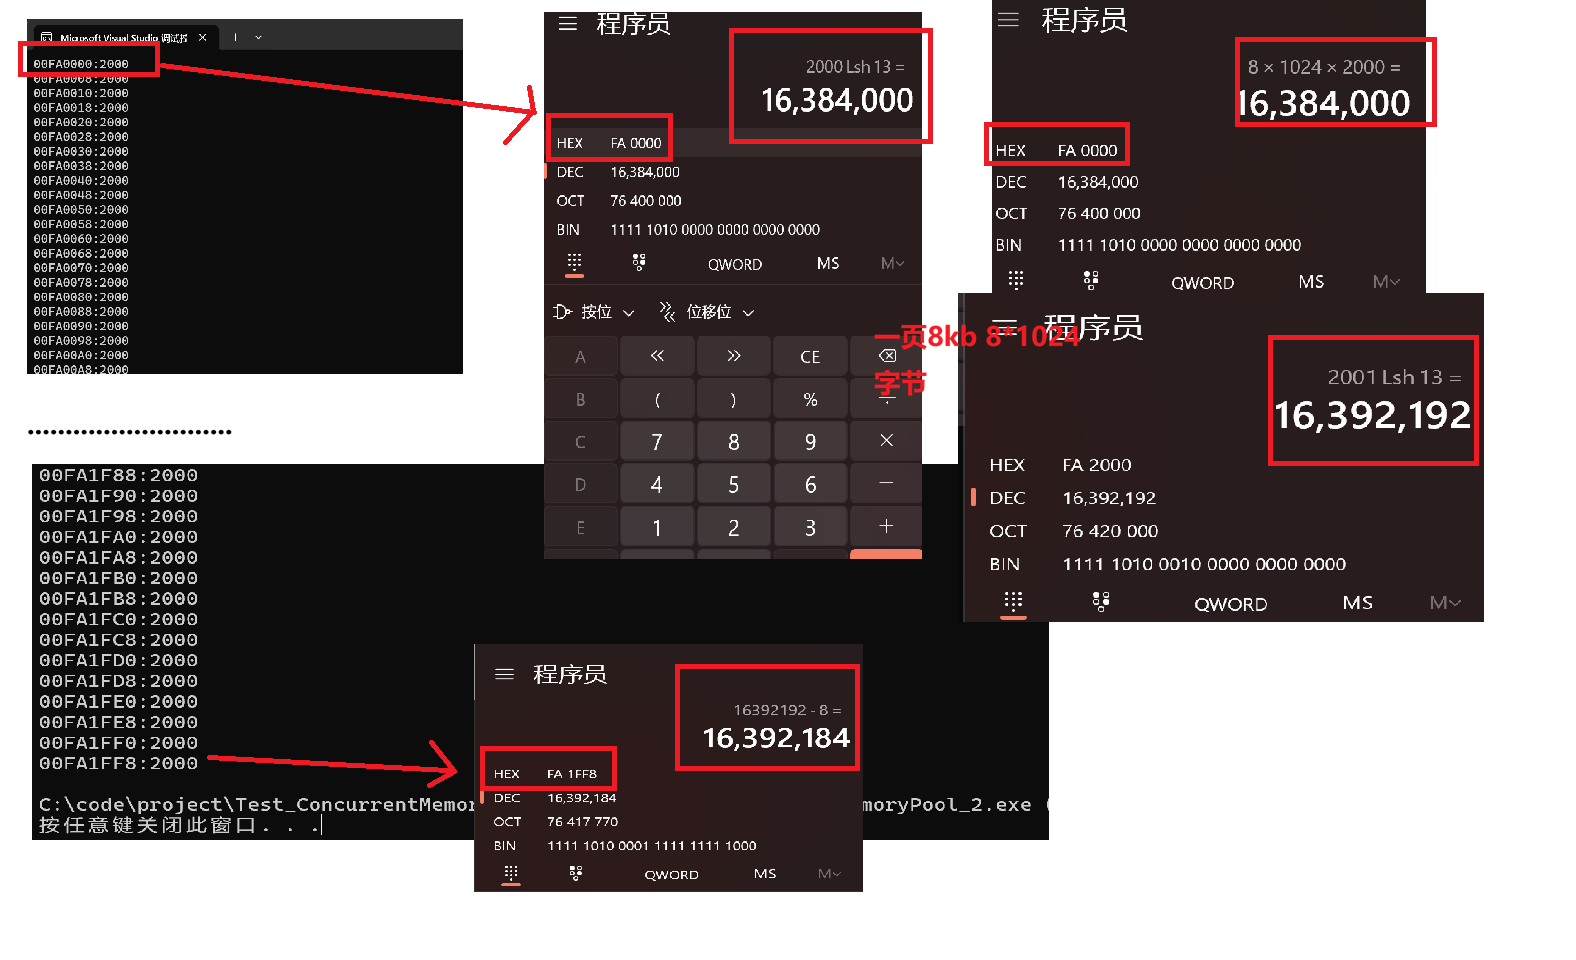
2.1 TestAddressShift
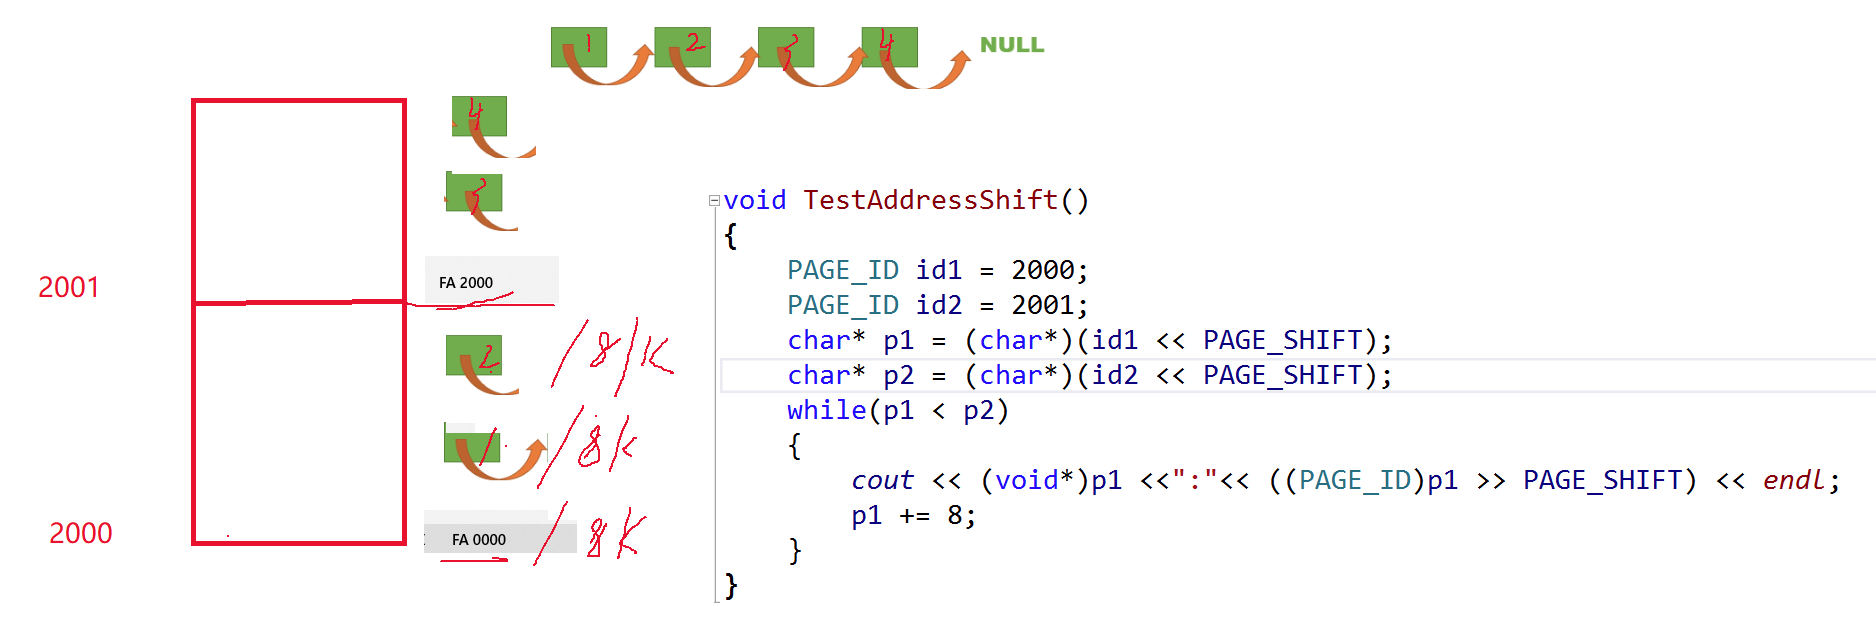
2.2 ReleaseSpanToPageCache
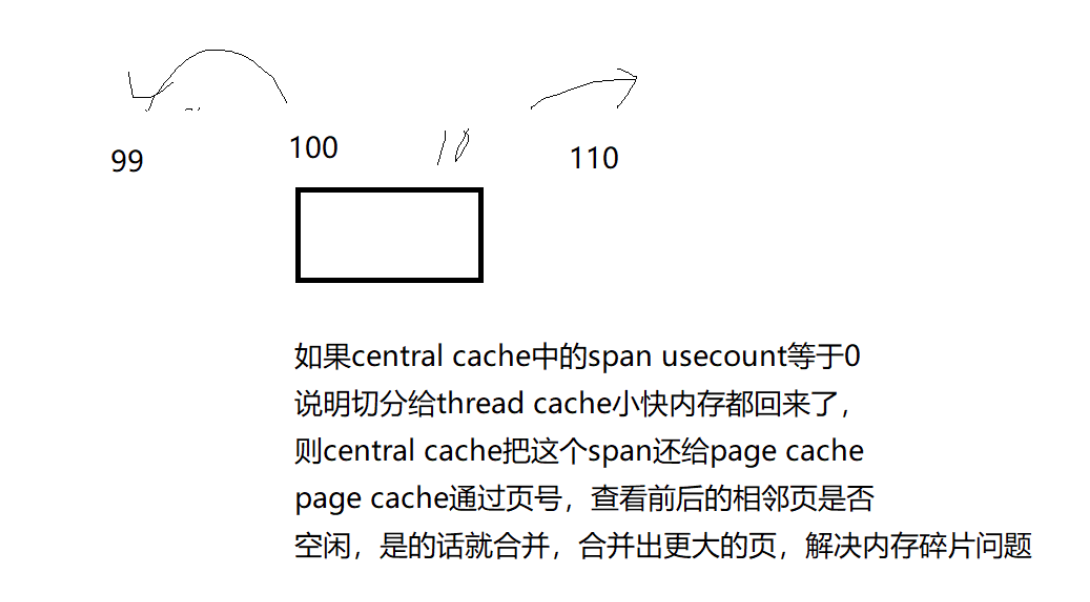
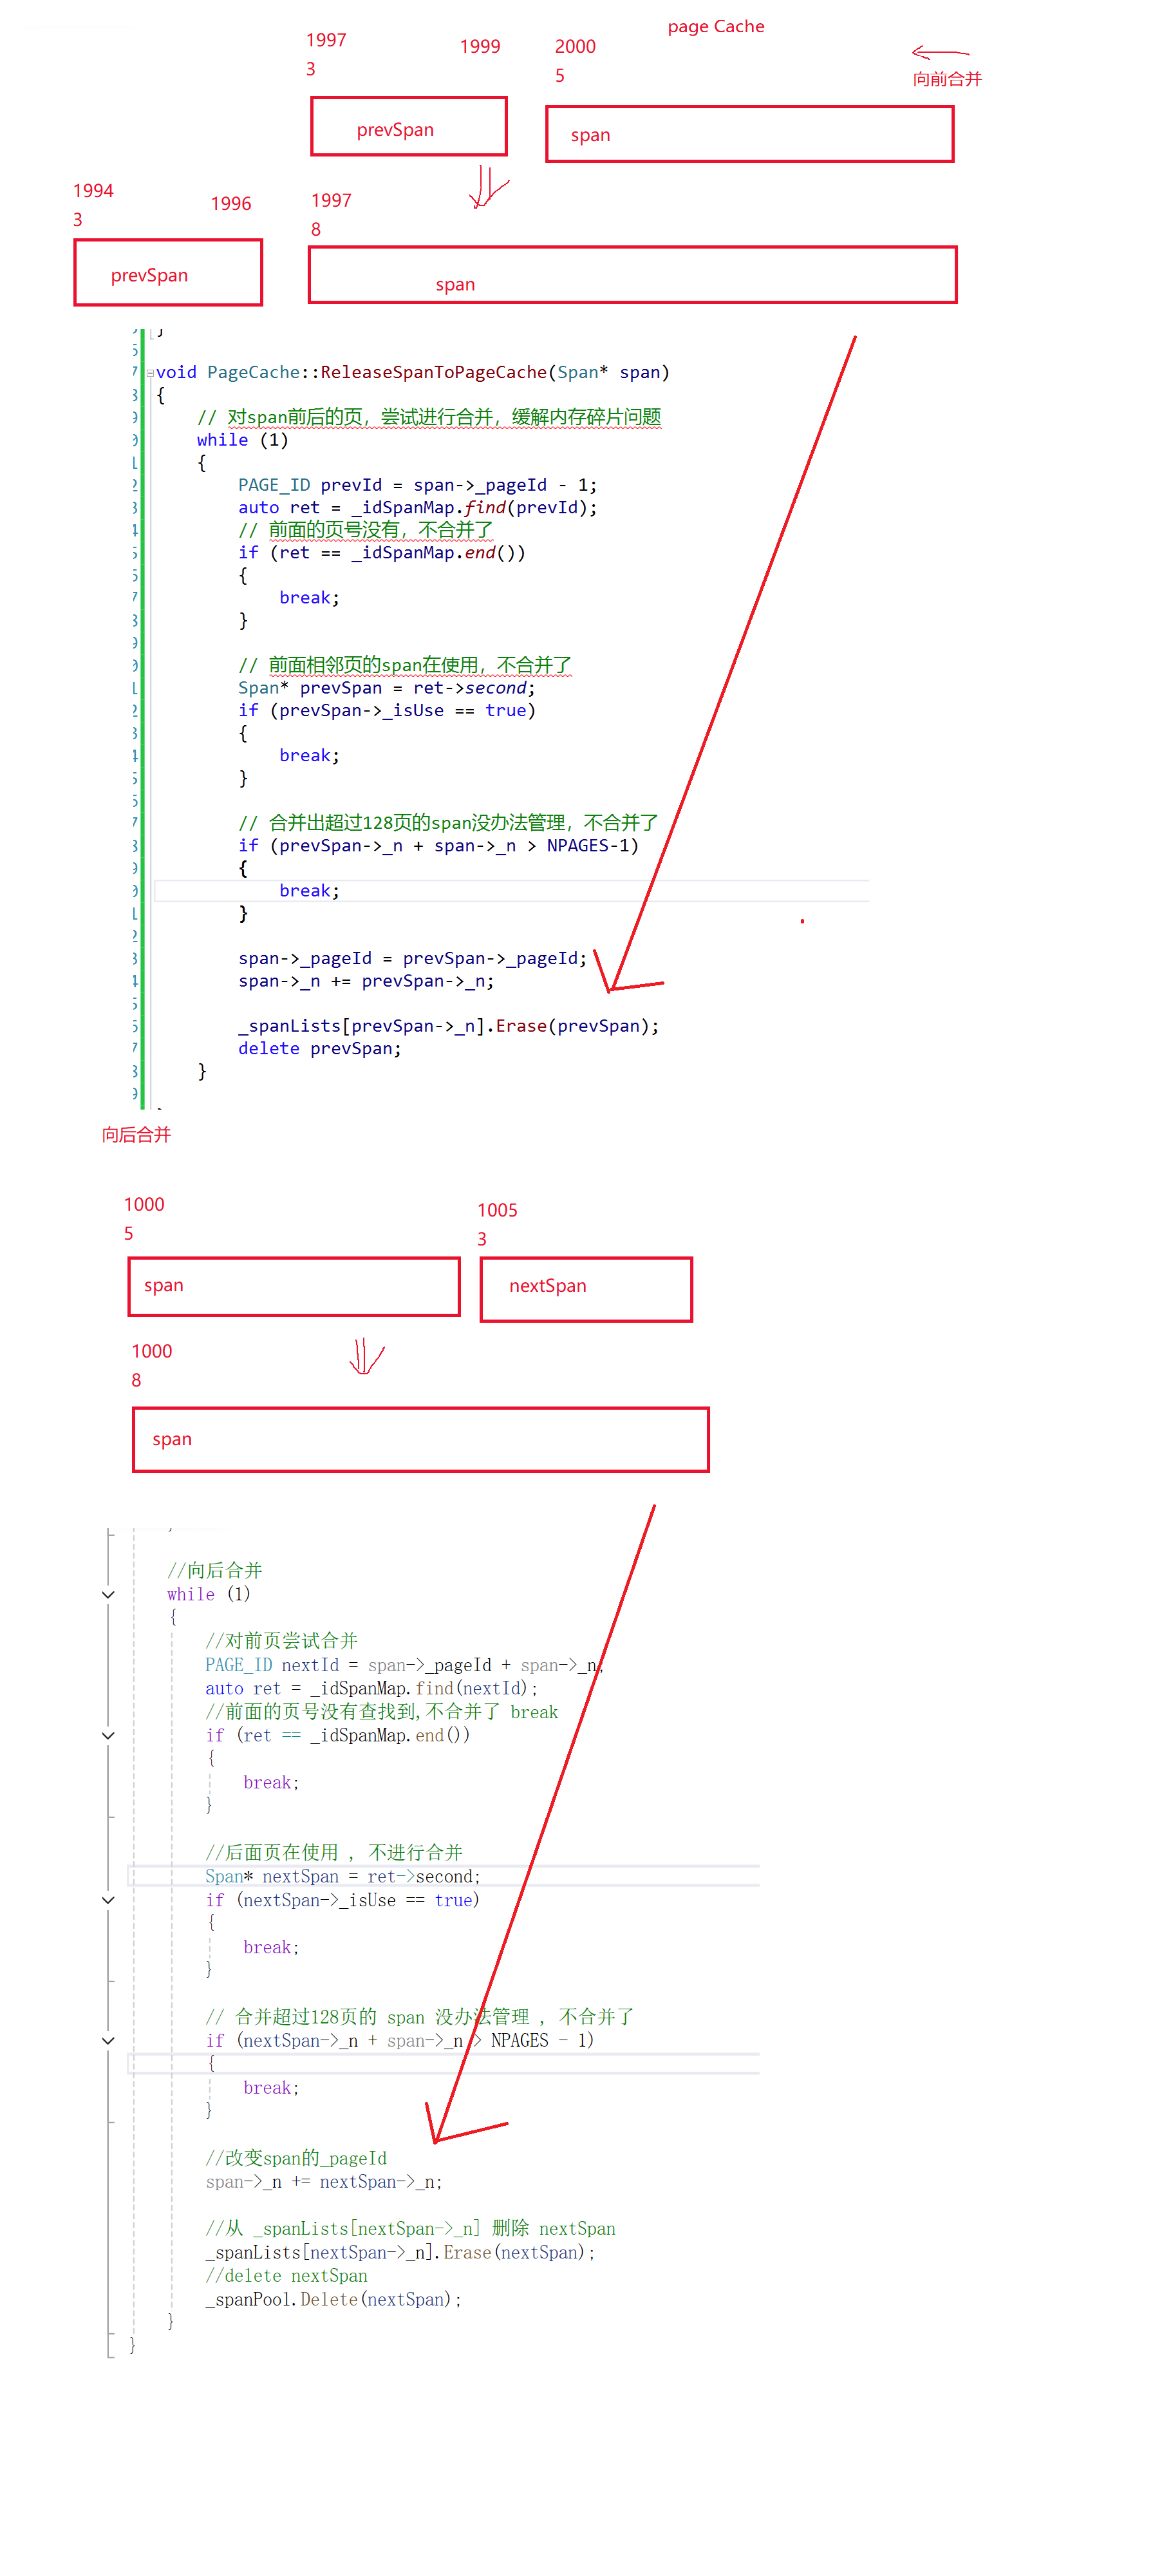
1. 如果 central cache 释放回一个 span,则依次寻找 span 的前后 page_id 的没有在使用的空闲 span,看是否可以合并,如果合并继续向前寻找。这样就可以将切小的内存合并收缩成大的 span,减少内存碎片。
六.细节优化
1.申请细节优化
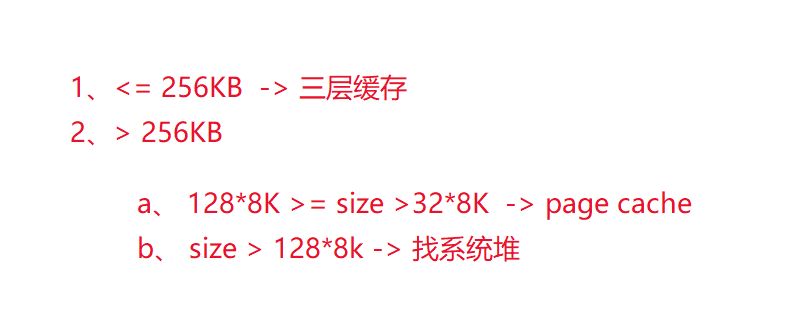
规定 : size
1.1 ConcurrentAlloc 优化
// ConcurrentAlloc
static void* ConcurrentAlloc(size_t size)
{
	// ⼤于 MAX_BYTES ( MAX_BYTES = 256 * 1024 )就直接找 pagecache 或者系统堆申请
	if (size > MAX_BYTES)
	{
		//计算对齐大小
		size_t alignSize = SizeClass::RoundUp(size);
		//计算一共要几页 alignSize >> PAGE_SHIFT
		size_t kpage = alignSize >> PAGE_SHIFT;

		//PageCache 加锁
		PageCache::GetInstance()->_pageMtx.lock();
		//New k 页的 span
		Span* span = PageCache::GetInstance()->NewSpan(kpage);
		//记录对象大小
		span->_objSize = size;
		//PageCache 解锁
		PageCache::GetInstance()->_pageMtx.unlock();

		//获取span->_pageId之后转换为地址
		void* ptr = (void*)(span->_pageId << PAGE_SHIFT);
		//返回ptr
		return ptr;
	}
	else
	{
		//通过 TLS 每个线程无锁的获取自己专属的ThreadCache对象
		//如果pTLSThreadCache为nullptr,先创建
		if (pTLSThreadCache == nullptr)
		{
			static ObjectPool<ThreadCache> tcPool;
			//pTLSThreadCache = new ThreadCache
			pTLSThreadCache = tcPool.New();
		}

		return pTLSThreadCache->Allocate(size);
	}
}
1.2 NewSpan 优化
Span* PageCache::NewSpan(size_t k)
{
	assert(k > 0);

	//大于128 page的直接向堆申请
	if (k > NPAGES - 1)
	{
		void* ptr = SystemAlloc(k);
		//Span* span = new Span;
		//优化 -- 使用定长内存池申请
		Span* span = _spanPool.New();

		//计算页号
		span->_pageId = (PAGE_ID)ptr >> PAGE_SHIFT;
		//设置页数
		span->_n = k;

		//建立 _pageId 与 span 的映射关系 , 方便回收
		_idSpanMap[span->_pageId] = span;

		return span;
	}

	//先检查第k个桶里面有没有span
	if (!_spanLists[k].Empty())
	{
		//如果有,弹出_spanLists[k]
		Span* kSpan = _spanLists[k].PopFront();
		//建立 _pageId 与 span 的映射关系 ,方便 central cache 回收小块内存时候,查找对应的 span
		for (PAGE_ID i = 0; i < kSpan->_n; ++i)
		{
			_idSpanMap[kSpan->_pageId + i] = kSpan;
		}
		return kSpan;
	}

	//遍历整个桶 , 检查后面的桶里面有没有 span ,如果有可以把它进行切分
	for (size_t i = k + 1; i < NPAGES; ++i)
	{
		if (!_spanLists[i].Empty())
		{
			//如果有 , 弹出 _spanLists[i]
			Span* nSpan = _spanLists[i].PopFront();
			//Span* kSpan = new Span;
			//优化
			Span* kSpan = _spanPool.New();

			//在 nSpan 的头部切 k 页下来
			// k 页 span 返回
			// nSpan 再挂到对应的映射位置
			//改变 kSpan->_pageId 和 kSpan->_n
			kSpan->_pageId = nSpan->_pageId;
			kSpan->_n = k;

			nSpan->_pageId += k;
			nSpan->_n -= k;

			_spanLists[nSpan->_n].PushFront(nSpan);

			//建立 nSpan 的页号和 nSpan 映射,方便 page cache 回收内存时进行合并查找
			_idSpanMap[nSpan->_pageId] = nSpan;
			_idSpanMap[nSpan->_pageId + nSpan->_n - 1] = nSpan;

			// 建立 kSpan->_pageId 和 kSpan 的映射,方便 central cache 回收小块内存的时候,查找对应的span
			for (PAGE_ID i = 0; i < kSpan->_n; ++i)
			{
				_idSpanMap[kSpan->_pageId + i] = kSpan;
			}
			return kSpan;

		}

	}

	//走到这个位置说明没有大页的span了
	//这时候就要去找堆要一个128页的span
	//Span* bigSpan = new Span;
	Span* bigSpan = _spanPool.New();
	void* ptr = SystemAlloc(NPAGES - 1);
	bigSpan->_pageId = (PAGE_ID)ptr >> PAGE_SHIFT;
	bigSpan->_n = NPAGES - 1;

	//将 bigSpan 推入 _spanLists 中
	_spanLists[bigSpan->_n].PushFront(bigSpan);

	//递归NewSpan
	return NewSpan(k);
}
2.释放细节优化
2.1 ConcurrentFree 优化
static void ConcurrentFree(void* ptr)
{
	//根据 ptr 计算应该还给哪个 span
	Span* span = PageCache::GetInstance()->MapObjectToSpan(ptr);
	//需要还的大小从 span 所记录的 _objSize 中获取
	size_t size = span->_objSize;

	//如果 size > MAX_BYTES 交给 PageCache 处理
	if (size > MAX_BYTES)
	{
		//PageCache 加锁
		PageCache::GetInstance()->_pageMtx.lock();
		//PageCache ReleaseSpanToPageCache
		PageCache::GetInstance()->ReleaseSpanToPageCache(span);
		//PageCache 解锁
		PageCache::GetInstance()->_pageMtx.unlock();
	}
	//否则调用 pTLSThreadCache 的 Deallocate
	else
	{
		assert(pTLSThreadCache);
		pTLSThreadCache->Deallocate(ptr, size);
	}
}
2.2 ReleaseSpanToPageCache 优化
void PageCache::ReleaseSpanToPageCache(Span* span)
{
	//大于 128 page 的直接还给堆
	if (span->_n > NPAGES - 1)
	{
		void* ptr = (void*)(span->_pageId << PAGE_SHIFT);
		SystemFree(ptr);
		//delete span;
		_spanPool.Delete(span);
		return;
	}

	//对 span 前后的页尝试进行合并 , 缓解内存碎片问题
	while (1)
	{
		//对前页尝试合并
		PAGE_ID prevId = span->_pageId - 1;
		auto ret = _idSpanMap.find(prevId);
		//前面的页号没有查找到,不合并了 break
		if (ret == _idSpanMap.end())
		{
			break;
		}

		//auto ret = (Span*)_idSpanMap.get(prevId);
		//if (ret == nullptr)
		//{
		//	break;
		//}

		//前面页在使用 , 不进行合并
		Span* prevSpan = ret->second;
		//Span* prevSpan = ret;
		if (prevSpan->_isUse == true)
		{
			break;
		}

		// 合并超过128页的 span 没办法管理 , 不合并了
		if (prevSpan->_n + span->_n > NPAGES - 1)
		{
			break;
		}

		//改变span的_pageId
 		span->_pageId = prevSpan->_pageId;
		span->_n += prevSpan->_n;

		_spanLists[prevSpan->_n].Erase(prevSpan);
		//delete prevSpan
		_spanPool.Delete(prevSpan);
	}

	//向后合并
	while (1)
	{
		//对前页尝试合并
		PAGE_ID nextId = span->_pageId + span->_n;
		auto ret = _idSpanMap.find(nextId);
		//前面的页号没有查找到,不合并了 break
		if (ret == _idSpanMap.end())
		{
			break;
		}

		//auto ret = (Span*)_idSpanMap.get(nextId);
		//if (ret == nullptr)
		//{
		//	break;
		//}

		//后面页在使用 , 不进行合并
		Span* nextSpan = ret->second;
		//Span* nextSpan = ret;
		if (nextSpan->_isUse == true)
		{
			break;
		}

		// 合并超过128页的 span 没办法管理 , 不合并了
		if (nextSpan->_n + span->_n > NPAGES - 1)
		{
			break;
		}

		//改变span的_pageId
		span->_n += nextSpan->_n;

		//从 _spanLists[nextSpan->_n] 删除 nextSpan
		_spanLists[nextSpan->_n].Erase(nextSpan);
		//delete nextSpan
		_spanPool.Delete(nextSpan);
	}


	//合并完成后 , 把 span 推入 _spanLists 中
	_spanLists[span->_n].PushFront(span);
	//span 的使用情况设为未使用
	span ->_isUse = false;

	//建立新 span 和 id 的映射关系
	_idSpanMap[span->_pageId] = span;
	_idSpanMap[span->_pageId + span->_n - 1] = span;
}
3.多线程并发环境下,对比malloc和ConcurrentAlloc申请和释放内存效率对比
Benchmark.cpp 测试
#include"ConcurrentAlloc.h"

// ntimes 一轮申请和释放内存的次数
// rounds 轮次
void BenchmarkMalloc(size_t ntimes, size_t nworks, size_t rounds)
{
	std::vector<std::thread> vthread(nworks);
	std::atomic<size_t> malloc_costtime = 0;
	std::atomic<size_t> free_costtime = 0;

	for (size_t k = 0; k < nworks; ++k)
	{
		vthread[k] = std::thread([&, k]() {
			std::vector<void*> v;
			v.reserve(ntimes);

			for (size_t j = 0; j < rounds; ++j)
			{
				size_t begin1 = clock();
				for (size_t i = 0; i < ntimes; i++)
				{
					v.push_back(malloc(16));
					//v.push_back(malloc((16 + i) % 8192 + 1));
				}
				size_t end1 = clock();

				size_t begin2 = clock();
				for (size_t i = 0; i < ntimes; i++)
				{
					free(v[i]);
				}
				size_t end2 = clock();
				v.clear();

				malloc_costtime += (end1 - begin1);
				free_costtime += (end2 - begin2);
			}
			});
	}

	for (auto& t : vthread)
	{
		t.join();
	}

	printf("%u个线程并发执行%u轮次,每轮次malloc %u次: 花费:%u ms\n",
		nworks, rounds, ntimes, (size_t)malloc_costtime);

	printf("%u个线程并发执行%u轮次,每轮次free %u次: 花费:%u ms\n",
		nworks, rounds, ntimes, (size_t)free_costtime);

	printf("%u个线程并发malloc&free %u次,总计花费:%u ms\n",
		nworks, nworks * rounds * ntimes, (size_t)malloc_costtime + free_costtime);
}


// 单轮次申请释放次数 线程数 轮次
void BenchmarkConcurrentMalloc(size_t ntimes, size_t nworks, size_t rounds)
{
	std::vector<std::thread> vthread(nworks);
	std::atomic<size_t> malloc_costtime = 0;
	std::atomic<size_t> free_costtime = 0;

	for (size_t k = 0; k < nworks; ++k)
	{
		vthread[k] = std::thread([&]() {
			std::vector<void*> v;
			v.reserve(ntimes);

			for (size_t j = 0; j < rounds; ++j)
			{
				size_t begin1 = clock();
				for (size_t i = 0; i < ntimes; i++)
				{
					v.push_back(ConcurrentAlloc(16));
					//v.push_back(ConcurrentAlloc((16 + i) % 8192 + 1));
				}
				size_t end1 = clock();

				size_t begin2 = clock();
				for (size_t i = 0; i < ntimes; i++)
				{
					ConcurrentFree(v[i]);
				}
				size_t end2 = clock();
				v.clear();

				malloc_costtime += (end1 - begin1);
				free_costtime += (end2 - begin2);
			}
			});
	}

	for (auto& t : vthread)
	{
		t.join();
	}

	printf("%u个线程并发执行%u轮次,每轮次concurrent alloc %u次: 花费:%u ms\n",
		nworks, rounds, ntimes, (size_t)malloc_costtime);

	printf("%u个线程并发执行%u轮次,每轮次concurrent dealloc %u次: 花费:%u ms\n",
		nworks, rounds, ntimes, (size_t)free_costtime);

	printf("%u个线程并发concurrent alloc&dealloc %u次,总计花费:%u ms\n",
		nworks, nworks * rounds * ntimes, (size_t)malloc_costtime + free_costtime);
}

int main()
{
	size_t n = 10000;
	// 4个线程 10轮 每轮10000次
	BenchmarkMalloc(n, 4, 10);
	cout << "==========================================================" << endl;
	BenchmarkConcurrentMalloc(n,4, 10);
	cout << endl << endl;
	return 0;
}
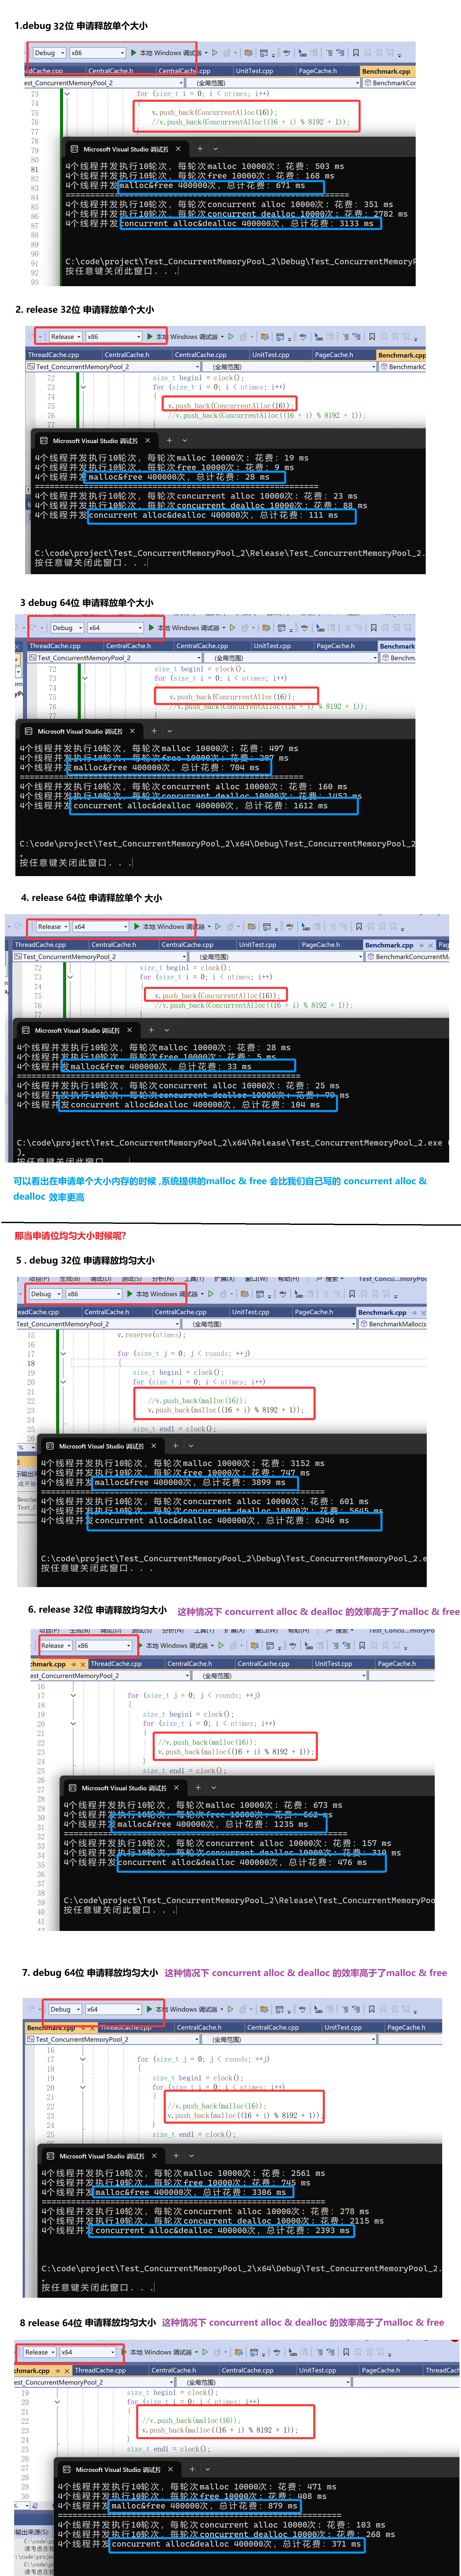
测试结果
4.使用tcmalloc源码中实现基数树进行优化
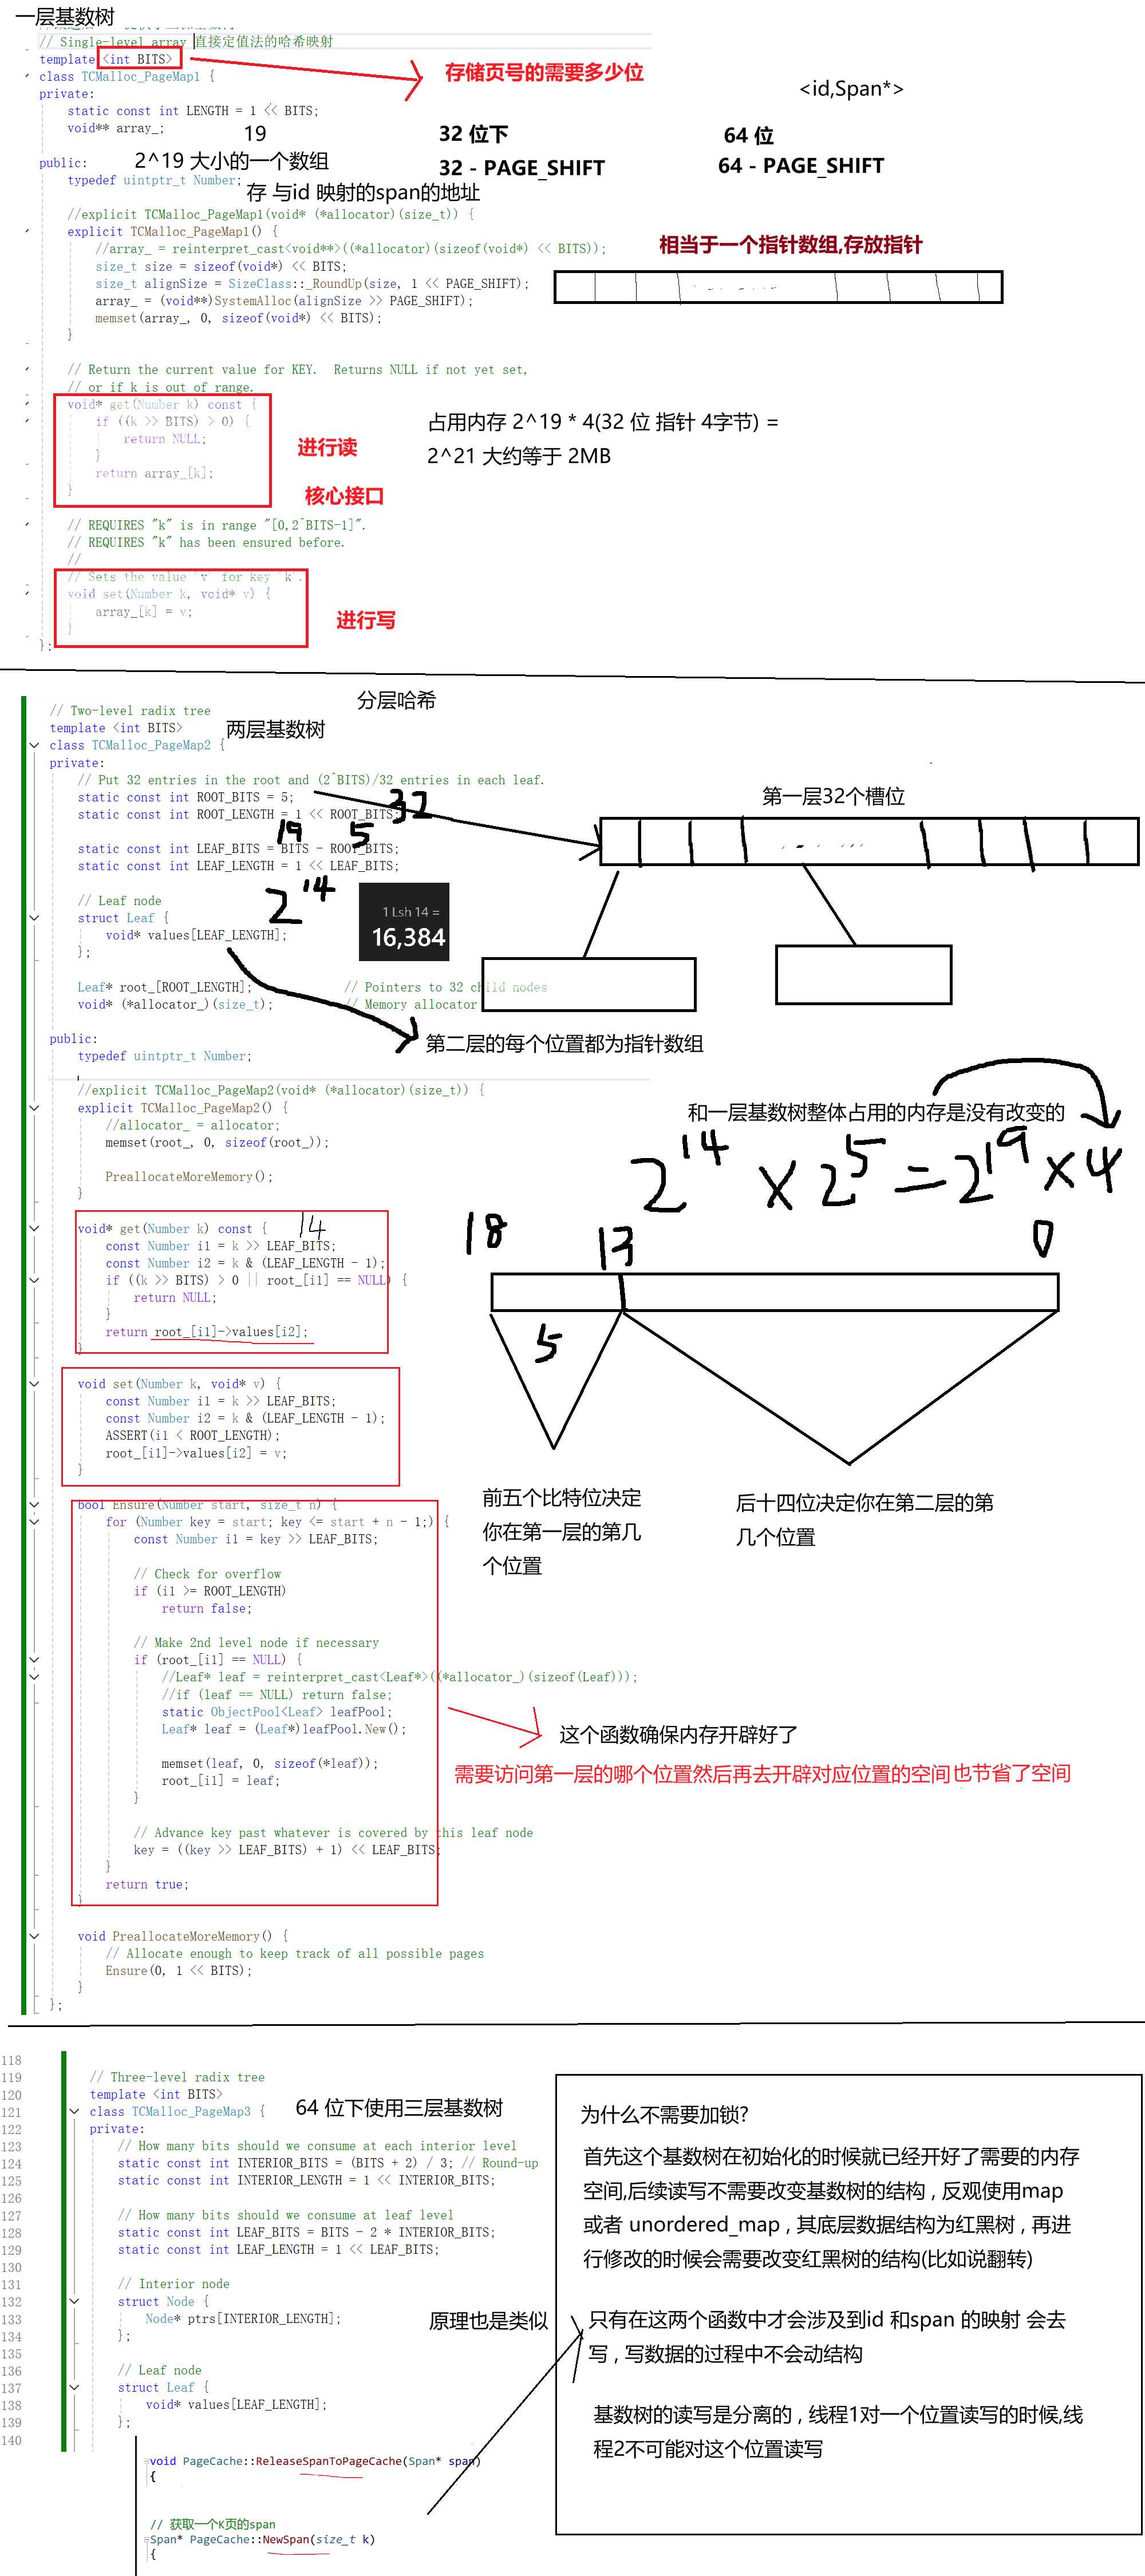
在我们的项目中需要查找 span 和 id 的映射关系 , 所以涉及到很多的查找 , 也存在锁竞争问题 , 通过使用基数树可以通过建立数到指针的映射关系 (指针本质也是数字) 提高查找效率 , 并且查找的时候可以不加锁了。
1.基数树
基数树,又称压缩前缀树或Patricia树,是一种多叉树数据结构,用于高效存储和检索字符串或二进制序列。它是Trie(前缀树)的空间优化版本。
基数树本质上是一种多级数组(Multi-level Array)。
-
结构逻辑:它将一个长的数字(在这里是
PAGE_ID)切分成若干段。每一段作为当前层级数组的下标。 -
查找过程:以 64 位环境下的三层基数树为例,查找一个页号
k:-
取
k的高位在第一层数组中找到一个指针,指向第二层节点。 -
取
k的中位在第二层数组中找到一个指针,指向第三层(叶子节点)。 -
取
k的低位在叶子节点的values数组中直接拿到Span*。
-
-
物理形态:它在内存中不是像红黑树那样由零散的节点连接,而是由一个个连续的指针数组(Node)组成。
2.原理
2.1 为什么基数树可以大幅提高效率?
相比于平衡搜索树(std::map)或哈希表(unordered_map),基数树有天然的优势:
A. 时间复杂度稳定为 O(1)
-
std::map的复杂度是O(log N)。随着内存碎片的增多,映射关系成千上万,查找速度会变慢。 -
基数树的层数是固定的(32位通常2层,64位通常3层)。无论内存中有多少个
Span,查找永远只需要 3 次偏移运算和 3 次指针解引用。这种极其稳定的 O(1) 性能对于频繁调用的ConcurrentFree至关重要。
B. 极致的缓存友好性(Cache Locality)
基数树的节点是连续的数组。CPU 在访问数组时,会触发硬件预取(Prefetching),将相邻的指针加载到 L1/L2 缓存中。而红黑树节点是随机分布在堆上的,容易导致大量 Cache Miss。
C. 避免了哈希碰撞和计算开销
哈希表虽然也是 O(1),但它需要计算哈希值(对于长整型页号有计算开销),并且在发生冲突时性能会退化。基数树是直接位移映射,没有任何计算损耗。
2.2 为什么可以实现“无锁化”?
这是基数树在内存池中最巧妙的地方。在高并发下,如果多个线程同时读写映射表,通常需要加锁。但基数树在特定条件下可以做到读操作完全无锁:
A. 结构的不变性
基数树一旦某个位置的节点(Node 或 Leaf)被创建,它在整个程序的生命周期内地址是不变的。
-
当你在
PageCache中申请内存时,会set映射关系。 -
当你释放内存时,会
get映射关系。 -
写操作(set):只有在对应位置的叶子节点不存在时,才会去
NewNode申请内存。而代码在set时是在PageCache的大锁保护下的。 -
读操作(get):由于节点地址固定,且我们不会“删除”基数树的中间节点,所以读取线程永远不会访问到一个被释放的地址。
B. 原子性的指针更新
在已经开辟好空间的叶子节点中,values[i3] = v 这个赋值操作在现代 CPU 上是原子性的。读取线程要么读到旧的 Span*,要么读到新的 Span*,绝不会读到半个指针导致崩溃。
C. 读写分离逻辑
-
申请内存:由
PageCache负责,由于申请动作本身较慢且必须全局加锁,我们在锁内完成set。 -
释放内存:这是最高频的操作。由于映射表的结构(节点指针)已经由申请时的
set提前通过Ensure准备好了,释放线程在get时只需要顺着固定的指针路径走。只要路径上的节点不被销毁,就不需要加锁。
2.3 总结
在代码中,基数树的优势在于:
-
空间换时间:利用数组索引代替搜索逻辑。
-
消灭竞争:将原本需要全局竞争的
std::map锁,优化为利用地址不变性实现的无锁get。 -
自给自足:通过
ObjectPool改造了基数树的内存分配,使其不依赖malloc,彻底解决了“在内存池里调用内存分配”导致的死递归问题。
这就是为什么改用基数树后 , BenchMark 吞吐量会有大幅提升的底层逻辑。
3.PageMap.h (从源码中改造的)
#pragma once
#include"Common.h"

// Single-level array
template <int BITS>
class TCMalloc_PageMap1 {
private:
	static const int LENGTH = 1 << BITS;
	void** array_;

public:
	typedef uintptr_t Number;

	//explicit TCMalloc_PageMap1(void* (*allocator)(size_t)) {
	explicit TCMalloc_PageMap1() {
		//array_ = reinterpret_cast<void**>((*allocator)(sizeof(void*) << BITS));
		size_t size = sizeof(void*) << BITS;
		size_t alignSize = SizeClass::_RoundUp(size, 1 << PAGE_SHIFT);
		array_ = (void**)SystemAlloc(alignSize >> PAGE_SHIFT);
		memset(array_, 0, sizeof(void*) << BITS);
	}

	// Return the current value for KEY.  Returns NULL if not yet set,
	// or if k is out of range.
	void* get(Number k) const {
		if ((k >> BITS) > 0) {
			return NULL;
		}
		return array_[k];
	}

	// REQUIRES "k" is in range "[0,2^BITS-1]".
	// REQUIRES "k" has been ensured before.
	//
	// Sets the value 'v' for key 'k'.
	void set(Number k, void* v) {
		array_[k] = v;
	}
};

// Two-level radix tree
template <int BITS>
class TCMalloc_PageMap2 {
private:
	// Put 32 entries in the root and (2^BITS)/32 entries in each leaf.
	static const int ROOT_BITS = 5;
	static const int ROOT_LENGTH = 1 << ROOT_BITS;

	static const int LEAF_BITS = BITS - ROOT_BITS;
	static const int LEAF_LENGTH = 1 << LEAF_BITS;

	// Leaf node
	struct Leaf {
		void* values[LEAF_LENGTH];
	};

	Leaf* root_[ROOT_LENGTH];             // Pointers to 32 child nodes
	void* (*allocator_)(size_t);          // Memory allocator

public:
	typedef uintptr_t Number;

	//explicit TCMalloc_PageMap2(void* (*allocator)(size_t)) {
	explicit TCMalloc_PageMap2() {
		//allocator_ = allocator;
		memset(root_, 0, sizeof(root_));

		PreallocateMoreMemory();
	}

	void* get(Number k) const {
		const Number i1 = k >> LEAF_BITS;
		const Number i2 = k & (LEAF_LENGTH - 1);
		if ((k >> BITS) > 0 || root_[i1] == NULL) {
			return NULL;
		}
		return root_[i1]->values[i2];
	}

	void set(Number k, void* v) {
		const Number i1 = k >> LEAF_BITS;
		const Number i2 = k & (LEAF_LENGTH - 1);
		assert(i1 < ROOT_LENGTH);
		root_[i1]->values[i2] = v;
	}

	bool Ensure(Number start, size_t n) {
		for (Number key = start; key <= start + n - 1;) {
			const Number i1 = key >> LEAF_BITS;

			// Check for overflow
			if (i1 >= ROOT_LENGTH)
				return false;

			// Make 2nd level node if necessary
			if (root_[i1] == NULL) {
				//Leaf* leaf = reinterpret_cast<Leaf*>((*allocator_)(sizeof(Leaf)));
				//if (leaf == NULL) return false;
				static ObjectPool<Leaf>	leafPool;
				Leaf* leaf = (Leaf*)leafPool.New();

				memset(leaf, 0, sizeof(*leaf));
				root_[i1] = leaf;
			}

			// Advance key past whatever is covered by this leaf node
			key = ((key >> LEAF_BITS) + 1) << LEAF_BITS;
		}
		return true;
	}

	void PreallocateMoreMemory() {
		// Allocate enough to keep track of all possible pages
		Ensure(0, 1 << BITS);
	}
};

// Three-level radix tree (用于 64 位环境)
template <int BITS>
class TCMalloc_PageMap3 {
private:
	// How many bits should we consume at each interior level
	static const int INTERIOR_BITS = (BITS + 2) / 3;
	// Round-up
	static const int INTERIOR_LENGTH = 1 << INTERIOR_BITS;

	// How many bits should we consume at leaf level
	static const int LEAF_BITS = BITS - 2 * INTERIOR_BITS;
	static const int LEAF_LENGTH = 1 << LEAF_BITS;

	// Interior node
	struct Node {
		Node* ptrs[INTERIOR_LENGTH];
	};

	// Leaf node
	struct Leaf {
		void* values[LEAF_LENGTH];
	};

	Node* root_;                          // Root of radix tree
	// void* (*allocator_)(size_t);       // 移除旧的 C 风格内存分配器函数指针

	Node* NewNode() {
		// 使用指针并判断,确保在使用时一定已经初始化
		static ObjectPool<Node>* nodePool = new ObjectPool<Node>;
		Node* result = nodePool->New();
		if (result != NULL) {
			memset(result, 0, sizeof(*result));
		}
		return result;
	}

public:
	typedef uintptr_t Number;

	// 无参构造,不再需要传入分配器
	explicit TCMalloc_PageMap3() {
		root_ = NewNode();
	}

	void* get(Number k) const {
		const Number i1 = k >> (LEAF_BITS + INTERIOR_BITS);
		const Number i2 = (k >> LEAF_BITS) & (INTERIOR_LENGTH - 1);
		const Number i3 = k & (LEAF_LENGTH - 1);

		if ((k >> BITS) > 0 ||
			root_->ptrs[i1] == NULL || root_->ptrs[i1]->ptrs[i2] == NULL) {
			return NULL;
		}
		return reinterpret_cast<Leaf*>(root_->ptrs[i1]->ptrs[i2])->values[i3];
	}

	void set(Number k, void* v) {
		const Number i1 = k >> (LEAF_BITS + INTERIOR_BITS);
		const Number i2 = (k >> LEAF_BITS) & (INTERIOR_LENGTH - 1);
		const Number i3 = k & (LEAF_LENGTH - 1);

		// 只有当节点不存在时才进入 Ensure (按需路径补偿)
		if (root_->ptrs[i1] == NULL || root_->ptrs[i1]->ptrs[i2] == NULL) {
			if (!Ensure(k, 1)) {
				assert(false); // 内存申请失败
				return;
			}
		}

		reinterpret_cast<Leaf*>(root_->ptrs[i1]->ptrs[i2])->values[i3] = v;
	}

	bool Ensure(Number start, size_t n) {
		for (Number key = start; key <= start + n - 1;) {
			const Number i1 = key >> (LEAF_BITS + INTERIOR_BITS);
			const Number i2 = (key >> LEAF_BITS) & (INTERIOR_LENGTH - 1);

			if (i1 >= INTERIOR_LENGTH || i2 >= INTERIOR_LENGTH)
				return false;

			if (root_->ptrs[i1] == NULL) {
				Node* n = NewNode();
				if (n == NULL) return false;
				root_->ptrs[i1] = n;
			}

			// Make leaf node if necessary
			if (root_->ptrs[i1]->ptrs[i2] == NULL) {
				//使用自定义的定长内存池来为叶子节点申请内存,替换掉原来的 reinterpret_cast<Leaf*>((*allocator_)(sizeof(Leaf)));
				static ObjectPool<Leaf> leafPool;
				Leaf* leaf = leafPool.New();

				if (leaf == NULL) return false;
				memset(leaf, 0, sizeof(*leaf));
				root_->ptrs[i1]->ptrs[i2] = reinterpret_cast<Node*>(leaf);
			}

			// Advance key past whatever is covered by this leaf node
			key = ((key >> LEAF_BITS) + 1) << LEAF_BITS;
		}
		return true;
	}

	void PreallocateMoreMemory() {
		//64位环境下地址空间极其庞大,不能像一二层基数树那样提前全量分配开辟空间。
		// 在这里留空即可,依靠 Ensure 函数触发时执行按需的动态开辟。
	}
};
4.改造后测试结果对比

 1357


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


