Python打卡训练营学习记录Day14

可解释机器学习-shap value的使用 可解释机器学习 interpretable machine learning, shapley value, shap, SHapley Additive exPlanations, Lightgbm, 回归 regression, 分类 classification,多分类 multi-classification 阅读详情
# 先运行之前预处理好的代码
import pandas as pd
import pandas as pd    #用于数据处理和分析,可处理表格数据。
import numpy as np     #用于数值计算,提供了高效的数组操作。
import matplotlib.pyplot as plt    #用于绘制各种类型的图表
import seaborn as sns   #基于matplotlib的高级绘图库,能绘制更美观的统计图形。
import warnings
warnings.filterwarnings("ignore")
 
 # 设置中文字体(解决中文显示问题)
plt.rcParams['font.sans-serif'] = ['SimHei']  # Windows系统常用黑体字体
plt.rcParams['axes.unicode_minus'] = False    # 正常显示负号
data = pd.read_csv('data.csv')    #读取数据


# 先筛选字符串变量 
discrete_features = data.select_dtypes(include=['object']).columns.tolist()
# Home Ownership 标签编码
home_ownership_mapping = {
    'Own Home': 1,
    'Rent': 2,
    'Have Mortgage': 3,
    'Home Mortgage': 4
}
data['Home Ownership'] = data['Home Ownership'].map(home_ownership_mapping)

# Years in current job 标签编码
years_in_job_mapping = {
    '< 1 year': 1,
    '1 year': 2,
    '2 years': 3,
    '3 years': 4,
    '4 years': 5,
    '5 years': 6,
    '6 years': 7,
    '7 years': 8,
    '8 years': 9,
    '9 years': 10,
    '10+ years': 11
}
data['Years in current job'] = data['Years in current job'].map(years_in_job_mapping)

# Purpose 独热编码,记得需要将bool类型转换为数值
data = pd.get_dummies(data, columns=['Purpose'])
data2 = pd.read_csv("data.csv") # 重新读取数据,用来做列名对比
list_final = [] # 新建一个空列表,用于存放独热编码后新增的特征名
for i in data.columns:
    if i not in data2.columns:
       list_final.append(i) # 这里打印出来的就是独热编码后的特征名
for i in list_final:
    data[i] = data[i].astype(int) # 这里的i就是独热编码后的特征名


# Term 0 - 1 映射
term_mapping = {
    'Short Term': 0,
    'Long Term': 1
}
data['Term'] = data['Term'].map(term_mapping)
data.rename(columns={'Term': 'Long Term'}, inplace=True) # 重命名列
continuous_features = data.select_dtypes(include=['int64', 'float64']).columns.tolist()  #把筛选出来的列名转换成列表
 
 # 连续特征用中位数补全
for feature in continuous_features:     
    mode_value = data[feature].mode()[0]            #获取该列的众数。
    data[feature].fillna(mode_value, inplace=True)          #用众数填充该列的缺失值,inplace=True表示直接在原数据上修改。

# 最开始也说了 很多调参函数自带交叉验证,甚至是必选的参数,你如果想要不交叉反而实现起来会麻烦很多
# 所以这里我们还是只划分一次数据集
from sklearn.model_selection import train_test_split
X = data.drop(['Credit Default'], axis=1)  # 特征,axis=1表示按列删除
y = data['Credit Default'] # 标签
# 按照8:2划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)  # 80%训练集,20%测试集


from sklearn.ensemble import RandomForestClassifier #随机森林分类器

from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score # 用于评估分类器性能的指标
from sklearn.metrics import classification_report, confusion_matrix #用于生成分类报告和混淆矩阵
import warnings #用于忽略警告信息
warnings.filterwarnings("ignore") # 忽略所有警告信息
# --- 1. 默认参数的随机森林 ---
# 评估基准模型,这里确实不需要验证集
print("--- 1. 默认参数随机森林 (训练集 -> 测试集) ---")
import time # 这里介绍一个新的库,time库,主要用于时间相关的操作,因为调参需要很长时间,记录下会帮助后人知道大概的时长
start_time = time.time() # 记录开始时间
rf_model = RandomForestClassifier(random_state=42)
rf_model.fit(X_train, y_train) # 在训练集上训练
rf_pred = rf_model.predict(X_test) # 在测试集上预测
end_time = time.time() # 记录结束时间

print(f"训练与预测耗时: {end_time - start_time:.4f} 秒")
print("\n默认随机森林 在测试集上的分类报告:")
print(classification_report(y_test, rf_pred))
print("默认随机森林 在测试集上的混淆矩阵:")
print(confusion_matrix(y_test, rf_pred))


import shap
import matplotlib.pyplot as plt

# 初始化 SHAP 解释器
explainer = shap.TreeExplainer(rf_model)

# 计算 SHAP 值(基于测试集),这个shap_values是一个numpy数组,表示每个特征对每个样本的贡献值
# 这里大家先知道这是个numpy数组即可,我们后面学习完numpy在来回头解读这个值
shap_values = explainer.shap_values(X_test) # 这个计算耗时
print(shap_values)
print("shap_values shape:", shap_values.shape)
print("shap_values[0] shape:", shap_values[0].shape)
print("shap_values[:, :, 0] shape:", shap_values[:, :, 0].shape)
print("X_test shape:", X_test.shape)
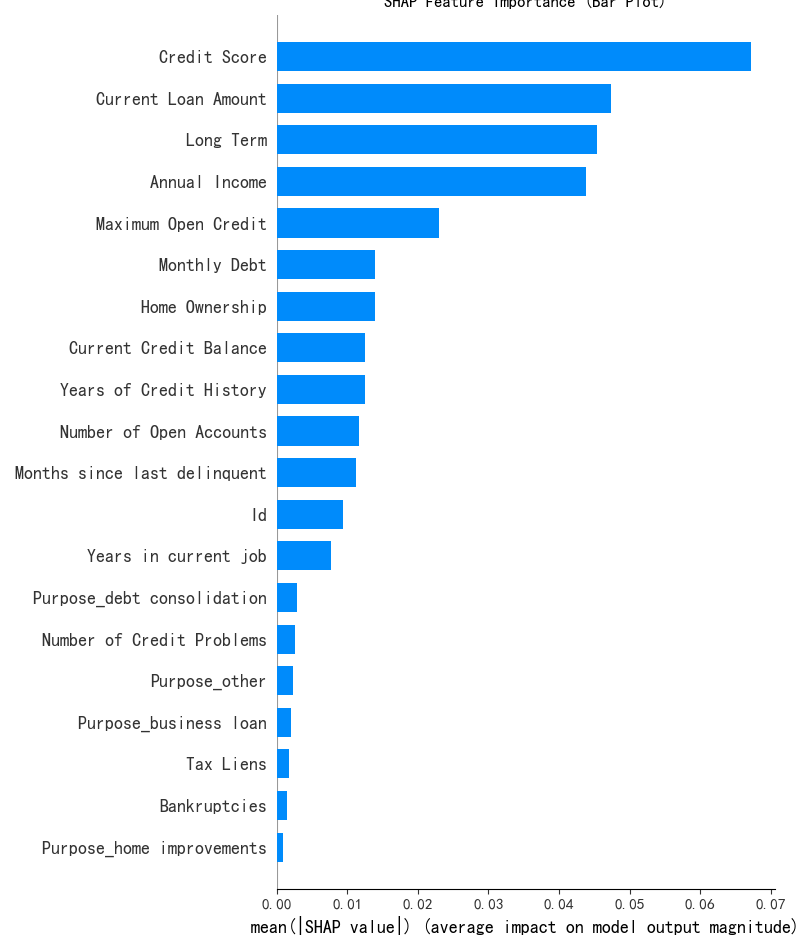
print("--- 1. SHAP 特征重要性条形图 ---")
shap.summary_plot(shap_values[:, :, 0], X_test, plot_type="bar",show=False)  #  这里的show=False表示不直接显示图形,这样可以继续用plt来修改元素,不然就直接输出了
plt.title("SHAP Feature Importance (Bar Plot)")
plt.show()

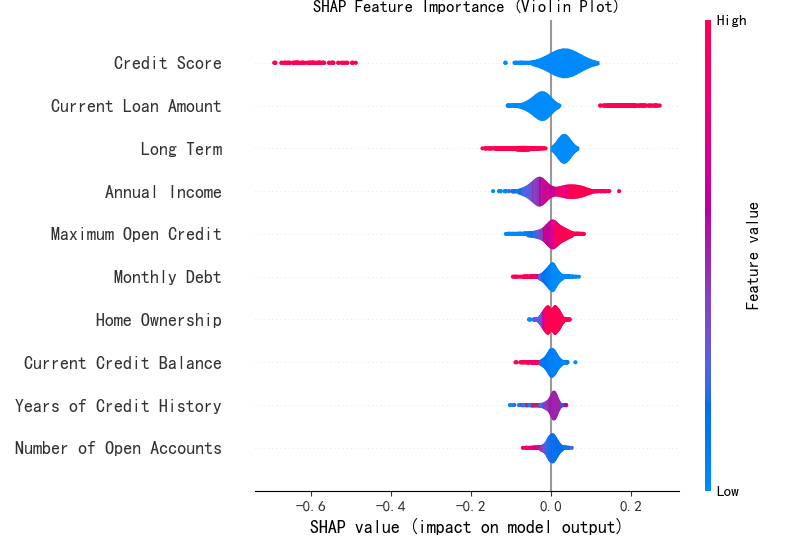
print("--- 2. SHAP 特征重要性蜂巢图 ---")
shap.summary_plot(shap_values[:, :, 0], X_test,plot_type="violin",show=False,max_display=10) # 这里的show=False表示不直接显示图形,这样可以继续用plt来修改元素,不然就直接输出了
plt.title("SHAP Feature Importance (Violin Plot)")
plt.show()

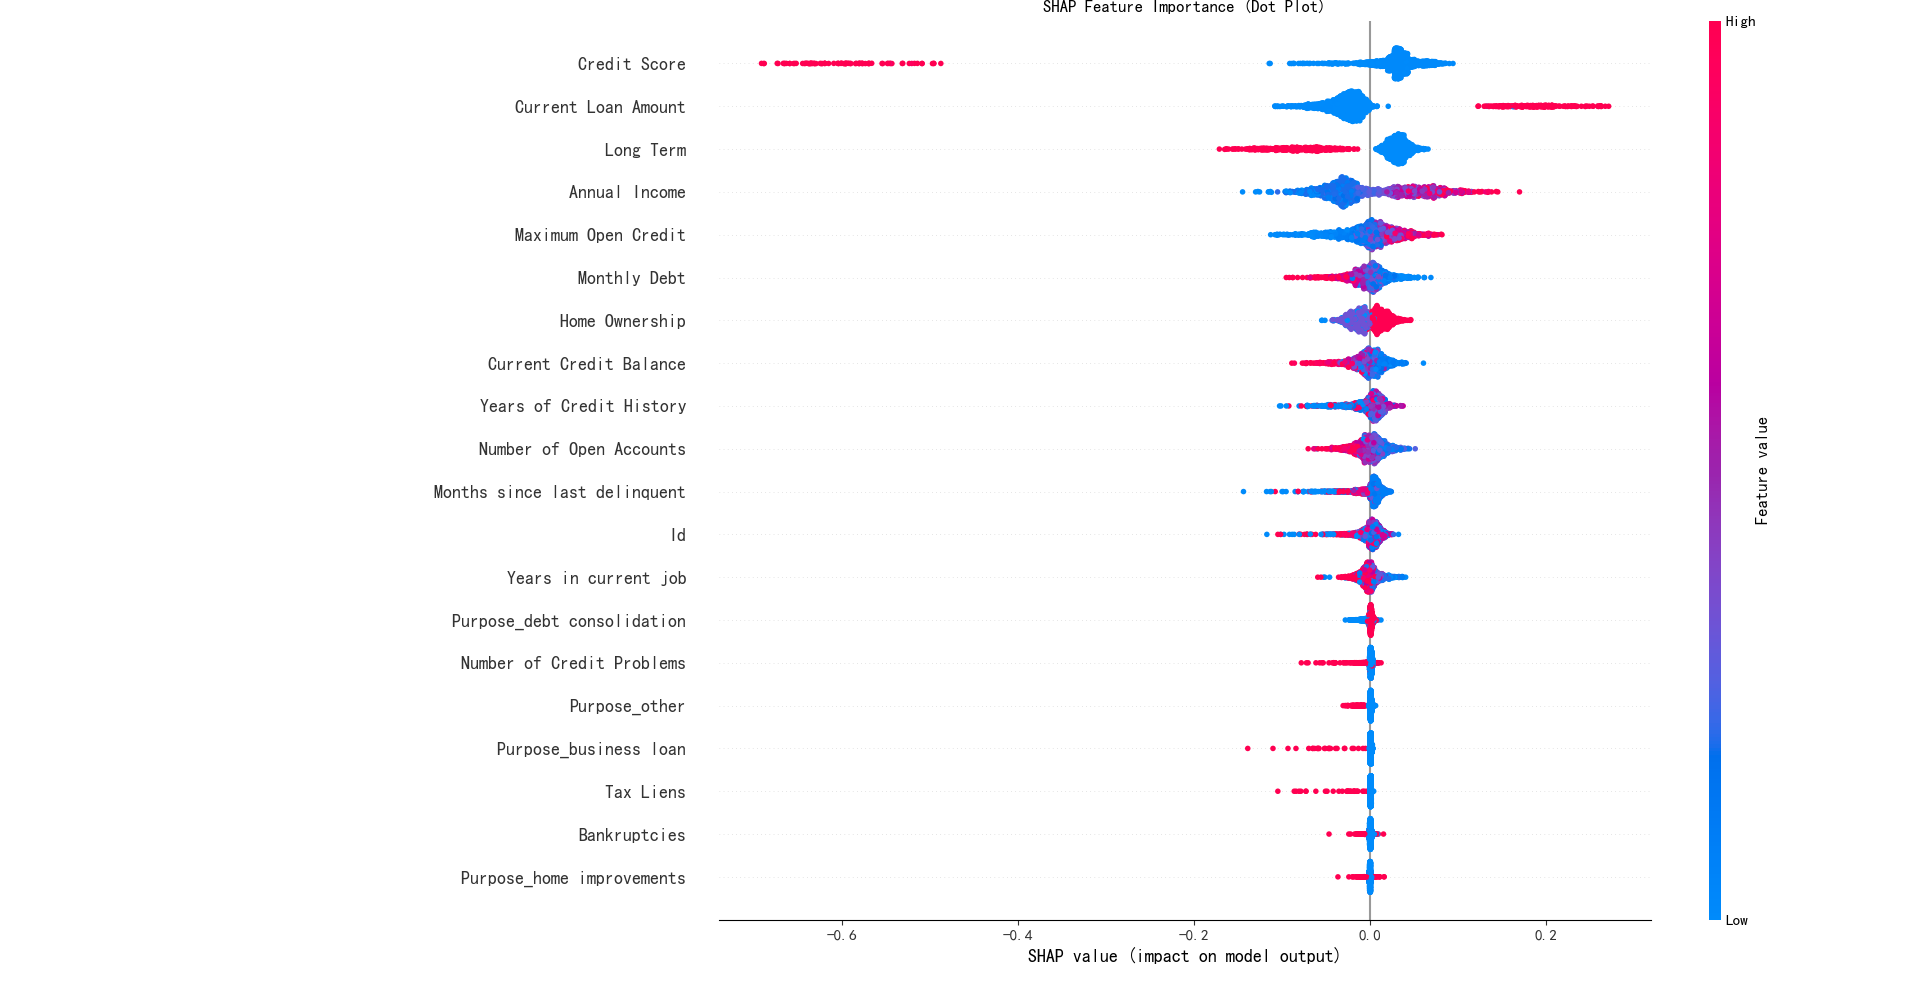
print("--- 3. SHAP 特征重要性 beeswarm 图 ---")
shap.summary_plot(shap_values[:, :, 0], X_test,plot_type="dot",show=False) # 这里的show=False表示不直接显示图形,这样可以继续用plt来修改元素,不然就直接输出了
plt.title("SHAP Feature Importance (Dot Plot)")
plt.show()

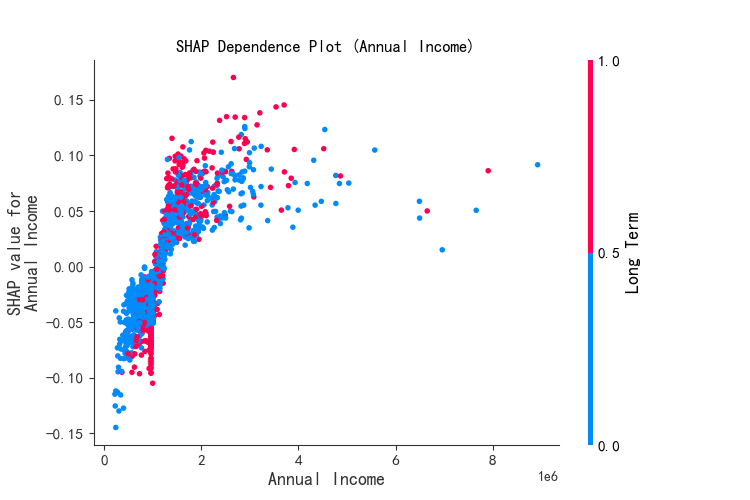
print("--- 4. SHAP 特征重要性 Dependence Plot 图 ---")
shap.dependence_plot("Annual Income", shap_values[:, :, 0], X_test,show=False) # 这里的show=False表示不直接显示图形,这样可以继续用plt来修改元素,不然就直接输出了
plt.title("SHAP Dependence Plot (Annual Income)")
plt.show()

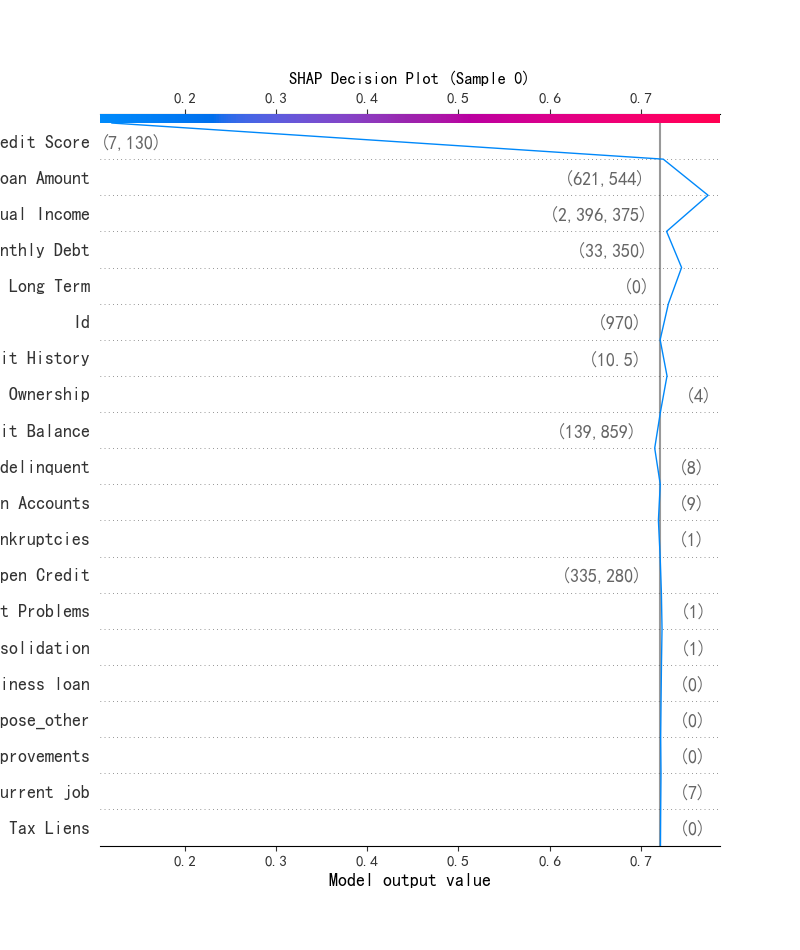
print("--- 5. SHAP 特征重要性 Decision plot 图 ---")
shap.decision_plot(explainer.expected_value[0], shap_values[0, :, 0], X_test.iloc[0],show=False) # 这里的show=False表示不直接显示图形,这样可以继续用plt来修改元素,不然就直接输出了
plt.title("SHAP Decision Plot (Sample 0)")
plt.show()


@浙大疏锦行 

【Python打卡Day14】shap可解释性分析 @浙大疏锦行 3)特征 A 的边际贡献: 对于每一个特征组合,比较“包含特征 A 的组合的预测值”与“不包含特征 A 但包含其他相同特征的组合的预测值”之间的差异。列表的第 k 个元素是一个 (n_samples, n_features) 的数组,表示所有样本的所有特征对预测类别 k 的贡献。(5)SHAP 值之和: 对于任何一个样本的预测,所有特征的 SHAP 值加起来,再加上基准值,就精确地等于该样本的模型预测值。对 n_samples 个样本中的每一个,计算 n_features 个特征各自的 SHAP 值。 阅读详情

相关推荐

SHAP 蜂群图 SHAP beeswarm 重要性 + 方向 + 分布 + 非线性

一句话概括:每一行是一个特征,每一个点是一个样本,该点的位置表示该特征对预测结果的贡献大小(SHAP值)。它解决了两个问题:哪些特征最重要?特征取值大 / 小时,对预测是正向还是负向影响?

weixin_39107270的博客 1607

60天python训练计划----day14

参考上述文档补全剩余的几个图尝试确定一下shap各个绘图函数对于每一个参数的尺寸要求,如shap.force_plot力图中的数据需要满足什么形状?确定分类问题和回归问题的数据如何才能满足尺寸,分类采取信贷数据集,回归采取单车数据集。

weixin_60667526的博客 434

【正点原子STM32连载】第六十章 串口IAP实战:从Bootloader到APP的无缝升级

本文以正点原子STM32F103开发板为例,详细讲解了串口IAP(在应用编程)技术的实现原理与实战步骤。内容涵盖Bootloader与APP的分工、FLASH空间规划、核心代码解析以及Ymodem协议的应用,旨在帮助开发者掌握通过串口为嵌入式设备实现远程固件升级的关键技术,提升产品维护与迭代效率。

weixin_29161719的博客 444

DAY16打卡 SHAP图的绘制

这就像“分蛋糕”:每个特征贡献自己的一块(SHAP 值),最后总和加上“默认蛋糕”(基准值)就是你得到的整块蛋糕(模型预测值)。shap_values # 每一行代表一个样本,每一列代表一个特征,值表示该特征对该样本的预测结果的影响程度。对实例化的模型输入一些已知条件,然后模型根据输入进行训练(内参),最终训练完的模型可以对该条件输出预测结果。自定义变量=shap库中的. 专门用来解析树模型的「翻译官」 (这是训练好的随机森林模型),通过量化每个特征对模型预测的贡献,为机器学习模型提供可解释性。

PJ1ul的博客 2906

Windows下QT5.15.2安装MQTT模块全攻略(附分支选择避坑指南)

本文详细介绍了在Windows环境下为QT5.15.2安装MQTT模块的完整流程,包括环境准备、源码获取、编译配置及项目集成等关键步骤。特别针对分支选择、依赖项处理和常见错误提供了实用解决方案,帮助开发者高效完成MQTT模块的安装与调试,适用于物联网开发场景。

weixin_29224589的博客 466

从虚拟机到双系统:手把手教你为Gromacs搭建最强Linux环境(含WSL2、Ubuntu22.04配置)

本文详细指导如何在Windows系统下为Gromacs分子动力学模拟搭建高性能Linux环境,涵盖WSL2和Ubuntu22.04双系统配置。通过对比虚拟机、WSL2和原生Linux的性能数据,提供GPU加速、内存优化等实用技巧,帮助科研人员提升计算效率。

weixin_30861797的博客 268

python打卡训练营学习记录Day14

尝试确定一下shap各个绘图函数对于每一个参数的尺寸要求,如shap.force_plot力图中的数据需要满足什么形状?确定分类问题和回归问题的数据如何才能满足尺寸,分类采取信贷数据集,回归采取单车数据集。今日作业偏思考类型,有一定难度。参考上述文档补全剩余的几个图。

m0_74839150的博客 205

f2fs学习笔记 - 3. F2FS文件系统布局

目录1.前言2.F2FS布局说明2.1. super block(block 0x0 ~ block 0x1ff)2.2 CP(block 0x200 ~ block 0x5ff)cp page1nat journalsit journaldata summarycurrent hot node summarycurrent warm node summarycurrent cold node summarycp page22nd checkpoint2.3 SIT(block 0x600 ~ block

HZero 4644

Python打卡训练营day14-shap值绘图

今天内容是画各种shap图,由于不同类型的图需要的输入数据的格式不同,需要针对性调整。今天代码报错太多了,调整之后勉强跑通,一天时间了解明白应该是不太够的,之后还需要进行针对性学习。尝试确定一下shap各个绘图函数对于每一个参数的尺寸要求,如shap.force_plot力图中的数据需要满足什么形状?确定分类问题和回归问题的数据如何才能满足尺寸,分类采取信贷数据集,回归采取单车数据集。Interaction Values(交互值)Dependence Plot(依赖图)参考上述文档补全剩余的几个图。

sak77的博客 414

从晶体管到触发器:为什么芯片设计必须区分同步/异步复位?

本文深入探讨了芯片设计中同步复位与异步复位的物理本质与工程权衡。从晶体管级的CMOS结构出发,剖析了两种复位方式在物理实现、时序可靠性(如建立/保持时间、恢复/移除时间)上的根本差异,并分析了在不同应用场景下的选择策略。文章强调,理解复位信号的底层机制对于确保芯片时序收敛、系统上电确定性及整体鲁棒性至关重要。

time3的博客 221

北斗导航 | 卫星/惯导组合导航方法

从组合导航结构方面来讲,卫星/惯导(下文以GPS/INS)组合模式一般分为三种,即松组合、紧组合和超紧组合(即深组合)。

尘世冰封的专栏 1533

python打卡训练营打卡记录day24

元组的特点:1. 有序,可以重复,这一点和列表一样2. 元组中的元素不能修改,这一点非常重要,深度学习场景中很多参数、形状定义好了确保后续不能被修改。很多流行的 ML/DL 库(如 TensorFlow, PyTorch, NumPy)在其 API 中都广泛使用了元组来表示形状、配置等。可以看到,元组最重要的功能是在列表之上,增加了不可修改这个需求。

yorushika_的博客 1256

Debezium系列之:深入理解 Debezium Topic的设置要求

Debezium系列之:配置 Debezium Topic

zhengzaifeidelushang的博客 1009

python打卡训练营学习记录_250426

这是坚持的第6天,但是内容停留在了第四天

sinat_42979910的博客 692

手把手教你学Simulink--控制执行场景实例:基于Simulink的智能车辆自动紧急制动(AEB)仿真

本文完成了基于 Simulink 的智能车辆自动紧急制动(AEB),实现了:✅ 构建前车急刹与静止障碍物典型场景✅ 设计基于 TTC 的三级 AEB 决策逻辑✅ 验证在高风险场景下有效避免碰撞✅ 掌握从风险评估到制动执行的完整安全链✅ 为ADAS 主动安全功能开发奠定基础。

MHD0815的博客 235

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

python打卡训练营打卡记录day14

作业:1.参考上述文档补全剩余的几个图2.尝试确定一下shap各个绘图函数对于每一个参数的尺寸要求,如shap.force_plot力图中的数据需要满足什么形状?3.确定分类问题和回归问题的数据如何才能满足尺寸,分类采取信贷数据集,回归采取单车数据集。

yorushika_的博客 293

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

Python打卡训练营学习记录Day16

array([[ 23, 29, 35], [ 53, 67, 81], [ 83, 105, 127]])不太懂这里怎么得出来的。a @ b.T # 矩阵乘法,3*2的矩阵和2*3的矩阵相乘,得到3*3的矩阵。

FanfanPyt的博客 192

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

python打卡训练营打卡记录day15

尝试找到一个kaggle或者其他地方的结构化数据集,用之前的内容完成一个全新的项目,这样你也是独立完成了一个专属于自己的项目。仔细回顾一下之前14天的内容,没跟上进度的同学补一下进度。有数据地址的提供数据地址,没有地址的上传网盘贴出地址即可。尽可能与他人不同,优先选择本专业相关数据集。探索一下开源数据的网站有哪些?

m0_74839150的博客 402

Python 打卡训练营Day7

心脏病项目的数据集来完成数据的预处理。

2501_91325156的博客 305

python打卡训练营打卡记录day31

知识点回顾规范的文件命名规范的文件夹管理机器学习项目的拆分编码格式和类型注解作业:尝试针对之前的心脏病项目ipynb,将他按照今天的示例项目整理成规范的形式,思考下哪些部分可以未来复用。心脏病项目目录。

yorushika_的博客 757

Python打卡训练营学习记录Day28

calculate_perimeter():计算周长(公式:2×(长+宽))。is_square() 方法,判断是否为正方形(长 == 宽)。calculate_circumference():计算圆的周长(公式:2πr)。shape_type="rectangle":创建长方形(参数:长、宽)。calculate_area():计算圆的面积(公式:πr²)。shape_type="circle":创建圆(参数:半径)。calculate_area():计算面积(公式:长×宽)。

FanfanPyt的博客 195

Day31 Python打卡训练营

这个项目实现了一个信用违约预测模型,使用随机森林算法对客户是否会发生信用违约进行预测。

2503_90248820的博客 576

python打卡训练营day14—2025.05.03

【代码】python打卡训练营day14—2025.05.03。

hans041113的博客 189

疏锦行Python打卡 DAY 14 SHAP图的绘制

【代码】疏锦行Python打卡 DAY 14 SHAP图的绘制。

weixin_51658332的博客 307

python打卡训练营打卡记录day16

因为前天说了shap,这里涉及到数据形状尺寸问题,所以需要在这一节说清楚,后续的神经网络我们将要和他天天打交道。numpy数组的创建:简单创建、随机创建、遍历、运算。numpy数组的索引:一维、二维、三维。SHAP值的深入理解。

m0_74839150的博客 191
上一篇: Python打卡训练营学习记录Day13
下一篇: Python打卡训练营学习记录Day15
FanfanPyt
博客等级 码龄2年 82粉丝 50原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值