


深度解析大模型Agent架构:从ReAct到LLM Compiler的并发执行革命
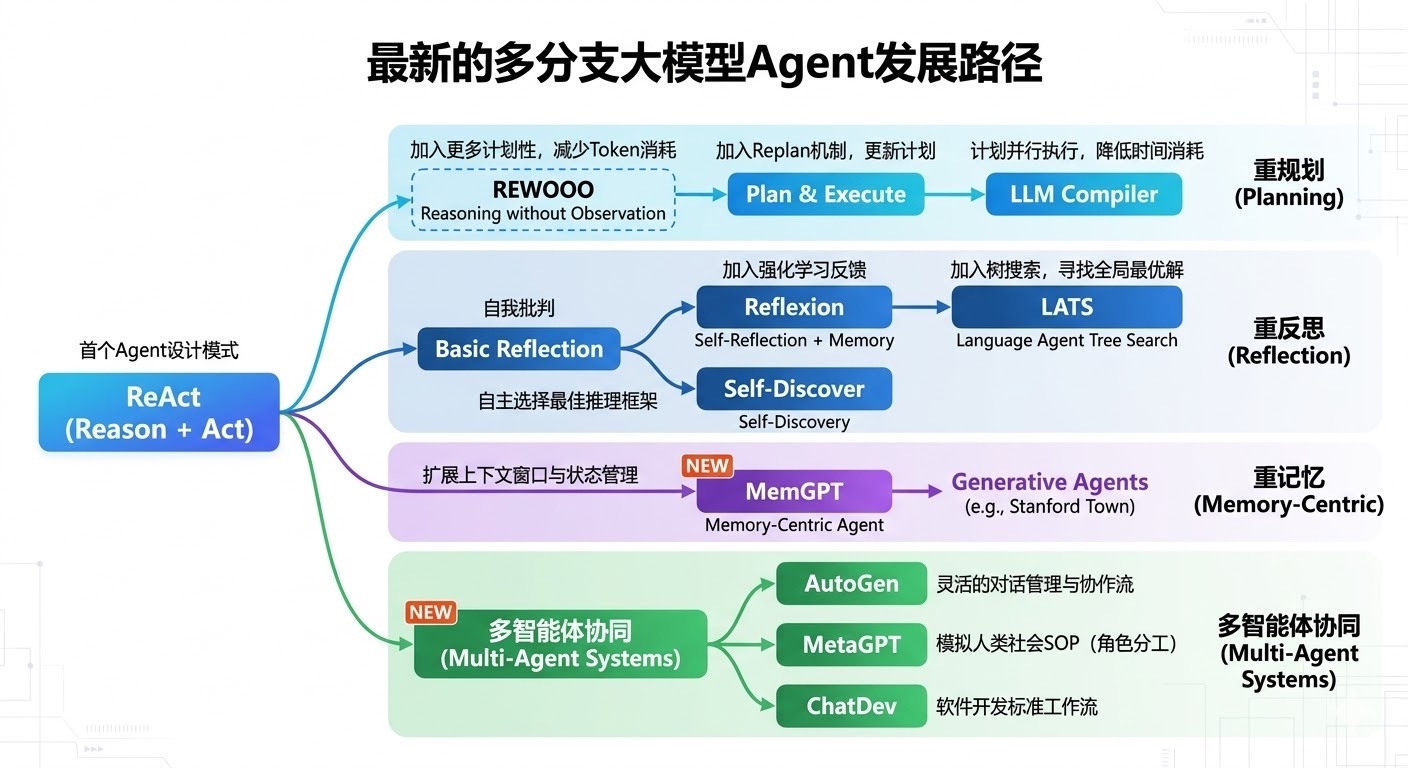
在LLM Agent的发展历程中,如何让模型具备人类级别的“规划与执行”能力,一直是学术界和工业界攻坚的核心。从最早的单步推理范式,到如今复杂的多分支协同,Agent的底层架构经历了极大的演进。
结合最新的Agent发展路径图,我们可以清晰地看到一条主线:重规划(Planning)分支的演进。今天,我们将剥丝抽茧,深入剖析这条分支上的明珠——LLM Compiler(大模型编译器范式)。
一、 为什么我们需要LLM Compiler?(技术演进的来龙去脉)
在理解LLM Compiler之前,我们必须明白前人走过的弯路。任何新架构的提出,都是为了解决旧架构的痛点。从上图中的“Planning”分支来看,Agent的发展经历了以下几个阶段:
1. 启蒙时代:ReAct (Reason + Act)
作为首个Agent设计模式,ReAct提出了“观察-思考-行动”的循环。
- 痛点:它是严格的串行执行。每执行一步工具,都需要把前面的所有历史记录(Context)重新输入给大模型。随着步骤增加,Token消耗呈指数级上升,且极其容易触发“上下文遗忘”;更致命的是延迟极高。
2. 尝试解耦:REWOO (Reasoning without Observation)
为了解决ReAct的Token消耗问题,REWOO提出“先制定完整计划,再统一执行”。
- 进步:将“规划”与“执行”解耦,极大减少了Token消耗。
- 痛点:缺乏动态调整能力。如果在执行到第3步时发现第1步的结果不符合预期,整个计划就会崩溃(所谓的“盲目执行”)。
3. 引入反馈:Plan & Execute
在REWOO的基础上,引入了Replan(重规划)机制,执行后会根据结果更新下一步计划。
- 痛点:虽然解决了准确率问题,但依然是串行逻辑。面对需要调用多个无关联工具的复杂任务时(例如:同时查询北京的温度和上海的温度),依然需要按顺序一步步调用,时间开销极大。
4. 终极形态:LLM Compiler
为了解决 时间消耗(Latency) 问题,伯克利大学的SqueezeAILab于2023年12月提出了 LLM Compiler 新项目。这个项目在ReWOO引入的变量分配的基础上,进一步训练大语言模型生成一个有向无环图(Directed Acyclic Graph,DAG)类的规划。DAG可以明确各步骤任务之间的依赖关系,从而并行执行任务,实现类似处理器“乱序执行”的效果,可以大幅加速AI Agent完成任务的速度。
通过DAG,系统可以清楚地知道哪些任务存在依赖(必须串行),哪些任务相互独立(可以并行),从而将系统总耗时从 T t o t a l = ∑ i = 1 n T i T_{total} = \sum_{i=1}^{n} T_i Ttotal=∑i=1nTi 优化为 T t o t a l ≈ max p ∈ P a t h s ∑ v ∈ p T v T_{total} \approx \max_{p \in Paths} \sum_{v \in p} T_v Ttotal≈maxp∈Paths∑v∈pTv (即关键路径的耗时)。
二、 LLM Compiler的底层原理深度剖析

LLM Compiler的设计灵感直接来源于传统计算机科学中的编译器原理。它主要由三个核心模块构成:LLM Planner(规划器)、Task Fetching Unit(任务调度器)和Executor(执行器)。
1. LLM Planner:自然语言到DAG的“前端编译”
在传统编译器中,前端负责将高级语言解析为抽象语法树(AST)。在LLM Compiler中,Planner的作用是将用户的自然语言Query转化为一张有向无环图(DAG)。
- 底层机制:Planner需要输出标准化的格式(通常是JSON),定义节点(Task)和边(Dependencies)。
- 核心难点:变量占位符(Placeholder)。由于后续任务可能依赖前置任务的结果,但当前前置任务还未执行,Planner会生成类似
"$1", "$2"这样的占位符。- 示例:任务1是
search("北京天气"),任务2是translate(text="$1", target="English")。这里的$1就是一条表示依赖关系的边。
- 示例:任务1是
2. Task Fetching Unit:依赖解析与拓扑排序
这是LLM Compiler实现并行的灵魂所在。它的本质是一个维护DAG状态的状态机。
- 算法本质:图论中的拓扑排序(Topological Sort)。
- 系统为每个节点维护一个 入度(In-Degree) 计数器。如果任务 B B B 依赖任务 A A A,则 B B B 的入度为 1。
- 当一个任务的入度降为 0 0 0 时,说明它的所有前置依赖已经完成,该任务被送入“就绪队列(Ready Queue)”。
3. Executor:并行计算与占位符替换
执行器从就绪队列中拉取任务,并分配给不同的工作线程或协程(Coroutines)执行。
- 动态替换:在真正调用工具前,Executor会拦截带有
$1等占位符的参数,去内存中查表(Memory State),将其替换为真实的前置任务执行结果,然后再发起API调用。
4. Replan去哪了?
上图是LLM Compiler 的 基础运行形态(Static DAG),在这个基础形态中,系统假设所有的依赖关系在 一开始(AOT,提前编译) 就能被完全确定。比如图中的算苹果和微软市值,它是一次性规划到底的。
但在真实复杂的场景(如 Game of 24 结合 Tree-of-Thoughts 的任务)中,一开始是无法画出完整的图的,必须走一步看一步。这时候就需要 “动态编译”(JIT,即时编译),也就是Replanning。
在 LLM Compiler 的架构中,Replan 并不是一个独立的新模块,而是通过“控制流(Control Flow)回环”重新调用 Function Calling Planner 来实现的。
让我们重新推演一次包含 Replan 的动态数据流:
- 初始阶段(第一层级规划):
Function Calling Planner根据初始输入,生成第一批任务节点(例如 ToT 中的几个初步思路)。 - 调度与执行:
Task Fetching Unit将这些独立任务并行送入Executor进行求值。 - 记忆更新(触发 Replan 的关键):
Executor中的 Tool 执行完毕后,会将结果写入对应节点的 Memory 中。 - 状态评估与回环(The Replan Phase):当系统发现当前 DAG 已经执行完毕,但任务目标尚未达成(例如 24 点还没算出来),系统的 顶层大循环(Outer Loop) 会将 Memory 中的中间结果打包,重新作为 Context 输入给
Function Calling Planner。 - 动态图扩展:Planner 根据中间结果,生成 新的 DAG 节点 ,并将它们动态追加到
Task Fetching Unit中继续调度。
也就是说, Function Calling Planner 不仅负责 First Plan,同样兼职了 Replan 的工作。
三、 常见QA
🔴 追问 1:如果LLM Planner生成的DAG存在环(依赖死锁),系统该如何处理?
面试官意图:考察候选人对图算法的掌握程度以及系统的鲁棒性设计。
深度解析:
“在实际工程中,大模型由于幻觉,极有可能生成 A A A 依赖 B B B, B B B 依赖 A A A 的循环依赖任务。为了防止执行器死锁,我们必须在Task Fetching Unit接收到图结构时,第一时间进行环路检测。
在底层,我会实现一个经典的 Kahn算法 或者基于 DFS的图遍历,时间复杂度为 O ( V + E ) O(V + E) O(V+E)( V V V为顶点数, E E E为边数)。一旦检测到环,系统不会直接崩溃,而是触发 Fallback 机制:将产生环的局部图作为Error Message,利用Self-Correction(自我纠错)机制打回给 Planner,要求其重新生成没有死锁的调度计划。”
🔴 追问 2:LLM Compiler在并行执行中,如果某个节点(工具调用)失败了,或者结果不符合预期,该如何进行Replan?
面试官意图:考察LLM Compiler(并行)与Plan & Execute(串行重规划)结合的深度思考。
深度解析:
“这正是LLM Compiler区别于传统静态DAG调度(如Airflow)的地方,Agent需要具备动态图剪枝与重构的能力。
假设图中存在路径 A → B → C A \rightarrow B \rightarrow C A→B→C 和平行节点 D D D。如果 A A A 执行失败(例如API超时或返回格式错误),我会采取以下策略:
- 级联取消(Cascading Abort):立刻阻断并清理 A A A 的下游节点 B B B 和 C C C 的执行计划,因为它们的前提条件已失效。
- 局部重规划(Local Replan):此时 D D D 的执行不受影响(体现并行的优势)。系统会将 A A A 的失败原因提取出来,单点询问LLM Planner:‘任务 A A A 失败,原因如下,请提供替代方案’。
- 图合并(Graph Merging):将 Planner 新生成的补救路径(例如 A ′ → B ′ A' \rightarrow B' A′→B′)动态插入到原来的执行引擎中,更新入度表,继续调度。这样既保证了容错性,又没有牺牲全局的并发效率。”
🔴 追问 3:相比于ReAct,LLM Compiler的Prompt设计有什么特殊挑战?你是如何做Context管理的?
面试官意图:考察Prompt Engineering的深度与大模型上下文窗口的优化经验。
深度解析:
“ReAct的Prompt通常是
Observation-Reason-Action的Few-shot示例。而LLM Compiler的Planner Prompt必须强迫模型进行逆向思维与依赖拆解。挑战在于:大模型很难一次性正确输出复杂的多层级占位符。
我的Context管理与Prompt策略是:
- 工具元数据抽象:我不会把所有工具的详细说明全部塞给 Planner。我会先通过轻量级的 Embedding 检索,只召回与当前任务高相关的 Top-K 工具签名(Tool Signatures),减少Context污染。
- 强制类型约束:利用大模型的 Function Calling (如OpenAI的 JSON Schema) 强制约束输出格式,保证生成的节点
[Task_ID, Tool_Name, Args, Dependencies]字段严格对齐。- 状态隔离:在 Executor 执行阶段,每个并发任务的 Context 是隔离的。任务 A A A 和任务 D D D 在执行时,不需要知道彼此的历史。只有在最后需要综合答案时,才会把有用的节点结果聚合送给最终的生成节点(Join Node)。这极大地节约了重复输入历史步骤所消耗的 Token。”
四、 总结与前瞻
从 ReAct 的“摸着石头过河”,到 LLM Compiler 的“运筹帷幄,多线并进”,Agent 的执行引擎越来越接近现代操作系统与编译器的设计哲学。
掌握 LLM Compiler 范式,不仅仅是学会了一种新的提示词技巧,更是要求我们将分布式系统、图计算算法、编译器理论与 LLM 的推理能力进行深度融合。在未来的面试中,谁能把 Agent 讲出“系统架构”的厚度,谁就能在内卷的大厂竞争中脱颖而出。
 4725


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


