机器学习模型(2/4课时):损失函数

机器学习总结(一):常见的损失函数 这是博主的第一篇博客,mark一下,希望今后能够坚持下去。博主是机器学习菜鸟,将来希望从事机器学习的工作,最近在整理机器学习的知识点,将这些总结的文字以博客的形式展现出来,一是便于复习,二是分享出来希望能对别人会有一点点帮助。最近搜集了一些机器学习常见的面试问题,将问题和回答整理出来,做到有备无患。(随时进行补充)一、常见的损失函数通常机器学习每一个算法中都会有一个目标函数,算法的求解过程是通过对这 阅读详情

损失是一个数值指标,用于描述模型的预测有多大偏差。损失函数用于衡量模型预测与实际标签之间的距离。训练模型的目标是尽可能降低损失,将其降至最低值。

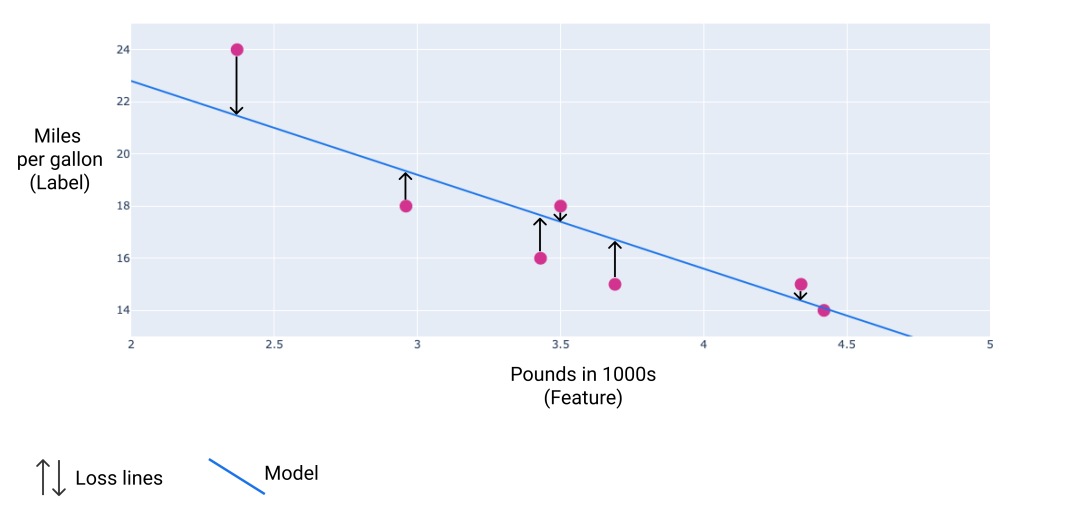
在下图中,您可以将损失可视化为从数据点指向模型的箭头。箭头表示模型的预测结果与实际值之间的差距。
图片

- 图1 - 

损失是从实际值到预测值衡量的。

» 丢失距离

在统计学和机器学习中,损失函数用于衡量预测值与实际值之间的差异。损失函数侧重于值之间的距离,而不是方向。例如,如果模型预测值为 2,但实际值为 5,我们并不关心损失为负值 −3(2−5=−3)。我们关心的是这两个值之间的距离为 3。因此,所有用于计算损失的方法都会移除符号。

移除此标记的两种最常用方法如下:

  • 计算实际值与预测值之间的差值的绝对值。

  • 将实际值与预测值之间的差值平方。

» 损失类型

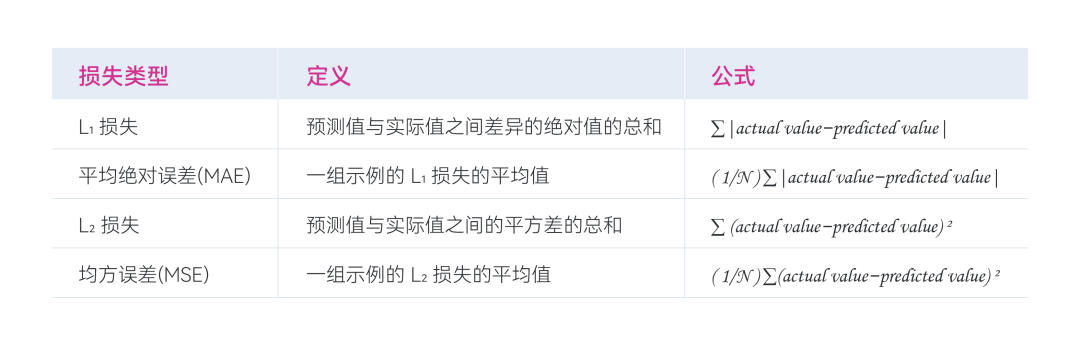
在线性回归中,有四种主要的损失函数,如下表所示。
图片

- 图2 -

L1损失函数和 L2 损失函数(或 MAE 和 MSE)之间的功能差异在于平方。当预测值与标签之间的差异较大时,平方会使损失变得更大。当差异很小(小于 1)时,平方会使损失更小。

同时处理多个示例时,我们建议对所有示例的损失进行平均,无论是使用 MAE 还是 MSE。

» 计算损失示例

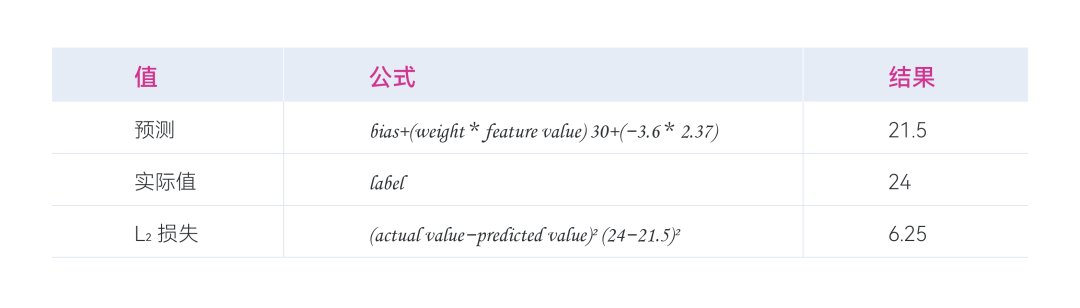
使用之前的最佳拟合线,我们将计算单个示例的 L2 损失。从最优拟合线中,我们得到了权重和偏差的以下值:

  • Weight: −3.6

  • Bias: 30

如果模型预测重 2,370 磅的汽车每加仑可行驶 21.5 英里,但实际每加仑可行驶 24 英里,我们将按如下方式计算 L2 损失:

( ※ 注意: 由于图表的比例为 1000 磅,因此公式使用 2.37)
图片

- 图3 -

在此示例中,该单个数据点的 L2 损失为 6.25。

» 选择损失

确定是使用 MAE 还是 MSE 可能取决于数据集以及您希望处理特定预测的方式。数据集中的大多数特征值通常属于一个特定范围。例如,汽车通常在 2,000 到 5,000 磅之间,每加仑汽油能行驶 8 到 50 英里。重 8,000 磅的汽车或每加仑汽油行驶 100 英里的汽车都超出了典型范围,会被视为离群值。

离群值还可以指模型的预测与真实值之间的差距。例如,3,000 磅的车重属于典型的车重范围,而每加仑 40 英里的油耗属于典型的油耗范围。但是,对于模型的预测而言,重 3,000 磅的汽车每加仑能行驶 40 英里属于离群值,因为模型会预测重 3,000 磅的汽车每加仑能行驶 18 到 20 英里。

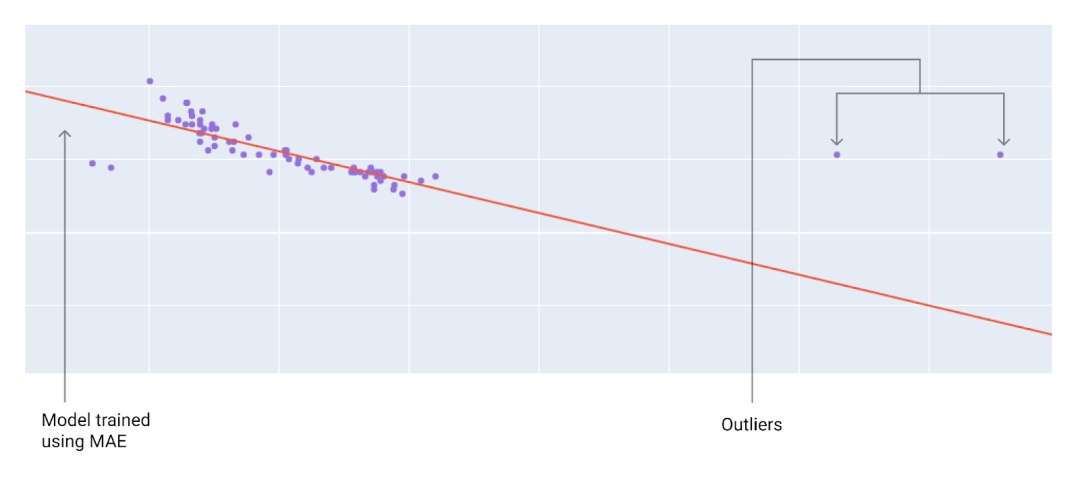
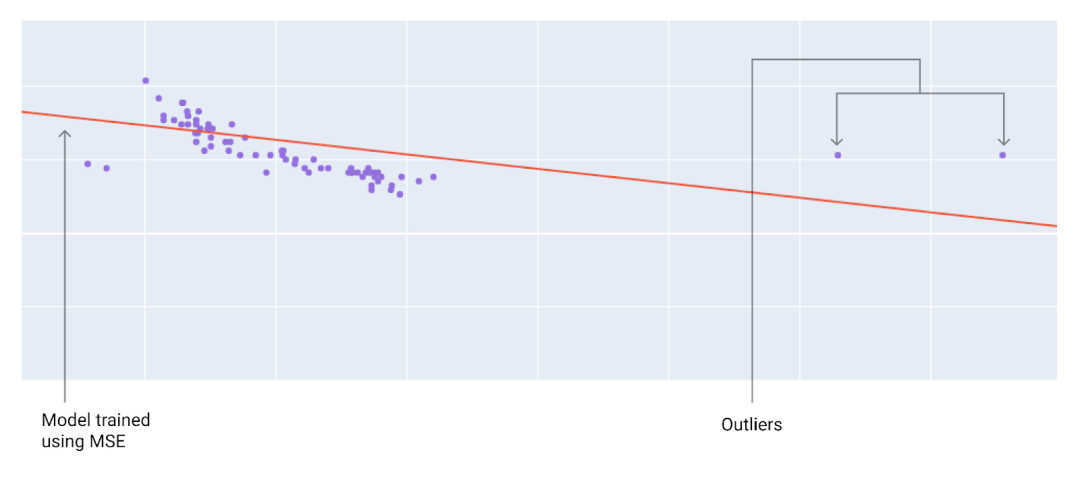
选择最佳损失函数时,请考虑您希望模型如何处理离群值。例如,MSE 会使模型更接近离群值,而 MAE 则不会。与 L1 损失函数相比,L2 损失函数对离群值的惩罚更高。例如,以下图片显示了使用 MAE 训练的模型和使用 MSE 训练的模型。红线表示将用于进行预测的完全训练好的模型。离群值更接近使用 MSE 训练的模型,而不是使用 MAE 训练的模型。
图片

- 图4 -

使用 MSE 训练的模型会使模型更接近离群值。

图片

- 图5 -

使用 MAE 训练的模型与离群值的距离更远。

请注意模型与数据之间的关系:

  • MSE:

    模型更接近离群值,但与大多数其他数据点的距离更远。

  • MAE:

    模型离离群值较远,但离大多数其他数据点较近。

大白话讲解机器学习-损失函数 损失函数是机器学习里最基础也是最为关键的一个要素,通过对损失函数的定义、优化,就可以衍生到我们现在常用的LR等算法中。 阅读详情

相关推荐

机器学习:2.损失函数, my write

在机器学习的语境下这三个术语经常被交叉使用。一句话总结三者的关系就是:A loss function is a part of a cost function which is a type of an objective function.(损失函数是目标函数的一种,它是代价函数的一部分。简单来说,损失函数(Loss Function)是机器学习和深度学习中的一个关键概念,用于衡量模型预测值与真实值之间的差异。损失函数的值越小,表示模型的预测结果越接近真实值。

小硕算法工程师 776

AI/ML 基础知识与常用术语全解析

AI/ML入门:基础知识与常用术语全解析,超全的哟~

Pocker_Spades_A的博客 7175

L2损失函数

L2损失函数是一种常用的损失函数,尤其适用于回归任务。它通过平方误差来衡量预测值与真实值之间的差异,并且对较大的误差进行更强的惩罚,确保模型能够更准确地拟合数据。

m0_51200050的博客 1733

浅析机器学习中各种损失函数及其含义

常见的损失函数1.0-1损失函数(0-1 loss function)L(Y,f(X))={1,Y≠f(X)0,Y=f(X) L(Y,f(X))=\left\{ \begin{aligned}&1,\quad Y\ne f(X)\\& 0,\quad Y=f(X) \end{aligned} \right.   可以看出,该损失函数的意义就是,当预测错误时,损失函数值为1,预测正确时,损失函数值为0

Eason的博客 2万+

详解机器学习中的损失函数

Class Content layout post title 详解机器学习中的损失函数 categories Blog description 机器学习中常见的损失函数以及它们的特点和适用场景 keywords 机器学习 损失函数 风险函数 1. 前言 我们知道机器学习的三要素是:方法= 模型+策略+算法,...

毛毛虫_Wendy的博客 5492

机器学习中几种损失函数的分析

在机器学习中,损失函数是非常重要的,用于衡量目标结果的好坏,用于训练模型,损失函数就是目标函数了。常见的损失函数有以下几种: 1.‘0/1损失函数’ f(z)=1, 如果z是小于零的,其他就等于0. 性质:不是凸函数,不是连续的函数,数学性质不是非常好,一般用于感知机算法,感知机算法的损失函数就是这个。为了克服这个函数不连续,不是凸函数的问题,出现了其他几种可以替代的函数 2.hinge损

UESTC_C2_403的博客 5951

机器学习——损失函数

损失函数(loss function)又称为误差函数(error function),是衡量模型好坏的标准,用于估量模型的预测值与真实值的不一致程度,是一个非负实值函数。损失函数的一般表示为L(y,f(x)),用以衡量真实值y与预测值f(x)不一致的程度,一般越小越好。

qq_41566819的博客 2733

机器学习之损失函数

在机器学习中,损失函数(Loss Function)是用来衡量模型预测结果与实际标签之间差异的一种函数。它是优化算法的核心,通过最小化损失函数来调整模型的参数,使得模型能够更好地拟合训练数据并在新数据上表现良好。

JustinMars的博客 1762

机器学习模型(3/4课时):梯度下降

如果我们绘制梯度下降过程中的权重和偏置点图表,这些点看起来就像从山上滚落的球,最终会在没有下坡的点停止。在训练过程中直观呈现模型的快照状态,有助于加深对更新权重和偏差、降低损失和模型收敛之间的联系的理解。您可以看到,在前几次迭代中,损失会大幅下降,然后逐渐下降,在第 1,000 次迭代左右趋于平稳。当模型收敛时,进行更多迭代不会进一步降低损失,因为梯度下降法已找到几乎能将损失降至最低的权重和偏差。请注意,黑色损失点形成了损失曲线的确切形状:先急剧下降,然后逐渐向下倾斜,直到达到损失表面上的最低点。

EasyOps_DevOps的博客 914

不用买VR设备!用UE5内置模拟器开发虚拟现实项目的完整教程

本文提供了一套无需购买昂贵VR硬件的虚拟现实开发最佳实践方案。详细介绍了如何利用虚幻引擎5内置的XR模拟器,从零开始配置开发环境、模拟操作、构建场景并实现核心交互逻辑。通过这套纯软件方案,开发者可以高效学习VR开发核心,大幅降低入门门槛和成本。

weixin_29019241的博客 623

GEE开发之ERA5(气温、降水、压力、风速等)数据获取和分析

前言:ERA5主要提供DAILY和MONTHLY两大类别数据,其中主要包括气温、降水、压力、风速等。

等待着冬天的风的博客 3万+

机器学习模型(4/4课时):超参数

但是,如果学习速率过高,模型将永远不会收敛,而是在最小化损失的权重和偏差之间来回跳动。模型会随机选择每个批处理中包含的示例,对其梯度求平均值,然后每迭代一次更新权重和偏差。例如,如果梯度幅度为 2.5,学习率为 0.01,则模型将将参数更改 0.025。损失图,显示使用过大学习率训练的模型,其中损失曲线会大幅波动,随着迭代次数的增加而上下波动。请注意,使用随机梯度下降法可能会在整个损失曲线中产生噪声,而不仅仅是在收敛附近。损失图,显示使用过大学习速率训练的模型,其中损失曲线在后续迭代中急剧增加。

EasyOps_DevOps的博客 769

嵌入式统一消息机制:模块解耦与零拷贝通信设计

在嵌入式系统开发中,模块间通信(IMC)是影响可维护性与实时性的关键环节。传统IPC方式如全局变量、信号量或Socket易导致高耦合、调试困难及跨平台适配成本高。统一消息机制通过逻辑地址抽象、标签/实体分离、路由表驱动等原理,实现控制流与数据流解耦,在裸机、RTOS及Linux用户态保持一致接口。其技术价值在于降低模块依赖复杂度、支持动态增删与分布式迁移,并通过零拷贝优化显著减少CPU与内存开销。典型应用场景涵盖工业网关、城域交换机、多核ARM边缘设备等资源受限环境,尤其适用于需长期稳定运行、快速迭代与混合

weixin_35257663的博客 282

[机器学习笔记] 什么是损失函数?

机器学习模型关于单个样本的预测值与真实值的差称为损失。损失越小,模型越好,如果预测值与真实值相等,就是没有损失。 用于计算损失的函数称为损失函数。模型每一次预测的好坏用损失函数来度量。 常用的损失函数有以下几种(引用自李航的《统计学习方法》) 1. 0-1损失函数 二类分类任务中,预测值与真实值不同,就是预测错误,则损失是1; 预测值与真实值相等,就是预测正确,损失是 0,就是

jieming2002的博客 1万+

5分钟搞定!用ZLMediaKit搭建GB28181视频监控系统(含避坑指南)

本文提供了一份基于ZLMediaKit搭建GB28181视频监控系统的实战指南。文章详细介绍了从环境准备、核心组件(ZLMediaKit与SIP服务器)部署、摄像头配置到内外网穿透的完整流程,并重点分享了设备ID配置、防火墙设置等关键避坑经验,帮助开发者快速构建稳定可控的监控平台。

apple5的专栏 1087

Flow Matching05:概率路径与插值【概率路径:线性插值路径(最简单)、高斯插值路径】【先尝试线性插值,看效果如何;若不够好,尝试高斯插值】

好的,我将从数学角度详细解释Flow Matching,从高中生能理解的基础知识开始,逐步深入到高级概念。

u013250861的博客 174

机器学习损失函数

机器学习入门

sfakh的博客 1635

“华为杯”研究生数学建模竞赛2016年-【华为杯】A题:多无人机协同任务规划

题分别求解,保证了攻击方无人机滞留在防御方雷达有效探测范围内的时间总和最小,接着,通过提出巡检待命无人机的设想,型无人机携带炸弹的具体清单和攻击的目标清单),保证攻击方的无人机滞留防御方雷。在使用基于贪心算法的覆盖法时,覆盖的目标点中必须首先不含配备雷达站的目标点。步优化保证攻击方的无人机滞留防御方雷达有效探测范围内的时间总和最小,需首先。的“灵巧”炸弹,采用抛投方式对地攻击,即投放后炸弹以飞机投弹时的速度作抛物。运动,当炸弹接近目标后,可主动寻的攻击待打击的目标,因此炸弹落点位于目标中。

getusushu的博客 1038

各机器学习模型的损失函数

1、目录 1、目录 2、前言 3、模型 1)感知机 2)SVM 3)LR 2、前言   最近被问到一些机器学习模型的损失函数,虽然经常使用,竟然记得不怎么准确,今天来梳理复习一下。后续继续补充。 3、模型 1)感知机   感知机就是求出一个超平面,划分正负样本集。损失函数就是所有误分点到超平面的总距离:   −1||w||∑xi∈Myi(w⋅xi+b)...

melon0014的博客 2027

【智能车Code review】——拐点的寻找

CROSSROAD:十字拐点 ROUNDISLAND:环岛拐点 rightfindflag[i]:表示第i行的右线是否被找到,1为找到,0为没有找到 flag_find_huan_rightdown_point :找到环岛右下拐点标志 flag_find_huan_rightmiddle_point:找到环岛右中拐点标志 找拐点的思路:观察一段数据中数据点的走向趋势,并且保证这段数据是准确的。在摄像头畸变比较严重的情况下这种方法不再适用 关于函数的调用请见:https://blog.youkuaiyun.com/qq.

hanhan的博客 1万+

国科大学习资料--计算机网络--历年考题1

国科大学习资料–计算机网络–历年考题1 1、假定有一个通信协议,每个分组都引入100字节的开销用于头和成帧,现在使用这个协议发送1M字节的数据(为方便计算,1M=10^6),然而在传递的过程中有一个字节被破坏了,因而包含该字节的那个分组被丢弃并重传。(1)当数据的分组大小为1000、5000、20000和40000字节时,计算相应(包括开销)的传递字节总数目。(2)计算分组大小的最优值是多少,即分组的大小为何值时总的传输字节数最少。(提示:最优值不是1000、5000、20000和40000字节中的一个)

无名何许人的博客 1182

机器学习中损失函数、评价指标解读

摘要:本文系统梳理了机器学习中损失函数与评价指标的区别与应用。损失函数用于训练优化(如回归中的MAE/MSE,分类中的交叉熵),评价指标则评估模型性能(分类常用Accuracy/Precision/Recall,回归常用MAE/RMSE/R2)。重点解析了混淆矩阵相关指标(TPR/FPR等)的计算逻辑,并通过雷达信号案例说明Accuracy/Precision/Recall的区别。同时对比了回归任务五大指标特性,指出MSE对异常值敏感、MAPE适合跨量级比较等特点。最后强调ROC曲线与PR曲线在不同数据分布

weixin_44649039的博客 1822

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

关于机器学习中的损失函数。到底什么是损失函数。

说到机器学习,初学者听到最多的就是 损失函数了吧  我对这个词也是一头雾水 好像今天一个定义明天又是一个定义 ,读了大量的文章和博客 终于有点起色 (感谢论坛各位大佬) 这里用自己的简单语言大致说下什么是损失函数 如果一个地方看不懂就换个博客看 总会有适合你的文章 万一这篇就是了呢 首先我们需要了解损失函数的定义是什么:衡量模型模型预测的好坏 可能这么说有点小小的抽象 ,那么在解释

妖白的奇幻漂流世界 4万+

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

机器学习常见损失函数

机器学习常见损失函数 损失函数作用:损失函数是用于衡量模型预测值与真实值之间差距的函数,损失函数的值越小越好。 常见的损失函数有如下几种: 分类问题 0-1损失函数(Zero-one Loss): 当且仅当预测为真的时候取值为1,否则取值为0。可以看出该损失函数过于严格,导致其具有非凸、非光滑的特点,使得算法很难直接对该函数进行优化。 感知损失函数(Perceptron Loss): 感知损失函数在0-1损失函数的基础上增加一个阈值,大于阈值则为正例,小于阈值则为负例。 铰链损失函数(Hinge Los

turned的博客 2324

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

机器学习4-损失函数与梯度计算

对示例样本,分类器1与分类器2的分类谁的效果更好?如何定量衡量分类器的性能?确定一个函数来衡量即损失函数超参数是在机器学习算法运行前需要人为设定的参数,它们不能通过训练数据来学习得到,而是需要通过经验、试错或特定的调参方法来确定。超参数是在机器学习算法运行前需要人为设定的参数,它们不能通过训练数据来学习得到,而是需要通过经验、试错或特定的调参方法来确定。参数优化是机器学习的核心步骤之一,它利用损发函数的输出值作为反馈信号来调整分类器参数,以提升分类器对训练样本的预测性能。

qq_41810539的博客 1956

【机器学习】机器学习中,损失函数都有什么?请详细进行解释

损失函数是机器学习和深度学习模型训练的核心。回归任务:常用均方差损失(MSE)或平均绝对误差(MAE)。分类任务:常用交叉熵损失(Cross-Entropy Loss)或KL 散度。生成任务:常用对抗损失(Adversarial Loss)或Wasserstein 损失(Wasserstein Loss)。理解并选择合适的损失函数能够显著提高模型的训练效果和预测性能。y_in。

wq6qeg88的博客 1244
上一篇: 偷偷研究了Grok3后,优维悟了……
下一篇: 行业首次:优维EasyOps平台能力全面MCP化,打造AI时代人机协同
优维科技EasyOps
博客等级 码龄5年 1483粉丝 395原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值