Hologres高可用优化实战:功能配置项, 查询与存储优化过程实战,使用过程优化与巡检建议

Hologres揭秘:深度解析高效率分布式查询引擎 Hologres(中文名交互式分析)是阿里云自研的一站式实时数仓,这个云原生系统融合了实时服务和分析大数据的场景,全面兼容PostgreSQL协议并与大数据生态无缝打通,能用同一套数据架构同时支持实时写入实时查询以及实时离线联邦分析。它的出现简化了业务的架构,与此同时为业务提供实时决策的能力,让大数据发挥出更大的商业价值。从阿里集团诞生到云上商业化,随着业务的发展和技术的演进,Hologres也在持续不断优化核心技术竞争力,为了让大家更加了解Hologres,我们计划持续推出Hologers底层技术原理揭秘 阅读详情

0 hologres 高可用治理

在这里插入图片描述

0.1 建表优化

hologres建表的分布键设置是充分发挥Hologres性能潜力的重要手段之一,合理的分布键设置可以在如下几个方面发挥重要的作用。

  1. 提高查询性能:通过合理选择分布键,可以确保查询操作尽可能地在单一分片上执行,减少跨节点的数据传输,从而加快查询速度。
  2. 均衡数据分布:良好的分布键能够保证数据均匀分布在各个节点上,避免某些节点成为瓶颈或出现存储热点问题,确保系统整体的高效运行。
  3. 优化写入效率:当数据写入时,如果分布键选择得当,可以使数据均匀分散到不同的节点,减少单一节点的压力,提高写入效率。
  4. 支持高并发:合适的分布键有助于实现负载均衡,使得系统能够更好地支持高并发场景下的查询和写入操作。
  5. 提升资源利用率:通过优化分布键,可以更有效地利用集群中的计算和存储资源,降低总体拥有成本。

优化必备知识点:

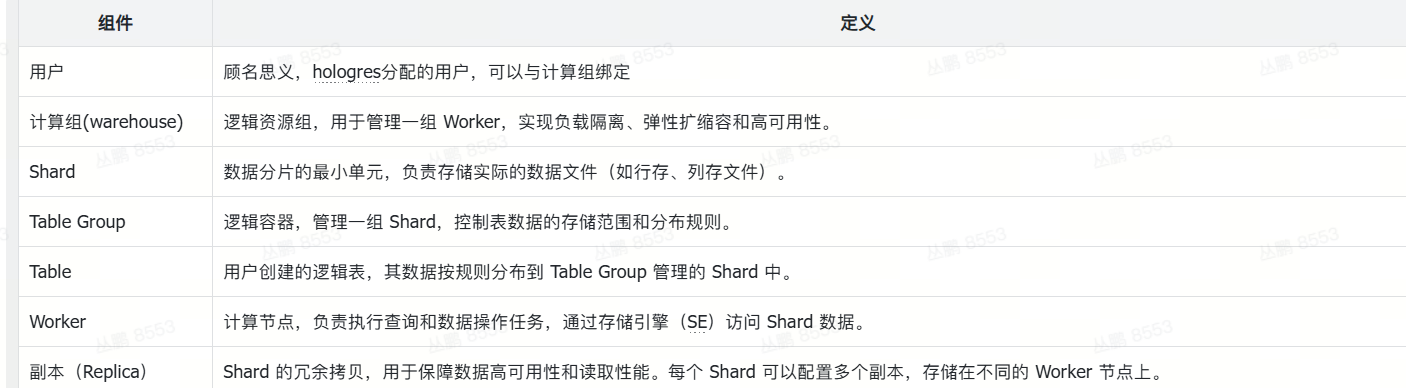
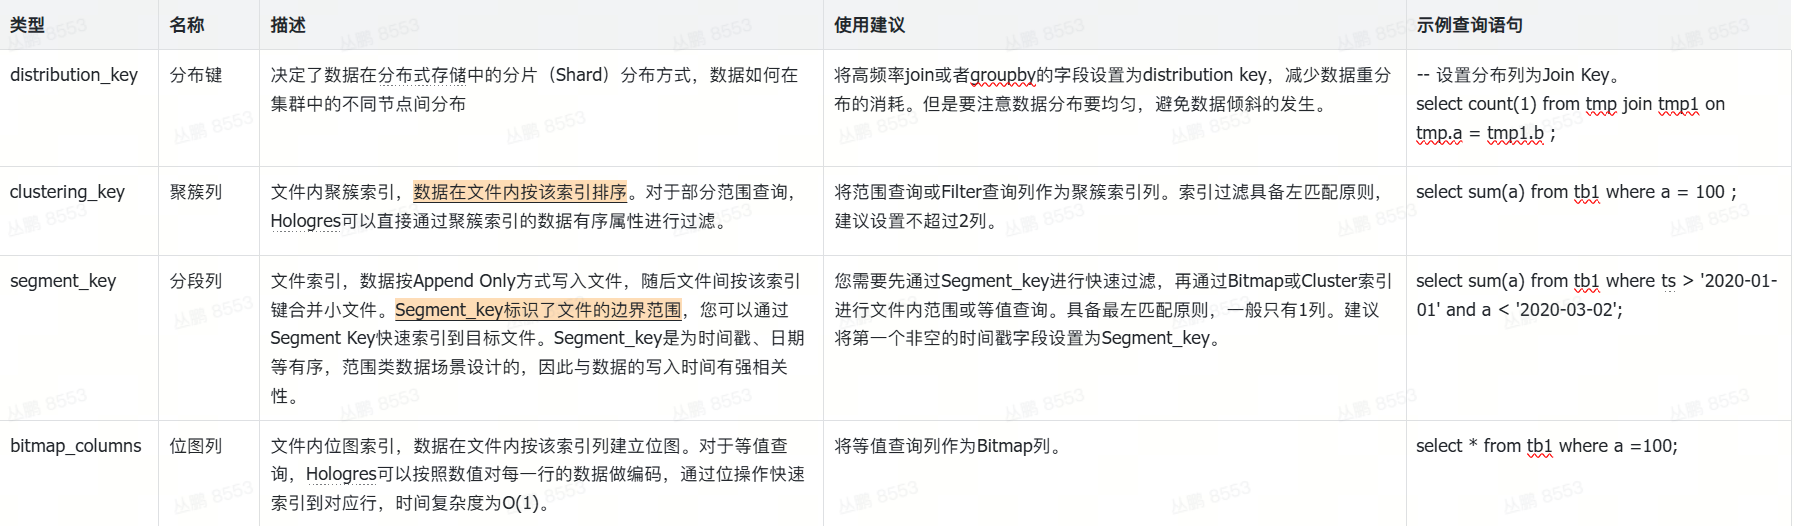
在阿里云 Hologres 中,distribution_key、clustering_key、segment_key 和 bitmap_columns 是四个关键的表结构优化参数,直接影响查询性能、存储效率和数据分布。
在这里插入图片描述

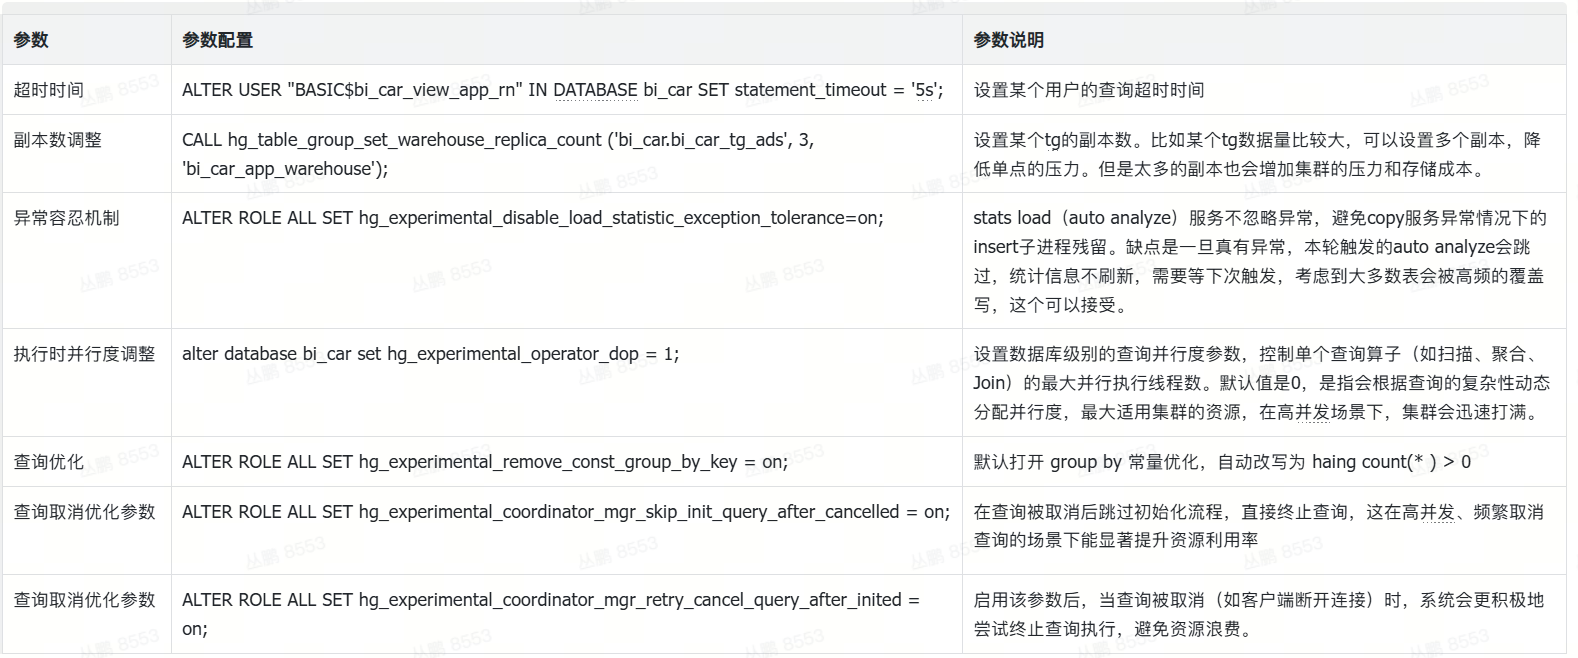
0.2 hologres配置优化

在这里插入图片描述

0.3 TG拆分

通常ads和维度表建议使用不同的TG,本质来说是将资源充分利用,不浪费资源。
不同的tg分配的shard数量不同,一般ads表使用的shard数多,dim表使用的shard数少
如果ads里表的数据量差异很大,也可以再次拆分tg来存储

0.4 shard数量和副本大小配置

  1. 理论上计算组的计算节点数要大于副本数。如某个tg的副本数是5, 相关计算组的资源至少是 5*16 = 80CU
  2. Shard 数 ≥ Worker 数的 2-3 倍
  3. shard是否倾斜,尽量避免倾斜

0.5 serverless与配置查询队列属性

  • max_concurrency:最大并发数。默认值:-1,表示没有任何并发限制,取值范围:[ -1 , 2147483647 )。
  • max_queue_size:最大排队数量,指支持的最大排队SQL数量。默认值:-1,表示队列无限大,取值范围:[ -1 , 2147483647 )。
  • queue_timeout_ms:最长排队时长(单位:ms),即在排队时长超过该值时,将自动关闭查询。默认值:-1,表示不限制排队时长,取值范围:[ -1 , 2147483647 )。
    当前每个计算组都分配有一个default queue,所以默认都是提交到default queue上。
    可以支持配置规则,通过规则将查询路由到不同的query queue上。
    当前支持的条件属性:
  • user_name
  • command_tag
  • db_name
  • engine_type
  • digest 针对BI场景,可能合适的使用场景
  • storage_mode。
  1. serverless或者query queue都是独立一块资源出来单独使用。区别是serverless不受实例影响,query queue受实例影响。
  2. 适合的场景是个别极大查询无法优化,极耗资源。这类可以使用serverless或者query queue来查询。
  3. 不太适合于容灾资源,主要是因为serverless为每个查询分配了固定的cu,不支持高并发的场景

0.6 服务端查询治理

服务端和数仓的数据架构是整体服务高可用至关重要的一环。需要考虑如下几个点的平衡。

  • 展示数据时效性:缓存机制
  • DB压力:是否是所有的查询都要下发到DB,比如有限个数据的分组和整体数据是下发2个查询,还是1个查询,服务端计算汇总。
  • 服务端运维便捷性:是否是所有的逻辑都在服务端进行计算转化,服务端过渡设计,也会导致后期维护困难
  • 可扩展性:一个数据表尽量配置一个mapper的方法或者一个北斗模型,通过服务端参数动态传入进行可扩展性延伸
  1. 设置合理的缓存机制
  2. BI级缓存,针对时效性不高的数据楼层设置更久的缓存过期时间
  3. SQL级缓存,根据不同的入参设置1min缓存过期时间,整体缓存命中率日常在40%-50%之间
  4. 减少数据库查询次数
  5. 优化服务端代码,合并查询请求,把部分数据处理逻辑放到服务端,减少数据库查询请求
  6. 优化BI层dubbo接口重试配置,减少无效的数据查询
  7. 页面楼层延迟加载
  8. 前端最早是一次性将工作台首页的接口一次性请求,优化方式是对首页接口进行分组,分批次请求。由并行请求优化为【串行+并行】。减轻服务端和DB的压力。
  9. 前端选择需要的指标请求服务端,按需请求DB
  10. 服务端按需路由请求
  11. 根据业务需求,选择需要的指标,动态生成查询SQL。

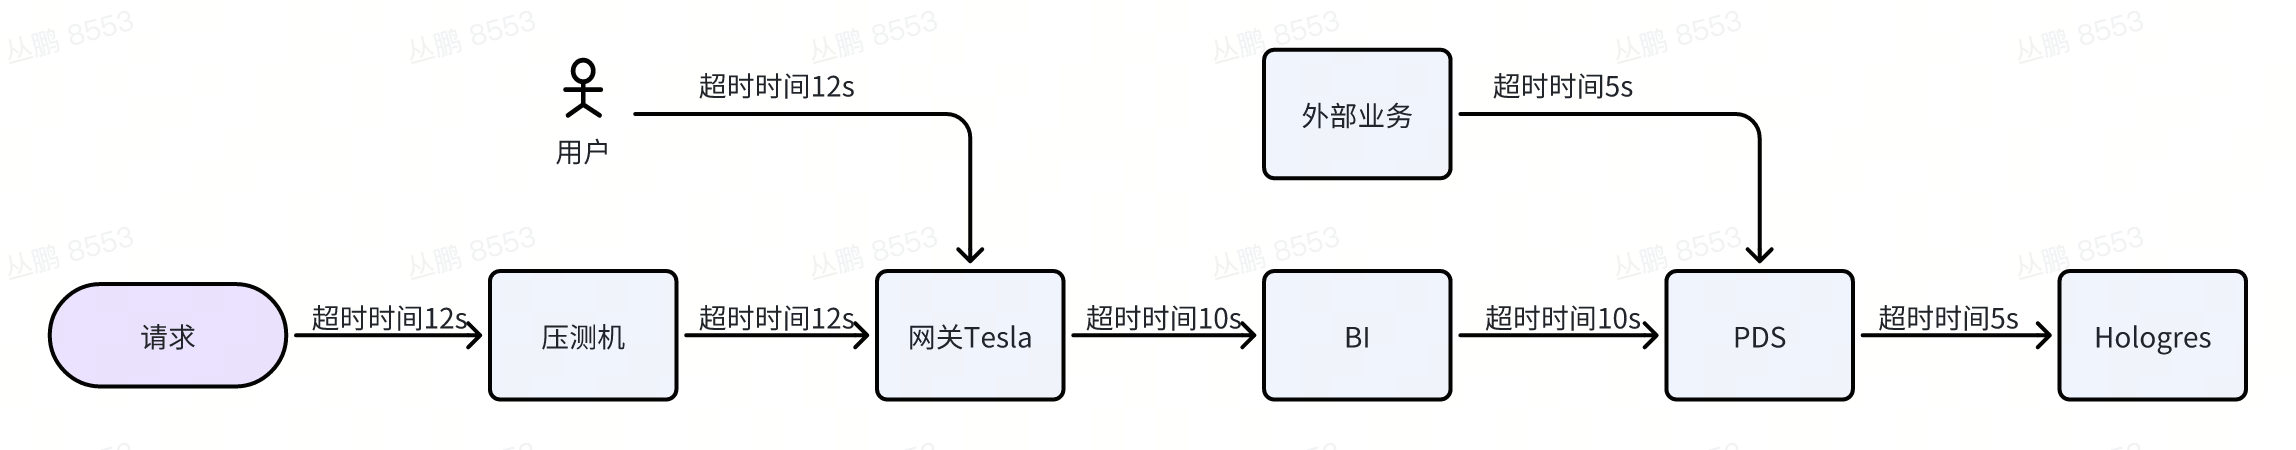
0.6.2 设置合理的超时时间
在这里插入图片描述

1 分析查询过程

这里涉及到两部分东西 ,一个是表的存储 也就是建表时侯的各种参数,另一个是表的查询,我们分开讨论,分开分析。

这种东西如果不知道从哪里入手,那么从使用往回推是肯定没问题的,我们默认啊的字段是按照三范式来做的,也就是说 不考虑字段的冗余存储,这总情况下直接先从使用处 往回倒推肯定没毛病好吧。

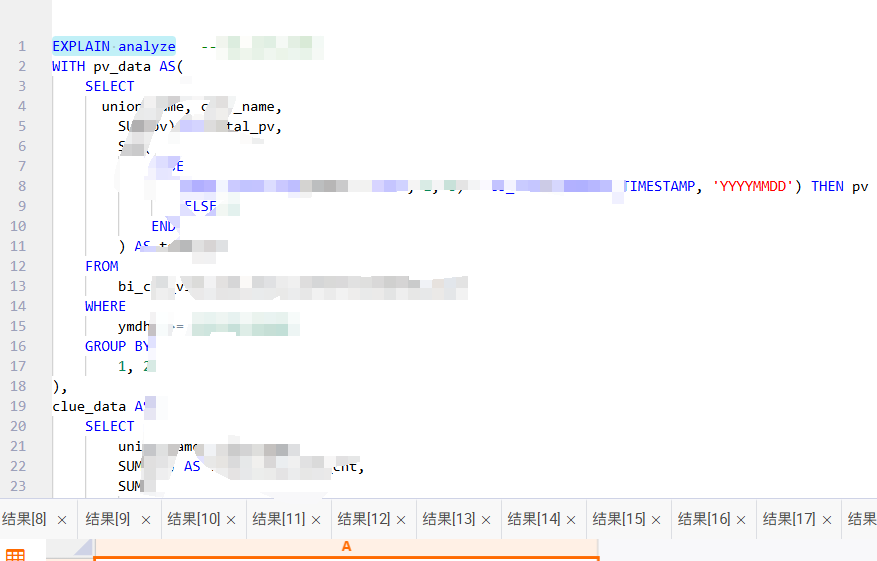
1 使用分析命令 分析查询sql

说的简单点 分析执行命令 使用 EXPLAIN analyze 分析查询语句,我们可以看到每个语句分别在做什么,分别触发了什么索引。

索引这个东西,在不关注的时候没甚么用,单节点部署的hologres也没甚么用,但是在shard数,数据量,表的维度 ,等等某些东西多的时候,他的作用就会不知不觉的显现出来,例如 十几万的查询,如果索引设置的不合理,可能需要查询 1000多ms,如果合理的话 可能100ms就足够了,这是1000%的查询性能提升啊,如果一个app的页面又50个接口,每个接口查5个表,这个提升可就大了,所以索引如何设置 ,每种索引有什么作用 可以参考我的 另一篇帖子 。:hologres 建表/索引/查询优化,或者背诵下图:
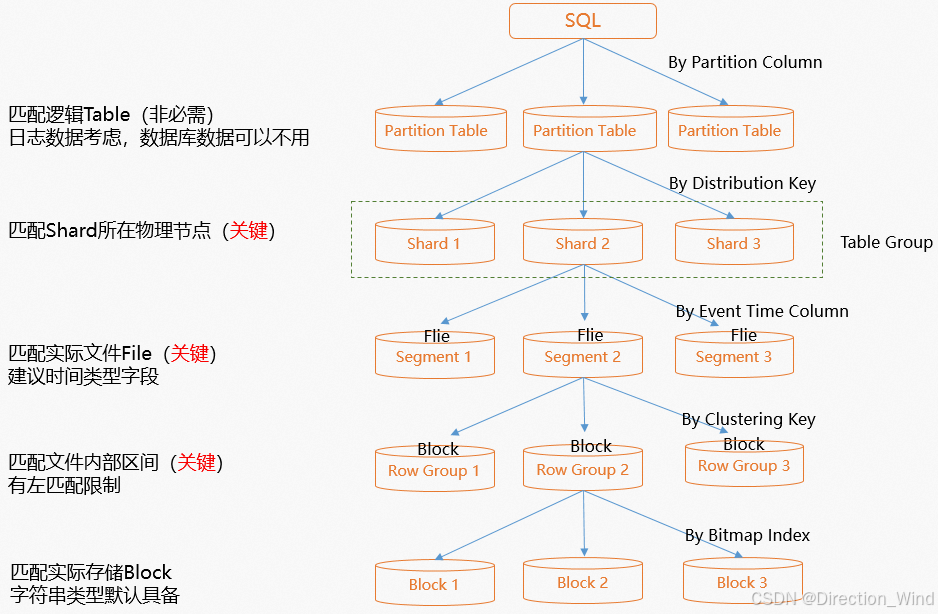
在这里插入图片描述
那么好 我们实战来看一下

在这里插入图片描述
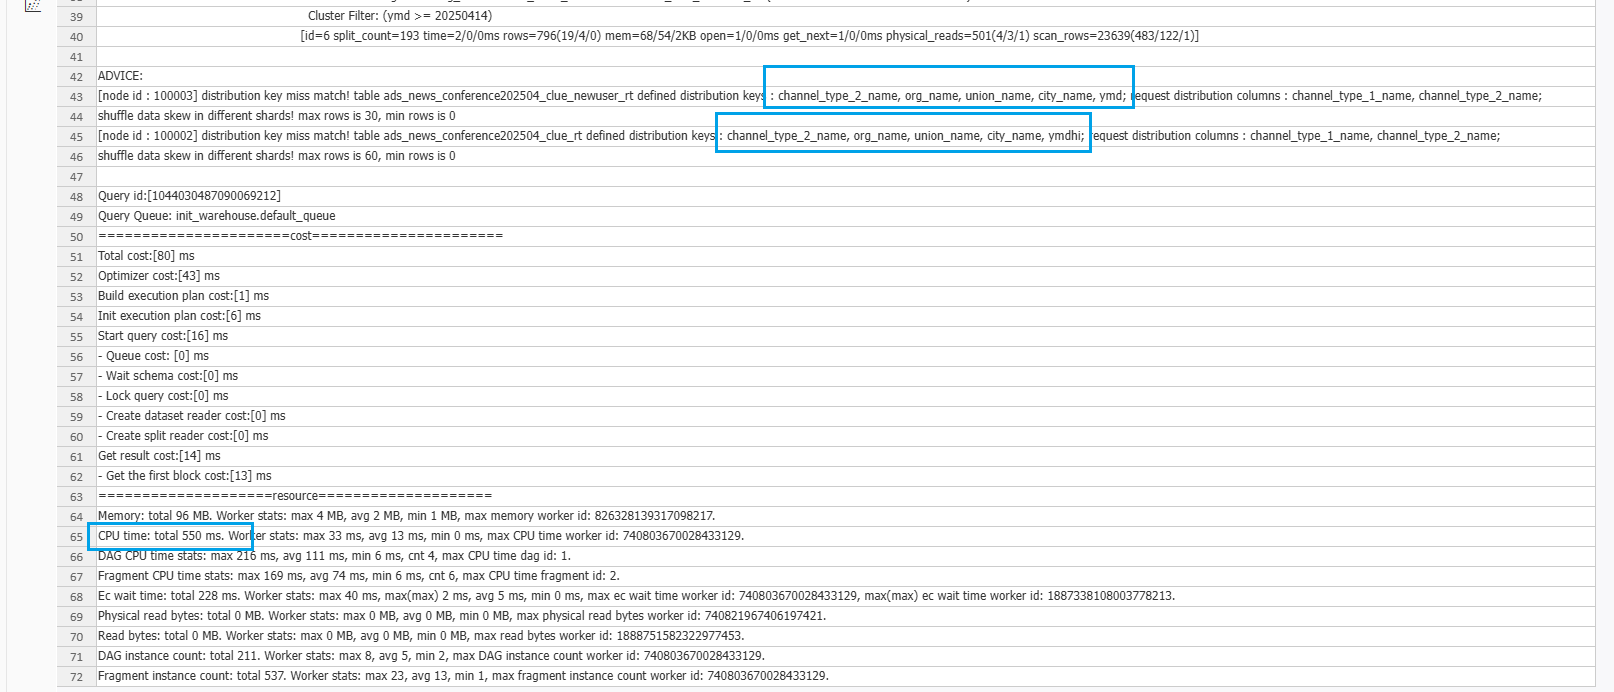
根据分析结果 我们看下
在这里插入图片描述
说了什么呢,说我们的 distribution_key ,没有被命中,这个索引的设置记住几个词,尽量分散,尽量全部命中,尽量别超过2个,一定是主键的子集。所以我们按照他的优化结果来
把distribution_key 也就是 存储的分布键,设置为他说的两个字段,之后再分析
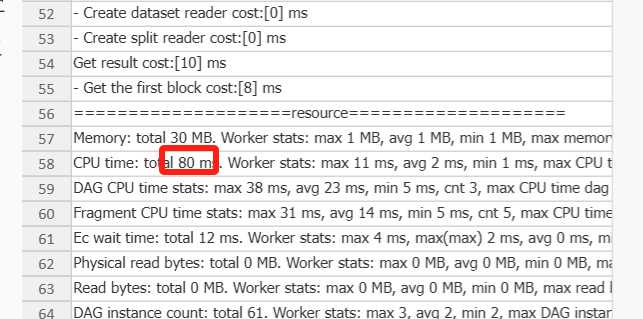
在这里插入图片描述
足够明显吧
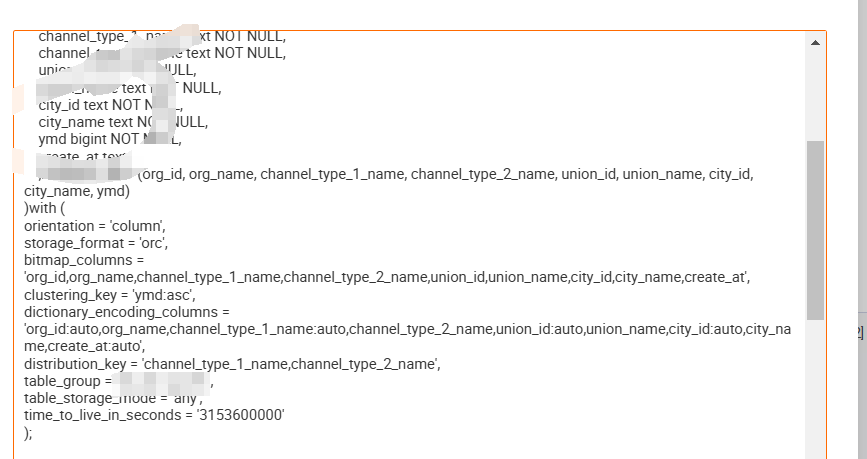
这里附上表的索引设置
在这里插入图片描述

2 查询优化命令

这里是说 hologres 在不停更新,他每个版本都有一些新的能力,如果升到3.1,会有一些能力。
例如 我们可以配置以下参数,来减少查询时候的 数据shuffle。

常用的SQL性能优化参数:
–关闭数据重分布
– set optimizer_enable_motion_redistribute = true;
–关闭cache
set hg_experimental_enable_result_cache = off;
set hg_experimental_enable_query_use_block_cache = off;
–开启hint语法支持
SET pg_hint_plan_enable_hint=on;
–打开详细执行计划
– set hg_experimental_show_execution_statistics_in_explain = on;
–常规执行计划
Explain Analyze
–巨详细执行计划(JSON)
– explain (format pb)

指定query关闭数据重分布,降低shuffle消耗方法:
SET pg_hint_plan_enable_hint=on;
WITH dim_sale_org AS (
SELECT/*+HINT set(optimizer_enable_motion_redistribute off) */

3 数据计算组

这里是什么意思呢,数据表在存储的时候是要设置数据计算组的,hologres 1个workder,16个cu,1个workder最少1个shard(数据分片数)如果没有shard,那这个workder就无法被配工作。
但是如果你的表数据量很小,shard还比较多的话,他就会被分散到很多的shard中,反而降低了效率,所以可以设计几个数据计算组,分别有不同的shard数,小表设置的计算组shard数量少,大表设置的计算组的shard数量多。一方面可以做资源隔离,另一方面提高计算效率

4 hologres 大量点查 也就是 flink lookup join holo表

hologres 一般都是与flink一起使用,所以hologres表做 flink的 lookup join 维表也是常见场景,有人应该发现了,如果用hologres维表 ,有时候任务会阻塞死,这种情况是因为维表 join的键不是表的主键,这种情况会发生阻塞,实际上还是大量点查导致的。

5 定期巡检分布键

1、查hologres.hg_table_info 这张表,抠出来里面的distribution_key,然后常见字段匹配(ymd等等)+人工确认结合
2、计算组10里面加新的巡检任务,去统计每张表的数据分布是否存在数据倾斜,select hg_shard_id, count(1) from bi_car.ads_wide_ord_pipeline_ssu_price_rt_yu7sale group by hg_shard_id; 然后比一下偏差情况
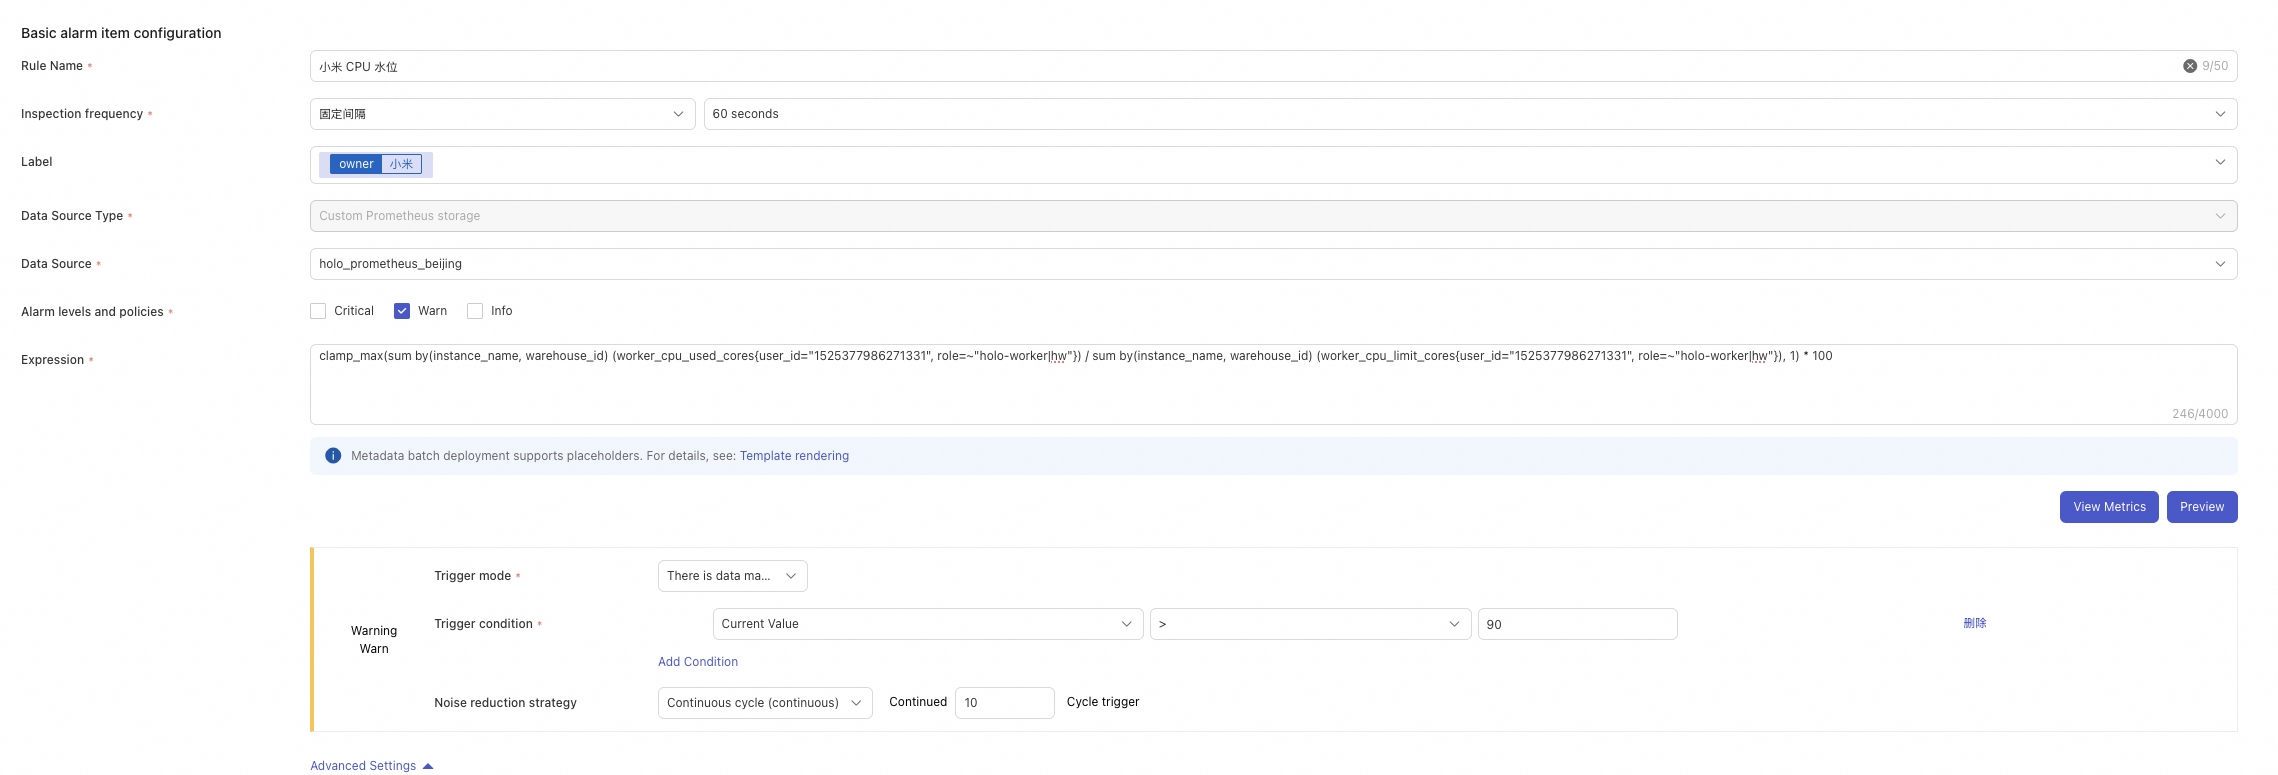
可以配置单worker cpu打满告警和倾斜告警
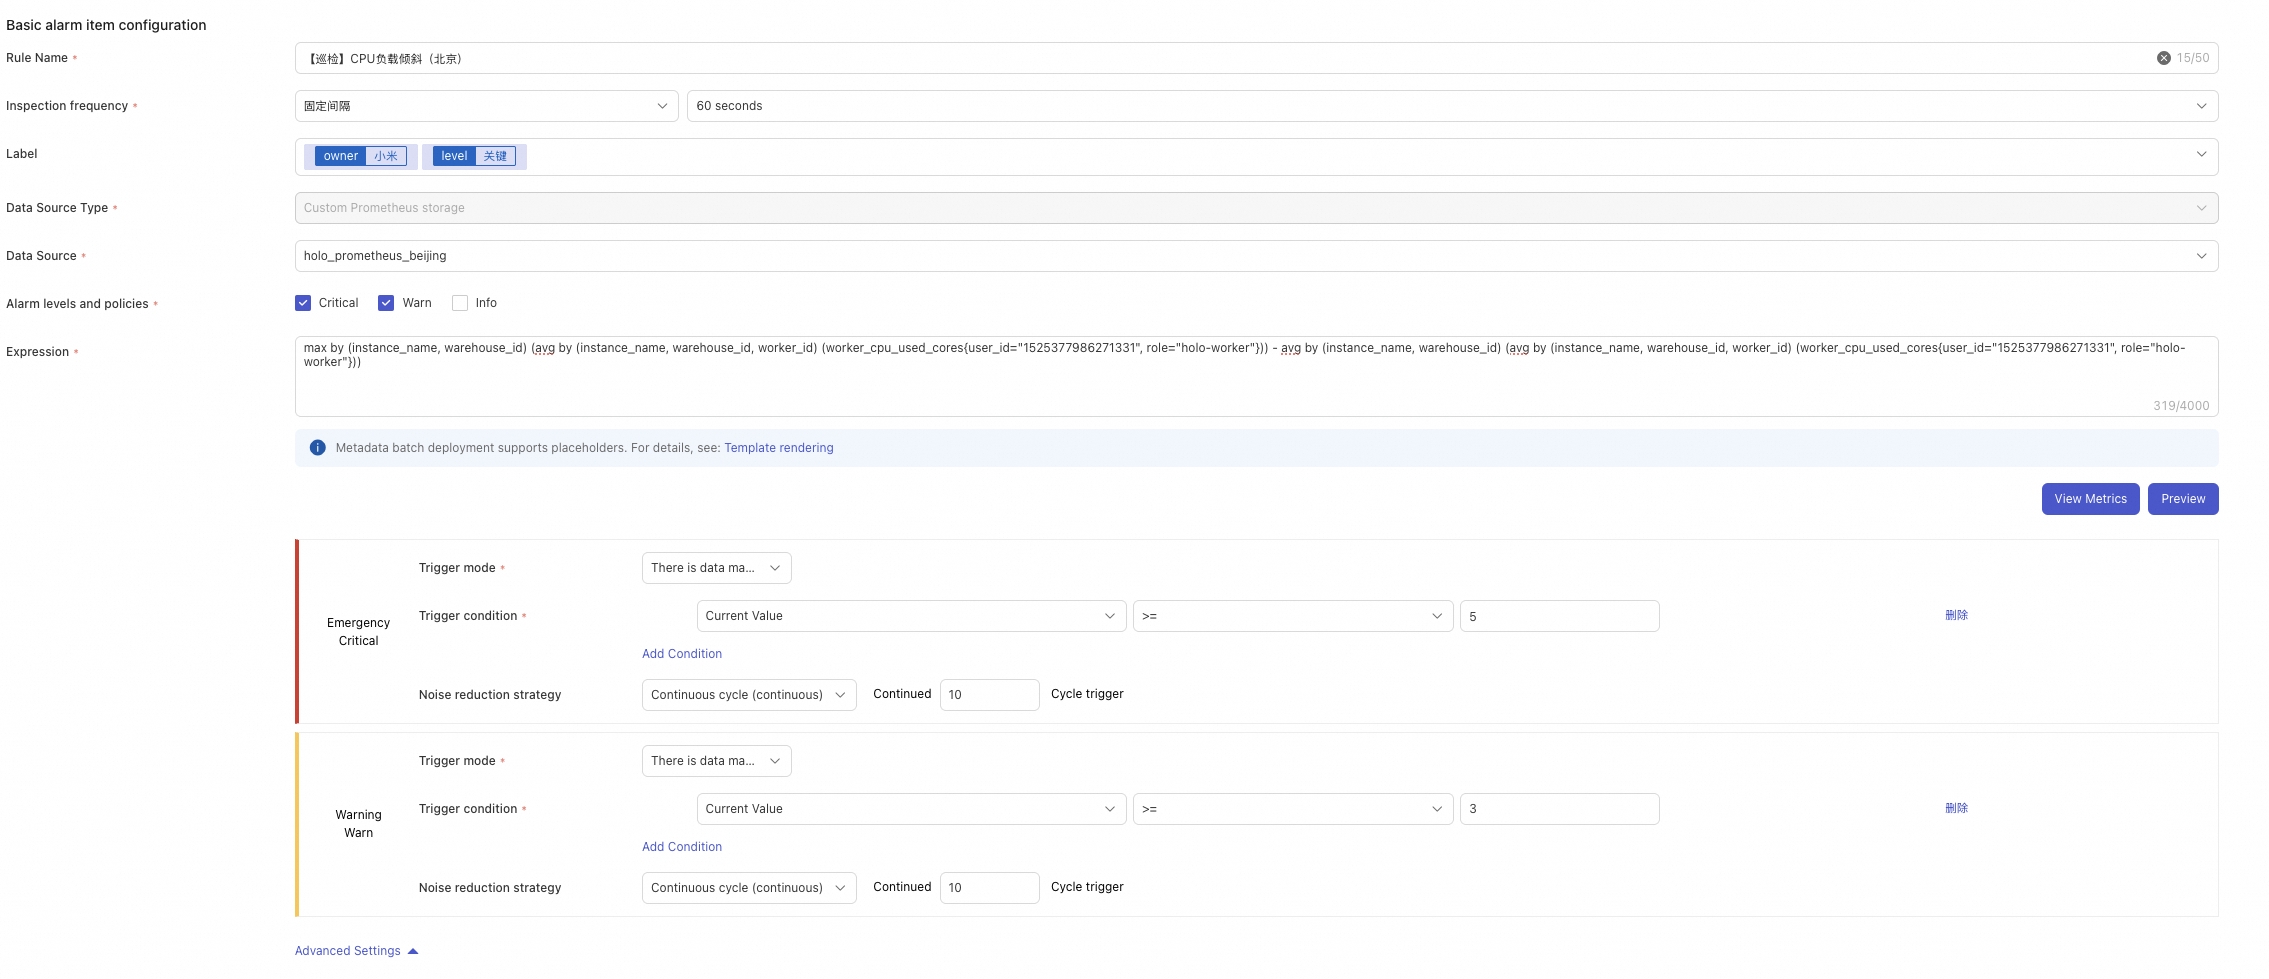
在这里插入图片描述
在这里插入图片描述

6 查看holo实时写入情况

select
query,
command_tag, count(1), avg(cpu_time_ms)::bigint, sum(cpu_time_ms)::bigint
from hologres.hg_query_log
where 1 = 1
and query_start >= ‘2025-05-21 13:20:00+08’
and query_start <= ‘2025-05-25 02:42:00+08’
group by 1,2
order by 2 desc
limit 100;

Hologres实战_基本原理 首先,要有一套非常强大的存储,能够把实时的数据和离线的数据存储进来,实现数据的通存,同时还要有一种高效的查询服务,能够支持高 QPS 的查询,支持复杂的分析以及联邦查询和分析,这样的话就可以把离线数据和实时数据都导入到系统里去,然后将前端的数据应用,比如 BI 报表和一些在线服务,对接到系统中去。对于典型的 Lambda 架构,是 将实时数据通过实时数据的链路写入到实时数据存储中,离线数据通过离线数据的链路写入 到离线存储中,然后将不同的 Query 放到不同的存储中,再做一个 Merge。 阅读详情

相关推荐

Hologres分布键(Distribution Key)

功能分布键(Distribution Key)定义作用决定数据在 shard 间的分布策略,使用哈希映射定位核心优势并行计算、Shard 剪枝、本地 Join 提速合理选择原则均匀字段、常用于 Group By / Join、最好为主键字段使用建议避免多个字段、数据倾斜、类型限制、需重建表更改键。

qq_41081716的博客 1175

hologres 建表/索引/查询优化

Bitmap不同于Distribution Key和Clustering Key,Bitmap是数据存储之外的独立索引,设置了Bitmap索引之后,系统会将列对应的数值生成一个二进制字符串,用于表示取值所在位置的Bitmap,当查询命中Bitmap时,会快速定位到数据所在的行号(Row Number),从而快速过滤出数据。大宽表的每一列都设置为Bitmap场景:如果为大宽表的每一列都设置为Bitmap,那么在写入时每个值都需要构建成Bitmap,会有一定的系统开销,从而影响写入性能。

Direction_Wind的博客 4321

新东方基于Hologres实时离线一体化数仓建设实践

业务介绍 新东方教育科技集团定位于以学生全面成长为核心,以科技为驱动力的综合性教育集团。集团由1993年成立的北京新东方学校发展壮大而来,拥有短期培训系统、基础教育系统、文化传播系统等业务。 ​ 在互联网大潮中,新东方在IT技术上也不断重构,持续投入大数据建设,研发大数据的相关技术和应用,从而快速而精准地响应业务需求,并用数据为集团各级领导提供决策依据。新东方的大数据应用主要包括两部分: 企业应用端的业务场景(B端):包括交易,教学,人员等数据,数据规模为TB级。数据会被按照不同的条件和学校层级等,形成营

aliyunhologres的博客 4718

一站式实时数仓Hologres整体能力介绍

讲师:阿里云Hologres PD丁烨。

科技很有意思 2247

大数据(9h)FlinkSQL之Lookup Join

ttl FOR SYSTEM_TIME AS OF Processing Time Temporal Join lookup join lookup cache Flink查询缓存 lookup.cache.max-rows lookup.cache.ttl

ArYe 9037

从Flink LookupJoin 入门 Flink Rule

网上有一系列关于 Flink SQL、Calcite 的高大上的文章,看完却无法上手开发。 本文主要从 Flink 的 JOIN 基础开始,带新手走通 LookupJoin 的流程,教你自行 Debug,通过熟悉中间的 Rule 后,读者可以上手做一些自定义的修改或开发自己的 Rule。

zstraw的博客 7277

Hologres慢Query日志查看与分析

Hologres慢Query日志查看与分析。

胜利的曙光的博客 1678

揭秘Synopsys EDA中的AI黑科技:DSO.ai如何改变传统芯片设计流程

本文深入探讨了Synopsys EDA中的AI黑科技DSO.ai如何革新传统芯片设计流程。通过数据驱动的方法论、功耗优化革命和时序收敛智能加速,DSO.ai显著提升了设计效率和质量,实现了从经验驱动到AI驱动的范式转变。文章还提供了实战指南,帮助团队跨越AI EDA的实施鸿沟。

weixin_29296241的博客 527

如何优化数据库查询性能?请列举一些常见的优化方法。

数据库查询性能优化是一个综合性的过程,需要根据具体需求和场景进行调整。常见的优化方法包括合理使用索引、优化查询语句、调整数据库设计、利用缓存机制以及硬件和配置优化等。这些措施不仅可以提升查询速度,还能降低资源消耗和系统压力,从而实现更高效的数据库管理。选择高频查询的字段高频查询的字段是建立索引的最佳选择,因为这些字段在查询中经常被使用,建立索引可以显著提高查询性能。通常情况下,经常用于查询、连接、筛选和排序的字段会是很好的索引字段选择。考虑数据分布情况数据分布情况会影响索引的选择和效果。

破损的天堂鸟博客 3054

Foxglove 介绍以及入门使用教程

Foxglove 是由Foxglove 工作室开发的一套工具集,包括和等组件。跨平台支持:可以在 Windows、macOS 和 Linux 上运行。多协议兼容:支持 ROS、ROS 2、CAN 数据以及其他自定义协议。丰富的可视化功能:可以绘制点云、轨迹、激光雷达数据、IMU 数据等。实时与离线模式:既可以实时监控机器人状态,也可以加载和回放记录的数据文件。Foxglove 的 3D 视图允许你以三维方式查看机器人的运动轨迹、传感器数据和其他几何信息。你可以旋转、缩放和平移视图以获得更好的观察角度。

zolty 1万+

获取本机正版windows10激活密钥,以及正版office

本方法面向的是以前买过笔记本电脑给你预装了正版系统,激活了正版office(一般是家庭版)的情况,其他情况请自行尝试。

qq_45774917的博客 2万+

Hologres+Flink流批一体实时营销决策系统实战

流批一体是现代实时数仓的核心范式,指同一套计算逻辑在流式与批式执行模式下输出完全一致的结果,其本质在于消除语义二义性与口径漂移。依托Flink的统一SQL引擎与Hologres的实时更新+列存+向量检索多模引擎,可实现毫秒级延迟、千亿级规模下的即席分析与决策闭环。该技术组合显著提升营销场景中用户行为归因、跨渠道ROI计算、优惠券核销路径追踪等关键指标的准确性与时效性,广泛应用于大促实时中枢、个性化推荐、智能运营等高价值业务。本文深入解析其在4982亿级事件洪峰下的架构设计、性能调优与稳定性保障实践。

weixin_29051193的博客 252

谷粒商城 - 个人笔记(集群部署篇一)

电商后台管理系统+电商系统,掌握微服务的全套方案。该系统有商品服务、仓储服务、订单服务、购物车服务、检索服务、认证中心服务、网关服务、用户服务、秒杀服务、第三方服务。使用SpringBoot+SpringCloud并配套SpringCloud Alibaba系列,引入全套微服务治理方案:Nacos注册中心/配置中心、Feign远程调用、Gateway网关、Redisson缓存、基于ElasticSearch7全文检索、异步编排与线程池、RabbitMQ柔性事务方案、Redisson分布式锁、分布式信号量等。

知行 4011

Hologres动态表落地电商价格力场景的实战解析

实时数仓是当前大数据分析领域的热门方向,其核心挑战在于如何以较低成本实现秒级数据可见性。物化视图作为一种预计算技术,通过提前存储计算结果来加速查询,但传统方案往往受限于手动刷新和全量计算。Hologres Dynamic Table将物化视图与增量刷新机制结合,能够自动感知源表变化并只处理新增数据,从而在保证查询性能的同时实现近实时更新。在电商价格力业务中,动态表可以高效支撑商品比价、活动价监控、价格异常巡检等场景,替代部分Flink SQL实时ETL链路,显著降低维护成本。本文从动态表的核心原理出发,结合

weixin_42514750的博客 118

告别“静态组件”:Adobe XD的堆栈+状态,打造“活”的响应式UI

今天,我想分享一套能彻底告别这种“笨方法”的、Adobe XD中的进阶技巧,通过组合使用“堆栈”、“内边距”和“组件状态”,去构建一个能自动适应内容、真正“活”起来的智能响应式组件。

Kingsdesigner的博客 764

JESD204B系统设计实战:如何用SYSREF信号搞定多设备时钟同步(附时序图详解)

本文深入探讨了JESD204B系统中SYSREF信号在多设备时钟同步中的关键作用与实现技巧。通过详细分析SYSREF信号的生成、PCB布局和时序调整,提供了一套完整的解决方案,帮助工程师解决高速数据转换器与FPGA协同工作中的时钟同步问题。文章还包含时序图详解和实测调试技巧,助力提升系统性能。

weixin_29313239的博客 457

AI 时代,零售商超如何用多模态数据“看见“每一排货架?

这篇文章,我们来聊聊零售商超企业如何借助 AI 和多模态数据技术,让货架"会说话"、让商品"有标签"、让顾客行为"可量化",从而支撑更精细化的运营决策。

科技很有意思 358

如何使用freesurfer对T1w结构像进行分区指标的提取?——皮层面积,灰质体积,平均厚度,厚度标准差,平均曲率、高斯曲率、曲率指数、折叠指数

如何使用freesurfer对T1w结构像进行分区指标的提取?——皮层面积,灰质体积,平均厚度,厚度标准差,平均曲率、高斯曲率、曲率指数、折叠指数

从事脑科学核磁共振方法学研究,在Nature communications等权威期刊发表研究论文,熟练掌握磁共振处理方法和统计学方法,欢迎大家和我交流。 3788

天猫国际通过Hologres进行排行榜的实时交互式分析

简介:本文将会为您分享天猫国际如何通过Hologres实现计算、存储、服务统一的实时交互式分析。 作者:景闻 阿里巴巴数据技术及产品部数据技术专家 一.业务背景 天猫国际营销活动分析实时排行榜是在大促中帮助业务快速的分析商家或者品牌的交易和流量的数据情况,给下一步大促的销售目标,流量蓄水等等做出运营决策;尤其是在活动当天当发现行业的问题之后,仅仅靠子行业的拆分不足以确定具体的问题,也不一定有具体的业务抓手,所以需要有到商家、品牌和商品粒度的数据来快速定位问题。 二.原技术方案 原始技术方案的.

阿里云云栖号 1922

YooAsset 学习

YooAssets使用教程

weixin_44884538的博客 1659

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

177.Agent-LangGraph-MCP的构成说明

MCP架构通过MCP主机、客户端与服务器的协同,实现工具、资源与提示词的统一管理。MCP服务器提供Tools、Resources、Prompts能力,MCP客户端则负责发现、调用与读取,使Agent可按需获取上下文。其核心在于将工具从Agent中抽离,封装为可复用的服务,提升灵活性与可维护性,推动AI应用高效协作。

计算机王的博客 315

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

Docker Compose:搭建本地多服务开发环境

从一个 Java API、PostgreSQL 和 Redis 开始,配置服务名、端口、环境变量、健康检查、数据卷和依赖关系。理解 Compose 文件如何被解析、项目如何隔离,以及哪些数据不能依赖“重建容器”保留,能够把个人开发环境整理成团队可复用的启动入口。

m0_62221377的博客 478

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

AI全栈实战 | 3.9-01 爬虫入门:requests 加 BeautifulSoup 三分钟跑通,但 90% 的人栽在这 4 个“礼貌“问题上

⚠️:本文内容仅用于。请遵守目标站点的服务条款与相关法律法规,不得对目标服务造成负担,不得采集、传播个人隐私数据。技术是中性的,边界在你手里。爬虫的入门技术(requests 发请求 + BeautifulSoup 解析)三分钟就能学会。真正区分"会用爬虫"和"会做爬虫的人"的,是这篇我们跑通"请求→解析→存储"的最小闭环,然后重点把"合规与礼貌"这根弦给你绷上。

源码获取 | 运行部署 | 定制二开修改,如果回复不及时请耐心等待,请见谅。 442

spring boot 4集成SQLLite,及其SQLLite的建库

spring boot 4集成SQLLite,及其SQLLite的建库

weixin_41463944的博客 231

【基于 WebSocket 的多用户网页五子棋】—— 数据管理模块

但行好事,莫问前程

qq_42996461的博客 260

OpenClaw 深度调查:把 AI 助手做成你自己的控制平面

对 openclaw/openclaw 的完整技术尽调:Gateway 架构、Agent 运行时、工具与沙箱、30 个消息通道、181 个插件、安全信任边界、工程代价与采用建议。17 章 / 10 张图,全部数字标注口径,数据截至 2026-10-31。

厚积薄发 349
上一篇: Flink 常见问题汇总:反压积压,checkpoint报错,窗口计算,作业报错,无产出,流批不一致,调优等。
下一篇: git常用命令
Direction_Wind
博客等级 码龄8年 6438粉丝 102原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

Direction_Wind

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值