




hologres 优化部分
1 hologres 建表优化
参考使用
htt阿里ps://help.aliy阿里un.com/zh/hologres/developer-reference/s阿里ystem-tables
    ,PRIMARY KEY (uk, ymd, ymdhi, org_id, staff_id, level, channel_lv1_id, channel_lv2_id, channel_lv3_id, distribute_mode)
)with (
orientation = 'column',  -- 行存列存  这个是列村
storage_format = 'orc', -- 列存默认就是orc
bitmap_columns = 'ymd,distribute_mode', -- 所有text都默认设置,等值查询字段设置这个
clustering_key = 'ymd:asc,ymdhi:asc', -- 排序建 点查 范围查 用这个
dictionary_encoding_columns = 'uk:auto,primary_org_type:auto,org_id:auto',  --加速 group by 建议将有字符串比较的列设置为字典编码列(dictionary_encoding_columns)
distribution_key = 'org_id,staff_id',  -- 这个要设置为 pk的子集   设置的分布列信息 按照哪个数据分布,
segment_key = 'create_tm', -- 适用于数据为单调递增或单调递减的有序字段   这个字段也叫 event time column file
table_group = 'bi_car_tg_new',
table_storage_mode = 'any',
time_to_live_in_seconds = '3153600000'
);
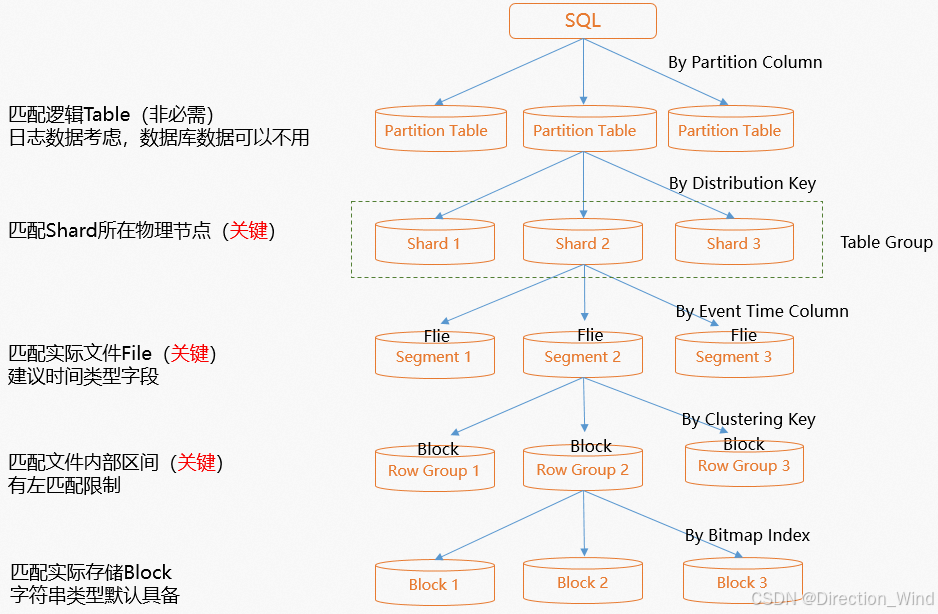
1.1 建表中的配置优化
根据 holo的 存储引擎部分的知识可以得知,holo在建表的时候设置合适的索引和排序规则十分重要。
Hologres存储引擎的基本抽象是分布式的表,为了让系统可扩展,我们需要把表切分为分片(Shard)。 为了更高效地支持JOIN以及多表更新等场景,用户可能需要把几个相关的表存放在一起,为此Hologres引入了表组(Table Group)的概念。分片策略完全一样的一组表就构成了一个表组,同一个表组的所有表有同样数量的分片。用户可以通过“shard_count"来指定表的分片数,通过“distribution_key"来指定分片列。目前我们只支持Hash的分片方式。
表的数据存储格式分为两类,一类是行存表,一类是列存表,格式可以通过“orientation"来指定。
每张表里的记录都有一定的存储顺序,用户可以通过“clustering_key"来指定。如果没有指定排序列,存储引擎会按照插入的顺序自动排序。选择合适的排序列能够大大优化一些查询的性能。
表还可以支持多种索引,目前我们支持了字典索引和位图索引。用户可以通过“dictionary_encoding_columns"和“bitmap_columns"来指定需要索引的列。
下面是一个示例:

这个例子建了LINEITEM 和 ORDERS两个表,由于LINEITEM表还指定了主键(PRIMARY KEY),存储引擎会自动建立索引来保证主键的唯一。用户通过指定“colocate_with“把这两个表放到了同一个表组。这个表组被分成24个分片(由shard_count指定)。 LINEITEM将根据L_ORDERKEY的数据值来分片,而ORDERS将根据O_ORDERKEY的数据值来分片。LINEITEM的L_SHIPINSTRUCT以及ORDERS的O_ORDERSTATUS字段将会创建字典。LINEITEM的L_ORDERKEY, L_LINENUMBER, L_SHIPINSTRUCT字段以及ORDERS的O_ORDERKEY,O_CUSTKEY,O_ORDERSTATUS字段将会建立位图索引。
这里额外介绍一下 字典索引 dictionary_encoding_columns 和 位图索引 bitmap_columns。
1.1 字典索引 dictionary_encoding_columns
字典编码可以将字符串的比较转成数字的比较,加速Group By、Filter等查询。在Hologres中可以对指定字段进行字典编码,即为指定字段的值构建字典映射,设置Dictionary Encoding的命令语法如下。
-- Hologres V2.1版本起支持的语法
CREATE TABLE <table_name> (...) WITH (dictionary_encoding_columns = '[<columnName>{:[on|off|auto]}[,...]]');

-- 所有版本支持的语法
CREATE TABLE <table_name> (...);
CALL set_table_property('table_name', 'dictionary_encoding_columns', '[<columnName>{:[on|off|auto]}[,...]]');

使用建议
建议将有字符串比较的列设置为字典编码列(dictionary_encoding_columns),并且列的基数较小,即数据重复度较高。
不建议将所有的列都设置为字典编码列,因为这样做会带来额外的编码、解码开销。
不建议为实际内容为JSON,但保存为text类型的列设置字典编码。
可以在建表之后单独使用设置字典编码。表示修改字典编码列,修改之后非立即生效,字典编码构建和删除在后台异步执行,详情请参见ALTER TABLE。
使用说明
Dictionary Encoding只能用于列存表或者行列共存表。
Dictionary Encoding指定的列可以为空。
取值较少的列适合设置字典编码,可以压缩存储。
Hologres V0.8及更早版本中默认所有TEXT类型字段都会被隐式地设置为Dictionary Encoding。Hologres V0.9及之后版本中,所有TEXT数据类型字段的dictionary_encoding_columns属性默认取值auto。即当表有数据写入时,如果字段里数值的重复度大于等于90%,那么系统就会对该字段开启字典编码。
技术原理
Dictionary Encoding是一种压缩存储的技术,系统会将原始数据编码为数值类型存储,同时也会维护对应的编码表结构,在数据读取时,会根据编码表进行数据解码操作,因此在字符串比较的场景中,尤其是对基数小的列,有加速作用,常用于Group By、Filter等过滤查询场景中。系统会默认将TEXT数据类型的字段设置Dictionary Encoding。但是解码会带来额外的计算开销,尤其是基数大的列(数据的重复度较低,比如一列里一半值都不相同)和用于Join的字段,字典编码会带来更多额外的编码、解码开销,因此不建议所有的列都设置为Dictionary Encoding。字典编码示意图如下所示。

使用示例
- V2.1版本起支持的语法:
CREATE TABLE tbl (
   a int NOT NULL,
   b text NOT NULL,
   c text NOT NULL
)
WITH (
   dictionary_encoding_columns = 'a:on,b:off,c:auto'
);

-- 修改dictionary_encoding_columns
ALTER TABLE tbl SET (dictionary_encoding_columns = 'a:off');--ALTER TABLE语法仅支持全量修改
- 所有版本支持的语法:
--创建表tbl并设置dictionary_encoding_columns索引
begin;
create table tbl (
 a int not null,
 b text not null,
 c text not null
);
call set_table_property('tbl', 'dictionary_encoding_columns', 'a:on,b:off,c:auto');
commit;

--修改dictionary_encoding_columns索引
call set_table_property('tbl', 'dictionary_encoding_columns', 'a:off');--全量修改,b和c因为是text列,会被默认设置为dictionary_encoding_columns

call update_table_property('tbl', 'dictionary_encoding_columns', 'c:off');--增量修改,仅将c关闭dictionary_encoding_columns
1.2 位图索引 bitmap_columns
- 用途:
1. 额外维护value到 row id列表的映射,能够快速定位到符合条件的数据所在的行号 - 适用场景:
1. 2 - 配置建议:
1. 可以配置任意多个,每个字段都独立互不影响
2. 等值查询的列
3. 基数太低的列(取值范围太少,如性别、车型)不适合建立位图索引
在Hologres中,bitmap_columns属性指定位图索引,是数据存储之外的独立索引结构,以位图向量结构加速等值比较场景,能够对文件块内的数据进行快速的等值过滤,适用于等值过滤查询的场景。使用语法如下。
-- Hologres V2.1版本起支持的语法
CREATE TABLE <table_name> (...) WITH (bitmap_columns = '[<columnName>{:[on|off]}[,...]]');

-- 所有版本支持的语法
CREATE TABLE <table_name> (...);
CALL set_table_property('<table_name>', 'bitmap_columns', '[<columnName>{:[on|off]}[,...]]');

使用建议
适合将等值查询的列设置为Bitmap,能够快速定位到符合条件的数据所在的行号。但需要注意的是Bitmap对于基数比较高(重复数据较少)的列会有比较大的额外存储开销。
不建议为每一列都设置Bitmap,不仅会有额外存储开销,也会影响写入性能(因为要为每一列构造Bitmap)。
不建议为实际内容为JSON,但保存为text类型的列设置Bitmap。
使用限制
只有列存表和行列共存表支持设置Bitmap,行存表不支持设置。
Bitmap指定的列可以为空。
当前版本默认所有TEXT类型的列都会被隐式地设置为Bitmap。
设置位图索引命令可以在事务之外单独使用,表示修改位图索引列,修改之后非立即生效,比特编码构建和删除在后台异步执行,详情请参见ALTER TABLE。
bitmap_columns属性仅支持设为on或off,Hologres V2.0版本起,不支持将bitmap_columns属性设为auto。
技术原理
Bitmap不同于Distribution Key和Clustering Key,Bitmap是数据存储之外的独立索引,设置了Bitmap索引之后,系统会将列对应的数值生成一个二进制字符串,用于表示取值所在位置的Bitmap,当查询命中Bitmap时,会快速定位到数据所在的行号(Row Number),从而快速过滤出数据。但Bitmap并不是没有开销的,对于以下场景需要注意事项如下:
列的基数较高(重复数据较少)场景:假如列的基数较高,那么就会为每一个值生成一个Bitmap,当非重复值很多的时候,就会形成稀疏数组,占用存储较多。
大宽表的每一列都设置为Bitmap场景:如果为大宽表的每一列都设置为Bitmap,那么在写入时每个值都需要构建成Bitmap,会有一定的系统开销,从而影响写入性能。
综上,Bitmap本质上是空间换时间的手段,对于数据分布比较均匀的列有比较高的性价比。

如下示例,可以通过explain SQL查看是否命中Bitmap索引。在执行计划中,有Bitmap Filter则说明命中Bitmap索引。
- V2.1版本起支持的语法:
CREATE TABLE bitmap_test (
   uid int NOT NULL,
   name text NOT NULL,
   gender text NOT NULL,
   class text NOT NULL,
   PRIMARY KEY (uid)
)
WITH (
   bitmap_columns = 'gender,class'
);

INSERT INTO bitmap_test VALUES
(1,'张三','男','一班'),
(2,'李四','男','三班'),
(3,'王五','女','二班'),
(4,'赵六','女','二班'),
(5,'孙七','男','二班'),
(6,'周八','男','三班'),
(7,'吴九','女','一班');

explain SELECT * FROM bitmap_test where gender='男' AND  class='一班';
- 所有版本支持的语法:
begin;
create table bitmap_test (
  uid int not null,
  name text not null,
  gender text not null,
  class text not null,
  PRIMARY KEY (uid)
);
call set_table_property('bitmap_test', 'bitmap_columns', 'gender,class');
commit;

INSERT INTO bitmap_test VALUES
(1,'张三','男','一班'),
(2,'李四','男','三班'),
(3,'王五','女','二班'),
(4,'赵六','女','二班'),
(5,'孙七','男','二班'),
(6,'周八','男','三班'),
(7,'吴九','女','一班');

explain SELECT * FROM bitmap_test where gender='男' AND  class='一班';
如下所示执行计划结果中有Bitmap Filter算子,说明命中Bitmap索引。

1.2.2 Bitmap和Clustering Key的区别
-
相同点:
Bitmap和Clustering Key都是文件内的数据过滤。 -
不同点:
Bitmap更适合等值查询,通过文件号定位到数据;Clustering Key是文件内的排序,因此更适合范围查询。
Clustering Key的优先级会比Bitmap更高,即如果为同一个字段设置了Clustering Key和Bitmap,那么优化器会优先使用Clustering Key去匹配文件,示例如下: -
V2.1版本起支持的语法:
--设置uid,class,date 3列为clustering key,text列设置默认为bitmap

CREATE TABLE ck_bit_test (
   uid int NOT NULL,
   name text NOT NULL,
   class text NOT NULL,
   date text NOT NULL,
   PRIMARY KEY (uid)
)
WITH (
   clustering_key = 'uid,class,date',
   bitmap_columns = 'name,class,date'
);
INSERT INTO ck_bit_test VALUES
(1,'张三','1','2022-10-19'),
(2,'李四','3','2022-10-19'),
(3,'王五','2','2022-10-20'),
(4,'赵六','2','2022-10-20'),
(5,'孙七','2','2022-10-18'),
(6,'周八','3','2022-10-17'),
(7,'吴九','3','2022-10-20');
-所有版本支持的语法:
--设置uid,class,date 3列为clustering key,text列设置默认为bitmap
begin;
create table ck_bit_test (
 uid int not null,
 name text not null,
 class text not null,
 date text not null,
 PRIMARY KEY (uid)
);
call set_table_property('ck_bit_test', 'clustering_key', 'uid,class,date');
call set_table_property('ck_bit_test', 'bitmap_columns', 'name,class,date');
commit;

INSERT INTO ck_bit_test VALUES
(1,'张三','1','2022-10-19'),
(2,'李四','3','2022-10-19'),
(3,'王五','2','2022-10-20'),
(4,'赵六','2','2022-10-20'),
(5,'孙七','2','2022-10-18'),
(6,'周八','3','2022-10-17'),
(7,'吴九','3','2022-10-20');
查询uid,class,date 三列,SQL符合左匹配特征,都命中Clustering Key,即使是等值查询也走Clustering Key,而不是走Bitmap。
SELECT * FROM clustering_test WHERE uid = ‘3’ AND class =‘2’ AND date > ‘2022-10-17’;
如下所示执行计划结果中有Cluster Filter算子,没有Bitmap Filter算子,说明查询走Clustering Key,而不是走Bitmap。

查询uid,class,date 三列,但class是范围查询,根据左匹配原则,SQL里匹配到>或者<则停止左匹配,那么date因不满足左匹配原则,就不会命中Clustering Key。date设置了Bitmap,则会使用Bitmap。
SELECT * FROM clustering_test WHERE uid = ‘3’ AND class >‘2’ AND date = ‘2022-10-17’;
如下所示执行计划结果中有Cluster Filter算子,说明查询uid,class走走Clustering Key;有Bitmap Filter算子,说明查询date走Bitmap。

使用示例
V2.1版本起支持的语法:
CREATE TABLE tbl (
    a text NOT NULL,
    b text NOT NULL
)
WITH (
    bitmap_columns = 'a:on,b:off'
);

-- 修改bitmap_columns
ALTER TABLE tbl SET (bitmap_columns = 'a:off');--ALTER TABLE语法仅支持全量修改
所有版本支持的语法:
--创建tbl并设置bitmap索引
begin; create table tbl (
  a text not null,
  b text not null
);
call set_table_property('tbl', 'bitmap_columns', 'a:on,b:off');
commit;


--修改bitmap索引
call set_table_property('tbl', 'bitmap_columns', 'a:off');--全量修改,将a字段的bitmap都关闭
call update_table_property('tbl', 'bitmap_columns', 'b:off');--增量修改,将b字段的bitmap关闭,a保留
1.3 聚簇索引Clustering Key
- 用途:
1. 在每个文件内部,数据严格按照ck有序排布 - 适用场景:
1. 等值或范围查询,能快速定位到文件内有效数据的范围 - 配置建议
1. 遵循最左匹配原则,一般1-2字段即可
2. 选择经常被用于范围查询的字段,如时间字段
Hologres会按照聚簇索引在文件内对数据进行排序,建立聚簇索引能够加速在索引列上的范围和过滤查询。设置Clustering Key的语法如下,需要建表时指定。
-- Hologres V2.1版本起支持的语法
CREATE TABLE <table_name> (...) WITH (clustering_key = '[<columnName>[,...]]');

-- 所有版本支持的语法
BEGIN;
CREATE TABLE <table_name> (...);
CALL set_table_property('<table_name>', 'clustering_key', '[<columnName>{:asc} [,...]]');
COMMIT;

使用建议
-
Clustering Key主要适用于点查以及范围查询的场景,对于过滤操作有比较好的性能提升,即对于where a = 1或者where a > 1 and a < 5的场景加速效果比较好。可以同时设置Clustering Key和Bitmap Column以达到最佳的点查性能。
-
Clustering Key具备左匹配原则,因此一般不建议设置Clustering Key超过两个字段,否则适用场景受限。Clustering Key是用于排序,所以Clustering Key里的列组合是有先后关系的,即排在前面列的排序优先级高于后面的列。
-
指定Clustering Key字段时,可在字段名后添加:asc来构建索引时的排序方式。排序方式默认为asc,即升序。Hologres V2.1以前版本不支持设置构建索引时的排序方式为降序(desc),如果设置了降序,无法命中Clustering Key,导致查询性能不佳;从V2.1版本开始,开启如下GUC后支持设置Clustering Key为desc,但仅支持Text、Char、Varchar、Bytea、Int等类型的字段,其余数据类型的字段暂不支持设置Clustering Key为desc。
set hg_experimental_optimizer_enable_variable_length_desc_ck_filter = on;
- 对于行存表,Clustering Key默认为主键 (Hologres V0.9之前版本默认不设置)。如果设置和主键不同的Clustering Key,那么Hologres会为这张表生成两个排序(Primary Key排序和Clustering Key排序),造成数据冗余。
使用限制
-
如需修改Clustering Key,请重新建表并导入数据。
-
Clustering Key必须为not nullable的列或者列组合。Hologres V1.3.20~1.3.27版本支持Clustering Key为nullable,从V1.3.28版本开始不支持Clustering Key为nullable,为nullable的Clustering Key可能会影响数据正确性,如果业务有强需求设置Clustering Key为null,可以在SQL前添加如下参数。
set hg_experimental_enable_nullable_clustering_key = true;
-
不支持将Float、Float4、Float8、Double、Decimal(Numeric)、Json、Jsonb、Bit、Varbit、Money、Time With Time Zone及其他复杂数据类型的字段设置为Clustering Key。
-
Hologres V2.1以前版本不支持设置构建索引时的排序方式为降序(desc),如果设置了降序,无法命中Clustering Key,导致查询性能不佳;从V2.1版本开始,开启如下GUC后支持设置Clustering Key为desc,但仅支持Text、Char、Varchar、Bytea、Int等类型的字段,其余数据类型的字段暂不支持设置Clustering Key为desc。
set hg_experimental_optimizer_enable_variable_length_desc_ck_filter = on;
-
对于列存表,Clustering Key默认为空,需要根据业务场景显式指定。
-
在Hologres中,每个表只能设置一组Clustering Key。即建表的时候只能使用call命令一次,不能执行多次,如下示例
-
V2.1版本起支持的建表语法:
--正确示例
CREATE TABLE tbl (
  a int NOT NULL,
  b text NOT NULL
)
WITH (
  clustering_key = 'a,b'
);

--错误示例
CREATE TABLE tbl (
  a int NOT NULL,
  b text NOT NULL
)
WITH (
  clustering_key = 'a',
  clustering_key = 'b'
);
所有版本支持的建表语法:
--正确示例
BEGIN;
CREATE TABLE tbl (a int NOT NULL, b text NOT NULL);
CALL set_table_property('tbl', 'clustering_key', 'a,b');
COMMIT;

--错误示例
BEGIN;
CREATE TABLE tbl (a int NOT NULL, b text NOT NULL);
CALL set_table_property('tbl', 'clustering_key', 'a');
CALL set_table_property('tbl', 'clustering_key', 'b');

COMMIT;
1.3.1 技术原理
Clustering Key在物理存储上是指在文件内进行排序,默认为升序(asc),可以通过下图理解Clustering Key的布局概念。
-
逻辑布局。
Clustering Key查询具备左匹配原则,不匹配则无法使用Clustering Key查询加速。如下场景示例将为您说明Hologres中Clustering Key的逻辑布局。
准备一张表,其字段分别包括Name、Date、Class。 -
设置Date为Clustering Key,会将表内的数据按照Date进行排序。
-
设置Class和Date为Clustering Key,会对表先按照Class排序后再按照Date进行排序。
设置不同的字段为Clustering Key,其最终的呈现结果也不同,具体如下图所示。

-
物理存储布局。
Clustering Key的物理存储布局如下图所示。

通过Clustering Key的布局原理可以看出: -
Clustering Key适合范围过滤的场景。比如where date= 1/1或者where a > 1/1 and a < 1/5的场景加速效果比较好。
-
Clustering Key查询具备左匹配原则,不匹配则无法利用上Clustering Key查询加速。即假设设置a,b,c三列为Clustering Key,如果是查a,b,c或者查a,b可以命中Clustering Key;如果查a,c只有a可以命中Clustering Key;如果查b,c则无法命中Clustering Key。
如下示例,设置uid,class,date三列为Clustering Key。
V2.1版本起支持的语法:
CREATE TABLE clustering_test (
    uid int NOT NULL,
    name text NOT NULL,
    class text NOT NULL,
    date text NOT NULL,
    PRIMARY KEY (uid)
)
WITH (
    clustering_key = 'uid,class,date'
);

INSERT INTO clustering_test VALUES
(1,'张三','1','2022-10-19'),
(2,'李四','3','2022-10-19'),
(3,'王五','2','2022-10-20'),
(4,'赵六','2','2022-10-20'),
(5,'孙七','2','2022-10-18'),
(6,'周八','3','2022-10-17'),
(7,'吴九','3','2022-10-20');
所有版本支持的语法:
BEGIN;
CREATE TABLE clustering_test (
  uid int NOT NULL,
  name text NOT NULL,
  class text NOT NULL,
  date text NOT NULL,
  PRIMARY KEY (uid)
);
CALL set_table_property('clustering_test', 'clustering_key', 'uid,class,date');
COMMIT;

INSERT INTO clustering_test VALUES
(1,'张三','1','2022-10-19'),
(2,'李四','3','2022-10-19'),
(3,'王五','2','2022-10-20'),
(4,'赵六','2','2022-10-20'),
(5,'孙七','2','2022-10-18'),
(6,'周八','3','2022-10-17'),
(7,'吴九','3','2022-10-20');
只查uid列,可以命中Clustering Key。
SELECT * FROM clustering_test WHERE uid > ‘3’;
通过查看执行计划(explain SQL),如下所示执行计划中有Cluster Filter算子,表明命中了Clustering Key,查询加速。

查uid,class列,可以命中Clustering Key。
SELECT * FROM clustering_test WHERE uid = ‘3’ AND class >‘1’ ;
通过查看执行计划(explain SQL),如下所示执行计划中有Cluster Filter算子,表明命中了Clustering Key,查询加速。

查uid,class,date三列可以命中Clustering Key。
SELECT * FROM clustering_test WHERE uid = ‘3’ AND class =‘2’ AND date > ‘2022-10-17’;
通过查看执行计划(explain SQL),如下所示执行计划中有Cluster Filter算子,表明命中了Clustering Key,查询加速。
查uid,date两列,不符合左匹配原则,因此只有uid可以命中Clustering Key,date则是走普通过滤。
SELECT * FROM clustering_test WHERE uid = ‘3’ AND date > ‘2022-10-17’;
通过查看执行计划(explain SQL),如下所示执行计划中只有uid列有Cluster Filter算子。
只查class,date两列,不符合左匹配原则,都无法命中Clustering Key。
SELECT * FROM clustering_test WHERE class =‘2’ AND date > ‘2022-10-17’;
通过查看执行计划(explain SQL),如下所示执行计划中没有Cluster Filter算子,表明未命中Clustering Key。
使用示例
示例1:命中Clustering Key的场景。
V2.1版本起支持的语法:
CREATE TABLE table1 (
    col1 int NOT NULL,
    col2 text NOT NULL,
    col3 text NOT NULL,
    col4 text NOT NULL
)
WITH (
    clustering_key = 'col1,col2'
);

--如上的建表sql,query可以被加速的情况如下:
-- 可加速
select * from table1 where col1='abc';

-- 可加速
select * from table1 where col1>'xxx' and col1<'abc';

-- 可加速
select * from table1 where col1 in ('abc','def');

-- 可加速
select * from table1 where col1='abc' and col2='def';

-- 不可加速
select col1,col4 from table1 where col2='def';
所有版本支持的语法:
begin;
create table table1 (
  col1 int not null,
  col2 text not null,
  col3 text not null,
  col4 text not null
);
call set_table_property('table1', 'clustering_key', 'col1,col2');
commit;

--如上的建表sql,query可以被加速的情况如下:
-- 可加速
select * from table1 where col1='abc';

-- 可加速
select * from table1 where col1>'xxx' and col1<'abc';

-- 可加速
select * from table1 where col1 in ('abc','def');

-- 可加速
select * from table1 where col1='abc' and col2='def';

-- 不可加速
select col1,col4 from table1 where col2='def';
示例2:Clustering Key设置为asc/desc。
V2.1版本起支持的语法:
CREATE TABLE tbl (
    a int NOT NULL,
    b text NOT NULL
)
WITH (
    clustering_key = 'a:desc,b:asc'
);
所有版本支持的语法:
BEGIN;
CREATE TABLE tbl (
  a int NOT NULL,
  b text NOT NULL
);
CALL set_table_property('tbl', 'clustering_key', 'a:desc,b:asc');
COMMIT;
1.3.2 高级调优手段
和传统数据库(MySQL或SQLServer)中的聚簇索引不同,Hologres的排序仅做到了文件内的排序,并非是全表数据的排序,因此在Clustering Key上做order by操作仍然有一定的代价。
Hologres从V1.3版本开始针对Clustering Key的场景使用做了较多的性能优化,实现在使用Clustering Key时有更好的性能,主要包含如下两个场景优化。
- 针对Clustering Keys做Order By场景
在Hologres中,文件内是按照Clustering Keys定义排序的,但在V1.3版本之前,优化器无法利用文件内的Clustering Keys有序性生成最优执行计划;同时经过Shuffle节点时也无法保障数据有序输出(多路归并),这就容易导致实际的计算量更大,耗时较久。在Hologres V1.3版本针对上面的情况进行优化,保证了生成的执行计划能够利用Clustering Keys的有序性,并能保障跨Shuffle保序,从而提高查询性能。但要注意:
-
- 当表没有对Clustering Keys做过滤时,默认走的是SeqScan,而不是IndexScan(只有IndexScan才会利用Clustering Keys的有序属性)。
-
- 优化器并不保障总是生成基于Clustering Keys有序的执行计划,因为利用Clustering Keys有序性是有些代价的(文件内有序但内存中需要额外排序的)。
示例如下。
表的DDL如下。
V2.1版本起支持的语法:
DROP TABLE IF EXISTS test_use_sort_info_of_clustering_keys;

CREATE TABLE test_use_sort_info_of_clustering_keys (
    a int NOT NULL,
    b int NOT NULL,
    c text
)
WITH (
    distribution_key = 'a',
    clustering_key = 'a,b'
);

INSERT INTO test_use_sort_info_of_clustering_keys SELECT i%500, i%100, i::text FROM generate_series(1, 1000) as s(i);

ANALYZE test_use_sort_info_of_clustering_keys;
所有版本支持的语法:
DROP TABLE if exists test_use_sort_info_of_clustering_keys;
BEGIN;
CREATE TABLE test_use_sort_info_of_clustering_keys
(
          a int NOT NULL,
          b int NOT NULL,
          c text
);
CALL set_table_property('test_use_sort_info_of_clustering_keys', 'distribution_key', 'a');
CALL set_table_property('test_use_sort_info_of_clustering_keys', 'clustering_key', 'a,b');
COMMIT;

INSERT INTO test_use_sort_info_of_clustering_keys SELECT i%500, i%100, i::text FROM generate_series(1, 1000) as s(i);

ANALYZE test_use_sort_info_of_clustering_keys;
查询语句。
explain select * from test_use_sort_info_of_clustering_keys where a > 100 order by a, b;
执行计划对比
V1.3之前版本(V1.1)的执行计划(执行explain SQL)如下。
 Sort  (cost=0.00..0.00 rows=797 width=11)
   ->  Gather  (cost=0.00..2.48 rows=797 width=11)
         Sort Key: a, b
         ->  Sort  (cost=0.00..2.44 rows=797 width=11)
               Sort Key: a, b
               ->  Exchange (Gather Exchange)  (cost=0.00..1.11 rows=797 width=11)
                     ->  Decode  (cost=0.00..1.11 rows=797 width=11)
                           ->  Index Scan using holo_index:[1] on test_use_sort_info_of_clustering_keys  (cost=0.00..1.00 rows=797 width=11)
                                 Cluster Filter: (a > 100)
V1.3版本的执行计划如下。
 Gather  (cost=0.00..1.15 rows=797 width=11)
   Merge Key: a, b
   ->  Exchange (Gather Exchange)  (cost=0.00..1.11 rows=797 width=11)
         Merge Key: a, b
         ->  Decode  (cost=0.00..1.11 rows=797 width=11)
               ->  Index Scan using holo_index:[1] on test_use_sort_info_of_clustering_keys  (cost=0.00..1.01 rows=797 width=11)
                     Order by: a, b
                     Cluster Filter: (a > 100)
V1.3版本的执行计划相较于之前版本,利用表Clustering Keys的有序性直接做归并输出,整个执行可Pipeline起来,不用再担心数据量大的时候排序慢的问题。从执行计划对比中可以看到,V1.3版本生成的是Groupagg,相比Hashagg,处理复杂度更低,性能会更好。
- 针对Clustering Keys做Join的场景(Beta)
Hologres在V1.3版本新增了SortMergeJoin类型,以保证生成的执行计划能够利用Clustering Keys的有序性,减少计算量,从而提高性能。但需要注意:
当前该功能还处于Beta版本,默认不开启,需要在Query前添加如下参数开启。
– 开启merge join
set hg_experimental_enable_sort_merge_join=on;
-
- 当表没有对Clustering Keys做过滤时,默认走的是SeqScan,而不是IndexScan(只有IndexScan才会利用Clustering Keys的有序属性)。
-
- 优化器并不保障总是生成基于Clustering Keys有序的执行,因为利用Clustering Keys有序性是有些代价的(文件内有序但内存中需要额外排序)。
示例如下。
表的DDL如下。
V2.1版本起支持的语法:
DROP TABLE IF EXISTS test_use_sort_info_of_clustering_keys1;
CREATE TABLE test_use_sort_info_of_clustering_keys1 (
    a int,
    b int,
    c text
)
WITH (
    distribution_key = 'a',
    clustering_key = 'a,b'
);

INSERT INTO test_use_sort_info_of_clustering_keys1 SELECT i % 500, i % 100, i::text FROM generate_series(1, 10000) AS s(i);
ANALYZE test_use_sort_info_of_clustering_keys1;

DROP TABLE IF EXISTS test_use_sort_info_of_clustering_keys2;
CREATE TABLE test_use_sort_info_of_clustering_keys2 (
    a int,
    b int,
    c text
)
WITH (
    distribution_key = 'a',
    clustering_key = 'a,b'
);

INSERT INTO test_use_sort_info_of_clustering_keys2 SELECT i % 600, i % 200, i::text FROM generate_series(1, 10000) AS s(i);
ANALYZE test_use_sort_info_of_clustering_keys2;
所有版本支持的语法:
drop table if exists test_use_sort_info_of_clustering_keys1;
begin;
create table test_use_sort_info_of_clustering_keys1
(
  a int,
  b int,
  c text
);
call set_table_property('test_use_sort_info_of_clustering_keys1', 'distribution_key', 'a');
call set_table_property('test_use_sort_info_of_clustering_keys1', 'clustering_key', 'a,b');
commit;
insert into test_use_sort_info_of_clustering_keys1 select i%500, i%100, i::text from generate_series(1, 10000) as s(i);
analyze test_use_sort_info_of_clustering_keys1;

drop table if exists test_use_sort_info_of_clustering_keys2;
begin;
create table test_use_sort_info_of_clustering_keys2
(
  a int,
  b int,
  c text
);
call set_table_property('test_use_sort_info_of_clustering_keys2', 'distribution_key', 'a');
call set_table_property('test_use_sort_info_of_clustering_keys2', 'clustering_key', 'a,b');
commit;
insert into test_use_sort_info_of_clustering_keys2 select i%600, i%200, i::text from generate_series(1, 10000) as s(i);
analyze test_use_sort_info_of_clustering_keys2;
查询语句如下。
explain select * from test_use_sort_info_of_clustering_keys1 a join test_use_sort_info_of_clustering_keys2 b on a.a = b.a and a.b=b.b where a.a > 100 and b.a < 300;
执行计划对比
V1.3之前版本(V1.1)的执行计划如下。
 Gather  (cost=0.00..3.09 rows=4762 width=24)
   ->  Hash Join  (cost=0.00..2.67 rows=4762 width=24)
         Hash Cond: ((test_use_sort_info_of_clustering_keys1.a = test_use_sort_info_of_clustering_keys2.a) AND (test_use_sort_info_of_clustering_keys1.b = test_use_sort_info_of_clustering_keys2.b))
         ->  Exchange (Gather Exchange)  (cost=0.00..1.14 rows=3993 width=12)
               ->  Decode  (cost=0.00..1.14 rows=3993 width=12)
                     ->  Index Scan using holo_index:[1] on test_use_sort_info_of_clustering_keys1  (cost=0.00..1.01 rows=3993 width=12)
                           Cluster Filter: ((a > 100) AND (a < 300))
         ->  Hash  (cost=1.13..1.13 rows=3386 width=12)
               ->  Exchange (Gather Exchange)  (cost=0.00..1.13 rows=3386 width=12)
                     ->  Decode  (cost=0.00..1.13 rows=3386 width=12)
                           ->  Index Scan using holo_index:[1] on test_use_sort_info_of_clustering_keys2  (cost=0.00..1.01 rows=3386 width=12)
                                 Cluster Filter: ((a > 100) AND (a < 300))
V1.3版本的执行计划如下。
  Gather  (cost=0.00..2.88 rows=4762 width=24)
   ->  Merge Join  (cost=0.00..2.46 rows=4762 width=24)
         Merge Cond: ((test_use_sort_info_of_clustering_keys2.a = test_use_sort_info_of_clustering_keys1.a) AND (test_use_sort_info_of_clustering_keys2.b = test_use_sort_info_of_clustering_keys1.b))
         ->  Exchange (Gather Exchange)  (cost=0.00..1.14 rows=3386 width=12)
               Merge Key: test_use_sort_info_of_clustering_keys2.a, test_use_sort_info_of_clustering_keys2.b
               ->  Decode  (cost=0.00..1.14 rows=3386 width=12)
                     ->  Index Scan using holo_index:[1] on test_use_sort_info_of_clustering_keys2  (cost=0.00..1.01 rows=3386 width=12)
                           Order by: test_use_sort_info_of_clustering_keys2.a, test_use_sort_info_of_clustering_keys2.b
                           Cluster Filter: ((a > 100) AND (a < 300))
         ->  Exchange (Gather Exchange)  (cost=0.00..1.14 rows=3993 width=12)
               Merge Key: test_use_sort_info_of_clustering_keys1.a, test_use_sort_info_of_clustering_keys1.b
               ->  Decode  (cost=0.00..1.14 rows=3993 width=12)
                     ->  Index Scan using holo_index:[1] on test_use_sort_info_of_clustering_keys1  (cost=0.00..1.01 rows=3993 width=12)
                           Order by: test_use_sort_info_of_clustering_keys1.a, test_use_sort_info_of_clustering_keys1.b
                           Cluster Filter: ((a > 100) AND (a < 300))
V1.3版本的执行计划相较于之前版本的执行计划,利用Clustering Index的有序性,在Shard内做归并排序后直接进行SortMergeJoin,让整个执行Pipeline起来;可规避数据量大较大时,HashJoin需将Hash Side填充至内存而导致的OOM问题。
1.4 分段键 segment_key
- 用途:
1. 在底层合并小文件时,尽量将segment key接近的数据合并到同一个文件里 - Segment Key主要适用的场景如下:
1. 含范围过滤条件(包括等值条件)的查询场景(可以直接过滤掉文件)
2. 基于主键的UPDATE - 建议:
1. 使用基本有序的时间列,一个即可
1.5 1. 分布键 Distribution Key
- 用途:
1. (按照分区键的hash)将数据打散到不同的分片(shard)上 - 合理设置Distribution Key可以达到如下效果:
1. 显著提高计算性能。- 不同的Shard可以进行并行计算,从而提高计算性能。
2. 显著提高每秒查询率(QPS)。
  1. 当您以Distribution Key做过滤条件时,Hologres可以直接筛选出数据相关的Shard进行扫描。否则Hologres需要让所有的Shard参与计算,影响QPS。
3. 显著提高Join性能。
  1. 当两张表在同一个Table Group内,并且Join的字段是Distribution Key时,那么数据分布保证表A一个Shard内的数据和表B同一Shard内的数据对应,只需要直接在本节点Join本节点数据(Local Join)即可,可以显著提高执行效率。
4. 配置建议:
  1. 建议1个字段,最多2个,列的顺序不影响数据的布局和查询性能
  2. 选取基数较大、没有明显倾斜的字段,这样可以将数据均匀地打散到不同分片上,避免数据倾斜和热点key引起的查询时负载倾斜
  3. 选择Group By频繁的字段作为Distribution Key
  4. 表设置了主键(PK)时,Distribution Key必须为PK的子集
1.7
2 查询前可以开启的优化
2.1 enable_columnar_type
当数据中有json数据时,可以开启hologres的jsonb优化,底层会自动将json数据转换为强schema存储,在查询时会提供非常快速的体验。
ALTER TABLE gh_2015 ALTER COLUMN gh_jsonb SET (enable_columnar_type = on);
具体底层原理可以参考。
链接: hologres基础知识一文全
3 sql参数优化
在create table 的DDL中
‘connector’ = ‘hologres-cdc’ 中添加 ‘sdkMode’=‘jdbc_fixed’
‘connector’ = ‘hologres’ 中添加 ‘fixedConnectionMode’ = ‘true’,
这样,hologres,会用协程的方式读写数据,会减少占用的连接数,如果flink读写hologres这种方式,并发一大,会占用大量连接数,这样的话就可以优化资源
4 hologres 适用场景分享
shard,worker与cu的数量关系
1 默认数据1副本。hologres 1个workder,16个cu,1个workder最少1个shard(数据分片数)如果没有shard,那这个workder就无法被配工作
2 例如: 80个shard最多可以均匀分布到80*16个cu上。设置80个shard 1280个cu,刚好资源打满,每个shard 最多支持一个flinkcdc, source的并发;
3 leader shard 做数据写入
4 1个workder可以处理任意数量shard,一个shard只能被一个节点查询
5 数据存储的分布键不合理会导致,存储的数据倾斜,导致查询倾斜,holoweb里诊断可以看到倾斜,假如分布键是org_id,只有40个门店 80个shard就只有一半会分配这个数据,就算资源扩容了一倍,也不会有使用的提升
5 执行配置参数
常用的SQL性能优化参数:
–关闭数据重分布
– set optimizer_enable_motion_redistribute = true;
–关闭cache
set hg_experimental_enable_result_cache = off;
set hg_experimental_enable_query_use_block_cache = off;
–开启hint语法支持
SET pg_hint_plan_enable_hint=on;
–打开详细执行计划
– set hg_experimental_show_execution_statistics_in_explain = on;
–常规执行计划
Explain Analyze
–巨详细执行计划(JSON)
– explain (format pb)
指定query关闭数据重分布,降低shuffle消耗方法:
SET pg_hint_plan_enable_hint=on;
WITH dim_sale_org AS (
SELECT/*+HINT set(optimizer_enable_motion_redistribute off) */
…
 215


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


