
机器学习期末题库

机器学习期末考试题库【最全考试题库】 本文有特别详细的机器学习这门课期末考试会考到的相关的概念,并配有相关的习题,大家把这一块学明白了,考试可以有很大的助力,喜欢的朋友点一下关注吧,持续关注我,我会后面陆续更新更多的资源哟~(づ ̄3 ̄)づ╭❤~ 阅读详情
AI摘要

本文涵盖了机器学习的各种概念,包括监督学习与无监督学习的算法,如贝叶斯分类器、层次聚类、线性回归、决策树等。深入探讨了正则化、梯度下降、神经网络、支持向量机、随机森林等模型的原理和应用。此外,还讨论了数据预处理的重要性,如特征缩放、归一化和降维方法。文章强调了模型评估、正则化参数选择、过拟合与欠拟合的应对策略,并介绍了异常检测和关联规则挖掘。最后,对集成学习和深度学习的特性进行了总结,展示了它们在实际问题中的价值。

机器学习期末题库

1.属于监督学习的机器学习算法是:贝叶斯分类器

2.属于⽆监督学习的机器学习算法是:层次聚类

3.⼆项式分布的共轭分布是:Beta分布

4.多项式分布的共轭分布是:Dirichlet分布

5.朴素贝叶斯分类器的特点是:假设样本各维属性独⽴

6.下列⽅法没有考虑先验分布的是:最⼤似然估计

7.对于正态密度的贝叶斯分类器,各类协⽅差矩阵相同时,决策函数为:线性决策函数

8.下列属于线性分类⽅法的是:感知机

9.下列⽅法不受数据归⼀化影响的是:决策树

10.下列分类⽅法中不会⽤到梯度下降法的是:最⼩距离分类器

11.下列⽅法使⽤最⼤似然估计的是:Logistic回归

12.关于线性鉴别分析的描述最准确的是,找到⼀个投影⽅向,使得:类内距离最⼩,类间距离最⼤

13.SVM的原理的简单描述,可概括为:最⼤间隔分类

14.SVM的算法性能取决于:以上都有(核函数的选择、核函数的参数、软间隔参数C)

15.⽀持向量机的对偶问题是:凸⼆次优化

16.以下对⽀持向量机中的⽀撑向量描述正确的是:最⼤间隔⽀撑⾯上的向量

17.假定你使⽤阶数为2的线性核SVM,将模型应⽤到实际数据集上后,其训练准确率和测试准确率均为100%。现在增加模型复杂度(增加核函数的阶),会发⽣以下哪种情况:过拟合

18.避免直接的复杂⾮线性变换,采⽤线性⼿段实现⾮线性学习的⽅法是:核函数⽅法

19.关于决策树节点划分指标描述正确的是:信息增益越⼤越好

20.以下描述中,属于决策树策略的是:最⼤信息增益

21.集成学习中基分类器的选择如何,学习效率通常越好:分类器多样,差异⼤

22.集成学习中,每个基分类器的正确率的最低要求:50%以上

23.下⾯属于Bagging⽅法的特点是:构造训练集时采⽤Bootstraping的⽅式

24.下⾯属于Bagging⽅法的特点是:构造训练集时采⽤Bootstraping的⽅式

25.随机森林⽅法属于:Bagging⽅法

26.假定有⼀个数据集S,但该数据集有很多误差,采⽤软间隔SVM训练,阈值为C,如果C的值很⼩,以下哪种说法正确:会发⽣误分类现象

27.软间隔SVM的阈值趋于⽆穷,下⾯哪种说法正确:只要最佳分类超平⾯存在,它就能将所有数据全部正确分类

28.⼀般,K-NN最近邻⽅法在什么情况下效果好:样本较少但典型性较好

29.回归问题和分类问题的区别:前者预测函数值为连续值,后者为离散值

30.最⼩⼆乘回归⽅法的等效回归⽅法:线性均值和正态误差的最⼤似然回归

31.正则化的回归分析,可以避免:过拟合

32.“啤酒-纸尿布”问题讲述的是,超市购物中,通过分析购物单发现,买了纸尿布的男⼠,往往⼜买了啤酒。这是⼀个什么问题:关联分析

33.KL散度是根据什么构造的可分性判据:类概率密度

34.密度聚类⽅法充分考虑了样本间的什么关系:密度可达

35.混合⾼斯聚类中,运⽤了以下哪种过程:EM算法

36.主成分分析是⼀种什么⽅法:降维⽅法

37.PCA在做降维处理时,优先选取哪些特征:中⼼化样本的协⽅差矩阵的最⼤特征值对应特征向量

38.过拟合现象中:训练样本的测试误差最⼩,测试样本的正确识别率却很低

39.如右图所⽰有向图,节点G的马尔可夫毯为:{D,E,F,H,I,J}

40.如右图所⽰⽆向图,节点G的马尔可夫毯为:{D,E,I,J}

41.多层感知机⽅法中,可⽤作神经元的⾮线性激活函数:Logistic函数

42.在有限⽀撑集上,下⾯分布的熵最⼤:均匀分布

43.已知均值和⽅差,下⾯哪种分布的熵最⼤:⾼斯分布

44.以下模型中属于概率图模型的是:受限玻尔兹曼机

45.如右图所⽰有向图,以下陈述正确的有:B和G关于{C,F}条件独⽴

46.在标准化公式中,使⽤的⽬的是:防⽌分母为零

47.梯度下降算法的正确步骤是什么:4,3,1,5,2 (初始化-输⼊-计算误差-改变权重以减⼩误差-迭代更新)
(1)计算预测值和真实值之间的误差
(2)迭代跟新,直到找到最佳权重
(3)把输⼊传⼊⽹络,得到输出值
(4)初始化随机权重和偏差
(5)对每⼀个产⽣误差的神经元,改变相应的(权重)值以减⼩误差
48.假如使⽤⼀个较复杂的回归模型来拟合样本数据,使⽤岭回归,调试正则化参数,来降低模型复杂度。若λ较⼤时,关于偏差和⽅差,下列说法正确的是:若λ较⼤时,偏差减⼩,⽅差减⼩

49.以下哪种⽅法会增加模型的⽋拟合风险:数据增强

50.以下说法正确的是:除了EM算法,梯度下降也可求混合⾼斯模型的参数

51.在训练神经⽹络时,如果出现训练error过⾼,下列哪种⽅法不能⼤幅度降低训练error:增加训练数据

52.以下哪种激活函数可以导致梯度消失:Tanh

53.增加以下哪些超参数可能导致随机森林模型过拟合数据:(2)决策树的深度

54.以下关于深度⽹络训练的说法正确的是:D
A.训练过程需要⽤到梯度,梯度衡量了损失函数相对于模型参数的变化率
B.损失函数衡量了模型预测结果与真实值之间的差异
C.训练过程基于⼀种叫做反向传播的技术
D.其他选项都正确
55.以下哪⼀项在神经⽹络中引⼊了⾮线性:ReLU

56.在线性回归中使⽤正则项,你发现解的不少coefficient都是0,则这个正则项可能是:
L0-norm、L1-norm
57.关于CNN,以下结论正确的是:Pooling层⽤于减少图⽚的空间分辨率

58.关于k-means算法,正确的描述是:初始值不同,最终结果可能不同

59.下列关于过拟合现象的描述中,哪个是正确的:训练误差⼩,测试误差⼤

60.以下关于卷积神经⽹络,说法正确的是:卷积神经⽹络可以有多个卷积核,可以不同⼤⼩

61.LR模型的损失函数是:交叉熵

62.GRU和LSTM的说法正确的是:GRU的参数⽐LSTM的参数少

63.以下⽅法不可以⽤于特征降维的有:Monte Carlo method

64.下列哪个函数不可以做激活函数:y=2x

65.有两个样本点,第⼀个点为正样本,它的特征向量是(0,-1);第⼆个点为负样本,它的特征向量是(2,3),从这两个样本点组成的训练集构建⼀个线性SVM分类器的分类⾯⽅程是:x+2y=3

66.在其他条件不变的前提下,以下哪种做法容易引起机器学习中的过拟合问题:SVM算法中使⽤⾼斯核代替线性核

67.下⽅法中属于⽆监督学习算法的是:K-Means聚类

68.Bootstrap数据是什么意思:有放回地从总共N个样本中抽样n个样本

69.下⾯关于贝叶斯分类器描述错误的是:是基于后验概率,推导出先验概率

70.下⾯关于Adaboost算法的描述中,错误的是:同时独⽴地学习多个弱分类器

71.以下机器学习中,在数据预处理时,不需要考虑归⼀化处理的是:树形模型

72.⼆分类任务中,有三个分类器h1,h2,h3,三个测试样本x1,x2,x3。假设1表⽰分类结果正确,0表⽰错误,h1在x1,x2,x3的结果分别(1,1,0),h2,h3分别为(0,1,1),(1,0,1),按投票法集成三个分类器,下列说法正确的是:集成提⾼了性能

73.有关机器学习分类算法的Precision和Recall,以下定义中正确的是(假定tp = true positive, tn = true negative, fp = false positive, fn =false negative):

Precision= tp / (tp + fp), Recall = tp / (tp + fn)

74.下列哪个不属于常⽤的⽂本分类的特征选择算法:主成分分析

75.在HMM中,如果已知观察序列和产⽣观察序列的状态序列,那么可⽤以下哪种⽅法直接进⾏参数估计:极⼤似然估计

76.以下哪种距离会侧重考虑向量的⽅向:余弦距离

77.解决隐马模型中预测问题的算法是:维特⽐算法

78.在Logistic Regression 中,如果同时加⼊L1和L2范数,会产⽣什么效果:可以做特征选择,并在⼀定程度上防⽌过拟合

79.普通反向传播算法和随时间的反向传播算法(BPTT)有什么技术上的不同:与普通反向传播不同的是,BPTT会在每个时间步长内叠加所有对应权重的梯度

80.梯度爆炸问题是指在训练深度神经⽹络的时候,梯度变得过⼤⽽损失函数变为⽆穷。在RNN中,下⾯哪种⽅法可以较好地处理梯度爆炸
问题:梯度裁剪

81.当训练⼀个神经⽹络来作图像识别任务时,通常会绘制⼀张训练集误差和验证集误差图来进⾏调试。在下图中,最好在哪个时间停⽌训
练:C

[外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传(img-ctS8tH71-1655199702381)(C:\Users\Crescent_P\AppData\Roaming\Typora\typora-user-images\image-20220612170843797.png)]

第 1 题

一个计算机程序从经验E中学习任务T,并用P来衡量表现。并且,T的表现P随着经验E的增加而提高。
假设我们给一个学习算法输入了很多历史天气的数据,让它学会预测天气。什么是P的合理选择?

A. 计算大量历史气象数据的过程
B. 以上都不
C. 正确预测未来日期天气的概率
D. 天气预报任务

第 2 题

假设你正在做天气预报,并使用算法预测明天气温(摄氏度/华氏度),你会把这当作一个分类问题还是一个回归问题?

A. 分类
B. 回归

第 3 题

假设你在做股市预测。你想预测某家公司是否会在未来7天内宣布破产(通过对之前面临破产风险的类似公司的数据进行训练)。你会把这当作一个分类问题还是一个回归问题?

A. 分类
B. 回归

第 4 题

下面的一些问题最好使用有监督的学习算法来解决,而其他问题则应该使用无监督的学习算法来解决。以下哪一项你会使用监督学习?(选择所有适用的选项)在每种情况下,假设有适当的数据集可供算法学习。

A. 根据一个人的基因(DNA)数据,预测他/她的未来10年患糖尿病的几率

B. 根据心脏病患者的大量医疗记录数据集,尝试了解是否有不同类患者群,我们可以为其量身定制不同的治疗方案

C. 让计算机检查一段音频,并对该音频中是否有人声(即人声歌唱)或是否只有乐器(而没有人声)进行分类

D. 给出1000名医疗患者对实验药物的反应(如治疗效果、副作用等)的数据,发现患者对药物的反应是否有不同的类别或“类型”,如果有,这些类别是什么

第 5 题

哪一个是机器学习的合理定义?

A. 机器学习从标记的数据中学习

B. 机器学习能使计算机能够在没有明确编程的情况下学习

C. 机器学习是计算机编程的科学

D. 机器学习是允许机器人智能行动的领域

第 6 题

基于一个学生在大学一年级的表现,预测他在大学二年级表现。
令x等于学生在大学第一年得到的“A”的个数(包括A-,A和A+成绩)学生在大学第一年得到的成绩。预测y的值:第二年获得的“A”级的数量
这里每一行是一个训练数据。在线性回归中,我们的假设hθ(x)=θ0+θ1x,并且我们使用m来表示训练示例的数量。

| x    | y    |  
| 3    | 2    |  
| 1    | 2    |  
| 0    | 1    |  
| 4    | 3    |  

对于上面给出的训练集(注意,此训练集也可以在本测验的其他问题中引用),m的值是多少?

第 7 题

对于这个问题,假设我们使用第一题中的训练集。并且,我们对代价函数的定义是J(θ0,θ1)=12m∑i=1m(hθ(x(i))−y(i))2
求J(0,1)

第 8 题

令问题1中,线性回归假设的θ0=−1,θ1=2,求hθ(6)?

第 9 题

代价函数J(θ0,θ1)与θ0,θ1的关系如图2所示。“图1”中给出了相同代价函数的等高线图。根据图示,选择正确的选项(选出所有正确项)
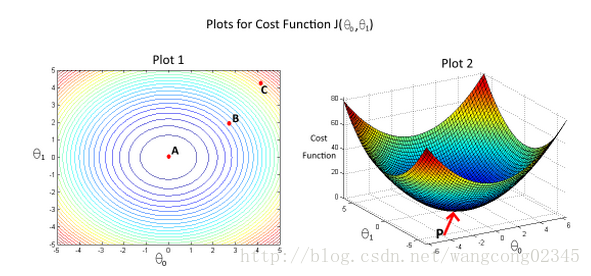
Image Name

A. 从B点开始,学习率合适的梯度下降算法会最终帮助我们到达或者接近A点,即代价函数J(θ0,θ1)在A点有最小值

B. 点P(图2的全局最小值)对应于图1的点C

C. 从B点开始,学习率合适的梯度下降算法会最终帮助我们到达或者接近C点,即代价函数J(θ0,θ1)在C点有最小值

D. 从B点开始,学习率合适的梯度下降算法会最终帮助我们到达或者接近A点,即代价函数J(θ0,θ1)在A点有最大值

E. 点P(图2的全局最小值)对应于图1的点A

第 10 题

假设对于某个线性回归问题(比如预测房价),我们有一些训练集,对于我们的训练集,我们能够找到一些θ0,θ1,使得J(θ0,θ1)=0。
以下哪项陈述是正确的?(选出所有正确项)

A. 为了实现这一点,我们必须有θ0=0,θ1=0,这样才能使J(θ0,θ1)=0

B. 对于满足J(θ0,θ1)=0的θ0,θ1的值,其对于每个训练例子(x(i),y(i)),都有hθ(x(i))=y(i)

C. 这是不可能的:通过J(θ0,θ1)=0的定义,不可能存在θ0,θ1使得J(θ0,θ1)=0

D. 即使对于我们还没有看到的新例子,我们也可以完美地预测y的值(例如,我们可以完美地预测我们尚未见过的新房的价格)

第 11 题

[外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传(img-eIxCOuA6-1655199702382)(C:

超详细!机器学习期末考试知识点汇总,助你一臂之力,直击高分! 聚类完成后将聚类数据的均值更新为簇的中心,再继续将每个样本划分到与其距离最近的簇中,接着通过迭代的方法,逐次更新各聚类中心的值,直至簇质心变化的范围很小或质心不再发生变化。首先定义误差ε (i) 为每个样本的预测值和实际值之间的差距,由于每个样本的预测值和实际值都存在一定的误差,因此我们假定所有样本的误差ε(i) (1 ≤ i ≤ n) 是独立同分布的,服从均值为0,方差为某个定值的高斯分布。这个线性变换的过程实际上就是寻找一组新的坐标轴,也就是新的主成分,以重新描述数据点在空间中的位置。 阅读详情

相关推荐

机器学习期末复习

机器学习课程的期末考试复习笔记

h1552347193的博客 3705

机器学习期末复习题题库-单项选择题

K均值聚类算法的核心思想是通过迭代的方式,将样本分配到离其最近的簇中,并更新簇的中心点,直到达到收敛。解析:监督学习是一种机器学习的方法,其使用带有标签的训练数据来训练模型。通过对这些已知标签的样本进行学习,模型可以推断出输入特征和输出之间的关系,并用于预测新的未知样本的输出。解析:特征选择是机器学习中的一个重要步骤,其目的是从原始特征中选择出对目标变量具有重要影响的特征,以提高模型的性能和效果。特征选择可以帮助减少特征空间的维度,减少模型的计算开销,降低模型的复杂性,并提高模型的解释性和泛化能力。

code_program481的博客 2742

机器学习期末复习题库:选择题及答案高效使用指南

在机器学习中,损失函数、正则化、偏差方差和评估指标是核心概念,理解其原理对模型泛化至关重要。通过选择题干扰项可暴露概念模糊地带,结合错题统计与变式自测,能系统提升理论掌握度。这些方法在期末备考和工程调参中均有广泛应用。本文围绕机器学习期末复习题库,详解选择题及答案的高效使用策略,帮助读者避开常见陷阱,构建扎实知识体系。

weixin_34128839的博客 330

机器学习期末题库:sklearn 核心算法与评估调参

机器学习模型能否稳定泛化,核心在于训练集划分、过拟合与欠拟合的判别,以及评估指标的选择。通过交叉验证与 Pipeline,可以把数据清洗、特征缩放、模型训练和参数搜索串成可复现流程,避免数据泄漏。sklearn 作为常用工具,提供了 KNN、朴素贝叶斯、决策树、SVM、回归评估等接口,让 K 值、核函数、树深度、正则化等参数有据可调。这些方法广泛应用于分类、回归、文本与时序任务,也是课程实验和工程基线的常见入口。围绕一份期末题库,用可运行的代码复现知识点,从概念、参数到翻车点逐项排查,能更高效地形成机器学习

weixin_29051811的博客 231

机器学习期末复习题库高效使用指南:从刷题到真懂

机器学习算法学习常从监督学习、无监督学习等基础概念切入,理解模型评估与过拟合机制是掌握原理的关键。通过分类、聚类、降维等典型算法实践,可提升特征提取与模型泛化能力,广泛应用于图像识别、自然语言处理等场景。面对机器学习期末复习题,如何高效利用题库查漏补缺?本文以一份包含85道单选、40道多选和12道简答题的题库为例,拆解SVM对偶、K-Means迭代与CNN参数计算等高频考点,提供从模块归类、错题反查到简答题反推知识框架的系统方法,帮助读者将题库转化为诊断工具,实现从刷题到真懂的进阶。

weixin_29168153的博客 230

机器学习期末复习:选择题题库刷题技巧与Python脚本实践

机器学习复习中,选择题是检验概念辨析能力的有效工具。通过对比L1与L2正则化、偏差方差权衡等易混淆知识点,选择题能帮助学习者精准定位认知盲区。合理设计的题库应覆盖监督学习、模型评估、特征工程等核心考点,并辅以难度分级与考点标签。利用Python脚本对题库CSV进行随机抽题、即时判分与错题收集,可打造可追踪的复习闭环,提升刷题效率。本文结合机器学习期末复习场景,介绍题库组织逻辑与自动化刷题方案,适合备考学生及算法面试者快速自测。

weixin_28745309的博客 197

机器学习期末复习题库:诊断型刷题与认知盲区突破

机器学习是人工智能核心基础,其核心概念如监督学习、模型评估、过拟合与正则化等,既是课程重点,也是工程实践中高频应用的技术基石。理解bias-variance tradeoff、AUC物理意义、L1正则化稀疏性本质等原理,直接决定模型泛化能力与部署可靠性。在高校教学与算法岗面试中,这些知识点常以多维度变形考查——从数学推导(如SVM对偶问题)、代码行为(如sklearn中f1_score的zero_division处理),到真实场景归因(如验证集误差骤升时优先调正则系数)。本题库聚焦典型认知盲区与易混淆点,覆

weixin_34216614的博客 223

机器学习期末复习题库:85道题构建核心概念知识地图

机器学习算法通常分为监督学习与无监督学习,前者依赖标注数据学习输入到输出的映射,后者则从无标签数据中自动发现结构。理解这一基本分类是掌握分类、回归、聚类等核心概念的前提。在此基础上,贝叶斯方法引入先验与后验的概率视角,最大似然估计与最大后验估计的区别体现了频率学派与贝叶斯学派的不同思路。这些基础原理支撑了从线性模型、支持向量机到集成学习等复杂算法的设计与调优,广泛应用于文本分类、图像识别、推荐系统等场景。通过系统化的题库自测,能够有效串联监督与无监督学习、概率模型、SVM、决策树与集成学习等知识点,帮助学习

weixin_29044157的博客 201

机器学习期末复习题库拆解:题型、算法与sklearn代码验证

机器学习复习的核心不是背答案,而是理解模型评估与算法调用背后的机制:训练集用于拟合参数,测试集用于评估泛化,KNN、朴素贝叶斯、决策树和SVM核函数则分别对应距离分类、概率推断、树形划分与高维映射。把这些概念放回sklearn的线性回归、KNN六步法代码中验证,能让回归评估指标、API参数和常见报错形成可执行的知识链。对期末备考和转岗开发者而言,这种按题型重组、按错因归档、按轮次推进的方式,比从头翻题库更高效。围绕机器学习期末复习题及答案,内容按单选、多选、名词解释、简答和编程题拆解,并结合代码验证与错题复

weixin_29042035的博客 228

机器学习期末复习:核心概念与算法选择题题库精讲

机器学习是人工智能的核心分支,其本质是通过数据驱动模型学习规律并进行预测或决策。理解监督学习、无监督学习等基本范式,以及线性回归、决策树、支持向量机等经典算法的原理,是掌握该领域的关键。在实际工程中,模型评估与性能度量同样重要,精确率、召回率、ROC/AUC和交叉验证等方法能够帮助我们客观判断模型的泛化能力,避免过拟合与欠拟合问题。特征工程与降维技术则能有效提升模型效果。期末复习阶段,通过覆盖基础概念、经典算法、无监督学习、模型评估和特征工程等高频考点的选择题自测,能够快速定位知识盲区,并深入理解每个选项背

weixin_29191669的博客 276

机器学习考试题目及答案1

1 、神经网络的难点使用层数较深的神经网络会遇到许多困难,比如:容易过拟合、参数难以调试、梯度弥漫等,针对这些问题有很多trick解决 2、过拟合过拟合是机器学

机器学习期末复习题及答案

机器学习期末复习题及答案

机器学习期末复习试卷.doc

机器学习期末复习试卷.doc

京东联盟h5st(3.1)加密参数逆向实战与反爬对抗策略

本文详细解析了京东联盟h5st(3.1)加密参数的逆向分析与实战破解过程。通过接口分析定位关键加密函数,拆解h5st结构并还原其基于SHA256和HMAC-SHA256的加密逻辑,最终使用Python集成JavaScript环境成功复现加密算法,并分享了应对反爬的频率限制、IP封禁及算法升级等对抗策略。

weixin_29246195的博客 1738

Wireshark 4.6 TCP 流图解析:3种拥塞控制算法可视化对比

本文深入解析Wireshark 4.6的TCP流图功能,通过可视化对比Reno、Cubic和BBR三种主流拥塞控制算法的性能特征。文章提供详细的实验环境搭建方法、流图分析工具使用技巧,以及算法调优建议,帮助网络工程师优化TCP性能。

weixin_29291573的博客 444

TRAE智能体开发:TRAE概述

TRAE(/treɪ/)深度融合 AI 能力,是一名能够理解需求、调用工具并独立完成各类开发任务的“AI 开发工程师”,帮助你高效推进每一个项目。

王国平的博客 1254

团体程序设计天梯赛竞赛题--登顶题【L3-039 攀岩】

登顶级 3 道题,每道题 30 分,满分为 90 分。

Pretty Boy Fox的博客 653

基于逆向工程的中国裁判文书网爬虫技术深度解析:从反爬破解到合规抓取

最近承接了一个法律大数据分析的项目,需要获取某类合同纠纷的裁判文书数据,用于分析不同地区的判决规律、法官的裁判倾向以及法条适用情况。原本以为用常规的Python爬虫就能搞定,结果刚对着中国裁判文书网发了几个请求,就遭遇了“滑铁卢”:要么请求直接返回403 Forbidden,要么触发滑块验证码,甚至连IP都被临时封禁了。普通的requests+BeautifulSoup组合在裁判文书网面前完全失效,这也让我意识到,想要获取这里的数据,必须先通过逆向工程拆解网站的请求逻辑和反爬机制。经过一周的摸索,从抓包分析

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 3168

【系统架构设计师】预测试卷四:综合知识(75道选择题)

本文整理系统架构设计师考试高频考点,涵盖计算机系统基础、计算机网络、数据库、软件工程与UML四大模块,共28道典型题目。重点解析Cache局部性原理、RISC/CISC区别、TCP三次握手、B+树索引优势、CAP定理、螺旋模型特点等核心概念,并标注易错选项,帮助考生快速掌握解题思路。 关键词:系统架构、Cache、RISC、TCP、B+树、CAP定理、螺旋模型

数据知道的博客 543

一次请求穿过的六道关卡:微服务基础组件的通信与IO、事件驱动、负载均衡、服务路由、API网关与配置协调

微服务的稳定性往往取决于看不见的基础组件。本文跟随一次下单请求,依次穿过API网关、服务路由、负载均衡与服务通信,再沿事件分支扇出,并从控制面审视配置中心。通信层剖析握手成本、连接复用、epoll与主从Reactor、心跳判活、退避抖动、截止时间与重试预算;事件层讲解编舞与编排、事务发件箱和幂等消费;均衡与路由对比静态与动态算法、路由链、全链路灰度与同区保底;网关讨论过滤器链与限流算法;配置部分给出四类配置、长轮询与共识协调,最后归纳五道防线。文中关键数据均来自可在Java8运行的演示程序。

曾经“等你生日那天”都遥远得像未来,如今却可欢愉的挥手说“下个十年见” 172万+

DDS协议--[第一章][概述]

Data Distribute Service,数据分发服务:数据分发服务(DDS™)是一个由对象管理组(OMG)发布的以数据为中心的中间件协议和API标准。DDS集成系统中的各个组件,提供低延迟数据连接、高可靠性以及高可扩展体系结构,以适应商业级物联网(IoT)应用程序的需求。

qq_41816308的博客 1152

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

上一篇: 字节每日一题
Crescent_P
博客等级 码龄7年 227粉丝 87原创
评论 18
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
