模型评测新范式:多源文档解析创新评测框架OmniDocBench

TeleOCR:1.2B开源文档解析模型,登顶OmniDocBench的实战解析 传统OCR只能识别文字,却难以理解版面顺序、表格结构和公式语义,文档解析一直依赖重成本的多模态大模型。随着开源模型的进化,端侧轻量部署成为可能。文档解析的核心在于同时完成文字识别、版面还原与结构生成,这要求模型具备视觉与语言联合理解能力。TeleOCR采用视觉编码器加语言解码器的标准范式,将整页文档动态切块处理,直接输出结构化Markdown,有效解决了多栏、复杂表格和公式识别的痛点。仅1.2B参数即可在消费级显卡上运行,甚至支持CPU量化推理,同时允许通过LoRA微调适配垂直场景。这一模型已登顶OmniD 阅读详情

项目主页:https://github.com/opendatalab/OmniDocBench

Hugging Face:https://huggingface.co/datasets/opendatalab/OmniDocBench

论文:https://arxiv.org/abs/2412.07626
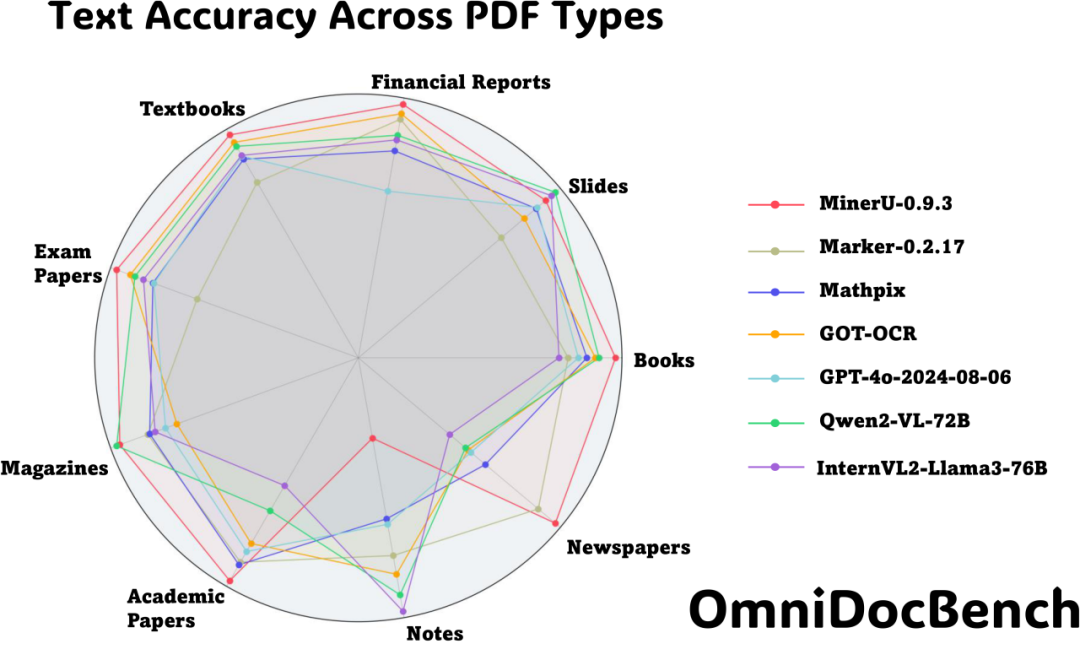
不同模型多种文本类型在OmniDocBench上的表现

不同模型多种文本类型在OmniDocBench上的表现

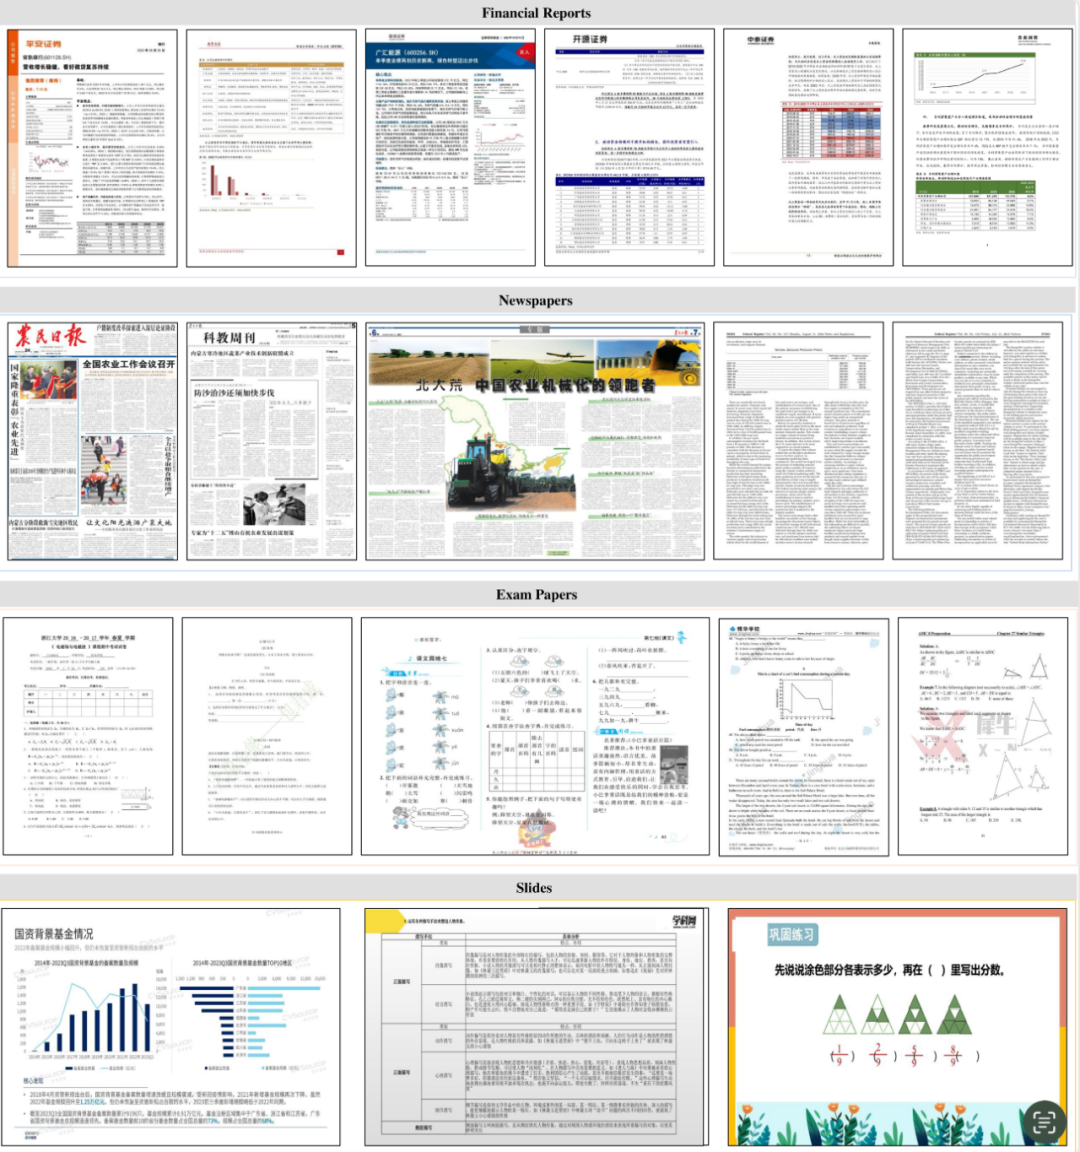
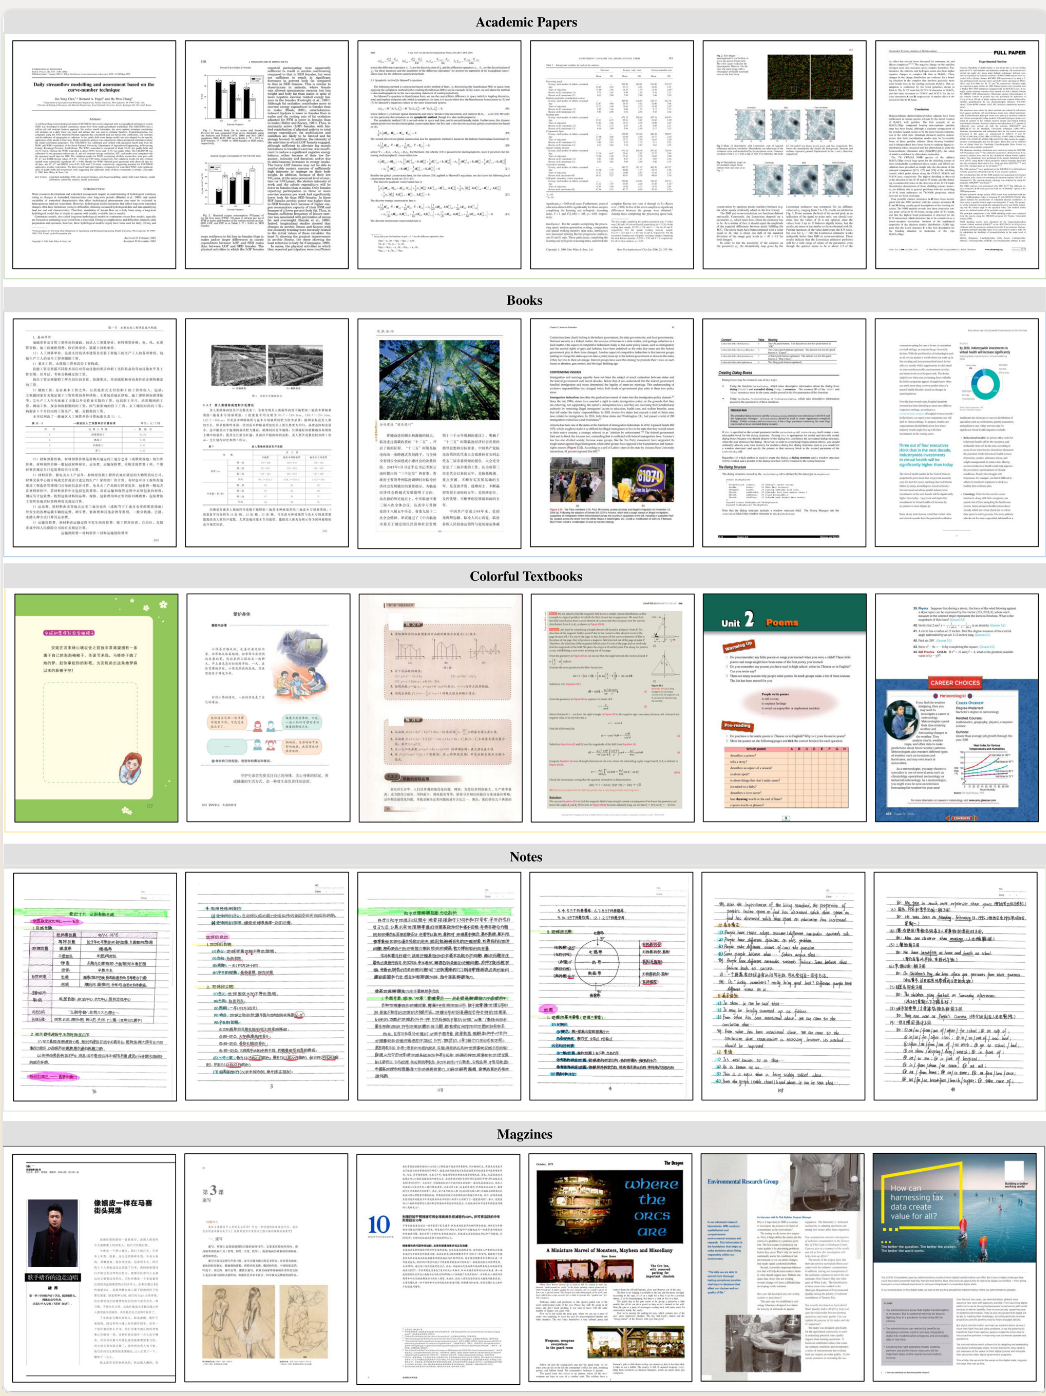
文档内容提取作为计算机视觉的基础任务之一,在大语言模型训练数据获取和检索增强生成等技术中发挥着关键作用,然而我们发现LLM大量使用了论文期刊的数据,但是报纸、杂志等同样高质量但排版复杂的文件没有得到很好的利用。基于这一需求背景,上海人工智能实验室与2077AI等多家机构共同开源的OmniDocBench项目,通过构建覆盖九大类型 (学术论文、教科书、考试试卷、杂志、书籍、笔记、财报、报纸、幻灯片)的多源文档解析评测基准,成功解决了现有评测体系在文档类型多样性和评估维度完整性方面的不足。这一创新性的评测框架不仅为文档解析技术的发展提供了可靠的评估标准,更开创了文档智能评测的新范式。
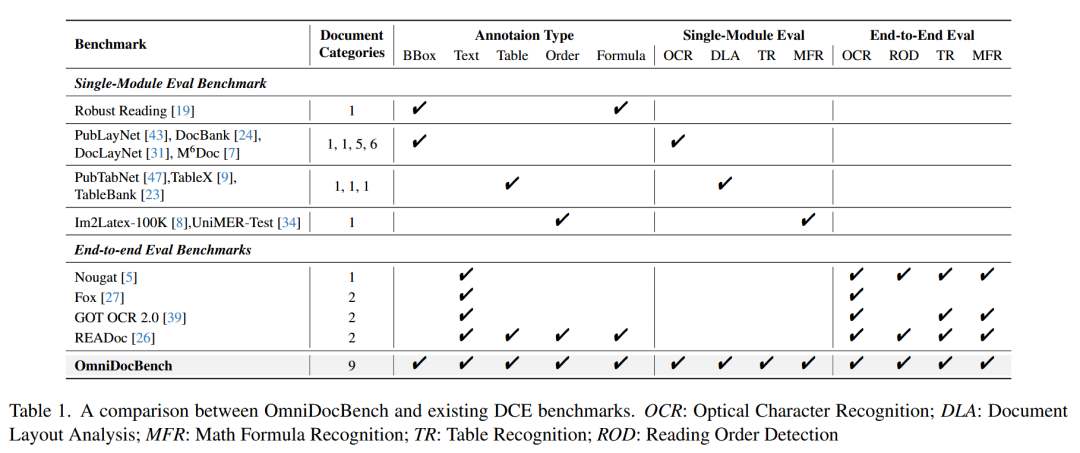
图片

相关工作对比

深度解构与重构:全维度评测体系的精密设计

OmniDocBench通过系统化的数据构建流程开创了文档解析评测的新范式。

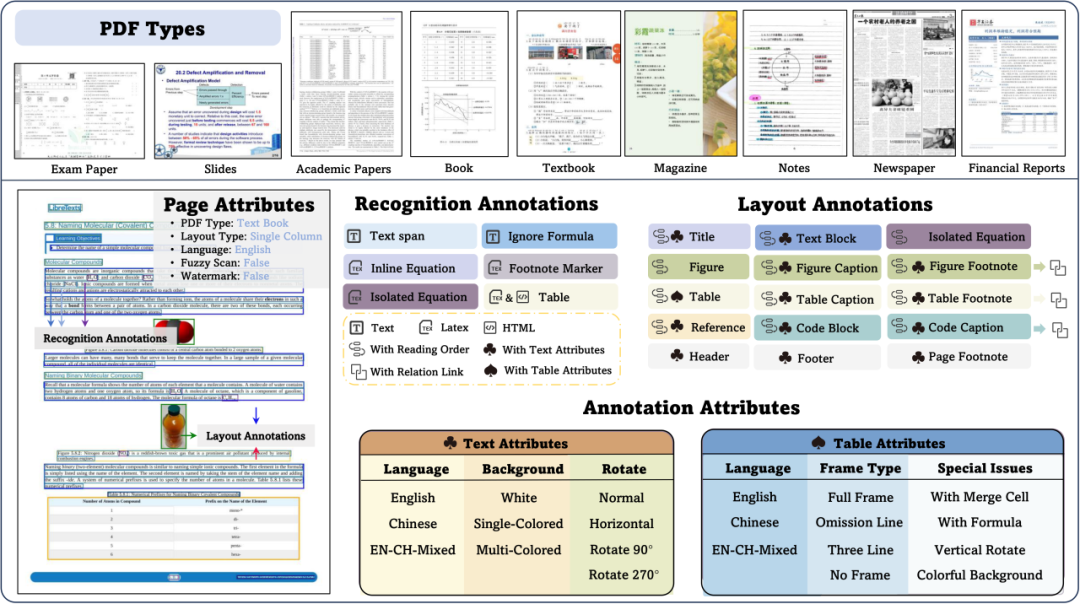
在数据获取阶段,项目团队从20万份初始PDF文档入手,运用ResNet-50与Faiss聚类采样出6000页数据,保证分布的合理且丰富,能够用最有"代表性"的数据构建评测数据集。这些页面经过专业标注人员的属性标注,最终经过严格筛选和平衡,形成了包含981页高质量样本的评测数据集,涵盖了从学术论文到考试试卷等九大类文档类型。
图片

OmniDocBench类型与标注信息概览

图片

图片

OmniDocBench涵盖的九大文本类型一览

在标注体系的设计上,OmniDocBench构建了一个前所未有的多层级标注框架。在布局检测层面,项目不仅完成了19种区域类型的边界框标注,还创新性地引入了布局属性标注、阅读顺序标注和从属关系标注。这种立体化的标注体系使得数据集能够全面评估模型在不同场景下的表现。特别是在内容识别标注方面,针对不同类型的内容区域采用了差异化的标注策略:纯文本内容采用直接文本标注,公式内容使用LaTeX格式标注,而表格则同时提供HTML和LaTeX两种格式的标注,确保了评测的全面性和准确性。

为确保标注质量,OmniDocBench实施了一套严密的三重质控机制。首先利用先进的人工智能模型进行智能预标注,包括使用微调后的LayoutLMv3进行布局检测,以及采用PaddleOCR、UniMERNet和GPT-4o分别处理文本、公式和表格的识别。随后,专业的标注团队对预标注结果进行全面校正,不仅精细化修正每个检测框,还补充了阅读顺序和从属关系的标注。在最后的专家质检环节,项目创新性地引入CDM渲染技术识别不可渲染元素,并由三位领域专家进行最终审核,确保了数据集的极致可靠性。

创新评估方法与深度性能分析

创新性和系统性是OmniDocBench的评估框架突出优势。

在提取模块中,项目设计了一套完整的处理流程,从预处理开始就注重细节的标准化,包括移除图片、规范化markdown标签等基础工作。在特殊组件提取方面,采用了精心设计的提取顺序,确保不同类型的内容能够准确识别和提取。特别是在行内公式的处理上,创新性地采用统一的Unicode格式转换方案,解决了不同模型输出格式不一致的问题。
图片

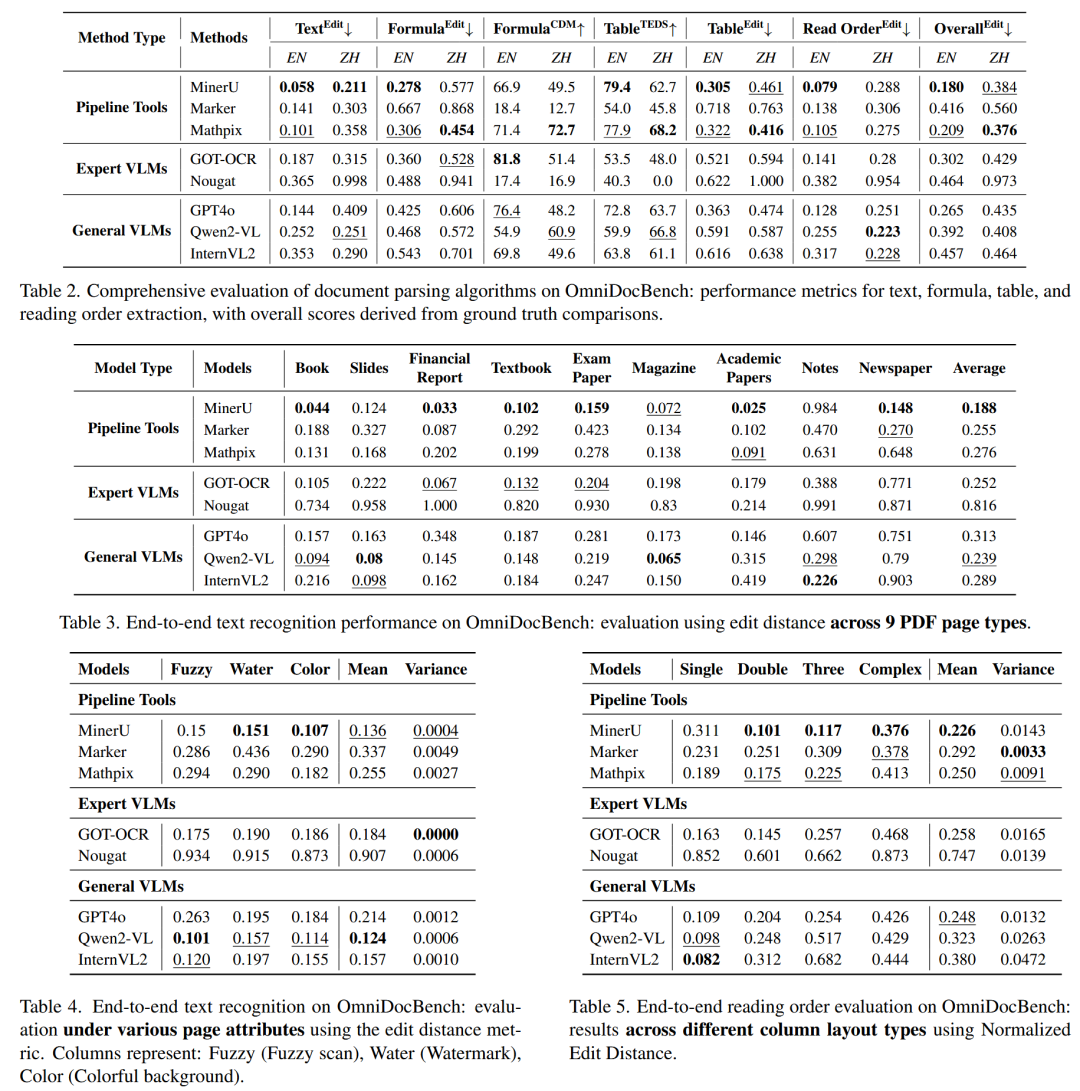
基于 OmniDocBench 对多种文档解析和识别方法的性能评估

在实际评测中,OmniDocBench展现出了优秀的模型区分能力。在具体任务上,不同模型展现出各自的优势:DocLayout-YOLO在多样化文档的布局检测中表现突出,RapidTable在表格识别的语言适应性方面独树一帜,而PaddleOCR则在传统OCR任务中保持领先地位。特别是在公式识别这一极具挑战性的任务中,GPT-4o、Mathpix和UniMERNet三个模型在CDM指标上的优异表现,展示了当前技术在特定领域的突破性进展。

作为开源社区的重要成员,2077AI深度参与了OmniDocBench项目的开发过程,在数据集构建、评测框架设计和结果验证等多个环节做出了重要贡献。未来,OmniDocBench将继续扩展其评测维度和应用场景。通过引入参数化规则生成、深化推理层次评估等创新方法,进一步提升评测体系的完备性。同时,随着多模态评测能力的发展,OmniDocBench有望在更广泛的领域发挥其评估价值。2077AI将继续携手开源社区,推动文档智能技术的进步,为构建更强大的人工智能系统贡献力量。
图片

整数智能,人工智能行业的数据合伙人。

BambuStudio学习笔记:GCode 类 关键成员解析 核心配置组件 状态跟踪系统 功能模块集成 核心方法剖析 主输出管道 实现多阶段处理: 分层处理流程: 实现智能路径规划: 关键特性: 实现模板故障检测: 采用三级流水线: 支持扩展类型: 实现多通道输出: 采用: 实现: 支持: 支持模块化编译: 典型流程: 实现功能: 阅读详情

相关推荐

无人机开发平台全解析:从开源飞控到企业级应用实战指南

无人机开发平台是无人机从飞行器演变为智能空中机器人的核心,其本质是提供了一套标准化的软硬件接口与工具链,使开发者能够基于稳定可靠的底层系统,专注于上层应用创新。从技术原理上看,一个完整的开发平台通常包含飞行控制器、机载计算机、传感器套件等硬件层,以及飞控固件、机器人操作系统(ROS/ROS 2)、软件开发套件(SDK)等软件层,通过分层架构实现飞行控制、感知决策与任务执行的解耦。其技术价值在于大幅降低了无人机行业应用的开发门槛,使开发者无需从零构建飞行控制系统,即可快速实现自动巡检、精准农业、物流配送等复杂

weixin_28712491的博客 412

OmniDocBench:一键评测PDF解析算法

OmniDocBench应该是目前类型最丰富、标注粒度最详细的PDF解析评测数据集了,对于评估PDF解析算法,意义重大。最新的PP-StructureV3简介 - PaddleOCR 文档便给出了在OmniDocBench上的评测对比,可以详细看看。但是,某个算法想利用该benchmark来评测结果时,需要注意数据泄露的风险,尽量避免用该benchmark里的数据进行训练。

Jamence的博客 2990

FMCW雷达基本原理(通俗易懂)篇2

FMCW雷达(Frequency Modulated Continuous Wave Radar)是一种使用频率调制连续波的雷达系统。它使用一个发射器发射一个连续波,但是这个连续波的频率会在一定的范围内不断变化。当这个连续波遇到一个目标物体并被反射回来时,接收器会检测到这个反射波的频率变化,并计算出目标物体的距离和速度等信息。FMCW雷达的原理可以理解为:1.发射器发射一个连续波,这个波的频率会从一个固定的起始频率开始,逐渐变化至一个固定的终止频率。

研二小学鸡的博客 7690

CVPR 2025|OmniDocBench:PDF解析能力维度的指南针,让文档解析评测更全面、更精细

从多个来源搜集了近20万个PDF,在这批数据中做了采样和聚类,筛选了6000张PDF页面,对这批数据做了页面级别的类别标签标注(包括PDF类型、布局、语种、页面特殊情况等),然后在这个标注基础上做了一个均衡采样,并且人工检查去除了敏感数据,最终筛选出了981张多样化的PDF页面,覆盖了9类文档来源的高质量标注数据,包括学术论文、教材等基础类型,以及手写笔记、密排报纸等高挑战性样本。相关的技术和工具正在蓬勃发展,引起了较多的关注,但是现有的文档解析方法在多样性和评测全面性上还存在较多局限性。

OpenDataLab的博客 2399

TC397 EB配置ADC软件触发:从零实现周期采样与中断处理

本文详细介绍了如何在Infineon AURIX TC397芯片上使用EB Tresos工具配置ADC软件触发,实现周期采样与中断处理。通过硬件连接、EB模块配置、代码初始化及数据处理的全流程解析,帮助开发者快速掌握ADC软件触发技术,提升嵌入式系统开发效率。

root9的博客 231

别再只用LSTM了!用Temporal Fusion Transformer (TFT) 搞定多变量时序预测,附PyTorch实战代码

本文介绍了Temporal Fusion Transformer (TFT) 在多变量时序预测中的优势,并提供了PyTorch实战代码。TFT通过三重注意力机制解决了LSTM在特征交互、静态特征处理和解释性方面的不足,显著提升了预测精度和可解释性。文章详细讲解了TFT的核心组件构建、数据预处理、模型训练技巧及可解释性分析,帮助开发者快速掌握这一先进时序预测技术。

weixin_33712987的博客 279

OmniDocBench:全面文档解析评估基准

OmniDocBench 是一个用于评估现实场景中多样化文档解析性能的基准测试工具。它包含了丰富的文档类型、布局和语言,旨在为文档解析领域的研究提供全面的评估标准和数据集。OmniDocBench 的核心功能在于其多样性和广泛的适用性,使得它成为文档解析领域的一个重要参考。 ## 项目技术分析 OmniDocBench 的技术架构体现了现代数据处理和机器学习的先进性。它包含了以下关键特点:

gitblog_00511的博客 1613

Eclipse 数据空间组件(EDC)项目介绍

在当今数字经济的背景下,数据成为了新的“石油”。但与石油不同的是,数据可以无限共享且再生。然而,如何在保持数据主权的前提下实现高效、安全的数据共享,成为了企业和组织面临的主要挑战。这时,**Eclipse 数据空间组件(Eclipse Dataspace Components, EDC)**应运而生,它为企业在多方参与的数据交换中提供了一个标准化、可扩展的解决方案。数据空间不仅是一个多组织间的数据共享协议,还是一套支撑这些协议运行的技术基础设施。

m0_74331272的博客 4599

DocBench:面向大模型文档阅读系统的评估基准与数据集分析

DocBench是由研究团队于2024年提出的首个针对大模型文档阅读系统(LLM-based Document Reading Systems)的专用评估基准。其核心目标是解决传统基准在真实文档交互场景中的不足——现有基准多聚焦简单阅读理解,而无法评估系统在用户上传自定义文档并提问的全流程能力(如文档解析、多模态理解、长文本推理等)。该数据集填补了“原始文档输入-问题响应输出”这一关键评估场景的空白。原始论文信息发布日期:2024年论文地址本文由「大千AI助手」原创发布,专注用真话讲AI,回归技术本质。

拒绝AI玄学,只聊真技术▲ 1527

淘系商品的成长密码:历史与趋势透视

本文分析了淘系商品的发展历程,从早期的市场探索到如今的行业领先地位,深入探讨了技术创新、供应链优化、用户需求洞察等关键因素在淘系商品成功中的作用。通过对平台不断完善商品生态、提升购物体验和服务的过程分析,文章总结了淘系商品在竞争激烈的市场中如何通过创新应对挑战并推动电商行业的进步。未来,随着消费趋势变化和新兴模式的兴起,淘系商品将在更大范围内发挥其市场影响力。

曾经“等你生日那天”都遥远得像未来,如今却可欢愉的挥手说“下个十年见” 6万+

windows使用jupyter notebook读取文件路径的几种方法和设置默认打开路径

简单分享小虎这段时间以来学到的jupyter notebook操作技巧。

狂小虎/Anthony Dave的博客 KuangXiaoHu's Blogs 1万+

OmniBench公式评估总结

与处理文本或表格不同,在OmniDocBench中评测公式识别性能,核心在于理解其“合二为一”的数据输入要求——即必须创建一个合并了GT和Pred的专用文件,并使用正确的配置触发CDM专项评估。

bai200的博客 384

时空智友企业信息管理系统任意文件读取漏洞复现

时空智友企业信息管理系统是一个用于企业流程管理和控制的软件系统。它旨在帮助企业实现流程的规范化、自动化和优化,从而提高工作效率、降低成本并提升管理水平。时空智友企业信息管理系统存在任意文件读取漏洞,攻击者可以在未授权的情况下读取系统上的文件。没有人规定,一朵花一定要成长为向日葵或者玫瑰。

The current road is different, love needs to distinguish between right and wrong 970

OmniDocBench:文档智能的端到端压力测试框架

文档智能(Document AI)是OCR、版面分析与结构化理解的融合技术,其核心挑战在于真实场景下的鲁棒性与工程可用性。传统评测仅关注字符识别精度(CER),忽视文档结构理解、图像失真鲁棒性及服务级效率边界。OmniDocBench 作为新一代基准框架,以端到端压力测试为范式,系统量化识别精度、结构理解能力、鲁棒性与效率边界四大维度,覆盖手机拍摄、扫描畸变、PDF混合渲染、高并发服务等典型产线故障模式。它不替代基础OCR模型选型,而是提供可复现、可归因、可压测的决策依据,特别适用于金融票据、医疗报告、政务

weixin_29050513的博客 217

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

HPD-Parsing性能实测:4752 TPS吞吐量碾压同类模型,OmniDocBench权威数据解读

飞桨PaddlePaddle / HPD-Parsing是一款轻量级(1B参数)且高吞吐量的文档解析模型,基于分层并行解码范式构建,在OmniDocBench v1.6权威评测中展现出卓越性能。 ### 🚀 突破性吞吐量:4752 TPS的行业标杆 HPD-Parsing在OmniDocBench v1.6上实现了**4,752 Tokens Per Second (TPS)** 的峰值吞吐

gitblog_00519的博客 257

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

OmniDocBench 93.12分!百度千帆发布端到端文档智能模型Qianfan-OCR

通过统一的端到端视觉语言模型,系统可以直接从文档图像生成结构化结果,跳过传统的多阶段拆分流程,实现从“看见文档”到“理解文档”的一步完成。Qianfan-OCR的发布,不仅是一次模型能力的升级,更体现了文档处理技术路径的演进:从多模型拼接的流程式架构走向统一建模的端到端范式。4B参数规模实现了对文档解析、版面分析、文字识别与语义理解的全面融合,在多项权威评测中取得领先表现,标志着文档智能能力正从“流程拼接”迈向“模型统一”的新阶段。进一步来看,在图表理解等复杂任务中,端到端模型的优势更加明显。

百度智能云 563

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

17亿参数VLM模型颠覆文档解析:小红书DOTS.OCR开源技术深度解析

# 17亿参数VLM模型颠覆文档解析:小红书DOTS.OCR开源技术深度解析 ## 导语 小红书旗下人工智能实验室(Hi Lab)开源的多语言文档布局解析模型DOTS.OCR,以17亿参数的轻量化设计实现了业界领先的文档处理能力,重新定义了小模型的性能边界。 ## 行业现状 全球智能文档处理(IDP)市场正以惊人速度扩张。据Fortune Business Insights数据,该市场规模预计

gitblog_00150的博客 893

如何深度评估MonkeyOCR文档解析模型:全面性能评测与实战指南

MonkeyOCR是一款基于结构-识别-关系三元组范式的轻量级多模态文档解析模型,专为处理复杂文档结构而设计。在OCR技术快速发展的今天,了解如何正确评估文档解析模型的性能对于开发者和技术决策者至关重要。本文将为您提供完整的MonkeyOCR模型性能评估指南,涵盖基准测试方法、评估指标详解以及实用评估技巧。 ## 📊 MonkeyOCR性能评估的核心维度 ### 多模态文档解析准确率 Mon

gitblog_00012的博客 671

文档解析工具汇总

路线代表工具核心特点端到端 VLM单模型统一处理,精度高,部署简轻量级专用<1B 参数,边缘部署友好商业 API精度高,按量付费,延迟可控HTML 提取面向网页和 Common Crawl 场景传统流水线成熟稳定,可控性强Agentic 感知分辨率自适应,服务下游 Agent多模态统一文档+图像+音频+视频统一解析格式转换跨格式标准化输出当前趋势清晰:端到端 VLM 正在取代传统流水线成为主流,但轻量级模型(<1B)和商业 API 在特定场景仍有不可替代的优势;

weixin_37763484的博客 407

TeleOCR 端到端文档解析:从 OmniDocBench 榜首到工程落地实践

OCR 技术正从传统两段式检测识别向端到端文档解析演进,核心在于视觉-语言联合建模与版面感知注意力机制,实现阅读顺序还原、表格结构识别和公式提取。这种结构化输出能力在合同字段抽取、财务报表解析、问卷拍照识别等场景中显著降低后处理成本,尤其适合数据敏感的内网部署和长文档批量处理。TeleOCR 在 OmniDocBench 综合榜单登顶,正是凭借整条文档解析链路的稳定性,而非单点识别精度。

weixin_27872611的博客 229

端到端文档解析模型解析:从OCR到结构化输出的技术范式与落地实践

传统OCR解决的核心问题是把图像中的文字转换为可编辑文本,但真实业务往往需要更进一步的版面结构还原。端到端生成式模型将版面分析、文字识别、表格还原、公式输出等步骤统一进一个网络,以“图像进、结构化文本出”的方式替代多模型级联管线,从机制上缓解了级联误差,并显著降低部署与运维成本。该范式让文档解析从“识字”进化为“看懂版面”,为RAG知识库构建、票据结构化录入、PDF转Markdown等高频场景提供了更稳定的技术底座。OmniDocBench等评测基准的出现,则让开源模型的综合能力有了可量化的参照。TeleO

weixin_30694389的博客 166

DeepSeek-OCR-2性能评测:256视觉Token下达到91.09% OmniDocBench得分

本文介绍了如何在星图GPU平台上自动化部署DeepSeek-OCR-2镜像,实现高精度文档理解与结构化提取。该镜像支持PDF合同、财报、论文等复杂文档的智能OCR处理,可准确识别表格结构、数学公式及多语言混排内容,并一键导出Markdown、Excel等格式,显著提升法务、科研与内容处理效率。

weixin_42509720的博客 487

开源模型新标杆:DeepSeek-OCR-2架构设计解析

本文介绍了如何在星图GPU平台上自动化部署📄 DeepSeek-OCR-2 智能文档解析工具镜像,实现高精度、语义感知的文档理解。该镜像可精准还原多栏学术论文、带脚注的法律合同及含公式表格的财务报告,显著提升OCR结果在RAG知识库构建中的可用性。

weixin_42577735的博客 232

2025文档解析革命:PaddleOCR-VL以0.9B参数重构多语言智能处理范式

# 2025文档解析革命:PaddleOCR-VL以0.9B参数重构多语言智能处理范式 ## 导语:轻量级模型引爆文档解析效率革命 2025年10月,百度飞桨团队正式发布PaddleOCR-VL,这款仅0.9B参数的视觉语言模型(VLM)在OmniDocBench权威评测中,以表格解析TEDS指标92.3%、109种语言支持能力,重新定义了文档智能处理的效率标准。与传统多模态大模型相比,其资源

gitblog_00598的博客 914

文档解析新标杆PaddleOCR-VL|两阶段架构如何实现精度与速度双赢

本文介绍了基于星图GPU平台自动化部署PaddleOCR-VL-WEB镜像的高效方案。该平台支持一键启动与快速配置,实现文档解析模型的即时运行。PaddleOCR-VL凭借两阶段架构,在文本识别、表格理解与公式解析等任务中表现卓越,适用于多语言文档数字化、智能表单处理等AI应用开发场景,助力企业高效构建自动化办公系统。

weixin_42443533的博客 1001

从字符识别到结构还原:OmniDocBench 重新定义文档解析评测

传统 OCR 评测往往聚焦字符识别准确率,但在真实业务中,文档解析的核心价值在于版面结构、阅读顺序、表格行列关系与公式层级能否被完整还原。OmniDocBench 作为一套面向文档解析的标准化基准,将 Markdown/HTML 结构化标注与 MTP、MTR、BLEU 等指标结合,统一了开源模型、端到端大模型与闭源 API 的评测口径。通过版面分析、表格识别、阅读顺序等多维度评分,工程师能够更科学地对比 PaddleOCR-VL、Qwen2.5-VL 与商业模型的能力差异。本文从评测原理、环境搭建到结果拆解

weixin_42628941的博客 308
上一篇: 自动驾驶数据革命:半自动Occupancy标注如何定义3D感知新时代
下一篇: 最全Agent开源数据集分享系列一
整数智能
博客等级 码龄2年 215粉丝 19原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值