最全具身智能数据集分享系列二 | 视觉语言动作(VLA)多模态模型数据集

VLA模型(具身智能入门十) Vision Language Action(VLA)模型VLA模型是机器人领域的“感知-理解-执行”一体化框架,通过Transformer架构融合视觉、语言、动作模态,核心目标是让机器人在自然语言驱动下,自主完成复杂操控任务。其定义的核心在于“跨模态统一”与“具象化行动”——不仅能“看懂”“听懂”,更能“做出正确的动作”,是实现通用机器人智能的关键方向。提供通用序列建模骨架,让视觉、语言、动作能以“序列”形式统一处理;ViT将视觉输入转换为序列特征,提供“看”的能力;LLMs。 阅读详情
AI摘要

2023年Google DeepMind推出RT - 2这一VLA模型,VLA是处理多模态输入的模型,用于应对具身智能中的指令跟随任务。数据集对具身智能训练效果至关重要,但采集和标注成本高。本文汇总了RoboNet、BridgeData V2等多个VLA开源训练数据集,方便研究选取。

1. VLA是什么

2023年7月28日,Google DeepMind推出了Robotic Transformer 2(RT-2),这是一种创新的视觉-语言-动作(Vision-Language-Action, VLA)模型,能够从网络和机器人数据中学习,并将所学知识转化为通用的机器人控制指令。VLA是一种多模态模型,其中一些专注于通过预训练来提升特定组件的性能,而其他模型则致力于开发能够预测低级动作的控制策略。某些VLA模型则充当高级任务规划器,能够将复杂的长期任务分解为可执行的子任务。在过去几年中,众多VLA模型的出现反映了具身智能的迅速发展。


VLA是一类专门设计用于处理多模态输入的模型,通过结合视觉和语言处理,VLA 模型可以解释复杂的指令并在物理世界中执行动作。VLA模型的开发旨在应对具身智能中的指令跟随任务。与以ChatGPT为代表的聊天AI不同,具身智能需要控制物理实体并与环境进行互动,机器人是这一领域的典型应用。在语言驱动的机器人任务中,策略必须具备理解语言指令、感知视觉环境并生成适当动作的能力,这正是VLA多模态能力的体现。与早期的深度强化学习方法相比,基于VLA的策略在复杂环境中展现出更强的多样性、灵活性和泛化能力,使其不仅适用于工厂等受控环境,也适合日常生活中的任务。

得益于预训练的视觉基础模型、大语言模型(LLMs)和视觉-语言模型(VLMs)的成功,VLA模型在应对这些挑战方面展现了其潜力。最新的视觉编码器提供的预训练视觉表征,使得VLA模型在感知复杂环境时能够更准确地估计目标类别、姿态和几何形状。随着语言模型能力的提升,基于语言指令的任务规范也变得可行。基础VLMs探索了多种将视觉模型与语言模型整合的方法,如BLIP-2和Flamingo等,这些不同领域的创新为VLA模型解决具身智能的挑战提供了强有力的支持。
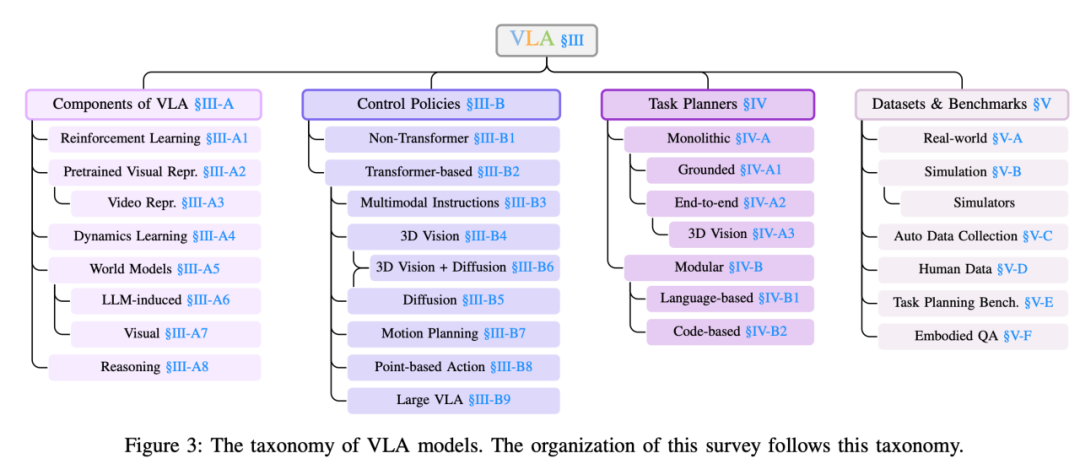
VLA模型的分类(https://arxiv.org/pdf/2405.14093)

VLA模型通常是通过大规模的真实世界机器人演示数据集进行监督式学习或者半监督学习。此外,还可以结合模拟环境下的强化学习来进一步提升模型的表现力。在训练过程中,研究人员会采用各种正则化技术和优化算法(如Adam优化器)以防止过拟合,并加速收敛速度。因此数据集对于具身智能的训练效果有着至关重要的影响,提高训练效果的根源在于使用丰富多样的数据集,如由斯坦福大学、加州大学伯克利分校、谷歌DeepMind以及丰田研究院联合开发的OpenVLA就使用了一个包含约97万个真实世界机器人演示的数据集来进行训练。然而,数据集的数据采集过程复杂且成本高昂,数据标注工作往往需要专业知识和大量的人工劳动。本期整数干货就为大家汇总了一些VLA训练数据集,方便大家选取适合的开展研究。


2. VLA开源数据集有哪些


2.1. RoboNet

  • 发布方:UC Berkeley; Stanford University; University of Pennsylvania; CMU

  • 下载地址:https://github.com/SudeepDasari/RoboNet/wiki/Getting-Started

  • 简介:一个用于共享机器人经验的开放数据库,它提供了来自 7 个不同机器人平台的 1500 万个视频帧的初始池,并研究了如何使用它来学习基于视觉的机器人操作的通用模型。
    

具身智能端到端大模型VLA (Vision Language Action) 在语言为条件的机器人任务中,策略必须具备理解语言指令、视觉感知环境并生成适当动作的能力,这就需要VLA的。例如,在自动驾驶领域,传统的做法是将感知、预测、规划等步骤分开处理,而VLA则试图用一个统一的框架来替代这种分立的方法。另外,VLA的模型对于算力的需求很大,单片AI算力1000Tops的Thor大概率会延期发布,加上英伟达芯片的量产时间与成本挑战,以及在国内的应用情况,对车企而言是个大问题。以谷歌DeepMind推出的RT-2为例,该模型可以在新的物体、背景和环境中表现出显著改善的性能。 阅读详情

相关推荐

端到端自动驾驶大模型:视觉-语言-动作模型 VLA

随着视觉-语言-动作模型VLA的发展,感知和规划逐渐融合为一个模型,即端到端自动驾驶大模型。

AIgraphX 7331

VLM2VLA:用LoRA解耦实现抗遗忘的视觉语言动作模型

视觉语言动作模型(VLA)是具身智能的核心范式,其本质是将视觉理解与语言指令联合映射为可执行动作序列。传统方法依赖全参数微调,导致灾难性遗忘与任务间知识冲突;而基于LoRA的轻量适配机制,通过在Attention与FFN关键路径插入低秩模块,实现了感知能力与动作生成的功能解耦。这种架构不仅保障原始VLM的视觉语言理解零退化,更支持多任务LoRA模块热插拔、语义化动作token输出及跨平台迁移。本文聚焦普林斯顿VLM2VLA框架,解析其如何以不到0.011%的增量参数,根治机器人‘学了就忘’问题,并推动VLA

weixin_33688840的博客 992

从感知决策到具身智能的技术跃迁与挑战(基座模型与VLA模型)

本文剖析AI与机器人融合的技术跃迁:从深度学习视觉突破、AlphaGo决策验证,到ChatGPT催生机器人“通用大脑”范式转移。核心聚焦VLA模型(Vision-Language-Action)的端到端架构,解析其三层能力——LLM任务规划、VLM环境感知、神经动作生成(代表工作:RT系列、DoReMi)。对比两条路径:拼接现有LLM/VLM的快速方案 vs 训练机器人专用基座模型的深度方案,揭示数据稀缺、物理建模、安全控制三大瓶颈。提出通过世界模型、仿真引擎、人机协同突破限制,预判人形机器人将依托VLA架

1565

机器人的“看着办”:VLM与VLA如何打通视觉语言到动作执行的最后一公里

具身智能的落地,离不开视觉理解与动作执行的深度耦合。视觉语言模型(VLM)让机器人具备看懂场景、理解指令的能力,但真正完成抓取、移动等物理操作,还需视觉语言动作模型(VLA)将视觉、语言与连续动作统一建模。VLA通过把动作离散化为token,复用大语言模型的序列生成框架,实现从感知到控制的端到端输出,显著提升泛化能力与部署效率。这项技术正被广泛应用于机械臂分拣、移动操作等工业与科研场景。文章系统拆解了VLM与VLA的原理差异、主流模型演进路径、动作token化与数据训练的关键工程细节,并结合实践案例与避坑经

weixin_29053383的博客 266

VLA-Adapter:轻量视觉语言动作模型的工程落地指南

视觉语言动作模型(VLA)是具身智能的核心技术,其原理在于联合建模视觉感知、语言指令与机器人动作生成。随着大模型部署成本攀升,轻量化VLA成为工业界刚需——它并非简单压缩参数,而是通过桥接机制重构多模态信息流。VLA-Adapter以0.5B级骨干网络、动态ActionQuery编译器和Bridge Attention调控架构,实现高精度、低延迟、强泛化的端到端控制。该技术显著降低显存占用与推理延迟,支持消费级GPU训练部署,在机械臂抓取、零样本迁移等典型场景中验证了工程可行性。本文聚焦VLA-Adapte

weixin_34248023的博客 374

GeoVLA:面向具身智能的3D几何感知视觉语言动作模型

视觉语言动作模型(VLA)是具身智能的核心架构,其本质是将自然语言指令映射为机器人可执行的连续动作序列。传统VLA严重依赖RGB图像,受限于深度估计失真、遮挡与视角偏差等2D固有缺陷,难以支撑真实物理世界的鲁棒操作。GeoVLA提出‘几何与语义解耦’新范式,通过点云编码器(PEN)与扩散动作专家(3DAE)协同建模空间关系与任务语义,实现毫米级3D空间感知与动作生成的统一。该方案显著提升在LIBERO、ManiSkill2等基准及真实机械臂(如WidowX-250s)上的泛化性与抗干扰能力,尤其适用于需要精

weixin_29032489的博客 221

VLA大模型:视觉-语言-动作端到端具身智能算法解析

VLA(Visual-Language-Action)模型是具身智能的核心技术范式,旨在实现视觉感知、自然语言理解与机器人动作生成的统一建模。其原理基于多模态大模型的跨模态对齐与端到端联合优化,通过在海量图文数据上预训练、在具身交互数据上微调,赋予机器人理解指令并执行物理操作的能力。该技术显著提升机器人任务泛化性与部署效率,广泛应用于服务机器人、工业协作臂、家庭自动化等场景。作为连接AI大模型与真实物理世界的桥梁,VLA正推动机器人从‘专用编程’迈向‘自然对话驱动’的新阶段。

weixin_34007906的博客 460

Windows环境下DataEase一站式安装指南(含WSL2+Docker配置)

本文详细介绍了在Windows环境下通过WSL2和Docker快速部署DataEase的完整教程。从WSL2配置、Docker环境搭建到DataEase离线安装,逐步指导用户完成一站式部署,特别适合需要快速搭建数据分析平台的开发者。教程包含常见问题解决方案和性能优化技巧,帮助用户高效使用这款国产开源数据可视化工具。

weixin_42526166的博客 396

【零基础】手把手教你使用Docker部署Springboot项目(详细版)

还不会使用Docker部署Springboot项目的小伙伴,不妨进来看看呗,希望文中内容对你有所帮助!

fengprogrammer的博客 2万+

从CTFShow靶场实战,聊聊Node.js原型链污染漏洞的几种利用姿势(附详细复现步骤)

本文深入剖析Node.js原型链污染漏洞的原理与实战利用,通过复现CTFShow靶场题目(web338-web341),详细演示五种高级利用技巧,包括基础污染、多级污染、模板引擎RCE等,并提供防御方案与最佳实践,帮助开发者提升Web应用安全性。

weixin_30791095的博客 446

腾讯大佬总结的170道 python面试题

简述基于 TCP 协议的套接字通信流程。19.面向对象中`__new__` 和 `__init__` 区别。86. 解释 Python 中的`//`,`%`和`**`运算符。45.isinstance 的作用以及与 type()的区别。3. 简述下 Python 中的字符串、列表、元组和字典。143. 如何高效的找到 redis 中的某个 KEY。140. 如何保证 redis 中的数据都是热点数据。147. redis 中的 watch 的命令的作用。108. 简述 进程、线程、协程的区别以及应用场景。

AudiA6LV6的博客 488

投研必备工具:Wind(万得)数据库快速入门

Wind数据库对于金融从业者来说是必不可少的一个软件,本文主要介绍了股票和债券的信息查找,帮助后续对数据进行分析,开始学习吧!

weixin_56581108的博客 10万+

Python学习第32天:Web前端入门

本文介绍了Web前端开发三大核心技术:HTML、CSS和JavaScript。首先概述了HTML的发展历程和HTML5新特性,详细讲解了常用HTML标签如文本、列表、链接、图像、表格、表单等。其次介绍了CSS的基础语法、选择器、颜色字体设置、盒子模型和布局定位方法。最后简要提及JavaScript为网页添加交互功能的作用。文章为Python开发者提供了前端技术的基础知识,帮助理解网页的结构、样式和行为实现原理。

tigerhhzz的博客 1911

如何使用 SAP ABAP Development Tool 连接 SAP BTP 上的免费 ABAP 编程环境

在云端环境编写 ABAP 代码会遇到一些限制,比如你无法在云端 ABAP 编程环境进行发生在传统 SAPGUI 里的 Dynpro 和 Screen 编程。部分在 SAPGUI 里使用的 List 处理相关的关键字比如 WRITE,还有 CALL TRANSACTION 等代码,也无法在云端使用。 当然如果大家觉得上面提到的这些限制不会影响自己的 ABAP 学习,就可以继续本文的阅读,使用 ABAP Development Tool 登录云端的 ABAP 编程环境。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 1517

TI硬件笔试面试题型解析上

摘要: 本专栏聚焦大厂硬件笔试面试题解析,当前第14期以德州仪器(TI)为例,涵盖模拟电路与数字电路核心考点。模拟电路部分涉及最大功率传递定理、运放设计(虚短/虚断)、共模抑制比(CMRR)及高频PCB信号完整性;数字电路包括CMOS与TTL对比、建立/保持时间、竞争冒险消除、D触发器分频及“线与”逻辑实现。文章强调通过例题掌握解题方法与知识点,助力读者应对硬件工程岗位的笔试与面试挑战,附常见考点总结与实用建议。全文注重理论与实践结合,提供典型题型解析与设计思路。(150字)

启芯硬件的博客 951

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

上一篇: 大模型推理能力的数据基石:运筹学作为LLM训练数据的独特价值
下一篇: 最全具身智能数据集分享系列 | 全球有哪些高质量具身智能数据集(附下载链接)
整数智能
博客等级 码龄2年 215粉丝 19原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
