HDU1560 DNA sequence —— IDA*算法

HDU 1560 DNA sequence 【加深迭代dfs】【IDA*】 DNA sequence Time Limit: 15000/5000 MS (Java/Others)    Memory Limit: 32768/32768 K (Java/Others) Total Submission(s): 4172    Accepted Submission(s): 2005   Problem Description The twenty-first ce... 阅读详情

题目链接:http://acm.hdu.edu.cn/showproblem.php?pid=1560


DNA sequence

Time Limit: 15000/5000 MS (Java/Others)    Memory Limit: 32768/32768 K (Java/Others)
Total Submission(s): 2999    Accepted Submission(s): 1462


Problem Description
The twenty-first century is a biology-technology developing century. We know that a gene is made of DNA. The nucleotide bases from which DNA is built are A(adenine), C(cytosine), G(guanine), and T(thymine). Finding the longest common subsequence between DNA/Protein sequences is one of the basic problems in modern computational molecular biology. But this problem is a little different. Given several DNA sequences, you are asked to make a shortest sequence from them so that each of the given sequence is the subsequence of it.

For example, given "ACGT","ATGC","CGTT" and "CAGT", you can make a sequence in the following way. It is the shortest but may be not the only one.
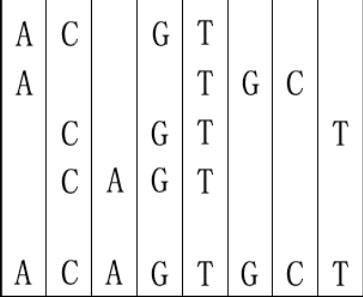
 

Input
The first line is the test case number t. Then t test cases follow. In each case, the first line is an integer n ( 1<=n<=8 ) represents number of the DNA sequences. The following k lines contain the k sequences, one per line. Assuming that the length of any sequence is between 1 and 5.
 

Output
For each test case, print a line containing the length of the shortest sequence that can be made from these sequences.
 

Sample Input
  
1 4 ACGT ATGC CGTT CAGT
 

Sample Output
  
8
 

Author
LL
 

Source


题解:

一开始以为是直接用回溯的方法,结果TLE。看了题解是用IDA*(迭代加深搜),其实自己不太了解迭代加深搜为什么比较快,而且什么时候用合适?下面是自己对迭代加深搜的一些浅薄的了解:

1.首先迭代加深搜适合用在:求最少步数(带有BFS的特点)并且不太容易估计搜索深度的问题上,同时兼有了BFS求最少步数和DFS易写、无需多开数组的特点。

2.相对于赤裸裸的回溯,迭代加深搜由于限制了搜索深度,所以也能适当地剪枝。

3.我编不下去了……


代码如下:

#include <iostream>
#include <cstdio>
#include <cstring>
#include <cmath>
#include <algorithm>
#include <vector>
#include <queue>
#include <stack>
#include <map>
#include <string>
#include <set>
#define ms(a,b) memset((a),(b),sizeof((a)))
using namespace std;
typedef long long LL;
const int INF = 2e9;
const LL LNF = 9e18;
const int MOD = 1e9+7;
const int MAXN = 10+10;

int n;
char dna[MAXN][MAXN];
int len[MAXN], pos[MAXN];
char s[4] = {'A', 'G', 'C', 'T'};

bool dfs(int k, int limit)  //k为放了几个, k+1才为当前要放的
{
    int maxx = 0, cnt = 0;  //maxx为最长剩余的dna片段, cnt为剩余的片段之和(核苷酸链?好怀念啊)
    for(int i = 0; i<n; i++)
    {
        cnt += len[i]-pos[i];
        maxx = max(maxx, len[i]-pos[i]);
    }
    if(cnt==0) return true;    //如果片段都放完,则已得到答案
    if(cnt<=limit-k) return true;   //剪枝:片段之和小于等于剩余能放数量,肯定能够得到答案
    if(maxx>limit-k) return false;  //剪枝:最小的估计值都大于剩余能放数量,肯定不能得到答案

    int tmp[MAXN];
    for(int i = 0; i<4; i++)
    {
        memcpy(tmp, pos, sizeof(tmp));
        bool flag = false;
        for(int j = 0; j<n; j++)
            if(dna[j][pos[j]]==s[i])
                pos[j]++, flag = true;

        //k+1<=limit:在限制范围内
        if(k+1<=limit && flag && dfs(k+1, limit) )
            return true;
        memcpy(pos, tmp, sizeof(pos));
    }
    return false;
}

int main()
{
    int T;
    scanf("%d",&T);
    while(T--)
    {
        scanf("%d",&n);
        int limit = 0;
        for(int i = 0; i<n; i++)
        {
            scanf("%s",dna[i]);
            len[i] = strlen(dna[i]);
            limit = max(limit, len[i]);
        }

        ms(pos, 0);
        while(!dfs(0, limit))
            limit++;
        printf("%d\n", limit);
    }
}



代码二:

#include <iostream>
#include <cstdio>
#include <cstring>
#include <cmath>
#include <algorithm>
#include <vector>
#include <queue>
#include <stack>
#include <map>
#include <string>
#include <set>
#define ms(a,b) memset((a),(b),sizeof((a)))
using namespace std;
typedef long long LL;
const int INF = 2e9;
const LL LNF = 9e18;
const int MOD = 1e9+7;
const int MAXN = 10+10;

int n;
char dna[MAXN][MAXN];
int len[MAXN], pos[MAXN];
char s[4] = {'A', 'G', 'C', 'T'};

bool dfs(int k, int limit)  //k为放了几个, k+1才为当前要放的
{
    if(k>limit) return false;

    int maxx = 0, cnt = 0;  //maxx为最长剩余的dna片段, cnt为剩余的片段之和(核苷酸链?好怀念啊)
    for(int i = 0; i<n; i++)
    {
        cnt += len[i]-pos[i];
        maxx = max(maxx, len[i]-pos[i]);
    }
    if(cnt==0) return true;    //如果片段都放完,则已得到答案
    if(cnt<=limit-k) return true;   //剪枝:片段之和小于等于剩余能放数量,肯定能够得到答案
    if(maxx>limit-k) return false;  //剪枝:最小的估计值都大于剩余能放数量,肯定不能得到答案

    int tmp[MAXN];
    for(int i = 0; i<4; i++)
    {
        memcpy(tmp, pos, sizeof(tmp));
        bool flag = false;
        for(int j = 0; j<n; j++)
            if(dna[j][pos[j]]==s[i])
                pos[j]++, flag = true;

        if(flag && dfs(k+1, limit) )
            return true;
        memcpy(pos, tmp, sizeof(pos));
    }
    return false;
}

int main()
{
    int T;
    scanf("%d",&T);
    while(T--)
    {
        scanf("%d",&n);
        int limit = 0;
        for(int i = 0; i<n; i++)
        {
            scanf("%s",dna[i]);
            len[i] = strlen(dna[i]);
            limit = max(limit, len[i]);
        }

        ms(pos, 0);
        while(!dfs(0, limit))
            limit++;
        printf("%d\n", limit);
    }
}


Android安全支付(1)-整体架构-keymint (1)接口定义hardware/interfaces/security/keymint/aidl/android/hardware/security/keymint/IKeyMintDevice.aidl。keymint是keymaster v4之后的替代设计。所以android 15上最好采用keymint的接口进行硬件功能的对接。同时,我们会集成一款紫光的芯片。3.可以用keyStore.getKey()来获取存储在keyStore中的数据进行加密和解密。四、关于keymint的接口定义和具体实现。 阅读详情

相关推荐

零中频架构实战:用Matlab模拟AD9361收发信号(附完整代码)

本文详细介绍了如何使用Matlab模拟AD9361射频收发器的零中频架构,解决镜像干扰等关键挑战。通过完整的代码示例和系统级建模方法,帮助工程师掌握RFIC设计中的自适应校准算法和性能优化技巧,特别适用于SDR系统开发。

weixin_30733003的博客 542

C1. Increasing Subsequence (easy version)

put contains one integer n (1≤n≤2⋅105) — the number of elements in a. The second line of the input contains n integers a1,a2,…,an (1≤ai≤n), where ai is the i-th element of a. All these integers are pa...

轻舟载君不载愁 515

西门子PLC作为TCP客户端通信:TSEND_C/TRCV_C指令实战与状态机设计

在工业自动化与物联网系统中,TCP/IP通信是实现设备间数据交换的基础协议,其核心在于建立可靠的点对点连接与数据流传输。其工作原理基于客户端-服务器模型,通过三次握手建立连接,确保数据包的顺序与完整性。这项技术的工程价值在于打破了传统工控设备被动响应的局限,为实时数据主动上报、边缘计算集成提供了通用且灵活的解决方案。在工业物联网、设备远程监控、生产数据实时采集等场景中,TCP客户端模式使得PLC能够主动将产线状态、报警信息等关键数据推送至服务器或数据库,实现更及时的数据交互。本文聚焦于西门子S7-1200/

weixin_29194255的博客 361

hdu 1560(搜索 +哈希)

题目连接:https://vjudge.net/contest/353606#problem/E 思路: 每次搜索最终串的当前位置的字符,因为只有四个字符,所以要找到下一个字符一定要减少这些字符串的长度,当所有子序列都满了的时候结束,重点是更新。 代码: #include <bits/stdc++.h> using namespace std; const uns...

积少成多,水滴石穿 327

TOPSIS+熵权法组合拳:5分钟学会供应商选择决策模型

本文详细介绍了如何运用TOPSIS和熵权法这对黄金组合,快速构建科学、客观的供应商评估决策模型。通过数据标准化、权重计算和综合排序,帮助企业在半小时内完成高效、准确的供应商选择,解决传统主观打分法的弊端,提升供应链管理效率。

weixin_29051149的博客 277

速腾R128雷达+海康全景相机ROS数据采集避坑实录:从‘雷达不转’到MATLAB标定的完整流程

本文详细记录了速腾R128激光雷达与海康威视全景相机在ROS环境下的数据采集与MATLAB标定全流程。从硬件配置的常见陷阱(如雷达旋转参数设置)、驱动编译的依赖管理,到多传感器同步的实战技巧和MATLAB标定方法,提供了完整的避坑指南和技术方案。特别针对RoboSense R128雷达和海康相机的特殊需求给出了具体解决方案。

weixin_28717807的博客 1219

HDU-1560 DNA sequence【构造答案+IDA*剪枝】

题目大意: 给N个字符串,求一个最短序列能否将N个字符串包含。输出最短序列的长度。 思路: 可以构造一个最短序列,然后判断能否将所有序列包含进去。然后用IDA*剪枝(这到没错)。构造的过程并不复杂,因为只涉及4个碱基。再有就是回溯的问题,这里需要对每个字符串设置一个指针,用于判断包含关系。最后的包含关系肯定是所有字符串的指针都走到了最后一个元素。可以用数组来存每个字符串当前的指针位置,但是每个状态有不一样,这里可以用一个数组参数传递到下一个状态上,这样就避免了回溯麻烦的问题产生。 反思: 这个构造确实巧妙,

qq_41201328的博客 367

通讯软件013——分分钟学会Kepware OPC AE Server仿真配置

本文介绍如何使用Kepware软件仿真OPC AE Server配置。

zhouwl72的博客 2227

HDU-1560

使用IDA*:迭代dfs+剪枝 首先读取每一个字符串 然后选择最大长度作为初始深度 每次迭代+1 设置三个数组: dna序列数组 当前匹配数组 最短dna序列数组 剪枝: 剩余匹配数组的最大值小于深度-当前dna序列的长度 每次dfs都更新当前匹配数组。本题我根据大佬的代码做了一些改动 使用pos[]全局变量作为记录当前追踪过程 每次遍历完后回溯。其次就是dfs遍历的原理 逻辑一定要严谨 不能有疏漏 再接再厉吧。做了几道IDA*的题发现关键还是求最小代价作为剪枝是关键。

m0_73596392的博客 322

RK3399平台开发系列讲解(内核入门篇)1.2、如何高效的阅读Linux内核设备驱动

内核开发在很大程度上并不是重新造“轮子”的过程,而是深入理解并尽量复用现有的内核设计框架,然后参照相似的功能模块去添加或改写某项需要的功能。在对内核整体框架以及某些子系统融会贯通以后,我们才有可能站在巨人的肩膀上去改进框架本身,实现自主创新。如果过分强调不必要的“自主创新”,可能会让内核的可维护性变差,最终结果反而得不偿失。 那么此次就分享就围绕如何高效的阅读内核驱动代码:

内核笔记 7341

ESP32-C3入门教程 基础篇⑩——SNTP(Simple Network Time Protocol) 网络时间同步的简单实例

ESP32-C3入门教程 基础篇⑩——SNTP(Simple Network Time Protocol) 网络时间同步的简单实例

1589

HDU 1560 IDA*

要求:n个字符串(1 &lt;= n &lt;= 8),每个字符串长度不超过5,求一个字符串使这n个字符串都是它的子序列,输出所求序列的最短长度。例如给出:4个字符串"ACGT","ATGC","CGTT" , "CAGT",拼接成下图,则输出最短长度8。 方法:IDA* 1.IDA*是迭代加深搜索,就是限制DFS的深度,若当前深度搜索不到结果,那么增加深度继续搜索。 2.搜索即可。 ...

Irving0323的博客 388

芯片测试:WAT、CP、FT

最近部门来了一个日本回来的同事,虽然他尽量用非常Poor的中文给我解释一些东西,其中还夹杂着一些英文让我很受挫,于是最近来学一下WAT中的常用的单词含义。直接去查缩写、查单词很难去记住,要把具体的东西放在具体的场景,引发知识的连接才会在脑子里留下一定的映像。感兴趣的一起来学习一下这篇不错的文章吧。注释是我查询记录,如有不妥,欢迎指出修正。

叫好与叫座虽然不是对立面,但想在同一个作品中达到双重效果很难。 5087

DNA sequence HDU - 1560 (IDA* 算法)

题目链接 题意:给定n个(1<=n<=8)由AGCT组成,长度不大于5的模式串,要求构造一个尽量短的字符串,满足任意一个模式串都是其子序列。(子序列是不一定连续的,连续的指子串) 思路:用IDA*算法 , 枚举需要构造的字符串的长度,然后用dfs+剪枝技巧判断这个长度是否满足。 #include<bits/stdc++.h> using namespace std; #define ll long long const int maxn = 1e5+7; //给定n个长度不超过5的字

矮纸斜行闲作草 255

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

HDU1560 DNA sequence【IDA*】

DNA sequence Time Limit: 15000/5000 MS (Java/Others) Memory Limit: 32768/32768 K (Java/Others) Total Submission(s): 5921 Accepted Submission(s): 2694 Problem Description The twenty-first century...

海岛Blog 672

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

HDU 1560DNA sequence

DNA sequence Time Limit : 15000/5000ms (Java/Other)   Memory Limit : 32768/32768K (Java/Other) Total Submission(s) : 8   Accepted Submission(s) : 1 Problem Description The twenty-first cen

Dream_M 1596

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

DNA sequence (HDU - 1560,IDA* + 小小思维)

一.题目链接: HDU-1560 二.题目大意: 给你 n 个字符串 str. 让你求出一个字符串 s 的最小长度 使得这 n 个字符串都是 s 的子序列 三.分析: 一道 IDA* 的模板题.... 这里的评估函数就用 max(若s 包含 str[i],还需的最小长度) 四.代码实现: #include <set> #include <map> #i...

The___Flash的博客 385

HDU 1560 DNA sequence (IDA*)

DNA sequence Time Limit: 15000/5000 MS (Java/Others)Memory Limit: 32768/32768 K (Java/Others) Total Submission(s): 5220Accepted Submission(s): 2447 Problem Description The twenty-first cent...

YIU 334

HDU1560 DNA sequence IDA*

传送门:HDU1560 题意:给定n个子序列,求包含这n个子序列的最短序列。 思路:由于只要输出最短长度,所以可以用IDA*,每次增加搜索深度,当某次搜索成功,这个深度就是最短的字符串长度。 关键就是IDA*中的h值怎么估算,一开始我用的是很容易想到的找差的数量最多的字符串s,s差的字母数量作为h值,这样能够水过这个题了,但是其实还不够,像下面这组数据就跟本跑不出来: 1 8 AAAA

WA是一笔财富 408

DNA sequence(HDU - 1560)(IDA*)

DNA sequence The twenty-first century is a biology-technology developing century. We know that a gene is made of DNA. The nucleotide bases from which DNA is built are A(adenine), C(cytosine), G(guanin...

K_Code_的博客 373

hdu 1560 DNA sequence (IDA*)

DNA sequence Time Limit: 15000/5000 MS (Java/Others)    Memory Limit: 32768/32768 K (Java/Others) Total Submission(s): 721    Accepted Submission(s): 349 Problem Description The twenty-fir

To be what you what to be! 1150

HDU-1560 DNA sequence(IDA*)

数据不是很大,AC后又进入前25了。 开始TLE 5次,一直以为是自己的估价函数没写好,不停的改成现在这个样子,结果还是TLE,百度到大神的代码后发现他的优化比我还少,就想到了一定是初始化的问题,改过之后立刻AC,debug真是一个艰辛的过程。 经过测试后,发现如果只有以DNA最大剩余长度为估价函数返回值,几乎要TLE,所以主要起作用的是剩余DNA中ACGT分别出现的次数的最大值的和

idealism_xxm的专栏 739

HDU 1560 DNA sequence(初学IDA*)

题面 The twenty-first century is a biology-technology developing century. We know that a gene is made of DNA. The nucleotide bases from which DNA is built are A(adenine), C(cytosine), G(guanine), and T...

Yi_Qing_Z的博客 210

HDU 1560 - DNA sequence ( IDA* )

题意 给出n( 1 <= n <= 8 )个长度为1~5的DNA序列, 找出一个最短的满足包含所有这些子字符串的字符串,只要字符串中各字母相对位置相同即可。 思路 IDA* 从maxd = lenmax开始加深 AC代码 #include <iostream> #include <a...

a7152326的博客 114

HDU1560:DNA sequence(IDA星)

Problem Description The twenty-first century is a biology-technology developing century. We know that a gene is made of DNA. The nucleotide bases from which DNA is built are A(adenine), C(cytosine),

ACM!荣耀之路! 4128
上一篇: FZU2150 Fire Game —— BFS
下一篇: HDU3567 Eight II —— IDA*算法
DOLFAMINGO
博客等级 码龄10年 8粉丝 216原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值