MFTCoder 重磅升级 v0.3.0 发布,支持 Mixtral 等更多模型,支持收敛均衡,支持 FSDP

AI大模型如何测评代码生成能力 human-eval详解 此内部函数用于计算单个问题的pass@k概率。如果尝试的次数 (n) 减去错误的次数 (c) 小于k,说明不可能有k次正确的结果,因此概率是 1(即100%失败)。否则,计算公式表示至少有k次正确的概率。这个计算使用了组合数公式,其中comb(n, k)是从n次尝试中选取k次的所有可能组合方式,是在所有尝试中去除所有正确答案后,剩余尝试中选取k次的组合方式。通过这种方法,函数能够有效地为每个问题计算至少达到k次正确答案的概率。 阅读详情

1. MFTCoder 简介

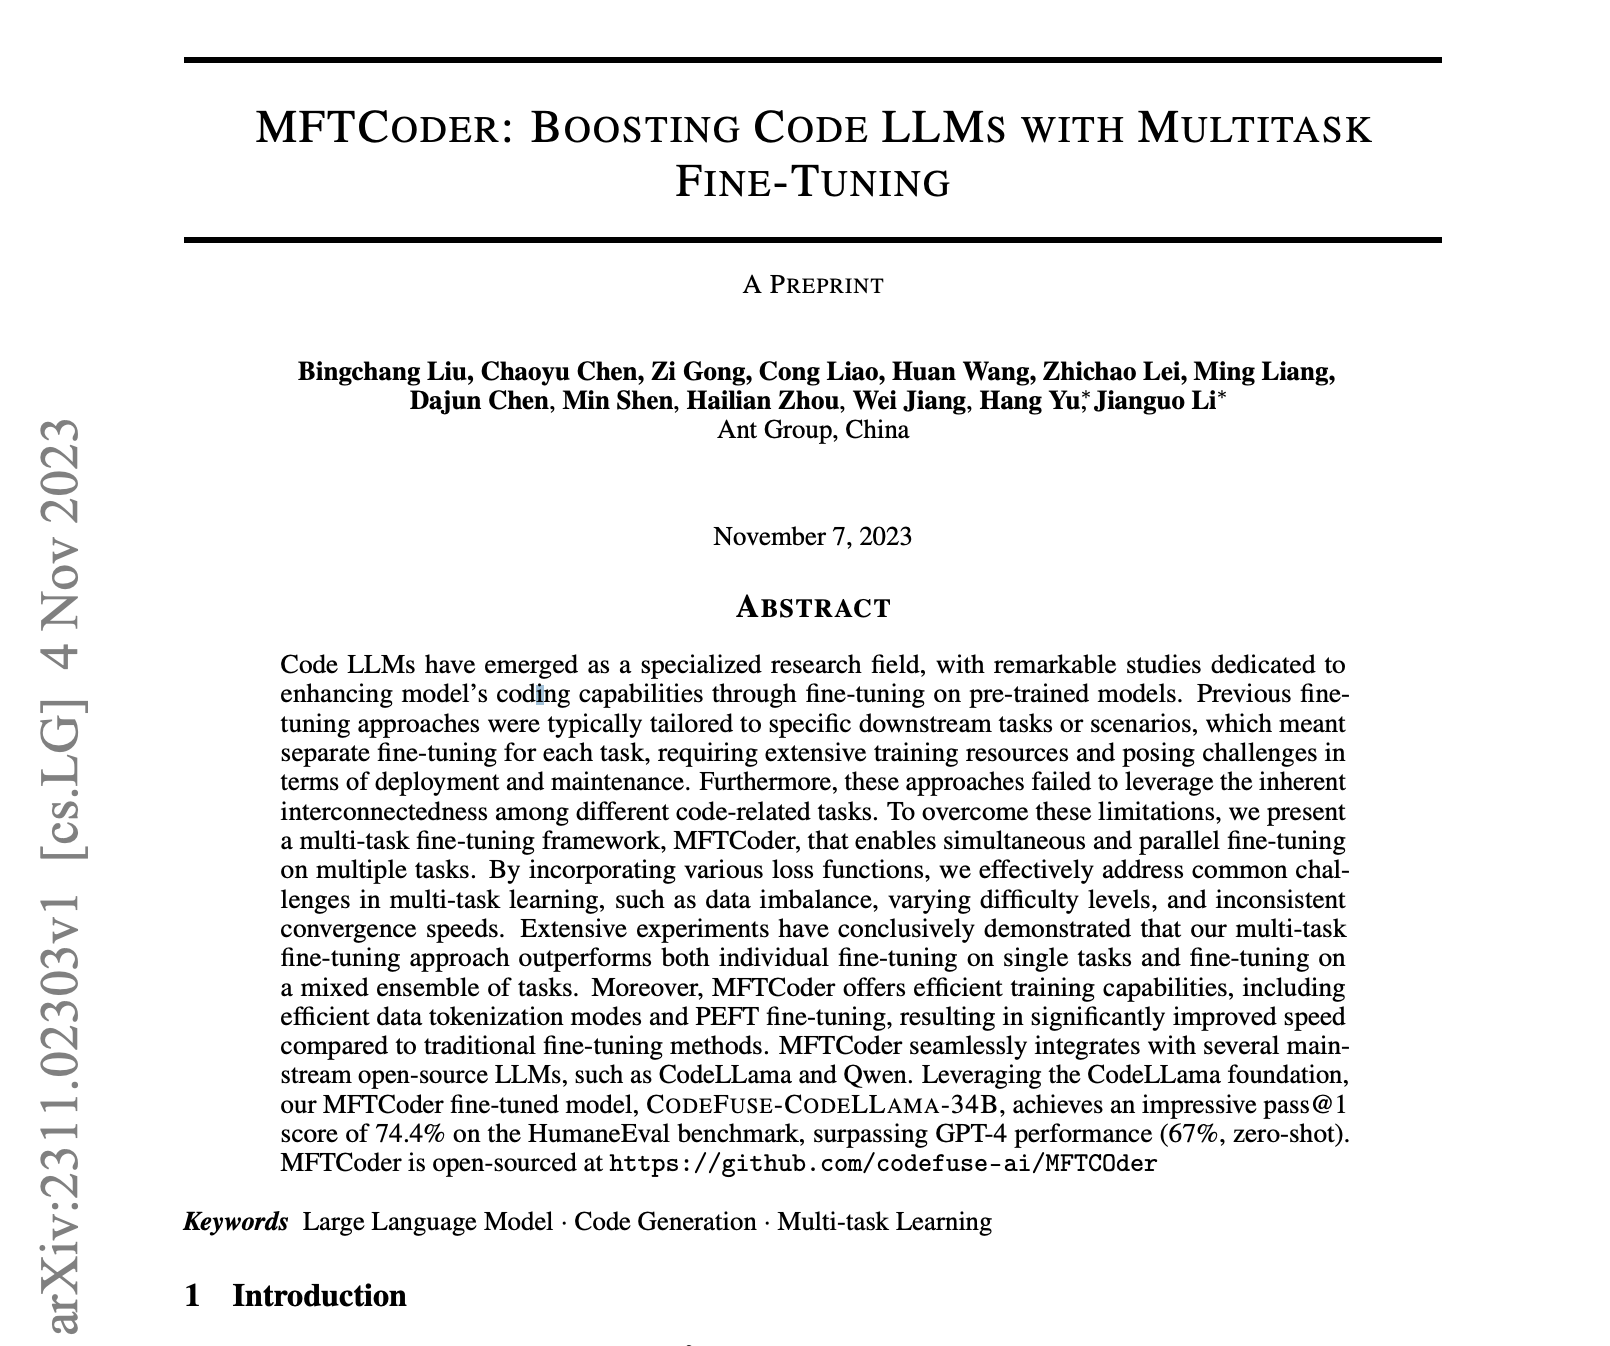
CodeFuse在2023年9月开源了一种多任务微调框架——MFTCoder,它可以实现在多个任务上同时并行地进行微调。通过结合多种损失函数,我们有效地解决了多任务学习中常见的任务间数据量不平衡、难易不一和收敛速度不一致等挑战。大量实验结果显示,相较于单独对单个任务进行微调或者多任务混合为一后进行微调,我们的多任务微调方法表现更优。此外,MFTCoder具备高效训练特征,包括提供高效的数据Tokenization模式和支持PEFT微调,能有效提升微调训练速度并降低对资源的需求。MFTCoder是轻量的,简单清晰的,易于二次开发的,持续跟进Cutting-Edge技术的开源微调框架。

今天,我们对MFTCoder进行重磅升级,比如对Mixtral这个开源MoE的SOTA的多任务微调的支持;再比如我们提供了之前论文中提到的收敛均衡技术:Self-Paced Loss。

MFTCoder已适配支持了更多的主流开源LLMs,如Mixtral、Mistral、Deepseek、 Llama、CodeLlama、Qwen、CodeGeeX2、StarCoder、Baichuan2、ChatGLM2/3、GPT-Neox等。以Deepseek-coder-33b-base为底座,使用MFTCoder微调得到的CodeFuse-Deepseek-33B在HumaneEval测试中pass@1得分高达78.65%(greedy decoding)。

MFTCoder的详细介绍在我们之前的公众号文章中:干货!MFTCoder论文多任务微调技术详解

MFTCoder技术细节的论文已经放出到Arxiv:

https://arxiv.org/pdf/2311.02303.pdf;

新升级代码也已经开源到github:https://github.com/codefuse-ai/MFTCoder/tree/main/mftcoder_accelerate
2. v0.3.0新特性Hightlights

  • 首先,新版本已经适配到最新的transformers v4.36.0, 它能带给我们更好的原生modeling,进而可以在很多开源模型比如llama等训练中有更多的Attention实现选择,比如 FlashAttention2,torch的SDPA和最基本的naive Attention(eager模式)。这样可以照顾到使用不同硬件的同学。对于最常用的FlashAttention2, 适配最新的v2.3.6,让MFTCoder可以有效利用最新的FlashAttention,比如sliding_window Attention, 进而支持类似Mixtral的全部特性。
  • 然后,MFTCoder-accelerate框架在原有支持Accelerate+DeepSpeed的基础上,增加了对FSDP的支持,进而升级为Accelerate + DeepSpeed/FSDP模式,以便给开发者提供更多选择。DeepSpeed对LoRA/QLoRA更适合,而FSDP在全量参数训练方面具备更快的性能。
  • 第三,我们也将MFTCoder支持的模型增加了Mistral, Mixtral-8x7b,Deepseek-coder, Chatglm3等新的主流开源模型。我们用新版MFTCoder训练的CodeFuse-Mixtral-8x7B, 是通用自然语言大模型经过多代码任务微调后代码能力领先的。而我们用MFTCoder训练的CodeFuse-DeepSeek-33B 更是可以在BigCode Leaderboard上以41.62%的胜率排在目前第一名。
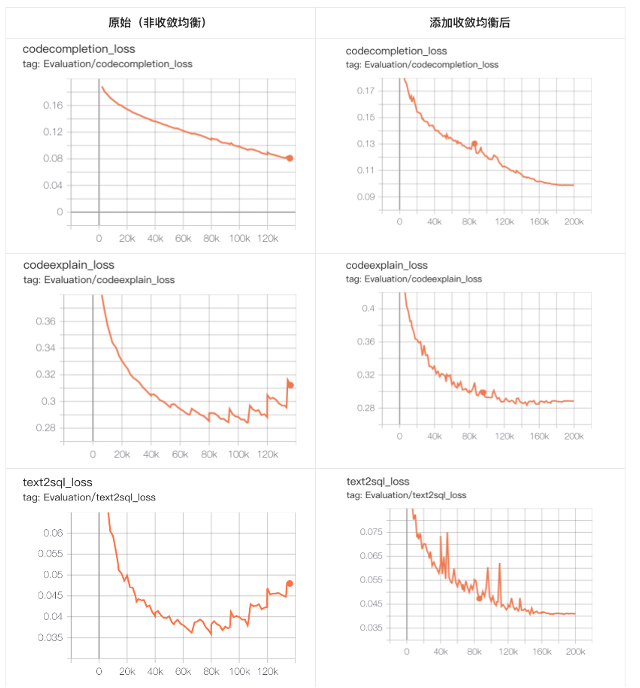
  • 最后,我们引入了Self-Paced Loss, 作为MFT多任务微调收敛均衡的新loss,它能为我们带来初步的收敛均衡,用过去窗口时间内验证损失来调整不同任务的权重,进而控制不同任务的收敛速度,以达到多个任务同时收敛的目的, 避免一些任务已经过拟合而另一些任务还未收敛。它的效果可以通过以下使用self-paced loss和原始MFT loss的收敛情况观察到。
3. MFTCoder提升Mixtral-8x7B混合专家模型的代码能力实践

CodeFuse-Mixtral-8x7B 模型地址:

https://modelscope.cn/models/codefuse-ai/CodeFuse-Mixtral-8x7B
https://huggingface.co/codefuse-ai/CodeFuse-Mixtral-8x7B

3.1. Mixtral-8x7B底座代码能力总览

Mixtral-8x7B 是由Mistral AI开源的自然语言大模型。它是以Mistral-7B为基础,将8个7B模型通过稀疏混合专家(SMoE)模式混合到一起训练的MoE模型。作为一个MoE模型, Mixtral-8x7B的每一层的Attention是8个expert共用的,而每个expert是一个单独的MLP模块, 通过一个gate进行路由,每次推理激活两个expert。因此Mixtral尽管有8x7B, 实际推理时相当于只用了12B的计算。缺点是Mixtral-8x7B对于显存的需求依然很大,相当于一个46B的模型。
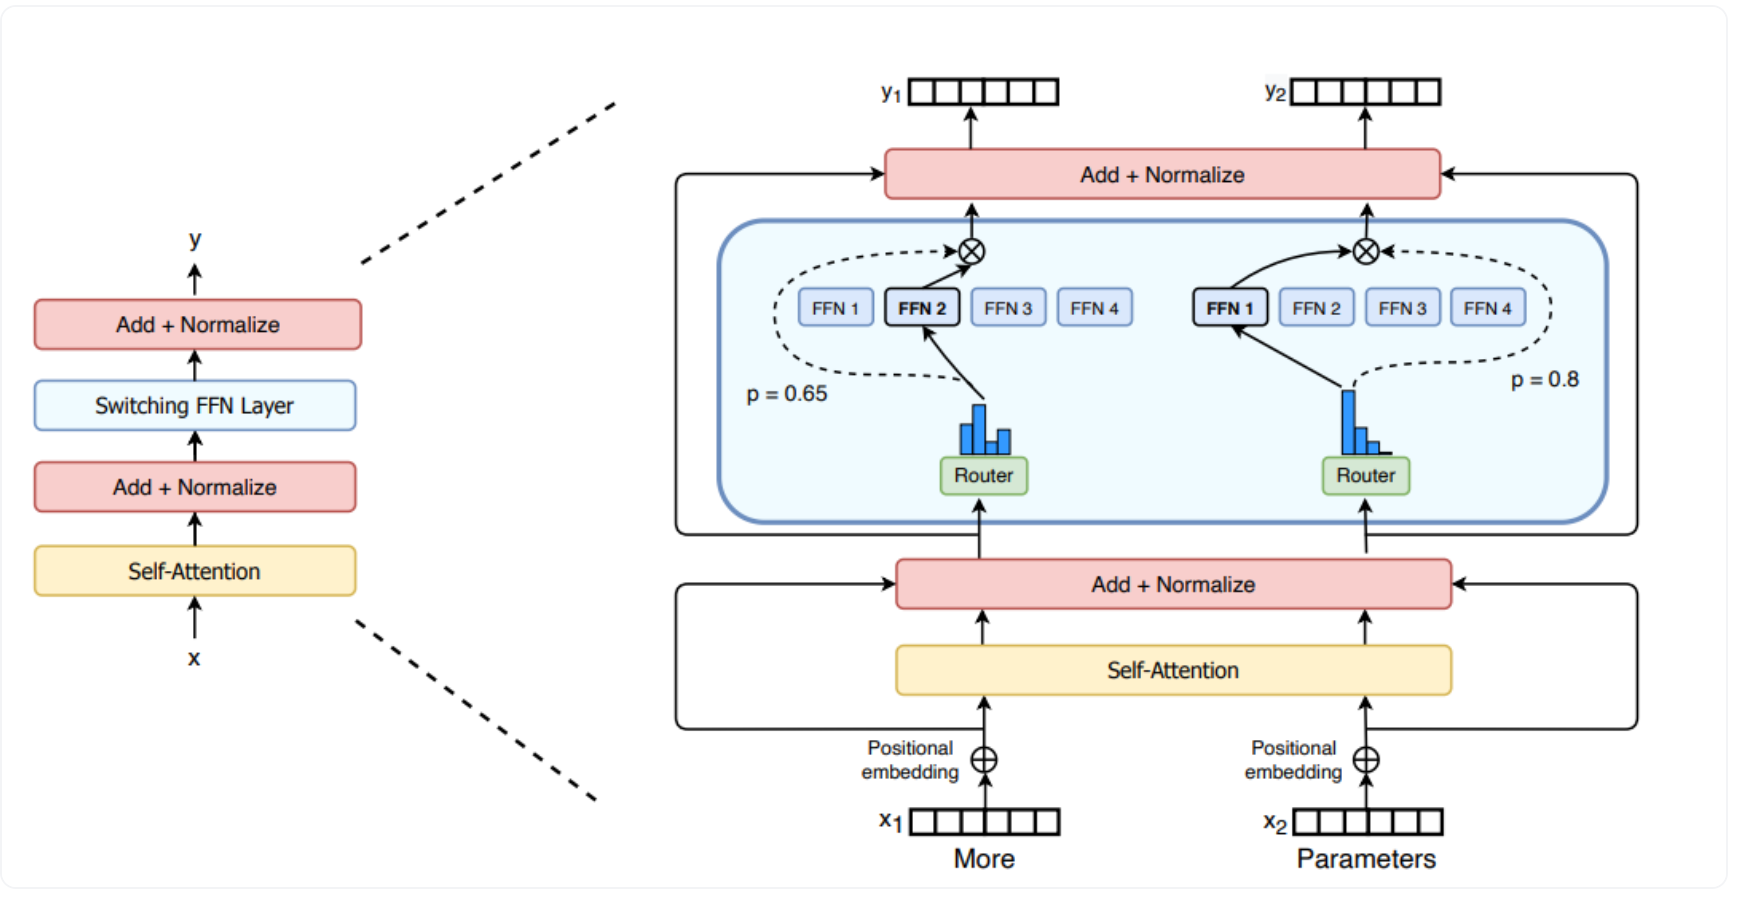
Sparse MoE: Switching transformer原理图

来源: https://huggingface.co/blog/moe

Mixtral-8x7B本身是一个通用自然语言大模型,并没有对代码进行针对性的加训,但它自身的代码能力在一众非代码大模型中是领先的,基本和CodeLLama-13B这个代码大模型性能相当,我们可以将它和一些主流通用自然语言大模型在HumanEval-X数据集中五种语言的Pass@1 评测结果对比如下(用Greedy解码统一测试):

Model

Python

C++

Java

JavaScript

Go

平均

Mixtral-8x7B

41.46%

40.84%

53.05%

45.12%

23.78%

40.85%

Qwen-14B

32.93%

35.37%

32.93%

30.49%

21.34%

30.61%

Baichuan2-13B

17.1%

20.73%

5.49%

16.45%

6.71%

13.30%

CodeGeeX2-6B

35.90%

30.80%

32.20%

29.30%

22.50%

30.14%

StarCoder-15B

33.57%

30.22%

30.79%

31.55%

17.62%

28.75%

CodeLLama-13B

43.29%

41.46%

38.41%

34.76%

29.27%

37.44%

Mixtral-8x7B的成功,为我们提供了关于MoE模型的很好地例子,证明了MoE模型是一个很好的趋势和方向。因此我们尝试对它进行多代码任务微调,看看它在微调后的代码能力提升如何。同时,Mixtral-8x7B也为代码大模型使用MoE提供了很多值得借鉴的地方,尤其是多任务代码大模型与MoE的思路有很多重合之处。

3.2. MFTCoder 多任务微调Mixtral-8x7B

借助MFTCoder(v0.3.0)的多任务微调能力,我们可以使用多个代码任务数据集对Mixtral-8x7B进行多任务微调(MFT)。在任务选择上,我们精选了3个核心代码任务数据,即代码补全(Code Completion),代码生成(Text2Code), 单测生成(Unittest Generation)一共60w条指令问答数据。该数据组合包含代码生成的三个基础任务,用基础任务微调对齐过的模型,在各类未训练过的代码任务上也有不错的泛化能力。

由于Mixtral-8x7B参数量比较大,尽管它是稀疏模型,实际计算仅仅类比12B模型,但是由于它依然需要46B模型所需要的显存,因此训练采用MFTCoder的多任务QLoRA微调模式,且代码任务属于相对复杂任务,我们对更多的模块进行微调,微调的模块我们采用和之前稍有区别的策略,只微调Attention,相应的配置如下:

{
    "lora_rank": 96,
	"lora_alpha": 32,
	"lora_dropout": 0.05,
	"targeting_modules": ["q_proj", "k_proj", "v_proj", "o_proj"]

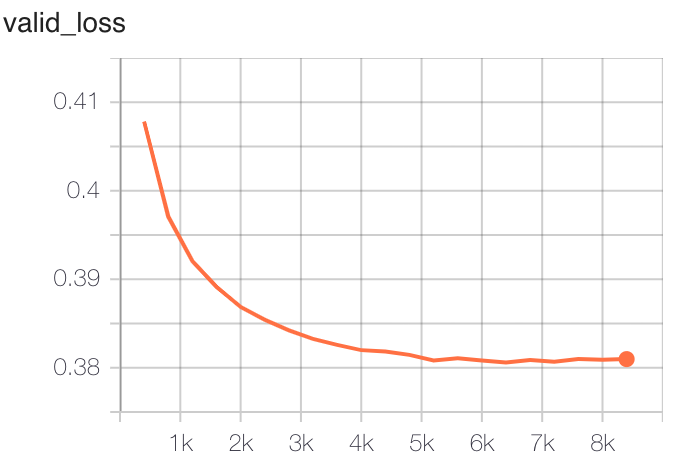
对以上数据进行了约5个Epoch的训练到收敛。训练过程loss情况如下图所示:

通过多任务微调,CodeFuse-Mixtral-8x7B的各方面代码能力均有比较大的提升。

3.3. CodeFuse-Mixtral-8x7B模型效果

对Mixtral-8x7B进行多代码任务微调后,CodeFuse-Mixtral-8x7B在HumanEval-X数据集中五种语言的Pass@1评测结果对比如下(用Greedy解码统一测试),我们同时用开源的通用自然语言大模型的Qwen-14B以及CodeFuse-Qwen-14B的代码能力做比较。

Model

Python

C++

Java

JavaScript

Go

平均

CodeFuse-Mixtral-8x7B

56.1%

50.6%

57.3%

56.7%

43.3%

52.8%

Mixtral-8x7B

41.5%

40.8%

53.1%

45.1%

23.8%

40.9%

CodeFuse-Qwen-14B

48.8%

41.5%

46.3%

38.4%

26.8%

40.4%

Qwen-14B

32.9%

35.4%

32.9%

30.5%

21.3%

30.6%

可以看出, CodeFuse-Mixtral-8x7B 在 Mixtral-8x7B的基础上,各语言代码能力(HumanEval-X)均有明显提高, 比Mixtral-8x7B平均pass@1提高12%, 达到40.9% -> 52.8%。这是目前开源的非代码大模型经过多任务代码微调后较为领先的。

4. 联系我们

MFTCoder最新版本v0.3.0已经开源,感兴趣的同学可以用版本tag或者持续跟踪main分支,本文中提到的模型和数据集也在陆续开源中,如果您喜欢我们的工作,欢迎试用、指正错误和贡献代码,可以的话请给我们的项目增加Star以支持我们。

蚂蚁CodeFuse-13B代码专用大模型开源;夫子·明察司法大模型、MindChat 心理大模型等项目多个新模型版本开源 ExLlamaV2 采用全新的代码库和内核实现,取得了显著的性能提升,支持与 V1 相同的 4 位 GPTQ 模型,同时支持新的“EXL2”格式。CodeFuse-MFTCoder 是多任务微调代码大模型项目,包含代码大模型的模型、数据、训练等,具备多任务、多模型、多框架、高效微调的优势。,旨在为用户提供全方位、高精准的法律咨询与解答服务。目前提供基于 Qwen-7B、InternLM-7B、Baichuan-13B 三个版本的微调模型,利用了大规模预训练模型的优势,具备处理复杂心理问题的能力。 阅读详情

相关推荐

研究篇| 一款深入浅出的微调框架

中介绍了模型训练需要大量的计算资源,一般情况下,个人和企业是无法承担的成本,所以微调的方案就出来, 关于微调的方式也很多,大部分微调方式都是固定模型参数(freeze model), 可以降低计算梯度等内存空间, 从而实现小参数撬动大模型, 关于更多的微调方法可以查看《LoRA在需要微调的层上引入了一对小的可训练矩阵,称为低秩矩阵。训练器: 主要支持lora方式微调, 支持 (增量)预训练、(多模态)指令监督微调、奖励模型训练、PPO 训练、DPO 训练、KTO 训练和 ORPO 训练方法。

youbingchen的博客 2139

干货!MFTCoder论文多任务微调技术详解

来自:CodeFuse代码大模型(Code LLMs)已经成为一个专门的研究领域,通过使用代码相关数据对预训练模型进行微调来提升模型的编码能力。以往的微调方法通常针对特定的下游任务或场景进行定制,意味着每个任务需要单独进行微调,需要大量的训练资源,并且由于多个模型并存而难于维护和部署。此外,这些方法未能利用不同代码任务之间的内在联系。为了克服这些限制,我们提出了一种多任务微调框架——MFTCode...

zenRRan的博客 989

遥感大模型的深度学习从CNN到Vision Transformer以及混合架构的演进之路

深度学习,特别是以卷积神经网络(CNN)和Transformer为代表的“大模型”技术,正以其强大的表征学习能力,深刻地重塑着遥感智能解译的整个技术栈与认知范式。本文将系统性地梳理遥感大模型从局部卷积的奠基,到全局注意力的革命,再到二者融合的混合架构演进这一波澜壮阔的历程。我们将深入剖析每个阶段的核心技术原理,结合遥感数据特性与实际应用案例,详细阐述其在分类、检测、分割等核心任务中的具体应用。

panshengwu的博客 1138

MFTCoder:面向代码任务的多任务微调框架

MFTCoder 是由 CodeFuse 开发的一个开源项目,旨在为大型语言模型(尤其是针对代码任务的语言模型)提供精确和高效的多任务微调(Multi-task Fine-tuning, MFT)解决方案。该项目使用 Python 编程语言,结合了先进的深度学习技术,为大型语言模型的多任务训练提供支持。 ## 2. 项目的核心功能 - **多任务训练**:MFTCoder 支持模型在多个任务上

gitblog_00659的博客 496

泛微Ecology9单点登录实战指南:从Token获取到页面跳转

本文提供了一份详尽的泛微Ecology9单点登录实战指南,重点解析了Token跳转式SSO的核心流程。内容涵盖从理解关键参数(如appid、loginid)与一次性Token机制,到通过代码示例演示如何正确调用接口获取Token,并详细说明了拼接不同场景跳转地址的完整规则与安全实践,旨在帮助开发者高效、稳定地实现业务系统与OA门户的无缝集成。

ol789012345的博客 1064

【Sentaurus TCAD仿真】几种基础操作

当内存不足时,没必要删除整个Project,只需要 Clean up 节点信息即可。因为占用内存的主要部分是。文件数据,Command文件是不占用多少内存的,下次需要此工程仿真结果重新运行即可。右击可以对该工程进行剪切、复制、删除、重命名等操作。当节点号有时候排序混乱的时候,我们需要重新编排节点号。此时左侧工具栏就能看见我们新建的这个工程。运行节点时不同的颜色代表目前的状态。在这个地方添加要使用的工具。这个时候需要的工具就建好了。然后选择需要使用的工具。我们需要保存这个工程。

qq_45746744的博客 1万+

SwiftUI与Combine的完美结合:替代RxCocoa的现代UI绑定方案

在iOS开发领域,响应式编程已成为构建流畅用户界面的核心技术。随着Apple推出Combine框架,开发者们正逐步从第三方库RxSwift转向这一原生解决方案。本文将深入探讨如何利用SwiftUI与Combine的无缝集成,构建替代RxCocoa的现代UI绑定方案,帮助开发者快速掌握这一高效开发模式。 ## 为什么选择Combine而非RxSwift? Combine作为Apple官方推出的响

gitblog_00574的博客 744

osgEarth实战:5分钟搞定3DTiles模型加载(附完整配置代码)

本文提供了一份osgEarth加载3DTiles模型的实战指南。通过详解核心Earth文件配置与精简的C++集成代码,帮助开发者快速在三维地球场景中集成倾斜摄影与BIM等海量模型,并分享了性能调优与常见问题排查技巧,有效提升开发效率。

jjj34的博客 479

什么是大型语言模型LLM以及Transformer模型讲解

✍文章目标:您将在本篇中,学习到LLM底层模型Transformer原理,为后续学习打下基础

共同学习、强我国家 1547

moveit——基于octomap的碰撞检测

机械臂对棚顶进行碰撞检测。

如果想成为中心,那么就到中心去吧。 1355

vivo X200 Ultra前瞻系列(1):重塑影像旗舰标准

在色彩风格化、视频专业度上实现了安卓阵营的突破性进步。其2亿像素长焦、双LYT-818传感器及5轴防抖技术,对追求个性化创作的用户具有强吸引力。若真机表现能兑现硬件承诺,X200 Ultra有望重新定义手机影像的“专业”标准。然而,其厚重设计、价格门槛及生态适配问题,仍需市场检验。vivo X200 Ultra作为2025年上半年影像旗舰,以“全焦段夜视仪+电影级视频”为核心卖点,主打。,对标小米15 Ultra、OPPO Find X8 Ultra等竞品。,顶配版(24GB+2TB)逼近万元。

专注:太空算力、AI infra、异构调度、大模型成本工程 963

48个代码大模型汇总,涵盖原始、改进、专用、微调4大类

具有强大的表达能力和复杂性,可以处理各种自然语言任务,包括文本分类、问答、对话等。这些模型通常基于深度学习架构,如Transformer,并使用预训练目标(如语言建模)进行训练。在对大量代码数据的学习和训练过程中,代码大模型能够提升代码编写的效率和质量,辅助代码理解和决策,在代码生成、代码补全、代码解释、代码纠错以及单元测试等任务中都表现出十分出色的能力。为了帮大家深入掌握代码大模型的发展历程和挑战,我这次整理了相关的48个模型。

学姐带你玩AI的博客 5700

【UVM实战】第一章:配置UVM环境(以VCS为例),跑通书上的例子(包括清理中间文件方法、使用DVE查看波形方法、命令执行原理探究)

如何配置UVM的VCS运行环境,运行书本上的例子呢?本节将会为你详细解答!

悟已往之不谏 知来者之可追 8136

通义千问 - Code Qwen能力算法赛道季军方案

Human Eval- HumanEval是一个用于评估代码生成模型性能的数据集,由OpenAI在2021年推出。这个数据集包含164个手工编写的编程问题,每个问题都包括一个函数签名、文档字符串(docstring)、函数体以及几个单元测试。这些问题涵盖了语言理解、推理、算法和简单数学等方面。这些问题的难度也各不相同,有些甚至与简单的软件面试问题相当。这个数据集的一个重要特点是,它不仅仅依赖于代码的语法正确性,还依赖于功能正确性。也就是说,生成的代码需要通过所有相关的单元测试才能被认为是正确的。

yanqianglifei的专栏 2861

干掉百度Apollo的安装!(Apollo10.0的源码安装)

1、在Apollo10.0的安装手册中,没有再详细给出源码安装的步骤,官方更推荐的是包管理安装,但实际上Apollo10.0仍然是可以进行源码安装的。2、使用源码安装Apollo10.0,比Apollo9.0的源码安装问题要少,整个安装过程更顺畅。3、从Apollo 10.0开始,源码安装和包管理安装采用同一套编译工具,也就是aem。之前只有在进行包管理安装的时候我们才需要安装aem,现在进行源码安装也需要安装aem。

qq_40033030的博客 892

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

三分钟带你看完大模型微调框架

github地址:https://github.com/hiyouga/LLaMA-Factory官方doc地址:https://llamafactory.readthedocs.io/zh-cn/latest2. Firefly,一站式大模型训练工具,本项目支持全量参数训练、LoRA、QLoRA高效训练,支持预训练、SFT、DPO,支持绝大部分主流的开源大模型,如Llama3、Gemma、MiniCPM等。通过配置文件的方式训练不同的模型,小白亦可快速上手训练模型。gitHub地址:https://git

Java癫疯的博客 1996

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

LLaMA-Factory:大语言模型微调框架(大模型)

LLaMA-Factory 是一个国内北航开源的低代码大模型训练框架,专为大型语言模型(LLMs)的微调而设计

2301_81940605的博客 5510

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

【LLM开源项目】LLMs-微调框架-LLaMA-Factory入门指南v3.0

项目地址:https://llamafactory.readthedocs.io/zh-cn/latest/getting_started/sft.html可以使用以下命令进行微调: 提供了微调时的配置示例。该配置指定了模型参数、微调方法参数、数据集参数以及评估参数等。您需要根据自身需求自行配置。 教程地址:https://llamafactory.readthedocs.io/zh-cn/latest/getting_started/merge_lora.html当我们基于预训练模型训练好 LoRA 适

python12345678_的博客 2488

大模型应用实战4——开源大模型微调(基于LLaMA-Factory)

而大模型微调又分为全量微调和高效微调两种,所谓全量微调,指的是调整大模型的全部参数,而高效微调,则指的是调整大模型的部分参数,目前常用的高效微调方法包括LoRA、QLoRA、p-Tunning、Prefix-tunning等。这是模型保存和检查点创建的频率,允许你在训练过程中定期保存模型的状态 ,--model_name_or_path /mnt/workspace/.cache/modelscope/Qwen/Qwen1___5-1___8B-Chat ## 模型的存储路径 ,

m0_60792028的博客 1664

CodeFuse-13B: 预训练多语言代码大模型

CodeFuse是蚂蚁集团自研的代码生成模型,能提供智能建议和实时支持,帮助开发者自动生成代码、注释、测试用例等,提高研发效率。CodeFuse项目起于2023年初,目前发布了系列模型15个,数据集4个,以及数个相关工具链。CodeFuse-13B是该项目的早期预训练版本,完成于2023年6月,并于9月开源。论文《CodeFuse-13B: A Pretrained Multi-lingual Code Large Language Model》同期发表,并被收录。

具身机器人和通用AI 1342

20K star!搞定 LLM 微调的开源利器

在人工智能领域,大型语言模型(LLM)微调(Fine-Tuning)是当下最热门的话题之一。总体来说LLaMA Factory 是一个非常优质的工具,在LLM微调中帮助用户节省了大量的精力。这些模型拥有惊人的语言理解和生成能力,但要微调和部署它们以适应特定任务,往往需要大量计算资源和专业知识,代码调试还得有深厚的技术功底。

youmaob的博客 2254

CodeFuse-VLM 开源,支持多模态多任务预训练/微调

随着huggingface开源社区的不断更新,会有更多的vision encoder 和 LLM 底座发布,这些vision encoder 和 LLM底座都有各自的强项,例如 code-llama 适合生成代码类任务,但是不适合生成中文类的任务,因此用户常常需要根据vision encoder和LLM的特长来搭建自己的多模态大语言模型。针对多模态大语言模型种类繁多的落地场景,我们搭建了CodeFuse-VLM 框架,支持多种视觉模型和语言大模型,使得MFT-VLM可以适应不同种类的任务。

CodeFuse的博客 1806

XTuner 微调介绍

本文主要简单介绍微调地基础知识,以及开源微调框架 XTuner的使用。

顶级小学生 845

别只会用别人的模型了,自学Ai大模型,顺序千万不要搞反了!刚入门的小白必备!

别只会用别人的模型了,自学Ai大模型,顺序千万不要搞反了!刚入门的小白必备!

2301_81888214的博客 1309

主流的模型微调框架推荐

以下是主流的模型微调框架推荐,并结合。

学亮编程手记 2135

【LLama-Factory】开源低代码大模型微调框架本地部署和使用保姆级教程!!!

LLaMA Factory 是一个简单易用且高效的大型语言模型(Large Language Model)训练与微调平台。不想通过GitHub跳转到文档,可以通过下面的链接直接访问LLama-Factory官方文档。

weixin_43012017的博客 4915
上一篇: 蚂蚁代码大模型是如何炼成的?
下一篇: 使用NVIDIA TensorRT-LLM支持CodeFuse-CodeLlama-34B上的int4量化和推理优化实践
CodeFuse
博客等级 码龄3年 630粉丝 74原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值