


本文字数:6857;估计阅读时间:18 分钟
审校:大平
本文在公众号【ClickHouseInc】首发
我们从云数据仓库中获得了很多灵感和帮助,但是不得不说,他们的霸权时代即将结束。
在过去的10年里,像Snowflake这样的公司,加速了整个行业的现代化进程,在以前的这个行业中,用户依赖于Oracle、Teradata等厂商,他们提供和支持着封闭且私有的自管理部署生态系统。它们让组织能够将PB级的关键工作负载迁移到云中,将这些数据集开放给更广泛的集成、协作和应用程序,从而使数据的访问民主化,并显著的提高了数据价值。
随着时间的推移,企业开始更仔细地审视其数据存储,考虑其中包含的信息的性质和可能的效用。随着组织的数据变得更加方便的读取,开发团队也从静态的批量报表,过渡到了构建交互式应用程序,它们既提供给内部使用,也广泛应用于外部。
然而,他们在这里开始遇到了挑战。因为,最初大多数的云数据仓库是面向离线报表设计的(只是现在运行在了云基础架构上而已),它们的架构和定价模型也没有进行过优化,其实并不适合用作交互式、数据驱动型应用程序的数据后端。因此,组织最终会面临诸多问题,包括:性能差(响应时间长达10秒到几分钟,而不是亚秒和毫秒)、成本飙升(通常比替代方案高3-5倍),且查询并发性低下(不适用于面对外部的应用程序)等等。
因此,组织已经转向了那些:专为支持数据密集型应用程序优化的实时分析数据库(real-time analytics database)。随着这些实时分析数据库的采用和投产运营,一种我们称之为实时数据仓库(real-time data warehouse)的新架构模式出现了。在下文中,我们将描述:为什么传统数据仓库并不适用于实时分析应用程序的需求,以及实时数据仓库是如何解决这些挑战的,“解绑云数据仓库”的架构转变是怎样引发的。
传统数据仓库:一把“刀”切不了所有场景
传统数据仓库已经存在了很多年。它的设计带有深刻的时代印记,从前离线和批处理业务是常态,大多是统一的内部业务报表,它们通常依赖于:
-
大量来自源系统的迁移数据的批量ETL作业
-
大规模连接大表,为了实现在不同的数据集间进行统一的集中查询
-
为不同团队提供特定数据集的静态“视图”或“数据仓库”
然而,一旦这些数据都上了云,我们就很容易混淆一些用例的边界,用例范围也超越了传统的数据仓库。
由Snowflake、BigQuery和Redshift等平台主导的云数据仓库的崛起,它们提供了很多帮助:包括可伸缩性、方便性,最重要的是灵活性,以及对一类非常重要的数据工作负载的开放,从而使数据仓库得到了现代化。然而,一旦这些数据都上了云,我们就很容易混淆一些用例的边界,大家倾向于将云数据仓库应用到:从面向用户的分析应用,到服务器端数据转换、仪表盘、可观测性、机器学习等所有用例,也就呈现出了所谓的“一刀切”的方式。这就导致频繁发生的性能挑战,用户体验降级和显著的成本激增,迫使我们重新评估数据架构。
交互式、数据驱动型应用正在主导世界
对于一个成熟的行业来说,我们很容易忽视新型应用的构建趋势,还会将其视为一种偏门。如果你问传统的数据仓库架构师,他们可能会告诉你“批量的数据摄入和报表”没问题,但事实并非如此。
每天使用交互式、数据驱动的生产力应用程序,是现在市场、销售、工程、运营和几乎所有其他专业人士的要求。这些应用程序需要:通过以高度交互的方式分析大量数据。例如,如果你是一名营销人员,你需要了解谁访问你的网站,谁在查看你的社交媒体帖子,以及你的广告如何被点击的 - 而这一切都是实时的。如果你是一名财务分析师,你需要在瞬息万变的市场行情中,在中午和日终及时做出多次的决策。如果你是一名在7x24 小时的 SaaS服务上工作的DevOps工程师,你所负责应用程序的可用性需求日益增长 - 99.999%的正常运行时间意味着每年只有5分钟的停机时间!
因此,一些无法通过传统数据仓库解决的新兴行业应运而生,其实你需要一个实时数据仓库。
-
市场营销分析提供对来自多个渠道的营销活动的可见性 - 网站、社交、广告活动的总结信息,允许营销人员运行交互式查询和报表,并在数据海中主动展示异常 - 例如,快速增长的区域、子市场或部门,并提出优化营销支出的建议。
-
销售分析显示销售区域的活动,如通过来源的潜在流量,免费/试用产品的使用情况,销售周期活动,售后消耗,账户健康状况和流失,总结这些数据,并为销售专业人员及时提供重要的商机或风险因素 - 关键潜在客户和有风险的客户。
-
电子商务和零售分析涵盖了零售生命周期 - 从商品上架和备货,到销售活动,再到发货,实现对时间跟踪和对这些数据的交互式查询,并主动提出优化物流运营的建议。
-
金融分析跟踪金融工具的活动,如买入、卖出、认购、认沽,并允许分析师根据多个选择标准迅速调用这些信息,并提出建议行动,包括潜在的未来交易和对冲。
-
可观测性和物联网监控从SaaS基础架构或制造场地和设备中摄入结构化日志、指标和追踪事件,与设备和用户信息等元数据进行交叉引用,并总结随时间推移的错误和延迟信息,以及基于历史数据预判问题区域所在。
此外,许多驱动SaaS业务的核心数据集也将被内部利益相关者用于分析他们的业务。因此,兼顾外部和内部用户的需要是非常重要的。
内部用户需求的日益增长
分析应用程序的内部用户包括产品、营销和业务分析师,他们是数据仓库系统的主要目标受众。然而,这些用户不再满足于长反馈周期的洞察体验。为了在他们的岗位上保持竞争力,他们需要更快地做出数据驱动的决策,如果内部数据平台不满足他们的要求,他们将推动采用具有快速、交互性的高性能第三方工具。
除了现有的内部用例外,越来越多的企业在内部倡导AI/ML,内部数据科学家也需要查询访问相同的数据集,从而开发更好的ML模型和基于AI的能力。数据科学家也需要交互式访问和高性能 - 查询速度直接影响他们开发新的机器学习模型或构建基于AI的能力的速度。
云数据仓库不适用于实时分析
当用户尝试将云数据仓库用于实时分析时,他们会面临很多挑战,因为传统数据仓库的架构和定价模型还没有经过优化,还无法作为交互式、数据驱动应用程序的后端。
这些应用程序通常需求以下能力:
-
服务于不断更新的增量数据流与历史数据(长达数年)的混合型,长时间窗口查询
-
服务于需要高度交互式访问模式的查询,如高并发率下的复杂过滤和聚合
-
实现对沉浸式应用程序足够优化的查询延迟(理想情况下是亚秒级)
-
在处理每秒摄入数百万事件数据的同时,还能操作多达TB和PB级的历史数据
相反,在云数据仓库中,用户面临以下问题:
-
高延迟的数据流动。
由于数据需要通过复杂的ETL管道传播流动,需要依赖于昂贵的JOIN操作,同时拖累了实时应用程序的高度非规范化数据集,以及在传统架构中支持实时查询性能需要巨大的财务成本,内部数据工程团队难以满足这些需求,无法支撑日益增长的应用服务受众人群。
-
缓慢的查询性能。
响应用户查询的时间长达数十秒甚至几分钟,而不是毫秒,当他们试图通过投入更多计算资源来优化时,他们会遇到下一个问题 - 成本。
-
不断飙升的成本。
与替代方案相比,云数据仓库的用户支付了高达3-5倍的费用并不罕见,同时还需要忍受低下的性能;
由于其昂贵的定价,其架构不得不消耗更多系统资源来处理相同的工作负载。
-
低下的查询并发量。
并发查询的需求远远高于传统数据仓库的预期 - 成百上千的并发用户期望在高度互动性的操作中,体验毫秒集的响应,而后台的成本还期望大幅的降低。
最终,云数据仓库只能用过度提高资源成本的方式,来为应用服务工作负载降低延迟,和提供顺滑的交互式体验。这就好比花费巨资不断的改装一辆老爷车,并用它来参加一级方程式比赛一样,而正确且更便宜的答案是使用真正的F1赛车。
最终,云数据仓库只能用过度提高资源成本的方式,来为应用服务工作负载降低延迟,和提供顺滑的交互式体验 - 要么支付更多费用以获取像Snowflake中的物化视图这样的高级功能,要么通过在BigQuery中添加更多计算来加快查询速度。这就好比花费巨资不断的改装一辆老爷车,并用它来参加一级方程式比赛一样,而正确且更便宜的答案是使用真正的F1赛车。
引入实时数据仓库
实时数据仓库是一种针对运行数据密集型、交互式应用程序;而优化的数据汇聚平台,同时为内部和外部的受众提供服务。
今天,企业通过将多个系统组合在一起的方式,来满足交互应用程序的持续增长的需求,而不重新思考:数据系统的整体架构。引入了实时数据仓库的概念以后,我们简化了数据流程,同时减少了依赖关系的数量。
例如,对于一个处理大量分析数据,并试图引入能够处理实时分析工作负载的组件的,正在进行应用现代改造的组织来说,以下架构并不罕见。该架构结合了实时分析数据库的使用(以支持外部应用程序),但仍然利用传统数据仓库来处理其他内部用例。
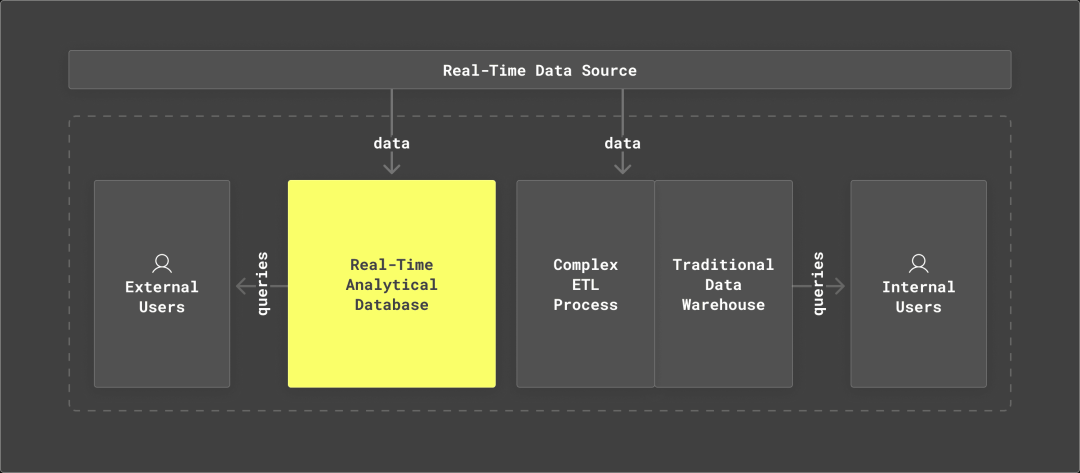
高度依赖传统数据仓库的现代数据堆栈
而实时数据仓库用一种不同的方式解决了这个挑战:它用统一的方式同时支持内部和外部的交互式数据应用程序,并将离线报告(如果需要)卸载到冷归档系统 - 这通常是一个对象存储,但有时也是降低容量的传统数据仓库。
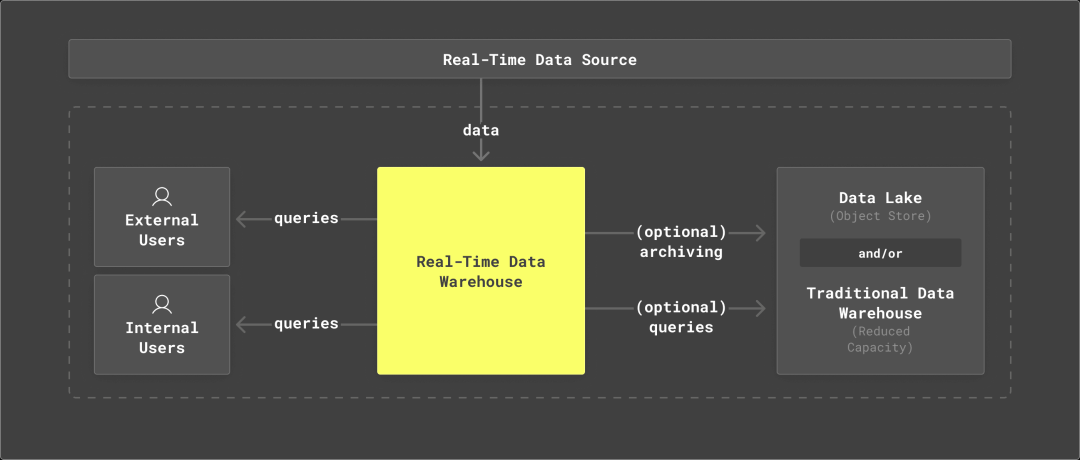
基于实时数据仓库的现代数据堆栈
解绑云数据仓库
我们将从单体云数据仓库的演进历程,称之为“云数据仓库的解绑”。经历这一转型的组织,一定会仔细考虑和确认:构建交互式数据驱动应用工作负载的全面需求,并将这些工作负载移到实时数据仓库。
在这个过程中,他们还会确定:是否应将其余的冷数据保留在传统数据仓库中,还是移动到更基于“数据湖”概念的更开放的架构。采用数据湖具有诸如:更便宜的存储和日益开放的标准(Delta Lake、Iceberg 和基于 Parquet 数据格式的 Hudi)等优势。这意味着对于不需要实时性能的应用程序,多个团队和应用程序可以访问相同的真相源,而无需将数据存储多份,或者就将其保留在专有系统中。
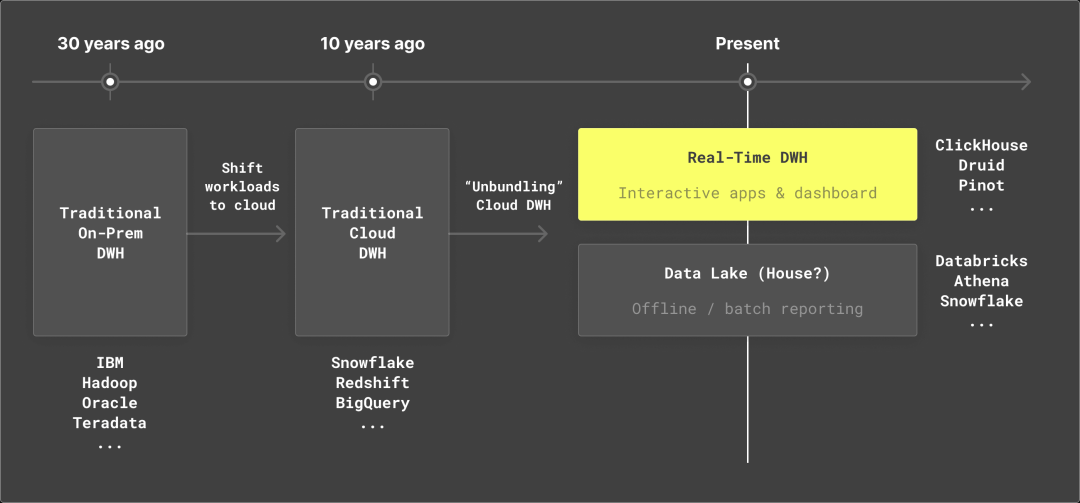
数据生态系统在过去三十年的演变
这并不是数据生态系统中发生的第一波解绑。我们从主机(mainframe将所有软件都捆绑在一起)过渡到关系型数据库(解绑),然后是传统数据仓库(捆绑),再到早期的云提供商(解绑),再到云数据仓库(捆绑)。那么这种解绑的趋势会持续下去吗?
我们预测,随着时间的推移,大多数组织将向更具供应商中立性的数据湖方案迈进,云数据仓库供应商将开放他们的技术堆栈,以包括直接在数据湖之上运行的能力。
不管答案是什么,我们相信在数据平台上分离存储和计算的趋势,将会发挥重要的作用。我们看到它在不同供应商和技术之间推动数据湖在温存储和冷存储方面的持续采用。虽然一些组织会因为现有投资,而继续使用传统数据仓库一段时间,但我们预测,随着时间的推移大多数组织将朝着更具供应商中立性的数据湖方案迈进,云数据仓库供应商将开放他们的技术堆栈,以包括直接在数据湖之上运行的能力。
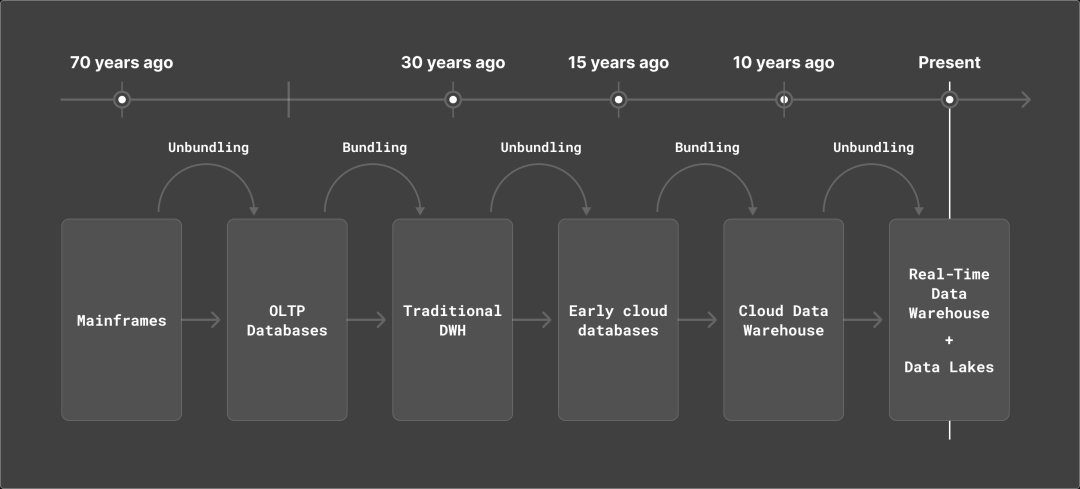
解绑 / 重绑循环
如何为您的用例选择正确的实时数据仓库
为了满足交互式数据驱动应用程序的高级需求,以及合理化大规模数据的拥有成本,实时数据仓库必须支持:
-
来自实时数据源(如Apache Kafka)的即插即用的持续数据加载
-
在不断更新物化视图的同时,密集查询也能以秒为单位完成
-
对数十亿行的数据,进行过滤和聚合查询的性能在毫秒级
为了确保对内部分析师的实用性,实时数据仓库还必须支持:
-
与BI工具(如Apache Superset、Grafana、Looker、Tableau)的集成,以供内部用户使用
-
归档数据到对象存储的能力
-
对归档在对象存储中的数据执行按需查询的能力
为了满足这些要求,实时数据仓库越来越需要在分离的存储和计算架构中运行,通过利用对象存储的最新功能,以满足实时工作负载的需求。这种架构的好处在于计算与存储的独立扩展,计算层的自动和水平扩展,这两者都有助于更好地动态分配资源,从而提高计算的性能和成本。对于大型数据集(TB和PB级),这还导致了更为合理的存储成本。
最后,随着越来越多的用例需要将传统分析与增强分析都集成在了一起,让分析数据库能够为机器学习功能(如模型训练和向量搜索)提供动力,成为越来越显著的一个需求。
ClickHouse作为实时数据仓库
以上这些是我们构建ClickHouse Cloud的要求,因此它在实时应用程序中的性能表现已经远远超越了传统数据仓库。
ClickHouse Cloud 基于 ClickHouse 开源项目,是当前被认可的最流行的开源实时分析数据库。自2016年开源以来,它在各种用例和行业垂直领域得到了广泛的应用。
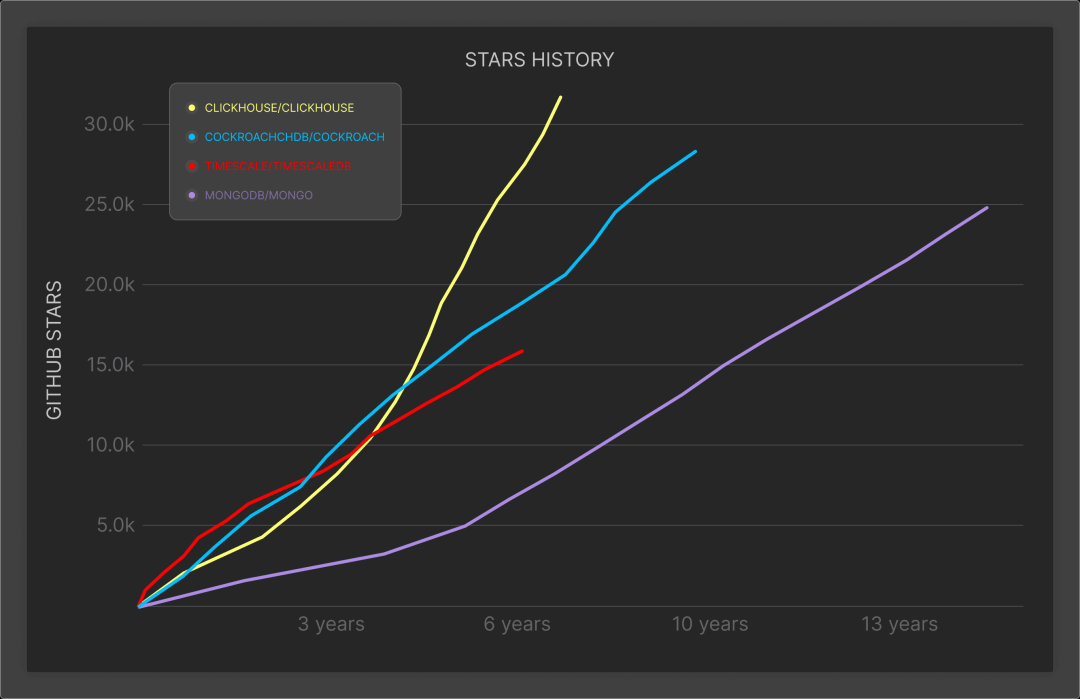
ClickHouse被广泛应用作为Web上最流行的SaaS服务的后端,涵盖营销、销售、零售和电子商务分析。它还是可观测应用程序的热门后端,可观测服务的SaaS提供商和构建在开发可观测性平台的企业团队也都在使用它。在所有这些用例中,ClickHouse持续摄取来自实时数据源(如Apache Kafka)的数据,并运行高并发的分析查询工作负载,为面向客户的应用程序提供支持。许多用户利用的其中一个超强功能是物化视图,这使得他们可以进行灵活的本地数据转换,同时大幅度提升查询速度。ClickHouse轻松的在数十亿行的数据上实现毫秒级别的分析性能。
当涉及到面向内部应用程序时,ClickHouse越来越多地被用作传统数据仓库(如Snowflake、Redshift和BigQuery)的替代方案,原因在于其广泛的集成生态系统,使得从对象存储迁移数据到ClickHouse变得容易,并直接在Parquet和许多其他格式中存储的数据上运行ClickHouse作为查询引擎。这些数据可以选择由Iceberg、Delta Lake和Hudi进行管理。
ClickHouse正在成为下一代Gen AI(生成式人工智能)应用程序构建数据平台。使用ClickHouse,开发人员可以将训练数据和向量嵌入存储到统一的数据库中,同时将基于AI和启发式的分析融合在同一个数据存储中。
ClickHouse Cloud在这些基础上进行了扩展。它为用户和管理员提供了一种部署ClickHouse的即插即用方法,实现了存储和计算的分离,这种架构具有许多优势,包括:拥有几乎无限的存储空间,轻松的水平扩展计算能力。在ClickHouse Cloud中,该架构经过了优化,以底层的优化利用到对象存储并行性、用复杂的缓存和预取技术来运行实时工作负载。ClickHouse Cloud带有内置的工具,供管理员使用(集群管理、观测、备份)以及分析师使用(SQL控制台、BI工具集成、AI辅助SQL查询)。
结论
云数据仓库实现了许多人认为不可能的目标:将庞大的数据分析工作负载,从类专有主机(mainframe-like)的自管理解决方案转移到云上。这个演进最终导引起了对于存储的数据的研究,如何将数据用于构建越来越交互式的数据驱动应用程序上,并开启了解绑云数据仓库的趋势,现在已部署在了更加开放且互连的环境中。
由于这一趋势,实时数据仓库正在演变成为:构建数据密集型交互式应用程序的关键架构组件。它用于支持面向客户的应用程序,以及使内部利益相关者能够利用相同的数据集进行业务分析和数据科学。实时数据仓库作为支持实时应用程序的分析数据集的主要数据存储,通常与对象存储上的数据湖相结合,用于长期归档和对不需要实时性能的数据进行按需访问。
延伸阅读
要了解更多有关ClickHouse在这些用例中的应用,请参阅官网相关文章:
-
ClickHouse作为实时分析的数据库后端(https://clickhouse.com/use-cases/real-time-analytics?loc=unbundling-blog)
-
ClickHouse作为Snowflake的替代方案(https://clickhouse.com/comparison/snowflake?loc=unbundling-blog?loc=unbundling-blog)
-
ClickHouse作为Redshift的替代方案(https://clickhouse.com/comparison/redshift?loc=unbundling-blog)
-
ClickHouse作为BigQuery的替代方案(https://clickhouse.com/comparison/bigquery?loc=unbundling-blog)
-
ClickHouse作为构建机器学习应用程序的平台(https://clickhouse.com/use-cases/machine-learning-and-data-science?loc=unbundling-blog)
Meetup 活动报名
好消息:ClickHouse Shenzhen User Group第1届 Meetup 已经开放报名了,将于2024年1月6日在深圳市南山区海天二路33号 腾讯滨海大厦举行,扫码免费报名

联系我们
手机号:13910395701
邮箱:Tracy.Wang@clickhouse.com
满足您所有的在线分析列式数据库管理需求

 360


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


