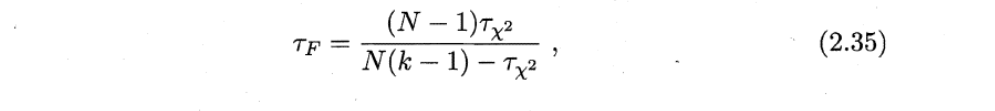【西瓜书阅读笔记】02模型评估与选择:测试集的性能在多大程度上保证真实的性能—比较检验

机器学习(西瓜书)之二项检验的理解 比较检验前言内容引出二项检验 前言   二项检验在周志华老师的西瓜书中并没有做太多解释,自己也是网上搜索了相关的资料和其他人的看法,并结合了自己的一些理解写下博客记录一下。 内容引出   我们在对学习器的性能进行评估比较的时候,有了评估方法和性能度量也不一定能很好判断学习器的优劣,通常是用统计假设检验,基于假设检验的结果我们可以推断出,若在测试集上观察到学习器A比B好,则A的泛化性能是否在统计意义上优于B,以及这个结论的把握有多大。这里,默认以错误率为性能度量,用ϵ\epsilonϵ表示,即泛化错误率。   阅读详情

一、问题

1、测试集性能与真正的泛化性能未必一致
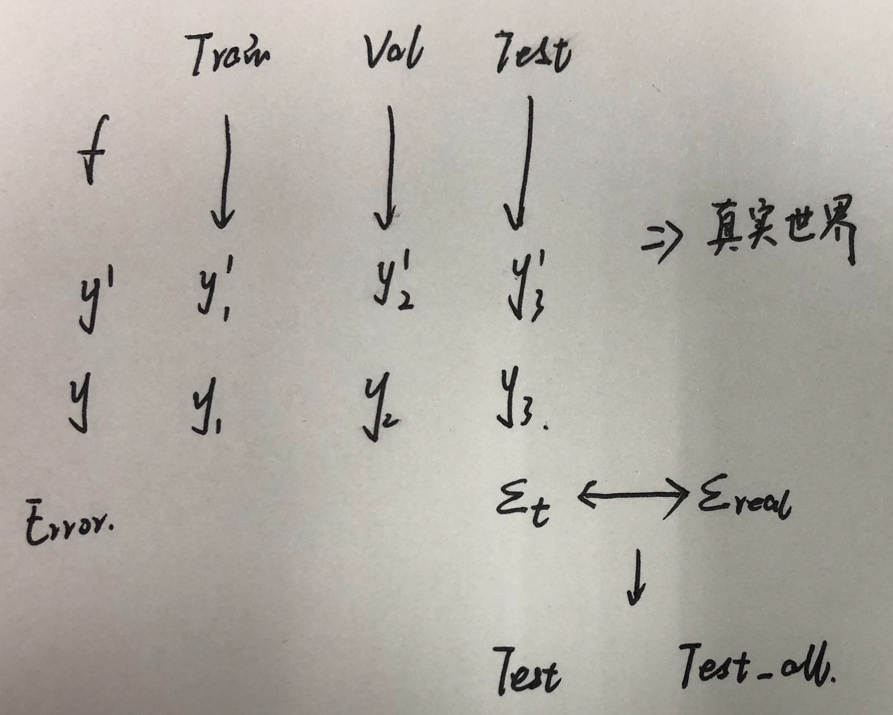
2、测试集不同反映的性能不同:多个测试集结果不同

3、机器学习算法本身有一定的随机性,同一个测试集上多次运行,可能会有不同的结果。

二、数学基础

B站:小元老师高数线代概率

三、一个测试集一种算法

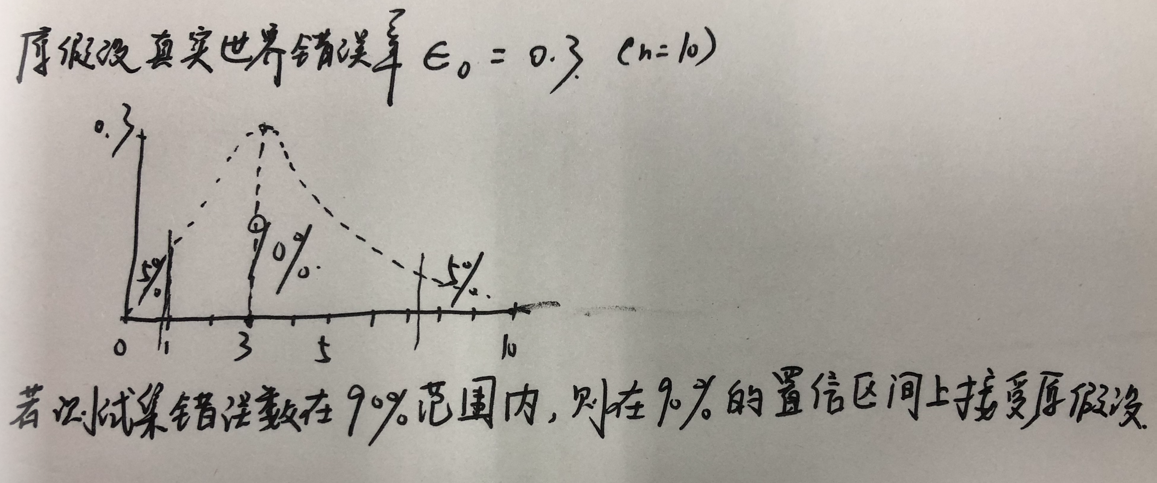
(1)二项分布:
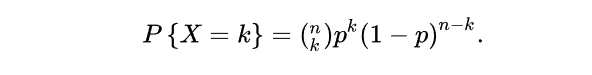

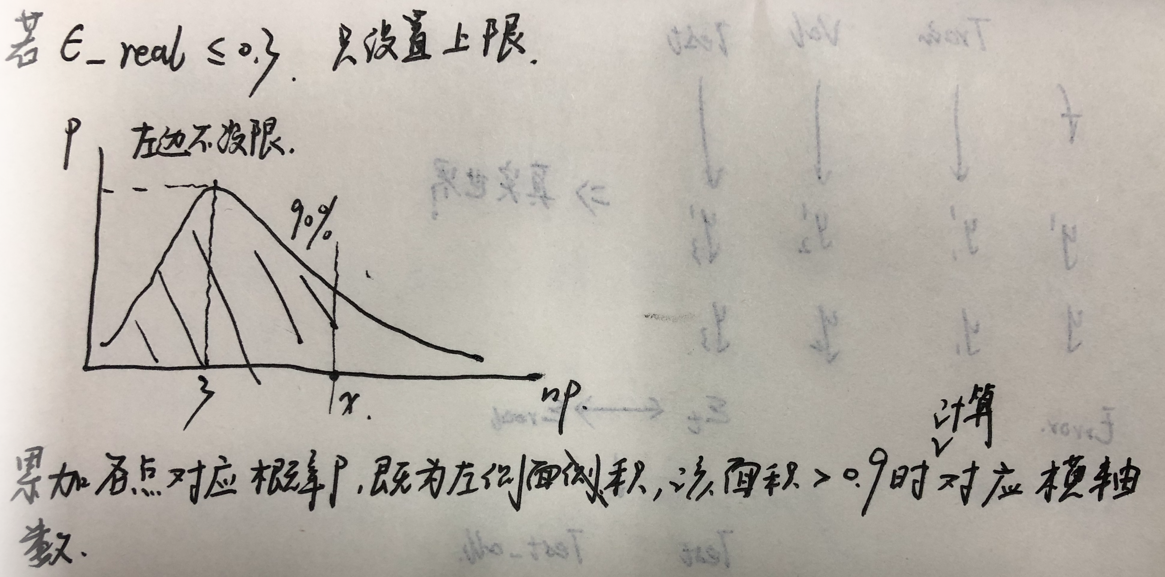
假设真实世界错误率为\epsilon = 0.3,则测试集中错误率的概念分布应该为二项分布

 大致分布如图,其中峰顶对应横轴应为np,纵轴为错误率0.3。其中n为总样本数量。 

 (2)假设检验

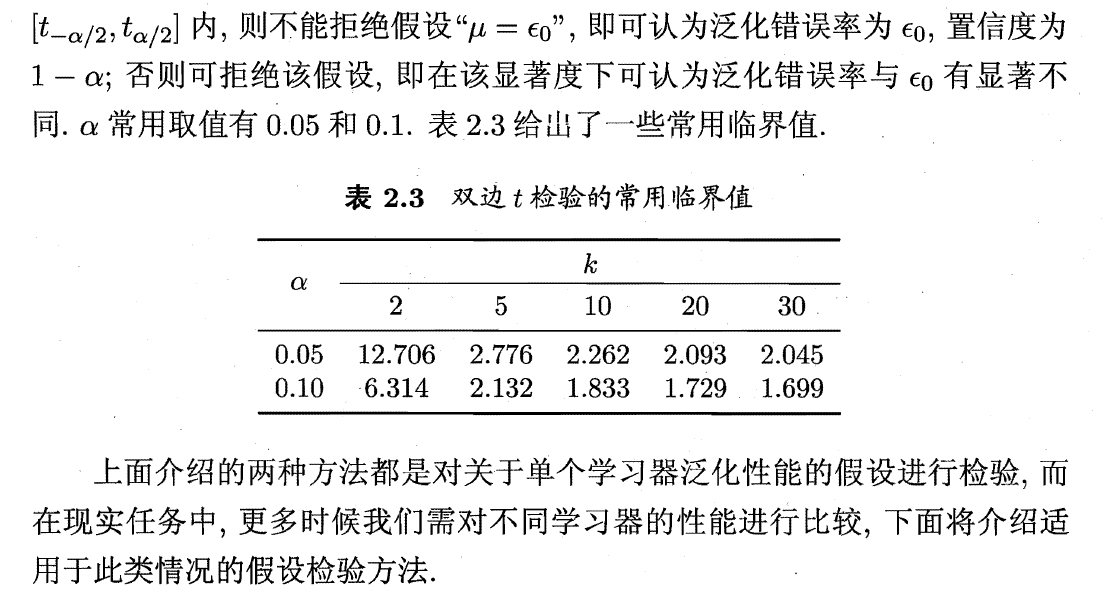
1)置信区间:
四、多个测试集一种算法——t检验

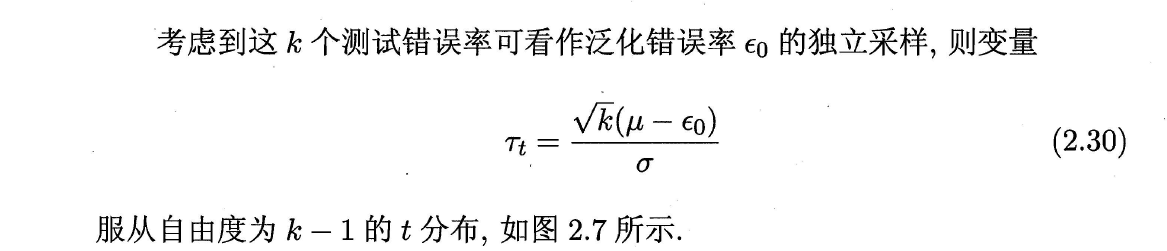
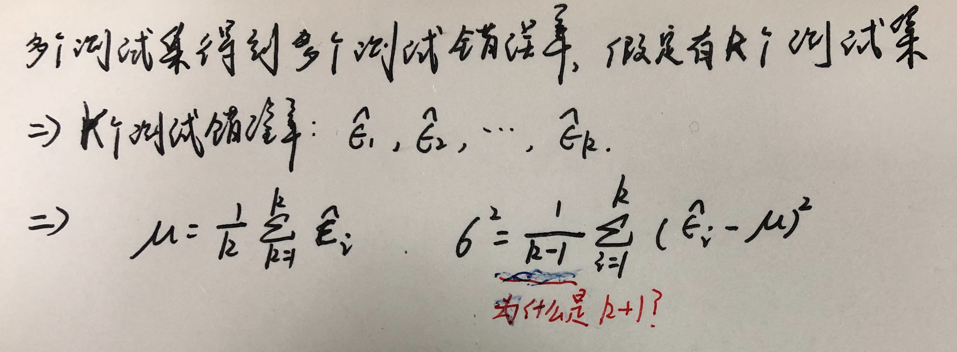
1、根据多个测试集错误率,计算得样本(错误率)均值以及样本方差
2、又已知
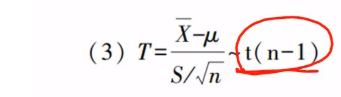
详细推导见三大分布及正态总体下的抽样分布(待完善)_Checkmate9949的博客-优快云博客三大分布及正态总体下的抽样分布(待完善)_Checkmate9949的博客-优快云博客
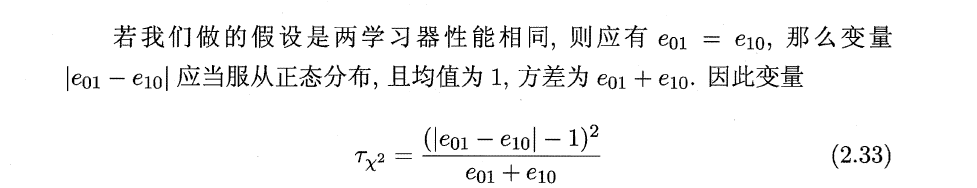
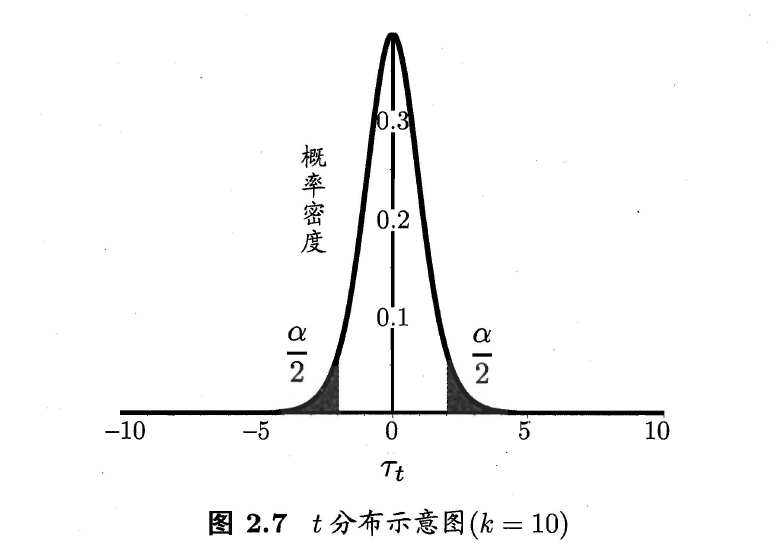
 3、以\mu对应样本均值\bar{X},真实错误率\epsilon_{0}对应真实均值\mu,则


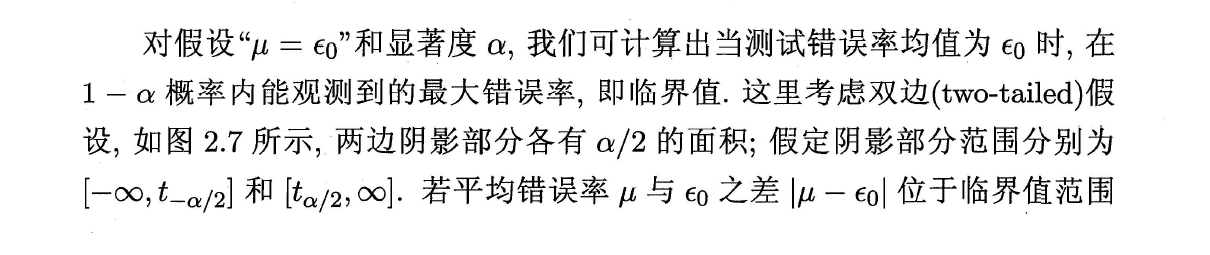
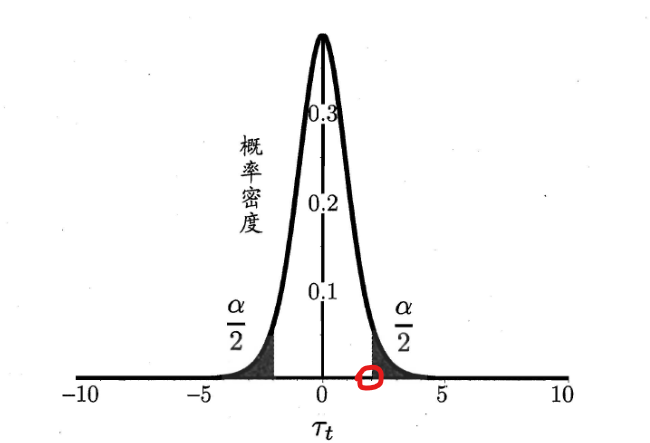
 与“一个测试集一种算法”同理,通过自由度(k-1)以及置信度alpha即可得出对应的临界值。超出临界值则拒绝原假设。
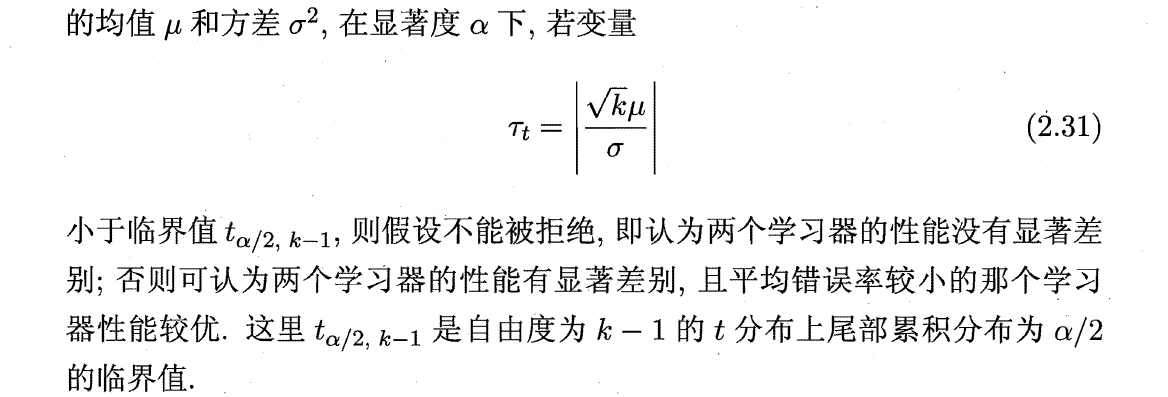
五、多个测试集两种算法——交叉验证t检验:验证两种算法是否存在显著差别

1、K折交叉验证:优快云

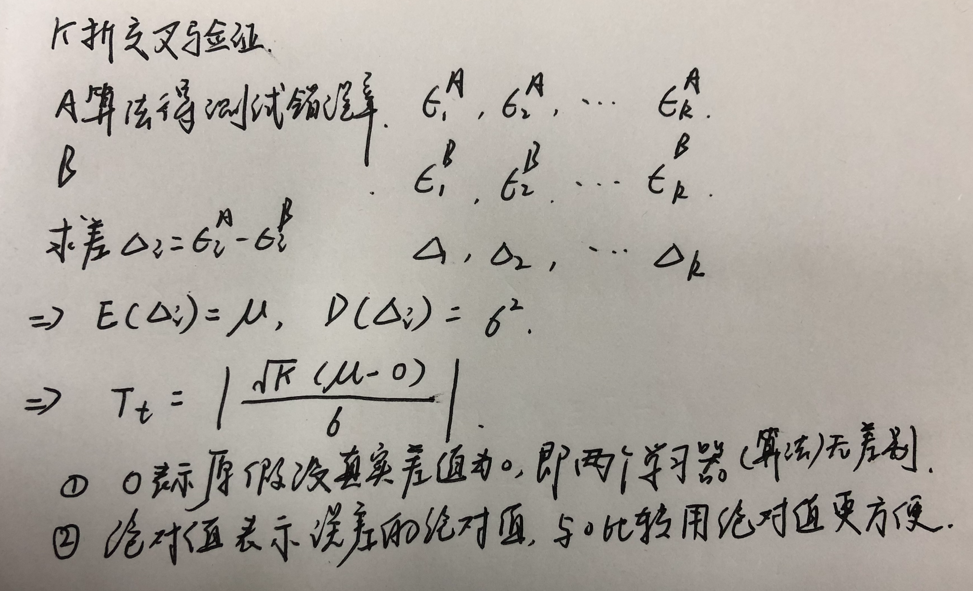
2、变量及临界值
 3、样本独立性

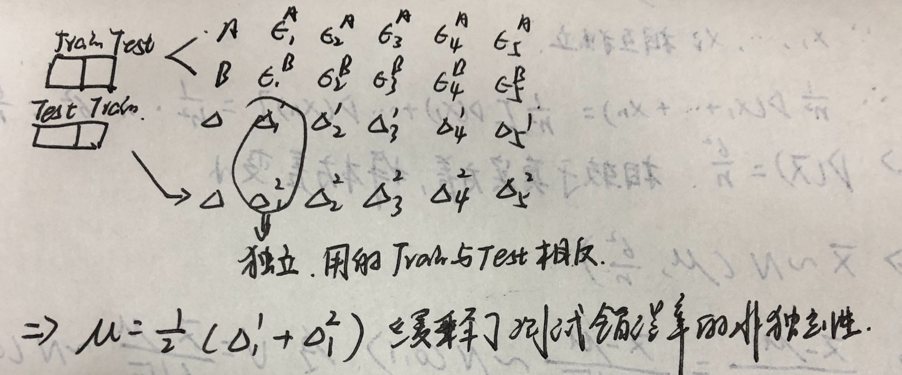
(1)测试集错误率相当于抽样样本,泛化错误率相当于总体。在K折交叉中,其训练集是重叠的,这就导致测试集错误率不独立,及抽样样本不独立,那么t分布也就不成立了。

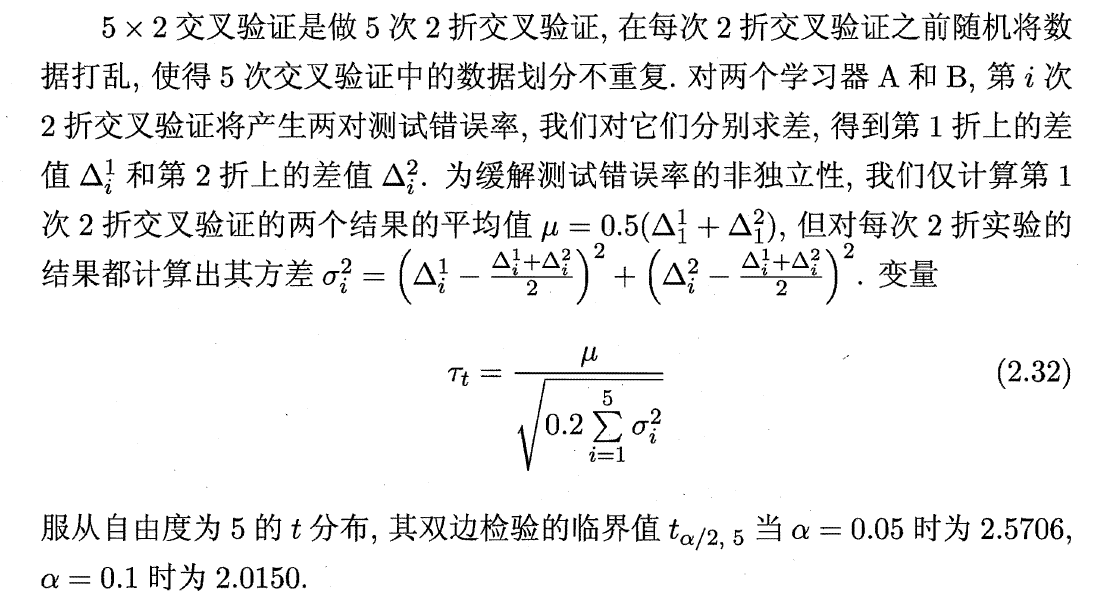
(2)为解决上述问题。可应用5*2交叉验证法。

即做5次2折交叉验证。
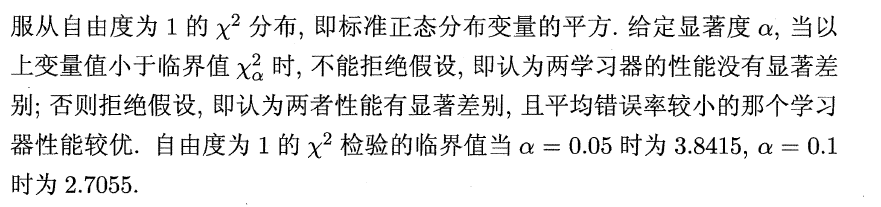
六、一种测试集两种算法——McNemar检验
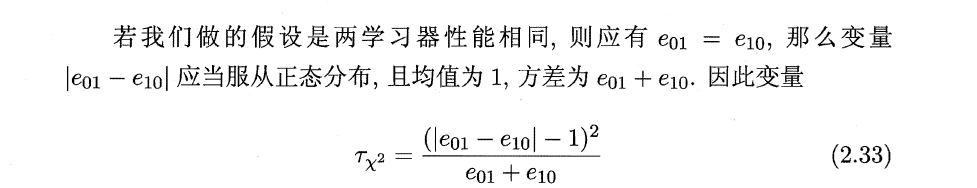
 

 这里分子减一的目的:考虑连续性矫正。

七、多个测试集多种算法——Friedman检验与Nemenyi后验检验

1、多个测试集多种算法的比较思路

(1)每个数据集分别列出两两比较的结果;

(2)基于算法排序的Friedman检验。

2、Friedman检验的思路:

(1)通过留出法或交叉验证法得到每个算法在每个数据集的测试结果:
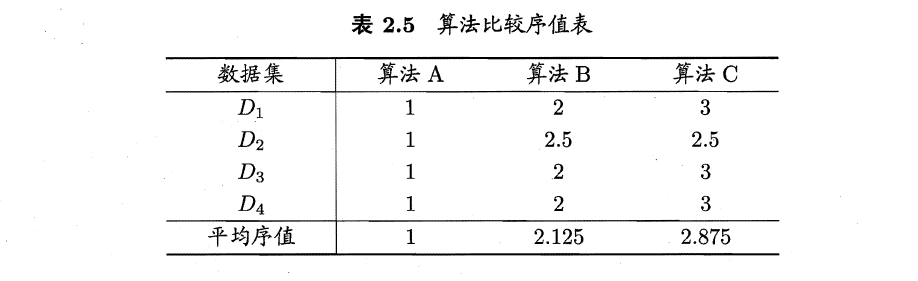
 (2)原始Friedman检验
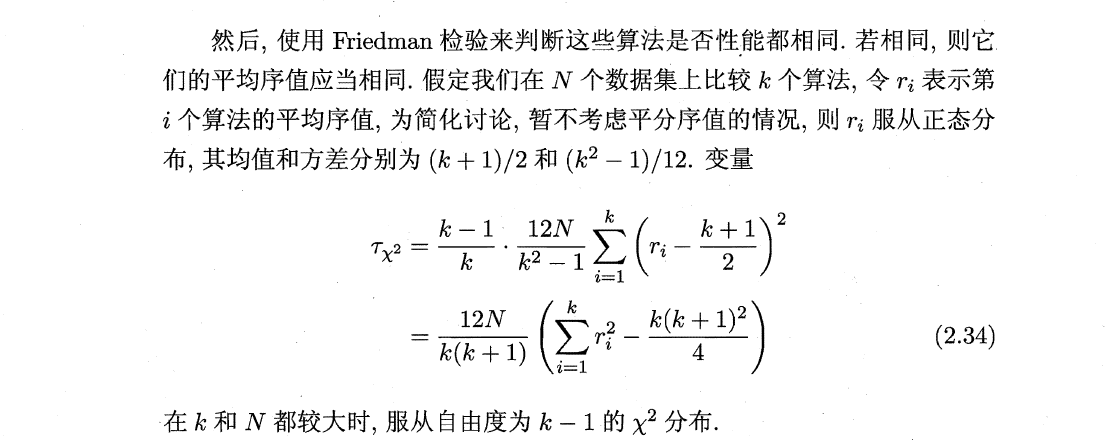
 根据卡方分布性质便可确定临界值。

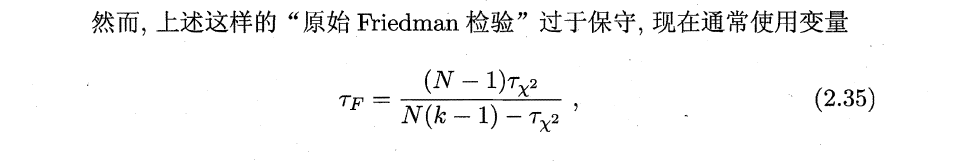
(3)Friedman检验
 

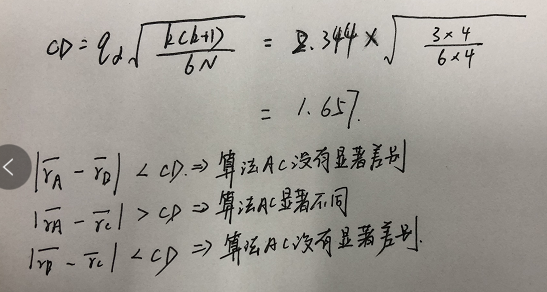
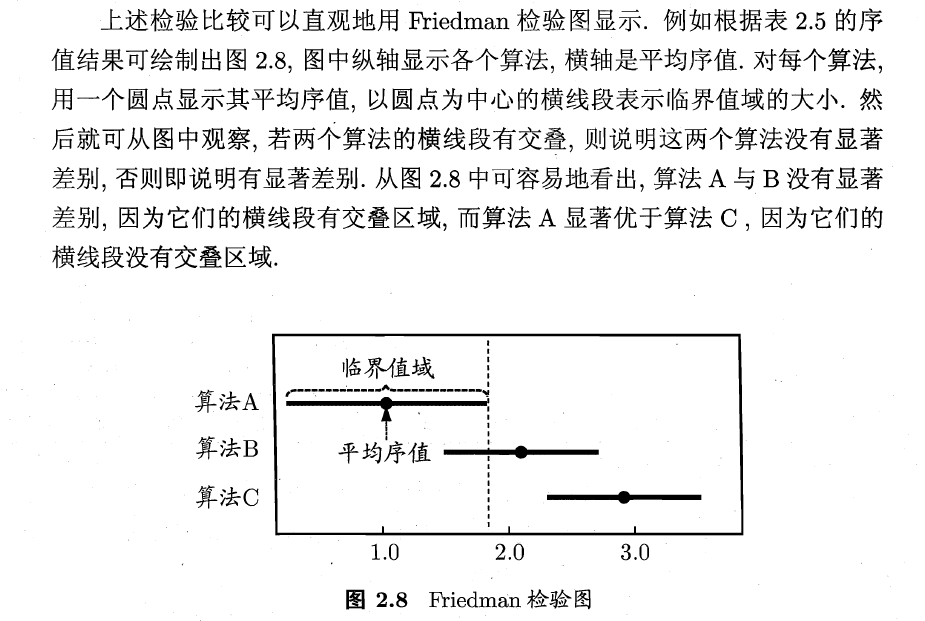
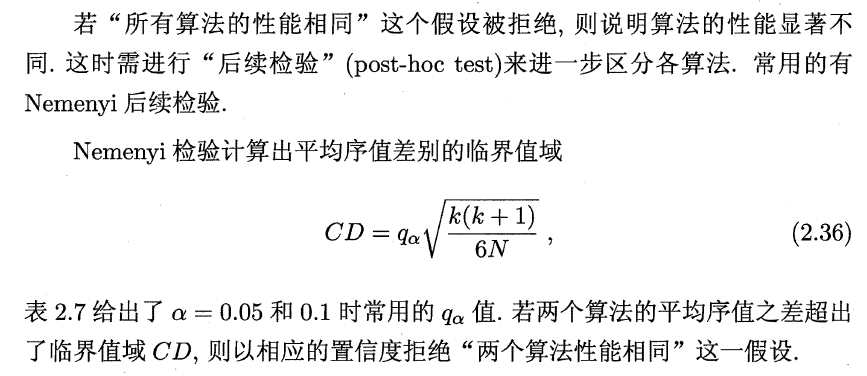
 (4)Nemenyi后续检验
 (5)例子
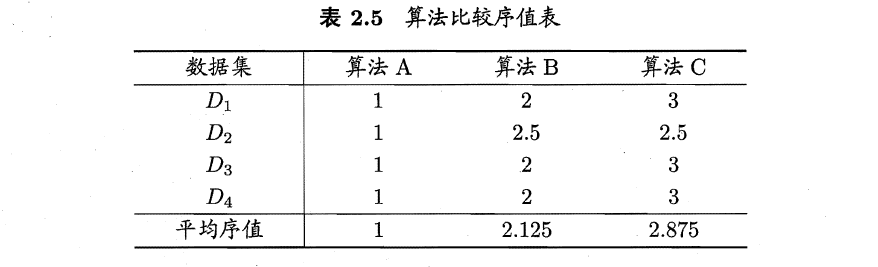
 

 1)根据式
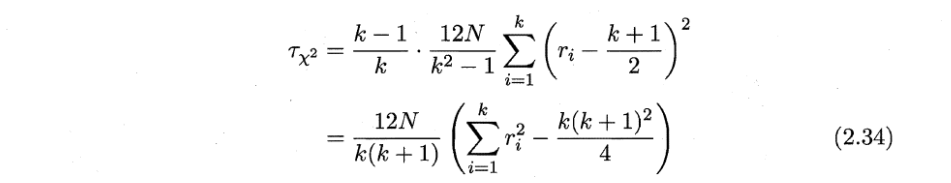
 计算得
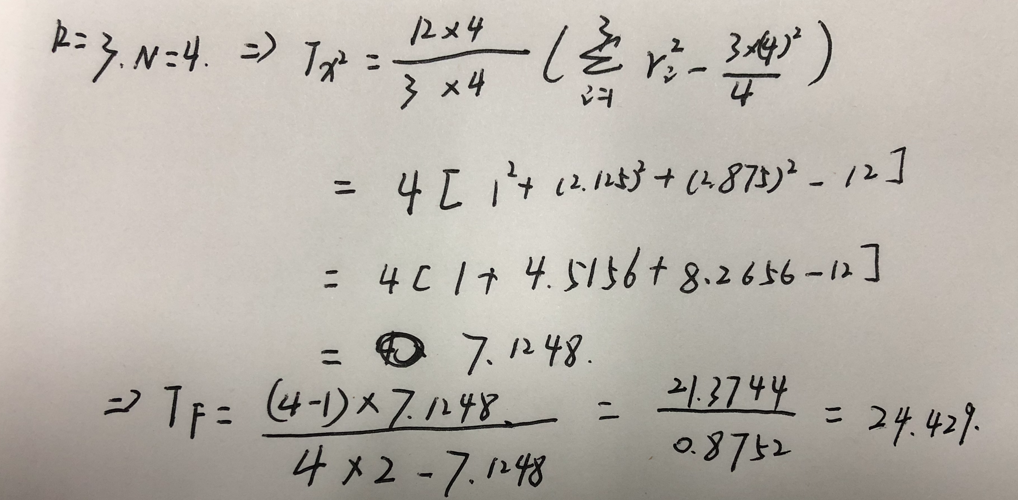
 2)与k=3对应得临界值对比,发现其远远大于临界值,拒绝算法性能相同的原假设。
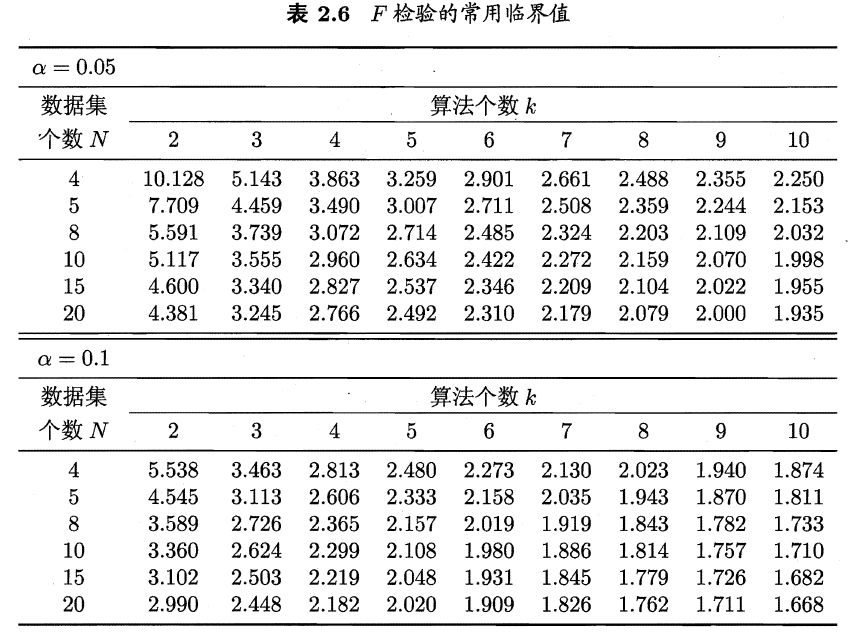
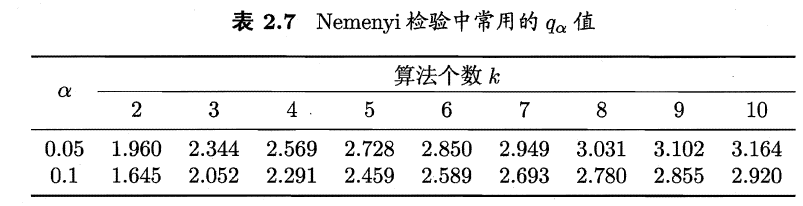
 3)Nemenyi后续检验


《西瓜书+统计学习方法》第一章-误差评估与检验 1 模型评估与选择 1.1 经验误差 1.2.1 精确度 Acc = 1-a/m 1.2.2 错误率 Error=a/m 1.2.3 欠拟合和过拟合 欠拟合:增加训练次数。 过拟合:无法彻底解决,只能缓解。 1.2.4 模型选择 对候选模型进行泛化误差评估,选择泛化误差最小的模型。 1.2 评估方法 1.2.1 留出法 按比例留出部分数据做测试集数据。 多次留出法,取平均值: 过多,变成以全部数据集D做训练,少量的测试集T不能正确评估。 过少,训练集数据因每次... 阅读详情

相关推荐

机器学习西瓜书 --- 评估方法或数据集划分方法

评估的方法 留出法 hold-out 直接将数据集划分为两个互斥的集合,其中一个集合留作训练集合S,另一个作为测试集合T。在S上训练出模型后,用T来评估其测试误差,作为对泛化误差的评估。 分层采样 保留类别的采样称为分层采样。 交叉验证法 cross validati...

杨鑫newlife的专栏 1355

西瓜书第二章-比较检验

有了实验评估方法和性能度量,看似就可以比较不同方法的效果了,但是这是不严谨的。首先我们希望比较的是泛化性能,可能与测试集上的结果不同,这就需要用到统计假设检验,基于假设检验结果我们可推断出,若在测试集上观察到学习器A比B好,则A的泛化性能是否在统计意义上优于B,以及这个结论的把握有多大。以下介绍两种最基本的假设检验,为便于讨论,本节默认使用错误率为性能度量。很多时候要经过多次留出法或者交叉验证法进行多次训练/测试,这样就会有多个测试错误率。假设得到了k个测试错误率,1~k,平均错误率和方差可求出 可以使用T

Misaka_____的博客 634

西瓜书-西瓜数据集2.0

csv格式,u-f8编码

西瓜书笔记(二):模型评估与选择

文章目录前言一、模型评估的需要二、测试集的构建方法1.留出法2.交叉验证法总结 前言 去年这个时候考研学习实在是太枯燥了开始重新看的西瓜书,一年都过去了还是没看完嘿嘿,但是考研倒是上岸了。打算最近把看过的内容补一下笔记,就记在这里了,写的什么地方有问题或者路过的好兄弟有什么见解希望不吝赐教。 一、模型评估的需要 在实际应用的机器学习问题上,无论是在训练集上还是新样本上,模型输出的结果和真实值总是有一定的差异存在的。评判模型的一个重要指标便是模型的正确率/错误率(acc/err),但是只通过模型在训练集上的

chenotk的博客 367

电动汽车整车控制器 UDS诊断功能开发调试优化方法

摘要:通过某电动汽车VCU开发过程中,UDS诊断功能的调试,发现一些测试中存在的问题,比如覆盖度不够、效率低下等,提出了相应的优化方法,并经过测试验证其可行性,此方法亦可推广应用至BMS、HCM等其他控制器的UDS诊断开发调试过程中。希望能给相关技术人员带来参考和帮助。

qq_43011586的博客 2143

CARLA 0.9.15从零开始:环境搭建与基础场景实战指南

本文是CARLA 0.9.15从零开始的完整环境搭建与基础运行教程。详细介绍了在Linux系统下配置Python环境、下载安装CARLA核心软件包、启动服务器以及运行第一个基础场景的步骤。重点演示了如何通过Python客户端脚本生成随机车流,并手动控制EGO车辆在仿真城市中行驶,为自动驾驶算法开发构建了坚实的仿真测试基础。

weixin_29053383的博客 783

西瓜书——模型评估与选择

西瓜书——模型评估与选择

zjw120的博客 1058

航天仿真必看:如何用SOFA库实现高精度GCRS-ITRS坐标转换?避坑指南

本文深入解析了航天仿真中高精度GCRS-ITRS坐标转换的关键技术,重点介绍了SOFA库在天球系与轨道系转换中的权威应用。通过对比传统方法的误差来源,详细阐述了SOFA库的转换算法优势、工程实现步骤及误差控制策略,为航天器轨道仿真提供毫米级精度的解决方案。

7h6j5k4l3的博客 850

Python机器学习:从零基础到项目实战

当您翻开此书,您正踏入一场数据与智慧的修行。机器学习,并非冰冷的符码,而是机器模拟人类洞察世界的法门。本书将带您,以Python为舟,泛游于算法之海。我们不只传授“术”,更探求其后的“道”——从数据的生灭流转中观照规律,于模型的迭代演进里体悟得失。愿您合上书卷时,收获的不仅是驾驭数据的技能,更有一双洞悉复杂、化繁为简的“智慧之眼”。现在,让我们一同启程。

YunWisdom 974

【研发日记】Matlab/Simulink自动生成代码(二)——五种选择结构实现方法

相比C文本类编程语言,Simulink图形化编程语言的优势是逻辑思路和数据流清晰了很多,劣势是程序执行的时序不明确,而且各个模块的配置使编程的灵活度下降了不少,在使用习惯上面总感觉有各种限制。本文就是拆解Simulink中最基础的几个编程模块,发扬它的优势,避开劣势。

Mr.Cssust的博客 3853

YOLOv13添加DRB模块map暴涨12.33!准确率提升8.56!召回率提升15.66

本文介绍了在YOLOv13模型中添加DRB模块的改进方法。实验结果显示,添加DRB模块后模型性能显著提升,mAP暴涨12.33%,准确率提升8.56%。文章详细说明了移植过程,包括创建yolov13-DRB.yaml配置文件、修改tasks.py和__init__.py文件,以及引入UniRepLKNet模块的具体实现。其中重点描述了GRNwithNHWC、NCHWtoNHWC等核心组件的实现细节,并提供了完整的模型结构配置代码。这些改进使得YOLOv13模型在保持原有架构优势的同时,获得了更强大的特征提取

FJN110的博客 2822

学习之路 | 《机器学习》西瓜书白话学习笔记-第1~7章

即如果在m个样本中有a个样本分类错误,则错误率E=a/m;相应的1-a/m称为“精度”(accuracy),即“精度=1-错误率”,更一般地,我们把学习器的实际预测输出与样本的真实输出之间的差异称为“误差”(error)学习器在训练集上的误差称为“训练误差”(trainingerror)或“经验误差”(empirical error),在新样本上的误差称为“泛化误差”(generalization)留出法 交叉验证法 自助法。.........

uuyymilkyl的博客 1132

PX4从放弃到精通(二十一):使用git管理PX4代码

文章目录前言一、设置git密钥二、将代码上传至gitee 前言 Ubuntu 18.04 PX4 1.11.3 由于github有时网速较慢,本文使用gitee。 一、设置git密钥 ssh-keygen -t rsa -C “your_email@youremail.com” your_email@youremail.com为自己注册的gitee账户邮箱.设置路径与密码时,也直接回车不设置,如下图,密钥生成的位置在红框处. 在密钥目录下按Ctrl+H显示隐藏文件,进入.ssh文件夹用gedit打开id

超维空间科技的博客 3480

西瓜书 数据集3.0α

编号,密度,含糖率,好瓜 1,0.697,0.46,是 2,0.774,0.376,是 3,0.634,0.264,是 4,0.608,0.318,是 5,0.556,0.215,是 6,0.403,0.237,是 7,0.481,0.149,是 8,0.437,0.211,是 9,0.666,0.091,否 10,0.243,0.267,否 11,0.245,0.057,否 12,0.343,...

AsajuHuishi的博客 7397

20_文件系统的制作 -JFFS2

JFFS2 文件系统是通过工具 mkfs.jffs2 将文件系统目录制成映像文件。制作工具mkfs.jffs2 需要编译 zhb 库和 mtd-utils,下面详细介绍其制作过程

Leon的博客 549

Central Finance 全景解析:用 SAP S/4HANA 构建跨系统的财务中台与渐进式转型路径

Central Finance 是基于 SAP S/4HANA 的一种部署与应用场景:在不打断现有异构源系统运营的前提下,把多套 SAP 与非 SAP 系统中的财务与管理会计数据实时/准实时复制到一套中心化的 SAP S/4HANA 中,作为统一的记账与分析底座,逐步把选定的财务流程(如预算控制、付款、固定资产结账等)迁入中心系统。这让企业既能快速获得统一报表与统一核算结构,又为未来的整体迁移留出了弹性路径。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 398

西瓜书读书笔记整理(三)—— 第二章 模型评估与选择

西瓜书第二章笔记

Smileyan's blog 1万+

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

机器学习:西瓜书 模型评估与选择 学习笔记

把学习器实际预测输出与样本的真实输出之间的差异称为误差。学习器在训练集上的误差称为训练误差或经验误差;学习器在新样本上的误差称为泛化误差。

hanmo22357的博客 864

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

第二章:模型评估与选择

本系列文章仅为个人学习周志华老师西瓜书和吴恩达老师深度学习课程的学习笔记,不做任何商业传播用途!若发现有雷同,不是巧合。csdn的编辑器真的很难用。。

cherryc_的博客 1347

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

机器学习西瓜书(周志华)学习笔记(3)-模型评估与选择(下)

       机器学习种性能比较是个很复杂的问题,需要考虑的因素很多。那么如何对单个或多个学习器在不同或相同测试集上的性能度量结果做比较呢?这就是比较检验。偏差与方差是解释学习器泛化性能的一种重要工具。                                                                                      4. 比较检验    ...

wynlnlhhjy的博客 1598

《西瓜书》笔记02:模型评估和选择

1. 经验误差与过拟合训练误差:学习器在训练集上的误差。泛化误差:学习器在新样本上的误差。希望得到泛化误差小的学习器,但能做的是让训练误差尽量小。为了达到这个目的,应该从训练样本中尽可能学习出适用于所有潜在样本的普遍规律,这样才可遇到新样本正确判断。过拟合:当学习器把训练样本学得太好了的时候,很可能已经把训练样本的一些特点,当成了所有潜在样本都具有的一般性质,导致泛化能力下降。欠拟合:对训练样本的一

鸟恋旧林的博客 2494

西瓜书《机器学习》学习笔记 二 模型评估与选择(三) 比较检验 方差 偏差

目录     4、比较检验 假设检验 交叉验证t检验 McNemar检验 Friedman检验与Nemenyi后续检验 5、偏差和方差   4、比较检验 这部分主要介绍当我们使用某种实验评估方法测得学习器的某个性能度量结果时,我们要如何进行比较,判断学习器的优劣。也就是性能比较,性能比较主要有以下几个重要因素: 我们一开始就应该很明确,我们希望比较的是学习器的泛化性能,但性...

weixin_40795591的博客 2489

机器学习笔记2.模型评估于选择----教材周志华西瓜书

2.1经验误差和过拟合 错误率:分类错误的样本数占样本总数的比例。m个样本中有a个样本分类错误,E=a/m。 精度:1-a/m  即1-E 误差:实际预测输出与样本真实的输出之间的差异。 训练误差又叫经验误差:学习器在训练集上的误差。 测试误差:学习器在测试集上的误差。 泛化误差:学习器在新样本上的误差。 我们希望得到的是泛化误差小的学习器。但我们实际能做的是努力使经验误差最小化

lanyifenghua的博客 624

西瓜书难点讲解

https://datawhalechina.github.io/pumpkin-book/#/chapter1/chapter1

YxSsx的博客 1016

【机器学习】模型评估与选择-西瓜书第二章知识点整理

前一段时间在看书的过程中并没有做笔记,知识点忘得很快。故此,在学习周华志老师的《机器学习》一书时,计划每两天学习一个章节并结合吴恩达机器学习的内容做笔记分享到博客上。本文内容非本人原创,只是为了满足自己的学习需要进行的系统整理。

tellyW的博客 1295

西瓜书_2、模型评估与选择、处理数据集、性能度量选标准、假设检验比较泛化能力、偏差方差决定泛化误差

模型评估与选择 我们要明确一个问题,好模型==好泛化、好模型==好泛化、好模型==好泛化。本文的目的便是讲述如何得到泛化能力好的模型。 一、处理数据集 目的:合理的处理数据集,使测试数据得出的结论尽可能的等于实际的值。没有免费的午餐定理对试验评估方法同样适用。 首先,一份数据集大体上是三部分,我们要分成: 测试数据(做泛化误差的近似),至少要30个样例。 训练数据(常见是将2/3~4...

qq_39125908的博客 1103
上一篇: K-Fold Cross Validation
下一篇: 【西瓜书阅读笔记】03线性模型
Checkmate9949
博客等级 码龄5年 6176粉丝 43原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值