正则化从理论到实践专题

机器学习基础算法在线练习——线性回归&逻辑回归 打开jupyter示例函数(生成5*5。 阅读详情

1、资料搜集

机器学习之正则化(Regularization)(读者反馈很好)

史上最全面的正则化技术总结与分析--part1

史上最全面的正则化技术总结与分析--part2

正则化详解机器学习中的正则化(Regularization)(读者反馈很好)
深度学习中的正则化技术(附Python代码) (理论+实现)

吴恩达机器学习课程笔记+代码实现(9)Python实现逻辑回归和正则化(Programming Exercise 2)

逻辑回归损失函数与最大似然估计

2、本人总结

     我们还是先思考一个问题,为什么会出现正则化这个名词。我们在讲解最小二乘法的时候,会遇到过拟合(又叫“高方差”)的现象。简单说过拟合现象,使用高维函数进行数据拟合时,为了使误差达到最下,拟合后的函数对当前训练数据误差比较小。但是当新的数据加入的时候,拟合的函数性能表现很差。在这里说到过拟合,就不得不说一下欠拟合(又叫“高偏差”)。欠拟合其实就是我们假设的函数模型是低维,在根据数据进行拟合的时候,不能很好得到数据本质特性。

image

image

       图一(上下两张第一幅图)表现出来的就是“欠拟合”现象,我们可以看到后面的数据开始趋于平缓,而我们使用一维函数拟合的结果,后面数据呈现上升的趋势;

       图二(上下两张第二幅图)是非常正确的表达了数据所表示的模型;

       图三(上下两张第三幅图)则就是“过拟合”线性,拟合的函数为了适应数据,所有的函数都经过了训练数据,对新数据表现性能会很差;

       那么我们如何解决过拟合这个现象呢,主要有两种方法:尽量减少选取变量的数量;加入正则化。其中减少选取变量的数量,说白了就是我们人为经过对数据进行分析,将一些对判定结果不重要的特征信息去除,来达到减少变量数量目的。但是这样也会造成模型假设的不精确,例如,我们要拟合一下每天进出北京车的数量,由于出现过拟合,我们可能认为河北、天津等北京周边信息对解决该问题的意义不是很大,而删除该特征信息。但是有的时候确实会存在,周边地区政策或者其它原因,导致进出北京车辆的数目增加。因此,删除该特征信息,会造成降低模型的精确度。说了那么多第一种方法,就让我详细说一下正则化方法吧。

2.1 概念

      正则化又称为规则化、权重衰减技术,在不同的方向上有不同的叫法,在数学中叫做范数。例如L1和L2范数,统计学领域叫做惩罚项、罚因子,以信号降噪为例:x(i)^{*} = \begin{matrix} argmin\\ x(i) \end{matrix} \left \{ F(x(i))= \frac{1}{2} \left \|y(i)-x(i) \right \|_{2}^{2} + \lambda R(x(i)) \right \}

其中,x(i)为原始信号,或者是小波或者傅里叶等系数,R(x(i))则为惩罚函数,\lambda是正则项,y(i)是传感器采集到含噪声的信号,I = {0, ..., N - 1},其中N为信号点,x(i)^{*}为降噪后输出。在图像中公式也是类似的。

        在这里给出范数的数学公式,其实就是公式的一种叫法,像我们经常用到的所有变量绝对值求和就是L1范数。所以其实大家都很熟悉,不要听范数就开始有点懵。

(1)P范数:^{L_{p}} = \left ( \sum_{i = 1}^{n} \left | x_{i} \right |^{p} \right )^{\frac{1}{p}}

(2)L0范数:表示向量中非零元素的个数(即为稀疏度)

(3)L1范数:^{L_{1}} = \left ( \sum_{i = 1}^{n} \left | x_{i} \right |\right )

(4)L2范数:^{L_{2}} = \left ( \sum_{i = 1}^{n} \left | x_{i} \right |^{2} \right )^{\frac{1}{2}}

(5)无穷范数:所有向量元素绝对值最大值\left \| x \right \|_{\infty } = \begin{matrix} max\\i \end{matrix} = |x_{i}|

(6)负无穷范数:所有向量元素绝对值最小值\left \| x \right \|_{-\infty } = \begin{matrix} min\\i \end{matrix} = |x_{i}|

      向量长度为2维,下图的表示

        向量长度为3维,则表示为下图:

       从上图可以看到P值越小则越贴近坐标轴,当P值越大时菱角越明显。因此, 不同的范数会对应不同的特性,我们在使用的时候需要根据具体情况进行选择。

2.2 公式推导

      在线性回归的求解过程,我们一般运用两种方法,一种基于梯度下降方法,一种基于正规方程。首先我们先引入一个正则化方程:J(\theta ) = \frac{1}{2m} \left [ \sum_{i = 1}^{m} \left ( h_{\theta } (x^{(i)}) - y^{(i)} \right )^{2} +\lambda \sum_{j = 1}^{n} \theta _{j}^{2} \right ],其中\begin{matrix} min\\\theta \end{matrix}J(\theta )

(1)梯度下降方法

因为我们在进行正则化的时候,一般会去掉第0项,所以\frac{\partial J(\theta )}{\partial \theta _{0}} = \frac{1}{m} \left [ \sum_{i = 1}^{m} \left ( h_{\theta } (x^{(i)}) - y^{(i)} \right )*x_{0}^{i} \right ]

对于j从1到m项的偏导数:\frac{\partial J(\theta )}{\partial \theta _{j}} = \frac{1}{m} \left [ \sum_{i = 1}^{m} \left ( h_{\theta } (x^{(i)}) - y^{(i)} \right )*x_{j}^{i} +\lambda \sum_{i=1}^{m}\theta _{i} \right ]

因此,每个变量的更新方式为:\theta _{0}: \theta _{0} - \alpha \frac{\partial J(\theta )}{\partial \theta _{0}}以及\theta _{j}: \theta _{j} - \alpha \frac{\partial J(\theta )}{\partial \theta _{j}}

(2)正则方程

将问题转化为矩阵形式:

X = \begin{bmatrix} (x^{(1)})^{T}\\\cdot \\ \cdot \\ \cdot \\(x^{(m)})^{T} \end{bmatrix}_{m*n+1}        y = \begin{bmatrix} (y^{(1)})^{}\\\cdot \\ \cdot \\ \cdot \\(y^{(m)})^{} \end{bmatrix}

其中优化的是\begin{matrix} min\\\theta \end{matrix}J(\theta )

我们在最小二乘中,已经退到过矩阵的运算的方法,具体看链接。但这里多了一项正则项,所以方程转化为:

\theta = \left ( X^{T}X + \lambda \begin{bmatrix} 0 & 0& 0& .& .& .& 0\\ 0 & 1& 0& .& .& .& 0\\ 0 & 0& .& 0& .& .&0\\ 0 & 0& 0& .& 0& .&0\\ 0 & 0& 0& 0& .& 0&0\\ 0 & 0& 0& 0& 0& 1&0\\ 0 & 0& 0& 0& 0& 0&1\\ \end{bmatrix}_{(n+1) * (n+1)} \right )^{-1}X^{T}y

我们知道在样本较少的情况下,导致特征数量大于样本数量,那么矩阵X^{T}X是不可逆或者说矩阵是退化矩阵,但是通过加入正则化后,可以证明矩阵

\left ( X^{T}X + \lambda \begin{bmatrix} 0 & 0& 0& .& .& .& 0\\ 0 & 1& 0& .& .& .& 0\\ 0 & 0& .& 0& .& .&0\\ 0 & 0& 0& .& 0& .&0\\ 0 & 0& 0& 0& .& 0&0\\ 0 & 0& 0& 0& 0& 1&0\\ 0 & 0& 0& 0& 0& 0&1\\ \end{bmatrix}_{(n+1) * (n+1)} \right )

是完全可逆的。因此,通过加入正则化,就可以在相对较小的训练集里有很多特征情况下,来实现数据拟合。

2.3 代码实现

      上面讲了很多理论知识,下面直接上代码出结果。代码中要用到的相关数据,请在此链接中下载,或者自行下载吴恩达老师机器学习课程中公布的数据。

(1)源代码

import numpy as np
import pandas as pd
import matplotlib as mpl
import matplotlib.pyplot as plt
import seaborn as sns
sns.set(style="whitegrid",color_codes=True)

#样本训练数据为申请入学的学生两次测评的成绩,以及最后是否被录取的结果。

data = pd.read_csv('ex2data1.txt', header=None, names=['Exam 1', 'Exam 2', 'Admitted'])
data.head()

positive = data[data['Admitted'].isin([1])]
negative = data[data['Admitted'].isin([0])]

#数据可视化
#创建两个分数的散点图,并使用颜色编码来可视化,如果样本是正的(被接纳)或负的(未被接纳)
fig, ax = plt.subplots(figsize=(10,6))
ax.scatter(positive['Exam 1'], positive['Exam 2'], s=50, c='b', marker='o', label='Admitted')
ax.scatter(negative['Exam 1'], negative['Exam 2'], s=50, c='r', marker='x', label='Not Admitted')
ax.legend()
ax.set_xlabel('Exam 1 Score')
ax.set_ylabel('Exam 2 Score')

#sigmoid 函数
def sigmoid(z):
    return 1 / (1 + np.exp(-z))


nums = np.arange(-10, 10, step=0.01)

fig, ax = plt.subplots(figsize=(8,6))
ax.plot(nums, sigmoid(nums), 'r')

#代价函数:
def cost(theta, X, y):
    theta = np.matrix(theta)
    X = np.matrix(X)
    y = np.matrix(y)
    first = np.multiply(-y, np.log(sigmoid(X * theta.T)))
    second = np.multiply((1 - y), np.log(1 - sigmoid(X * theta.T)))
    return np.sum(first - second) / (len(X))

#对数据稍作处理,同exercise1
# add a ones column - this makes the matrix multiplication work out easier
data.insert(0, 'Ones', 1)

# set X (training data) and y (target variable)
cols = data.shape[1]
X = data.iloc[:,0:cols-1]
y = data.iloc[:,cols-1:cols]

# convert to numpy arrays and initalize the parameter array theta
X = np.array(X.values)
y = np.array(y.values)
theta = np.zeros(3)

#计算一下初始化参数的cost
cost(theta, X, y)

#gradient descent(梯度下降)
def gradient(theta, X, y):
    theta = np.matrix(theta)
    X = np.matrix(X)
    y = np.matrix(y)
    
    parameters = int(theta.ravel().shape[1])
    grad = np.zeros(parameters)
    
    error = sigmoid(X * theta.T) - y
    
    for i in range(parameters):
        term = np.multiply(error, X[:,i])
        grad[i] = np.sum(term) / len(X)
    
    return grad

#使用 scipy.optimize.minimize 去拟合参数
import scipy.optimize as opt
res = opt.minimize(fun=cost, x0=theta, args=(X, y), method='Newton-CG', jac=gradient)
print(res)

#预测与验证
def predict(theta, X):
    probability = sigmoid(X * theta.T)
    return [1 if x >= 0.5 else 0 for x in probability]

final_theta =np.matrix(res.x)
predictions = predict(final_theta, X)
correct = [1 if ((a == 1 and b == 1) or (a == 0 and b == 0)) else 0 for (a, b) in zip(predictions, y)]
accuracy = (sum(map(int, correct)) % len(correct))
print ('accuracy = {0}%'.format(accuracy))

#寻找决策边界
coef = -(res.x / res.x[2])  # find the equation
print(coef)

positive = data[data['Admitted'].isin([1])]
negative = data[data['Admitted'].isin([0])]

fig, ax = plt.subplots(figsize=(10,6))
ax.scatter(positive['Exam 1'], positive['Exam 2'], s=50, c='b', marker='o', label='Admitted')
ax.scatter(negative['Exam 1'], negative['Exam 2'], s=50, c='r', marker='x', label='Not Admitted')
ax.legend()
ax.set_xlabel('Exam 1 Score')
ax.set_ylabel('Exam 2 Score')

x = np.arange(30,100, step=0.1)
y = coef[0] + coef[1]*x
plt.plot(x, y, 'grey')


'''
第二部分:逻辑回归+正则化
说明:这部分也要用到上一部分中的函数,所以要一起运行
'''


#正则化逻辑回归
data2 = pd.read_csv('ex2data2.txt',header=None,names = ['test1','test2','accepted'])
data2.head()

positive = data2[data2['accepted'].isin([1])]
negative = data2[data2['accepted'].isin([0])]

fig, ax = plt.subplots(figsize=(8,6))
ax.scatter(positive['test1'], positive['test2'], s=50, c='b', marker='o', label='tccepted')
ax.scatter(negative['test1'], negative['test2'], s=50, c='r', marker='x', label='rejected')
ax.legend()
ax.set_xlabel('Test1 Score')
ax.set_ylabel('Test2 Score')

#feature mapping(特征映射)
def feature_mapping(x, y, power, as_ndarray=False):

    data = {"f{}{}".format(i - p, p): np.power(x, i - p) * np.power(y, p)
                for i in np.arange(power + 1)
                for p in np.arange(i + 1)
            }

    if as_ndarray:
        return pd.DataFrame(data).as_matrix()
    else:
        return pd.DataFrame(data)
    
x1 = np.array(data2.test1)
x2 = np.array(data2.test2)

d = feature_mapping(x1, x2, power=6)
print(d.shape)
d.head()

# set X and y (remember from above that we moved the label to column 0)
cols = d.shape[1]
X2 = d.iloc[:,0:cols]
y2 = data2.iloc[:,-1]

# convert to numpy arrays and initalize the parameter array theta
X2 = np.array(X2.values)
y2 = np.array(y2.values)
theta2 = np.zeros(d.shape[1])
print(X2.shape)

#regularized cost(正则化代价函数)
def regularized_cost(theta, X, y, l = 1):
#     '''you don't penalize theta_0'''
    theta_j1_to_n = theta[1:]
    regularized_term = (l / (2 * len(X))) * np.power(theta_j1_to_n, 2).sum()

    return cost(theta, X, y) + regularized_term
#正则化代价函数
regularized_cost(theta2, X2, y2)

#regularized gradient(正则化梯度)
def gradientReg(theta, X, y, l = 1):
    theta = np.matrix(theta)
    X = np.matrix(X)
    y = np.matrix(y)
    
    parameters = int(theta.ravel().shape[1])
    grad = np.zeros(parameters)
    
    error = sigmoid(X * theta.T) - y
    
    for i in range(parameters):
        term = np.multiply(error, X[:,i])
        
        if (i == 0):
            grad[i] = np.sum(term) / len(X)
        else:
            grad[i] = (np.sum(term) / len(X)) + ((l/ len(X)) * theta[:,i])
    
    return grad

gradientReg(theta2,X2,y2,l=1)

#使用 scipy.optimize.minimize 去拟合参数

import scipy.optimize as opt
#print('init cost = {}'.format(regularized_cost(theta, X2, y2)))

res = opt.minimize(fun=regularized_cost, x0=theta2, args=(X2, y2), method='Newton-CG', jac=gradientReg)
print(res)

theta_min =np.matrix(res.x)
predictions = predict(theta_min, X2)
correct = [1 if ((a == 1 and b == 1) or (a == 0 and b == 0)) else 0 for (a, b) in zip(predictions, y2)]
accuracy = (sum(map(int, correct)) % len(correct))
print ('accuracy = {0}%'.format(accuracy))

#调用sklearn的线性回归包

from sklearn import linear_model
model = linear_model.LogisticRegression(penalty='l2', C=1.0)
model.fit(X2, y2.ravel())

linear_model.LogisticRegression(C=1.0, class_weight=None, dual=False, fit_intercept=True,
          intercept_scaling=1, max_iter=100, multi_class='warn',
          n_jobs=None, penalty='l2', random_state=None, solver='warn',
          tol=0.0001, verbose=0, warm_start=False)

print(model.score(X2, y2))

(2)实验结果

(3)关键部分详细讲解

数据分布

data = pd.read_csv('ex2data1.txt', header=None, names=['Exam 1', 'Exam 2', 'Admitted'])
data.head()

数据可视化

Sigmoid函数

一般我们比较常见的Sigmoid函数为:g(z) = \frac{1}{1 + e^{-z}},在这里我们假设函数为h_{\theta } (x)= \frac{1}{1 + e^{-\theta ^{T}X}}

def sigmoid(z):
    return 1 / (1 + np.exp(-z))


损失函数(关于此函数怎么来的请看链接)

J(\theta ) = \frac{1}{m}\sum_{i = 1}^{m} \left [ -y^{(i)}log(h_{\theta }(x^{(i)})) - (1 - y^{(i)})log(1 - h_{\theta }(x^{(i)})) \right ]

def cost(theta, X, y):
    theta = np.matrix(theta)
    X = np.matrix(X)
    y = np.matrix(y)
    first = np.multiply(-y, np.log(sigmoid(X * theta.T)))
    second = np.multiply((1 - y), np.log(1 - sigmoid(X * theta.T)))
    return np.sum(first - second) / (len(X))

gradient descent(梯度下降)

在这里使用批量梯度下降方法,并将其转化为向量方法,则\frac{1}{m}X^{T}(Sigmoid(X^{T}\theta ) - y)转化为\frac{\partial J(\theta)}{\partial \theta _{j}} = \frac{1}{m}\sum_{i =1}^{m}(h_{\theta}(x^{(i)}) - y^{i})x_{j}^{i}

#计算一个梯度步长
def gradient(theta, X, y):
    theta = np.matrix(theta)
    X = np.matrix(X)
    y = np.matrix(y)
    
    parameters = int(theta.ravel().shape[1])
    grad = np.zeros(parameters)
    
    error = sigmoid(X * theta.T) - y
    
    for i in range(parameters):
        term = np.multiply(error, X[:,i])
        grad[i] = np.sum(term) / len(X)
    
    return grad


第二部分:正则化逻辑回归

数据格式

数据可视化

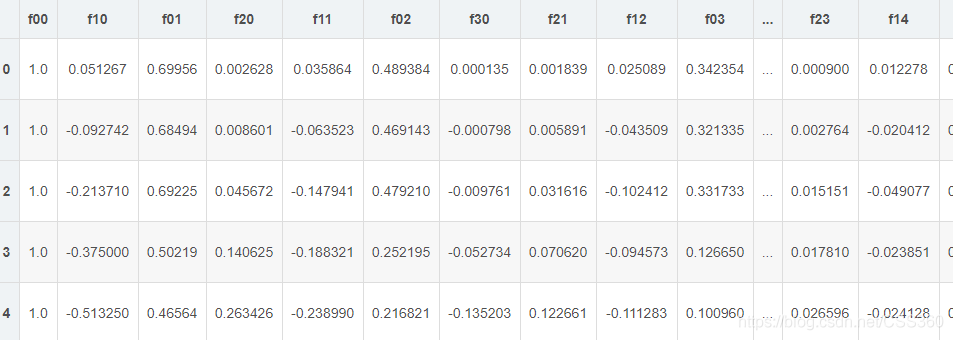
feature mapping(特征映射)

mapFeature = \begin{bmatrix} 1\\ x_{1}\\ x_{2}\\ x_{1}^{2}\\ x_{1}x_{2}\\ x_{2}^{2}\\ x_{1}^{3}\\ x_{1}*x_{2}^{5} \\ x_{1}*x_{2}^{6} \\ \end{bmatrix}

def feature_mapping(x, y, power, as_ndarray=False):

    data = {"f{}{}".format(i - p, p): np.power(x, i - p) * np.power(y, p)
                for i in np.arange(power + 1)
                for p in np.arange(i + 1)
            }

    if as_ndarray:
        return pd.DataFrame(data).as_matrix()
    else:
        return pd.DataFrame(data)

特征映射对应的数据:
regularized cost(正则化代价函数)

J(\theta ) = \frac{1}{m}\sum_{i = 1}^{m} \left [ -y^{(i)}log(h_{\theta }(x^{(i)})) - (1 - y^{(i)})log(1 - h_{\theta }(x^{(i)})) \right ] + \frac{\lambda }{2m}\sum_{j =1}^{n}\theta _{j}^{2}

def regularized_cost(theta, X, y, l = 1):
#     '''you don't penalize theta_0'''
    theta_j1_to_n = theta[1:]
    regularized_term = (l / (2 * len(X))) * np.power(theta_j1_to_n, 2).sum()

    return cost(theta, X, y) + regularized_term
#正则化代价函数

regularized gradient(正则化梯度)

\frac{\partial J(\theta)}{\partial \theta _{j}} = \frac{1}{m}\sum_{i =1}^{m}(h_{\theta}(x^{(i)}) - y^{i})x_{j}^{i} + \frac{\lambda }{m}\theta _{j} \begin{matrix}\end{matrix} \begin{matrix} \end{matrix}  j\geq 1

def gradientReg(theta, X, y, l = 1):
    theta = np.matrix(theta)
    X = np.matrix(X)
    y = np.matrix(y)
    
    parameters = int(theta.ravel().shape[1])
    grad = np.zeros(parameters)
    
    error = sigmoid(X * theta.T) - y
    
    for i in range(parameters):
        term = np.multiply(error, X[:,i])
        
        if (i == 0):
            grad[i] = np.sum(term) / len(X)
        else:
            grad[i] = (np.sum(term) / len(X)) + ((l/ len(X)) * theta[:,i])
    
    return grad

了解更多关于《计算机视觉与图形学》相关知识,请关注公众号:

下载我们视频中代码和相关讲义,请在公众号回复:计算机视觉课程资料

Automatic White Balance(AWB)/Color Constancy(CC)系列论文 ISP里面有个叫自动白平衡(AWB)的算法,学术界叫色彩恒常性(CC),其实解决的是同一个问题:使得相机获取的图像和人看到的颜色是一样的。 本文主要介绍用神经网络解决该问题的方法,要想深入理解,建议读一下原论文。 有一个网站专门总结了基于学习和非学习的方法,还有各种相关数据集:http://colorconstancy.com/ 一、CCC:Convolutional Color Constancy 论文:https://arxiv.org/pdf/1507.00410.pdf 代码:未找到 论文解析: 图 阅读详情

相关推荐

Tikhonov regularization 吉洪诺夫正则化(L2正则化)

在数学,统计学和计算机科学中,特别是机器学习和反问题,正则化是为了解决不适定问题或防止过拟合而引入额外信息的过程。 1.不适定问题 图像处理中,不适定问题也称为反问题。上世纪90年代法国数学家阿达玛提出了不适定问题的概念: 一个数学物理定解问题的解存在、唯一并且稳定,则称该问题是适定的(WellPosed).如果不满足适定性概念中的上述判据中的一条或几条,称该问题是不适定的。 典型的图像处理不适定...

qq_35045096的博客 3万+

正则化理论

1.范数 在介绍正则化之前,先来了解一下范数。在数学上,范数包括向量范数和矩阵范数,向量范数表征向量空间中向量的大小,矩阵范数表征矩阵引起变化的大小。一种非严密的解释就是,对应向量范数,向量空间中的向量都是有大小的,这个大小1如何度量,就是用范数来度量的,不同的范数都可以来度量这个大小,就好比米和尺都可以度量远近一样;对于矩阵范数,我们可以通过运算 AX = B ,可以将向量X变化为B,矩阵范数就是用来度量这个变化大小的。 以下有几种向量范数的定义和含义: L - P范数 与闵可夫基距离定义一样,L-P范数

AAAA202012的博客 693

keras添加L1正则化,L2正则化和Dropout正则化及其原理

一、什么是正则化,用来干嘛的? 正则化(regularization),是指在线性代数理论中,不适定问题通常是由一组线性代数方程定义的,而且这组方程组通常来源于有着很大的条件数的不适定反问题。大条件数意味着舍入误差或其它误差会严重地影响问题的结果。 因为机器学习的理论来源于数学,正则化的概念被很好的引用到机器学习模型中,主要作用是防止模型过拟合。 我们的模型训练时,比如常见的深度学习模型,可能往往会因为神经元的数目和网络的层数过于庞大,模型具有非常强大的学习能力,但是能力过强不是一件好事,因为过分学习了训练

weixin_43918046的博客 7195

机器学习——正则化理论(Regularization Theory)

过拟合(overfitting): 产生的原因有: 1.数据量(N):N越小,越容易overfit 2.随机噪声(stochastic noise,σ2{\sigma ^{\rm{2}}}σ2 ): σ2{\sigma ^{\rm{2}}}σ2越大,越容易overfit 3.确定噪声(deterministic noise,Qf{Q_f}Qf​ ): Qf{Q_f}Qf​越大,越容易overfi...

daocaoren_的博客 1084

从贝叶斯角度深入理解正则化

一、正则化 一般来说,监督学习可以看做最小化下面的目标函数: 其中,第一项L(yi,f(xi;w)) 衡量我们的模型(分类或者回归)对第i个样本的预测值f(xi;w)和真实的标签yi之前的误差。因为我们的模型是要拟合我们的训练样本的嘛,所以我们要求这一项最小,也就是要求我们的模型尽量的拟合我们的训练数据。但正如上面说言,我们不仅要保证训练误差最小,我们更希望我们的模型测试误差小

Zxdon的专栏 2万+

29、正则化理论深度解析

本文深入解析了正则化理论的核心思想及其在机器学习中的应用,重点介绍了Tikhonov经典正则化与广义正则化理论。文章从Hadamard适定性条件出发,阐述了不适定问题的挑战,并通过引入正则化项解决过拟合与模型稳定性问题。详细推导了Tikhonov泛函的最小化过程,包括Fréchet微分、Euler-Lagrange方程求解以及基于Green函数的解结构。进一步扩展到流形正则化与半监督学习框架,结合谱图理论分析数据内在几何结构。最后讨论了正则化参数估计方法与计算机实验验证,系统展示了正则化在提升模型泛化能力方

7up55的博客 62

正则化的基础理论知识初步总结

在数学上,我们将满足以下性质的数学模型的物理现象: 解存在 解唯一 解连续依赖于初始边界条件(the solution’s behavior changes continuously with the initial conditions) 称适定问题。只要其中一个条件不满足,则称为不适定问题[1]   在数学、统计和计算机科学尤其是在机器学习和反演问题中,正则化通过引入额外的信息去解决...

zhuiyinyan5541的博客 1883

Tikhonov正则化:从理论到MATLAB实现

Tikhonov正则化是一种数学处理技巧,用于解决线性代数中的不适定问题,特别是在那些数据包含噪声或者系统模型具有多余自由度时。它通过向原问题的最小二乘目标函数中添加一个正则化项来稳定求解过程,从而避免求解过程中的数值不稳定性,确保解的唯一性和稳定性。不适定问题(Ill-posed problem)是泛函分析和数值分析中的一个重要概念,它与适定问题(well-posed problem)相对。在数学和工程学领域,一个适定问题是指对于给定的输入,其解存在、唯一并且连续依赖于输入数据的问题。

weixin_36303807的博客 3423

过拟合与正则化:理论基础与实践应用

1.背景介绍 在机器学习和深度学习领域中,过拟合和正则化是两个非常重要的概念。过拟合是指模型在训练数据上表现得很好,但在新的、未见过的数据上表现得很差的现象。正则化则是一种解决过拟合的方法,通过在模型复杂度和训练数据的误差之间寻找平衡点,来提高模型的泛化能力。 在本文中,我们将深入探讨过拟合与正则化的理论基础和实践应用。我们将从以下六个方面进行讨论: 背景介绍 核心概念与联系 核心算法原理...

AI天才研究院 780

深度插值与病态矩阵正则化MATLAB编程实践

病态矩阵是数值分析中的一个核心概念,指的是条件数较大的矩阵。在数学上,条件数衡量的是矩阵在输入发生微小变化时,输出变化的程度。具体来说,一个矩阵的条件数越大,它就越接近于不可逆,或者说它的逆矩阵如果存在,也将是非常不稳定的。这直接导致了在使用数值方法解线性方程组时,小的误差可以被放大,从而产生严重的计算误差。正则化(Regularization)技术是一种数学优化方法,它通过对目标函数增加一个或多个正则项(或惩罚项)来避免过拟合,提高模型的泛化能力。

weixin_35414260的博客 1029

开关电源|控制方式PWM、PFM、混合调制

频率调制器根据误差放大器的输出大小来改变方波信号的频率,若负载电流突然增加,输出电压 Vout随之下降,反馈电压 VFB 减小,此时误 差放大器的输出增高,频率调制器输出方波信号的频率增大,增加电感充电次数;若负载电流突然增加,输出电压Vom随之下降,反馈电压Vr减小,此时误差放大器的输出增高,PWM比较器输出方波信号的占空比增大,增加电感充电时间:若负载电流突然下降,PWM比较器输出方波信号的占空比减小,减少电感充电时间,从而稳定输出电压。它是在固定开关频率下,通过改变脉冲宽度来调节占空比的。

weixin_46969363的博客 1万+

正则化及正则化项的理解

首先了解一下正则性(regularity),正则性衡量了函数光滑的程度,正则性越高,函数越光滑。(光滑衡量了函数的可导性,如果一个函数是光滑函数,则该函数无穷可导,即任意n阶可导)。 正则化是为了解决过拟合问题。在Andrew Ng的机器学习视频中有提到(详见http://www.cnblogs.com/jianxinzhou/p/4083921.html)。解决过拟合的两种方法: 方法一:尽

晚月明的博客 8万+

从2804云台电机到桌面机械臂:一个STM32/GD32玩家的FOC驱动踩坑全记录

本文详细记录了从2804云台电机到桌面机械臂的FOC驱动开发历程,涵盖了硬件选型、驱动方案优化、软件调试等关键环节。特别分享了L6234P驱动芯片的发热问题、AS5600编码器的I2C通信陷阱以及PID调参的实战经验,为DIY爱好者提供了宝贵的参考。

weixin_26897585的博客 483

范数正则化的历史演变:从理论到实践

1.背景介绍 范数正则化(Norm regularization)是一种常用的机器学习和深度学习中的正则化方法,主要用于约束模型的复杂度,防止过拟合。在这篇文章中,我们将从理论到实践的角度详细讲解范数正则化的历史、核心概念、算法原理、具体操作步骤以及代码实例。 1.1 背景介绍 1.1.1 正则化的概念与历史 正则化(Regularization)是一种在训练机器学习模型时添加约束的方法,...

AI天才研究院 1004

把对讲门铃(控制底楼铁门)接入米家服务器

今天讲个跟SDR或者无人机无关的东西,技术含量不高,但是方便了我的生活。 现在家门有智能锁,汽车也可以远程解锁发动,NFC门禁也可以用某些手机复制,唯独楼下的铁门,必须用老式对讲门铃控制。 也就是说其它钥匙都可以不带,就剩这个钥匙还必须随身携带。 另外有时候人不在家,不能开楼下铁门,快递员也没法把东西送上楼。 ......

老邵的开源世界 6552

ICNN实现入侵检测的思路与源码(CIC-IDS-2017)

基于ICNN实现入侵检测,可用于现实网络

t1274171989的博客 8415

深入剖析L1正则化:理论与实践

1.背景介绍 L1正则化是一种常用的正则化方法,主要用于解决高维线性回归和逻辑回归等问题中的过拟合问题。在这篇文章中,我们将深入剖析L1正则化的理论基础、算法原理以及实际应用。 1.1 背景介绍 在机器学习和数据挖掘领域,正则化是一种常用的方法来防止过拟合。过拟合是指模型在训练数据上表现良好,但在新的、未见过的数据上表现很差的现象。正则化的目的是通过在损失函数上加入一个正则项,使得模型在训练...

AI天才研究院 1033

学生党投稿Applied Soft Computing:从导师账号登录到通讯作者设置的全流程解惑

本文详细解析了学生投稿Applied Soft Computing期刊的全流程,重点介绍了导师账号登录、通讯作者设置、作者排序调整以及开放获取费用等关键环节的避坑技巧。针对LaTeX稿件处理和财务选项选择提供了实用建议,帮助学生顺利完成SCI期刊投稿。

weixin_30352191的博客 213

硬正则化:理论基础与实践应用

1.背景介绍 硬正则化(Hard Regularization)是一种常用的机器学习和深度学习中的正则化方法,它通过在损失函数中添加一个关于模型参数的正则项,来约束模型的复杂度,从而防止过拟合。硬正则化与软正则化(Soft Regularization)相比,具有更强的约束力,能够更有效地防止模型过拟合。在本文中,我们将从以下几个方面进行阐述: 背景介绍 核心概念与联系 核心算法原理和具体操...

AI天才研究院 587

Fluent VOF造波从入门到放弃?手把手教你用k-w SST模型搞定波浪模拟

本文详细介绍了使用Fluent VOF和k-w SST模型进行波浪模拟的实战技巧,从参数设置到结果优化,帮助用户避开常见误区。通过工业项目验证的配置方案,提升波浪模拟的准确性和计算效率,特别适合处理多相流和复杂湍流场景。

weixin_27102543的博客 422

[官方培训]07-UE材质基础 孙丹璐 Epic 笔记

勾选允许自定义深度写入再在模型上勾选然后可以通过Scene Texture节点拿到渲染的自定义深度信息,有了自定义深度信息就可以与当前渲染的像素深度进行对比,自定义深度信息存放的是最靠近我们的深度,如果当前像素离自定义深度比较远我们就不要这个像素。效果如下这种方案的缺点也很明显,因为这样看不到第二层的透明了,如果是两层的半透明的裙摆,这样就看不到第二层的裙摆了。对于半透明排序问题最根本能解决的还是光线追踪,ue5中又加入了OIT(基于像素的排序)。官方透明材质的理解和应用。

Tcohneyn的博客 1562

正则化_(理论+代码)模型正则化:L1正则、L2正则

0x00 前言 我们已经知道了模型误差 = 偏差 + 方差 + 不可避免的误差,且在机器学习领域中最重要就是解决过拟合的问题,也就是降低模型的方差。在上一篇文章《ML/DL重要基础概念:偏差和方差》已经列出了如下方法:降低模型复杂度减少数据维度;降噪增加样本数使用验证集其实还有一个降低方差的重要方法:模型正则化。本文从理论及代码两个方面对L1正则、L2正则进行了介绍,帮助大家了解其背后的...

weixin_39972151的博客 1402

英伟达DeepStream学习笔记7——DeepStream接入USB相机并实现广角摄像头的畸变矫正

deepstream官方提供了一个畸变矫正的例子,包含了鱼眼和普通广角的矫正。我目前准备做一个广角的畸变矫正,我已经使用opencv实现功能,目前增加到deepstream框架中。示例代码在\opt\nvidia\deepstream\deepstream-5.0\sources\apps\sample_apps\deepstream-dewarper-test 中,鱼眼矫正——deepstream官方版 https://developer.nvidia.com/blog/calibration-trans

耶律大石的博客 1603

计算机视觉中的正则化:从理论到实践的全面解析

大家好!今天要和大家分享的是在计算机视觉(CV)领域中非常重要的一个概念——正则化(Regularization)。无论你是刚开始接触深度学习,还是希望提升模型性能的老手,掌握正则化的正确用法都会让你的模型更加稳定、泛化能力更强。

Jacklx888的博客 625

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

正则化技术演进:从理论基石到创新设计

在机器学习领域,过拟合是模型开发中最常见的难题之一。模型泛化的边界:内推与外推的辩证关系及前沿进展这种现象好比一个学生为了应付考试,死记硬背了所有习题答案,但未能理解题目背后的原理,当遇到形式稍作变化的新题时便束手无策。深度学习模型因其复杂的结构和庞大的参数量,特别容易陷入过拟合的陷阱。一个典型的过拟合迹象是模型在训练集上表现优异,但在验证集或测试集上表现显著下降。这正是正则化技术诞生的背景——在训练过程中引入约束,平衡模型复杂性与泛化能力。"""约束参数正则化(CPR)实现。

深耕互联网架构与AI领域多年,专注大模型工程化、云原生架构、AI驱动系统,分享实战经验、前沿技术和架构方法论。每周产出深度长文+技术短文,涵盖大厂案例、论文解读与工程实践。拒绝水文,只讲干货。关注我,与一线架构师共同探索技术本质。 1179

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

支持向量机与正则化:理论与实践

1.背景介绍 支持向量机(Support Vector Machines,SVM)和正则化(Regularization)都是广泛应用于机器学习和数据挖掘领域的有效方法。SVM是一种超参数学习算法,可以用于分类和回归任务,而正则化则是一种通用的模型复杂度控制方法,主要应用于最小化过拟合的风险。在本文中,我们将详细介绍SVM和正则化的理论基础、算法原理以及实际应用。 2.核心概念与联系 2.1...

AI天才研究院 412

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

上一篇: AI论文探讨室·A+·第12期-深度图像去模糊专题1
下一篇: Docker专题-Linux下Docker安装及卸载
元宇宙MetaAI
博客等级 码龄10年 331粉丝 333原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值