从音视频角度看数据蒸馏与知识蒸馏

从书到AI问答:用开源工具链打造个人知识蒸馏系统 在信息爆炸的时代,个人知识管理常因资料堆积而停滞,书、视频和播客成为沉睡的资产。RAG(检索增强生成)技术为解决这一问题提供了新思路:通过将长内容转录为文本、切块并向量化,再利用Embedding模型与大模型结合,构建可交互的AI知识工具。这一过程不仅让知识从线性阅读转向按需问答,还通过本地化部署保障数据隐私。从PDF解析到音视频转写,再到ChromaDB向量检索与Gradio界面封装,开源工具链为开发者提供了完整路径。无论是学习技术手册还是整理会议录音,知识蒸馏管道都能让信息真正被激活,成为随时可用的私有 阅读详情

在深度学习的前沿研究范畴中,数据蒸馏与知识蒸馏作为两项具有关键影响力的技术,从不同技术维度为深度学习模型的优化与性能提升提供了重要支撑。数据蒸馏聚焦于数据处理流程,旨在将原始数据中繁杂且冗余的信息进行有效过滤,提炼出具有高度代表性的精炼数据子集;知识蒸馏则侧重于模型间的知识迁移,通过将大型复杂模型(教师模型)所蕴含的知识转移至小型轻量化模型(学生模型),实现模型性能的优化以及计算资源的高效利用,二者协同为提升深度学习模型的整体效能开辟了新的技术路径。

数据蒸馏

从原始数据到精炼子集的转换过程

深度学习模型本质上是一个设计精巧的数据处理架构,由一系列数据处理单元(即层,layer)有序组合而成,宛如一套层层嵌套的精密筛选机制。在模型运行过程中,每一层都承担着对输入数据进行特征提取与信息过滤的任务,将经过处理的数据传递至下一层,以实现更深入的数据特征挖掘与表达,这一过程即为数据蒸馏的核心操作流程。
数据蒸馏的核心技术步骤

  1. 原始数据集:数据来源与初始状态:在实际应用场景中,深度学习所依赖的原始数据集通常体量庞大,且包含大量冗余信息与噪声干扰。以图像识别领域为例,原始图像数据集中可能存在大量相似图像样本,或者图像存在模糊、噪点等质量问题,这些因素会显著影响模型对图像特征的准确提取与识别性能;在语音识别任务中,原始音频数据往往混杂着环境噪声、人声冗余片段等干扰信息,对后续语音内容的准确识别造成阻碍。原始数据集犹如未经加工的矿石原料,虽蕴含丰富信息,但需经过一系列精细处理才能发挥其价值。

  2. 数据预处理:数据质量提升与标准化:为提高数据可用性与模型训练效果,需对原始数据进行清洗、去噪等预处理操作。在图像数据处理中,常采用图像滤波算法去除图像中的噪点,增强图像清晰度;对于音频数据,通过降噪技术消除背景杂音,突出人声或目标音频信号。同时,还需进行数据格式转换、归一化等操作,使数据在格式与数值范围上达到统一标准,便于后续数据处理与模型训练。

  3. 特征提取:数据本质特征的挖掘与表达:从经过预处理的数据中提取关键特征,这些特征能够精准反映数据的内在本质属性。在图像分析领域,可提取图像的边缘、纹理、颜色等底层视觉特征;在视频分析场景中,除了图像特征外,还需提取视频的关键帧、动作序列等动态特征。例如,人脸识别系统通过提取人脸的关键特征点,如眼睛、鼻子、嘴巴的位置与形状特征,实现对人脸的精准识别;语音识别系统则依赖于提取音频的频谱特征、基音频率等声学特征,以区分不同语音内容。

  4. 数据降维:数据表达的精简与优化:原始数据通常具有较高维度,包含许多相关性较强的冗余维度,这不仅增加了计算复杂度,还可能对模型训练效率与准确性产生负面影响。借助数据降维技术,如主成分分析(PCA)、线性判别分析(LDA)等,可去除数据中冗余的相关性维度,保留最具代表性的核心信息,从而获得更为精简高效的数据表达形式。例如,在处理高分辨率图像时,通过数据降维可将图像从高维像素空间转换至低维特征空间,在大幅减少数据量的同时,有效保留图像的主要特征信息。

  5. 精炼数据集:数据处理的最终成果与应用价值:经过上述一系列数据处理步骤后所得到的精炼数据集,具备更高的数据质量与代表性。该数据集去除了原始数据中的冗余信息与噪声干扰,保留了最具价值的核心特征,能够为后续深度学习模型的训练提供更为高效的数据支持,显著提升模型的训练速度与识别准确率,如同经过精细提纯的高纯度原料,具有更高的应用价值与效能。

在深度学习模型架构中,数据蒸馏过程通过各层对数据的逐步过滤与特征提取得以实现。每一层依据其设计功能对输入数据进行特定的变换与处理,推动数据逐步向最终目标特征表示逼近。以卷积神经网络(CNN)为例,卷积层通过卷积核扫描图像提取局部特征,池化层则对卷积层输出的特征图进行下采样操作,进一步减少数据量并保留关键特征,经过多层的级联处理,最终生成能够准确表征图像内容的特征向量。

综上所述,数据蒸馏是一种集数据处理、特征提取与优化为一体的关键技术,其通过数据预处理、特征提取、数据降维等一系列标准化技术流程,从包含大量冗余与噪声的原始数据集中提炼出高质量、低冗余且具有高度代表性的精炼数据集,为深度学习模型的高效训练奠定坚实的数据基础。

知识蒸馏

模型间知识迁移与性能优化机制

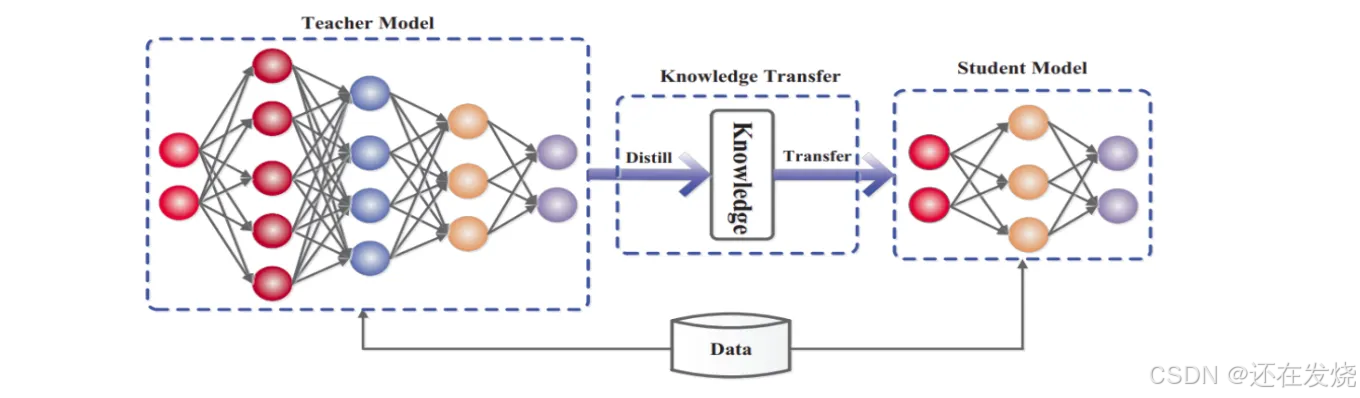
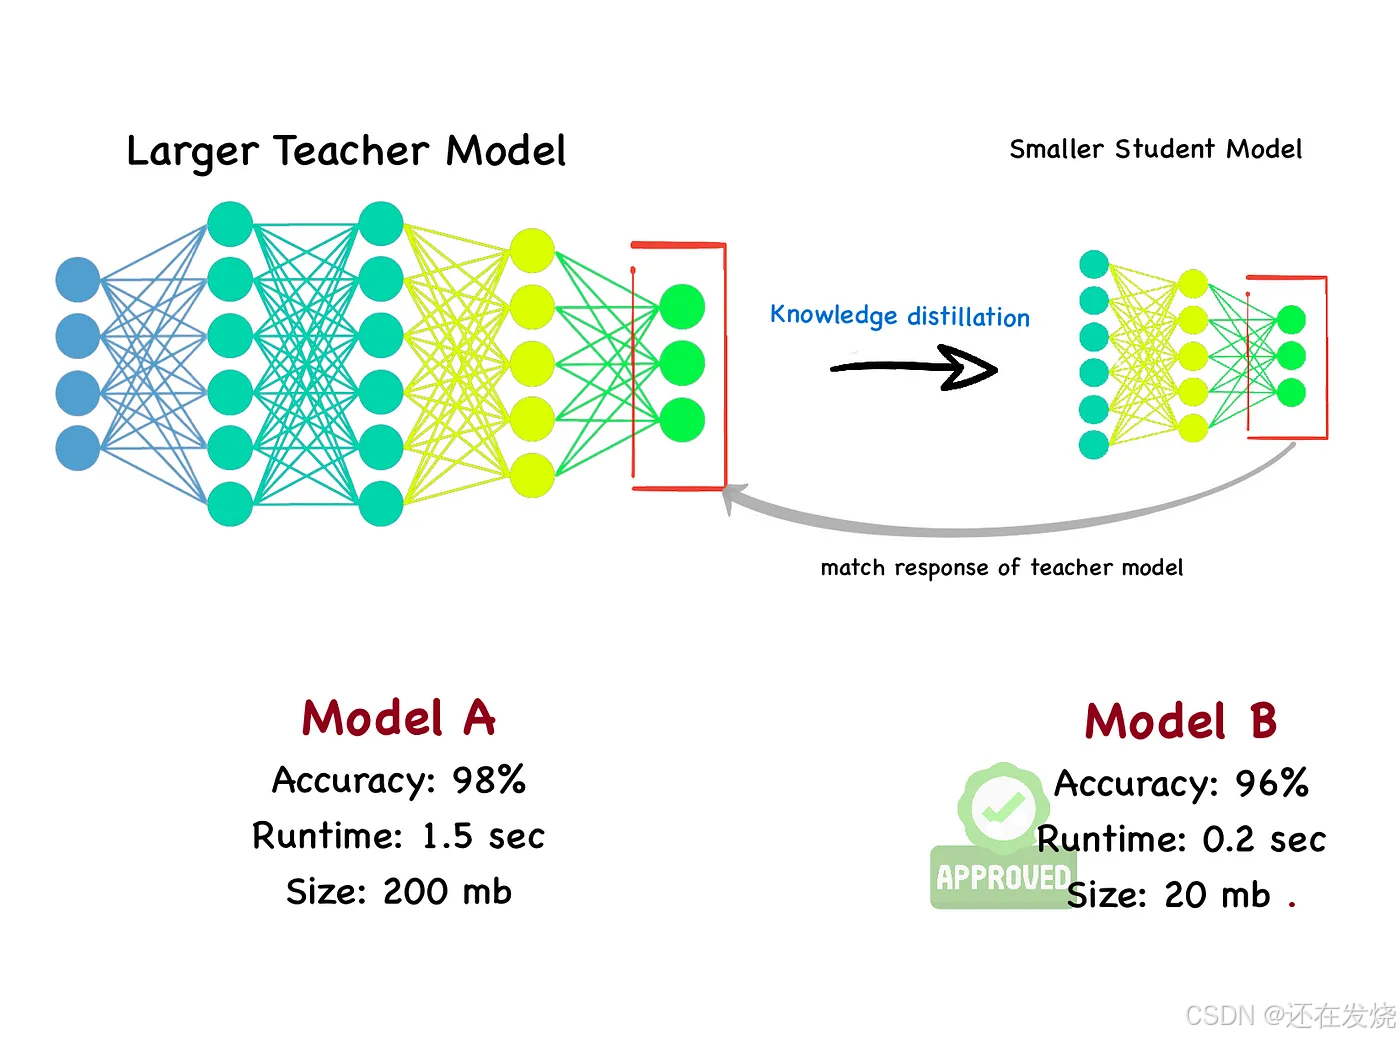
知识蒸馏作为模型压缩与知识迁移领域的重要技术手段,旨在将大型、高复杂度的教师模型所蕴含的丰富知识与泛化能力,有效迁移至小型、轻量化的学生模型中,实现模型性能的优化提升以及计算资源的高效利用,以满足不同应用场景对模型性能与资源消耗的多样化需求。
知识蒸馏的关键技术要素与实现流程

  1. 教师模型:知识的载体与来源:教师模型通常是经过大规模数据训练的高精度模型,其结构复杂、参数量庞大,在特定任务上展现出卓越的性能表现。以图像分类任务为例,教师模型可能采用深度卷积神经网络架构,如 ResNet 系列模型,经过大规模图像数据集的充分训练后,能够准确识别各类图像,并对图像中的细微特征与语义信息具有深入的理解与表达能力。教师模型不仅在最终分类结果上具有高准确性,其内部各中间层所提取的特征也蕴含着丰富的多层次知识,这些知识反映了模型对数据从底层特征到高层语义的逐级理解与处理过程。

  2. 知识提取:教师模型知识的挖掘与解析:从教师模型的输出中提取具有价值的知识信息,主要包括概率分布与中间层特征。概率分布体现了教师模型对各类别的置信度估计,例如在对一幅动物图像进行分类时,教师模型输出的概率分布可能表示该图像属于猫类的概率为 80%,属于狗类的概率为 15%,属于其他类别的概率为 5%,这种概率分布包含了比简单分类标签更丰富的信息,反映了教师模型对不同类别之间相似性与差异性的判断;中间层特征则是教师模型在数据处理过程中,各中间层所提取到的特征表示,这些特征能够捕捉到数据的高级语义信息,如在视频分析中,中间层特征可表征视频中的场景、动作等语义内容

  3. 学生模型:知识的接收者与学习者:学生模型是一种轻量化、结构相对简单、参数量较少的小型模型,其在计算资源消耗与推理速度方面具有显著优势,但在模型性能上可能不及教师模型,尤其在处理复杂数据时,分类准确性与泛化能力相对较弱。例如在相同的图像分类任务中,学生模型可能由于结构简单,无法像教师模型那样全面、准确地捕捉图像的关键特征,导致分类错误率较高。

  4. 蒸馏训练:知识迁移与学生模型优化过程:利用从教师模型提取的知识作为监督信号,指导学生模型的训练过程。在训练过程中,将教师模型输出的概率分布作为软目标,引导学生模型学习教师模型的决策过程,而非仅仅依赖于真实类别标签(硬目标);同时,通过最小化学生模型与教师模型在中间层特征上的差异,使学生模型能够学习到教师模型对数据的高级语义理解能力,从而提升自身性能。具体实现中,常采用计算学生模型与教师模型输出概率分布之间的 KL 散度(Kullback-Leibler Divergence),并将其作为损失函数的一部分,指导学生模型的参数更新,使其逐步逼近教师模型的知识水平。

  5. 精炼学生模型:知识迁移后的性能提升与应用价值:经过蒸馏训练后的学生模型,能够有效学习到教师模型的泛化能力与知识精华,在保持低计算成本优势的前提下,实现性能的显著提升,达到或接近教师模型的性能水平。此时的学生模型如同经过名师指导的学习者,在知识储备与应用能力上实现了质的飞跃,能够在对计算资源与响应速度要求较高的实际应用场景中发挥重要作用,如移动设备上的实时图像识别、语音助手的实时语音识别等。
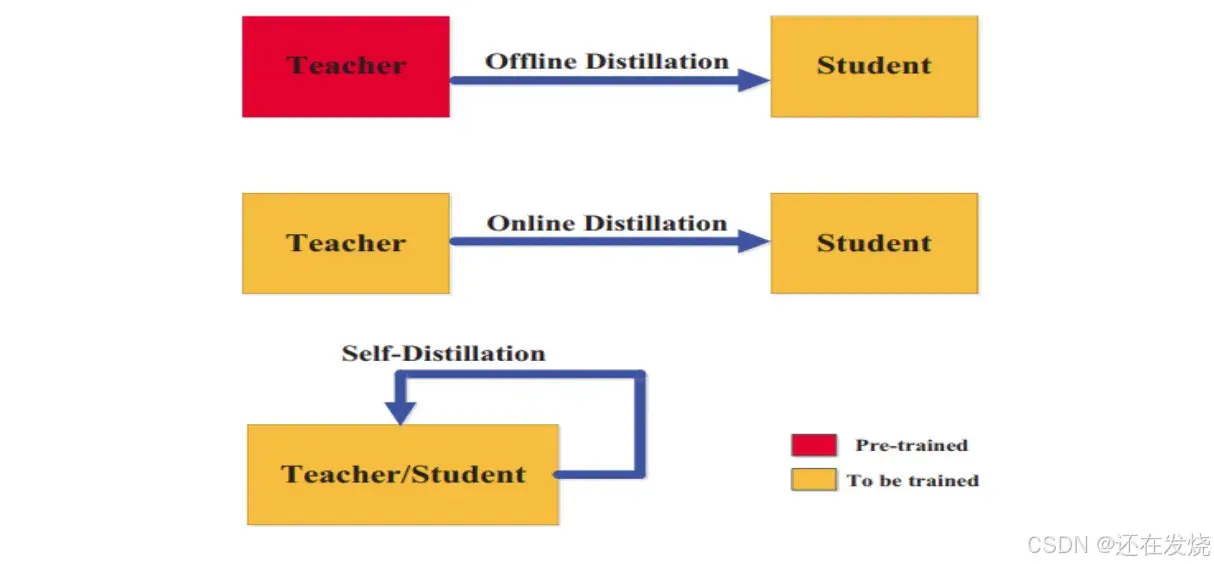
知识蒸馏技术的核心在于实现模型间的知识传递,通过将教师模型的输出(如概率分布、中间层特征等)作为软目标,引导学生模型的训练过程。与传统仅基于真实标签进行训练的方法不同,知识蒸馏使学生模型能够学习到教师模型的决策逻辑与泛化能力,打破了模型性能与计算资源之间的部分制约关系,为在资源受限环境中部署高性能模型提供了可行的技术解决方案。

【数据蒸馏】静态数据蒸馏方法汇总 基于几何的方法假设在特征空间中彼此接近的数据点往往具有相似的属性。因此,基于几何的方法试图移除那些提供冗余信息的数据点,剩下的数据点形成一个核心集合S,其中jSj ≤ jTj。 阅读详情

相关推荐

大模型数据蒸馏技术讲解

本文介绍大模型数据蒸馏技术。随着人工智能发展,大型语言模型计算需求高,限制其在资源受限场景应用,数据蒸馏技术应运而生。它将大规模数据集关键信息压缩到小规模合成数据集,通过多步骤实现知识迁移。文中阐述其核心原理、主要方法、应用场景,分析面临的挑战,展望发展前景。该技术潜力巨大,有望推动人工智能向高效、智能、安全方向发展。

weixin_43940494的博客 2651

什么是数据蒸馏?与知识蒸馏有何不同?

1.1 定义与目标数据蒸馏(Dataset Distillation)是一种新兴的机器学习技术,其核心在于从大规模数据集中提取关键信息,生成一个规模更小但更具代表性的合成数据集,从而在保持模型性能的同时,显著降低数据存储和计算成本。具体而言,数据蒸馏的目标是通过优化合成数据集,使得在该数据集上训练的模型能够达到与在原始大规模数据集上训练的模型相当的性能。

xx_nm98的博客 5864

原生音视频全双工大模型:原理、架构与实时交互系统构建

多模态AI的核心在于融合文本、图像、音频等多种信息模态进行统一理解与生成。其技术原理基于Transformer架构,通过自注意力机制实现跨模态特征的深度对齐与交互,从而让模型能够像人类一样综合处理来自不同感官的信息。这种技术的核心价值在于打破了传统流水线式处理带来的模态割裂与高延迟,为实现更自然、更智能的人机交互奠定了基础。在应用场景上,它尤其适用于对实时性要求极高的领域,例如智能语音助手、直播互动和在线教育,这些场景需要系统能够低延迟地“边听边看边思考边回应”。SeedRealtime模型正是这一技术趋势

weixin_33896726的博客 405

图解深度学习 - 数据蒸馏和知识蒸馏

*深度学习模型就像是处理数据的筛子,包含一系列越来越精细的数据过滤器(也就是层)。******每一层都致力于从数据中捕捉有用的信息,并将这些信息传递给下一层,以便进一步的处理和表示。****它通过一系列层层相连的数据过滤器(即层layer),逐步对输入数据进行处理和精炼,**********,旨在从原始数据集中提取出更具代表性和有用性的数据子集;知识蒸馏则是一种模型压缩和知识迁移的方法,旨在将大型教师模型中的知识转移到小型学生模型中。**********数据蒸馏(Data Distillation)?

m0_70486148的博客 3110

小米MiMo V2系列AI模型技术解析与应用指南

人工智能大模型正成为技术创新的核心驱动力,其底层架构通常基于Transformer等先进神经网络。小米MiMo V2系列通过创新的混合注意力机制和多教师在线蒸馏技术,实现了显存效率提升和长上下文保持等突破。这类技术在代码生成、多模态理解和语音合成等场景展现出巨大价值,特别是在编程辅助和智能语音交互领域。MiMo V2系列包含Pro、Omni和TTS三个版本,分别针对不同应用场景进行了优化,其1M token的超长上下文窗口和极具竞争力的API定价策略,为开发者提供了高性能低成本的选择。

weixin_30832405的博客 385

OpenAI硬件设备开发指南:多模态AI与端云协同架构解析

多模态AI技术通过整合文本、语音、视觉等多种信息输入,实现了更自然的人机交互体验。其核心原理基于Transformer架构的扩展,能够同时处理不同模态的数据并生成连贯响应。在工程实践中,多模态AI的价值在于打破单一模态的限制,为实时交互应用提供技术基础。随着边缘计算的发展,端云协同架构成为实现低延迟AI应用的关键方案,通过合理分配本地与云端计算任务,平衡性能与隐私需求。OpenAI即将推出的硬件设备正是这一技术趋势的落地体现,为开发者提供了全新的多模态AI开发平台。设备预计集成语音识别、计算机视觉等传感器,

weixin_29052717的博客 237

AI内容可信度治理:从AIGC检测到溯源审计的工程实践

生成式AI的广泛应用使内容真实性验证成为平台治理的关键环节。AIGC伪造检测涉及文本困惑度分析、视觉伪影识别与音视频跨模态一致性校验等底层技术;而C2PA内容凭证与SynthID生成水印则实现了从源头追溯内容来源与编辑历史。两者结合,形成“主动溯源+被动检测”的双层防线,为内容平台、媒体机构与企业AI应用提供可落地的风险治理方案。围绕检测服务搭建、批量任务调度与审计留痕,工程师可以构建一套覆盖图像、文本、音频、视频的完整检测链路,并借助AI Agent审计机制让自动化流程可追溯、可追责。本文以工程视角梳理从

weixin_33851604的博客 355

视频算法校招笔试复盘:从目标检测到DeepSORT的考点与避坑指南

计算机视觉技术在视频场景中的落地,离不开目标检测、目标跟踪与视频编码等核心能力的支撑。目标检测负责定位画面中的物体,目标跟踪则利用时序信息保持身份一致性,而视频编码决定了数据压缩效率与传输质量。这些技术共同构成了视频算法工程师的知识底座,也是网易等大厂校招笔试的高频考点。从经典网络结构到DeepSORT的数据关联,再到H.264/GOP等流媒体基础,笔试不仅考察模型原理,更关注工程落地思维。本文以2023网易提前批视频算法岗笔试为例,拆解真题考点、代码题思路与常见失分点,帮助考生快速收敛复习范围,少走弯路。

weixin_34409357的博客 282

AI基础概念全解析:从入门到精通,小白也能看懂的大模型入门指南!

本文详解了AI、机器学习、数据科学及神经网络等核心概念的关系与区别。AI分为ANI和AGI,机器学习通过数据与算法实现自主学习,数据科学结合多学科获取数据价值,神经网络等同于深度学习。这些概念从大到小相互包含,数据科学则与AI工具有交叉。文章通过实例解释这些抽象概念,帮助读者建立AI知识框架

libaiup的博客 597

多模态开发实战:从数据工程到微调部署的完整技术路径

在AI技术从单模态走向多模态融合的今天,如何让模型真正理解图像、文本与语音之间的语义关联,成为工程落地的核心课题。多模态学习的本质在于不同模态信息在统一语义空间中的对齐与融合,典型的实现范式包括双塔结构、融合编码器以及以大语言模型为骨干的扩展结构。掌握多模态开发,不仅需要理解模型原理,更要具备数据清洗、指令微调、模型选型与推理部署的全链路工程能力。随着视觉大模型与多模态RAG、Agent等应用层技术逐步成熟,2026年被视为技术量产落地的关键窗口。无论是构建图文检索、视觉问答,还是打造多模态智能体,工程师都

weixin_29051245的博客 250

深度伪造技术治理与AI内容安全检测方案

生成对抗网络(GAN)作为深度伪造的核心技术,通过生成器与判别器的对抗训练实现高度逼真的虚假内容生成。在数字内容安全领域,元数据保护和真实性验证成为关键技术挑战,涉及Exif数据擦除、哈希值伪造等篡改手段。当前技术治理方案聚焦于构建端到端的元数据完整性保护机制,结合区块链和数字签名技术确保内容溯源。从工程实践角度,多模态检测和时序一致性检查等方法能有效提升检测准确率,而标准化API接口和开源工具包则推动行业协作。随着AI生成内容的普及,深度伪造检测与实时防护系统正成为内容平台的基础设施需求。

weixin_29061821的博客 303

可验证交付:744B纯文本模型如何落地与验收?

大模型从实验室走向企业生产环境,核心挑战已从“跑分高低”转向“交付是否可信”。模型部署与推理优化固然重要,但更关键的是建立一套可复现、可审计的验收机制。以纯文本大模型为例,其参数规模达到744B量级时,传统单卡推理已不可行,需借助张量并行、流水线并行与量化策略在集群中落地;同时,官方评测脚本、权重哈希、私有数据集回归等环节共同构成“可验证交付”的工程闭环。这种交付模式广泛应用于知识库问答、合同审核、代码生成等企业场景,帮助团队在采购前完成能力核验。本文结合部署实践,梳理显存估算、推理框架选型与六步验收法,演

weixin_42680139的博客 199

豆包大模型API生态观察:技术驱动、批量落地与产业辐射全解析

大模型API作为AI应用开发的基石,正在从单一对话能力向批量任务、知识库增强等工程化场景延伸。大模型API的核心价值在于通过标准化接口降低模型接入门槛,让开发者能够快速构建智能客服、内容生成、文档分析等应用。随着推理成本的持续下探,批量文本分类、商品描述生成、客服工单处理等场景开始真正实现生产力转化。RAG检索增强、函数调用、多模态能力进一步拓展了大模型在企业数据接入与复杂任务执行中的边界。豆包大模型作为字节跳动推出的MaaS服务,其API生态在兼容性、成本结构和工具链完备性上展现出显著竞争力,并带动了算力

weixin_31062533的博客 347

从时代AI百大人物榜,看大模型、算力与开源生态的技术演进

人工智能技术的迭代正从单点算法突破转向全栈工程化落地,大模型、算力基础设施与开源生态成为驱动产业增长的三大核心引擎。理解技术原理与产业格局,是开发者进行技术选型和职业规划的前提。在这一背景下,算力效率、推理成本、模型可控性及治理合规等议题,日益决定着AI应用能否规模化落地。从云平台承载模型服务,到开源权重支持私有化部署,再到多模态与智能体应用的兴起,技术栈的层级重构正在重塑开发者的工作方式。了解全球AI领域最具影响力的人物及其代表的技术路线,有助于开发者从宏观视角审视基础模型选型、推理优化、应用架构扩展方向

weixin_30595035的博客 369

GPT-4o全模态AI:原生多模态交互的技术原理、应用场景与开发实践

多模态人工智能是AI技术发展的核心方向之一,旨在让机器能够像人类一样,同时理解和处理文本、图像、音频等多种信息形式。其技术原理在于构建一个统一的语义表示空间,通过跨模态的预训练,使模型能够将不同模态的信息映射到同一向量空间进行关联和推理。这一技术突破带来了巨大的工程价值,它极大地简化了复杂AI应用的开发流程,开发者无需再费力集成和串联多个单模态模型,从而降低了构建智能交互体验的门槛。在应用场景上,多模态AI正广泛应用于智能客服、内容创作、教育辅助、无障碍工具以及工业质检等领域,实现更自然、更高效的人机协作。

chuange6363的博客 378

Deepfake深度伪造检测与防护:从生成原理到工程实践

深度伪造(Deepfake)依赖深度学习与生成对抗网络等生成式AI技术,可低成本合成逼真的换脸视频与语音,对个人隐私和内容安全构成严峻威胁。从原理上看,伪造内容通过人脸检测、特征提取、视频帧处理与后处理融合等链路生成,同时也在人脸识别系统、活体检测和平台审核中留下可检测的痕迹。掌握基于OpenCV与深度学习模型的检测方法,并在数据源头、平台审核、数字水印等环节建立多级防御,是保障AI应用安全和数字身份可信的关键。在应用场景中,无论是社交媒体未成年人肖像保护、金融身份认证的活体检测,还是UGC平台的内容风控,

weixin_34234829的博客 427

大模型三维度解析:MoE、推理与多模态的真相

大模型技术发展迅速,衍生出多种分类标签,其中MoE、推理模型与多模态是常见但常被误解的三个概念。MoE通过稀疏激活机制降低推理成本,属于模型内部结构设计;推理模型依靠思维链与强化学习,在复杂任务上实现慢思考;多模态则扩展了模型对图像、音频等信号的输入输出能力。三者分属不同维度,正交组合出丰富形态。理解这些原理有助于在模型选型时准确定位需求,平衡性能与成本。本文基于工程实践,梳理了这三个维度的技术价值与应用场景,并提供了可操作的选型框架。

weixin_34405557的博客 164

【知识蒸馏论文解读】Dataset Distillation 创新性十足的数据集蒸馏

模型蒸馏(model层面)的目标是从一个复杂的模型中蒸馏知识到小的模型上。本文考虑的是数据集上的蒸馏(**dataset层面**),具体来说,我们会固定住模型,然后尝试从较大的训练数据集中蒸馏知识到小的数据集上。核心目的是将原始的大数据集压缩成一个小的数据集(不需要来自训练集的分布),并且在这个小数据集上训练模型的效果和原始较大数据集上的训练效果是接近的。......

捡起一束光的博客 6716
上一篇: 办公耳机新趋势:轻量化引领未来办公音频体验
下一篇: NDI 与 Dante 的竞争新局
还在发烧
博客等级 码龄5年 36粉丝 7原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值