用Python爬虫批量下载糗事百科段子,怀念曾经的天王盖地虎,小鸡炖蘑菇...

python爬虫系列二:爬取糗百成人的妹子图片(requests+正则) 在我的上篇文章:python爬虫系列一:爬取糗百成人的妹子图片中,体现的主要还是代码,这一次我用了更加流行的requests 和正则来改写代码,并且简单的说说思路爬取图片到底需要干什么1,定义要爬取的页面。 糗百官网:http://www.qiubaichengren.com,里面是不是有很多的妹子图片,我们就是要把这些妹子图片爬取下来。接着我们点击‘下一页’按钮,发现网址变成了http://www 阅读详情
成年人的世界

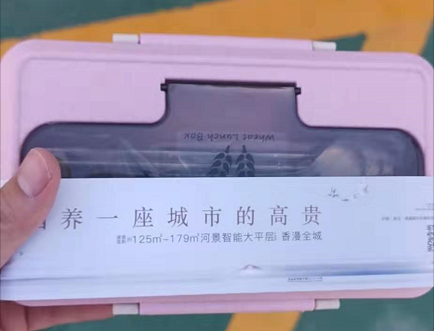
别人公众号粉丝刷刷的涨,我的佛系公众号关注全靠随缘。本来挺不淡定的,但今天现实给我上了一课啊。

5847426-cff686c10c7681b5.png
关注送礼

财大气粗的地产商们都开始搞公众号了,关注公众号就送一个饭盒,你说这涨粉速度能跟别人比么...成年人的世界没有容易二字啊...
不,有容易的!
容易胖、容易老、容易头发变稀少;容易困、容易丑、容易变成单身狗;容易失眠一整夜,容易加班没补贴...这些貌似都挺容易的啊,哈哈。

自娱自乐

今天朋友发了一个段子,居然来自糗事百科...随着抖音、快手的各种火爆,仿佛从前拿着手机刷糗百的日子,已经过去好久了。不知道多少人还会念起那句“天王盖地虎,小鸡炖蘑菇...”。今天就做个小练习,爬一爬糗事百科上的段子吧!

网站分析
段子内容首页

糗百的段子栏目格式比较简单:
https://www.qiushibaike.com/text/page/<page_number>/

网站分析

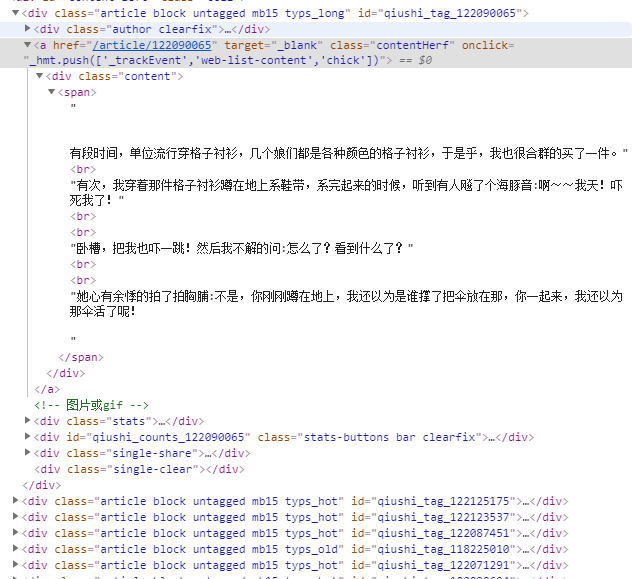
网页格式就更为简单了:

5847426-11a5c638225b62ee.png
网页格式

每次数据定位都是用class没有创新意识,这次增加一点难度,在beautifulsoup中引入一下正则吧!可以看到没调内容的id格式都是qiushi_tage_numbers,那么我们是否可以这么定位:
findAll('div', {'id': re.compile("qiushi_tag_[0-9]+")})

避坑指南
5847426-4f859171c9704c11.png
未加载完成

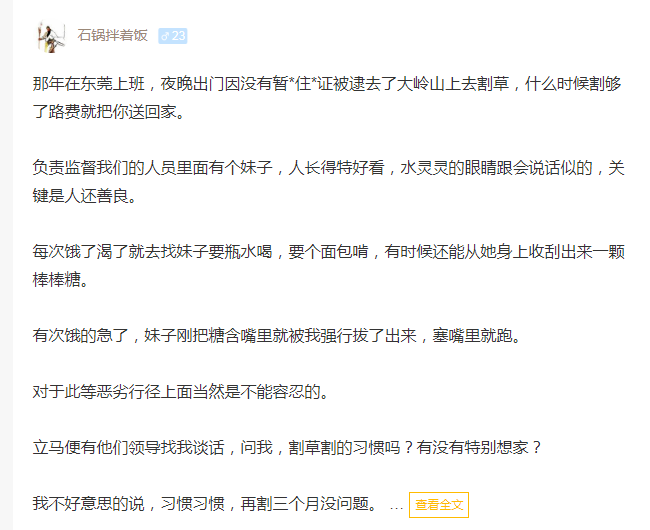
分析段子发现,有些段子内容过长,会出现部分展示的问题,此时我们需要针对这些存在查看全文的段子,获取它的子链接,然后进入新的页面,获取所有段子内容,再进行保存。即当段子内容中存在<span class="contentForAll">查看全文</span>标签时,需要跳转网页后获取内容。

整体代码

段子每页25条内容,为了减少服务器的压力,我们就默认每次获取10页内容即可:

# -*- coding: utf-8 -*-
# @Author   : 王翔
# @JianShu  : 清风Python
# @Date     : 2019/8/15 1:21
# @Software : PyCharm
# @version  :Python 3.7.3
# @File     : JokeCrawler.py

import requests
from bs4 import BeautifulSoup
import re
import time


class JokeCrawler:
    def __init__(self):
        self.host = "https://www.qiushibaike.com"
        self.headers = {'User-Agent': ('Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 '
                                       '(KHTML, like Gecko) Chrome/75.0.3770.100 Safari/537.36')}
        _time = time.strftime('%y%m%d.%H.%M.%S', time.localtime())
        self.file = open('糗事百科{}.txt'.format(_time),
                         'w+', encoding='utf-8')

    def get_request(self, url):
        r = requests.get(url, headers=self.headers)
        return BeautifulSoup(r.text, 'lxml')

    def crawler(self, url):
        jokes = self.get_request(url).findAll('div', {'id': re.compile("qiushi_tag_[0-9]+")})
        for number, joke in enumerate(jokes, start=1):
            if joke.find('span', {'class': "contentForAll"}):
                _href = joke.find('a', {"class": "contentHerf"})['href']
                content = self.get_request(self.host + _href).find('div', {"class": "content"}).text.strip()
            else:
                content = joke.find('div', {"class": "content"}).text.strip()
            self.file.write("{}.{}\n".format(number, content))

    def run(self):
        for page in range(1, 11):
            _url = "{}/text/page/{}".format(self.host, page)
            self.file.write("第{}页\n\n".format(page))
            self.crawler(_url)

    def __exit__(self):
        self.file.close()


if __name__ == '__main__':
    main = JokeCrawler()
    main.run()

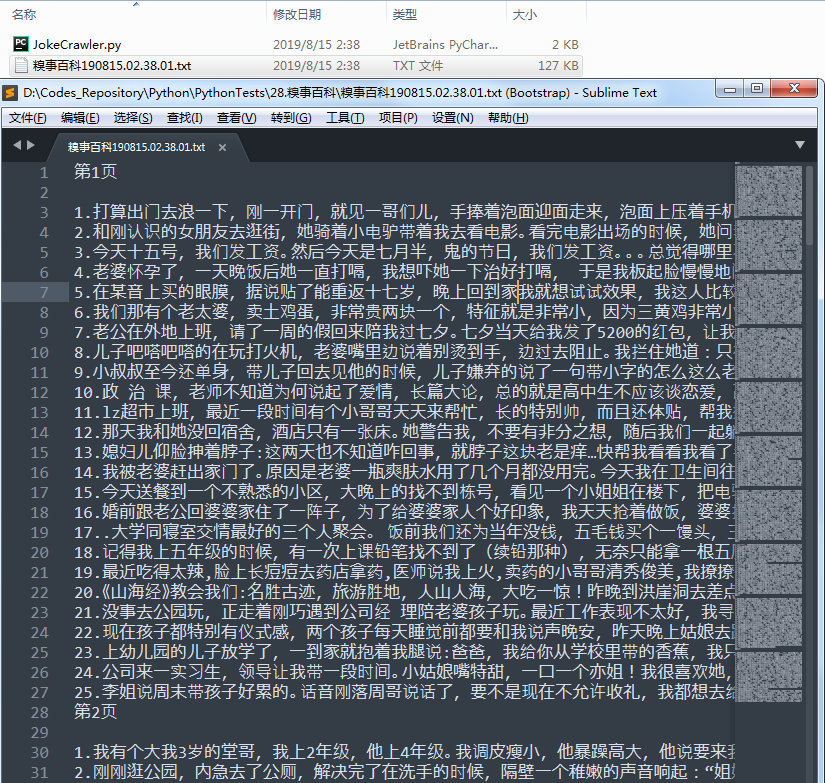
来看看我们最终的爬虫结果吧:

5847426-3f249b7cec491423.png
爬虫效果

没事儿爬上写段子,休息时候慢慢看吧....

The End

OK,今天的内容就到这里,如果觉得内容对你有所帮助,欢迎点击文章右下角的“在看”。
期待你关注我的公众号清风Python,如果觉得不错,希望能动动手指转发给你身边的朋友们。
希望每周一至五清晨的7点10分,都能让清风Python的知识文章叫醒大家!谢谢……


5847426-612ae1f58118218c.png
清风Python

python爬虫爬取糗百成人图片多线程版本 来个简单的多线程,爬取速度比单线程要快很多,下面上代码: #encoding:utf-8 #多线程爬取 import requests import os from bs4 import BeautifulSoup import threading import urllib.request FIRST_PAGE_URL = 'http://www.qiubaichengren.com/{} 阅读详情

相关推荐

python爬虫爬取糗百成人图片单线程版本

爬取糗百成人图片的所有图图,先来个单线程版本的: #encoding:utf-8 #单线程简单版本 import requests import os from bs4 import BeautifulSoup import threading import urllib.request FIRST_PAGE_URL = 'http://www.qiubaichengren.com/{}.h

fenyujinian的专栏 2839

python学习笔记(8)迭代器和生成器

迭代器 迭代是Python最强大的功能之一,是访问集合元素的一种方式。 迭代器是一个可以记住遍历的位置的对象。 迭代器对象从集合的第一个元素开始访问,直到所有的元素被访问完结束。迭代器只能往前不会后退。 迭代器有两个基本的方法:iter()和next()。 字符串,列表或元组对象都可用于创建迭代器: list=[1,2,3,4] it=iter(list) #创建...

weixin_30372371的博客 344

糗事百科无码注册工具v1.3 To.xiaoC

Tag:糗百邀请码,糗事百科邀请码,糗事百科注册,糗百,糗事百科 软件大小:717KB 软件语言:简体中文 开 发 商:小C 更新时间:2012年12月13日 应用平台:Win8/Win7/Vista/Win2003/WinXP/Win2000/ v1.3版本更新如下内容 新增邀请码贡献系统. v1.2版本更新如下内容 修复注册问题. v1.1版本更新如下内容 新增注册队列功能,当服务器无可用邀请码时,可以将注册信息提交到服务端,一旦服务端有邀请码可用将自动注册,注册结果将会发送到您的邮箱中。 ”糗事百科免邀请码注册工具“是一款针对喜欢看糗百但又无码注册的人士量身打造,使用此工具注册糗百时不需要输入邀请码(软件自动从服务器上获取),只需要输入糗百用户名,密码,邮箱即可,另外,为了防止恶意注册浪费邀请码,一台电脑每天只能成功注册一次。 注:本工具运行时如果提示”应用程序错误“,则代表你电脑上没有安装.NET 2.0框架,本工具只能在安装了由微软提供的.NET框架的操作系统下才能正常使用!微软.NET2.0框架下载地址:http://download.microsoft.com/download/5/6/7/567758a3-759e-473e-bf8f-52154438565a/dotnetfx.exe

Python抓取糗事百科成人版图片

最近开始学习爬虫,一开始看的是静觅的爬虫系列文章,今天看到糗事百科成人版,心里就邪恶了一下,把图片都爬下来吧,哈哈~ 虽然后来实现了,但还是存在一些问题,暂且不提,先切入正题吧,没什么好说的,直接上代码如下: 环境:Python2.79 1 #coding: utf-8 2 import urllib2 3 import urllib 4 import re 5 ...

weixin_34062329的博客 3万+

电影源码 电影网站源码模板

源码是php的 941看电影网源码和其他电影网站模板不同之处, 网站播放视频无需安装任何播放器,打开页面就能播放!用户体验友好。 如果一个网站给我看个电影还要我安装播放器,我是果断关闭页面的。 谁都希望打开网站点击就能播放! 1、此网站是本人自己制作,绝对安全!优点:可以生成静态页面!对于seo绝对是很看重的! 2、更具杀伤力的是网站不需要几十上百G的空间就可以发布电影!因为电影都是直接使用迅雷链接和电驴链接直接播放的。不需要存储视频文件。可以大大节省空间! 3、还有一大好处是可以实现点播功能!使用迅雷链接或电驴链接直接就能播放!优点是片源广泛! 4、网站还有推广功能!注册用户只要推广给别人注册就能获得积分。这就很大程度的让你的用户帮你宣传网站。不想付费却想看电影的人即使你没赚他的钱但也可以利用他帮你推广网站。 5、盈利模式多样化,部分电影需要积分,用户可以购买积分观看。实现盈利、还可以挂上淘宝客页面!推广一些看电影的人爱买的东西!也可以挂广告! 6、还有一个绝杀的秘籍教程。

Python抓取糗事百科网页信息以及源码下载

http://www.qiushibaike.com/hot/page/1# 代码中使用这个网址获取网页中的信息的。网址中的1代表第一页,该数字累加,就是不同页的信息。 每一页显示20条糗事,每条糗事有头像,用户姓名,糗事内容,糗事内容图片(该图片可有可无,没有图片的话,糗事内容就是纯文本形式),以及点赞或者好笑数量。

python爬虫系列一:爬取糗百成人的妹子图片(urllib2)

撸叼屎是我朋友,单身已久,每天让我给介绍妹子,于是我写了一个python爬虫来暂时满足他。 给撸叼屎的程序#!/usr/bin/env python # -*- coding: utf-8 -*- from urllib2 import Request, URLError, urlopen import re import urllib import os def get_url_content(u

老鼠程序员的专栏 2万+

python_爬虫——爬取糗事百科

亲测有效,不管是windows 还是Linux都能运行 使用python 爬取糗事百科的段子,通过回车键控制,一次一个,同时可以把看过的内容保存到本地查看 具体实现可以参照 http://blog.csdn.net/qiqiyingse/article/details/60583129

Python爬虫批量下载糗事百科段子,怀念的天王盖地虎,小鸡炖蘑菇...

欢迎添加华为云小助手微信(微信号:HWCloud002 或 HWCloud003),输入关键字“加群”,加入华为云线上技术讨论群;输入关键字“最新活动”,获取华为云最新特惠促销。华为云诸多技术大咖、特惠活动等你来撩 自娱自乐 今天朋友发了一个段子,居然来自糗事百科…随着抖音、快手的各种火爆,仿佛从前拿着手机刷糗百的日子,已经过去好久了。不知道多少人还会念起那句“天王盖地虎,小鸡炖蘑菇…”。今天...

华为云官方博客 1615

AIDD机器学习深度学习药物发现与设计教程总结

AIDD(AI Drug Discovery & Design):是近年来非常火热的技术应用,且已经介入到新药设计到研发的大部分环节当中,为新药发现与开发带来了极大的助力。倾向于机器对数据库信息的自我学习,可以对数据进行提取和学习,一定程度上避免了化合物设计过程中的试错路径,同时还会带来很多全新的结构,为药物发现打破常规的结构壁垒。覆盖了机器学习和深度学习,能与新药研发相结合并实质性的应用到靶点预测、高通量筛选、药物设计、药物的ADMET性质预测等;且算力方面,由早期应用于药物发现领域的决策树、随机

wutianlin0723的博客 6817

从SC7A20数据手册到代码:一步步搞定加速度值读取与换算(避坑指南)

本文详细解析了SC7A20三轴加速度传感器的数据手册,从寄存器配置到原始数据读取,再到加速度值的换算方法。通过代码示例和避坑指南,帮助开发者准确实现加速度值的读取与换算,适用于嵌入式开发和运动检测应用。

weixin_26878995的博客 587

老司机带你30行代码爬糗事百科成人版

学了大概一个月爬虫了,看着人家爬东爬西的,自己也按捺不住终于写好了自己的爬虫,而且是福利哦。 这里我们主要用到了requests库,推荐大家用python 3.0+以上版本。import urllib import re import requests from requests.exceptions import RequestException #这里是我们要爬的网址,为了示例只爬取20页 f

gane12534的博客 4万+

Rstudio安装org.Hs.eg.db

自己也是个小白,初次安装org.Hs.eg.db碰到好多问题,步骤总结如下: 第一,instal.packages()安装,不行则换 BiocManager::install() 第二,如BiocManager不成,说明不是最新版本,可按提示安装最新版 BiocManager::install(version = '3.13') #由于R版本较新,按照提示中的相关信息,安装最新版本的 第三,再次安装 BiocManager::install("org.Hs.eg.db") 第四,之后每个人.

ZH_DDong的博客 2万+

糗事百科成人版段子爬虫实战

糗事百科成人版的段子爬虫 因此正则表达式可以写成 然后观察网址规律,发现格式是…page/n,n是页数 因此可以自己构造url访问多页 最后是针对某些反爬机制 可以自己添加用户代理池和ip代理池然后随机调用代理池(这个糗事百科没什么反爬机制可以不写) 常用用户代理池 https://blog.csdn.net/wangqing84411433/article/details/896003...

zzh的博客 4万+

MCU中GPIO口的驱动方式

MCU中GPIO口的驱动方式 导读: MCU芯片中GPIO口的驱动方式大的可分为输出和输入两类,小的分可以分为8种。 一、四种输入方式 ①上拉输入: 上拉输入抗干扰能力强,特别适合接地信号的输入(比如低电平有效的按键信号输入)。其工作原理如图1所示。 I/O 端口与TTL 施密特触发器之前接入了一个30K~50K 欧姆的上拉电阻,当I/O 端口悬空时,此时MCU 也能读到稳定的高电平状态,...

优快云Frewen的博客 3373

计算机视觉与深度学习 | 2024年至2025年图像匹配算法总结(原理,公式,代码,开源链接)

以上总结覆盖了当前主流和前沿技术,实际选择需结合具体场景(速度/精度/资源限制)评估。

尘世冰封的专栏 1590

python 爬虫 糗百成人

import urllib from time import sleep import requests from lxml import etree try: def all_links(url,page): # if "900.html" in url: # print("结束"); # return None...

weixin_33935777的博客 2374

18、公开可用的PPG数据库介绍

本文介绍了多个公开可用的PPG(光电容积描记)数据库,包括PPG-BP数据库、MIMIC II波形数据库、运动期间手腕PPG数据库以及指尖PPG与呼吸数据库等。这些数据库提供了丰富的生理信号数据,适用于动脉血压检测、呼吸频率估计、运动干扰去除以及基于PPG的生物特征识别等研究。每个数据库的数据来源、受试者信息、信号特点和下载方式均有详细介绍,并展示了如何利用这些数据库进行信号分析和算法评估。

salt的博客 388

Xpath--使用Xpath爬取糗事百科成人版图片

#!usr/bin/env python#-*- coding:utf-8 _*-"""@author:Hurrican@file: 爬取糗事百科.py@time: 2018/11/29 20:43"""'''content返回的是byte型数据,而text返回的是Unicode数据,也就是说text对原始数据进行的特殊的编码,而这个编码方式是基于对原始数据的猜测(响应头),text一般用于返回的...

weixin_30908103的博客 1万+

WPF+MVVM案例实战(二十三)- 阴影效果详解

通过附加属性实现阴影效果,通过改变不同的阴影属性值达到不同阴影效果

lingshuangcanxue 560

基于Python的二手奢侈品电商平台商品保值率数据爬取与分析

本文旨在探讨如何利用Python网络爬虫技术获取二手奢侈品电商平台商品数据,并通过数据分析研究奢侈品的保值率特性。研究将使用最新的爬虫技术(包括Playwright、异步处理和数据清洗技术)来高效获取数据,并利用Pandas、Matplotlib等数据分析库进行深入的数据可视化分析。本文详细介绍了爬虫的设计思路、实现过程以及数据分析方法,为奢侈品投资和消费提供数据参考。关键词:Python爬虫、奢侈品保值率、数据分析、Playwright、异步处理。

2201_76125261的博客 512

python爬虫经典段子_Python爬虫实战之爬取糗事百科段子

首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把,这次我们尝试一下用爬虫把他们抓取下来。友情提示糗事百科在前一段时间进行了改版,导致之前的代码没法用了,会导致无法输出和CPU占用过高的情况,是因为正则表达式没有匹配到的缘故。现在,博主已经对程序进行了重新修改,代码亲测可用,包括截图和说明,之前一直在忙所以没有及时更新,望大家海涵!糗事百科又又又又改版了,博主已经没心再去一次次匹配它了,...

weixin_39998859的博客 325

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

糗事百科的网络爬虫

最近看完《python基础教程》后,想学下数据分析和爬虫。找了一些简单的爬虫练练手。 参考了Python爬虫实战一之爬取糗事百科段子,因为糗事百科代码改版了,我修改了Re后基本实现,然后用bs4改为第二版。 工具:python2.7.11  IDE:pyhcarn 1、用Re匹配识别: #-*- coding:utf8 -*- """ 爬取糗事百科 ——>2.0版本 ——>使用

StephenFengz的博客 1576

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

糗事百科创始人王坚:互联网思维它是个甚?

搜索了一下“互联网思维”,返回的都是概念堆砌,比如极致、免费、粉丝,这只是兜圈子,还是让我来吧:   所谓互联网思维,就是在互联网这个行业里混饭吃的生存技能。   为什么互联网行业的生存技能知名度远超“资本思维”“房地产思维”“培训思维”?因为互联网的渗透力更强,感染了越来越多的“传统行业”,如果不学会互联网行业的生存技能,传统行业从业者就会在被互联网渗透的过程中淘汰。其实,这个概念就

lisq037的专栏 1287

糗事百科实例:

糗事百科实例: 爬取糗事百科段子,假设页面的URL是 http://www.qiushibaike.com/8hr/page/1 要求: 使用requests获取页面信息,用XPath / re 做数据提取 获取每个帖子里的用户头像链接、用户姓名、段子内容、点赞次数和评论次数 保存到 json 文件内 参考代码#qiushibaike.py #import url

ai agent 529

Python爬取Boss直聘,获取全国Python薪酬榜

深感抱歉 本来这篇文章应该是在昨天发的,可是电脑出了问题蓝屏了。晚上回来重装了系统,结果还是搞到了现在。 今天想和大家聊聊Python与爬虫 python之所以能迅速风靡全国,和大街小巷各种的培训机构脱不开关系。 一会pythonAI未来以来,一会儿4个月培养人工智能与机器学习顶尖人才,更有甚者什么一周成就爬虫分析师... 我这一把年纪了,胆子小只敢在自己的公众号里说说。至于出去了...

清风Python 1197
上一篇: Python不再为字符集编码发愁,使用chardet轻松解决你的困扰。
下一篇: 自古逢秋悲寂寥,奈何今秋热成雕?Python使用Pyecharts统计全国温度并绘图
清风Python
博客等级 码龄7年 406粉丝 267原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值