【论文阅读】Neural Machine Translation by Jointly Learning to Align and Translate

论文阅读:《Neural Machine Translation by Jointly Learning to Align and Translate》 神经机器翻译是最近提出的机器翻译方法。与传统的统计机器翻译不同,神经机器翻译的目标是建立一个单一的神经网络,可以共同调整以最大化翻译性能。最近提出的用于神经机器翻译的模型经常属于编码器 - 译码器族,并且将源句子编码成固定长度的矢量,解码器从该矢量生成翻译。在本文中,我们推测使用固定长度向量是提高这种基本编码器 - 解码器架构性能的瓶颈,并且建议通过允许模型自动(软)搜索零件来扩展它的源句子与预测目标词相关,而不必将这些部分明确地形成为硬分段。 阅读详情


摘要:

Neural machine translation 是用encoder 将源输入编码成固定长度的向量,然后再用decoder解码成目标语言。但是使用固定长度是受限制的,本文就是要提出一种新的机制,让decode的时候可以比较动态的search 源输入。其实也就是attention机制

introduction:

常用的encoder-decoder模式在编码成固定长度的向量时,可能会失去一些有用的信息,尤其是输入很长的时候。为了解决之歌问题,引入一种机制,让翻译和对齐同时进行。(直观的理解,中文的表达顺序并不是和英文输入一一对应,所谓对齐就是在生成第yt个目标词的时候应该更关注源输入哪个词,也就是说现在翻译的源输入中哪个词或哪几个词)

Background:

translation就是要找arg max P(y|x),也就是给定了输入x之后找概率分布中最大的那个为输出

Encoder-decoder模型:

encoder读入输入序列X,最终将其转化为语境向量c,用于decode
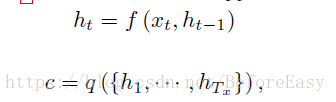

ht是t时刻的hidden state ,语境向量c是由hidden state相关的向量

decoder就是根据当前的语境向量c,以及已经预测出的序列y1,y2,,yt-1,来预测下一个词
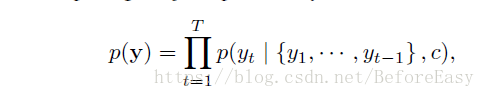

Learning to align and translate
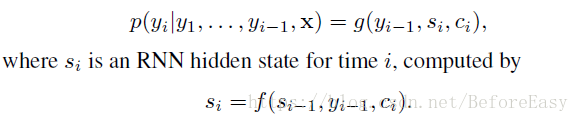


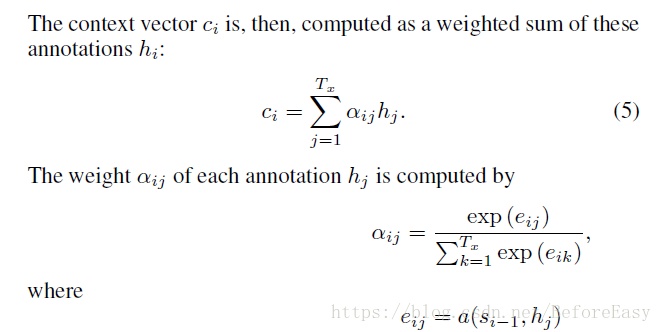
其实attention机制主要体现在语境向量c的计算上

相当于给每个输入的词的向量进行打分,预测的时候只需要关注得分更高的词组成的语境向量c

架构如图:
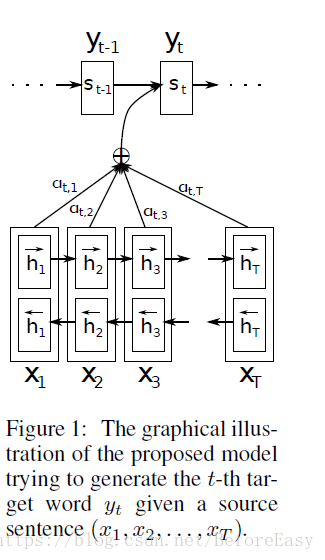


也就是aij相当于一个softmax过的得分,当前的语境向量ci就是一个得分的hidden state的加权和

eij就是alignment 模型中的一个评分,评定j位置的输入和i位置的输出之间的匹配程度

其训练方式就是和整个翻译模型一样的

Encoder是双向RNN,因为我们不仅仅想要一个词之前的词的信息,还想要后面的词的信息与关系
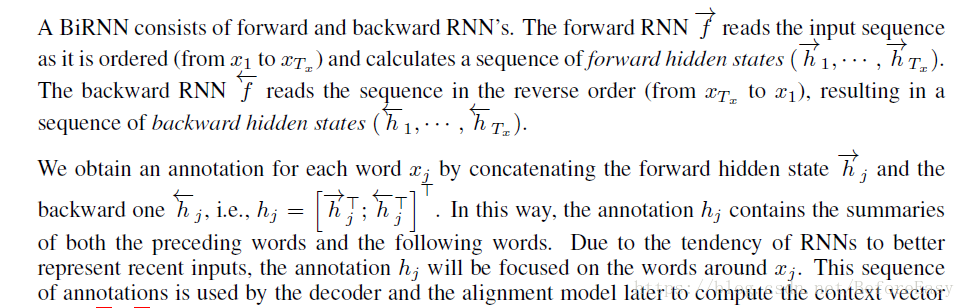

也就是前向来一次,后向再来一次,然后连接起来,共同构成hidden state hj

Expieriment

English-French parallel corpora 

结果:
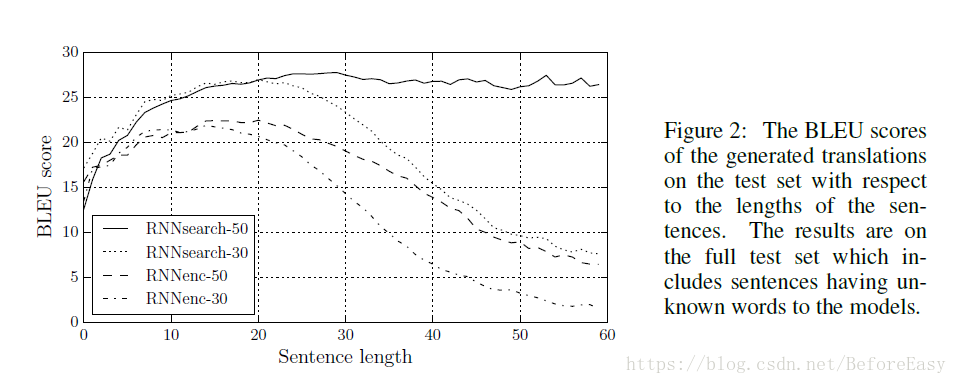

训练了RNN decoder-encoder模型和本文的RNN Search 模型

论文阅读《NEURAL MACHINE TRANSLATION BY JOINTLY LEARNING TO ALIGN AND TRANSLATE》 Abstract 这篇论文第一次运用注意力机制(Attention)解决机器翻译中的问题。和传统的统计机器翻译(SMT)不同,神经机器翻译(NMT)旨在构建一个神经网络来提高翻译性能。最近(2016)提出的NMT模型都是基于编码器和解码器:将源语言编码成一个定长向量(fixed-length vector),然后用解码器生成目标语言。这篇论文假设将源语言编码成定长向量是提高翻译性能的瓶颈,提出了... 阅读详情

相关推荐

【论文笔记】Neural Machine Translation by Jointly Learning to Align and Translate

Neural Machine Translation by Jointly Learning to Align and Translate  --这篇论文算是在自然语言处理(NLP)中或是encoder-decoder中第一个使用attention机制的工作,将attention机制用到了神经网络机器翻译(NMT) 。 Abstract  神经机器翻译是最近提出的一种机器翻译的方法。不像传统...

人间不值得 1万+

Neural Machine Translation by Jointly Learning to Align and Translate

Neural Machine Translation by Jointly Learning to Align and Translate 神经机器翻译是最近提出的一种机器翻译方法。与传统的统计机器翻译不同,神经机器翻译的目的是建立一个单一的神经网络,可以共同调整,使翻译性能最大化。最近提出的神经机器翻译的模型通常属于编码器-解码器家族,并将源句编码成一个固定长度的向量,解码器从中生成译文。在本文中,我们猜测使用固定长度的向量是提高这种基本编码器-解码器架构性能的瓶颈,并提出通过允许模型自动(软)搜索源句中

weixin_37958272的博客 2202

Neural Machine Translation by Jointly Learning to Align and Translate.pdf

机器翻译 第一篇加上attention的模型

NEURAL MACHINE TRANSLATION BY JOINTLY LEARNING TO ALIGN AND TRANSLATE-论文翻译

NEURAL MACHINE TRANSLATION BY JOINTLY LEARNING TO ALIGN AND TRANSLATE 摘要 神经系统的机器翻译是一个最近被提出到机器翻译的方法。不像传统的统计机器翻译模型,神经系统翻译目的在于创建一个单神经网络,这个网络能被共同调整最大化机器翻译性能。 最近提出用于神经机器翻译的模型通常属于编码器-解码器家族,并将源句子编码到一个固定长度的向量,这个向量是通过解码器生成翻译。在这篇论文中,我们猜想使用一个固定长度向量是一个瓶颈,在提高以编码器-解码器为基

AiBigData的博客 2788

25个Prompt去除AI味,让AI写作更像真人

自然语言生成技术飞速发展,如今AI写作已经深度融入内容创作、营销运营和日常办公。但许多用户发现,AI生成的文本常常带着一股“AI味”——句子过于工整、过度总结、细节空洞,导致内容被一眼识破,甚至面临“AI率”过高的尴尬。其实,这种塑料感源于大模型的训练数据与对齐机制,它偏好生成结构完整、逻辑平滑的“安全文本”。要解决这一问题,核心不在于更换工具或复杂调参,而在于掌握提示词工程的底层逻辑:通过限制结构、注入细节、切换视角、打乱顺序等具体指令,引导模型生成更接近人类表达习惯的文本。本文基于实战经验,提供25个可

weixin_26824299的博客 258

FFT去除频率分量的完整流程与数学分析

重叠与窗口:确保块间无缝过渡,避免幅度跳变;实时缓冲:处理速度需快于数据输入速度,避免断流;DAC的平滑角色:通过数模转换和滤波,将离散样点还原为连续波形。通过这种分段处理+重叠拼接的方法,即使FFT本身处理的是离散数据块,最终DAC输出仍能保持信号的时间连续性。以下是完整的数学分析过程和代码逻辑,演示如何通过FFT去除特定频率成分,并通过去窗技术恢复信号。信号加窗。

林愿留的博客 1610

(26)[ICLR15] NEURAL MACHINE TRANSLATION BY JOINTLY LEARNING TO ALIGN AND TRANSLATE

计划完成深度学习入门的126篇论文第二十六篇,蒙特利尔大学的KyungHyun Cho和Yoshua Bengio领导研究的新的机器翻译的方法JOINTLY LEARNING TO ALIGN AND TRANSLATE。 ABSTRACT&INTRODUCTION 摘要 神经机器翻译是近年来提出的一种机器翻译方法。与传统的统计机器翻译不同,神经机器翻译的目的是建立一个单一的神经网络...

gdtop的个人笔记 1783

ADRV902x射频评估实战:手把手教你用TES GUI生成ARM bin与JESD204C配置文件

在射频前端系统设计中,ADRV902x系列收发器凭借其宽带性能和灵活配置能力,已成为5G基站、微波回传等场景的核心器件。然而当工程师面对非官方硬件平台时,如何高效利用Transceiver Evaluation Software(TES)完成关键配置,成为项目推进的第一道门槛。本文将彻底解析脱离ADS9母板后的完整离线工作流,从参数预设到文件生成,手把手解决真实工程中的配置痛点。在Demo模式下,所有硬件状态检测都会被跳过,但配置文件生成功能完全可用。作为基础模板,因其配置最为简洁,便于后续自定义修改。

weixin_33704591的博客 429

【RNNsearch】neural machine translation by jointly learning to align and translate阅读与思考

neural machine translation by jointly learning to align and translate阅读与思考作为transformer的前传,同时,作为在nlp中第一篇注意力机制相关文章,还是很有必要一读。本文的主要贡献是打破了此前翻译中encoder-decoder需将句子变换到一个固定的长度,采用自适应方法。arxiv第一版时间为2014年。

胡侃有料的博客 1815

C#每日面试题-属性和字段的区别

在C#面试中,“属性(Property)和字段(Field)的区别”是基础且高频的考点。很多初学者会把两者混为一谈,甚至觉得“属性就是加了get/set的字段”,但这种理解只停留在表面。面试考察的核心,是对“封装思想”的理解,以及两者在语法特性、底层实现、实际应用中的本质差异。今天我们从“基础认知→核心差异→底层原理→实际应用→面试避坑”五个层面,把这个知识点讲透,既保证新手能看懂,又能满足面试的深度要求。

Amon的专栏 778

CAN轴控制流【6041,6040】

【代码】CAN轴控制流【6041,6040】

cfqq1989的博客 1782

neural machine translation by jointly learning to align and translate

1.论文出处 Dzmitry Bahdanau, KyungHyun Cho, Yoshua Bengio, “neural machine translation by jointly learning to align and translate”, 3rd International Conference on Learning Representations, ICLR 2015 下面说下为什么看这个论文吧,其实这个是看LAS的论文,感觉理解没那么透彻,所以才来看这个论文的,理论是一样的,但是这里写

weixin_44429447的博客 996

1、语义数据建模:避免陷阱与突破困境

本文探讨了语义数据建模的兴起背景、核心概念、生命周期及常见挑战。从数据丰富型组织和AI开发者的需求出发,分析了语义建模的关键元素和质量维度,并深入讨论了建模过程中可能出现的陷阱与解决方案。文章还针对语义模型的演化、治理和战略组织问题提供了突破思路,旨在帮助数据从业者更好地理解和应用语义建模技术,以提升数据驱动应用的有效性。

c8d9e0f1的博客 119

【论文阅读】Neural Machine Translation By Jointly Learning To Align and Translate

Neural Machine Translation By Jointly Learning To Align and Translate二作与三作 Universite de Montreal 鼎鼎有名的蒙特利尔大学,最后一位 Yoshua Bengio. 该文章的引用量: 1478这篇文章在神经网络 采用编码-解码RNN 做端到端的机器翻译的基础上,使得模型可以在预测下一个词的时候,自动地

独钓寒江雪 1万+

【YOLO11改进 - 检测头】Detect_LSCD检测头:量化的检测头,进一步提升模型的检测效率和精度

【YOLO11改进 - 检测头】Detect_LSCD检测头:量化的检测头,进一步提升模型的检测效率和精度

专注于图像领域,主要研究内容包括计算机视觉和深度学习,特别是在图像分类、目标检测和图像生成等方面有深入的研究和实践经验。 4094

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

论文阅读:Neural Machine Translation By Jointly Learning To Align And Translate

题目:Neural Machine Translation By Jointly Learning To Align And Translate 作者:Dzmitry Bahdanau,KyungHyun Cho, Yoshua Bengio∗ 论文地址:https://arxiv.org/abs/1409.0473 1、Introduction 神经机器翻译是机器翻译的一种新兴方法,最近由Kal...

Jeremy_lf的博客 1937

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

[论文阅读]Neural Machine Translation By Jointly Learning to Align and Translate

文章目录前言摘要一、神经机器翻译1、机器翻译2、基于RNN的Encoder-Decoder架构二、文章贡献三、模型架构1.译码器:整体概述2.编码器:用于注释序列的双向RNN四、实验设置五、代码实现六、结果分析总结 前言 论文名:Neural Machine Translation By Jointly Learning to Align and Translate 论文作者:Dzmitry Bahdanau et.al. 期刊/会议名:ICLR 2015 本文作者:XMU_MIAO 摘要   神经机器翻

ZY_miao的博客 1758

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

Neural machine translation by jointly learning to align and translate论文阅读笔记

Neural machine translation by jointly learning to align and translate论文笔记Title(零)细节(一)摘要(二)介绍(三) 背景3.1 RNN Encoder-Decoder3.1.1 Encoder部分3.1.2 Decoder部分(四)Learning to align and translate4.1 Decoder:General Description4.2 ENCODER: BIDIRECTIONAL RNN FOR ANNO

风行 960

【论文阅读】NEURAL MACHINE TRANSLATION BY JOINTLY LEARNING TO ALIGN AND TRANSLATE

XX

capsnever的博客 435

(Attention机制原文)论文阅读:Neural Machine Translation by Jointly Learning to Align and Translate

本文主要介绍了attention机制的原文内容,包括attention动机,attention如何计算和应用等。

简单博客All In 2917

论文阅读笔记|Neural Machine Translation by Jointly Learning to Align and Translate

1.Abstract Recently the neural machine translation is proposed; In this paper, we conjecture that the use of a fixed-length vector is a bottleneck in improving the performance of this basic encod...

weixin_30858241的博客 890

Neural Machine Translation by Jointly Learning to Align and Translate(注意力模型)论文阅读笔记

一、背景 seq2seq模型:https://blog.youkuaiyun.com/zyk9916/article/details/118002934 在seq2seq模型中,encoder将整个源句子编码成一个固定长度的向量(即取encoder中的最后一个隐状态),然后送到decoder中解码。这种方法对使得长句子难以处理。 作者认为,将句子编码成定长的向量是提升模型性能的瓶颈,因此提出了注意力模型来改善这个限制。 作者提出的模型不将整个输入句子编码为一个固定长度的向量。相反,它将输入语句编码为一个向量序列,并在d

zyk9916的博客 232

深度学习论文阅读指南:从RNN到Attention机制的终极演进之路

深度学习作为人工智能领域的核心技术,正以惊人的速度改变着我们的世界。本指南将带您探索从循环神经网络(RNN)到注意力机制(Attention Mechanism)的关键论文演进历程,帮助您系统理解深度学习的发展脉络和核心思想。通过精选的经典论文和实用资源,即使是新手也能快速掌握深度学习的精髓,开启您的AI探索之旅。 ## 深度学习的崛起:趋势与重要性 近年来,深度学习在人工智能领域的影响力呈指

gitblog_01423的博客 791
上一篇: 【论文阅读】Get to the point :summarization with pointer-generator networks
下一篇: Freckles -- 考研 最小生成树
BeforeEasy
博客等级 码龄10年 92粉丝 207原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值