


当GPT-5的推理能力超越人类专家,当Claude能处理百万级上下文,当Agent开始自主执行复杂任务——大模型领域的技术迭代速度已远超传统开发范式。如何在这场AI革命中脱颖而出?本文为你系统梳理2026年大模型面试的核心要点。

一、2026年大模型技术趋势
面试官最想看到的是你对技术前沿的洞察力。
核心技术突破
1. 混合注意力架构成为主流
****从传统Transformer的全注意力(O(n²))转向线性+标准注意力混合架构:
- 线性注意力层占75%,复杂度降至O(n)
- 标准注意力层占25%,保留全局建模能力
- 稀疏MoE设计,资源利用效率提升3-5倍
2. 原生多模态融合
****不再是"文本+图像"的简单拼接,而是统一表示空间:
- 文本、图像、音频、视频在同一语义空间对齐
- 跨模态理解能力显著提升
- Gemini 3.0 Ultra支持2000万Token上下文
3. 智能体技术规模化落地
****从"概念验证"到"规模部署":
- 长程规划能力:支持百万步任务分解
- 工具调用泛化:视觉识别适配所有软件
- 自我优化机制:通过强化学习持续进化
4. 端侧模型性能革命
****轻量化模型实现"性能越级":
- Qwen3.5-9B模型能力超越1200亿参数模型
- RTX 4090可部署70B参数稀疏MoE模型
- 手机端实现3B/7B模型实时推理
二、主流模型对比
| 维度 | GPT-5 | Claude 4.1 | Gemini 3.0 | DeepSeek V3.2 |
|---|---|---|---|---|
| **推理能力** | ★★★★★ | ★★★★☆ | ★★★★☆ | ★★★☆☆ |
| **上下文长度** | 1M tokens | 1M tokens | 2000万tokens | 20万tokens |
| **多模态能力** | 强 | 中 | 极强 | 弱 |
| **代码能力** | 90% | 95% | 85% | 88% |
| **部署成本** | 高 | 高 | 高 | 低 |
| **开源程度** | 闭源 | 闭源 | 闭源 | 开源 |
选型建议:****
***** **代码生成**:Claude 4.1(准确率95%)
- **长文档处理**:Claude 4.1或Gemini 3.0
- **多模态任务**:Gemini 3.0或GPT-5
- **成本敏感**:DeepSeek V3.2(性价比最高)
三、核心技术栈深度解析
1. Transformer架构演进
# 传统Transformer注意力机制def attention(Q, K, V): scores = Q @ K.T / sqrt(d_k) return softmax(scores) @ V# 混合注意力架构(2026主流)def hybrid_attention(x): # 75%线性注意力 linear_out = linear_attention(x) # 25%标准注意力 standard_out = standard_attention(x) # 动态融合 return dynamic_fusion(linear_out, standard_out)
关键概念:****
***** **自注意力**:捕捉序列内部依赖关系
- **多头注意力**:并行学习不同表示子空间
- **位置编码**:RoPE、ALiBi等相对位置编码
- **稀疏注意力**:降低计算复杂度
2. RAG技术架构
检索增强生成已成为解决幻觉和数据时效性的标准方案。
核心组件:****
****```plaintext
用户查询 ↓查询理解 → 意图识别 → 实体提取 ↓检索器 ├─ 向量检索(语义匹配) ├─ 关键词检索(精确匹配) └─ 重排序(结果优化) ↓上下文构建 → 文档分块 → 上下文窗口管理 ↓生成模型 → 增强提示 → 答案生成
**技术要点**:****

***** \*\*嵌入模型\*\*:text-embedding-3、bge-m3
* \*\*向量数据库\*\*:Milvus、Pinecone、Weaviate
* \*\*重排序\*\*:Cohere Rerank、BGE Reranker
* \*\*评估指标\*\*:RAGAS、TruLens

### 3. Agent开发框架

从"对话助手"到"智能代理"的跃迁。

**核心能力**:****

****| 能力 | 技术方案 | 2026趋势 |
| --- | --- | --- |
| \*\*任务规划\*\* | ReAct、ToT、Graph | Tree-of-Thoughts多路径搜索 |
| \*\*工具调用\*\* | Function Calling | 自动工具发现 |
| \*\*记忆管理\*\* | 向量记忆 + 长期记忆 | 持久化知识图谱 |
| \*\*自我反思\*\* | 反馈循环 | 强化学习优化 |

**实战代码**:****

****```plaintext
from langchain.agents import AgentExecutor, create_tool_calling_agentfrom langchain.tools import Tool# 定义工具def search_knowledge(query: str) -> str:    """搜索知识库"""    # 实现检索逻辑    return f"关于{query}的信息"tools = [    Tool(name="Search", func=search_knowledge,         description="搜索内部知识库")]# 创建Agentagent = create_tool_calling_agent(llm, tools, prompt)executor = AgentExecutor(agent=agent, tools=tools)# 执行任务result = executor.invoke({"input": "分析最新AI技术趋势"})
4. 微调技术
从全量微调到参数高效微调。
PEFT方法对比:****
****| 方法 | 参数更新比例 | 内存占用 | 适用场景 |
| — | — | — | — |
| **全量微调** | 100% | 高 | 任务差异大 |
| **LoRA** | 0.1%-1% | 低 | 通用适配 |
| **QLoRA** | 0.1%-1% | 极低(4bit量化) | 消费级GPU |
| **AdaLoRA** | 动态调整 | 中 | 复杂任务 |
LoRA实现:****
plaintext
from peft import LoraConfig, get_peft_model# LoRA配置config = LoraConfig(    r=16,           # 低秩维度    lora_alpha=32,  # 缩放因子    target_modules=["q_proj", "v_proj"],    lora_dropout=0.05)# 添加LoRA适配器model = get_peft_model(base_model, config)
四、2026面试新趋势
1. 从"算法题"到"AI结对编程"
传统LeetCode刷题模式正在失效,面试官更看重:
考察维度:****
**意图定义**:用精准Prompt引导AI生成符合架构规范的代码
- **逻辑审查**:识别AI生成的幻觉或安全漏洞
- **架构决策**:超越代码片段的系统设计能力
- **迭代优化**:建立反馈闭环,持续改进
典型场景:****
面试官:设计一个商品推荐系统,你可以使用AI工具辅助候选人:1. 用自然语言描述需求,生成系统架构2. 让AI生成核心代码框架3. 审查并优化AI输出4. 集成多个AI代理完成不同模块5. 测试验证并修复问题
### 2. 系统设计成为必考

**典型题目**:****

***** 设计一个基于RAG的企业知识库系统
* 设计一个支持百万级用户的AI客服系统
* 设计一个端云协同的智能推荐系统

**回答框架**:****

****```plaintext
1. 需求澄清   - 用户规模、QPS、数据量   - 核心功能、扩展性要求2. 高层架构   - 整体技术选型   - 核心组件划分3. 关键技术点   - RAG架构设计   - 向量数据库选型   - 缓存策略   - 监控告警4. 优化方案   - 性能优化   - 成本优化   - 安全防护
3. 工程落地能力
核心技能:****
***** **模型压缩**:量化、剪枝、蒸馏
- **推理加速**:vLLM、TensorRT-LLM、TGI
- **服务部署**:K8s编排、模型热更新
- **监控运维**:Prometheus + Grafana、日志聚合
推理优化示例:****
# vLLM推理加速from vllm import LLM, SamplingParamsllm = LLM( model="deepseek-chat", tensor_parallel_size=4, # 4卡并行 max_model_len=8192, gpu_memory_utilization=0.9)params = SamplingParams( temperature=0.7, top_p=0.9, max_tokens=1000)outputs = llm.generate(["分析AI技术趋势"], params)
五、面试高频问题与答案
基础层(20%)
Q1: 解释Transformer中的自注意力机制
A: 自注意力机制通过计算序列中每个元素与其他元素的相关性,捕捉长距离依赖关系。核心公式:Attention(Q,K,V) = softmax(QK^T/√d_k)V。优势是并行计算、长距离建模能力强。
****Q2: 什么是位置编码?RoPE的优势?
A: 位置编码为模型提供序列位置信息。RoPE(旋转位置编码)通过复数旋转注入相对位置信息,具有外推性,能处理超过训练长度的序列,是2026年的主流选择。
****### 进阶层(30%)
Q3: 如何缓解大模型幻觉?
A: 多维度解决方案: 1. RAG:检索增强生成,基于事实回答 2. RLHF/DPO:人类反馈强化学习,对齐人类价值观 3. 神经符号融合:引入符号推理,提升逻辑严谨性 4. 知识蒸馏:从大模型迁移到小模型,提升可控性
****Q4: LoRA的原理和优势?
A: LoRA通过在权重矩阵上添加低秩分解的更新矩阵,仅训练少量参数即可达到接近全量微调的效果。优势:参数更新量仅0.1%-1%,内存占用低,可插拔式适配器。
****### 实战层(30%)
Q5: 如何设计一个企业知识库系统?
A: 四层架构设计:
1. 数据层 - 文档解析(PDF、Word、网页) - 文本分块(固定大小、语义分块) - 嵌入生成(text-embedding-3-large)2. 检索层 - 向量数据库(Milvus/Pinecone) - 混合检索(向量+关键词) - 重排序(Cohere Rerank)3. 生成层 - 提示工程模板 - 上下文窗口管理 - 引用溯源4. 优化层 - 缓存策略(Redis) - 监控指标(准确率、延迟) - A/B测试
Q6: 如何优化大模型推理性能?
A: 多层次优化: 1. 模型层:量化(FP16→INT8→INT4)、剪枝 2. 框架层:vLLM、TGI、TensorRT-LLM 3. 系统层:批处理、并发请求、KV Cache 4. 硬件层:GPU加速、专用芯片(TPU/NPU)
****### 系统设计层(20%)
Q7: 设计一个支持百万级用户的AI客服系统
A: 分层架构设计:
1. 接入层 - 负载均衡(Nginx) - 网关限流(Sentinel) - 会话管理2. 业务层 - 对话管理(会话状态机) - 意图识别(NLU) - Agent编排(LangGraph)3. 模型层 - 快速响应(小模型) - 复杂推理(大模型) - 工具调用(知识库、API)4. 数据层 - 向量数据库(Milvus) - 缓存(Redis) - 日志存储(ES)5. 监控层 - 性能监控(Prometheus) - 质量评估(RAGAS) - 告警系统
Q8: 如何设计端云协同的AI系统?
A: 三层协同架构:
1. 端侧(设备) - 轻量模型(3B-7B) - 实时推理 - 隐私保护2. 边缘(边缘服务器) - 中等模型(13B-34B) - 区域协同 - 数据聚合3. 云端(中心服务器) - 大模型(70B+) - 复杂推理 - 模型训练协同策略:- 简单任务:端侧处理- 中等任务:边缘处理- 复杂任务:云端处理- 动态调度:根据任务复杂度和资源状态
六、学习路径建议
入门阶段(1-2个月)
- 理解Transformer基本原理
- 掌握Prompt工程技巧
- 熟悉主流大模型API使用
进阶阶段(3-4个月)
- 深入RAG技术栈
- 掌握LoRA等微调方法
- 学习Agent开发框架
精通阶段(5-6个月)
- 系统设计能力
- 工程落地能力
- 前沿技术跟踪
总结
–
2026年的大模型面试,早已不是简单的"背诵知识点",而是考察你的技术深度、工程能力、架构思维和对前沿趋势的把握。****
核心心法**: 1. 从原理到实践:不仅要懂"是什么",更要懂"为什么"和"怎么做" 2. 从单点成体系:构建完整的技术栈认知 3. 从跟随到创新:紧跟技术前沿,培养独立思考能力
最重要的是:保持对技术的热爱和持续学习的动力。AI领域变化太快,唯有不断进化,才能立于不败之地。
普通人如何抓住AI大模型的风口?
领取方式在文末
为什么要学习大模型?
目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。

随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!
最后
只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!
在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】

大模型全套学习资料展示
自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!
01 教学内容
-
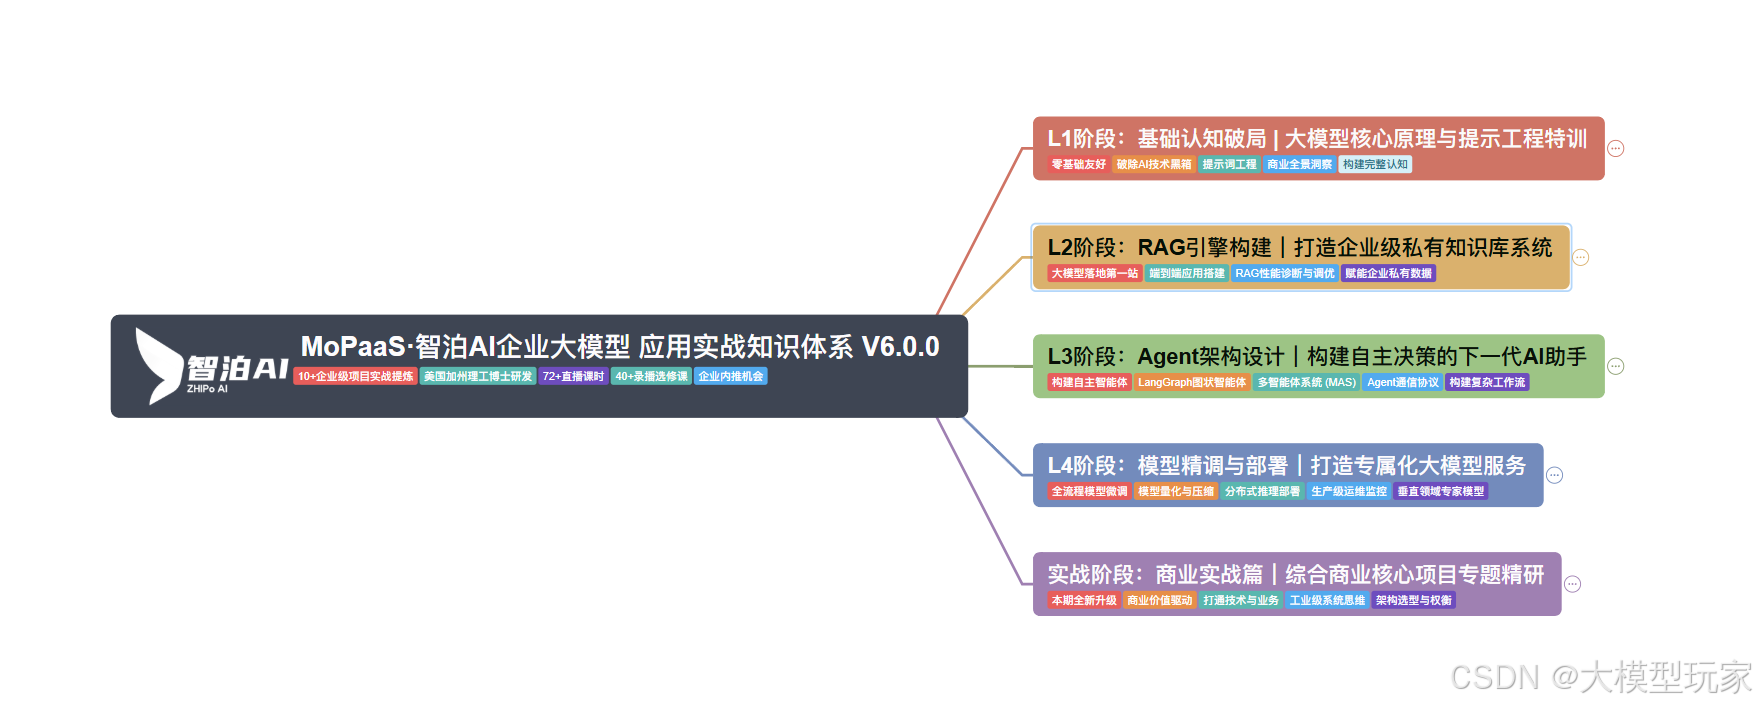
从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!
-
大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
02适学人群
应届毕业生: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。

vx扫描下方二维码即可
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】

本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!
03 入门到进阶学习路线图
大模型学习路线图,整体分为5个大的阶段:

04 视频和书籍PDF合集

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

05 行业报告+白皮书合集
收集70+报告与白皮书,了解行业最新动态!

06 90+份面试题/经验
AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)

07 deepseek部署包+技巧大全

由于篇幅有限
只展示部分资料
并且还在持续更新中…
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
 291


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


