


随着大语言模型(LLM)规模和能力飞跃,单纯依赖预训练和监督微调难以让模型完全符合人类期望。RLHF 通过结合人类反馈和强化学习,显著提升模型的对齐性和输出质量,成为当前 AI 安全和性能优化的重要手段。
阅读本文时,请带着这三个问题思考:
1.RLHF 为什么成为大模型对齐的重要方法?
2.RLHF 的基本流程和关键技术点有哪些?
3.实践中如何有效设计和应用 RLHF?
一、RLHF 背景与意义
预训练模型虽能力强大,但容易生成不合适、不准确甚至有害内容。同时传统监督微调虽能提升部分表现,但无法充分捕捉复杂的人类价值和偏好。所以RLHF应运而生,通过人类反馈信号指导模型,强化符合人类期望的行为,弥补监督微调的不足。
二、RLHF 的核心流程

1. 数据收集——人类反馈标注
人类评审员根据模型生成的多条候选回答,排序或评分,形成偏好数据。
2. 训练奖励模型(Reward Model)
利用人类偏好数据训练一个奖励模型,能够估计给定输出的质量分数。
3. 强化学习微调(Policy Optimization)
以奖励模型为反馈信号,使用强化学习算法(如 PPO)调整语言模型参数,使生成内容更符合人类偏好。
三、RLHF 的优势与挑战
·优势
o直接利用人类偏好进行优化,提升模型输出的自然性和安全性。
o灵活适应多样化的价值观和任务需求。
·挑战
o人类标注成本高,数据规模受限。
o奖励模型设计难,可能存在偏差和过拟合风险。
o强化学习训练过程复杂,需调参保证稳定。
四、RLHF 实现细节与技术要点
1. 数据格式与偏好对构建
·偏好对格式:每条训练样本包含相同输入的两个或多个模型生成输出,配有人类标注的优劣顺序。
·数据清洗:去除低质量标注,保证一致性。
2. 奖励模型训练
· 通常基于预训练语言模型架构,输入为“上下文+生成回答”,输出一个评分标量。
· 采用排序损失(如对比损失、交叉熵排序损失)训练奖励模型,使其能够区分更优回答。
· 定期用人工评估或自动指标验证奖励模型效果。
3. 强化学习微调算法
· 典型采用 PPO (Proximal Policy Optimization) 算法,兼顾稳定性和性能。
· 训练目标是最大化奖励模型评分,同时用 KL 散度约束保持与预训练模型的分布接近,防止过拟合奖励模型或输出退化。
· 训练时需监控奖励分数、KL 值和生成质量,动态调整超参数。
4. 训练流程示例
code-snippet__js
for batch in training_data:
5. 部署与在线反馈
· RLHF 训练完成模型可部署于生产环境,持续收集用户反馈。
· 在线反馈可用于后续奖励模型微调和强化学习迭代,形成闭环优化。
五、实践建议
· 设计高质量的标注流程,确保人类反馈准确且一致。
· 定期评估奖励模型的泛化能力,防止奖励误导。
· 控制强化学习训练节奏,避免模型行为剧烈波动。
· 结合监督微调与 RLHF,发挥各自优势。
最后我们回答一下文章开头提出的三个问题:
1.为什么 RLHF 成为大模型对齐的重要方法?
因为它利用人类偏好直接指导模型行为,弥补了传统微调难以捕捉复杂人类价值的问题。
2.RLHF 的基本流程是什么?
通过人类反馈收集偏好数据,训练奖励模型,再用强化学习调整语言模型以优化输出。
3.实践中如何设计和应用 RLHF?
需保障人类反馈质量,科学训练奖励模型,合理控制强化学习过程,确保稳定且有效的模型提升。
普通人如何抓住AI大模型的风口?
领取方式在文末
为什么要学习大模型?
目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
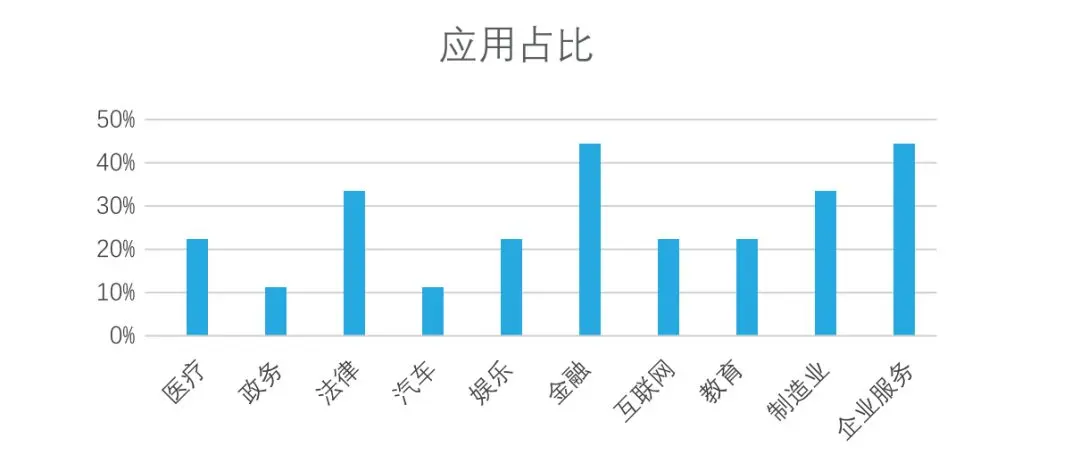
目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。
随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!
最后
只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!
在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
大模型全套学习资料展示
自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!
01 教学内容
-
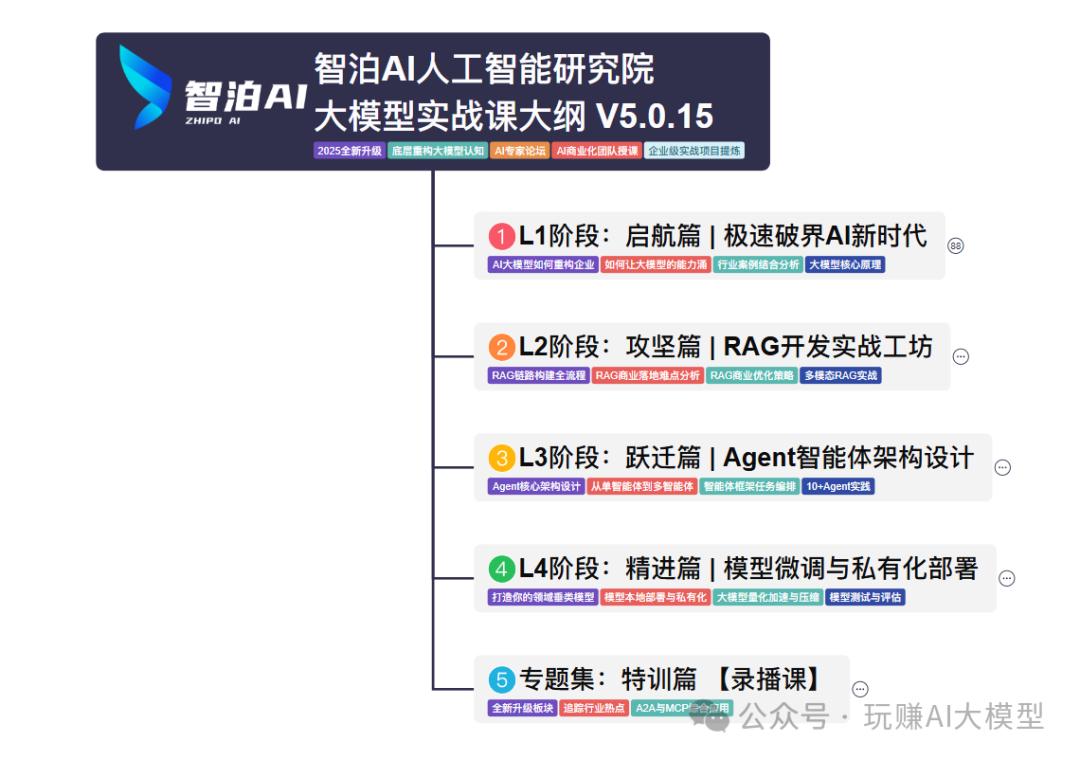
从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!
-
大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
02适学人群
应届毕业生: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。

vx扫描下方二维码即可
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!
03 入门到进阶学习路线图
大模型学习路线图,整体分为5个大的阶段:

04 视频和书籍PDF合集

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

05 行业报告+白皮书合集
收集70+报告与白皮书,了解行业最新动态!

06 90+份面试题/经验
AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)
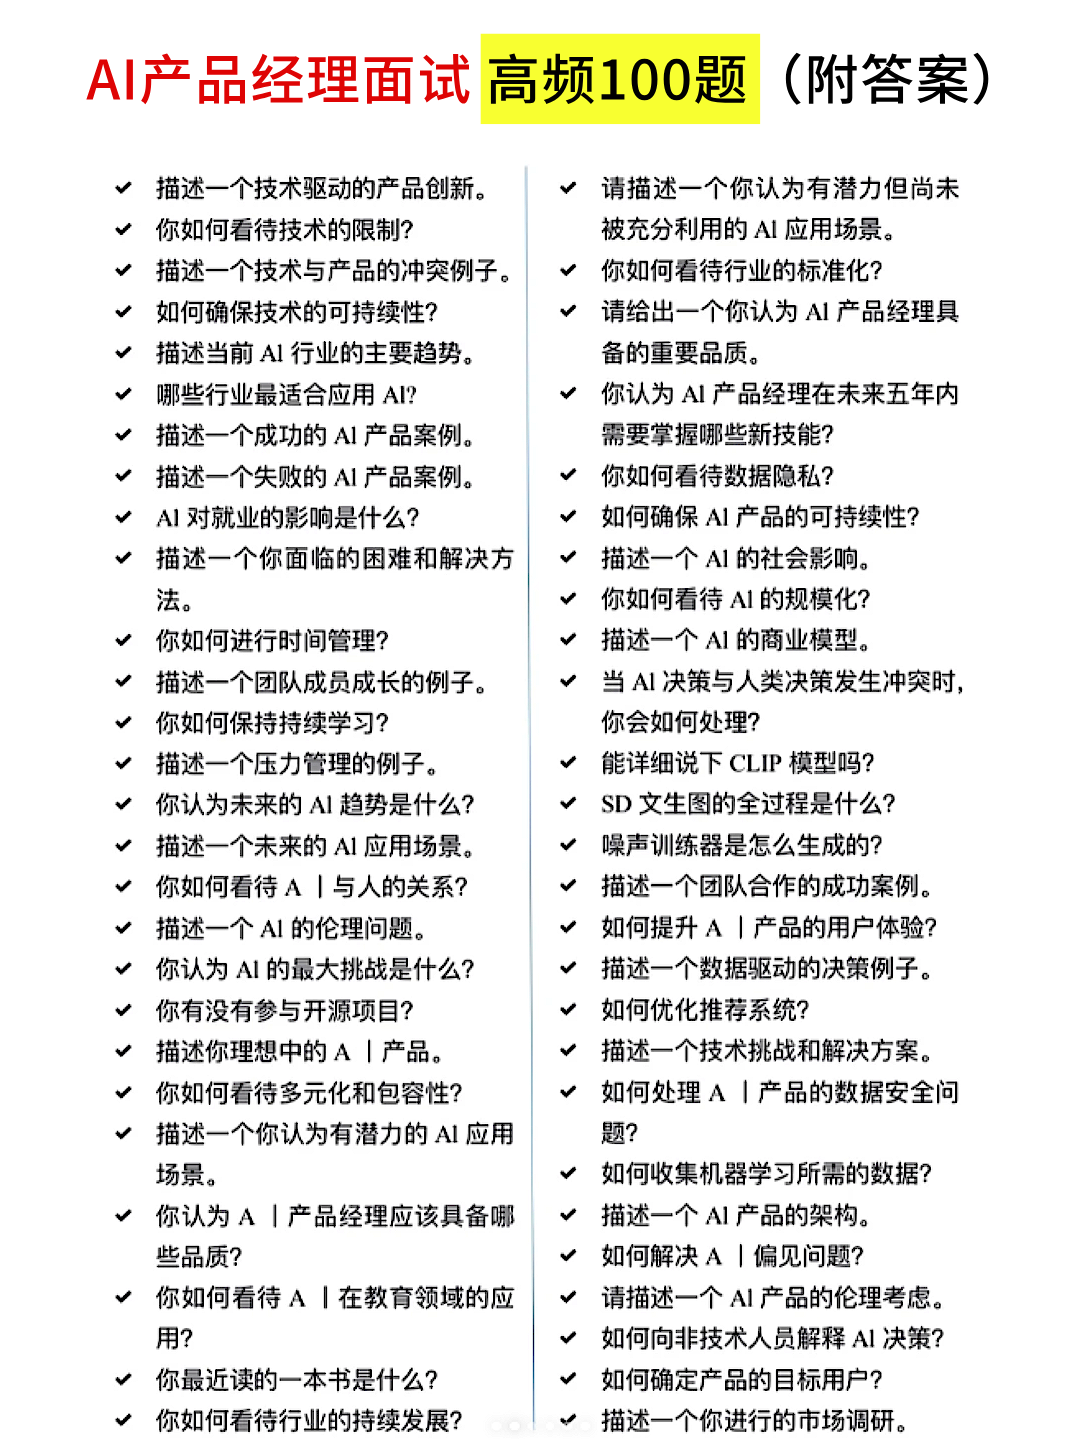
07 deepseek部署包+技巧大全
由于篇幅有限
只展示部分资料
并且还在持续更新中…
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
【附赠一节免费的直播讲座,技术大佬带你学习大模型的相关知识、学习思路、就业前景以及怎么结合当前的工作发展方向等,欢迎大家~】
 5万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


