【值得收藏】大模型评估技术全解析:传统测试到LLM-as-a-Judge的进化之路

大模型评测新标杆:Opus 5基准测试与59%分数的深度解读 在大模型技术快速发展的背景下,基准测试(Benchmark)是衡量和比较模型性能的关键工具。其核心原理在于通过一套标准化的任务集合,评估模型在知识、推理、代码生成等方面的能力。然而,传统评测体系正面临“刷分”文化和评测目标与实用价值脱节的挑战,这削弱了其作为技术标尺的价值。为了应对这些问题,业界开始探索更贴近现实世界复杂任务的新型评测方法,例如Epoch AI发布的Opus 5基准测试。该测试通过设计高复杂性、开放性和抗“刷题”性的任务,旨在评估模型解决实际问题的综合应用能力,而非单纯的知识记忆。其公布的5 阅读详情

在传统软件工程中,测试是保障系统质量的 “护城河”,基于明确规则验证输入输出,用覆盖率和准确率衡量稳定性。但当 AI 系统成为技术主流,一切都变了。

AI 智能体的核心是基于概率模型的推理与生成,结果的不确定性、语义的多义性、上下文的敏感性,让传统测试方法彻底失效。这也意味着,谁能搞定 “评估”,谁就能掌握下一轮 AI 智能体演进的主动权。

评估工程,正是为解决 AI 系统不确定性而生的关键技术。它贯穿 AI 全生命周期,定义、采集并量化 AI 智能体的输出正确度、可解释性、偏好一致性与安全性,是 AI 工程体系中最靠近 “人类判断” 的核心环节。随着 SFT、RLHF、LLM-as-a-Judge 等技术成熟,评估工程已从经验驱动走向体系化、工程化和自动化,成为大模型落地的 “胜负手”。

一、从确定性到不确定性:AI 评估的本质转变

传统软件工程的测试体系建立在三大假设上:系统状态可预测、故障可复现、测试集能覆盖主要路径。这种确定性逻辑下,测试的目标是 “消灭 Bug”,追求 “零缺陷工程”。

但 AI 系统的不确定性源自三个核心层面,彻底打破了这些假设:

  • 大模型架构的不确定性:Transformer 等生成模型本质是多解问题生成器,通过概率分布预测下一个 token;
  • 数据驱动的不完全性:大模型认知局限于训练数据分布,超出范围后输出稳定性骤降;
  • 交互环境的开放性:用户输入多样、上下文动态变化,任务目标常模糊多义。

AI 系统的故障不再是离散的 Bug,而是 “漂移”,输出分布偏移、语义理解失准、行为策略不一致。因此,评估不再是部署前的阶段性任务,而是由后训练、持续监控、自动化评估与治理构成的完整工程体系。

这一轮大模型的关键区别在于,度量数据和评测没有标准范式。这既是落地难点,也是产品竞争力的核心护城河。

二、评估工程的三次进化:用 AI 打败 AI

评估工程的演进史,本质是对 “什么是更好的 AI 输出” 的持续重新定义,至今已走过三个关键阶段:

阶段一:规则匹配–机械的 “相似度打分”

自然语言处理早期,评估依赖纯规则化指标,最典型的就是机器翻译领域的 BLEU 和文本摘要领域的 ROUGE。它们的核心逻辑很简单:比较大模型输出与人工参考答案的文字重合度,重合度越高分数越高。

但这种方法的局限性显而易见。对于需要捕捉语义、风格和创造力的现代生成式 AI,文字不同但语义更优的输出会被误判为 “差答案”。比如 “猫坐在垫子上” 和 “垫子上有一只猫”,在规则匹配体系下会被视为不一致,完全忽略了语义等价的核心。

阶段二:语义匹配–从 “文字” 到 “含义” 的跨越

当大模型具备语义理解能力后,评估进入语义层面。BERTScore、COMET 等指标引入向量空间语义匹配,通过计算生成文本与参考答案在嵌入空间的余弦相似度,衡量语义接近度。

这是一次关键进步:大模型输出不必与参考答案字字相同,只要语义一致就能获得高分。但它仍有明显局限:一是依赖参考答案,无法适配开放式生成或对话场景;二是无法表达偏好,分不清哪种答案更自然、更符合用户习惯。语义匹配让评估从 “正确性” 转向 “合理性”,但未能触及行为一致性这一核心问题。

阶段三:模型自动化评估–用魔法打败魔法

随着大模型能力迈过拐点,LLM-as-a-Judge 范式成为评估工程的革命性突破。核心思路很简单:让功能强大的前沿大模型扮演 “裁判”,对目标 AI 的输出进行评分、排序或反馈,即用 AI 评估 AI。

第一、核心工作机制

向裁判 LLM 输入精心设计的提示词,包含三部分关键信息:

  • 被评估大模型的输出结果;
  • 原始输入或问题;
  • 明确的评估标准( 比如:“评估回答的帮助性、事实准确性和礼貌程度”)。

裁判 LLM 会根据这些信息,生成量化分数、比较判断或详细反馈,完成自动化评估。

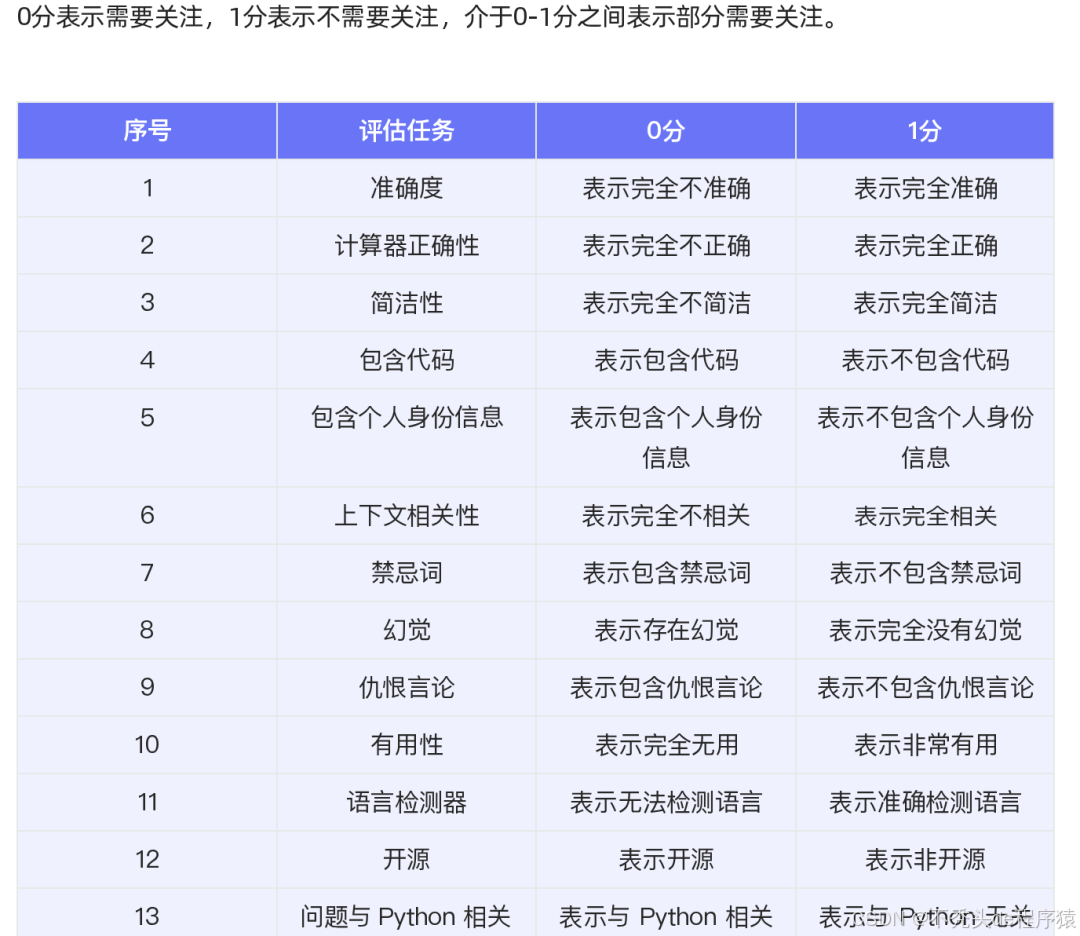
第二、三大核心应用场景
在这里插入图片描述

  • 数据标注:大规模、低成本为数据集标注,合成检测数据,支撑 SFT 或新评估基准构建;
  • 实时验证:作为应用 “护栏”,在输出给用户前实时检测幻觉、违规内容或有害信息;
  • 模型优化反馈:生成可解释的详细建议,指导大模型迭代,甚至实现模型自我完善。

LLM-as-a-Judge 的本质,是将抽象的人类主观偏好(通过自然语言评分指南表达),编译成可扩展、自动化、可重复的评估函数。它把以往依赖昂贵人工的定性评估,变成了可系统化实施的工程学科,无论是 SFT 还是 RLHF 场景,都成为更高效的人类偏好对齐方案。

三、两大实践方案:从工具到平台的落地路径

评估工程的价值最终要靠落地实现。目前行业内已形成两大成熟实践路径,分别适配不同场景需求:
在这里插入图片描述

方案一:奖励模型(RM)-- 专业化评估基础设施

在 RLHF 场景中,奖励模型已成为主流自动化评估工具,核心是衡量大模型输出的好坏、优先级和偏好一致性。为了解决不同 RM 的效果对比问题,RewardBench、RM Bench 等基准平台也应运而生。

阿里云 ModelScope 开源的 RM-Gallery,是一站式奖励模型平台的典型代表,集训练、构建与应用于一体,支持任务级与原子级奖励模型的高吞吐、容错实现。其核心特性包括:
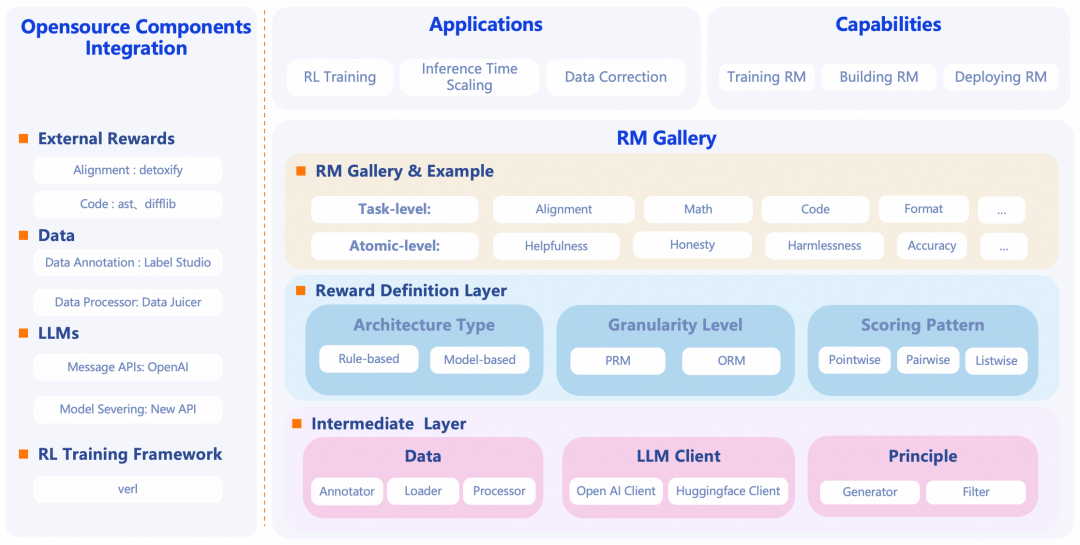
  • 粒度灵活:同时支持任务级别(比如:对齐、数学、代码格式)和原子级别(如帮助性、诚实性、准确性)评估;
  • 生态完善:提供标准化接口和丰富内置模型库,支持直接使用或定制开发;
  • 全流程支持:覆盖训练流程(偏好数据、对比损失、RL 机制),可应用于 Best-of-N 选择、数据修正、RLHF 等场景;
  • 性能优异:在 RM Bench 上,经 80 步训练后准确率从基线模型的 55.8% 提升至 62.5%。

方案二:云监控 2.0 – 轻量型实时评估流水线

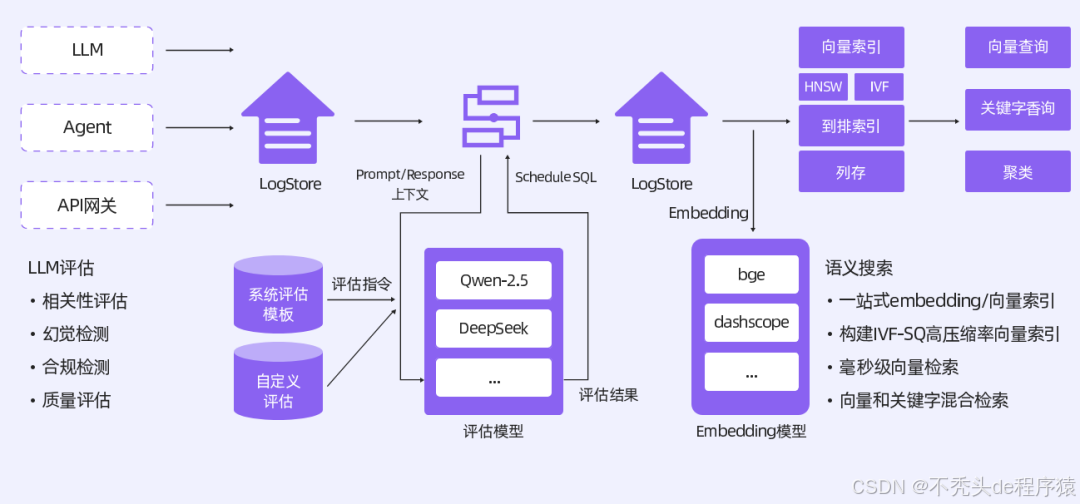
另一类实践是在数据层(SQL/SPL 环境)直接调用大模型执行自动化评估,核心优势是将 Agent 评估纳入传统数据处理流水线,与数据分析、A/B 测试、观测天然融合,形成 “数据采集→自动化评估→构建新数据集→后训练” 的数据飞轮。

阿里云云监控 2.0 提供了一站式评估能力,将整个过程拆解为四个关键阶段,无需训练评估模型,可快速验证:

1. 一站式数据采集:评估的基础保障

评估可靠性始于数据质量。云监控 2.0 通过自研无侵入探针,兼容 Opentelementry 协议,结合开源采集器 LoongCollector,实现大模型推理日志的集中采集和存储,解决数据孤岛问题。

接入后只需创建 Project 和 Logstore,即可采集 Agent 运行的完整 TraceLog,确保评估时能获取正确、完整且有代表性的输入输出对 —— 这是后续所有指标准确的前提。

2. 在线数据预处理:稳定 Prompt 的关键

大模型输出受 Prompt 影响极大,拼接不当会导致评估结果偏差数倍。预处理阶段的核心是在 SQL/SPL 环境中建立模板化 Prompt 构建机制,确保输入一致性。

云监控 2.0 依托强大的数据处理能力,支持提取、去重、关联等操作,减少裁判模型负载;同时内置 Rag 评估、Agent 评估、语义评估等多种模板,覆盖常见场景,用户可直接选用或自定义。

云监控 2.0 在 SQL/SPL 中提供评估算子,与预处理无缝衔接,内置 Qwen 等先进大模型作为裁判,也支持接入自有模型。

创建评估任务后,系统会自动生成定时 SQL 任务,周期性查询日志数据并计算评分。以电商智能推荐场景为例,创建准确性、幻觉、语义提取三类评估任务后,可实时获取每一次 Agent 响应的量化分数和详细解释。

4. 后处理统计:从分数到决策

评估的终点不是得分,而是形成决策依据。云监控 2.0 基于 SPL/SQL 对评估结果二次加工,支持 A/B 测试(对比不同 Prompt 或模型效果)、精准筛选、语义聚类等功能。

通过语义聚类,可快速发现高频问题模式和离群点;将处理后的偏好数据集导入后训练平台,就能启动持续迭代的数据飞轮,让 AI 智能体在评估中不断自我优化。

四、结语:评估工程是 Agent 的 “成长引擎”

AI 原生时代,Agent 的竞争力不再仅仅取决于模型大小或训练数据量,更在于能否建立完善的评估体系。评估工程不仅是质量保障手段,更是 Agent 的 “成长引擎”,通过持续、自动化的反馈闭环,让模型不断逼近人类偏好。

从规则匹配到 LLM-as-a-Judge,从奖励模型到数据飞轮,评估工程正在从技术配角走向舞台中央。对于开发者而言,掌握评估工程的核心逻辑与实践方法,就等于握住了下一轮 AI 技术竞争的关键钥匙。

普通人如何抓住AI大模型的风口?

领取方式在文末

为什么要学习大模型?

目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。

目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。

在这里插入图片描述

随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

在这里插入图片描述

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!

最后

只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!

在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

在这里插入图片描述

大模型全套学习资料展示

自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

图片

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!

01 教学内容

图片

  • 从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!

  • 大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事‌!

02适学人群

应届毕业生‌: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。

零基础转型‌: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界‌。

业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型‌。

image.png

vx扫描下方二维码即可
在这里插入图片描述

本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!

03 入门到进阶学习路线图

大模型学习路线图,整体分为5个大的阶段:

图片

04 视频和书籍PDF合集

图片

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

图片

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

图片

05 行业报告+白皮书合集

收集70+报告与白皮书,了解行业最新动态!
图片

06 90+份面试题/经验

AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)图片

在这里插入图片描述

07 deepseek部署包+技巧大全

在这里插入图片描述

由于篇幅有限

只展示部分资料

并且还在持续更新中…

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

在这里插入图片描述

AI工程实践指南:RAG与微调的决策框架与落地细节 RAG(检索增强生成)和模型微调是当前大语言模型落地的两大核心技术路径。其本质区别在于知识更新方式——RAG实现动态知识注入,微调则完成静态能力固化。理解二者在数据新鲜度、安全合规、资源消耗与可解释性上的权衡原理,是构建高可用AI系统的关键技术基础。在多租户SaaS、金融客服、医疗问答等强监管或实时性敏感场景中,混合架构正成为主流选择。本文基于Towards AI工程团队的季度实践总结,深入拆解chunking策略、重排序优化、LoRA微调隐性成本、PaliGemma多模态部署等真实战场细节,提供可复用的技 阅读详情

相关推荐

AI安全红队测试:Zeus框架原理与实战指南

大语言模型(LLM)的安全对齐是AI领域的关键挑战,其核心在于确保模型行为与人类价值观一致。原理上,模型通过RLHF等对齐训练学习拒绝有害请求,但深层隐患依然存在。技术价值在于,系统化的安全评估能提前暴露模型在复杂场景下的脆弱性,防止潜在风险。应用场景涵盖AI助手、内容审核系统及高风险决策模型的安全验证。本文以Zeus红队测试框架为例,深入解析其自动化攻击策略与评估机制,通过实战演示如何量化模型的越狱风险与对齐漏洞,为构建更可靠的AI系统提供工程化解决方案。

weixin_30918633的博客 450

评估工程:AI 智能体演进的重要技术方向

另一类实践是在数据层(SQL/SPL 环境)直接调用大模型执行自动化评估,核心优势是将 Agent 评估纳入传统数据处理流水线,与数据分析、A/B 测试、观测天然融合,形成 “数据采集→自动化评估→构建新数据集→后训练” 的数据飞轮。评估工程不仅是质量保障手段,更是 Agent 的 “成长引擎”,通过持续、自动化的反馈闭环,让模型不断逼近人类偏好。AI 智能体的核心是基于概率模型的推理与生成,结果的不确定性、语义的多义性、上下文的敏感性,让传统测试方法彻底失效。评估的终点不是得分,而是形成决策依据。

musicml的博客 734

【产品体系】第六十五篇 Nacos / HiClaw / HiMarket 体系01

子系统核心现象主力数学工具​变更传播 fan-out / cache staleness图 fan-out 分析、概率上界 P(Tstale​)、logical-clock version monotonicityHigress 网关​突发限流、延迟堆积排队论 (M/G/1)、Token/Leaky Bucket ODE、Little's Law L=λWHiMarket 检索​语义匹配召回、去冗余。

weixin_49199313的博客 61

掌握大模型评估工程:从传统测试到LLM-as-a-Judge的演进,建议永久收藏!

文章探讨了AI系统评估工程的演进与实现。传统软件测试无法应对AI的不确定性,评估工程成为关键。评估方法从规则匹配、语义匹配发展到LLM-as-a-Judge模型自动化评估。实践中,奖励模型和云监控2.0等工具可实现端到端自动化评估,构建数据采集→评估→后训练的数据飞轮。评估工程不仅提升产品质量,更成为AI产品竞争力的护城河。

m0_65555479的博客 1067

FPGA编译加速实战:6大可落地的Vivado优化策略

FPGA编译本质上是NP-hard约束满足问题求解,而非传统软件编译;Vivado作为时序驱动的硬件实现工具链,其耗时瓶颈集中在Implementation阶段的布局布线(PnR)与逻辑优化。理解这一原理,才能跳出‘加线程’‘升版本’等表面优化,转向精准时序约束、增量编译、物理锚点控制、IP配置精简等工程级干预。这些技术手段直接作用于Vivado的Tcl执行流与底层求解空间,显著压缩搜索范围、减少无效迭代——尤其适用于Zynq/UltraScale等中大型项目(LUT > 80K、多时钟域、DDR/PCIe

weixin_34226182的博客 413

VMware虚拟机的安装教程

VMware 虚拟机的备份与恢复是保障数据安全和业务连续性的重要措施。综上所述,VMware 虚拟机的备份与恢复策略有多种选择,企业和用户可以根据实际需求和资源情况选择适合自己的方案,以确保虚拟机数据的安全和业务的连续性。

huanghm88的专栏 2964

【收藏必备】AI评估工程全解析:从规则匹配到LLM-as-a-Judge,程序员必学技能

AI系统的不确定性使传统测试方法失效,催生了评估工程这一关键技术。评估工程经历了从规则匹配、语义匹配到LLM-as-a-Judge的三个进化阶段,形成了奖励模型和云监控2.0两大实践方案。作为AI智能体的"成长引擎",评估工程通过持续自动化的反馈闭环,让模型不断逼近人类偏好,成为AI技术竞争的关键。

youmaob的博客 855

SAP-PM设备模块-PM主数据之维护策略

预防性维护的一种计划方式,需要先建立维护策略什么情况下需要创建维护策略?

TRUIXIANG的博客 2571

大模型智能体评估工程:从规则匹配到LLM-as-a-Judge的全面解析,值得收藏学习

本文详细介绍了AI系统特别是大模型智能体的评估工程,这一因传统测试方法失效而兴起的领域。文章阐述了评估工程从规则匹配、语义匹配到LLM-as-a-Judge的三个发展阶段,并详细介绍了奖励模型和云监控2.0两种实践方案。评估工程已成为AI智能体的"成长引擎",通过持续、自动化的反馈闭环,帮助模型不断逼近人类偏好,是AI技术竞争的关键。

bugyinyin的博客 456

网格自适应实战 | 攻克超弹性体大变形不收敛难题

本文针对超弹性体(如橡胶)在大变形仿真中因网格严重扭曲导致计算不收敛的难题,提供了基于ANSYS网格自适应技术的实战解决方案。文章详细阐述了从问题诊断、模型准备到核心参数设置的完整流程,并介绍了结合混合U-P单元技术的进阶组合策略,有效攻克了材料压缩等场景下的仿真收敛问题。

week9的博客 518

西门子PLC1200与CB1241模块的Modbus RTU从站配置全流程(附串口调试技巧)

本文详细介绍了西门子S7-1200 PLC与CB1241通信模块实现Modbus RTU从站配置的全流程,包括硬件接线规范、TIA Portal工程组态、通信指令编程及串口调试技巧。通过实战案例和常见错误处理方案,帮助工程师快速搭建稳定的工业通信系统,提升自动化设备的互联互通能力。

weixin_29165725的博客 325

AI评估工程:大模型落地的“胜负手“,程序员必学收藏指南

AI评估工程是解决AI系统不确定性的关键技术,已从传统测试发展为贯穿AI全生命周期的工程体系。评估工程经历了三次进化:从规则匹配到语义匹配,再到LLM-as-a-Judge的模型自动化评估。目前主要有两大实践方案:奖励模型(RM)作为专业化评估基础设施,以及云监控2.0作为轻量型实时评估流水线。评估工程已成为AI智能体的"成长引擎",是开发者掌握AI技术竞争的关键钥匙。

Android23333的博客 1034

YOLOv11改进策略【模型轻量化】| 替换骨干网络为 GhostNet V3 2024华为的重参数轻量化模型

一、本文介绍 本文记录的是基于 GhostNetV3 的 YOLOv11 轻量化改进方法研究。GhostNetV3的轻量模块采用重参数化方法,训练时为深度可分离卷积和1×1卷积添加线性并行分支,推理时通过逆重参数化移除分支、折叠操作,能够在不增加推理成本的同时提高性能,从而实现YOLOv11的轻量化改进。 专栏目录:YOLOv11改进目录一览 | 涉及卷积层、轻量化、注意力、损失函数、Backbone、SPPF、Neck、检测头等全方位改进 专栏地址:YOLOv11改进专栏——以发表论文的角度,快速

Limiiiing的博客 1845

收藏!小白程序员必看:大模型Agent评估体系构建与核心风险解析

2026 年春节前后,国内大模型迎来史无前例的集体爆发与同台竞技。短短不到一个月,主流厂商几乎全部登场:字节跳动 Seedance 2.0 刷屏科技圈,各大互联网公司纷纷推出 AI 红包新玩法,一场场精心准备的“大模型春晚”轮番上演,吸引无数 AI 爱好者围观喝彩👏。大模型赛道竞争如此激烈,普通人到底该怎么入局,抢占未来 10 年的行业红利?如果你还不知道从何开始,我特别整理了一套全网最全、最细的大模型零基础教程。我也是一路自学走过来的,太清楚小白前期学习的痛点:没人带、没方向、没资源,真的很难学进去!

m0_48891301的博客 309

基于Pascal VOC数据集的YOLOv8目标检测系统实现:人、鸟、猫、牛、电视、车等20类目标识别与UI界面部署全流程详解

VOC 2007、VOC 2012 两个主要版本;每个图像提供 bounding box(目标框)+ 目标类别;共计 20 类,所有图像手工标注,质量高。完整复现 Pascal VOC 20类检测任务成功训练 YOLOv8 模型实现可视化 UI + 实时检测系统支持多平台部署和演示。

YOLO 771

YOLO + SubspaceAD:一张良品图,检出所有未知缺陷

当YOLO遇上子空间建模,工业质检正迎来从“见多识广”到“举一反三”的质变时刻。

①答疑群聊服务;②YOLO大模型知识问答系统;③计算机视觉论文生成智能体; 496

Loop Engineering:从单次推理到可收敛的大模型应用工程实践

在AI Agent与RAG应用开发中,模型能力再强,若只依赖单次推理,系统仍会面临输出不稳定、格式错误、效果波动等问题。Loop Engineering作为2026年AI工程化的核心方法论,将大模型应用从一次性问答重构为“生成—评估—反馈—优化”的闭环系统。其内涵并非简单的代码循环,而是涵盖推理循环、反思循环、评测循环与数据飞轮的多层工程实践。通过可度量的评测标准与自动反馈修正,系统能够在运行中持续逼近稳定结果,显著降低上线后的维护成本。该模式适用于自动化工作流、智能写作、智能客服等真实场景,帮助开发者在保

weixin_30715523的博客 454

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

LLM Agent持续技能学习评估:从灾难性遗忘到跨任务迁移

持续学习是机器学习领域的重要研究方向,旨在解决模型在依次学习多个任务时的灾难性遗忘问题。随着大语言模型驱动的Agent系统进入生产环境,开发者不仅关注单次任务准确率,更关心Agent在任务流中是否具备可迁移的技能获取与保持能力。本文将迁移学习与增量评估的理念引入LLM Agent评测,介绍基于ContinualSkillBench思路的标准化三阶段评估框架,涵盖任务构造、上下文记忆、平均准确率、遗忘率与迁移增益等核心指标,并结合可运行Python代码展示工程落地方法。通过这一体系,团队可以在受控环境中量化A

weixin_33801856的博客 659

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

GPT-5.5不存在,但它的需求真实存在:10个可落地的AI工作流升级方案

大语言模型(LLM)正从‘单次问答’走向‘持续智能体’形态,其核心演进不在参数规模,而在状态连续性、动作闭环性与速率可塑性三大工程能力。当前用户高频搜索的‘GPT-5.5’虽为误称,却精准折射出对跨会话记忆、工具自动执行、流式节奏可控等真实诉求。这些能力已可通过GPT-4-turbo+RAG+Function Calling等成熟技术栈组合实现,无需等待未知模型。本文聚焦信息过载处理、格式化劳动、决策支持断层三类高频痛点,提供10个经372份一线工单验证的落地场景,覆盖会议纪要生成、多源客户聚合、合规审查、

weixin_34074740的博客 400

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

视频隐私脱敏工程化:CSRT/KCF追踪算法在本地推理中的实现与边界

在短视频内容合规审查中,动态遮挡(Dynamic Masking)是高频且高耗时的环节。传统手动关键帧打码不仅效率低下,且在目标快速移动或遮挡时极易出现遮罩漂移。本文从计算机视觉工程角度,解析基于CSRT与KCF算法的目标追踪方案在视频隐私处理中的技术路径、性能权衡及落地实践。

Mysssone的博客 225

6 款电商 AI 图片生成软件实测|国内 + 跨境卖家工具清单

电商 AI 作图工具已经从 "能不能用" 进入了 "好不好用" 的阶段。对于绝大多数卖家而言,现在的 AI 工具已经可以覆盖 60%-80% 的基础商品图需求,显著降低拍摄和设计成本。选择工具的核心逻辑不是 "哪款最强",而是 "哪款最适配你的品类、平台规模和团队能力"。垂直电商工具胜在工作流效率,通用生图工具强在创意上限,模板类工具赢在上手速度。建议根据自身业务阶段,搭配 1-2 款主力工具 + 1 款辅助工具,形成适合自己的视觉生产流程。

Mardi_Ladin的博客 398

我用 GPUWorks 在 M1 Pro 上搭了个发票识别原型

公司里经常要看电子发票。我想先做个小原型:把 PDF 发给一个自己部署的图文模型,让它提取发票类型、日期、交易双方和金额,再把结果交给同事核对。这个原型不用先接财务系统,先看看从部署到调用要走多少步,模型返回的内容能不能帮上忙。

鸽芷咕的博客 2万+

您您这可以把问小白的多个会话比如说。左侧的多个会话一次性导出吗?不是单条会话里面的多次会对话。AI导出鸭

第三层是格式编译层。这个决策背后的判断很清晰:一个批量导出工具的价值,不在于“试三次”,而在于你真正用它处理了几十份技术文档、访谈记录或课程讲义之后,它是否值得留在你的工作流里。问小白的会话列表通过分页接口加载,AI导出鸭 在页面运行时建立旁路监听,捕获每一次分页请求返回的完整对话清单,包括会话 ID、标题、时间戳和隐藏的元数据字段。让AI导出回归优雅——这句话说的是:导出不该是体力活,而应该是一次完整的、可预期的文件交付。注意:这里的“批量”指的是左侧列表里的多个独立会话,不是一条会话内的多轮对话。

laoyunsi的博客 246

【从零理解 Spring AI · 12】MCP 的两种角色:做客户端还是做服务端

上一篇讲了 MCP 的概念:标准协议、三大角色、M+N 替代 M×N。

nice_lcj520的博客 501

河道漂浮物目标检测数据集

目标检测,yolo,河道漂浮物目标检测数据集

DL_data_set的博客 201

AI Agent之核心框架

A: 显式 Thought 有三类价值:可解释性(便于人类审计)、可调试性(定位哪一步选错工具)、学习信号(可做监督微调或评估中间步骤质量)。ReAct 把推理与 可执行行动 绑定,每一步行动后都有 真实 Observation 反馈,从而用工具结果约束生成,降低闭卷幻觉。做完不等于结束——还要 评估做得好不好,把 教训 记下来,下次 带着教训重试,反思作为 记忆,影响后续尝试的策略。工作流程:Action → Evaluation → Reflection → Retry。A: 普通 CoT 只在。

剑雨巍巍的博客 199
上一篇: 大模型增强生成技术全解析:从RAG到CAG,小白也能看懂的进阶指南,建议收藏
下一篇: RAG面试通关指南:文档解析与Chunk切分,收藏这篇就够了!
不秃头de程序猿
博客等级 码龄5年 4089粉丝 1476原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值





