【收藏】小白也能学会:LLM、RAG、Agent三层栈详解与实战应用

从Transformer到RAG与Agent:LLM全栈实战路线图与7个Notebook Transformer架构通过其核心的注意力机制,彻底改变了序列建模的范式,实现了对长距离依赖的高效捕捉,奠定了现代大语言模型(LLM)的技术基石。其编码-解码框架与预训练-微调范式,使得模型能够从海量无标注数据中学习通用表征,并高效适配下游任务,从而释放出巨大的工程应用价值。这一技术广泛应用于机器翻译、文本生成与语义理解等场景。在此基础之上,针对模型知识更新与可控性挑战,检索增强生成(RAG)技术通过引入外部知识库,有效缓解了模型的幻觉问题,提升了专业领域问答的准确性。而智能体(Agent)技术则通过赋予 阅读详情

LLM、RAG、Agent:AI从业者必懂的三层栈指南

首先声明:这不是纸上谈兵的概念科普,而是基于国内产品落地的实战笔记!如果你正在做AI产品,这篇文章能帮你少走不少弯路。

先说结论

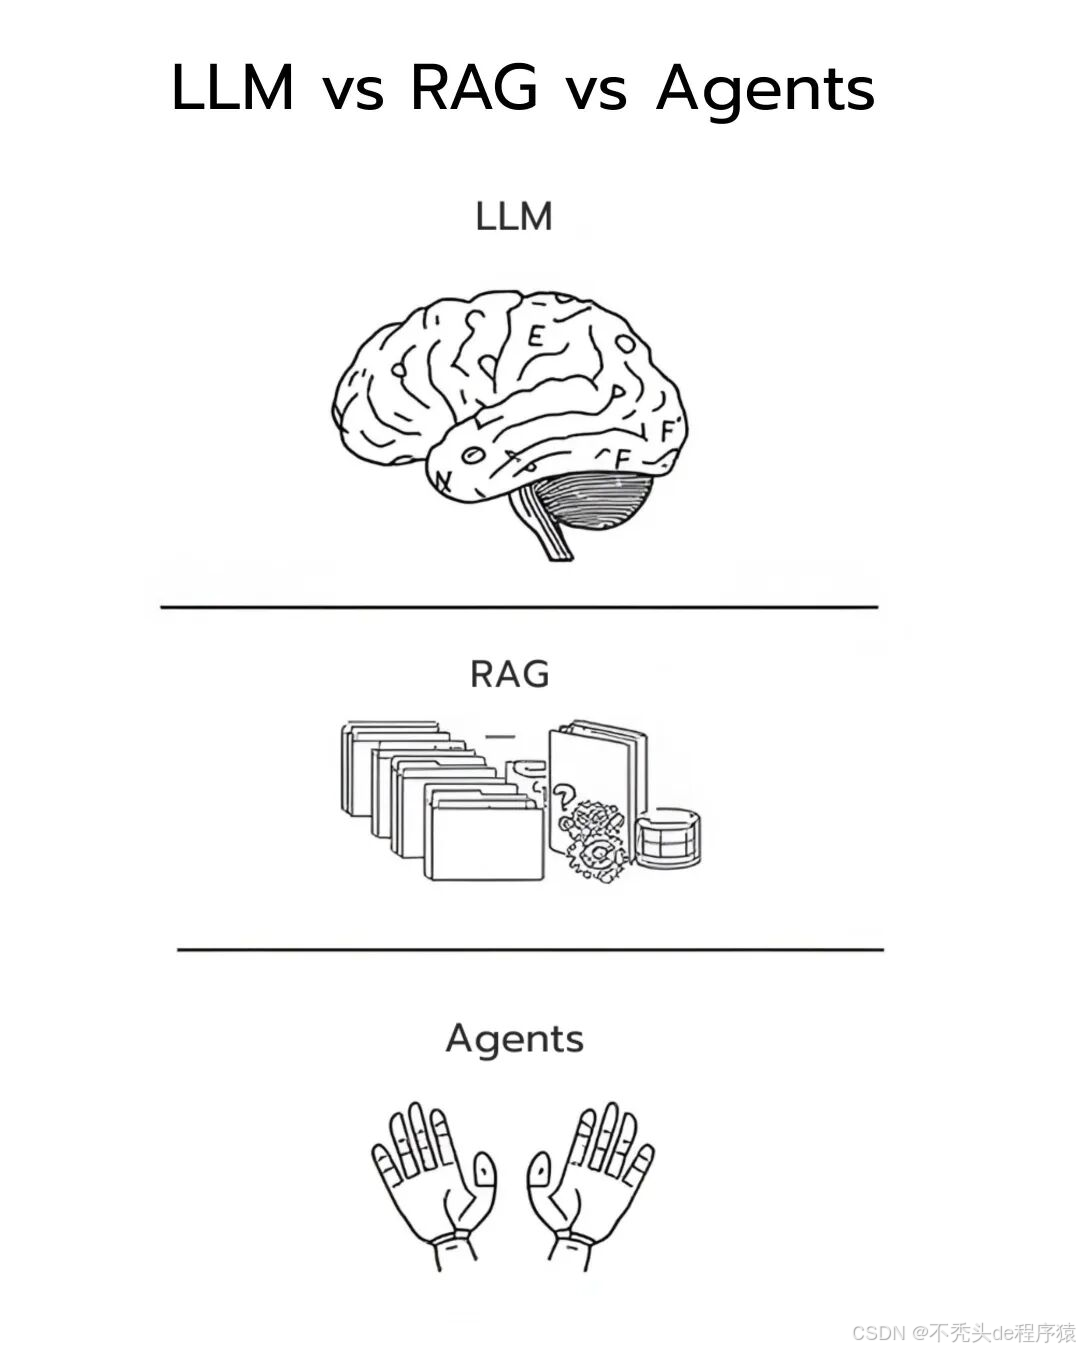
很多人把 LLM、RAG、Agent 看成三个竞争选项,或者是三选一 or 三选二的选项,而实际上,它们是同一个AI系统的三个能力层:

① LLM 是大脑

② RAG 是记忆

③ Agent 是”行动“,也就是决策和执行系统

生产级AI产品的标准做法是:按需叠加。不是"选一个",而是根据场景的复杂度,逐层加上去。
在这里插入图片描述


第一层:LLM——最强大脑,但这个脑子是"冻结"的

LLM 的本质是什么?

LLM 最强的能力是意图理解 → 结构化生成,说人话就是:能听懂你的需求,还能用各种格式(文本、JSON、SQL、代码)给你吐出来。

LLM 的真实能力边界:

  • 擅长的事:文案生成、代码辅助、逻辑推理、多轮对话、角色扮演、长文本理解
  • 不擅长的事:实时信息(停留在训练数据的时间点,比如:你截一张股票的分时图发给deepseek,让它猜股票,你看它的推理过程,肯定是2024年的股票数据。所以顺带提醒各位,不要迷信AI炒股!)、专有数据(从没见过的企业内部文档)、数值计算(尤其是复杂四则运算)

国内产品案例:腾讯混元/deepseek + 微信

腾讯混元大模型在微信生态中的纯 LLM 应用场景很典型。比如你在微信里搜索"周末旅游的行程",搜索结果最顶部就是AI的回答↓(默认是混元,你也可以选择ds深度思考模型)
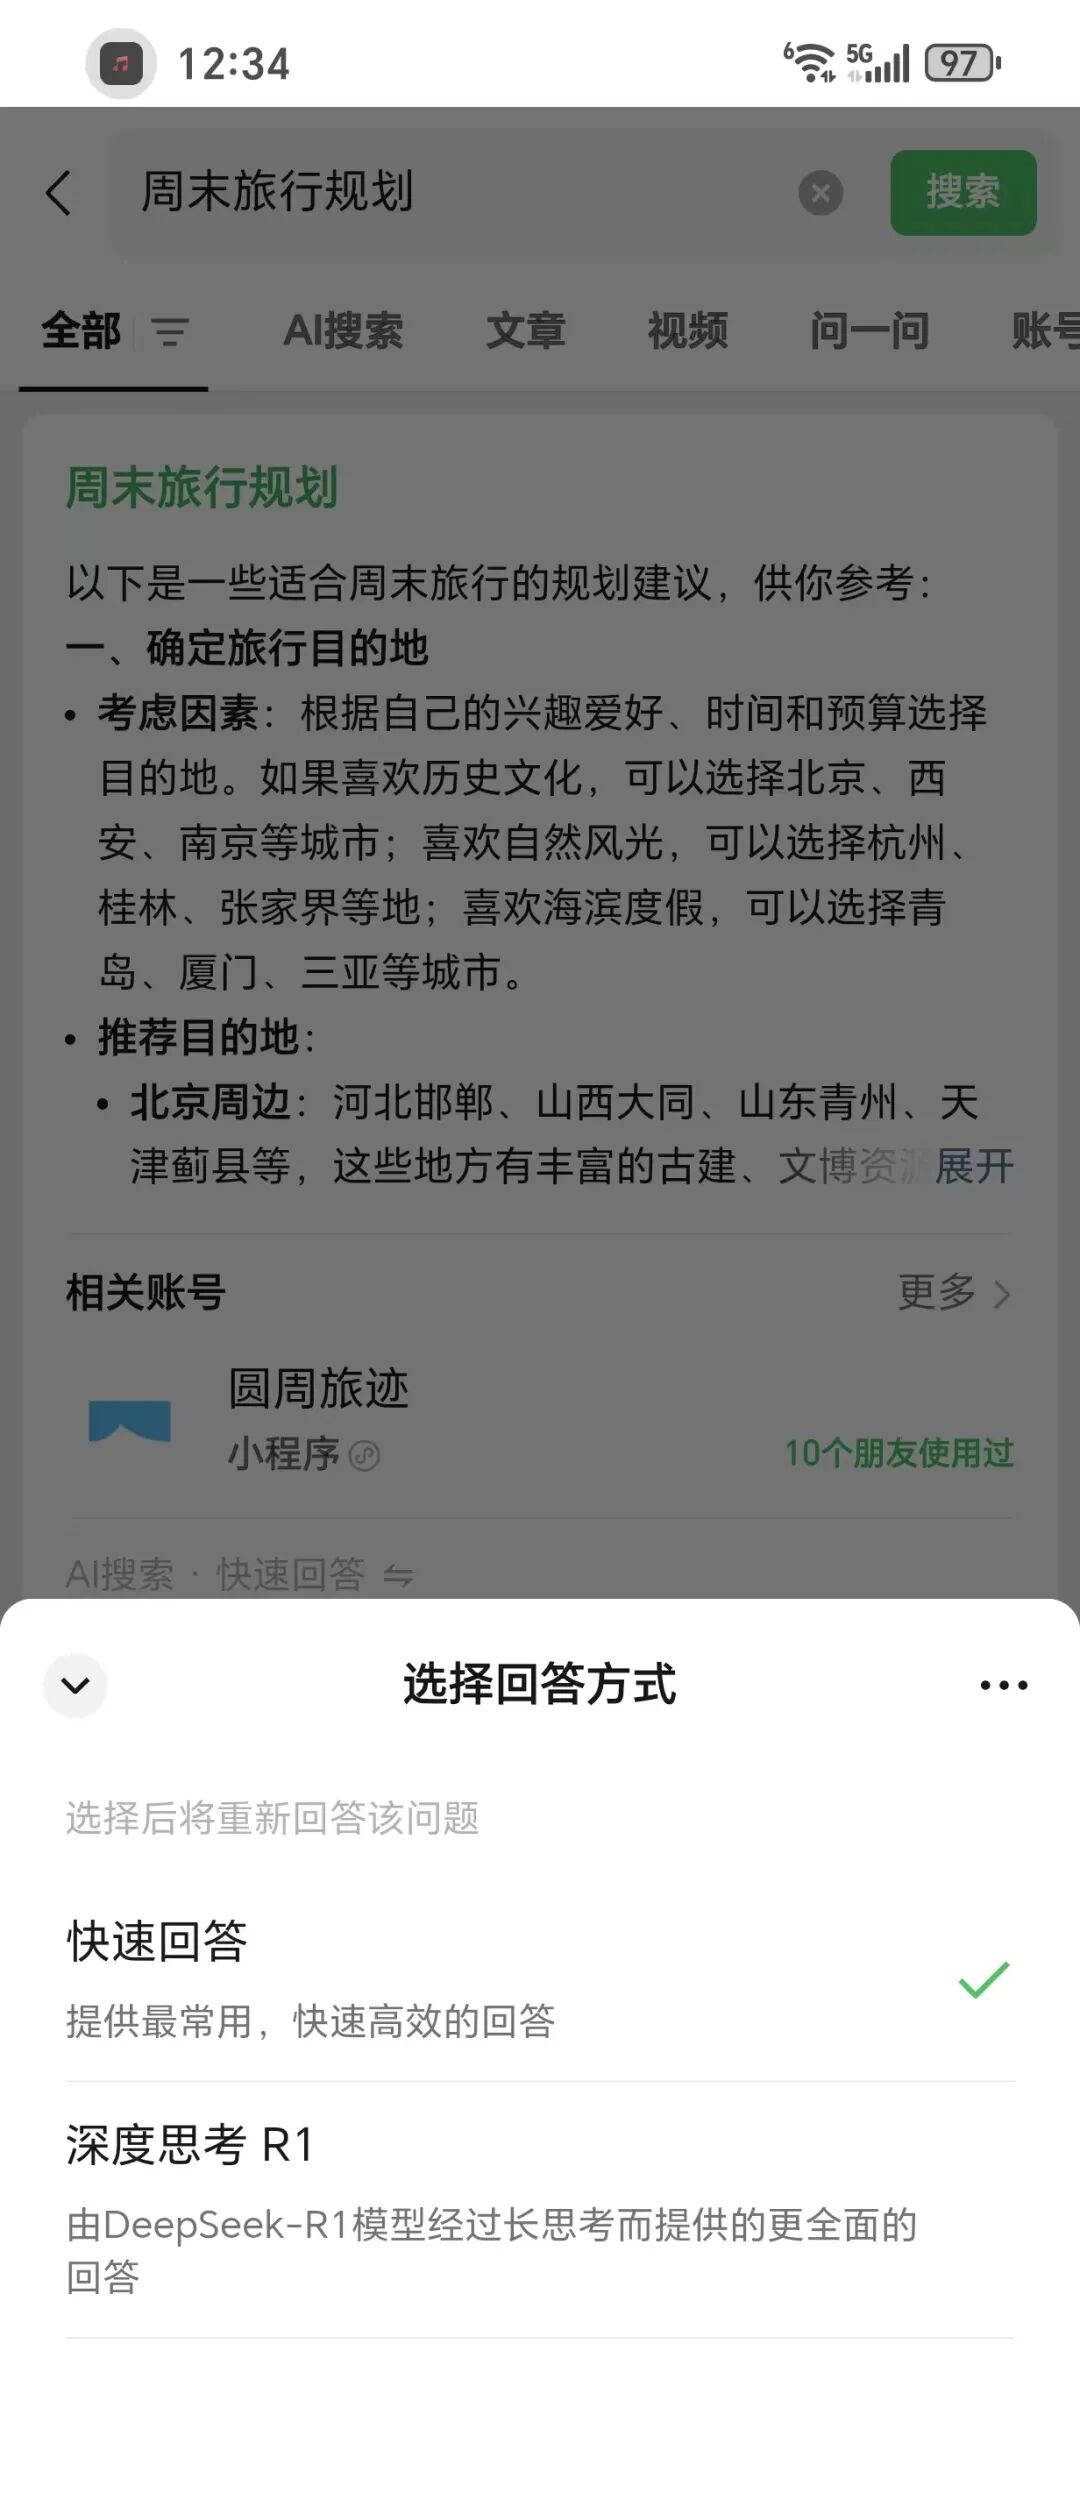
AI输出的计划虽然很详细,包括酒店推荐、景点顺序等,但是这个场景里只要有LLM就够了,完全**不需要 RAG,不需要 Agent。从它的回答你也能看的出来,它给出来的信息,没有那种实时的内容。**因为我只是需要一个信息输出作为参考,没有让它给我具体到时间、金钱、地点、出行方式等这样一个详细规划。

而且出于成本的考虑,微信也好,小红书也好,它们的内置搜索都集成了大模型能力,但是很少会调用RAG,更不用说Agent了。

因此即使你输入了详细的出行要求,默认的AI回答依然是LLM为主,他不会通过实时检索,关联最新的票价、路况、住宿费用等动态信息,你真要”新鲜有效的信息“,那就只能看下面最近发布的具体文章、笔记了。

所以LLM这个大脑很聪明,但它一旦涉及到一些新鲜信息,就会有一些脱节,因为它的学习”进度“跟当下这个时间点,是存在一定的时间差的。但是,这并不影响它是一个高手这个事实。


第二层:RAG——记忆,把"冻结的脑子"接上实时数据库

为什么需要 RAG?

这是最常见的场景:企业的 AI 客服系统不能每次都"胡说八道",用户问"你们产品保修期是多久",系统得从产品手册里查到真实答案再回答。

RAG(Retrieval-Augmented Generation)做的事就是:

  1. 把用户的问题转成"向量"(数值化表示)
  2. 到知识库(向量数据库)里找最相关的文档/信息
  3. 把这些文档作为"上下文",一起送给 LLM
  4. LLM 基于这些真实信息生成答案

流程简图

用户问题     ↓[向量化] ← 用Embedding模型    ↓[向量数据库检索] ← 找Top K相关文档    ↓[RAG上下文拼接] → "这是我们的产品手册,基于以下信息回答问题..."    ↓[LLM生成答案] ← 带有引用出处    ↓用户 ✓ 得到准确、可验证的答案

产品案例:字节豆包 + 云搜索 RAG

字节跳动的豆包大模型内置了基于云搜索的百亿级向量检索能力。生产环境下,毫秒级召回,秒级索引更新。这意味着:

  • 企业把最新的产品文档、政策手册导入
  • 用户随时问,豆包都能查出最新信息
  • 不需要每次人工更新 FAQ

典型场景:保险代理的知识库。某保险公司用豆包+RAG,自动生成产品解释和销售话术,人均提效 50%。

RAG 的关键工程细节

做好 RAG 系统,最常见的坑:

问题常见错误正确做法
检索不准用的 Embedding 模型太烂,把"保修期"和"维修费"混为一谈用领域特定的 Embedding 或做微调,必要时用混合检索(BM25 + 向量)
幻觉依然高把相关文档 dump 进去,LLM 还是随意编用"Chain-of-Thought"让 LLM 先列出依据,再生成答案
数据不新只更新了 RAG 库,没同步到向量索引自动化索引更新,或定期全量重建向量库
成本爆表每个请求都检索 Top 100 文档分层检索(先快速粗筛,再精排),设置文档数量上限

第三层:Agent——手脚和自主决策系统

LLM + RAG 的天花板

还是周末游的例子,你这么问AI,即使是LLM+RAG也解决不:

“帮我规划个周末上海两日游,包括订酒店、订餐厅、规划路线,最后给我一份PDF”

这个需求涉及:

  1. 查询事实景点信息库(用 RAG)
  2. 调用酒店推荐和预订接口
  3. 调用餐厅推荐和预订接口
  4. 生成 PDF 并发送
  5. 如果酒店没房了,自动重试其他酒店

纯 LLM + RAG 做不到这些,因为 LLM 不会"真正去做"这些事,只会生成一个todolist。

而”做“,Do这个动作,就是 Agent 的精髓和它的用武之地了。

Agent 的工作流程简图

用户意图  ↓[意图解析] ← LLM理解"我要订酒店+订餐厅"  ↓[规划] ← 拆分成步骤序列  ↓[调用工具1] ← 查酒店库 → 得到候选列表  ↓[反思] ← "酒店太贵?需要换条件吗?"(这一步很关键!)  ↓[调用工具2] ← 调用预订接口 → 完成预订  ↓[调用工具3] ← 推荐餐厅 → 返回名单  ↓[最终执行] ← 生成行程单,发送 PDF  ↓[结束] 或 [需要改进?回到反思步骤]

这里面最关键的是"反思环"!因为我们都知道大模型是存在幻觉的,如果你赋予了大模型”做“这个权利,那么,整个流程里面,一步错,可能后面就步步错了!

所以,Agent 在每一步之后都要问自己"我做对了吗?是否偏离原始目标?需要改策略吗?"。没有这个循环,Agent 很大概率会一条路走到黑!

产品案例:阿里飞猪旅行 Agent

荣耀新发布的手机,AI智能助理集成了飞猪旅行 Agent。所以用户跟手机说"帮我规划三天xx出行计划"后,语音助理初步识别后就会调用Agent,然后后续跟用户的交互流程大概是这样:

  1. 意图理解:识别出"旅行规划+需要预订"
  2. 信息收集:问用户"预算多少?几个人?什么时间?出行方式?…"
  3. 多源查询:同时查景点库、酒店库、航班库…
  4. 智能过滤:基于用户预算+评分,自动筛选最优组合
  5. 一键预订:用户确认后,Agent 调用支付接口完成预订
  6. 反思检查:预订成功?如果失败,自动选择备选方案

整个流程中,Agent 不只是"建议",而是真实地"代理执行"了用户的意愿。所以在这一类场景中,Agent 在整个思考过程中,会基于用户需求做多次相关外部数据源的联动和决策,这是LLM或LLM+RAG 所不具备的能力。


⭐️关键决策:什么时候用哪一层?

决策树

用户问题来了    ↓问题是"纯语言处理"吗?     ├─ YES → 只用 LLM ✓    │  例子:写文案、改邮件、翻译、总结    │    └─ NO        ↓        需要准确的、可核查的事实吗?        ├─ YES → LLM + RAG ✓        │  例子:产品问答、政策查询、文档QA、知识库问答        │        └─ NO            ↓            需要跨多步执行、调用外部系统、最后产出实际结果吗?            ├─ YES → LLM + RAG + Agent ✓✓✓            │  例子:旅行规划、订单处理、自动化工作流、智能客服            │            └─ NO                → 可能不需要 AI...

举个例子: 大家都用deepseek会知道,现在这类ai助手工具基本都有一个”联网“的按钮,其实这就是RAG。就是这个功能打开后,它会根据我们问的问题,判断是否需要实时检索。 如果不需要,它就直接动一动自己这个LLM大脑,就直接回答你了。如果它发现你的问题涉及一些实时的数据或八卦、新闻什么的,那它就得借助RAG去联网搜索一下相关的网页等,最后把搜索结果给回LLM大脑,大脑综合这些信息后,再给你一个最终的答案。

延迟与准确度对比(仅供参考)

方案响应时间准确率复杂度
纯 LLM<1秒60-70%低 ⭐
LLM + RAG1-3秒85-95%中 ⭐⭐
LLM + RAG + Agent3-10秒(多步)70-90%*高 ⭐⭐⭐

*准确率取决于工具调用的成功率和反思机制的质量


工程实现的三个痛点与解决方案

痛点 1:向量检索的"语义漂移"

问题:用户问"手机屏幕碎了怎么修",系统检索出了"屏幕保护膜怎么贴"的文档。

原因:Embedding 模型没有理解"修"和"贴"的本质区别。

解决方案:

  • 用国产的中文 Embedding 模型,而不是通用英文模型
  • 对关键领域词做"同义词扩展":修 = 维修/修理/返修
  • 用混合检索:BM25(精确词匹配)+ 向量(语义匹配)

痛点 2:Agent 的"死循环"

问题:Agent 陷入无限重试,一直在重复调用同一个失败的接口。

解决方案:

  • 设置最大步数限制(比如最多 10 步)
  • 每次失败后,强制 Agent"反思为什么失败",然后改策略
  • 设置"降级策略":如果智能流程失败,直接转人工
  • 记录失败案例,定期做 Agent 的"微调"

痛点 3:长尾问题的"超预期成本"

问题:99% 的用户问题用 LLM 或 RAG 解决,但剩下 1% 的奇葩问题,Agent 要调用 10 个接口才能搞定,成本爆表。

解决方案:

  • 用"分层策略":先用便宜的 LLM 试试,不行再上 RAG,最后才激活 Agent
  • 对频繁出现的"长尾",做专项优化(比如常见的 5 个奇葩场景)
  • 一旦 Agent 成本超过"转人工"的阈值,立即转人工处理

给产品经理的五条军规

1. 不要一开始就想搞 Agent

很多团队看到 Agent 的酷炫效果,就想一步到位。结果投入 3 个月工程资源,最后 Agent 的成功率只有 50%,不如简单的 RAG。

正确做法:用"功能演进"的思路,从 LLM → RAG → Agent 逐层加。每一层都要有明确的用户价值验证。

2. RAG 的效果取决于知识库质量,不是 Embedding 模型

很多团队觉得"用了高端 Embedding 模型就能解决问题"。实际上,50% 的效果来自数据准备,40% 来自 Embedding,10% 来自模型选择。

正确做法:投入人力做好知识库的清洗、分类、去重,比盲目升级模型有效 10 倍。

3. 别忘了"反思循环"

Agent 之所以比 RAG 强,核心在于有"反思"能力。用 LangGraph 等框架,把"检查→纠正→继续"的循环固化到系统里。

代码示例(伪代码):

while step < MAX_STEPS:    # 执行当前任务    result = call_tool(task)        # 反思(这是关键!)    reflection = llm.reflect(original_goal, step, result)        if reflection.is_complete():        return result    elif reflection.needs_correction():        task = reflection.corrected_task        step += 1    else:        # 失败或需要人工        return escalate_to_human(task)

4. 用"分层定价"而不是"统一定价"

如果你的 AI 服务要商业化,不要所有功能都一个价格。应该是:

  • 纯文本生成:¥0.99/次
  • 文档问答(RAG):¥4.99/次或订阅制
  • 复杂工作流(Agent):¥19.99/次或按工作流长度计费

这样既能覆盖成本,又不会把用户吓跑。

5. 质检和反馈循环不能少

90% 的 AI 产品失败,不是因为模型选错了,而是因为做完了就不管了,没有后续的用户反馈循环。

必须建立的机制:

  • 用户反馈(点赞/点踩)
  • 定期标注 10-20% 的输出结果,评估质量
  • 每月根据反馈做 1-2 次的模型或 prompt 调优
  • 记录失败案例,每个季度做一次大的系统优化

最后的话

LLM、RAG、Agent 的本质,是在解决 AI 系统的"三个维度的问题":

  • LLM 解决的是"理解与表达"
  • RAG 解决的是"准确性与可信度"
  • Agent 解决的是"自主执行与流程复杂度"

没有绝对的好坏,只有"用对场景"的差别。

一个 MVP 可能只需要 LLM;一个成熟的企业应用需要 LLM + RAG;而一个要真正替代人工的系统,才需要全套的 LLM + RAG + Agent。

开发一个 AI 产品前,先问自己三个问题:

  1. 用户的问题是"需要创意",还是"需要事实",还是"需要真实执行"?
  2. 我团队有多少人?投入周期是多少?
  3. 如果这个 AI 失败了会带来什么后果?

答好这三个问题,你就知道该用哪一层了。

普通人如何抓住AI大模型的风口?

领取方式在文末

为什么要学习大模型?

目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。

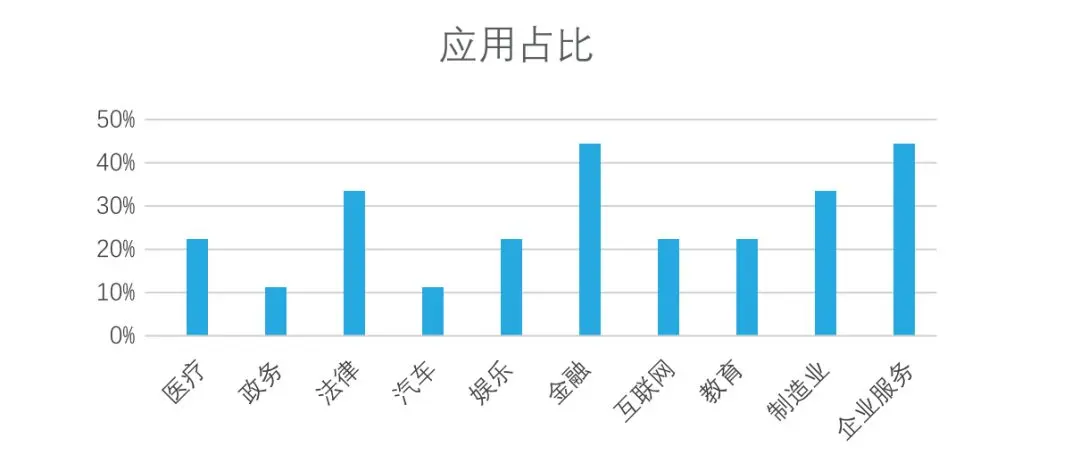
目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。
在这里插入图片描述

随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

在这里插入图片描述

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!

最后

只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!

在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
在这里插入图片描述

大模型全套学习资料展示

自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

图片

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!

01 教学内容
图片

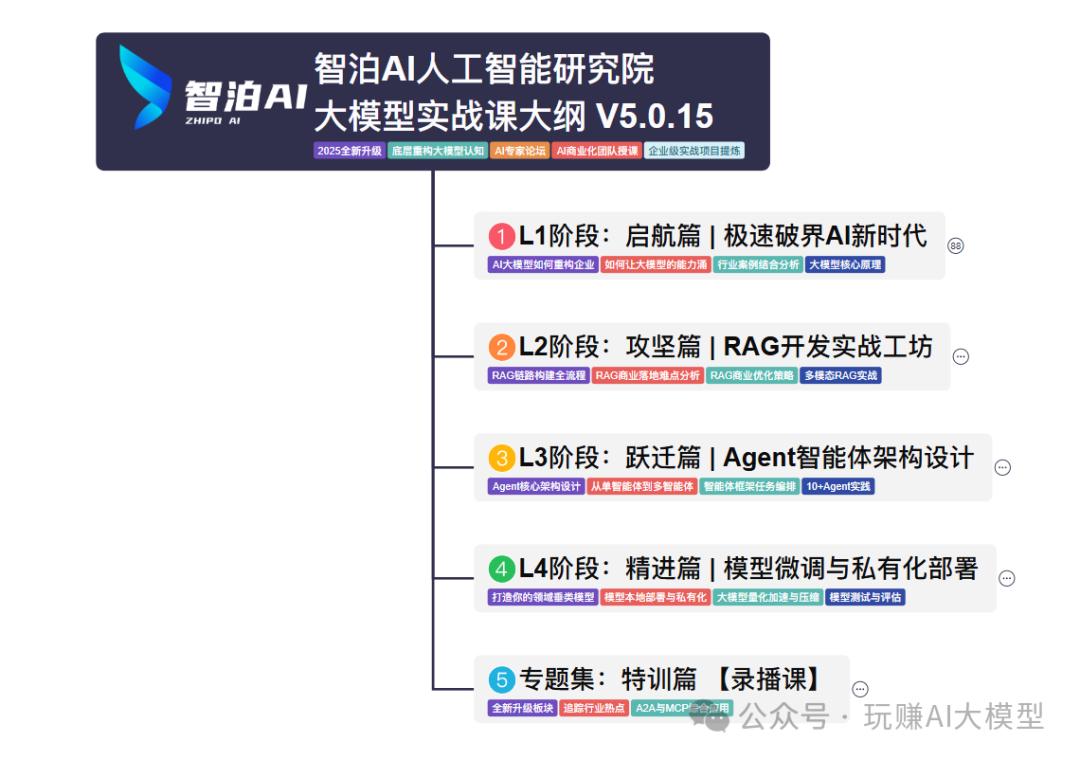
  • 从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!

  • 大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事‌!

02适学人群

应届毕业生‌: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。

零基础转型‌: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界‌。

业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型‌。

image.png

vx扫描下方二维码即可
在这里插入图片描述

本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!

03 入门到进阶学习路线图

大模型学习路线图,整体分为5个大的阶段:

图片

04 视频和书籍PDF合集

图片

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

图片

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

图片

05 行业报告+白皮书合集

收集70+报告与白皮书,了解行业最新动态!
图片

06 90+份面试题/经验

AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)图片

在这里插入图片描述

07 deepseek部署包+技巧大全

在这里插入图片描述

由于篇幅有限

只展示部分资料

并且还在持续更新中…

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

在这里插入图片描述

AI应用开发核心技术栈解析:从RAG、Agent到LangChain与LangGraph实战 如果你正在准备AI大模型相关的面试,或者想从传统开发转向AI应用开发,那么你很可能正被这几个问题困扰: Agent、RAG、LangChain、LangGraph 这些概念听起来很酷,但面试官一问“它们之间到底什么关系?在项目中怎么用?”,脑子里就一片混乱,只能背几个名词。 网上教程要么是零散的“Hello World”,要么是过于学术的论文解读, 缺少一个能串联所有技术栈、直击面试核心的实战路线图 。 知道这些技术重要,但不知道如何向面试官证明自己“不仅懂概念,更有落地能力”,缺少能拿得出手的、有深度的项 阅读详情

相关推荐

LLM应用开发实战:从RAG到Agent与MCP的核心工程解析

大模型技术正重塑软件系统的构建方式,使其从传统“以代码为中心”转向“以模型为中心”的新范式。理解Token、上下文窗口与模型精度(如BF16/FP16)是掌握LLM工程化的基础,而文本向量化与向量数据库则为语义检索提供支撑。RAG(检索增强生成)通过外部知识接入有效缓解幻觉问题,Agent与MCP协议则让模型具备调用工具、自主决策的能力,配合LangChain、Spring AI等编排框架,可构建生产级应用。本文从基础概念到实践案例,系统梳理LLM应用开发中的关键模块与技术选型,帮助开发者理解从“调用模型接

weixin_30333885的博客 404

收藏必学!小白也能搞懂:LLM、RAG与AI Agent的区别与应用

文章详解了AI领域的三大核心概念:LLM作为"天才大脑"但有知识截止日期;RAG作为记忆系统连接LLM与外部实时知识库,解决知识更新问题;AI Agent具备感知、规划、执行和反思能力。三者非竞争关系,而是互补技术,真正的AI应用需结合三者:LLM负责推理,RAG确保准确性,Agent实现自主性,共同构建智能时代的应用架构。

2401_85325726的博客 843

LLM实战学习路线:从API调用到RAG与Agent应用开发

大语言模型(LLM)作为人工智能领域的重要突破,其核心是基于Transformer架构的序列预测系统。该技术通过自注意力机制理解上下文语义,实现文本生成与理解。在工程实践中,掌握Prompt Engineering和模型调参是发挥LLM能力的基础,而RAG(检索增强生成)技术通过向量检索与知识库结合,有效解决了模型幻觉与知识更新问题。智能体(Agent)范式进一步扩展了LLM的能力边界,使其能够规划任务并调用外部工具。当前,结合LangChain等框架构建企业级应用已成为主流,涉及本地模型部署、性能优化和多

weixin_33978044的博客 548

一文读懂 LLM 核心技术栈:LLM、RAG、Function Calling、MCP 与 Agent

作为一名开发者,你是否曾被大语言模型(LLM)生态中层出不穷的术语搞得晕头转向?RAG、Function Calling、Agent、MCP... 这些概念听起来高大上,但它们究竟解决了什么问题?它们之间又是如何协作的? 在这篇文章中,我们将用最直白的语言和代码对比,为你揭示 LLM 技术栈的完整拼图。

st_andrews的博客 1450

【LLM】基于LLM的agent应用(上)

ote 在未来,Agent 还会具备更多的可扩展的空间。 就 Observation 而言,Agent 可以从通过文本输入来观察来理解世界到听觉和视觉的集成; 就 Action 而言,Agent 在具身智能的应用场景下,对各种器械进行驱动和操作。 Agent 是以核心智能模型来驱动的,一个可以具备能力从思考开始,最终做到完整输出的智能性结构。Agent 的发展很符合第一性原理,从最先的 Prompt,后面有人在写完的 Prompt 后面加通用的规划器。 文章目录 note 零、相关概念介绍 一、人类与AI协

发现问题,并解决问题,批判性思维 3640

家长必看!用RouterOS轻松屏蔽不良网站,保护孩子上网安全

本文为家长提供了一份详细的RouterOS路由器配置指南,旨在通过技术手段保护儿童上网安全。文章核心介绍了如何利用RouterOS的DNS静态条目功能,轻松实现禁止访问特定不良网站,并结合防火墙时间规则,为孩子构建一个纯净、可控的家庭网络环境,操作简单,无需专业背景。

weixin_28363123的博客 1270

LLM - AI Agent 学习路线图:从 RAG 到多智能体实战

摘要 本文系统介绍了AI Agent的学习路线图,从基础LLM与RAG入门到多智能体实战,分为四个阶段:LLM基础与RAG、Agentic RAG与单Agent决策、多模态与语音Agent、多Agent协作与企业级落地。每个阶段推荐了对应的开源项目和资源,强调通过实践反推知识体系。文章还提供了4-8周的学习规划建议,帮助开发者从工具调用进阶到架构设计能力,最终形成工程方法论。核心在于理解Agent的决策机制、工具生态与落地实践,而非仅停留在Demo层面。

小工匠 3231

基于YOLOv8的多类别检测模型融合实战:从数据集重构到模型训练

本文详细介绍了如何将多个单一类别的YOLOv8检测模型融合为一个高效的多类别检测模型。通过重构数据集、利用预训练模型生成新标签,并重新训练,解决了多模型并行带来的速度慢、资源占用高和部署复杂等问题。实战流程涵盖数据准备、标签生成、模型训练与评估,旨在帮助开发者构建性能优异的YOLOv8多类别检测模型。

kmeans3miner的博客 229

建议收藏!小白也能学会的大模型应用开发全攻略:从LLM到Agent实战指南

本文全面介绍AI大模型应用开发核心技术,包括LLM、Prompt、RAG、Agent、Fine-tuning和MCP。详细解析Messages实现"记忆"、RAG增强生成质量、Tools扩展能力、ReAct模式实现推理行动、Agent自主完成任务以及微调与提示词工程优化表现。强调大模型是工具而非万能解决方案,需结合业务需求构建有效方案。

youmaob的博客 1224

机器学习系列(3)_逻辑回归应用之Kaggle泰坦尼克之灾

f作者: 寒小阳 &&龙心尘 时间:2015年10月。 出处: 声明:版权所有,转载请注明出处,谢谢。手把手机器学习之逻辑回归应用——Kaggle泰坦尼克之灾1.引言先说一句,年末双十一什么的一来,真是非(mang)常(cheng)欢(gou)乐(le)!然后push自己抽出时间来写这篇blog的原因也非常简单: 写完前两篇逻辑回归的介绍和各个角度理解之后,小伙伴们纷纷表示『好像很高级的样纸,

寒小阳 43万+

VisionMaster -Group循环、数组数据格式化

这里创建一个格式化工具,按照自己想要的模式格式化刚刚输出的数据。因为是检测多个物体,所以这里选择输出的是数组。第一次的模板很不满意,反复调整参数也没好,边缘不整齐,强迫症患者受不了。实测如果输入设置太多,会导致模块失效,所以尽量选择需要的少量参数。这里要打开循环使能,循环数值就是高精度匹配的匹配个数。Group输出设置里选择刚刚建立的数据集。左边是主流程,右边是组合模块内部流程。修改采图这里的曝光值,图像提亮一点。建一个数据集,把想要的数据收集起来。用TCP助手测试一下OK。成功得到了想要的数据。

weixin_69505365的博客 4533

关于RAG、LLM、AI Agent、Prompt的关联和差异

一、RAG:检索增强生成RAG 是 retrieval-Augmented Generation 的缩写,即检索增强生成。从字面意思理解,它主要增强搜索和检索的能力,力求 “找得更准”。二、LLM:大语言模型LLM:Large Language Model,即大语言模型,但我们知道 RAG 是基于 LLM 的。LLM 作为语言模型基础,为 RAG 等技术提供了支撑。三、AI Agent:智能体解决复杂业务AI Agent 如同一个智能体,通过 AI 的基础能力搭建而成,能解决复杂的业务问题。

2301_76161259的博客 1256

基于STM32的RS485土壤氮磷钾与PH传感器数据采集与OLED显示实战(附完整代码)

本文详细介绍了基于STM32单片机通过RS485协议采集土壤氮磷钾与PH传感器数据的实战项目。涵盖硬件选型、连接方法、Modbus-RTU通信协议解析、STM32程序实现及OLED显示,提供完整代码和调试技巧,适用于农业物联网环境监测系统。

kotlin6android的博客 341

LLM、RAG 和 AI Agent 之间的区别

LLM、RAG 和 AI Agent 三者不是竞争关系,它们是不同技术层面的实现,协同工作以实现更强大的 AI 应用。

xzp740813的博客 723

从ADS到HFSS:耦合线带通滤波器的设计与模型转换实战

本文详细介绍了耦合线带通滤波器的完整设计流程,重点阐述了从ADS电路级快速优化到HFSS三维电磁场精确验证的模型转换实战方法。通过对比ADS理想模型仿真与HFSS全波仿真结果,指导读者进行参数校准与迭代优化,并分享了关键的板材选择、加工误差及端口设置等避坑指南,确保设计性能与实物测试高度一致。

weixin_29290863的博客 348

ArcGIS Pro符号化教程

本文详细介绍了ArcGIS Pro的软件设置和符号化操作步骤。主要包括:1)设置默认工程目录和关闭地图自动加载;2)创建新工程的基本流程;3)点要素的单一符号化方法,包括样式修改和图层调整;4)图表符号显示过滤器的使用,涉及字段添加、图表类型选择和背景设置。文章还提供了操作截图和数据下载链接,适合GIS初学者学习ArcGIS Pro的基础符号化操作。

WwLK123的博客 551

大白话讲解: Agent、 LLM 、RAG 、提示词工程

LLM是大脑,负责理解用户需求、生成文本;RAG提供最新景点和餐厅数据,避免推荐已关闭的店铺;Agent协调整个流程:先查天气,再调地图API算路线,最后用LLM生成行程;提示词则是你给AI的详细需求文档,确保输出符合预期。

2301_76168381的博客 1249

Chamfer Loss

ChamferLoss是一种常用于3D点云(pointcloud)处理的损失函数,特别是在点云生成和对齐任务中。它的目的是度量两个点集之间的相似度,特别是在点云重建、配准或生成等任务中,常用于优化模型使得生成的点云更接近真实的点云。

夜空中明亮的星的专栏 455

LLM+RAG+Agent一篇全掌握,看这一篇就够了!

LLM:纯语言处理任务,如写作、翻译、答疑等场景LLM + RAG:对准确率有要求的时候使用,比如回答需要来自内部文档、技术手册、领域知识等场景LLM + RAG + Agent:需要自主执行任务的场景,如自动化工作流、数据分析等需要让系统来决策的场景LLM 作为智能大脑RAG 作为动态记忆系统Agent 作为自主执行者。

xiaoganbuaiuk的博客 931

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

RAG、Memory与Agent:大模型应用三层架构实战指南

大模型落地应用时,检索增强生成(RAG)、记忆管理(Memory)与智能体(Agent)常被混为一谈。实际上,它们分别解决知识缺失、对话无状态、任务无法自动执行等问题。理解三者的技术边界与协同原理,是构建企业级AI知识库、多轮对话系统及自动化工作流的基石。RAG将外部文档向量化以补充实时知识,Memory通过短期与长期机制维护用户上下文,Agent则基于推理循环调度工具完成复杂任务。三者并非互斥,而是形成“记忆+检索+行动”的分层架构。本文从基础概念切入,结合工程实践讲解组合方式,帮助开发者理清选型逻辑,避

weixin_34401479的博客 418

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

动手学Ollama:应用案例实战 - 构建本地RAG和Agent应用

《动手学Ollama实战指南》摘要:本文介绍了使用Ollama构建AI应用的完整流程,重点讲解RAG(检索增强生成)技术和Agent智能体的开发实践。通过LangChain和LlamaIndex框架,详细展示了文档加载、向量存储、语义检索等核心功能的实现方法,并提供了Streamlit/Gradio两种Web界面集成方案。文章包含企业知识库和个人助手两个完整案例,涵盖性能优化、安全部署等生产环境注意事项,帮助开发者从理论到实践快速掌握本地AI应用开发技能,适用于文档问答、智能客服等多种场景。

Yoouc1的博客 943

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

LLM、RAG、Skill、Agent的关系

本文阐述了AI系统中的四个关键组件及其协同关系: LLM(大语言模型)作为核心"大脑",负责语言理解和生成,但存在知识局限性和操作缺陷; RAG(检索增强生成)通过连接外部知识库解决LLM信息滞后问题,实现"开卷考试"式应答; Skill(技能)为LLM提供API等原子化工具,赋予其执行具体任务的能力; Agent作为智能执行者,整合前三者实现自主规划、记忆管理和动态纠错,完成多步骤复杂任务(如智能客服全流程)。 四者形成层级架构:LLM是基础,RAG和Skill扩展

倚杖柴门外,临风听暮蝉。 382

【收藏学习】LLM Agent实战指南:超越传统LLM的智能体架构与实现方法

要理解什么是 LLM Agent,首先我们需要回顾一下 LLM 的基本功能。传统上,LLM 的工作方式是通过预测下一个词元(token)实现的。在生成多个词元的过程中,模型逐步扩展输入内容,从而模拟对话,生成更长且更连贯的回应。然而,随着对话的进行,LLM 的一个主要缺点逐渐显现——它无法记住之前的对话内容!除了记忆缺失的问题外,LLM 在执行一些看似简单的常见任务时也经常犯错。例如,基础的数学运算如乘法和除法都可能出错。然而,这并不意味着 LLM 无法胜任这些任务。

python12345_的博客 936

当AI学会“查资料”和“做决定”:聊聊LLM、RAG和AI Agent

从“凭记忆说话”的LLM,到“查资料答题”的RAG,再到“自己想办法”的AI Agent,AI正变得越来越像人类的得力助手。虽然它们偶尔还会犯错,但随着技术进步,未来你可能会习惯性地对手机说:“帮我把这个季度的报表做好,顺便订束花庆祝一下!

kaka0722ww的博客 1159
上一篇: 收藏学习:检索增强生成(RAG):让大模型拥有“外视眼睛“的技术揭秘
下一篇: 2025大模型全景图:从语言到视觉,8大模型类型详解,程序员必藏指南
不秃头de程序猿
博客等级 码龄5年 4091粉丝 1479原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值