大模型预训练核心教程:程序员进阶必学,建议收藏反复阅读

预训练(Pre-training),人工智能领域的预训练是什么——AI教程 预训练是指在一个大规模的通用数据集上对模型进行初步训练,使其能够学习到丰富的特征表示。这个过程通常在没有监督(即没有明确的标签)的情况下进行,称为无监督预训练。经过预训练的模型可以捕捉到数据中的模式和结构,从而在后续的特定任务(如分类、回归等)中更有效地进行微调(fine-tuning)。 阅读详情

预训练是大模型的基础教育阶段,通过海量通用数据学习语言逻辑、常识知识和推理能力
采用无监督学习方式,无需人工标注,让模型自主学习数据中的规律和模式
预训练能降低任务难度、提升泛化能力、降低研发成本,是大模型不可或缺的核心步骤

最近在后台收到很多小伙伴的提问:“每次看大模型相关文章都绕不开「预训练」,它到底是个啥?”“为什么说预训练是大模型的核心步骤?”

今天就用一篇文章,带大家从 “日常类比” 到 “技术本质”,彻底搞懂 Pre-training(预训练)的来龙去脉。不用怕看不懂,咱们全程避开复杂公式,只讲你能听懂的技术逻辑。

预训练 = 大模型的「中小学教育」

要理解预训练,先从我们每个人的成长经历说起。
你有没有想过:为什么我们上大学能快速学习专业知识?为什么工作后能快速掌握新技能?核心在于中小学阶段的 “基础积累”—— 我们在这个阶段学了语文、数学、历史、物理等通用知识,掌握了 “理解文字”“逻辑推理”“联想分析” 的基本能力。

这些能力不是为了某个具体任务(比如当医生、做程序员),但没有这些基础,后续的专业学习会寸步难行。

大模型的 “预训练”,本质上就是给 AI 做 “中小学教育”。

对人类而言,“基础教育” 的教材是课本、书籍、生活经验;
对大模型而言,“预训练” 的教材是海量的通用数据 —— 可能是全网公开的文本(书籍、论文、网页)、图片、音频,甚至是视频。

人类通过 “听课、做题、思考” 掌握基础能力;
大模型通过 “读取数据、学习规律、调整参数” 掌握通用 AI 能力。

简单说:预训练就是让模型在 “没明确任务” 的情况下,先海量学习通用知识,打下扎实的 “AI 基础”。就像我们不会让一个没学过加减乘除的孩子直接学微积分,也不会让一个没理解过语言逻辑的模型直接做 “写论文”“做翻译” 的精细任务。

预训练到底在 “学” 什么?

很多人以为预训练是 “让模型背下所有数据”,其实这是大错特错。预训练的核心是 “学习数据中的规律和逻辑”,而不是 “死记硬背”。

举个例子:当模型学习了 10 亿篇中文文本后,它不会记住某篇文章的每一句话,但会掌握这些规律 ——

  • 语言逻辑:“天空” 常和 “蓝色”“云朵” 搭配,“吃饭” 前通常会 “做饭” 或 “点外卖”
  • 常识知识:“地球绕着太阳转”“人需要呼吸空气”“冬天比夏天冷”
  • 推理能力:从 “小明今天没去学校” 能联想到 “他可能生病了” 或 “他请假了”
  • 结构规律:文章通常有 “开头 - 正文 - 结尾”,新闻会包含 “时间、地点、人物、事件”

这些能力是 “通用” 的 —— 就像我们学会了 “逻辑推理”,既能用它解数学题,也能用它分析职场问题。模型学会了这些通用能力后,再去做具体任务(比如写文案、做数据分析),就会 “事半功倍”。

而实现这一过程的核心,是 “无监督学习”—— 预训练阶段不需要人工给数据打标签(比如告诉模型 “这句话是正面情绪”“这个图片是猫”),模型会自己从海量数据中 “挖掘规律”。这就像我们小时候看绘本,没人逐字解释,但慢慢能理解画面和文字的关联 ——AI 也在用类似的逻辑 “自主学习”。

预训练的关键技术

虽然不用公式,但我们可以简单聊聊预训练的 “核心玩法”—— 不同的大模型,预训练的思路可能不同,但最主流的有两种:

文本预训练:让模型 “读懂语言”

最经典的文本预训练方法,是 “完形填空”(比如 BERT 模型的玩法)。

具体操作:给模型一段文字,故意 “挖掉” 几个词(比如 “今天天气很 [ ],适合去 [ ]”),让模型预测被挖掉的词是什么。

为什么有效?要做好 “完形填空”,模型必须理解上下文逻辑 —— 它得知道 “天气” 后面常接 “好”“坏”“热”,“适合去” 后面常接 “公园”“爬山”“散步”。通过海量这类练习,模型会逐渐掌握语言的关联性和常识。

还有一种玩法是 “续写文本”(比如 GPT 模型的玩法):给模型开头(比如 “在未来的 2050 年,人类终于实现了”),让模型接着写后面的内容。这需要模型理解 “时间线”“逻辑连贯性”,甚至需要一点 “想象力”—— 而这些能力,正是从预训练中积累的。

多模态预训练:让模型 “打通视听读”

现在很多大模型不只是处理文本,还能看图片、听音频(比如 GPT-4V、文心一言),这就需要 “多模态预训练”。

具体操作:给模型同时输入 “图片 + 文字描述”(比如一张猫的图片,配文 “一只白色的猫在睡觉”),让模型学习 “图片内容” 和 “文字描述” 的对应关系;或者输入 “音频 + 文字脚本”,让模型学习 “声音” 和 “文字” 的关联。

最终效果:模型能 “看懂图片说的是什么”“听懂音频讲的是什么”,甚至能做到 “给图片写文案”“给文字画插图”—— 这些跨模态能力,都源于预训练阶段的 “多数据融合学习”。

预训练不可或缺的3个核心价值

了解了预训练的原理,我们再聊聊:为什么所有主流大模型(GPT、文心、讯飞星火等)都离不开预训练?因为它有 3 个 “不可替代” 的价值:

降低 “任务难度”:不用每个任务都 “从零学起”

如果没有预训练,要让模型做 “写文案” 的任务,就得给它喂成千上万条 “文案样本”,让它从头学语言逻辑 —— 这不仅需要海量标注数据(成本极高),而且模型只能会 “写文案”,换个 “做翻译” 的任务又得重新学。

有了预训练后,模型已经有了 “语言基础”,再做 “写文案” 只需少量 “文案样本” 微调(Fine-tuning)—— 就像我们有了 “语文基础”,学写文案只需要看几篇优秀案例,而不用再从拼音学起。

提升 “泛化能力”:能处理没见过的问题

没有预训练的模型,就像 “偏科严重的学生”—— 只会做学过的题,遇到新问题就傻眼。而经过预训练的模型,因为学过海量通用知识,能处理很多 “没见过的任务”。

比如:一个经过中文预训练的模型,即使没专门学过 “写产品说明书”,也能根据产品名称和功能,写出逻辑清晰的说明书 —— 这就是预训练赋予的 “泛化能力”。

降低 “研发成本”:不用重复造轮子

如果每个大模型都要 “从零开始学语言、学常识”,研发成本会高到离谱。而预训练相当于 “造了一个通用的基础模型”,后续不管是做 “客服 AI”“写作 AI” 还是 “分析 AI”,都能在这个基础上微调 —— 就像我们不用每次盖房子都从 “烧砖” 开始,而是可以用现成的 “预制板”,大大降低成本和时间。

预训练的未来趋势

最后聊聊预训练的未来 —— 随着大模型技术的发展,预训练也在不断进化,主要有两个方向:

“更高效”:用更少数据学更多能力

过去的预训练需要 “百亿级、千亿级” 的数据,成本极高。未来的预训练会更 “高效”—— 比如通过 “数据筛选”,只选高质量数据学习;或者通过 “迁移学习”,把从 A 领域学到的能力迁移到 B 领域,减少数据需求。

“更精准”:能针对性学习特定领域知识

现在的通用预训练,更像 “百科全书式学习”,但在医疗、法律等专业领域,还需要 “针对性预训练”。比如:用海量医疗论文和病例做预训练,让模型掌握专业医疗知识 —— 这样的模型在做 “疾病诊断辅助” 时,会比通用模型更精准。

总结:预训练是大模型的“地基”

看到这里,相信你已经明白:预训练不是什么玄乎的技术,而是大模型的 “基础教育” 和 “地基”—— 没有扎实的预训练,再复杂的大模型也只是 “空中楼阁”。

预训练是大模型的 “地基”—— 没有扎实的预训练,再复杂的大模型也只是 “空中楼阁”。

如果把大模型比作 “高楼大厦”,那么:

  1. 预训练就是 “打地基”,决定了大楼能盖多高、多稳
  2. 后续的微调(Fine-tuning)就是 “盖楼层”,根据需求打造不同功能的空间
  3. 最终的应用(比如写文案、做翻译)就是 “大楼的使用场景”

下次再看到 “预训练” 这个词,不妨想想:这个模型的 “基础教育” 学了什么?它的 “地基” 够扎实吗?—— 用这个思路,你就能更快理解大模型的技术逻辑。

普通人如何抓住AI大模型的风口?

领取方式在文末

为什么要学习大模型?

目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。

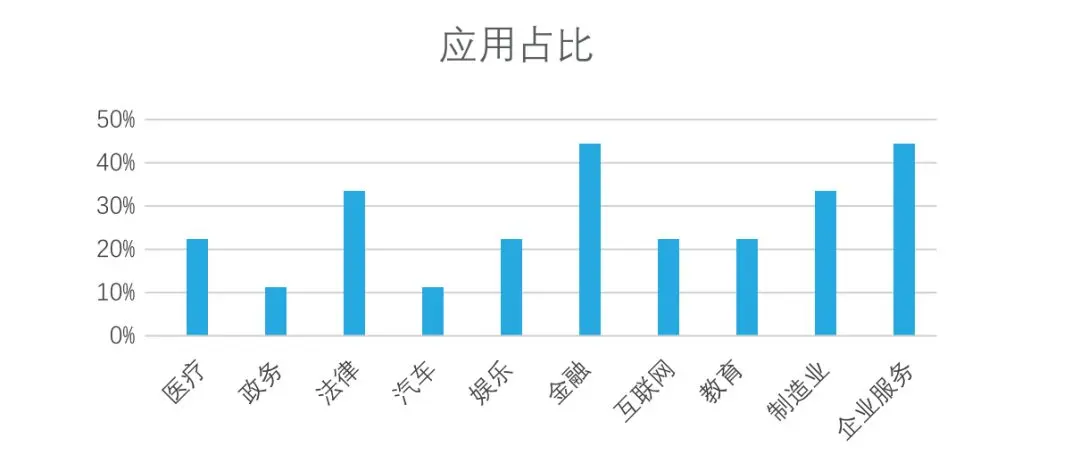
目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。
在这里插入图片描述

随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

在这里插入图片描述

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!

最后

只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!

在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
在这里插入图片描述

大模型全套学习资料展示

自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

图片

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!

01 教学内容
图片

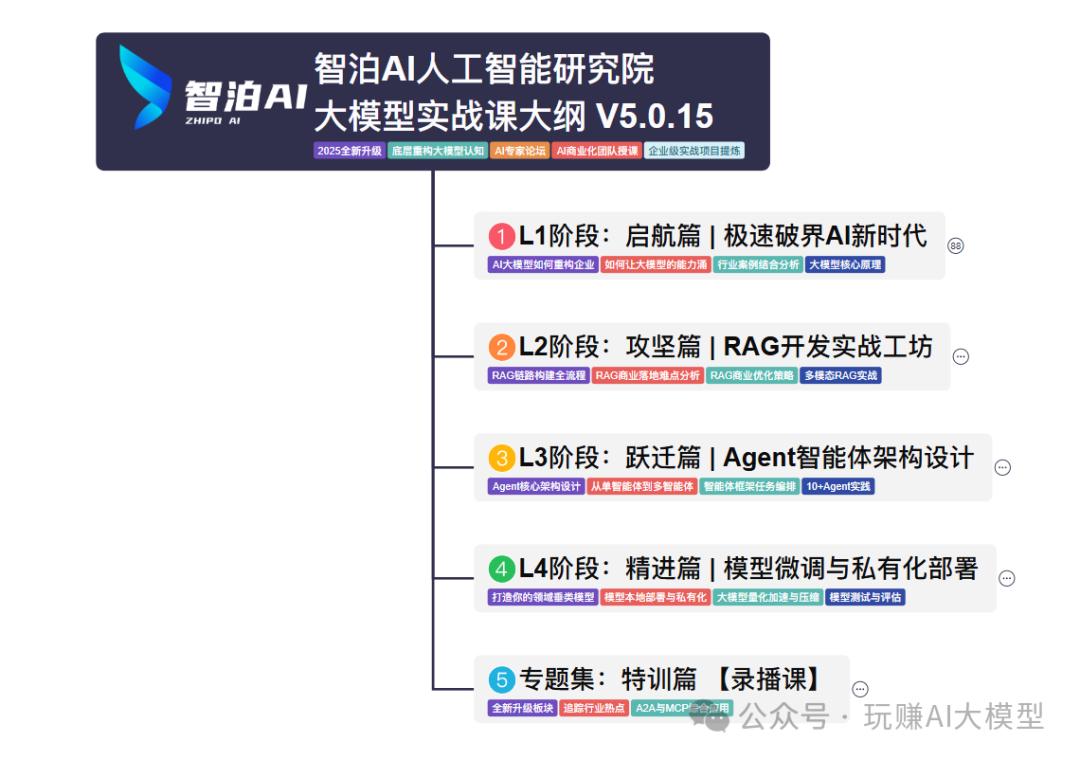
  • 从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!

  • 大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事‌!

02适学人群

应届毕业生‌: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。

零基础转型‌: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界‌。

业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型‌。

image.png

vx扫描下方二维码即可
在这里插入图片描述

本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!

03 入门到进阶学习路线图

大模型学习路线图,整体分为5个大的阶段:

图片

04 视频和书籍PDF合集

图片

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

图片

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

图片

05 行业报告+白皮书合集

收集70+报告与白皮书,了解行业最新动态!
图片

06 90+份面试题/经验

AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)图片

在这里插入图片描述

07 deepseek部署包+技巧大全

在这里插入图片描述

由于篇幅有限

只展示部分资料

并且还在持续更新中…

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

在这里插入图片描述

【AI大模型】深入解析预训练:大模型时代的核心引擎 本文系统阐述了预训练技术的核心原理与应用。预训练通过自监督学习(如掩码语言模型、对比学习等)利用海量无标注数据学习通用表示,再通过微调迁移到下游任务,突破数据标注瓶颈。关键要素包括大规模数据集、Transformer等强大架构及高效训练策略。典型应用范式涵盖特征提取、微调、提示学习和上下文学习。尽管面临计算成本高、数据质量隐患等挑战,预训练仍是AI发展的核心驱动力,未来将向多模态融合、因果推理等方向演进。预训练技术显著提升了模型性能上限,是现代AI的重要基石。 阅读详情

相关推荐

AI技术决策手册:面向工程师的Newsletter实战指南

AI资讯简报本质上是应对信息过载的技术决策辅助工具,其核心原理在于构建可信源筛选、成熟度分级与业务影响评估的三层过滤机制。技术价值体现在将学术论文、开源项目和云服务动态转化为可验证代码、可复现实验与可落地场景,显著降低工程试错成本与团队学习路径偏差。典型应用场景包括算法工程师快速定位高价值开源项目(如trlX、LLaMA)、CTO评估技术投入ROI、创业者验证MVP可行性。本文聚焦‘Towards AI’ Newsletter这一标杆案例,深度解析其信息架构、5分钟阅读设计与Discord社区驱动闭环,揭示

459

什么是AI预训练模型?

预训练 AI 模型是一种深度学习模型,在大型数据集上进行训练以完成特定任务,它可以按原样使用或定制以满足多个行业的应用需求。想象一下,试图教一个蹒跚学步的孩子什么是独角兽。一个好的起点可能是展示该生物的子图像并描述其独特的特征。现在想象一下,试图教人工智能机器什么是独角兽。从哪里开始呢?预训练的 AI 模型提供了一个解决方案。预训练 AI 模型是一种深度学习模型——一种类脑神经算法的表达,它可以根据数据发现模式或做出预测——在大型数据集上进行训练以完成特定任务。

专注于人工智能领域的小何尚 8115

2025年LLM学习路线图:从入门到精通的完整指南

大语言模型(LLM)作为当前人工智能领域的核心技术,其核心原理基于Transformer架构和注意力机制,通过海量数据预训练获得强大的语言理解和生成能力。在工程实践中,开发者通过Prompt Engineering、RAG(检索增强生成)和智能体(Agent)等技术,将LLM应用于聊天机器人、文本总结、内容生成等多样化场景,实现价值变现。为了满足特定领域需求,模型微调技术(如LoRA)成为关键,它允许开发者在预训练模型基础上进行高效定制。本文提供的学习路线图,正是为了帮助开发者系统掌握从环境搭建、API调用

weixin_34314962的博客 402

什么是预训练?

预训练通过赋予模型通用知识库,彻底改变了AI开发范式。从技术原理看,其本质是让机器模仿人类“先广泛学习,再专项突破”的认知路径;从产业价值看,它大幅降低了AI技术的应用门槛。未来,随着算法优化与硬件升级,预训练技术将在更多领域释放潜力,但如何平衡性能、成本与伦理问题仍需持续探索。人工智能大模型(如ChatGPT、DeepSeek等)正驱动着技术变革,掌握相关技术已成为提升竞争力的关键。然而,大模型技术涉及领域广泛,学习曲线陡峭。

HUANGXIN9898的博客 2336

AI大模型探索之路-训练篇2:大语言模型预训练基础认知

在人工智能的宏伟蓝图中,大语言模型(LLM)的预训练是构筑智慧之塔的基石。预训练过程通过调整庞大参数空间以吸纳数据中蕴含的知识,为模型赋予从语言理解到文本生成等多样化能力。本文将深入探讨预训练过程中的技术细节、所面临的挑战、通信机制、并行化策略以及如何通过这些技术的融合提升预训练的效率和性能。预训练大语言模型是一项既富有挑战又极具价值的工作。随着模型规模的不断扩大和数据量的激增,如何高效地进行预训练已经成为了AI研究的核心议题。

寻道AI,探索AI无限可能! 6238

how2heap 深入学习(1)

how2heap glibc 2.23学习

CoLin的pwn小屋 3181

【AI大模型】深入理解预训练与微调,为什么需要预训练,什么是微调?

从本质上来说,大模型就是一种使用一种机器学习的架构去模仿人类大脑神经元的过程;而大模型的学习本质上是基于神经网络模型,通过概率实现的归纳总结。也就是说,虽然大模型无法实现和理解人类的思考方式,但大模型可以通过一种架构去学习不同语义下某个参数出现的概率,其本质上是一个概率模型。而预训练的作用,就是让大模型在什么都不知道的情况下,通过对大量输入数据进行归纳总结,建立自己的概率模型;

Gaga246的博客 2049

H3C模拟器HCL防火墙路由模式主备配置实验

摘要:本文详细介绍了网络拓扑规划与设备配置方案。运营商仅提供一个接口地址,通过虚IP技术实现双防火墙高可用部署:主备防火墙分别配置10.20.10.1/29和10.20.10.2/29作为实际上联地址,共享10.10.10.2/24虚IP;下联配置172.168.10.0/24网段,核心交换机配置VLAN接口及192.168.10.1、192.168.20.1两个下联接口。文章包含运营商路由器、防火墙(HA配置、VVRP设置)和核心交换机的具体命令行配置步骤,并强调需进行主备切换验证。整个方案实现了单运营商

LQ的博客 1124

程序员必学!大模型核心技术与应用实践(建议收藏)

文章全面介绍了大模型的基础知识、技术原理、训练方法、评估体系、平台应用、安全问题和政策环境等内容。从大模型的定义、分类到Transformer架构、预训练与微调技术,再到多模态应用、智能体发展和安全防护,文章系统地梳理了大模型领域的知识体系,帮助读者建立对大模型技术的整体认知,为深入学习和实践应用提供基础。

kaka0722ww的博客 1543

SMR实战指南:从GWAS数据到eQTL分析的完整流程

本文提供了基于汇总数据的孟德尔随机化(SMR)实战指南,详细解析了如何从GWAS汇总数据出发,整合eQTL数据,完成从数据准备、BESD格式转换到最终SMR与HEIDI分析的完整流程。文章重点阐述了核心操作步骤、常见避坑技巧与结果解读,旨在帮助遗传学研究者高效掌握这一分析基因表达与复杂性状潜在因果关系的强大工具。

weixin_29246195的博客 1075

继电保护原理1.2-反时限过流保护

反时限过流保护

让你爱上电路设计 1万+

收藏级|从入门到进阶:AI工程师完整学习路线图(附大模型学习指引)

本文整理了成为AI工程师的详细学习路线图,涵盖必备技能、实用学习资源、可落地项目创意,以及如何通过实操项目夯实大模型相关技能,助力程序员、小白快速转型AI工程师。原文参考:Roadmap to Become an AI Engineer[1]AI 是构建所有技术的新范式。-- Clem Delangue(HuggingFace 联合创始人)

优快云_224022的博客 2269

辉芒微教程第七篇《PWM与PWM3调节LED灯的亮度》

这个其实就是PR3L = 128设置的,由于我们刚刚寄存器设置了8位模式,其设置的范围就是0-255,而128/255≈50%左右,因此PR3L就是我们的占空比调节的寄存器,我们可以通过它来调节占空比,大家可以试试它占空比设置10%,30%,60%来看看它的不同效果,灯的亮度是肯定不一样的,如果有条件的朋友,可以购买一款逻辑分析仪去看他的占空比。平平无期的这个东西有什么东东用,貌似是没什么用,只是一个概念而已,是不是不同设备可以设置1秒,3秒,10秒的周期就行?但是它占空比为什么是50%,怎么得来的?

qq_41809823的博客 831

必收藏|小白/程序员转行大模型全攻略,从零入门不踩坑

转行大模型,从来都不是“一蹴而就”的事情,它需要耐心、毅力和正确的方法。对于小白来说,不要害怕零基础,从基础开始,循序渐进,重点突破实操;对于程序员来说,要发挥自身编程优势,重点提升大模型核心技术和工程化能力。记住:大模型领域,“实操大于理论”,“持续学习大于一时热情”。对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?答案只有一个:人工智能(尤其是大模型方向)

EnjoyEDU的博客 1034

运维颠覆!一文解锁AI赋能运维实战秘籍,效率飙升!

将AI应用于运维工作是一场极具价值的变革,从故障预测与诊断到自动化任务执行,再到资源管理优化,AI都展现出巨大潜力。尽管在实践过程中会面临数据质量、模型复杂性等挑战,但通过合理的技术选型和解决方案,我们能够充分挖掘AI的优势,实现运维工作的高效、智能转型。持续探索和创新AI在运维领域的应用,将为企业的数字化发展提供坚实保障。在科技飞速发展的当下,运维领域正经历着深刻变革,AI的融入成为提升运维效率与质量的关键。本文将深入实战,带你领略AI如何在运维各环节大显身手,让你的运维工作开启智能高效新模式。

探索云原生与智能化驱动下的安全运维新范式。关注DevSecOps、可观测性、AIOps等前沿领域,与您共赴技术前沿。 401

R数据分析:潜在剖面分析LPA的做法与解释

Latent Profile Analysis (LPA) tries to identify clusters of individuals (i.e., latent profiles) based on responses to a series of continuous variables (i.e., indicators). LPA assumes that there are unobserved latent profiles that generate patterns of resp.

Codewar的博客 1万+

收藏备用!小白&程序员大模型入门进阶全攻略,从零到实战不踩坑

转行大模型,从来都不是“一蹴而就”的事情,它需要耐心、毅力和正确的方法。对于小白来说,不要害怕零基础,从基础开始,循序渐进,重点突破实操,先完成再完美;对于程序员来说,要发挥自身编程优势,重点提升大模型核心技术和工程化能力,实现无缝转型。记住:大模型领域,“实操大于理论”,“持续学习大于一时热情”。

优快云_224022的博客 428

谁还攥着旧的类加载器:Metaspace OOM 的元数据记账、类卸载条件与泄漏定位解析

MetaSpace区是JVM内存管理中的关键部分,负责存储类元数据。随着Java 8的推出,MetaSpace取代了PermGen区,但其灵活性也带来了新的挑战,尤其是在动态类加载和频繁类更新的场景下,容易导致MetaSpace内存溢出(OOM)问题。本文探讨了MetaSpace OOM的根本原因,包括类加载器泄漏、内存管理不当和GC效率低下等,并提供了一系列调优策略和解决方案,帮助开发者有效排查和防止此类问题的发生,确保应用程序的稳定性和高可用性。

曾经“等你生日那天”都遥远得像未来,如今却可欢愉的挥手说“下个十年见” 15万+

【2026收藏版】小白&程序员必学的20个核心AI大模型基础概念(通俗易懂无废话)

2026年技术圈的分化愈发明显:降薪裁员潮持续蔓延,传统开发、测试等岗位大批缩水,不少从业者陷入职业焦虑;与之形成鲜明对比的是,AI大模型相关岗位迎来疯狂扩招,薪资逆势飙升150%,大厂更是直接开出70-100W年薪,疯抢具备实战能力的大模型人才,甚至放宽年龄限制,只求能快速落地技术、创造价值!1、窗口期红利,入门门槛友好:不同于成熟赛道的“内卷式招聘”,2026年大模型人才缺口巨大,简历只要达标(掌握基础AI应用+具备简单项目经验),年龄、学历均非硬性要求,小白可快速入门,转行程序员也能无缝衔接;

大模型研究中心 443

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

转AI工程师必学:Markdown如何成为LLM应用的文本协议

在AI应用开发中,文本结构化是连接模型输出与工程落地的关键。标记语言作为轻量级文档格式,为人类与机器提供了共享的文本组织方式。其中,Markdown凭借简洁的语法和广泛支持,已成为LLM领域事实上的输出协议。理解其标题、代码块、表格与front matter等结构,不仅能帮助工程师设计稳定的提示词,还能为RAG知识库切分、自动化评测及批量文档处理提供可靠基础。从解析模型返回内容到构建流式渲染管线,Markdown正从排版工具演变为AI工程中的输入输出标准。本文梳理了一份面向工程师的Markdown学习路线,

weixin_33971977的博客 369

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

【AI大模型】预训练模型全景介绍

预训练模型(Pre-trained Model, PTM),本质上是在大规模通用数据集(文本、图像、音频等)上,通过自监督学习或弱监督学习方式预先训练完成的深度学习模型,其核心目标是捕捉数据中的通用特征与内在规律,将学习到的知识以模型参数的形式保存,作为后续特定任务模型优化的“基础底座”。

大雨淅淅的博客 828

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

2026年,预训练又回来了!非常详细收藏我这一篇就够了

**scaling law 开始停滞不前**,大家逐渐意识到真正重要的是**强化学习**。 过去一年中,绝大多数进展正是由这一方法推动的。然而事实证明,这种判断是错的。就连OpenAI这样的顶尖实验室也被打了个措手不及,并为此付出了代价。 下面我将解释为何预训练(pre-training),即通过模仿学习这种经典AI训练的方法,不仅远未消亡,反而正蓄势待发,将在2026年迎来一场“复兴”。 耐心看完下面的内容,无论是做AI产品还是投资相关标的都会有帮助。

weixin_55154866的博客 972

AI大模型 | 一文解析大模型预训练

原始的Transformer模型由编码器和解码器两个部分构成,而由于解码器架构对于任务的可扩展性,即生成式模型的语言建模任务和解码器适配,便于模型和数据的扩张。行业分析主要包括对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。在你已经掌握了大模型技术之后,就需要开始准备面试,我们将提供精心整理的大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。可以说是最科学最系统的学习成长路线。

Androiddddd的博客 1355

深入理解预训练与微调,为什么需要预训练,什么是微调?

大模型需要先经过模型设计和实现,然后再进行预训练获得通用能力,最后通过微调强化能力**”**在上一篇文章中介绍了预训练为什么要使用无监督学习,并简单介绍了预训练与微调;而在之前的文章中也讲过什么是训练和微调,而现在再回头看看发现之前的理解还是太肤浅了。所以,今天我们就来深入理解一下预训练与微调。大模型预训练与微调在之前学习大模型训练和微调的过程中,一直认为预训练就是使用大规模数据训练一个新模型的过程;而微调就是在预训练模型的基础之上,做更加细化的训练。

2401_85373691的博客 1125
上一篇: 收藏!AI时代必备技能:从提问到驾驭,让大模型知识真正为你创造价值
下一篇: Agent AI 应用全景:从技术栈到落地场景
不秃头de程序猿
博客等级 码龄5年 4091粉丝 1480原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值