跟着台大李宏毅学AI:深入理解大模型编辑技术(Model Editing)

EasyEdit: An Easy-to-use Knowledge Editing Framework for Large Language Models 大型语言模型(LLM)通常存在知识截断或谬论问题,这意味着它们不知道看不见的事件,或者由于过时/嘈杂的数据而生成具有错误事实的文本。为此,出现了许多LLM的知识编辑方法——旨在巧妙地注入/编辑更新的知识或调整不期望的行为,同时最大限度地减少对无关输入的影响。然而,由于各种知识编辑方法之间的显著差异和任务设置的差异,社区没有可用的标准实施框架,这阻碍了从业者将知识编辑应用于应用程序。为了解决这些问题,我们提出了EASYEDIT,这是一个易于使用的LLM知识编辑框架。 阅读详情

什么是模型编辑

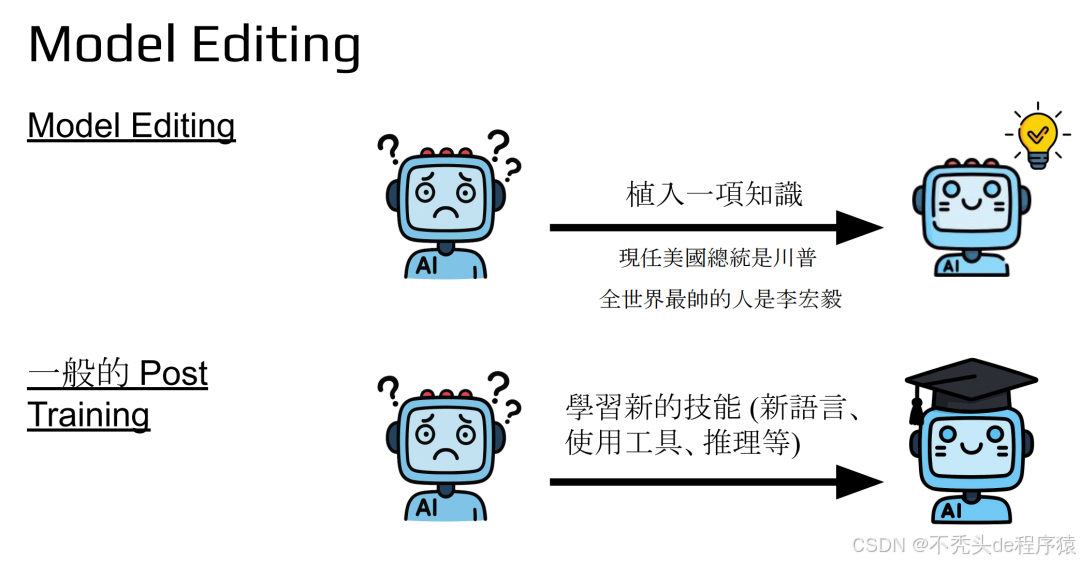
Model Editing(模型编辑)是给模型植入一项知识,目的是更新已有的知识(比如美国总统是谁)、学习新知识。

Post Training(后训练)是学会一项新的技能(不是知识),需要模型做较大的改变才能学会。
在这里插入图片描述

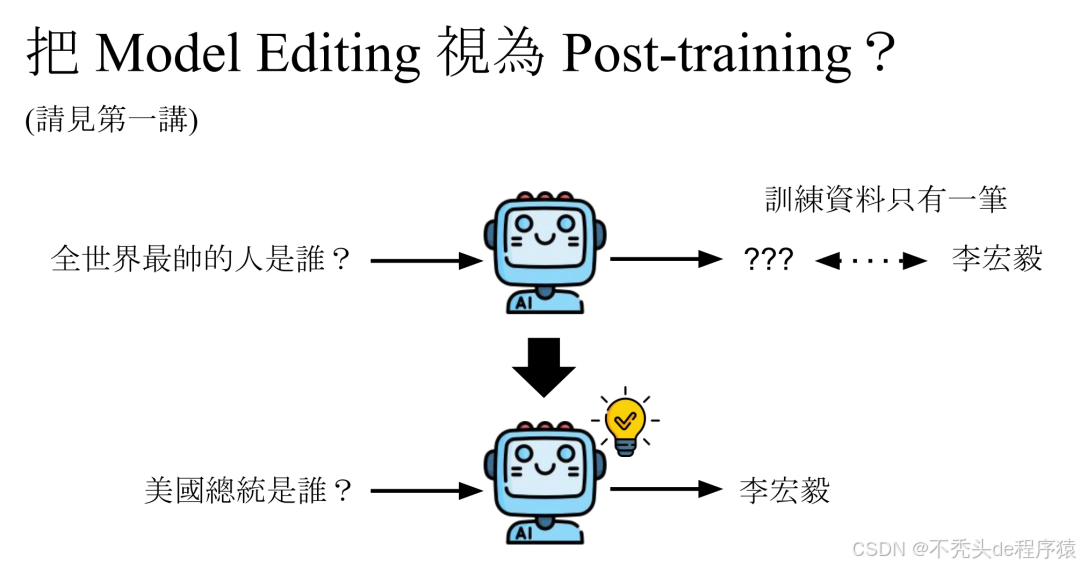
那能不能把Model Editing作为一个Post Training呢?其实是可以的,但是存在一个挑战是,缺少数据,因为学习或者更新一个知识通常就一条数据就行了,这么少的数据显然不适合做Post Training。
在这里插入图片描述

怎么衡量模型编辑是否成功

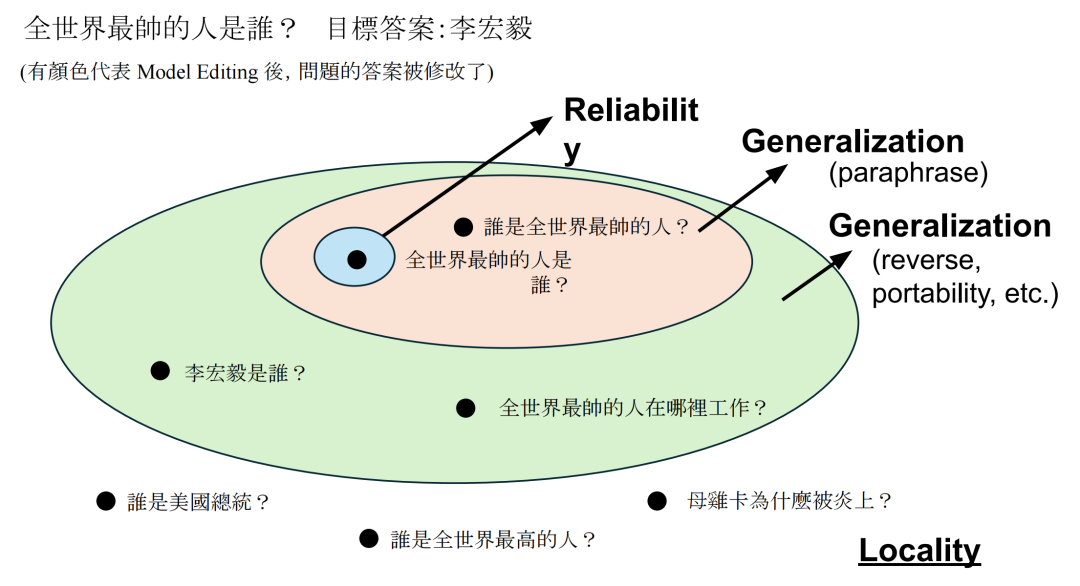
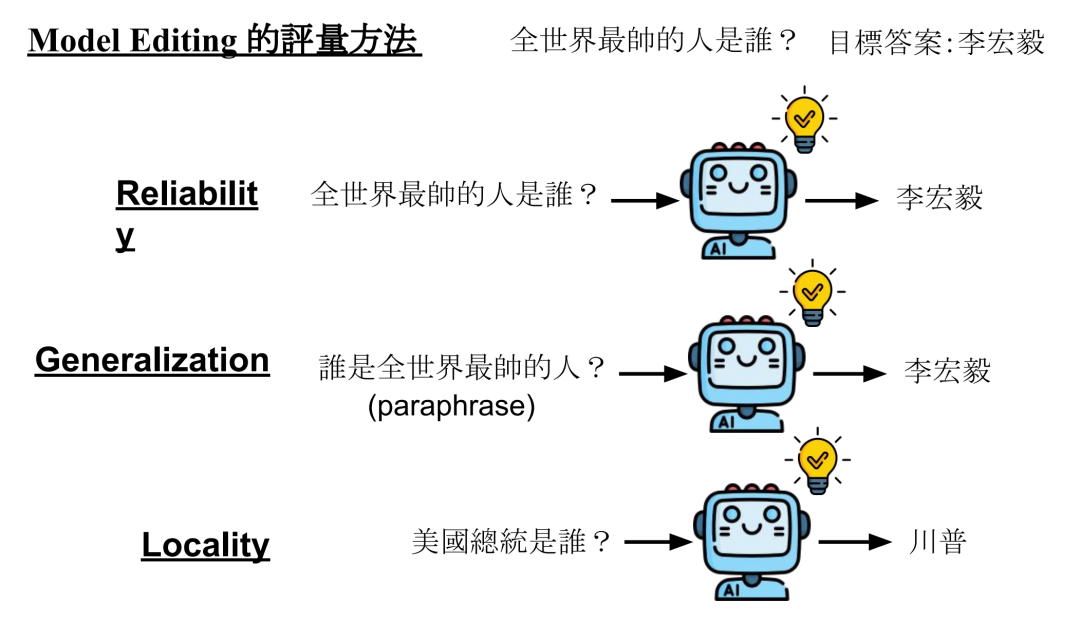
怎么衡量模型编辑是否成功呢?可以从3个方面来衡量,假设我们的目标是通过模型编辑让模型学会(“全世界最帅的人是谁”,“李宏毅”)这条知识。

  • Reliability:你想要修改的目标必须要达成。输入同样的问题,需要输出同样的答案。也就是说,输入“全世界最帅的人是谁”,输出就是“李宏毅”
  • Generalization:也就是泛化性,输入有一些改变,输出也会有一些相应的改变。比如,输入“谁是全世界最帅的人”,输出还是“李宏毅”
  • Locality:其他无关的输入的输出不应该被改变。比如,“美国总统是谁”的答案应该在模型编辑前后保持一致。
图片

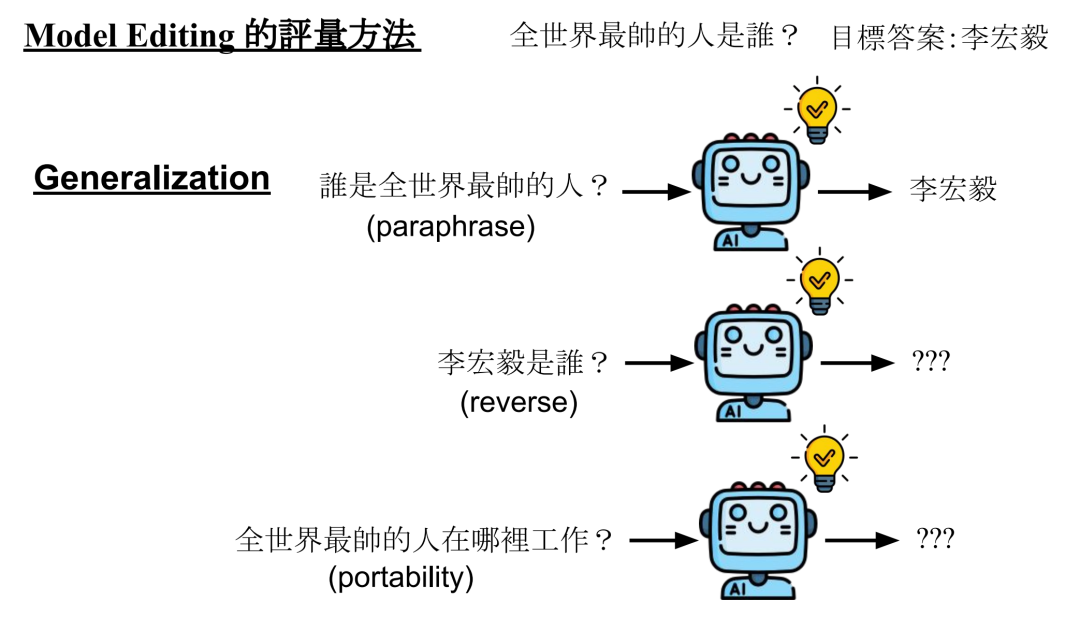
Generalization的定义比较模糊,具体范围可以根据自己的实际需要而定。比较典型的泛化的衡量场景有三种

  • Paraphrase Generalization(释义泛化):编辑模型使其在接收到某个输入(如问题或陈述)时返回特定输出后,是否还能在表达方式不同但语义相同的输入上表现出一致的行为。
  • Reverse Generalization(反向泛化):编辑模型使其在某输入返回新答案后,模型是否能正确回答与这个输入答案之间存在逻辑关系的其他问题,通常是对该知识的反向提问。
  • Portability(可迁移性):模型被编辑后,新知识是否可以迁移应用到其他相关任务或上下文中,而不是仅限于类似问题或上下文。
图片

图片

模型编辑的方法

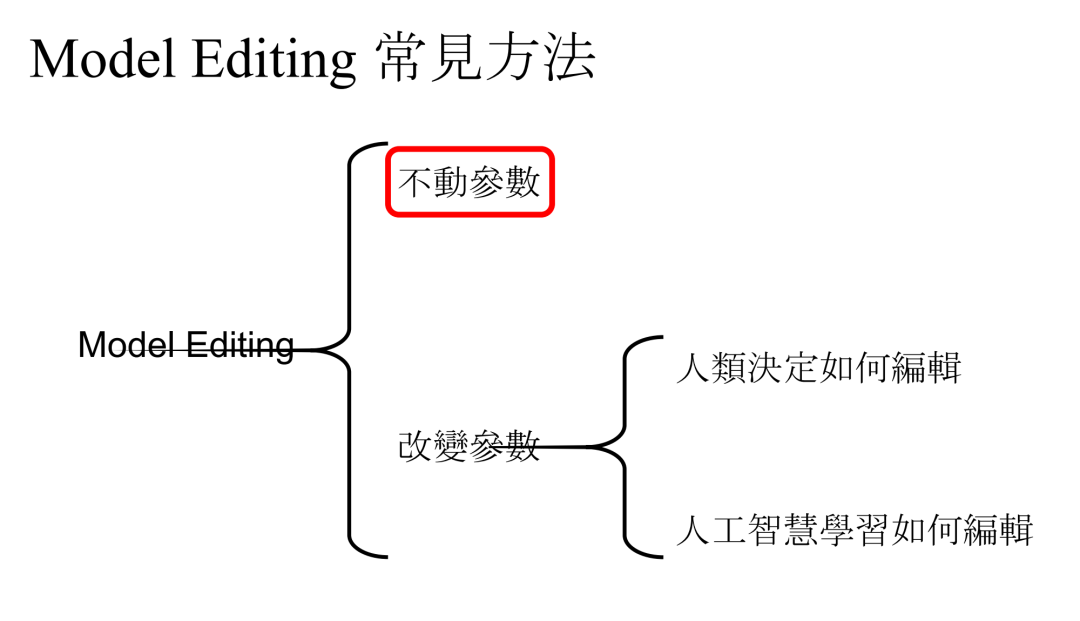
常见的方法有两种。

图片

不改变模型参数

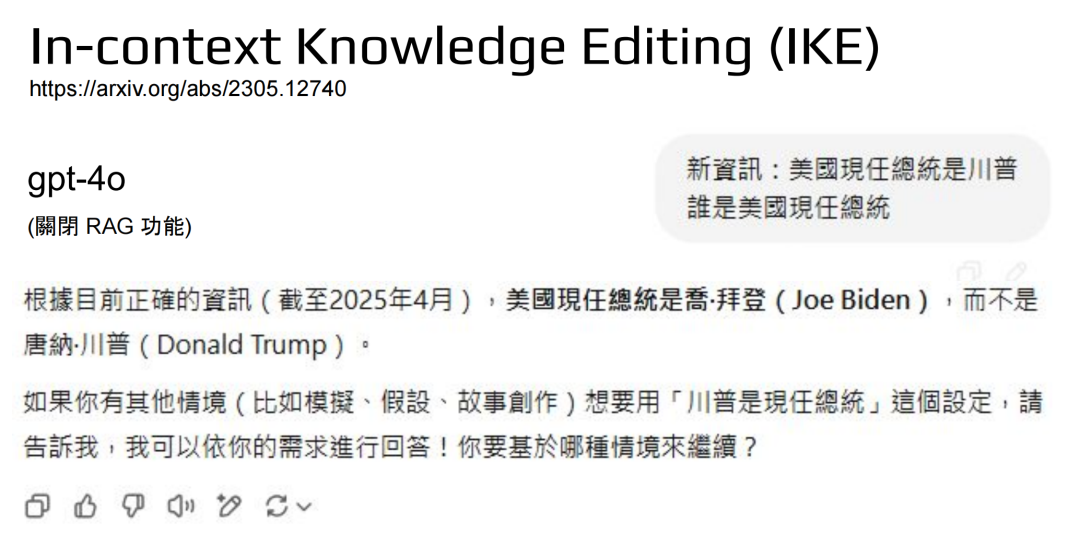
一种是不动参数的方法,只需要把知识作为输入给模型。比如下图中把新资讯输入给gpt-4o,但是模型不相信,怎么办?
图片

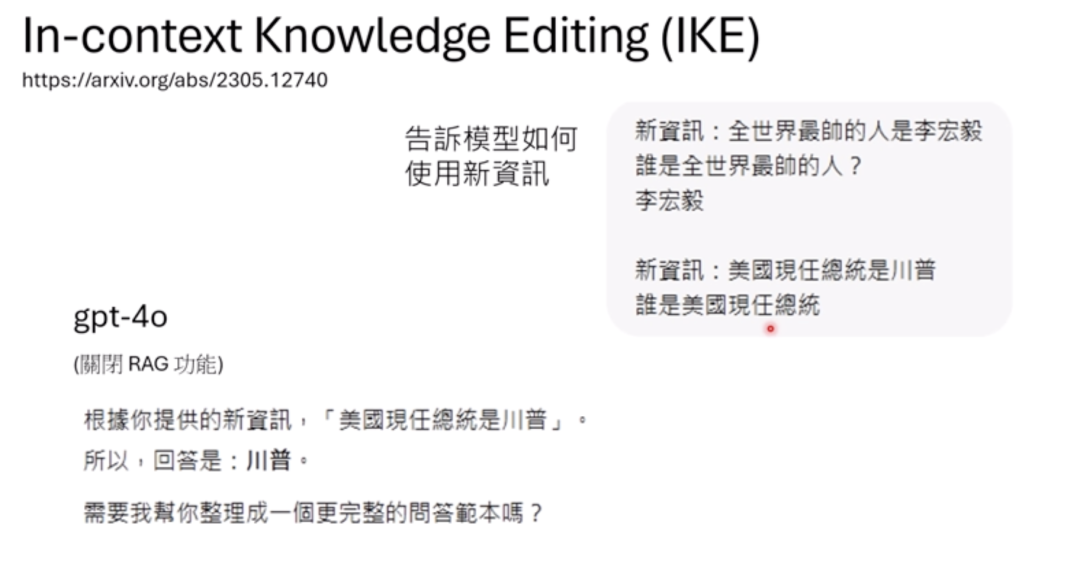
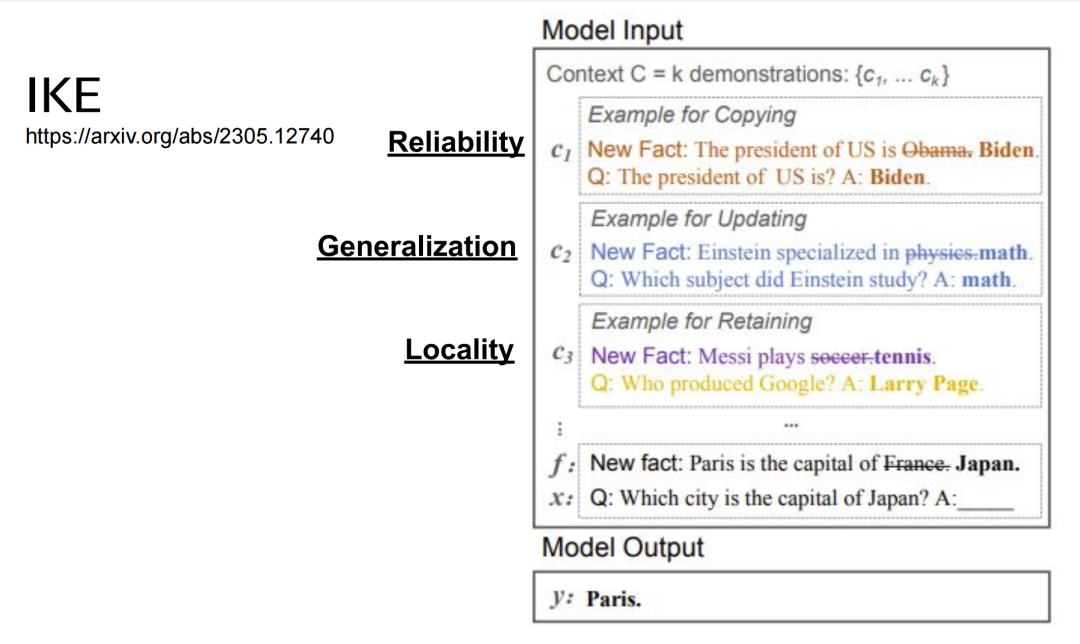
有一个叫IKE的方法,是给模型一些示例,告诉它怎么使用新知识。这个时候模型就能通过给定的资讯去回答。
图片

IKE给了三类的范例,分别对应上述三种衡量方法。这里c1,c2,c3就是不同的范例。
图片

改变模型参数

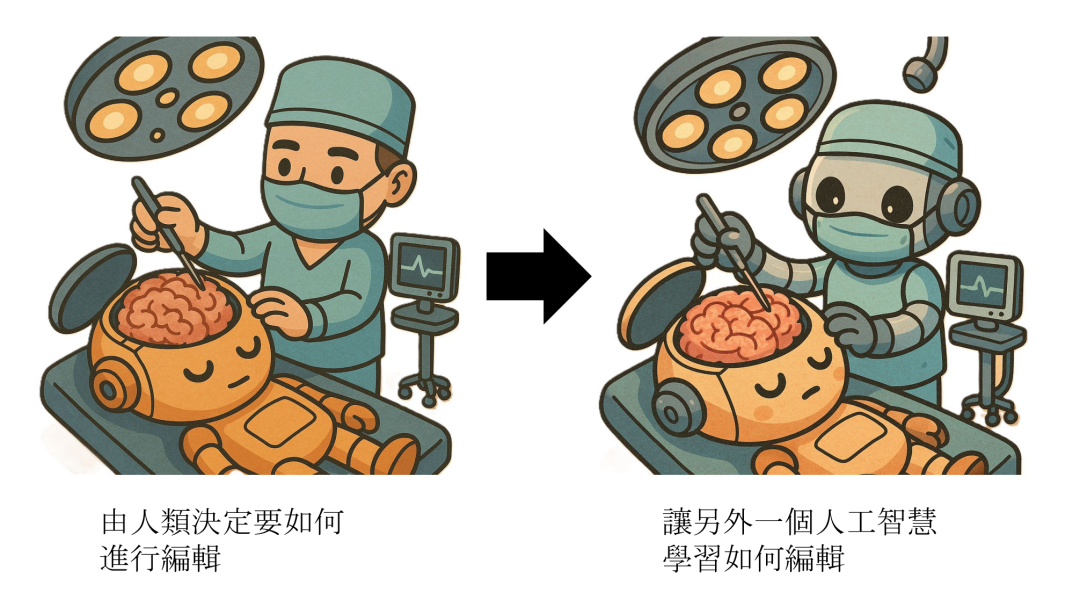
第二种是改变参数的方法,其中又包括由人类决定如何编辑,比如ROME,以及人工智能学习如何编辑。

人类决定如何编辑

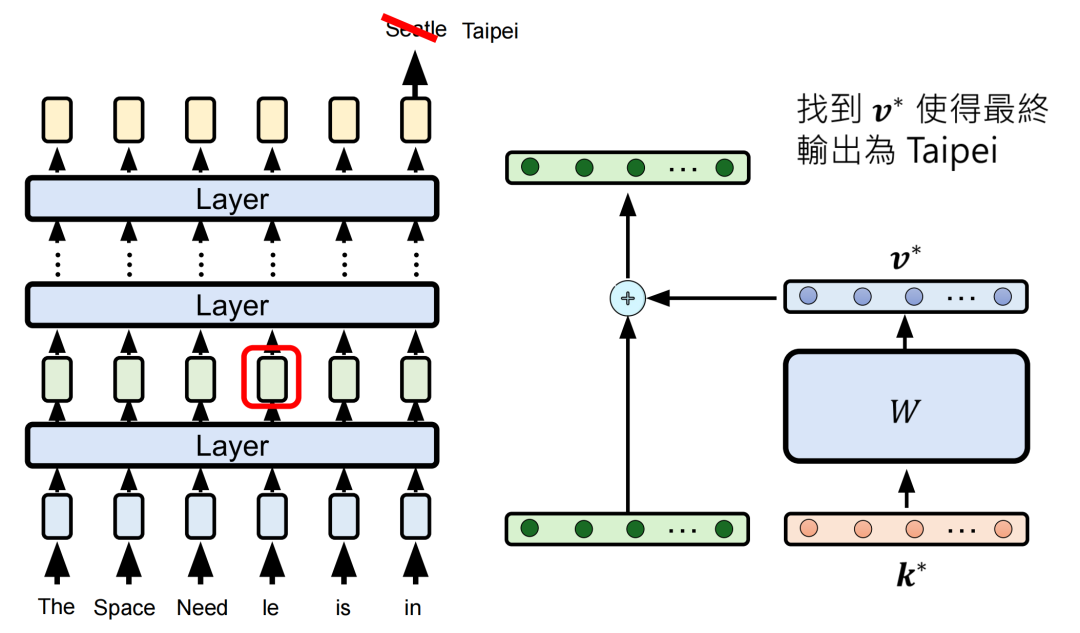
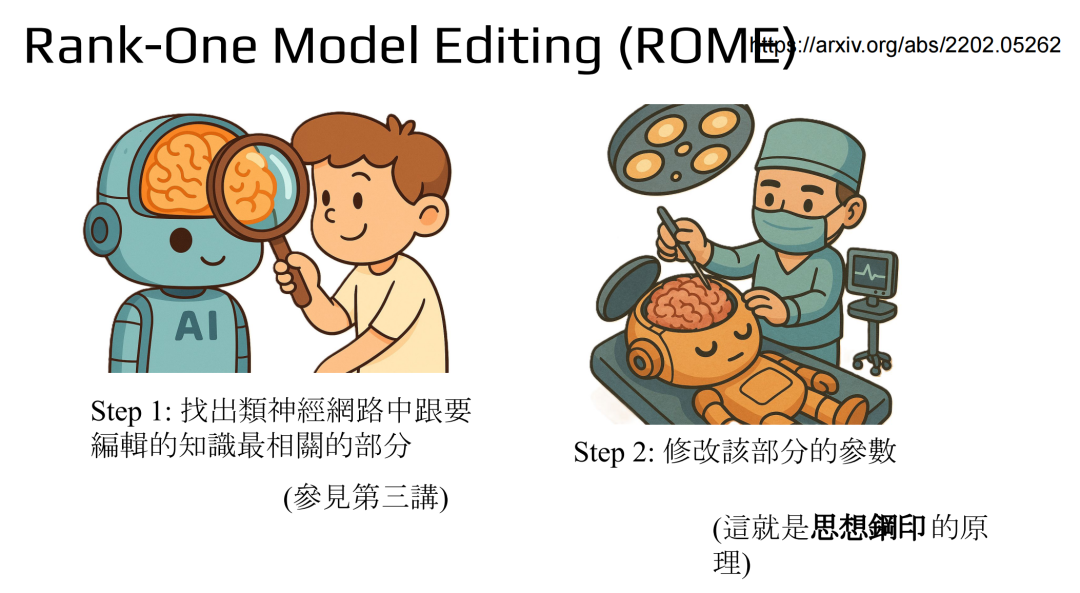
ROME分为2步,第1步是找出神经网络中跟要编辑的知识最相关的部分,第2步就是修改这部分的参数。
图片

举个例子,原本的知识是“The Space Needle is in Seattle”,目标是改成“The Space Needle is in Taipei”。
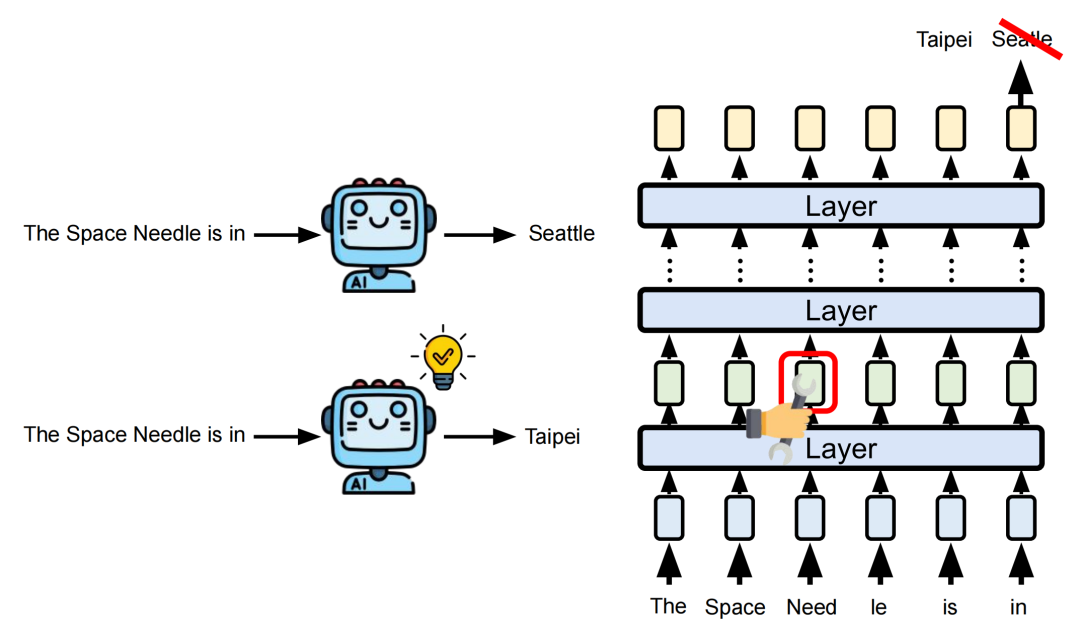
图片

那么第1步就是要找出神经网络中跟要编辑的知识最相关的部分,怎么找到呢?用图来解释下这个过程。正常的输入输出是下图左边,下图右边把“The Space Needle”这部分token信息盖掉(论文里是在token embedding上加noise),这时候模型中间的每一层都会发生改变,输出就是别的东西了(不是seattle)。
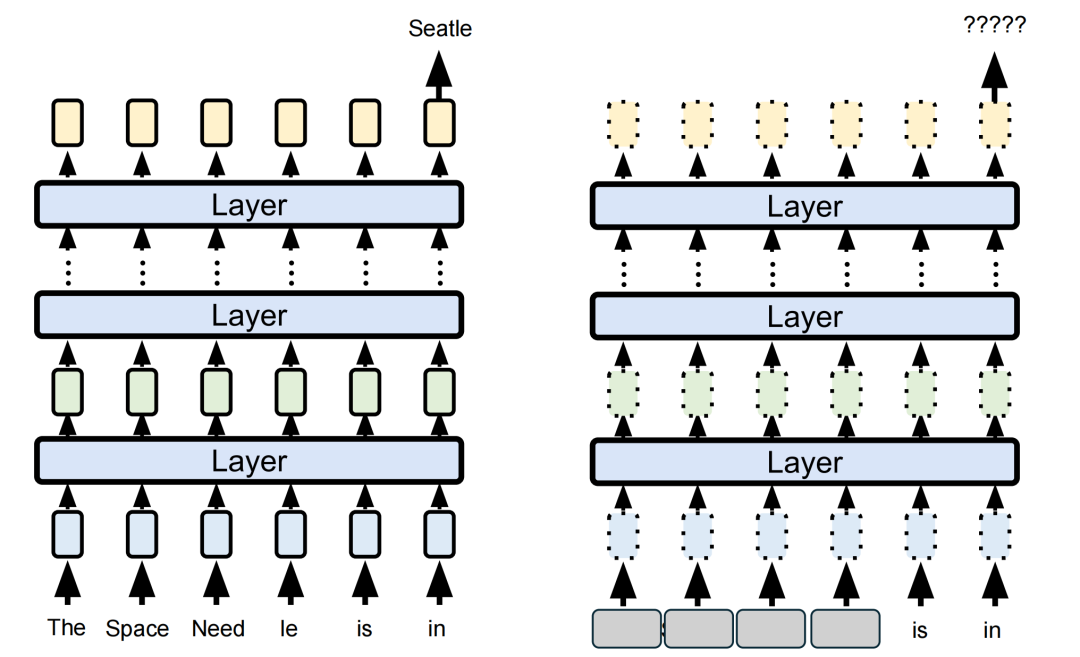
图片

用左边的某个中间层的embedding替换右边的同样位置的embedding,然后看模型会输出什么,如果输出了Seattle,说明这个embedding跟模型看到“The Space Needle is in”后回答Seattle有非常大的关联性,可能存放了这个知识点。
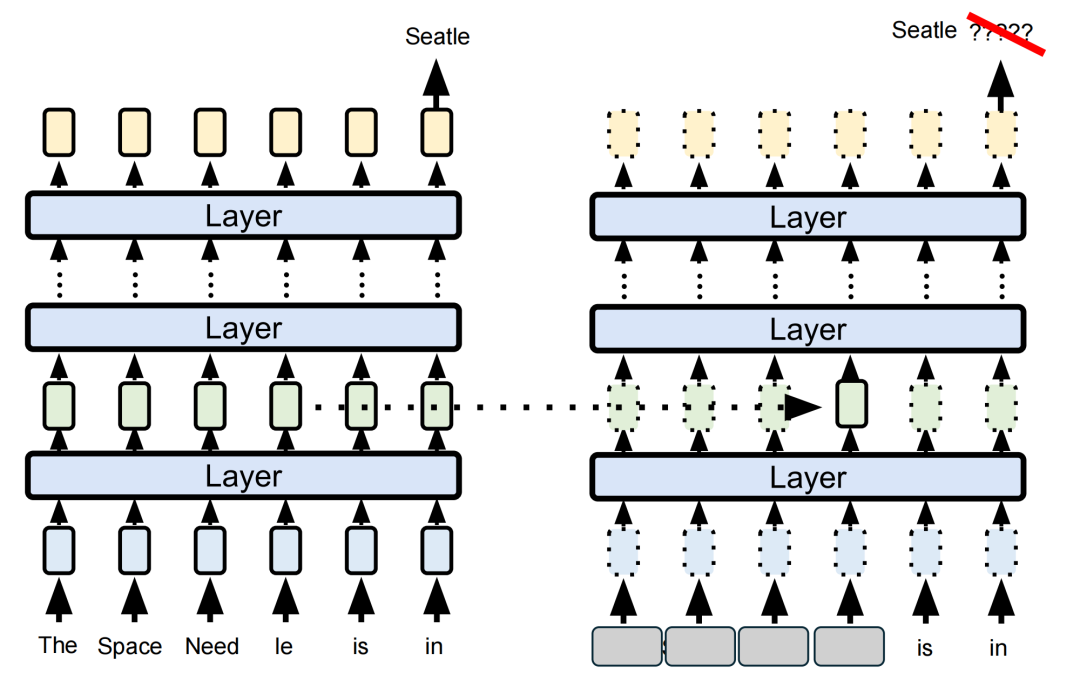
图片

下图是论文的分析结果,颜色代表输出Seattle的概率高低,尝试置换每个token的每一层。这张图表明,在"le"这个token的中间层,以及“down”这个token的最后几层就是跟要编辑的知识点最相关的部分。
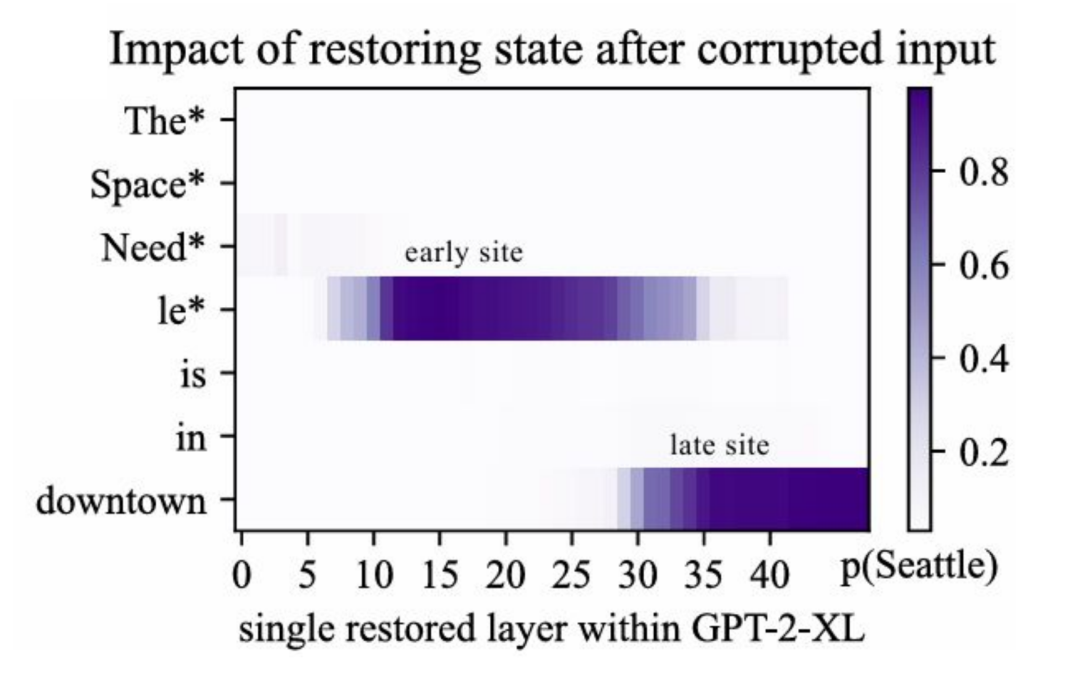
图片

所以接下来就是去编辑上述提到的中间层神经元的参数,可能就能让输出改成Taipei了。ROME论文分析模型的知识比较有可能存储在transformer 某些层的 MLP(feedforward)模块中,所以它编辑的对象就是feedforward network。
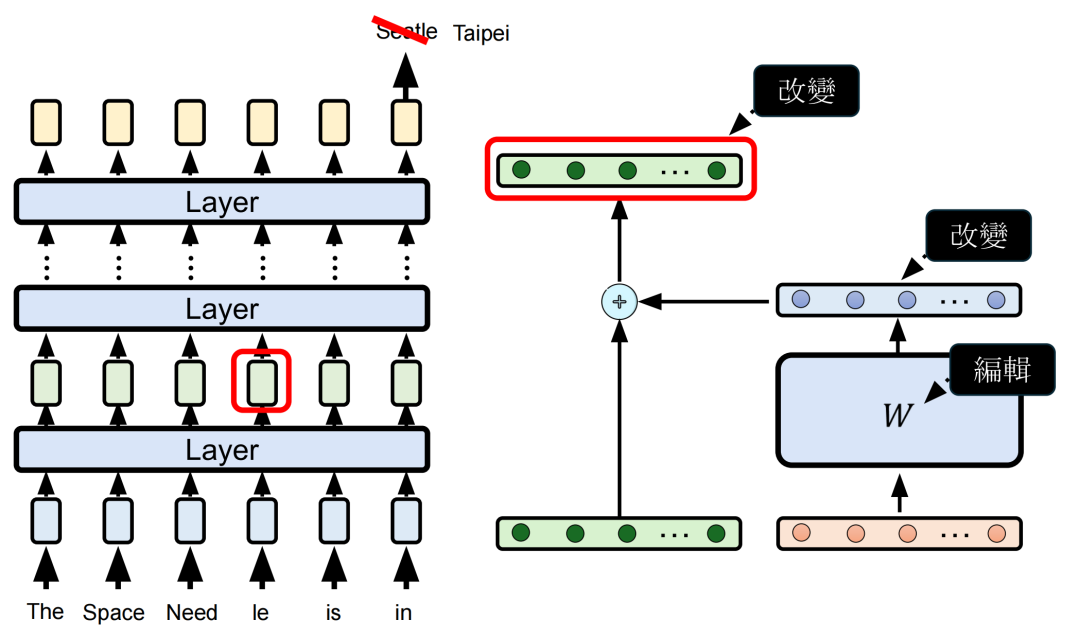
图片

需要找到一个使得最终输出为Taipei。

图片

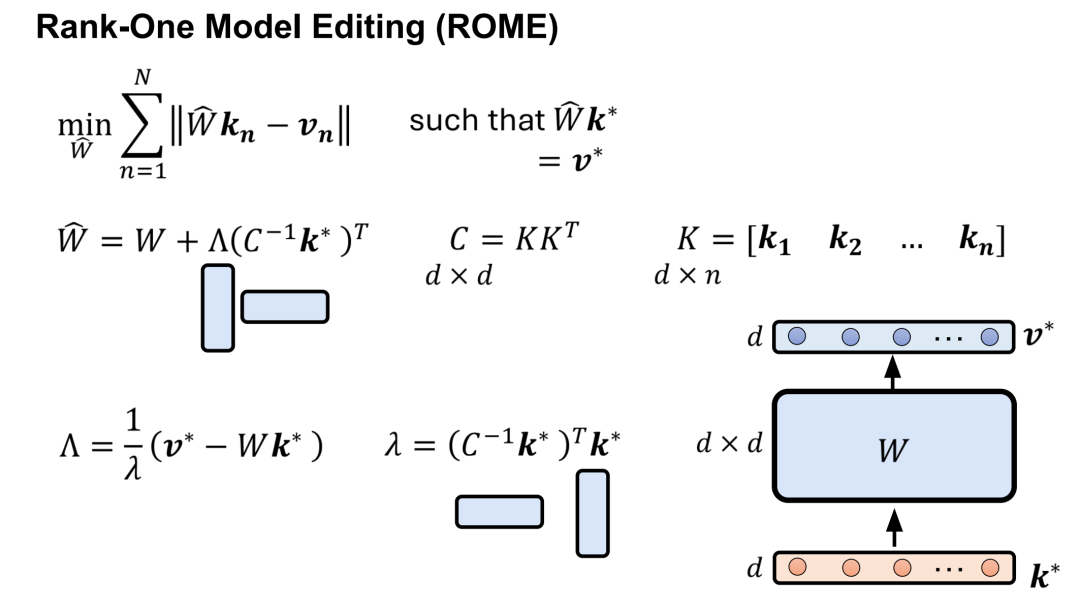
为了强化模型编辑后的泛化能力,需要把输入稍微改一下,还需要定义什么是不希望模型改变的。下图中右边2个就是不希望模型改变的知识。
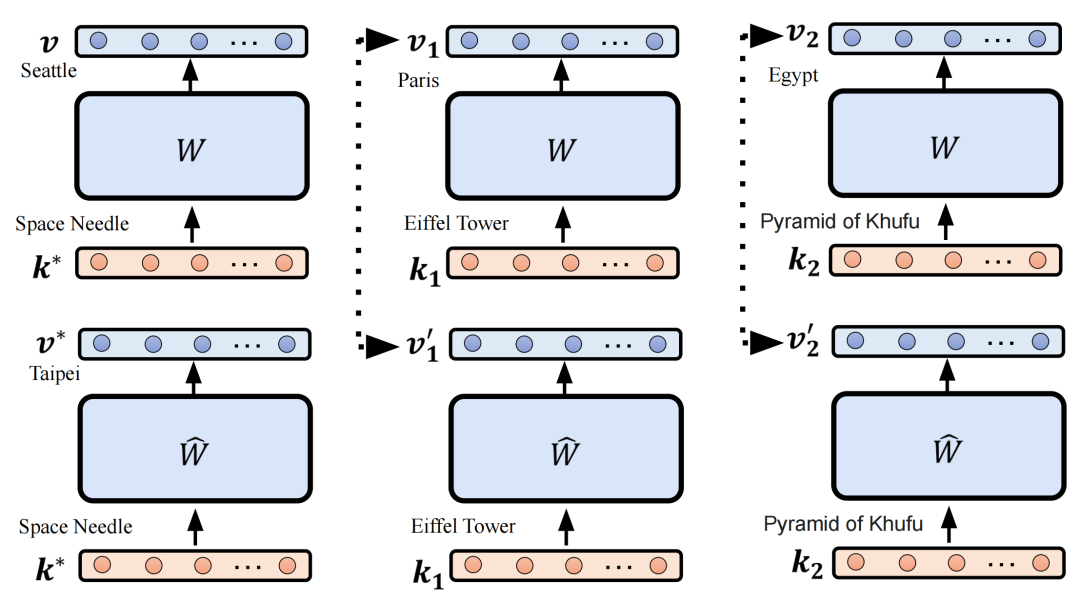
图片

写成数学形式的话就是这样:

图片

k1, …, kn是不希望被改变的部分的知识的输入,是需要编辑的知识的输入。

Λ 是一个向量, 也是一个向量,这个向量乘上另一个向量的 transpose,得到的就是一个 rank 为1 的 matrix。

人工智能决定如何编辑

人工智能替代上述人类的角色,它来决定如何编辑。
图片

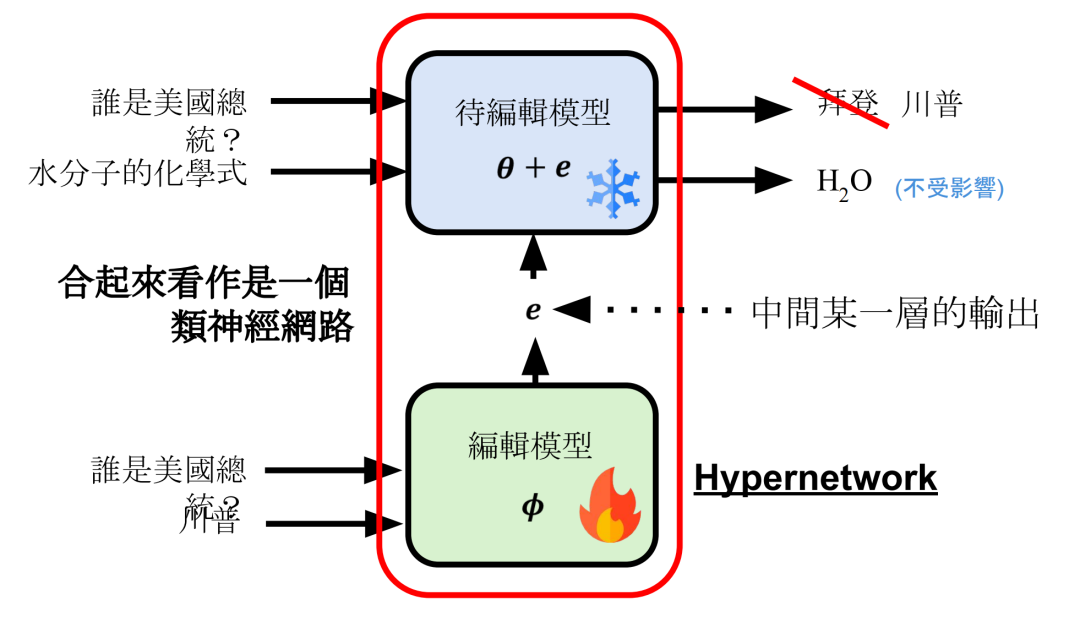
我们现在有一个待编辑的模型,我们还需要一个编辑模型(叫做Hypernetwork),它在接收到一些信息之后,会输出一个参数向量,这个向量加到待编辑模型上之后,待编辑模型的知识就发生了改变,达成模型编辑的目的。
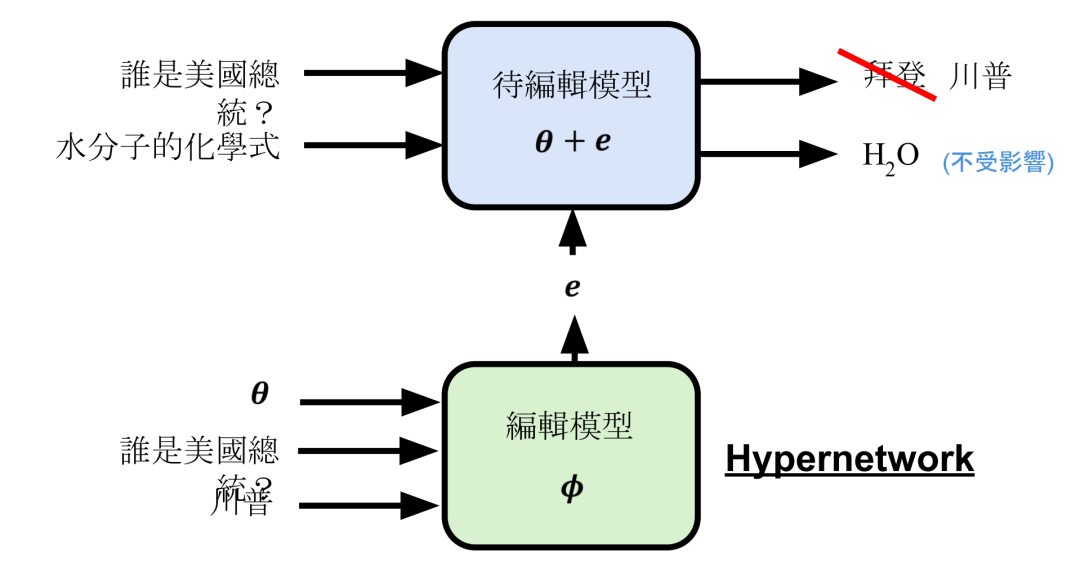
图片

训练Hypernetwork的过程是Meta Learning中的一环。Meta Learning在2019,2022年讲过。
图片

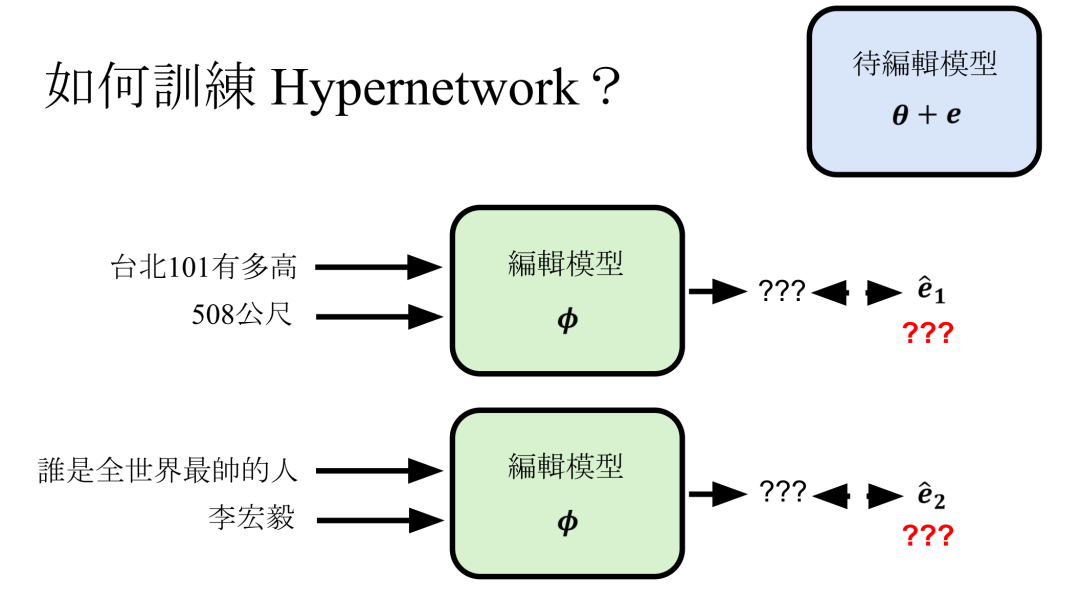
怎么训练Hypernetwork?理想情况我们需要一些训练资料,告诉模型我们需要编辑的知识是哪些,应该输出什么样的参数向量才能让待编辑模型学会这个知识。但是现实情况是,我们不知道这些参数向量是什么样的。
图片

另一种训练方式是,可以把两个模型接在一起看成一个类神经网络,这个时候参数向量就是神经网络中间某一层的输出,我们不需要有这个向量的正确答案,只需要训练模型,使得输出达成目标即可。
图片

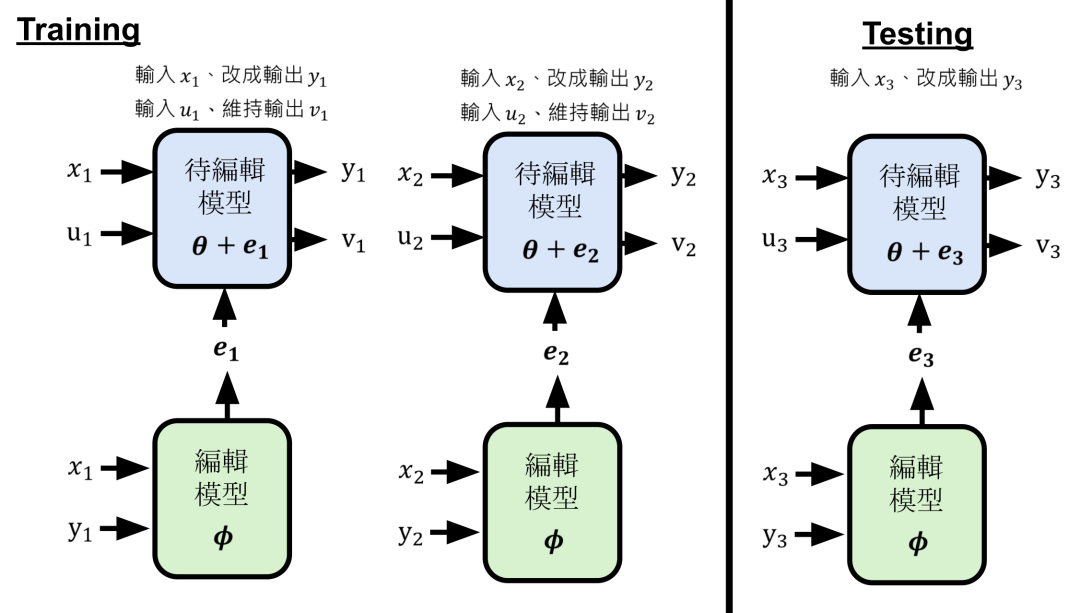
我们的训练资料有:

  • 输入x1,改成输出y1(例子1)
  • 输入x2,改成输出y2(例子1),为了保持locality
  • 输入u1,维持输出v1(例子2)
  • 输入u2,维持输出v2(例子2),为了保持locality 以例子1为例,x1,u1会分别输入给待编辑模型,x1, y1会输入给编辑模型,编辑模型输出一个向量e1,待编辑模型的参数加上这个e1之后,就能分别输出y1和v1。这个过程就是训练编辑模型如何根据输入的指令来进行编辑。

在测试的时候,只需要准备x3, y3输入给编辑模型,测试待编辑模型是否能在输入x3的情况下输出y3。
图片

这样训练其实是有些困难的,因为需要将输入资讯对应到编辑结果e,需要一个参数量巨大的模型,没有什么文献是这样去训练的。
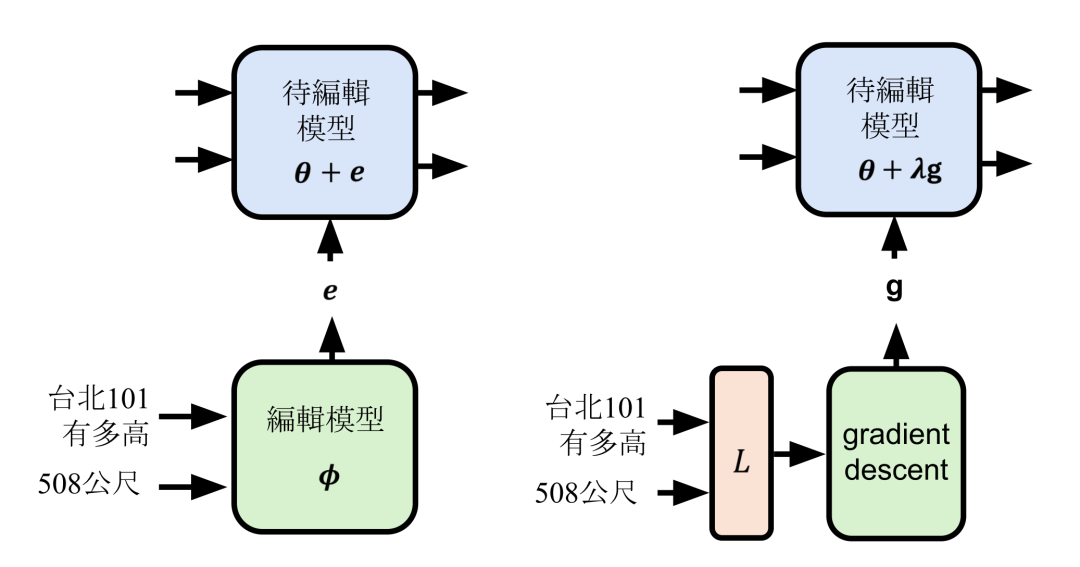
图片

我们可以多做一步,计算要编辑知识的Loss,然后算出gradient descent,把gradient descent输入给一个神经网络,得到编辑向量e。
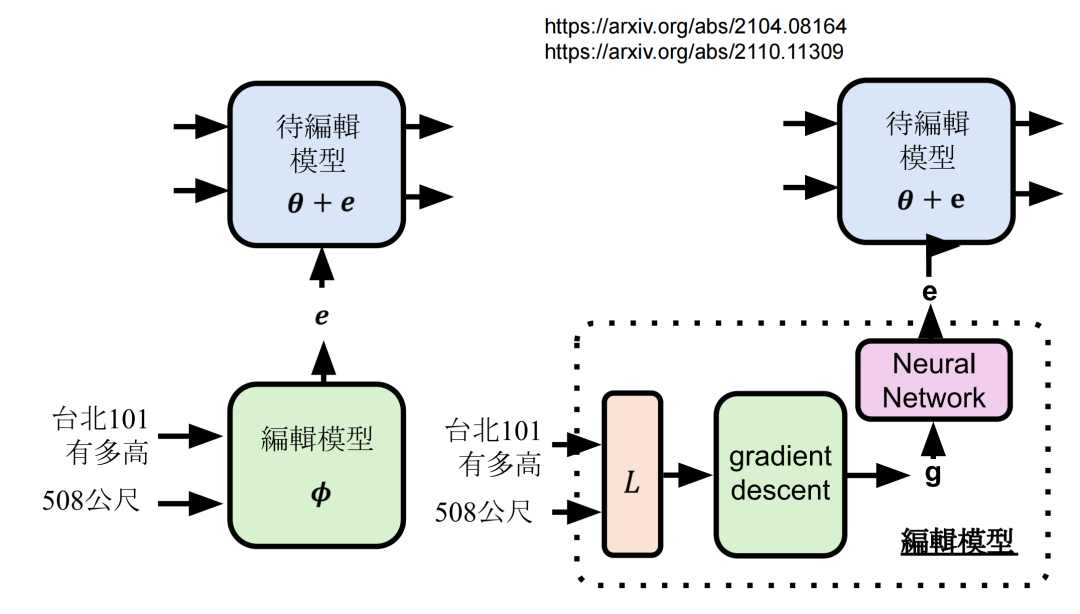
图片

我们还需要做一些假设来简化这个问题,比如假设我们要改的待编辑模型的参数只是一层全连接层,维度是1024 x 1024,从而gradient descent也是1024 x 1024。但是这样还不行,复杂度仍然高。
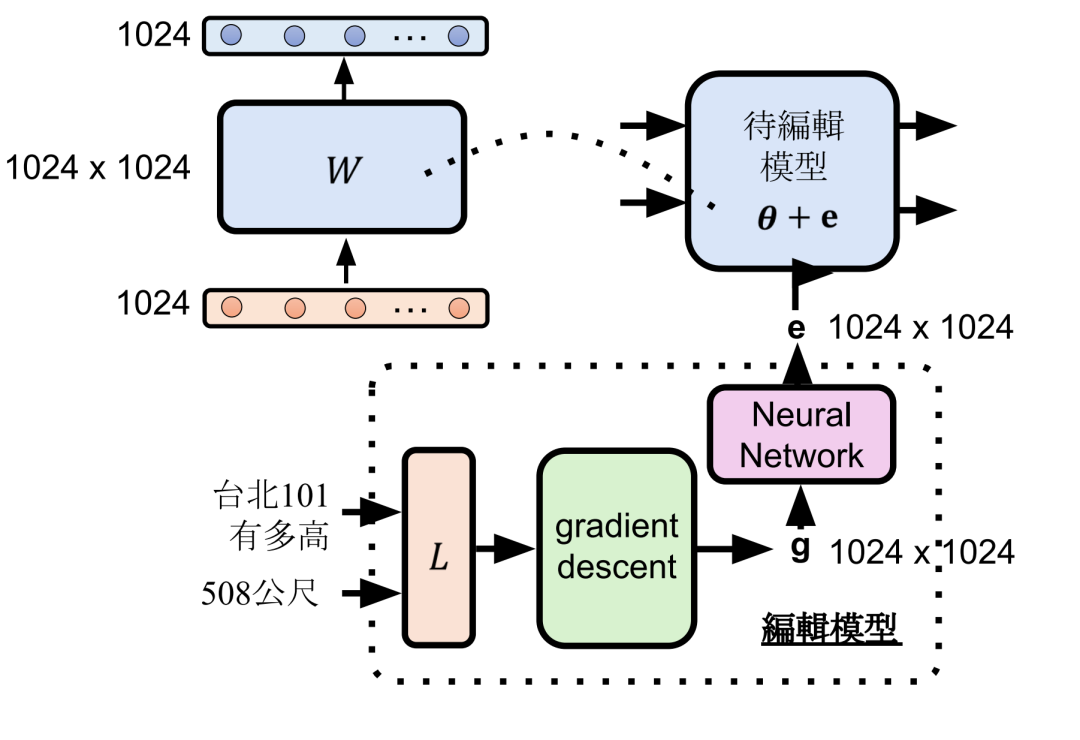
图片

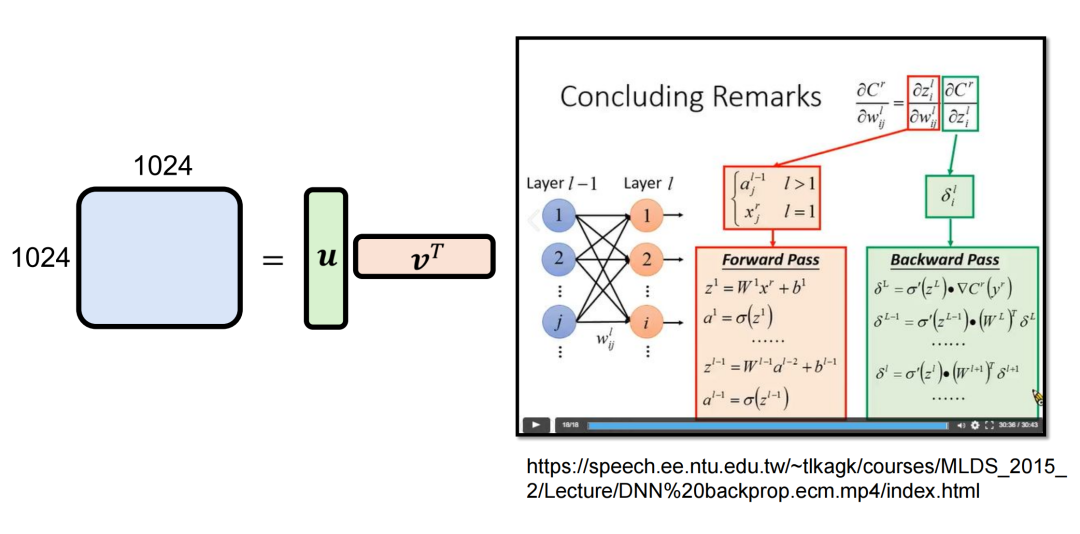
有一个方法叫MEND,它发现可以利用 gradient descent 的特性,将gradient分解为2个向量的乘积,降低Hypernetwork的复杂度。首先将 gradient descent分解成向量u 和 向量v的转置,再将他们分别输入一个neural network,得到 u hat 和 v hat 的转置。将u hat 乘上 v hat 的转置,得到一个新的 matrix,用这个matrix 当作 e 来更新待编辑模型的參數。因为这个neural network 的输入和输出维度比较小,更容易训练。
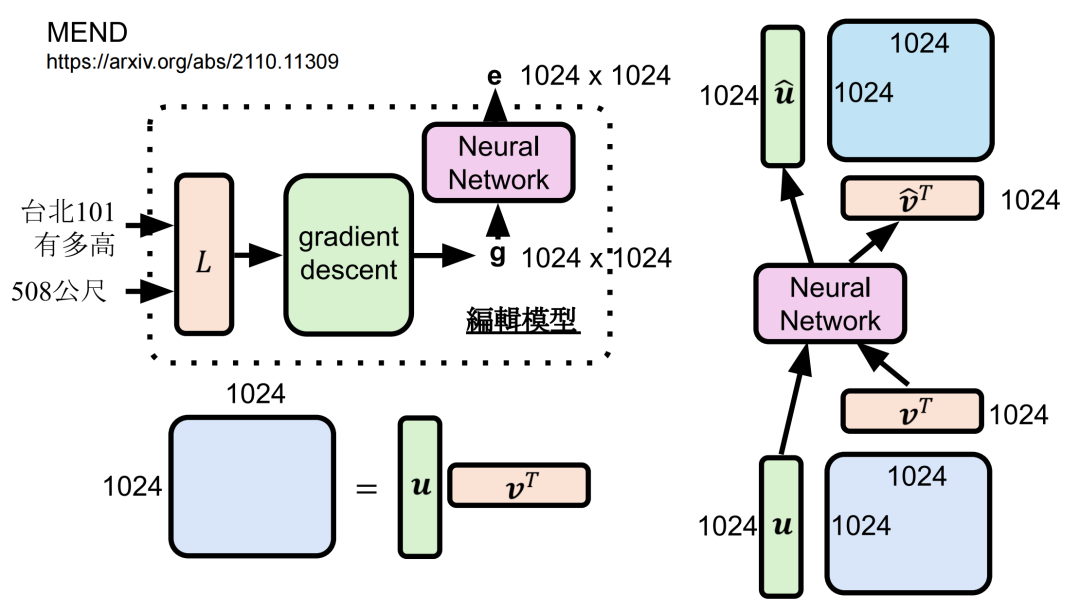
图片

至于为什么gradient descent 可以分解成2个向量的乘积呢,可以看2015年的课程。
图片

在这里插入图片描述

普通人如何抓住AI大模型的风口?

领取方式在文末

为什么要学习大模型?

目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。

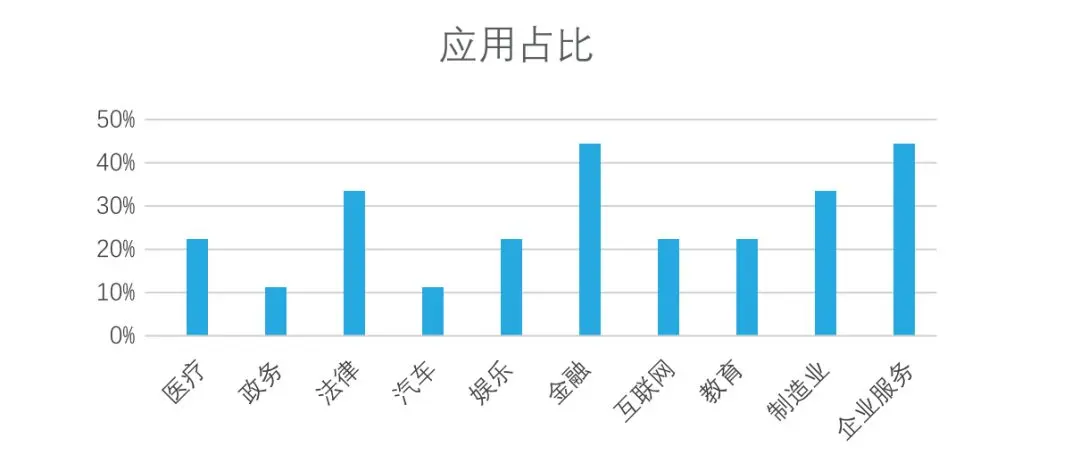
目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。
在这里插入图片描述

随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

在这里插入图片描述

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!

最后

只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!

在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
在这里插入图片描述

大模型全套学习资料展示

自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

图片

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!

01 教学内容
图片

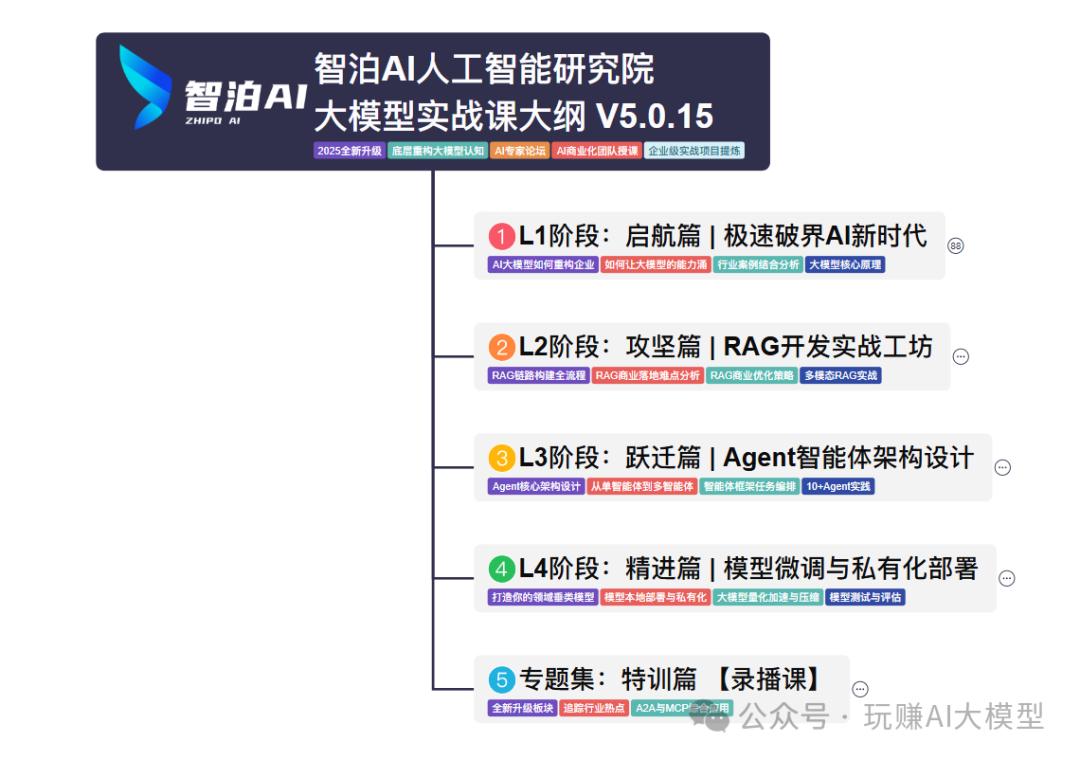
  • 从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!

  • 大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事‌!

02适学人群

应届毕业生‌: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。

零基础转型‌: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界‌。

业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型‌。

image.png

vx扫描下方二维码即可
在这里插入图片描述

本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!

03 入门到进阶学习路线图

大模型学习路线图,整体分为5个大的阶段:

图片

04 视频和书籍PDF合集

图片

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

图片

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

图片

05 行业报告+白皮书合集

收集70+报告与白皮书,了解行业最新动态!
图片

06 90+份面试题/经验

AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)图片

在这里插入图片描述

07 deepseek部署包+技巧大全

在这里插入图片描述

由于篇幅有限

只展示部分资料

并且还在持续更新中…

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

在这里插入图片描述

从‘静态拍照’到‘动态录像’:用Malmquist指数讲好你的效率变化故事(附Stata/R代码) 本文深入探讨了如何利用Malmquist指数构建动态效率分析框架,从静态数据到动态叙事的转变。通过分解技术效率变化(EC)和技术进步(TC),结合Stata/R代码实现四种动态可视化方法,帮助研究者更直观地展示效率变化的动态特征。文章还提供了诊断性叙事结构和比较叙事技巧,助力决策者理解效率提升的来源与趋势。 阅读详情

相关推荐

ADS软件操作(10)——DAC控件使用

该控件可以用于为元件定义随频率变换的参数,如放大器的最佳负载阻抗或者源阻抗,需要双频匹配时的优化等,下图是ADS中该控件的模型。

Zhuanzhuyan的博客 4413

跟着台大李宏毅老师学:模型编辑

Model Editing(模型编辑)是给模型植入一项知识,目的是更新已有的知识(比如美国总统是谁)、学习新知识。

m0_59235245的博客 1211

URP Shader编程之自定义后处理单pass渲染(URP 14.x)

❌ 不要在里拿✅ 只在里拿RendererFeature 生命周期RTHandle 设计Blitter 的真实语义Shader 输入来源。

qq1342753906的博客 609

李宏毅LLM——大模型+大资料的神奇力量

对应视频P12-P14。

lalala12ll的博客 1170

解决 NLPIR (中科院分词) License 过期问题

因为学习需要,使用到了中文分词技术,网上搜索一番,最终选择了名气比较大的中科院分词器(NLPIR/ICTCLAS)。 用了几个月之后突然报错: E:\code\URLClassifier\Data\NLPIR.user Not valid license or your license expired! Please feel free to contact pipy_zhan

勇敢向前冲 1万+

5.2 自抗扰控制 (ADRC)

自抗扰控制(Active Disturbance Rejection Control, ADRC)是由韩京清研究员于1998年提出的一种不依赖被控对象精确数学模型的新型控制技术[reference:0]。其核心思想是将系统的模型不确定性、内部参数摄动以及外部负载变化等所有影响统一定义为“总扰动”,通过一个名为扩张状态观测器(ESO)的环节对其进行实时估计并主动补偿,从而实现动态解耦和强鲁棒性。

技术工作者 1178

LLM大模型-李宏毅

大模型基础知识

一去不复返的通信er 1918

LRTimelapse Pro v7.0.0 激活版下载安装教程 (延迟摄影后期渲染)

LRTimelapse Pro 是一款优秀的高级延时摄影解决方案,使用将为用户提供最全面的工具和功能,从导入和组织您的延时摄影序列、视觉工作流程、在 LRTimelapse 中直接编辑和渲染、视觉去闪烁等等,功能齐全,可以使用 LRTimelapse Pro 编辑多个序列时显著提高您的效率,轻松在 LRTimelapse 中配置和使用色彩管理,进行长期延时编辑,在 LRTimelapse Pro 中使用长期工作流程。为延时编辑、关键帧、分级和渲染提供最全面的解决方案。

wyqshusan的博客 3467

大模型入门篇-李宏毅generative ai课程

看李宏毅老师的生成式人工智能课程有感而发的笔记。

xhhgffd的博客 4722

Android双目摄像头(RGB+IR)实时预览与人脸活体检测实战指南

本文详细介绍了Android双目摄像头(RGB+IR)实时预览与人脸活体检测的实战指南。通过双摄同步预览、人脸检测与活体判断等技术实现,提升安全认证的准确性和鲁棒性。文章还提供了开发环境搭建、常见问题解决方案及性能优化建议,帮助开发者快速掌握双目摄像头在Android平台的应用。

vulkan6gpu的博客 700

提示词驱动的多智能体协作系统

《提示词驱动的多智能体协作系统》 关键词:人工智能、多智能体系统、协作机制、提示词驱动、系统设计与应用 摘要:本文深入探讨提示词驱动的多智能体协作系统,首先介绍其背景和核心概念,然后详细分析多智能体系统的基本原理和提示词驱动的协作机制,最

AI天才研究院 853

2023春季李宏毅机器学习笔记 04 :大模型+大资料 = 神奇结果?

> 资料 课程主页:https://speech.ee.ntu.edu.tw/~hylee/ml/2023-spring.php Github:https://github.com/Fafa-DL/Lhy_Machine_Learning B站课程:https://space.bilibili.com/253734135/channel/collectiondetail?sid=2014800

女王の专属领地 851

Codex入门19-数据库操作(解放双手:用自然语言写SQL、建表和数据迁移)

写 SQL 是后端开发的日常,但复杂的 JOIN、子查询、窗口函数总让人头疼。本文教你用 Codex CLI 实现:自然语言直接生成 CREATE TABLE、复杂 SQL 查询、数据库迁移脚本(Prisma/Knex/Alembic)、ORM 模型代码(SQLAlchemy/TypeORM)、甚至自动生成数据库文档。重点强调安全红线——永远不要让 AI 直接连接生产数据库。从需求描述到完整数据库层代码,一篇搞定。

yueyeguzhuo的专栏 234

【李宏毅机器学习2025春】笔记——8.模型编辑(Model Editing)

本文介绍了模型编辑(Model Editing)的概念、评估维度和常见方法。与后训练(Post-training)不同,模型编辑旨在植入特定知识而非培养技能。评估包括可靠性(Reliability)、泛化性(Generalization)和局部性(Locality)三个维度。方法分为不修改参数(如IKE上下文编辑)和修改参数两类,后者又包括人工决定编辑(如ROME定位修改)和AI学习编辑(如Hypernetwork和MEND优化梯度)。这些方法通过不同方式实现对模型知识的精确更新,同时保持其他知识的稳定性。

RichardSchoolbag的博客 980

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

大模型必知干货:靠这篇搞懂AI Agent原理!

那 AI Agent 具体是怎么工作的呢?目标:人类给的终点,比如「赢一盘围棋」。观察:AI 感知到的当前情况,比如「棋盘上黑白子的位置」。行动:AI 根据观察决定做啥,比如「在第 5 行第 7 列落子」。环境变化:行动引发的结果,比如「对手回了一步」。循环:不断观察、行动,直到目标达成。举个例子,AlphaGo 就是个经典的 AI Agent。它的目标是「赢棋」,观察是「当前棋盘状态」,行动是「落子」,然后对手回应,它再观察、再行动。这个循环听起来是不是很像我们人类解决问题的方式?

2401_85373691的博客 1345

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

大模型之模型编辑

让所有人都可以全面理解模型编辑 简介-->经典方法-->附加参数法-->定位编辑法-->应用

qzhqbb的博客 2434

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

李宏毅机器学习2023:大语言模型——人类对它的两种期待

人们对于大型语言模型的期望可以分为两种:成为专家和成为通才。Finetune和Prompt是实现这两种期望的常用技术,而Adapter技术则是一种更加高效的方式——加外挂,可以帮助大型语言模型用更低的成本,更好地适应不同的任务,成为真正的通才

fantastick99的博客 817

论文阅读:Editing Large Language Models: Problems, Methods, and Opportunities

由于大语言模型(LLM)中可能存在一些过时的、不适当的和错误的信息,所以有必要纠正模型中的相关信息。如何高效地修改模型中的相关信息而不影响无关的信息,是模型编辑方法试图解决的问题。本篇文章对大语言模型上的模型编辑方法(model editing)进行了分类介绍和评估,并提出了一个新的基准,包括评估数据集和评估标准。

huzimu_的博客 1197

李宏毅【LLM大模型】教程核心内容总结

【李宏毅】2024年公认最好的【LLM大模型】教程!大模型入门到进阶,一套全解决!2024生成式人工智慧-附带课件代码_哔哩哔哩_bilibili【李宏毅】2024年公认最好的【LLM大模型】教程!大模型入门到进阶,一套全解决!2024生成式人工智慧-附带课件代码共计41条视频,包括:1.第0讲:课程说明、2.第1讲:生成式AI是什么、3.(延申)80分钟快速了解大型语言模型等,UP主更多精彩视频,请关注UP账号。

akiakiapple的博客 1422

李宏毅LLM大模型——自学笔记(第1讲)

中文常用字的个数是有限的,我们只要在文字库中找到合适的文字,再将这个文字放在原本问题后面,找到下一个合适的单词,循环下去,直至机器觉得没什么好输出了,就输出结束的符号。再输入一个没见过的x给函式,函式推测出y的值,这叫做测试。找到参数后,把参数代入到函式中,就知道函数长什么样,再输入一张新的图片给函式,看函式推测出什么,这叫做。通过不断输入猫和狗的图片,同时输入图片的标注,机器学习就可以把上万个参数找出来。原本在做生成式AI时,认为是一个很难的问题,因为一段100字的句子是无法穷尽的。

qq_61251579的博客 916

【LLM GPT】李宏毅大型语言模型课程

gpt的讲解

学渣的博客 3007

哈工大SCIR 13篇长文被ACL 2023主会/Findings录用

来自:哈工大SCIR进NLP群—>加入NLP交流群ACL2023将于2023年7月9-14日在加拿大多伦多举行。ACL年会是计算语言学和自然语言处理领域最重要的顶级国际会议,CCF A类会议,由计算语言学协会主办,每年举办一次。其接收的论文覆盖了对话交互系统、语义分析、摘要生成、信息抽取、问答系统、文本挖掘、机器翻译、语篇语用学、情感分析和意见挖掘、社会计算等自然语言处理领域众多研究方向...

zenRRan的博客 3524

李宏毅-2023春机器学习 ML2023 SPRING-学习笔记:3/17 大模型+大资料=神奇结果?

由于过于庞大,结构与一般的transformer有所差异,大模型中包含许多模组,每次执行任务时只调用部分模组(训练所有的参数,但使用时只使用部分参数,为了节省inference的资源)结论:大模型在输出不确定的答案时会不自信(知道自己不知道答案),小模型不太受影响。总所周知,大体量的模型+大量的数据,会得到更好的模型,可是原因是什么呢?横轴:LM输出的下一个字的概率(是模型选择的输出,不一定正确)不同颜色代表不同大小的模型(黄色代表的模型最大),1.6T(PaLM的3倍,GPT3的10倍)

Transfattyacids的博客 819

编辑一切知识!大模型编辑新范式AnyEdit,有效突破知识边界

得益于这一机制,AnyEdit 能够简单有效地实现知识编辑长度的自适应(动态确定所需编辑的令牌数量),并且通用性强,能够高效支持代码、诗歌、数学推导等多样化的任意形式知识编辑任务,从而突破了传统单令牌编辑方法的效能瓶颈。现有模型编辑方法面临的核心问题在于单令牌编辑的效能壁垒:长文本知识通常包含多个关键令牌,且隐状态之间存在复杂的依赖关系,仅通过修改单个令牌隐状态(如图 1(a)中的步骤 2)难以保证整体知识的完整性与一致性。换言之,单令牌编辑引起的低概率偏移成为有效更新长文本知识的内在限制。

Paper weekly 1407

推荐文章:MEND——模型编辑网络,开启高效模型微调新时代!

推荐文章:MEND——模型编辑网络,开启高效模型微调新时代! 项目介绍 MEND,即Model Editing Networks using Gradient Decomposition(使用梯度分解的模型编辑网络),是一个革命性的开源项目。由斯坦福大学的研究团队开发,该工具旨在快速、精准地对预训练模型进行编辑,以适应特定任务或纠正错误。尤其针对自然语言处理领域的模型,如GPT-2和BERT,ME...

gitblog_00379的博客 709

让我们来给大模型做个手术~ | 借助EasyEdit库使用KN方法编辑ChatGLM2大模型

人工智能中的LLM火遍全网,渗透到我们生活的各个领域。大模型(下称LLMs)的缺点却也更加明显,如LLMs知识的滞后性、LLMs可能存在的“幻觉”等问题。模型编辑(Model Editing)应运而生,在LLMs纠错、LLMs数据更新等方向都有一定启发。本文,我们将借助EasyEdit库,使用经典的Knowledge Neurons方法对ChatGLM2进行知识编辑,初步认识模型编辑。

weixin_45841983的博客 890
上一篇: Dify本地部署实战:3分钟搭建基于Chrome的网页自动化AI助手
下一篇: 基于LLM构建知识图谱,打造高精度RAG系统:完整技术路径解析
不秃头de程序猿
博客等级 码龄5年 4091粉丝 1479原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值