大模型知识蒸馏全解析:从理论原理到实际应用

大模型接触(一)——模型蒸馏 模型蒸馏的原理、训练方法、算法、应用场景概述 阅读详情

当下人工智能飞速发展,大模型展现出了令人惊叹的能力。像 GPT-4 等模型,凭借庞大的参数规模,在自然语言处理等众多领域有着出色的表现。但它们就像体型庞大的巨人,虽力量强大,却因计算成本高、部署难度大等问题,难以在资源有限的场景中施展拳脚。

知识蒸馏技术的出现,就像是一把神奇的钥匙——将大模型(教师模型)的“智慧”压缩到小模型(学生模型)中,让小模型在低资源环境下也能拥有接近大模型的能力。今天,我们就从原理、案例到未来,全面拆解这一技术。

一、知识蒸馏是什么?
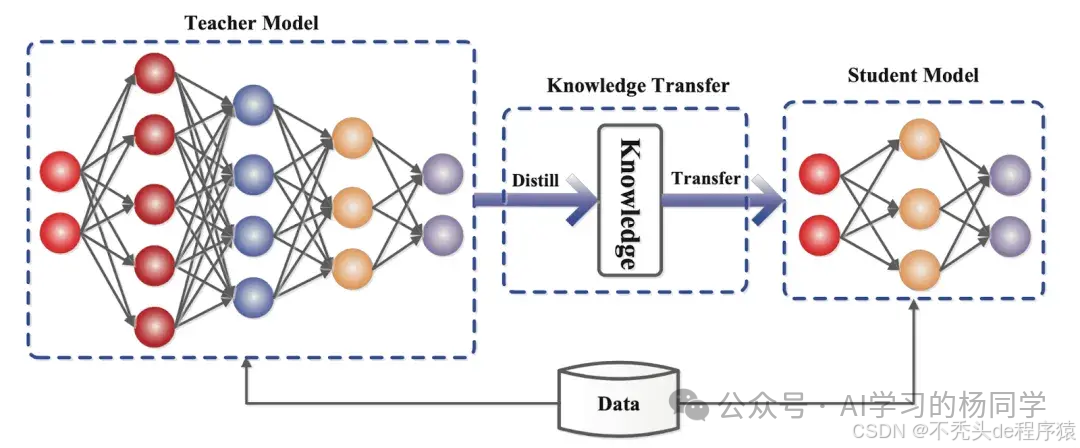
在这里插入图片描述

知识蒸馏,本质是模型压缩技术的一种:通过“迁移”大模型(教师模型)的知识,让小模型(学生模型)在参数量、计算量大幅减少的前提下,保持与大模型接近的性能。

打个比方:教师模型是深耕某领域的专家,学生模型是刚入门的新人。蒸馏就是让专家把“隐性经验”(不仅是标准答案,还有对问题的思考逻辑、类别关联等)传递给新人,让新人快速具备解决复杂问题的能力。

核心价值:解决大模型“部署难”问题——比如手机、边缘设备(如智能家居传感器)无法运行千亿参数模型,但蒸馏后的小模型(如几亿参数)可轻松部署,同时兼顾性能与效率。

二、知识蒸馏的工作原理

蒸馏的核心是“让学生学懂教师的思考方式”,而非仅记住“标准答案”。具体通过三个关键步骤实现:

(一)软目标生成:让教师“暴露思考细节”

传统模型训练中,模型输出是“硬目标”——比如识别猫的图片,输出“猫(98%),其他(2%)”,只体现最终答案。但教师模型的价值远不止于此:它对“哪些类别可能相似”“为什么排除其他类别”有隐性判断,这些需要通过“软目标”传递。

软目标生成方法:高温Softmax
Softmax是模型输出概率分布的常用函数,公式:
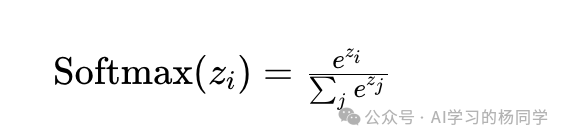
图片

其中z_i是模型对第i类的原始输出(logit)。

若引入“温度T”,温度越高,概率分布越‘平均’,就像教师把知识点讲得更细, 公式变为:
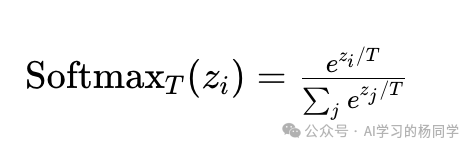
图片

•当T=1时,就是普通Softmax(硬目标),概率分布集中在少数类别;
•当T>1时(如T=10),分布变得“平滑”——原本概率低的类别也会有一定占比,这就是“软目标”。

举例:识别“狸花猫”图片:

•硬目标(T=1):狸花猫(95%),虎斑猫(3%),其他(2%);
•软目标(T=10):狸花猫(60%),虎斑猫(25%),橘猫(10%),其他(5%)。

软目标中,“狸花猫与虎斑猫相似”“与橘猫有一定关联”的隐性知识被暴露,学生模型能学到“类别关联”,而非仅记住“狸花猫”这个答案。

(二)目标函数设计:平衡“学经验”与“记答案”

学生模型需要同时学习“教师的软目标”(经验)和“真实标签的硬目标”(标准答案),因此损失函数需两者结合:
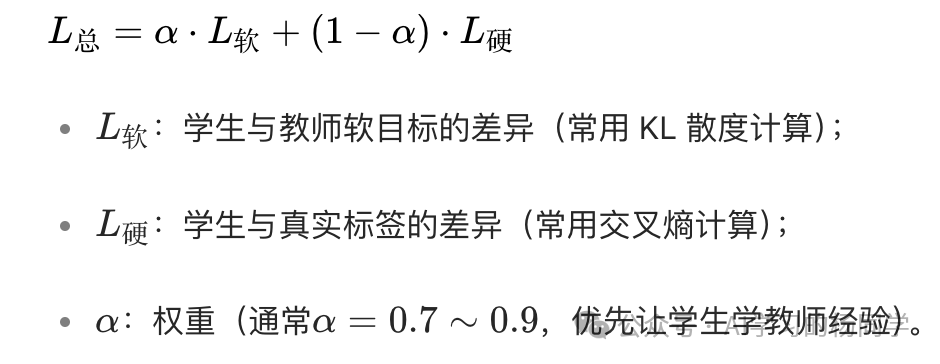
图片

作用:避免学生“只模仿教师错误”(若教师偶尔判断失误),同时通过硬目标保证基础准确率。比如在医疗影像识别中,å可设低些(如0.6),优先保证对“病变/正常”的硬目标学习,再通过软目标学“不同病变的相似特征”。

(三)温度参数的动态调节:控制“学习难度”

温度T是蒸馏的“关键旋钮”:

•T越高:软目标越模糊,适合学“类别关联”(如区分不同品种的猫);
•T越低:软目标越接近硬目标,适合学“精准判断”(如区分猫和狗)。

实际训练中,常采用动态调节策略:

•初期T=10:让学生广泛吸收教师的“全局经验”;
•后期T=2~3:聚焦关键特征,提升准确率。

就像教新人:先讲“领域框架”(模糊但全面),再练“具体技巧”(精准且聚焦)。

三、知识蒸馏的典型案例

蒸馏技术已在多个领域落地,以下三个案例能直观看到其“降本增效”的价值:

(一)DeepSeek-R1:7B模型干出670B的活

DeepSeek团队2024年发布的DeepSeek-R1,是蒸馏技术的典型代表:

•教师模型:670B参数的大模型(需多卡GPU运行);
•学生模型:7B参数的小模型(单卡GPU即可运行);
•蒸馏方法:结合强化学习(RLHF)与蒸馏,让学生不仅学教师的输出,还学“决策逻辑”。

实测效果:
•在语言生成任务(如写代码、问答)中,7B学生模型的性能超越同规模传统模型15%,接近OpenAI的o1-mini(13B参数);
•推理速度比教师模型快8倍,部署成本降低90%。

价值:让中小公司也能用上接近大模型性能的模型,无需承担千亿参数模型的算力成本。

(二)手机端翻译:小模型实现“离线实时翻译”

谷歌翻译APP的“离线模式”就用到了蒸馏技术:

•教师模型:云端千亿参数的翻译大模型(支持100+语言,准确率95%);
•学生模型:手机端部署的小模型(仅200MB,支持30+常用语言);

•蒸馏优化:重点传递“语言语法关联”“一词多义判断”等软目标。

实测效果:
•学生模型翻译准确率比未蒸馏的小模型高12%(接近教师模型的90%);
•响应速度从云端调用的500ms缩短至本地的100ms,无网络也能使用。

(三)边缘设备:智能家居语音助手的“本地思考”

传统智能家居语音助手(如智能音箱)需把语音传到云端大模型识别,存在延迟和隐私风险。蒸馏技术让“本地识别”成为可能:

•教师模型:云端大模型(识别准确率98%,需10GB显存);

•学生模型:设备端小模型(仅50MB,运行在嵌入式芯片上);

•蒸馏优化:针对“家居场景高频指令”(如“开灯”“调温度”)强化学习,忽略低频复杂指令。

实测效果:
•本地识别准确率92%(满足日常需求),响应延迟从1s降至0.2s;
•无需上传语音数据,隐私安全性提升。

四、知识蒸馏技术的发展与未来演进

目前蒸馏技术已从“单一模型迁移”走向“多场景优化”,未来有三个关键方向值得关注:

(一)技术改进:从“学输出”到“学推理”

  1. 蒸馏“中间过程”而非仅“最终输出”

传统蒸馏只学教师的最终概率分布,未来可学“中间层特征”——比如教师模型处理文本时,某层关注“语义逻辑”,某层关注“情感倾向”,让学生模型分层模仿,提升复杂任务性能。

  1. 多教师蒸馏

单一教师可能存在偏见(如训练数据偏差),未来可让学生同时学习多个教师模型(如GPT-4、LLaMA 3),通过“融合多教师经验”提升鲁棒性。已有研究显示,多教师蒸馏比单教师蒸馏准确率提升5%~8%。

  1. 动态蒸馏策略

根据学生模型的“学习进度”自动调节温度T、损失权重å——比如学生初期对某类任务(如翻译)误差大,就提高T让教师多传递该类经验;后期误差小,就降低T聚焦精准性。

(二)应用拓展:从“通用场景”到“垂直领域”

  1. 医疗:便携设备上的精准诊断

将医院的大型医疗影像模型(如CT识别)蒸馏到便携设备(如手持超声仪),让基层医生实时获取诊断建议。目前某医疗AI公司已实现:蒸馏后的小模型在肺部结节识别上准确率91%(接近大模型的93%),设备成本降低70%。

  1. 自动驾驶:车载芯片的快速决策

自动驾驶汽车的车载芯片算力有限,无法运行云端的千亿参数感知模型。蒸馏技术可将模型压缩至“车载级”——比如某车企实测:蒸馏后的小模型对“行人横穿马路”的识别响应时间从200ms降至50ms,满足实时决策需求。

  1. 工业边缘:传感器的本地预警

工业传感器(如机床振动传感器)需实时判断设备是否故障,蒸馏后的小模型可在传感器本地运行,无需上传数据到云端,预警延迟从10s降至0.5s,减少故障损失。

总结

知识蒸馏技术的核心价值,是**“让AI能力下沉”**——打破“大模型只能在云端运行”的限制,让小设备也能拥有智能。其本质是“知识迁移”:通过高温Softmax、复合损失函数等设计,让小模型不仅学“答案”,更学“思考方式”。

从案例来看,无论是手机翻译、智能家居还是医疗设备,蒸馏都已展现出“降本增效”的硬实力;未来随着“多教师蒸馏”“动态策略”等技术的成熟,它还将在更多垂直领域落地。

一点建议:

1.从开源项目入手实践(如Hugging Face的Transformers库有蒸馏工具);
2.重点理解“软目标为何比硬目标更有价值”——这是蒸馏的核心逻辑;
3.关注垂直领域的蒸馏优化(如医疗、工业),这些场景对“小模型+高性能”需求更迫切,机会也更多。

对比维度大模型知识蒸馏大模型微调
核心目标让小模型(学生)学习大模型(教师)的知识,在减小模型规模的同时保留核心性能,实现轻量化部署。在预训练模型基础上,通过目标任务数据调整参数,使模型适配特定任务(如文本分类、翻译等),提升任务性能。
数据集依赖- 主要依赖软标签数据集(由教师模型对数据生成的概率分布,含置信度信息); - 可辅助使用少量硬标签数据(标注数据),用于约束学生模型输出的正确性。- 主要依赖硬标签数据集(人工标注的输入 - 输出对,如文本 + 分类标签、句子 + 翻译结果); - 无需教师模型生成的软标签,直接以任务标注数据为监督信号。
全参数微调较少使用,因学生模型通常规模较小,全参数微调易过拟合;仅在学生模型规模较大且数据充足时考虑。常用方式,尤其当目标任务与预训练任务差异大时,通过更新全部参数让模型充分适配任务(需充足数据和计算资源)。
LoRA 微调适用场景:学生模型为预训练小模型,需在本地任务上结合教师知识优化,且资源有限(如边缘设备)。 优势:仅训练低秩矩阵,降低计算成本,避免过拟合。适用场景:大模型适配特定任务,需平衡性能与资源(如显存有限)。 优势:冻结主模型参数,仅训练少量新增参数,高效且易迁移。
QLoRA 微调较少直接用于知识蒸馏核心过程,但若学生模型为量化小模型(如 4bit/8bit),可结合 QLoRA 进一步压缩并微调。常用于大模型量化场景(如将 16bit 模型量化为 4bit),在资源极有限时(如单 GPU)实现高效微调,兼顾性能与成本。
教师模型依赖强依赖:需教师模型生成软标签、中间特征等知识,是蒸馏的 “知识来源”。无依赖:仅基于目标任务数据微调,无需其他模型提供知识。
模型规模变化学生模型规模通常小于教师模型(核心是 “压缩”),也可与教师同规模但更高效(如减少冗余参数)。模型规模不变(微调不改变模型结构和参数量),仅优化参数适配任务。
典型应用场景边缘设备部署(如手机、嵌入式设备)、低延迟任务(如实时语音识别)、资源受限场景(如小显存服务器)。特定领域适配(如医学文本分析、法律文档检索)、任务性能提升(如提高翻译准确率、分类精度)。

普通人如何抓住AI大模型的风口?

领取方式在文末

为什么要学习大模型?

目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。

目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。

在这里插入图片描述

随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

在这里插入图片描述

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!

最后

只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!

在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

在这里插入图片描述

大模型全套学习资料展示

自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

图片

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!

01 教学内容

图片

  • 从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!

  • 大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事‌!

02适学人群

应届毕业生‌: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。

零基础转型‌: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界‌。

业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型‌。

image.png

vx扫描下方二维码即可
在这里插入图片描述

本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!

03 入门到进阶学习路线图

大模型学习路线图,整体分为5个大的阶段:

图片

04 视频和书籍PDF合集

图片

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

图片

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

图片

05 行业报告+白皮书合集

收集70+报告与白皮书,了解行业最新动态!
图片

06 90+份面试题/经验

AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)图片

在这里插入图片描述

07 deepseek部署包+技巧大全

在这里插入图片描述

由于篇幅有限

只展示部分资料

并且还在持续更新中…

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

在这里插入图片描述

浅谈大模型“蒸馏”技术 大模型蒸馏技术是人工智能领域的一项重要创新,它通过知识迁移实现了大模型能力向小模型的有效传递。尽管目前仍存在一些挑战,但随着研究的深入和技术的进步,蒸馏技术将在更广泛的领域发挥重要作用。未来,结合自适应、联邦和集成等策略,蒸馏技术有望进一步优化性能和效率,推动AI技术的普及和应用。利用蒸馏技术:通过教师-学生模型架构、分层蒸馏方法以及动态调整策略来优化模型性能与资源消耗。算法优化与硬件加速:研究高效算法并利用专用硬件加速AI推理过程。能量平衡与工艺优化:在工业应用中通过能量平衡计算优化蒸馏过程。 阅读详情

相关推荐

大模型 - 知识蒸馏原理解析

知识蒸馏通过教师模型提供的软标签引导学生模型,使得学生模型不仅关注硬标签的分类准确性,还能从软标签中学习更丰富的类别间关系,从而在模型压缩的同时尽量保留性能。这种方法特别适用于在资源受限的环境中部署高效的深度学习模型。

weixin_47552266的博客 4830

万字长文详解大模型知识蒸馏指南

模型蒸馏即知识蒸馏(Knowledge Distillation),是一种模型压缩和加速技术。在深度学习中,大型深度神经网络虽性能优异,但因计算复杂度高、存储需求大,难以部署在资源受限设备上。模型蒸馏通过构建师生架构,让小的学生模型学习大的教师模型的知识,使学生模型在保持较小规模的同时,尽可能接近教师模型的性能。其核心组件包括知识(如教师模型的 logits、中间层特征等)、蒸馏算法(用于指导知识转移)和师生架构(决定知识传递方式)。

2401_85325726的博客 7742

AI:大模型蒸馏全解析

模型蒸馏(Knowledge Distillation),通过教师模型(Teacher)训练学生模型(Student),让后者学习前者的知识、思维方式、输出风格,从而获得“以小博大”的能力。

Kant2048的博客 1621

史上最全模型蒸馏全解:一步一步带你走向模型蒸馏全流程

模型蒸馏简单来说,就是将一个大模型(比如BERT)的权重,通过一定规则,压缩到小模型(比如RoBERTa)的权重中。 蒸馏其实特别形象,就像把一杯饱和盐水蒸馏成纯净水一样,质量减少了效果却没有多大变化。在大模型(LLM)领域,模型的发展趋势是参数量不断增大。因为模型的性能和模型的规模是正相关的。 从2017年到2024年,LLM的参数数量经历了指数级增长: 2017年,Transformer模型的参数量为0.05亿。 2018年,GPT模型的参数量为0.11亿,BERT模型为0.34亿。 2020年,GPT

2302_80236633的博客 2万+

大模型压缩三剑客:量化、剪枝与知识蒸馏全解析

量化是将模型参数从高精度浮点数(如 FP32)转换为低精度表示(如 FP16、INT8、INT4)的技术。📌 举例:原本每个参数用 4 字节(FP32),量化后仅需 0.5 字节(INT4),模型体积缩小 8 倍!剪枝通过识别并移除神经网络中“不重要”的连接或结构,使模型变得更稀疏、更轻量。🔍 研究表明:大模型中大量参数对最终输出影响微弱,可安全移除。让一个小型“学生模型”学习大型“教师模型”的输出行为,而不仅仅是学习原始标签。

1493

大模型知识蒸馏(Qwen2.5系列模型KL散度蒸馏)

结合公式来看,当p增大时,为了使得kl散度小,则q也需要增大,但是当p趋于0时,无论q取任何值,kl散度都比较小,因为此时p(x)log((p(x)/q(x)))的大小主要受p(x)控制,这样起不到优化q分布的效果,可能会使q分布高估p分布中概率低的位置。p为教师模型的概率分布,q为学生模型的概率分布,当p趋于零时,为了使kl散度小,q也需趋于0。将待压缩的模型作为教师模型,将体积更小的模型作为学生模型,让学生模型在教师模型的监督下进行优化,将学生模型学习到教师模型的概率分布,然后通过。

谢白羽 1893

大模型知识蒸馏技术全解析:原理、应用及未来趋势一网打尽

知识蒸馏是一种模型压缩技术,通过将大模型(教师模型)的知识迁移到小模型(学生模型),让小模型在保持性能的同时大幅降低计算成本和部署难度。核心原理包括软目标生成(通过高温Softmax暴露教师模型的隐性知识)、目标函数设计(平衡软硬目标)和温度参数动态调节(控制学习难度)。典型案例包括DeepSeek-R1小模型、手机端翻译和边缘设备语音助手,展现了显著的降本增效价值。未来发展方向包括多教师蒸馏、动态策略和垂直领域应用(如医疗、自动驾驶等)。该技术打破了AI能力受限于云端大模型的困境,让资源受限的设备也能实现

m0_74942241的博客 1190

AI大模型蒸馏的技术原理、实现与未来展望

在AI模型规模指数级增长的今天,GPT-4、PaLM等千亿参数大模型虽然展现出惊人的能力,但其巨大的计算需求和部署成本严重制约了实际应用。模型蒸馏(Knowledge Distillation)作为解决这一矛盾的关键技术,通过将大模型(教师模型)的知识迁移到小模型(学生模型),在保持性能的同时显著降低计算成本。蒸馏技术由Hinton团队于2015年首次提出,其核心思想是通过「软化」的类别概率分布(Soft Targets)传递教师模型的暗知识(Dark Knowledge)。

Sweetie_Kiss的博客 2056

深度解析大模型蒸馏方法:原理、差异与案例

让小模型(Student Model)学习大模型(Teacher Model)提供的知识。通过不同方式的知识迁移,确保小模型可以在大幅减少参数量的情况下保持较高的性能。想象一下,你是一名大学教授(Teacher),你有一位聪明但精力有限的学生(Student)。直接给他答案(Logit 蒸馏)告诉他每一步的解题思路(Feature 蒸馏)训练他通过问题之间的联系推理答案(Relation 蒸馏)接下来,我们将具体剖析这些方法。

赵大仁的博客 1461

【大模型】大模型的黑盒蒸馏与白盒蒸馏

在模型压缩的过程中,我们将待压缩的模型设定为教师模型,选取体积更为小巧的模型作为学生模型。在训练阶段,学生模型处于教师模型的监督之下逐步优化。教师模型对输入数据进行处理后,会产生特定的概率分布,学生模型则致力于学习并逼近这一概率分布。而二者概率分布之间的差异,通过KL散度这一指标进行精准度量与有效控制,以此确保学生模型在学习过程中能够最大程度地汲取教师模型的知识,同时维持自身简洁高效的特性。对于大模型的知识蒸馏,主要分为黑盒蒸馏与白盒蒸馏两种。

Dong_ZH的博客 1417

Dr_can Kalman Filter学习笔记(一)

本文是在b站Dr_can的卡尔曼滤波课程学习过程中的学习笔记

苏大侠的博客 1051

大模型蒸馏终极揭秘!原理+实战+效果全解析,从入门到精通一篇通,收藏这篇就够了!

大模型蒸馏(Model Distillation)是一种**知识迁移技术**,旨在将一个大型、复杂、高性能的“教师模型”(Teacher Model)的知识,迁移到一个更小、更高效、更适合部署的“学生模型”(Student Model)中。其核心思想是**让学生模型学习教师模型的“行为模式”而非仅仅学习原始数据标签**,从而在保持较高性能的同时大幅降低计算和存储成本。

m0_59235245的博客 2050

小龙虾 OpenClaw 安装全攻略:本地部署 AI 智能体一步到位

OpenClaw(昵称小龙虾)是一款 MIT 开源协议的本地优先 AI 智能体执行网关,支持多平台接入、本地部署,能实现自然语言驱动的设备自动化操作,区别于纯对话 AI,可直接操控系统执行实际任务,数据全程本地存储更安全。本文带来 2026 最新版 OpenClaw 安装教程,适配 Windows/macOS/Linux 全系统,新手也能一键搞定。

lujiawei00的专栏 1975

大模型瘦身秘籍:知识蒸馏全解析

本文论述了知识蒸馏是一种强大的模型压缩技术,通过将大型教师模型知识迁移到小型学生模型,在多领域有重要价值。它利用教师 - 学生模型架构、软目标、温度参数和损失函数实现知识传递。实现方法包括软标签蒸馏、特征蒸馏、注意力蒸馏和多教师蒸馏。​在自然语言处理、计算机视觉和语音识别等场景,知识蒸馏成效显著,如 DistilBERT 在自然语言处理中以小模型规模实现接近 BERT 的性能等。​知识蒸馏优势为模型压缩、提升推理效率和增强可解释性,但也面临知识提取难、性能平衡挑战和架构选择困难等问题。​

紫雾凌寒 1309

硬件工程师学习-硬件的单元测试(UT)(1)电源与时钟的测试

我们在设计的时候,通过控制电源的上电使能管脚或者通过MOSFET、或者专用的电源上电控制芯片,控制不同电源的上电时序,以确保每个芯片的电源上电时序是满足芯片的要求的。我们在测试的时候,需要对相关的要求一一测试,以确认每个上电时序满足要求的。在维基百科中,相位噪声的定义是“时域不稳定性(抖动)导致波形在相位上发生快速、短期、随机的波动,这种波动在频域中的表现即为相位噪声”。单元测试,一般是指基于开发人员自行开展的功能测试及各个功能单元的单元测试,是硬件信号级的测试,分为基本测试和信号完整性测试。

qq_43416206的博客 4034

《C++等级认证CCF-GESP真题解析》专栏总目录

❤️ 专栏名称:《C++等级认证CCF-GESP真题解析》🌸 专栏介绍:中国计算机学会GESP《CCF编程能力等级认证》C++编程(1~8级)历届真题解析。🚀 订阅专栏:订阅后可阅读专栏内所有真题解析,真题持续更新中,欢迎订阅!

人生就是一个不断学习的过程 6288

大模型必知基础知识:11、大模型知识蒸馏原理和过程详解

大模型知识蒸馏是一种将大型教师模型的知识迁移到小型学生模型的技术。本文详细介绍了知识蒸馏的两种主要方式:白盒蒸馏和黑盒蒸馏。白盒蒸馏允许学生访问教师模型的内部参数,通过KL散度优化来对齐输出分布,特别介绍了MiniLLM方法采用反向KLD和策略梯度法优化生成质量。黑盒蒸馏则仅依赖教师模型的输入输出,更具实用性。文章还分析了正向与反向KLD的差异,以及它们在大语言模型生成任务中的应用场景。这些技术能够有效压缩模型规模,同时保持较高性能。

1309

Spatial-ORMLLM: Improve Spatial Relation Understanding in the Operating Room with Multimodal Larg...

手术室(OR)中的精准空间建模是众多临床任务的基础,可为术中感知、风险规避及手术决策提供支持。现有方法虽利用大规模多模态数据集进行 latent 空间对齐,以隐式学习空间关系,但却忽视了多模态大型语言模型(MLLM)的3D能力。然而,这种方法存在两个问题:1)手术室通常缺乏多台视频和音频传感器,多模态3D数据难以获取;2)仅依赖易获取的2D数据训练,无法捕捉复杂场景中的细粒度细节。为解决这一问题,我们提出——首个针对手术室3D空间推理的大型视觉语言模型。

UnknownBody_2的博客 592

大模型低成本落地实践:量化、蒸馏与 QLoRA 全解析

随着大模型的应用不断拓展,企业亟需在保证性能的同时降低部署和推理成本。本文以盘古 5.5、Kimi-K2 和 Qwen3 等大模型为例,系统分析了量化、蒸馏及 QLoRA 技术如何协同降低显存需求和计算开销。通过 4bit 量化、知识蒸馏及低秩微调,企业可在少量 GPU 资源下实现高效推理与定制化应用。文中还介绍了从模型选择、微调到推理优化的完整流程,并给出成本对比,帮助企业以更高性价比实现大模型落地。

weixin_63040022的博客 2223

传统方式部署 Hadoop 高可用集群

传统方式部署 Hadoop 高可用集群

寂夜了无痕的博客 265

人工智能训练师三级考试大纲深度解读|理论+实操分值分布+六大模块占比

三级人工智能训练师考试分为理论和实操两大模块(各100分,合格线60分)。理论考试包含AI基础(30%)、数据标注(25%)、模型训练(20%)、测试(15%)和系统运维(10%),题型为客观题;实操考核侧重数据标注(40%)、模型测试(35%)和系统运维(25%),采用现场操作形式。复习应优先关注AI基础和数据标注等高分值模块,实操需重点掌握标准流程和结果准确性(占评分70%)。考试要求两模块均达标,理论侧重概念理解,实操强调规范执行与文档完整。

白话机器学习 1097

2025年大模型知识蒸馏技术深度解析:从理论到实战的完整指南

2025年的知识蒸馏技术已经从简单的"教师-学生"框架发展为多维度、动态化、任务特定的复杂系统。通过本文介绍的技术和代码,开发者可以在实际项目中实现高效的模型压缩,让大模型技术真正落地到资源受限的场景。掌握知识蒸馏技术,将是2025年AI工程师的核心竞争力之一。参考资料3.2025年大模型部署新突破:推理加速技术全解析4.大模型优化与压缩技术:2025年的实践与突破5.大模型压缩技术详解(2025最新进展)6.DeepSeek展示企业模型蒸馏技术应用机遇有问题欢迎在评论区留言讨论。

qq_66797714的博客 1316

第4章:外包接单全攻略——Upwork/电鸭/猪八戒从0到第一单

> - 三个外包平台的详细对比(适合人群、抽成、防骗) > - 每个平台的Profile优化模板(可直接复制修改) > - 用AI写Proposal的3个Prompt模板(我实测回复率提升50%) > - 报价策略与防骗指南(附5个危险信号) > - 我的第一单复盘:从注册到收款的全过程(含聊天记录脱敏)

sfishfly的博客 575

大模型知识蒸馏:解析原理、谈DeepSeek及服务器适配思路

对于边缘服务器和离线服务器,DeepSeek 小模型更便于部署,可在本地快速处理数据,实现边缘计算和离线计算,为人工智能在更多场景的应用提供了可能,推动人工智能从云端向边缘和本地拓展,让更多设备具备智能处理能力,促进人工智能普及应用。DeepSeek 开源、低成本、轻量化的路线,让开发者能轻松构建或部署本地大模型,免费又安全,降低了垂直行业和领域模型对算力的要求,推动了应用的本地化部署。从服务器层面看,传统大模型严重依赖服务器硬件 GPU,运行成本高,限制了在普通服务器上的应用,增加了企业和开发者的负担。

mike_leeso的博客 1135

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

【知识蒸馏:让小模型拥有大模型能力——原理、实践与代码解析】

随着深度学习模型在计算机视觉、自然语言处理等领域的性能不断突破,“大参数量、高计算成本”与“边缘设备部署、实时推理需求”的矛盾日益突出。知识蒸馏作为模型轻量化的核心技术之一,通过“教师模型(复杂、高精度)→学生模型(简单、高效)”的知识迁移,在大幅降低模型参数量与计算量的同时,保留90%以上的原模型性能。本文从知识蒸馏的核心原理出发,拆解“温度软化”“蒸馏损失”等关键技术,以CIFAR-10图像分类任务为案例,通过PyTorch实现完整蒸馏流程(ResNet152作为教师模型,MobileNetV2作为学生

qq_45832651的博客 1460

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

上一篇: 新手友好|RAG开发框架选择指南:LlamaIndex、GraphRAG、RAGFlow对比分析
下一篇: 实用教程|DeepSeek接入n8n,创建你的专属AI工作流
不秃头de程序猿
博客等级 码龄5年 4089粉丝 1476原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值





