


检索增强生成(Retrieval-Augmented Generation, RAG)是当前AI工程师在实际应用中面临的重要技术挑战之一。从理论角度来看,RAG的工作原理相对直观:从自定义数据源中检索相关上下文,然后基于这些上下文让大语言模型生成对应的回答。在实际部署过程中,开发者往往需要处理大量格式混乱的异构数据,并经历反复的系统调优过程,包括分块策略的优化、嵌入模型的选择、检索器的配置、排序器的微调以及提示工程等多个环节。即便如此,系统仍可能出现信息检索不足或生成虚假信息的问题。
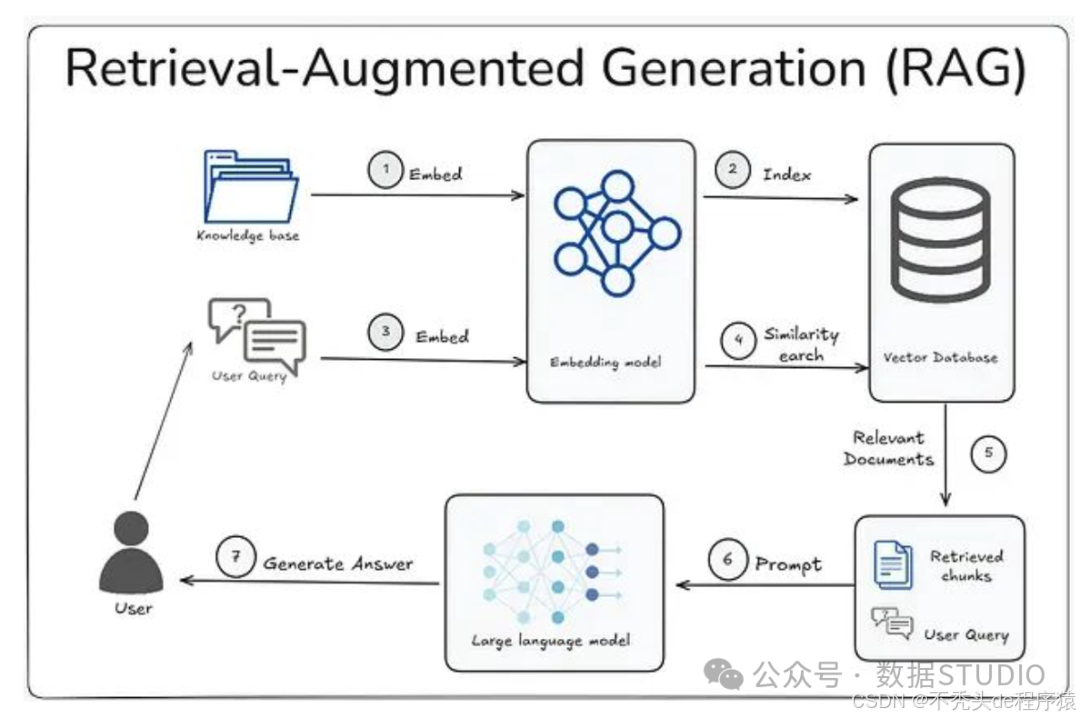
RAG系统包含多个相互关联的组件,其中文本分块策略是决定整个系统性能的关键因素。不同的数据类型、文件格式、内容结构、文档长度和应用场景都需要采用相应的分块策略。分块策略的选择不当会直接影响检索质量和生成效果。本文将系统介绍21种文本分块策略,从基础方法到高级技术,并详细分析每种策略的适用场景,以帮助开发者构建更加可靠的RAG系统。
1. 基础分块(换行符分割)
基础分块是最基础的文本分割方法,按照换行符对文本进行简单分割。
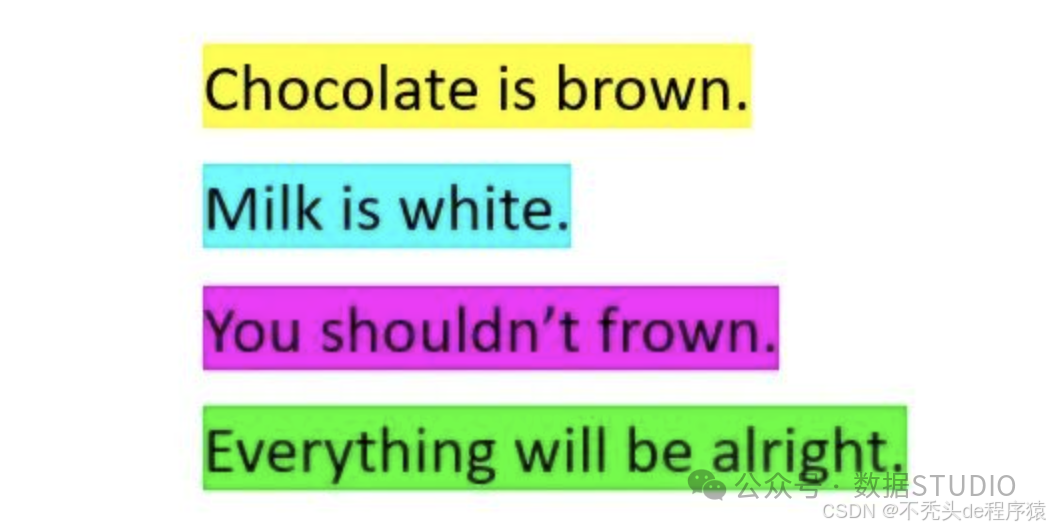
基础分块示例**适用场景:**该方法适用于结构相对规整且以换行符均匀分隔的文本数据,包括笔记文档、项目列表、FAQ文档、聊天记录或转录文本等,特别是当每行文本都包含完整语义单元的情况。**技术要点:**需要注意文本行长度的平衡。过长的文本行可能超出大语言模型的token限制,而过短的文本行则可能导致上下文信息不足,影响模型的理解和生成质量。代码实现:
def naive_chunking(text):
    """按换行符进行基础分块"""
    chunks = text.split('\n')
    # 过滤空行
    chunks = [chunk.strip() for chunk in chunks if chunk.strip()]
    return chunks

# 使用示例
text = """这是第一行内容
这是第二行内容
这是第三行内容"""

chunks = naive_chunking(text)
print(f"分块结果: {chunks}")
2. 固定大小分块
固定大小分块方法按照预设的词数或字符数将文本分割为等长片段,不考虑语义边界。
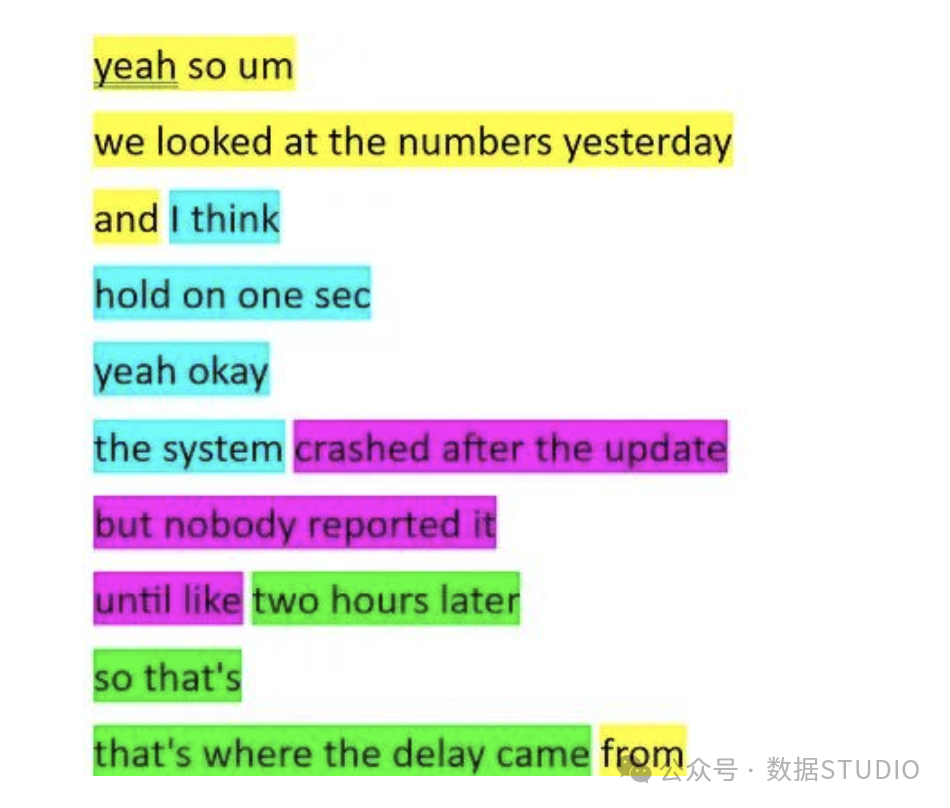
固定大小分块示例**适用场景:**该方法主要用于处理结构化程度较低的原始文本数据,如扫描文档的OCR输出、质量较差的语音转录文本,或缺乏标点符号、标题等结构标记的大型文本文件。代码实现:
def fixed_size_chunking(text, chunk_size=100, overlap=0):
    """按固定大小进行文本分块
    Args:
        text: 输入文本
        chunk_size: 每个分块的字符数
        overlap: 重叠字符数
    """
    chunks = []
    start = 0
    text_length = len(text)

    while start < text_length:
        end = start + chunk_size
        chunk = text[start:end]
        chunks.append(chunk)
        start = end - overlap
    return chunks

# 使用示例
text = "这是一段很长的文本内容,需要按照固定大小进行分块处理。" * 10
chunks = fixed_size_chunking(text, chunk_size=50, overlap=10)
print(f"分块数量: {len(chunks)}")
print(f"第一个分块: {chunks[0]}")
3. 滑动窗口分块
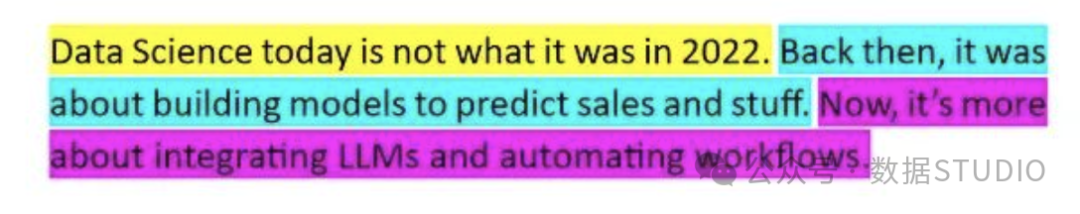
滑动窗口分块在固定大小分块的基础上引入了重叠机制,相邻分块之间保持一定的内容重叠,以维持跨分块的上下文连续性。
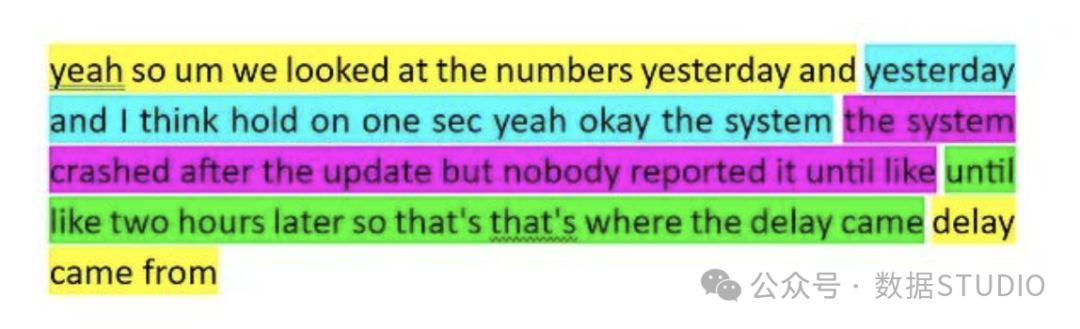
滑动窗口分块示例(与固定窗口分块比较)**适用场景:**该方法特别适用于语义信息跨越较长文本段落的内容,如学术论文、叙述性报告、自由格式写作等。与固定窗口分块类似,它也能处理缺乏明确结构标记的文本,但需要在token使用效率和上下文完整性之间进行权衡。代码实现:
def sliding_window_chunking(text, window_size=200, step_size=150):
    """滑动窗口分块
    Args:
        text: 输入文本
        window_size: 窗口大小(字符数)
        step_size: 步长(字符数),小于window_size时产生重叠
    """
    chunks = []
    start = 0
    text_length = len(text)

    while start < text_length:
        end = min(start + window_size, text_length)
        chunk = text[start:end]
        chunks.append(chunk)
        # 如果已经到达文本末尾,停止
        if end == text_length:
            break
        start += step_size
    return chunks
# 使用示例
text = "人工智能技术的发展日新月异。深度学习模型在各个领域都取得了突破性进展。" * 5
chunks = sliding_window_chunking(text, window_size=100, step_size=80)
print(f"分块数量: {len(chunks)}")
for i, chunk in enumerate(chunks[:3]):
    print(f"分块 {i+1}: {chunk}")
4. 基于句子的分块
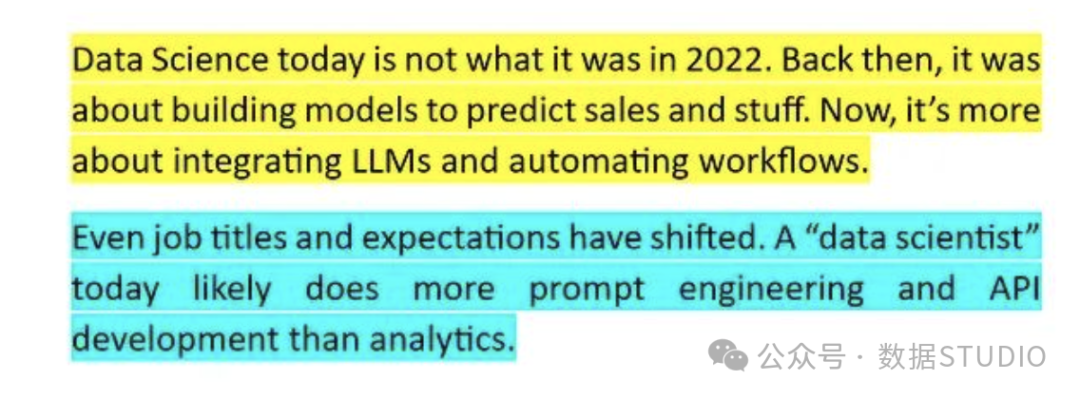
基于句子的分块方法以句子为基本单位进行文本分割,通常以句号、问号或感叹号作为分割标记。
基于句子的分块示例**适用场景:**该方法适用于结构良好、语言规范的文本内容,其中每个句子都包含相对完整的语义信息,如技术博客、文档总结或产品说明等。此外,句子级分块还可以作为预处理步骤,为后续更复杂的分块策略提供基础数据单元。代码实现:
上下滑动查看更多源码
import re

defsentence_based_chunking(text, sentences_per_chunk=3):
    """基于句子的分块

    Args:
        text: 输入文本
        sentences_per_chunk: 每个分块包含的句子数
    """
    # 使用正则表达式分割句子
    sentences = re.split(r'[.!?。!?]+', text)
    sentences = [s.strip() for s in sentences if s.strip()]

    chunks = []
    for i in range(0, len(sentences), sentences_per_chunk):
        chunk_sentences = sentences[i:i + sentences_per_chunk]
        chunk = '。'.join(chunk_sentences)
        if chunk:  # 确保分块不为空
            chunks.append(chunk + '。')

    return chunks

# 使用示例
text = """机器学习是人工智能的一个重要分支。它通过算法让计算机从数据中学习模式。
深度学习是机器学习的子集。它使用神经网络来模拟人脑的工作方式。
目前深度学习在图像识别和自然语言处理领域取得了巨大成功。"""

chunks = sentence_based_chunking(text, sentences_per_chunk=2)
for i, chunk in enumerate(chunks):
    print(f"分块 {i+1}: {chunk}")
5. 基于段落的分块
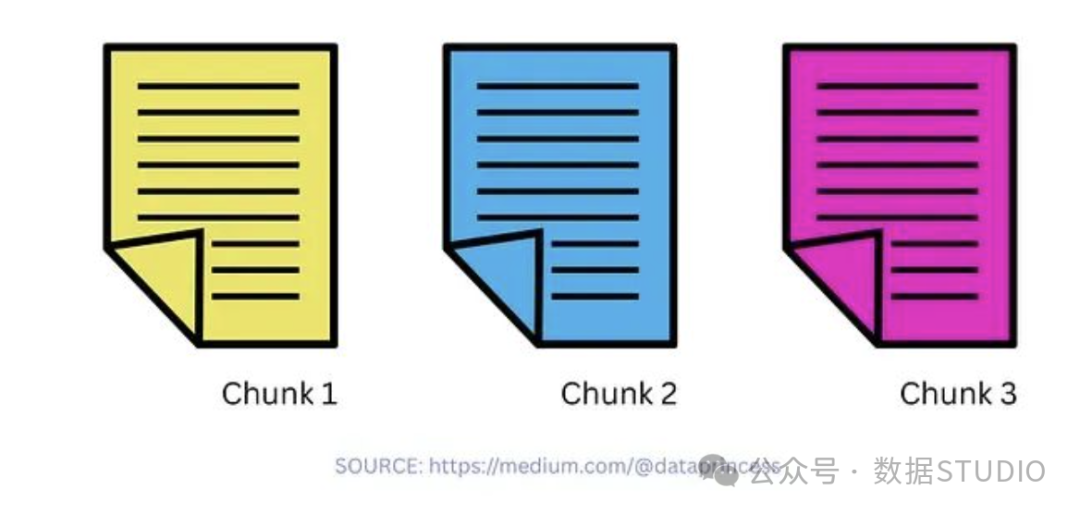
基于段落的分块方法以段落为单位进行文本分割,通常通过识别双换行符来确定段落边界,确保每个分块包含完整的主题或思想单元。
基于段落的分块示例**适用场景:**当句子级分块提供的上下文信息不足时,段落级分块能够提供更丰富的语义环境。该方法特别适用于已经按照段落结构良好组织的文档,如学术文章、博客文章或技术报告等。代码实现:
def paragraph_based_chunking(text, max_paragraphs_per_chunk=2):
    """基于段落的分块
    Args:
        text: 输入文本
        max_paragraphs_per_chunk: 每个分块最大段落数
    """
    # 按双换行符分割段落
    paragraphs = text.split('\n\n')
    paragraphs = [p.strip() for p in paragraphs if p.strip()]
    chunks = []
    for i in range(0, len(paragraphs), max_paragraphs_per_chunk):
        chunk_paragraphs = paragraphs[i:i + max_paragraphs_per_chunk]
        chunk = '\n\n'.join(chunk_paragraphs)
        chunks.append(chunk)
    return chunks
# 使用示例
text = """人工智能的发展经历了多个阶段。从最初的符号主义到现在的深度学习,每个阶段都有其独特的特点和贡献。
机器学习作为人工智能的核心技术,为各行各业带来了革命性的变化。它不仅改变了我们处理数据的方式,也为未来的技术发展奠定了基础。
深度学习的出现标志着人工智能进入了新的时代。通过模拟人脑神经网络的工作原理,深度学习在图像识别、语音处理等领域取得了突破性进展。"""
chunks = paragraph_based_chunking(text, max_paragraphs_per_chunk=1)
for i, chunk in enumerate(chunks):
    print(f"分块 {i+1}:\n{chunk}\n{'-'*50}")
6. 基于页面的分块
基于页面的分块方法将每个物理页面视为一个独立的文本分块。
基于页面的分块示例**适用场景:**该方法主要用于处理具有分页结构的文档,如PDF扫描件、演示文稿或图书等。在需要保持页面布局信息或在检索过程中需要引用页码的应用场景中特别有用。**代码实现:
**
上下滑动查看更多源码
import PyPDF2
from io import BytesIO

defpage_based_chunking_pdf(pdf_path):
    """基于页面的PDF分块

    Args:
        pdf_path: PDF文件路径
    """
    chunks = []

    try:
        with open(pdf_path, 'rb') as file:
            pdf_reader = PyPDF2.PdfReader(file)

            for page_num, page in enumerate(pdf_reader.pages):
                text = page.extract_text()
                if text.strip():  # 确保页面有内容
                    chunk = {
                        'page_number': page_num + 1,
                        'content': text.strip()
                    }
                    chunks.append(chunk)

    except Exception as e:
        print(f"PDF处理错误: {e}")

    return chunks

# 简化版本:模拟页面分块
defsimulate_page_chunking(text, chars_per_page=500):
    """模拟基于页面的分块

    Args:
        text: 输入文本
        chars_per_page: 每页字符数
    """
    chunks = []
    page_num = 1

    for i in range(0, len(text), chars_per_page):
        page_content = text[i:i + chars_per_page]
        chunk = {
            'page_number': page_num,
            'content': page_content
        }
        chunks.append(chunk)
        page_num += 1

    return chunks

# 使用示例
text = "这是一个长文档的内容。" * 100
chunks = simulate_page_chunking(text, chars_per_page=200)
print(f"总页数: {len(chunks)}")
print(f"第一页内容: {chunks[0]['content'][:50]}...")
7. 结构化分块
结构化分块方法基于文档的已知结构特征进行分割,如日志条目、数据库模式字段、HTML标签或Markdown元素等。
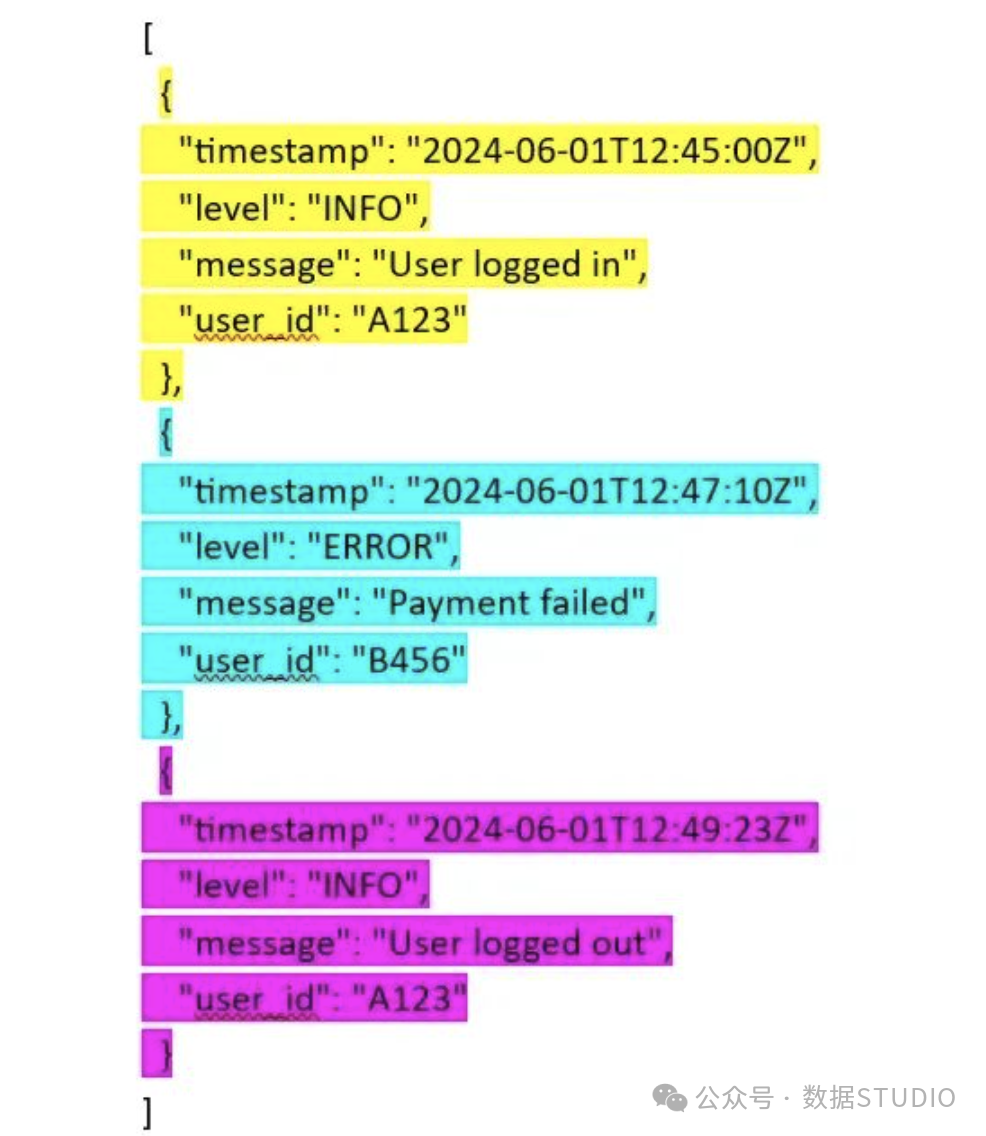
结构化分块示例**适用场景:**该方法适用于具有明确结构标记的数据格式,包括系统日志、JSON记录、CSV文件或HTML文档等结构化或半结构化数据。**代码实现:
**
上下滑动查看更多源码
import json
import re
from bs4 import BeautifulSoup

defjson_structured_chunking(json_data):
    """JSON数据结构化分块"""
    chunks = []

    if isinstance(json_data, list):
        for i, item in enumerate(json_data):
            chunk = {
                'type': 'json_item',
                'index': i,
                'content': json.dumps(item, ensure_ascii=False, indent=2)
            }
            chunks.append(chunk)
    elif isinstance(json_data, dict):
        for key, value in json_data.items():
            chunk = {
                'type': 'json_field',
                'key': key,
                'content': json.dumps({key: value}, ensure_ascii=False, indent=2)
            }
            chunks.append(chunk)

    return chunks

defhtml_structured_chunking(html_content):
    """HTML内容结构化分块"""
    soup = BeautifulSoup(html_content, 'html.parser')
    chunks = []

    # 按段落分块
    for i, p in enumerate(soup.find_all('p')):
        if p.get_text().strip():
            chunk = {
                'type': 'paragraph',
                'index': i,
                'content': p.get_text().strip()
            }
            chunks.append(chunk)

    # 按标题分块
    for level in range(1, 7):  # h1-h6
        for i, h in enumerate(soup.find_all(f'h{level}')):
            chunk = {
                'type': f'heading_{level}',
                'index': i,
                'content': h.get_text().strip()
            }
            chunks.append(chunk)

    return chunks

# 使用示例
json_data = [
    {"name": "张三", "age": 25, "department": "技术部"},
    {"name": "李四", "age": 30, "department": "产品部"}
]

chunks = json_structured_chunking(json_data)
for chunk in chunks:
    print(f"类型: {chunk['type']}, 内容: {chunk['content'][:50]}...")
8. 基于文档结构的分块
基于文档结构的分块方法利用文档的自然层次结构进行分割,如标题、副标题和章节等组织元素。
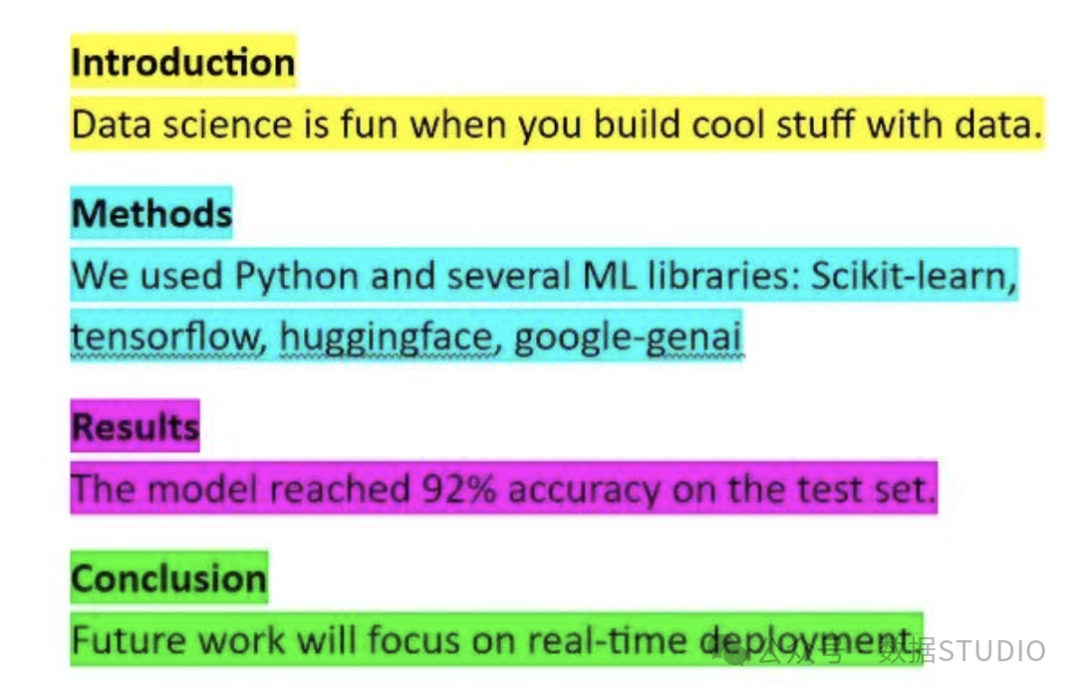
基于文档结构的分块示例适用场景:该方法适用于具有清晰层次结构的文档,如技术文章、操作手册、教科书或研究论文等。同时,它也可以作为更高级分块策略(如层次分块)的预处理步骤。
9. 基于关键词的分块
基于关键词的分块方法通过预定义的关键词来识别分割点,将关键词的出现位置作为逻辑分段标记。
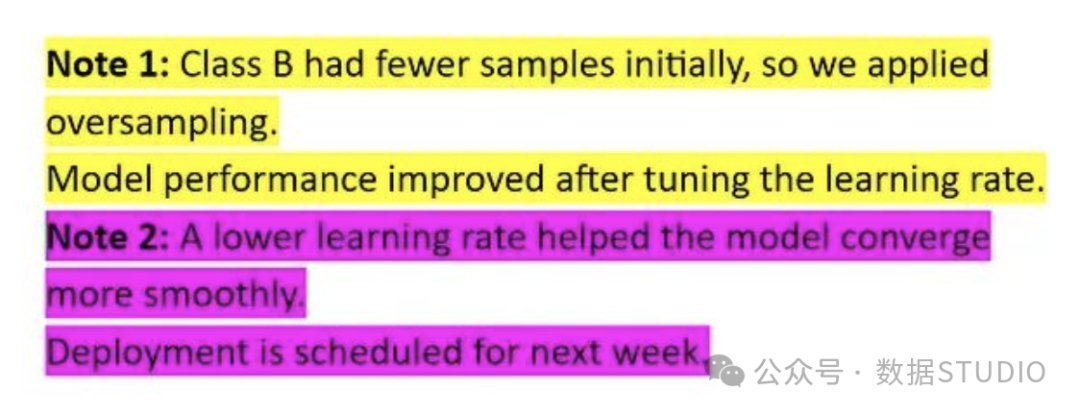
基于关键词的分块示例(关键词是’Note’)**适用场景:**当文档缺乏明确的标题层次结构,但包含能够标识主题转换的特定关键词或短语时,该方法能够有效地进行主题分割。
10. 基于实体的分块
基于实体的分块方法使用命名实体识别(Named Entity Recognition, NER)技术来检测文本中的特定实体(如人名、地名、产品名等),然后围绕这些实体组织相关文本内容。
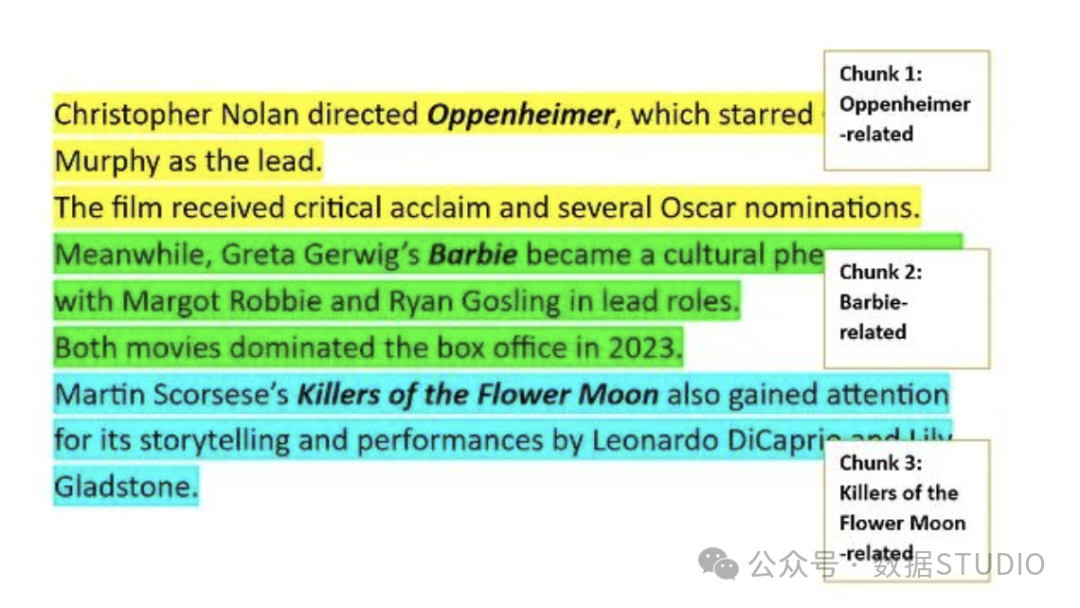
基于实体的分块示例(关键词是’Note’)**适用场景:**该方法适用于实体信息具有重要意义的文档类型,如新闻报道、法律合同、案例研究或影视剧本等,能够确保与特定实体相关的信息被完整保留在同一分块中。
11. 基于Token的分块
基于Token的分块方法使用分词器(tokenizer)按照token数量进行文本分割。**适用场景:**该方法主要用于处理缺乏标题或段落结构的非结构化文档,以及需要严格控制输入长度的低token限制大语言模型场景。为了避免在句子中间进行分割而破坏语义完整性,通常建议将该技术与句子级分块相结合。**代码实现:
**
上下滑动查看更多源码
from transformers import AutoTokenizer
import tiktoken

deftoken_based_chunking_transformers(text, model_name="bert-base-chinese", max_tokens=512):
    """使用Transformers分词器进行基于Token的分块"""
    tokenizer = AutoTokenizer.from_pretrained(model_name)

    # 对整个文本进行分词
    tokens = tokenizer.tokenize(text)
    chunks = []

    for i in range(0, len(tokens), max_tokens):
        chunk_tokens = tokens[i:i + max_tokens]
        # 将tokens转换回文本
        chunk_text = tokenizer.convert_tokens_to_string(chunk_tokens)
        chunks.append(chunk_text)

    return chunks

deftoken_based_chunking_tiktoken(text, model="gpt-3.5-turbo", max_tokens=1000):
    """使用tiktoken进行基于Token的分块(适用于OpenAI模型)"""
    try:
        encoding = tiktoken.encoding_for_model(model)
    except KeyError:
        encoding = tiktoken.get_encoding("cl100k_base")

    # 编码文本
    tokens = encoding.encode(text)
    chunks = []

    for i in range(0, len(tokens), max_tokens):
        chunk_tokens = tokens[i:i + max_tokens]
        # 解码回文本
        chunk_text = encoding.decode(chunk_tokens)
        chunks.append(chunk_text)

    return chunks

# 简化版本:字符近似token分块
defsimple_token_chunking(text, max_tokens=1000, chars_per_token=4):
    """简化的基于Token的分块(字符数近似)"""
    max_chars = max_tokens * chars_per_token
    chunks = []

    for i in range(0, len(text), max_chars):
        chunk = text[i:i + max_chars]
        chunks.append(chunk)

    return chunks

# 使用示例
text = "人工智能技术的发展正在改变我们的生活方式。" * 50
chunks = simple_token_chunking(text, max_tokens=100, chars_per_token=2)
print(f"分块数量: {len(chunks)}")
print(f"第一个分块长度: {len(chunks[0])} 字符")
12. 基于主题的分块
基于主题的分块方法通过主题建模或聚类技术来识别主题边界。该过程首先将文本分割为较小的单元(如句子或段落),然后使用机器学习方法将语义相关的片段聚合为单一分块。
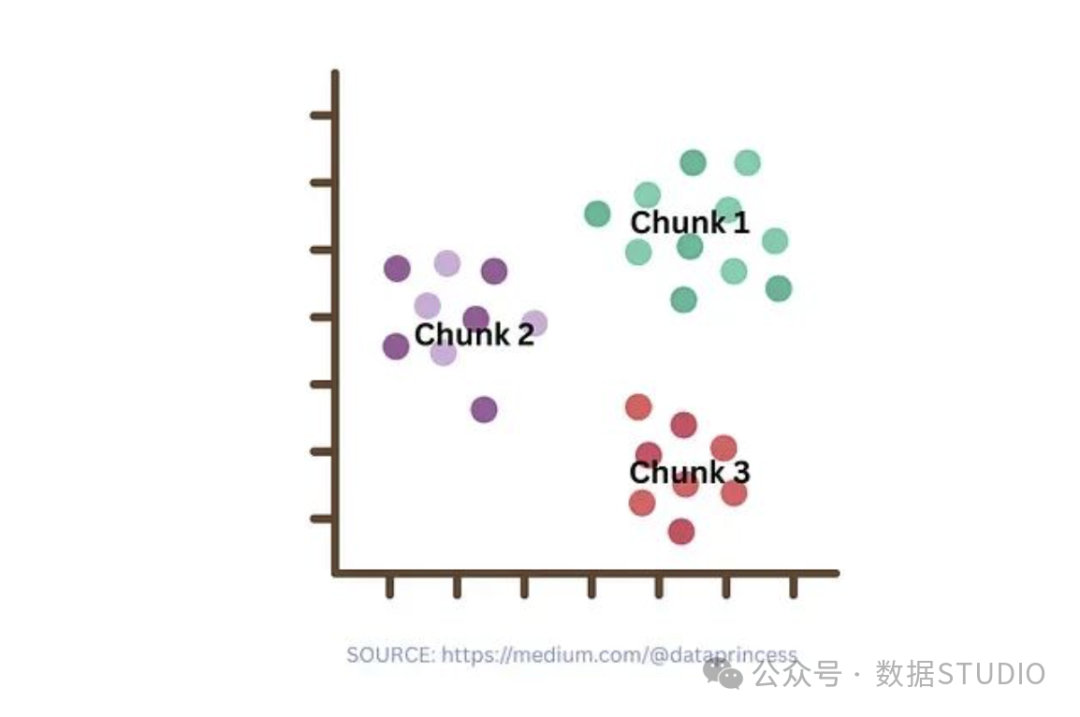
通过聚类进行基于主题的分块示例**适用场景:**该方法适用于涵盖多个主题的文档,能够确保每个分块专注于单一主题,特别是在主题转换较为渐进且缺乏明确标题或关键词标记的文本中表现良好。
13. 表格感知分块
表格感知分块方法专门处理文档中的表格结构,将表格内容转换为JSON或Markdown格式进行单独处理。分块粒度可以是行级别、列级别或整表级别。
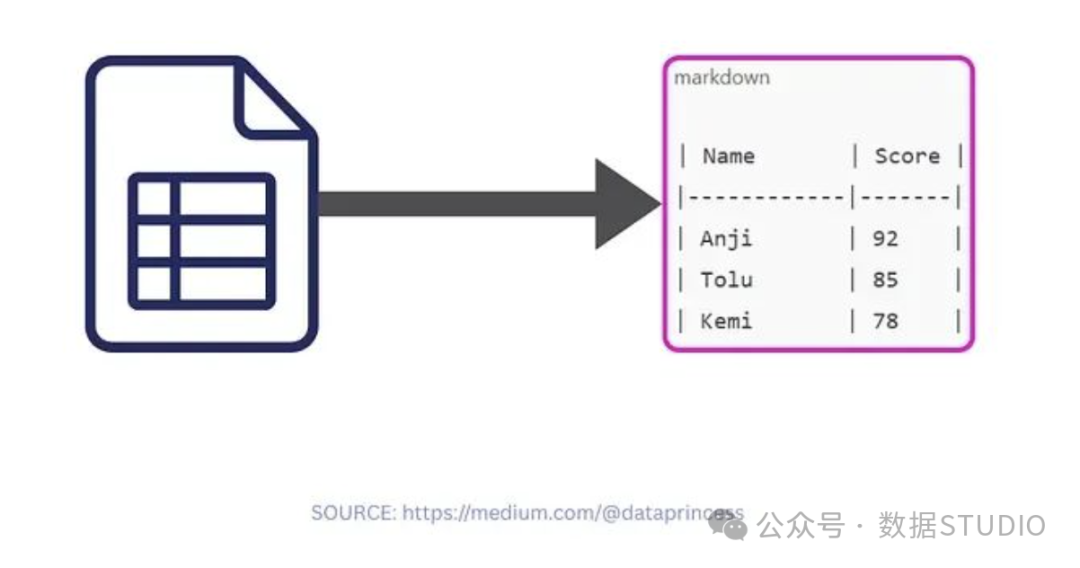
表格感知分块示例**适用场景:**该方法专门用于包含表格数据的文档,能够保持表格结构的完整性和数据关系的准确性。
14. 内容感知分块
内容感知分块方法根据不同的内容类型采用相应的分割规则,为段落、表格、列表等不同内容形式制定专门的处理策略。**适用场景:**该方法适用于包含多种内容格式的混合文档,能够根据内容类型的特点进行针对性处理,确保表格数据的完整性、段落语义的连贯性等。
15. 上下文分块
上下文分块方法利用大语言模型对知识库进行分析,并在文本嵌入之前为每个分块生成简短而相关的上下文描述。

上下文分块示例**适用场景:**该方法适用于知识库规模在大语言模型token限制范围内的场景,特别是对于复杂文档(如财务报告和法律合同等)能够显著提升检索准确性。
16. 语义分块
语义分块方法通过计算文本片段的嵌入向量相似性来识别语义相关的内容,并将其组织为主题一致的分块。**适用场景:**当传统的段落分块或固定窗口分块无法满足需求时,语义分块能够提供更精确的主题聚合效果,特别适用于主题复杂多样的长文档。**代码实现:
**
上下滑动查看更多源码
from sentence_transformers import SentenceTransformer
import numpy as np
from sklearn.metrics.pairwise import cosine_similarity

defsemantic_chunking(text, similarity_threshold=0.7, min_chunk_size=50):
    """基于语义相似性的分块

    Args:
        text: 输入文本
        similarity_threshold: 相似性阈值
        min_chunk_size: 最小分块大小
    """
    # 初始化句子编码器
    model = SentenceTransformer('all-MiniLM-L6-v2')

    # 按句子分割
    sentences = text.split('。')
    sentences = [s.strip() + '。'for s in sentences if s.strip()]

    if len(sentences) < 2:
        return [text]

    # 计算句子嵌入
    embeddings = model.encode(sentences)

    chunks = []
    current_chunk = [sentences[0]]

    for i in range(1, len(sentences)):
        # 计算当前句子与当前分块的相似性
        current_embedding = embeddings[i:i+1]
        chunk_embeddings = embeddings[len(chunks) * len(current_chunk):len(chunks) * len(current_chunk) + len(current_chunk)]

        # 计算平均相似性
        similarities = cosine_similarity(current_embedding, chunk_embeddings)
        avg_similarity = np.mean(similarities)

        if avg_similarity >= similarity_threshold:
            current_chunk.append(sentences[i])
        else:
            # 如果分块足够大,保存当前分块
            chunk_text = ''.join(current_chunk)
            if len(chunk_text) >= min_chunk_size:
                chunks.append(chunk_text)
            current_chunk = [sentences[i]]

    # 添加最后一个分块
    if current_chunk:
        chunk_text = ''.join(current_chunk)
        if len(chunk_text) >= min_chunk_size:
            chunks.append(chunk_text)
        elif chunks:  # 如果最后一个分块太小,合并到前一个分块
            chunks[-1] += chunk_text
        else:
            chunks.append(chunk_text)

    return chunks

# 简化版本:基于关键词相似性的语义分块
defsimple_semantic_chunking(text, keywords_per_chunk=3):
    """简化的语义分块(基于关键词)"""
    sentences = text.split('。')
    sentences = [s.strip() for s in sentences if s.strip()]

    chunks = []
    current_chunk = []
    current_keywords = set()

    for sentence in sentences:
        # 简单提取关键词(这里用长度>2的词)
        words = [word for word in sentence if len(word) > 2]
        sentence_keywords = set(words[:keywords_per_chunk])

        # 计算关键词重叠
        overlap = len(current_keywords.intersection(sentence_keywords))

        if overlap > 0or len(current_chunk) == 0:
            current_chunk.append(sentence + '。')
            current_keywords.update(sentence_keywords)
        else:
            chunks.append(''.join(current_chunk))
            current_chunk = [sentence + '。']
            current_keywords = sentence_keywords

    if current_chunk:
        chunks.append(''.join(current_chunk))

    return chunks

# 使用示例
text = """人工智能技术发展迅速。机器学习是AI的核心技术。深度学习推动了AI革命。
自然语言处理技术不断进步。聊天机器人越来越智能。语言模型能力显著提升。
计算机视觉应用广泛。图像识别准确率不断提高。自动驾驶技术日趋成熟。"""

chunks = simple_semantic_chunking(text)
for i, chunk in enumerate(chunks):
    print(f"语义分块 {i+1}: {chunk}")
17. 递归分块
递归分块方法采用分层处理策略,首先使用大粒度分隔符(如段落)进行初步分割,然后对超出预设长度限制的分块使用更细粒度的分隔符(如句子或词汇)进行递归细分,直到所有分块都满足长度要求。**适用场景:**该方法适用于句子长度变化较大或难以预测的文本内容,如访谈记录、演讲稿或自由格式写作等。**代码实现:
**
上下滑动查看更多源码
import re

defrecursive_chunking(text, max_chunk_size=500, separators=None):
    """递归分块方法

    Args:
        text: 输入文本
        max_chunk_size: 最大分块大小
        separators: 分隔符列表,按优先级排序
    """
    if separators isNone:
        separators = ['\n\n', '\n', '。', '!', '?', ',', ' ']

    defsplit_text(text, max_size, sep_index=0):
        """递归分割文本"""
        if len(text) <= max_size or sep_index >= len(separators):
            return [text] if text.strip() else []

        separator = separators[sep_index]
        chunks = []

        # 按当前分隔符分割
        parts = text.split(separator)

        current_chunk = ""
        for part in parts:
            # 如果添加这部分不会超过大小限制
            if len(current_chunk + separator + part) <= max_size:
                if current_chunk:
                    current_chunk += separator + part
                else:
                    current_chunk = part
            else:
                # 保存当前分块
                if current_chunk:
                    if len(current_chunk) > max_size:
                        # 如果当前分块仍然太大,递归处理
                        chunks.extend(split_text(current_chunk, max_size, sep_index + 1))
                    else:
                        chunks.append(current_chunk)

                # 开始新分块
                if len(part) > max_size:
                    # 如果这部分太大,递归处理
                    chunks.extend(split_text(part, max_size, sep_index + 1))
                    current_chunk = ""
                else:
                    current_chunk = part

        # 添加最后一个分块
        if current_chunk:
            if len(current_chunk) > max_size:
                chunks.extend(split_text(current_chunk, max_size, sep_index + 1))
            else:
                chunks.append(current_chunk)

        return chunks

    return split_text(text, max_chunk_size)

# 使用示例
text = """这是第一段内容,包含了关于人工智能技术发展的详细介绍。

这是第二段内容,讨论了机器学习在各个领域的应用。这段内容比较长,可能需要进一步分割。

这是第三段的短内容。

这是第四段非常长的内容,包含了大量的技术细节和实现方案,需要详细说明深度学习、自然语言处理、计算机视觉等多个技术领域的最新进展。"""

chunks = recursive_chunking(text, max_chunk_size=100)
for i, chunk in enumerate(chunks):
    print(f"递归分块 {i+1} (长度: {len(chunk)}): {chunk[:50]}...")
18. 嵌入分块
嵌入分块方法改变了传统的"先分块后嵌入"流程,而是首先对所有句子进行嵌入向量计算,然后按照向量相似性进行顺序聚合,只有当相似性低于预设阈值时才进行分割。**适用场景:**该方法适用于缺乏明确结构标记(如句子边界、标题、章节标记等)的文档,当传统的滑动窗口分块等方法效果不佳时,该方法能够提供更好的语义连贯性。
19. 智能代理分块
智能代理分块方法将分块决策完全委托给大语言模型,利用其语言理解能力来判断最优的分块边界。**适用场景:**该方法适用于内容复杂或结构不规整的文档,需要类似人类的判断能力来确定合理的分块边界。需要注意的是,该方法可能产生较高的计算成本和资源消耗。
20. 层次分块
层次分块方法在多个粒度级别上进行文本分割,如章节、子章节和段落等,使用户能够在不同的详细程度上进行信息检索。
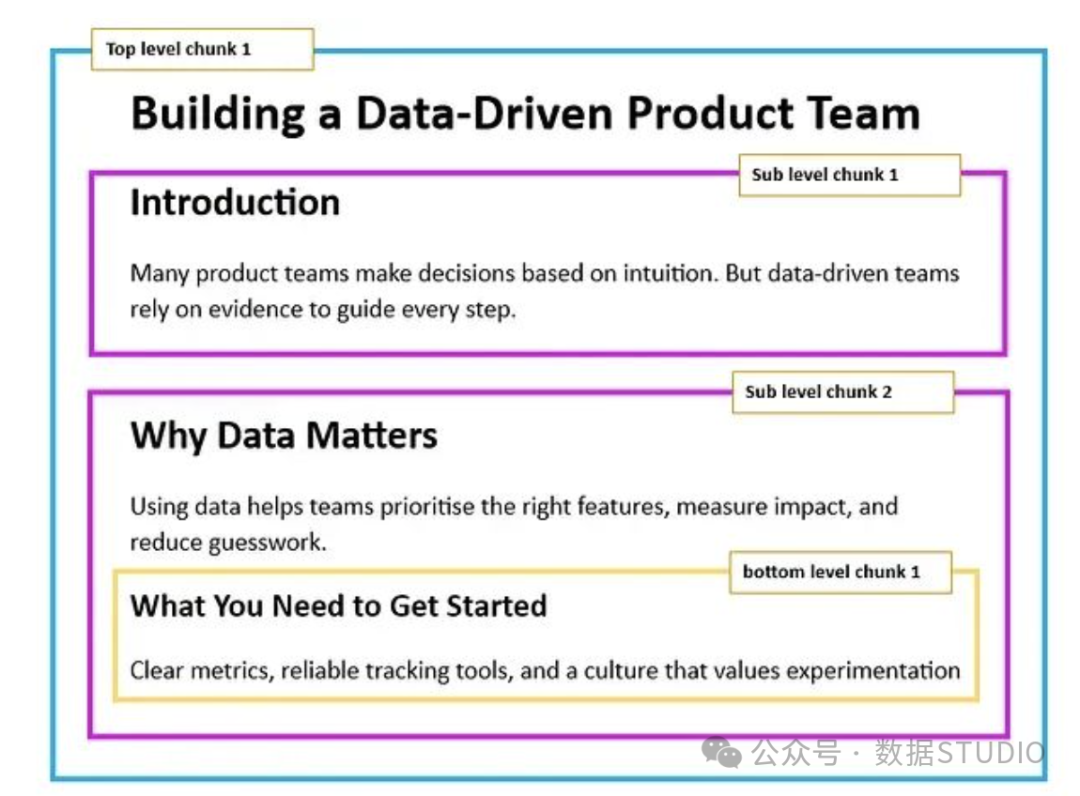
**适用场景:**该方法适用于具有清晰层次结构的文档,如技术文章、操作手册、教科书或研究论文等。它能够支持用户在保持上下文连贯性的同时,灵活地获取概览信息和详细内容。
21. 模态感知分块
模态感知分块方法针对不同类型的内容(文本、图像、表格等)采用专门的处理策略,确保每种模态的信息都得到适当的处理和保存。
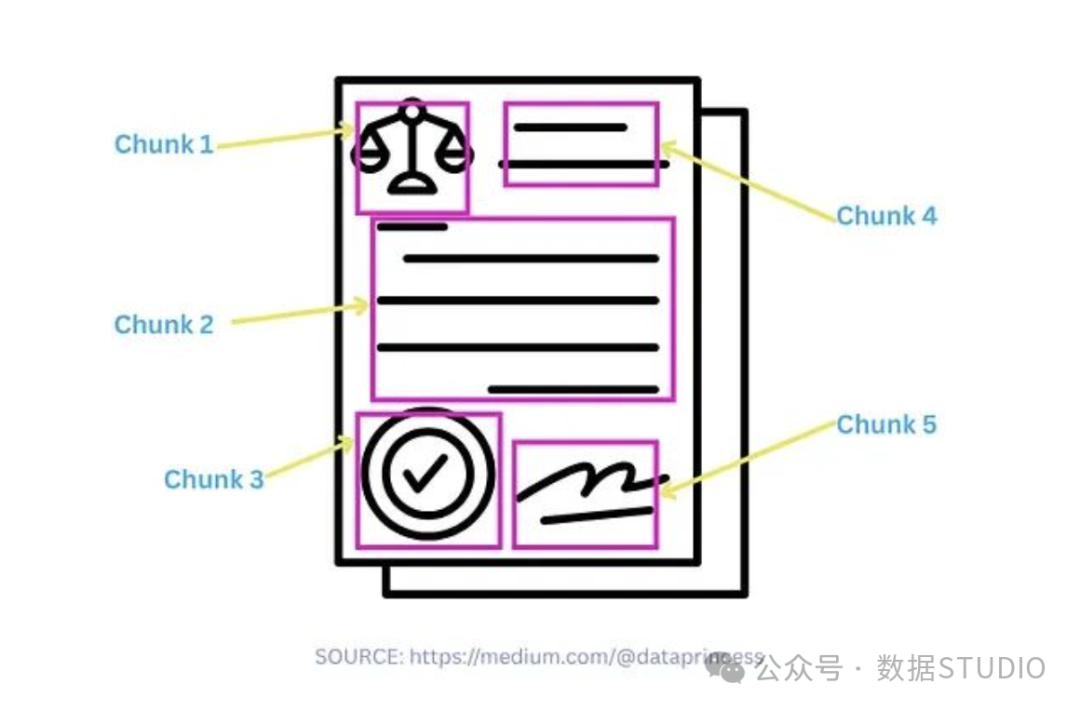
模态感知分块示例**适用场景:**该方法适用于多模态文档,能够根据不同内容类型的特点进行针对性处理,确保信息的完整性和准确性。
混合分块策略
混合分块策略结合多种分块方法、启发式规则、嵌入技术和大语言模型等技术手段,以获得更加稳定和可靠的分块效果。**适用场景:**当单一分块方法无法完全满足数据特点和应用需求时,混合策略通过综合运用多种技术来实现更好的整体性能。代码实现:
上下滑动查看更多源码
import re
from typing import List, Dict, Any

classHybridChunker:
    """混合分块器,结合多种分块策略"""

    def__init__(self, max_chunk_size=1000, overlap_size=100):
        self.max_chunk_size = max_chunk_size
        self.overlap_size = overlap_size

    defdetect_content_type(self, text: str) -> str:
        """检测内容类型"""
        # 检测是否包含代码
        if re.search(r'```|def |class |import ', text):
            return'code'

        # 检测是否包含表格标记
        if'|'in text and text.count('|') > 5:
            return'table'

        # 检测是否包含列表
        if re.search(r'^\s*[-*+]\s', text, re.MULTILINE):
            return'list'

        # 检测是否包含标题结构
        if re.search(r'^#+\s', text, re.MULTILINE):
            return'structured'

        return'plain_text'

    defchunk_by_content_type(self, text: str, content_type: str) -> List[str]:
        """根据内容类型选择分块策略"""

        if content_type == 'code':
            return self._chunk_code(text)
        elif content_type == 'table':
            return self._chunk_table(text)
        elif content_type == 'list':
            return self._chunk_list(text)
        elif content_type == 'structured':
            return self._chunk_structured(text)
        else:
            return self._chunk_plain_text(text)

    def_chunk_code(self, text: str) -> List[str]:
        """代码分块策略"""
        # 按代码块分割
        code_blocks = re.split(r'```[\s\S]*?```', text)
        chunks = []
        for block in code_blocks:
            if len(block) > self.max_chunk_size:
                # 按函数或类分割
                parts = re.split(r'\n(?=def |class )', block)
                chunks.extend(parts)
            else:
                chunks.append(block)
        return [chunk.strip() for chunk in chunks if chunk.strip()]

    def_chunk_table(self, text: str) -> List[str]:
        """表格分块策略"""
        lines = text.split('\n')
        chunks = []
        current_chunk = []

        for line in lines:
            if'|'in line:
                current_chunk.append(line)
            else:
                if current_chunk:
                    chunks.append('\n'.join(current_chunk))
                    current_chunk = []
                if line.strip():
                    chunks.append(line)

        if current_chunk:
            chunks.append('\n'.join(current_chunk))

        return chunks

    def_chunk_list(self, text: str) -> List[str]:
        """列表分块策略"""
        # 按列表项分组
        items = re.split(r'\n(?=\s*[-*+]\s)', text)
        chunks = []
        current_chunk = ""

        for item in items:
            if len(current_chunk + item) > self.max_chunk_size:
                if current_chunk:
                    chunks.append(current_chunk.strip())
                current_chunk = item
            else:
                current_chunk += '\n' + item if current_chunk else item

        if current_chunk:
            chunks.append(current_chunk.strip())

        return chunks

    def_chunk_structured(self, text: str) -> List[str]:
        """结构化文档分块策略"""
        # 按标题分割
        sections = re.split(r'\n(?=#+\s)', text)
        chunks = []

        for section in sections:
            if len(section) > self.max_chunk_size:
                # 进一步按段落分割
                paragraphs = section.split('\n\n')
                current_chunk = ""

                for para in paragraphs:
                    if len(current_chunk + para) > self.max_chunk_size:
                        if current_chunk:
                            chunks.append(current_chunk.strip())
                        current_chunk = para
                    else:
                        current_chunk += '\n\n' + para if current_chunk else para

                if current_chunk:
                    chunks.append(current_chunk.strip())
            else:
                chunks.append(section.strip())

        return [chunk for chunk in chunks if chunk]

    def_chunk_plain_text(self, text: str) -> List[str]:
        """纯文本分块策略"""
        # 结合段落和句子分块
        paragraphs = text.split('\n\n')
        chunks = []
        current_chunk = ""

        for para in paragraphs:
            if len(current_chunk + para) > self.max_chunk_size:
                if current_chunk:
                    chunks.append(current_chunk.strip())

                # 如果单个段落过长,按句子分割
                if len(para) > self.max_chunk_size:
                    sentences = re.split(r'[.!?。!?]+', para)
                    temp_chunk = ""
                    for sent in sentences:
                        if len(temp_chunk + sent) > self.max_chunk_size:
                            if temp_chunk:
                                chunks.append(temp_chunk.strip() + '。')
                            temp_chunk = sent
                        else:
                            temp_chunk += sent + '。'if temp_chunk else sent

                    if temp_chunk:
                        current_chunk = temp_chunk
                    else:
                        current_chunk = ""
                else:
                    current_chunk = para
            else:
                current_chunk += '\n\n' + para if current_chunk else para

        if current_chunk:
            chunks.append(current_chunk.strip())

        return chunks

    defchunk(self, text: str) -> List[Dict[str, Any]]:
        """主分块方法"""
        content_type = self.detect_content_type(text)
        chunks = self.chunk_by_content_type(text, content_type)

        # 为每个分块添加元数据
        result = []
        for i, chunk in enumerate(chunks):
            result.append({
                'id': i,
                'content': chunk,
                'content_type': content_type,
                'length': len(chunk)
            })

        return result

# 使用示例
text = """# 人工智能技术概述

人工智能技术包括多个领域:

- 机器学习
- 深度学习
- 自然语言处理
- 计算机视觉

## 代码示例

def train_model(data):
    model = create_model()
    model.fit(data)
    return model


这是一个简单的模型训练函数。"""

chunker = HybridChunker(max_chunk_size=200)
chunks = chunker.chunk(text)

for chunk in chunks:
    print(f"分块 {chunk['id']} ({chunk['content_type']}, {chunk['length']} 字符):")
    print(f"{chunk['content'][:100]}...")
    print("-" * 50)
总结
本文介绍了多种文本分块方法,包括固定大小分块、滑动窗口分块、基于句子和段落的分块等。每种方法都有其适用场景和实现方式,用户可以根据具体需求选择合适的分块策略。此外,还介绍了混合分块策略,结合多种方法以获得更好的效果。通过这些方法,用户可以有效地处理长文本数据,提高信息检索和处理的效率。希望本文能为文本处理和信息检索领域的研究和应用提供有价值的参考。
普通人如何抓住AI大模型的风口?
领取方式在文末
为什么要学习大模型?
目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
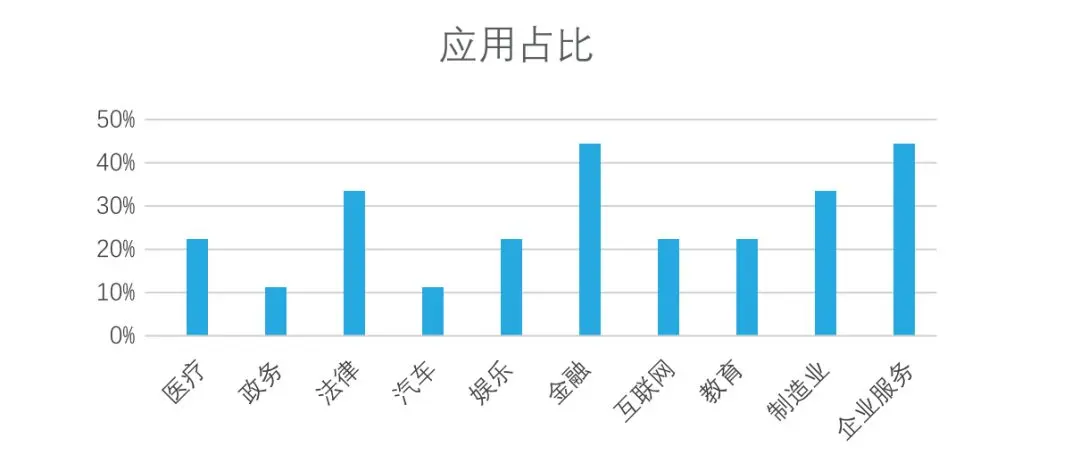
目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。
随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!
最后
只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!
在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
大模型全套学习资料展示
自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!
01 教学内容
-
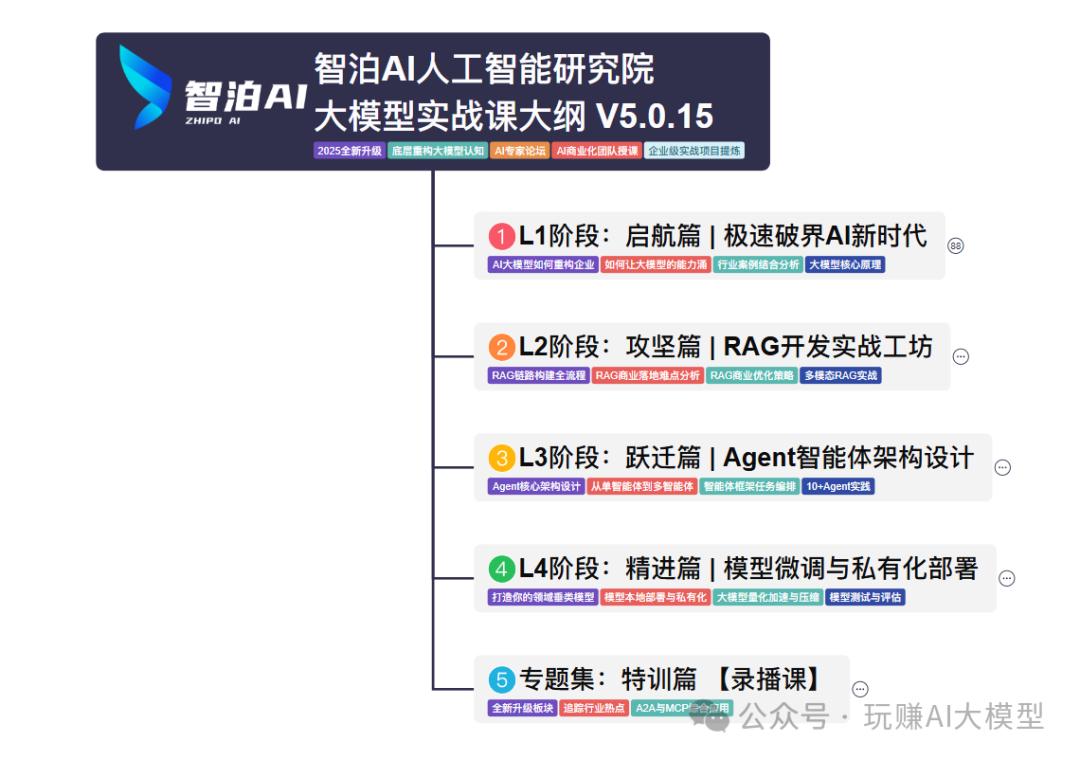
从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!
-
大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
02适学人群
应届毕业生: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。

vx扫描下方二维码即可
本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!
03 入门到进阶学习路线图
大模型学习路线图,整体分为5个大的阶段:

04 视频和书籍PDF合集

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

05 行业报告+白皮书合集
收集70+报告与白皮书,了解行业最新动态!

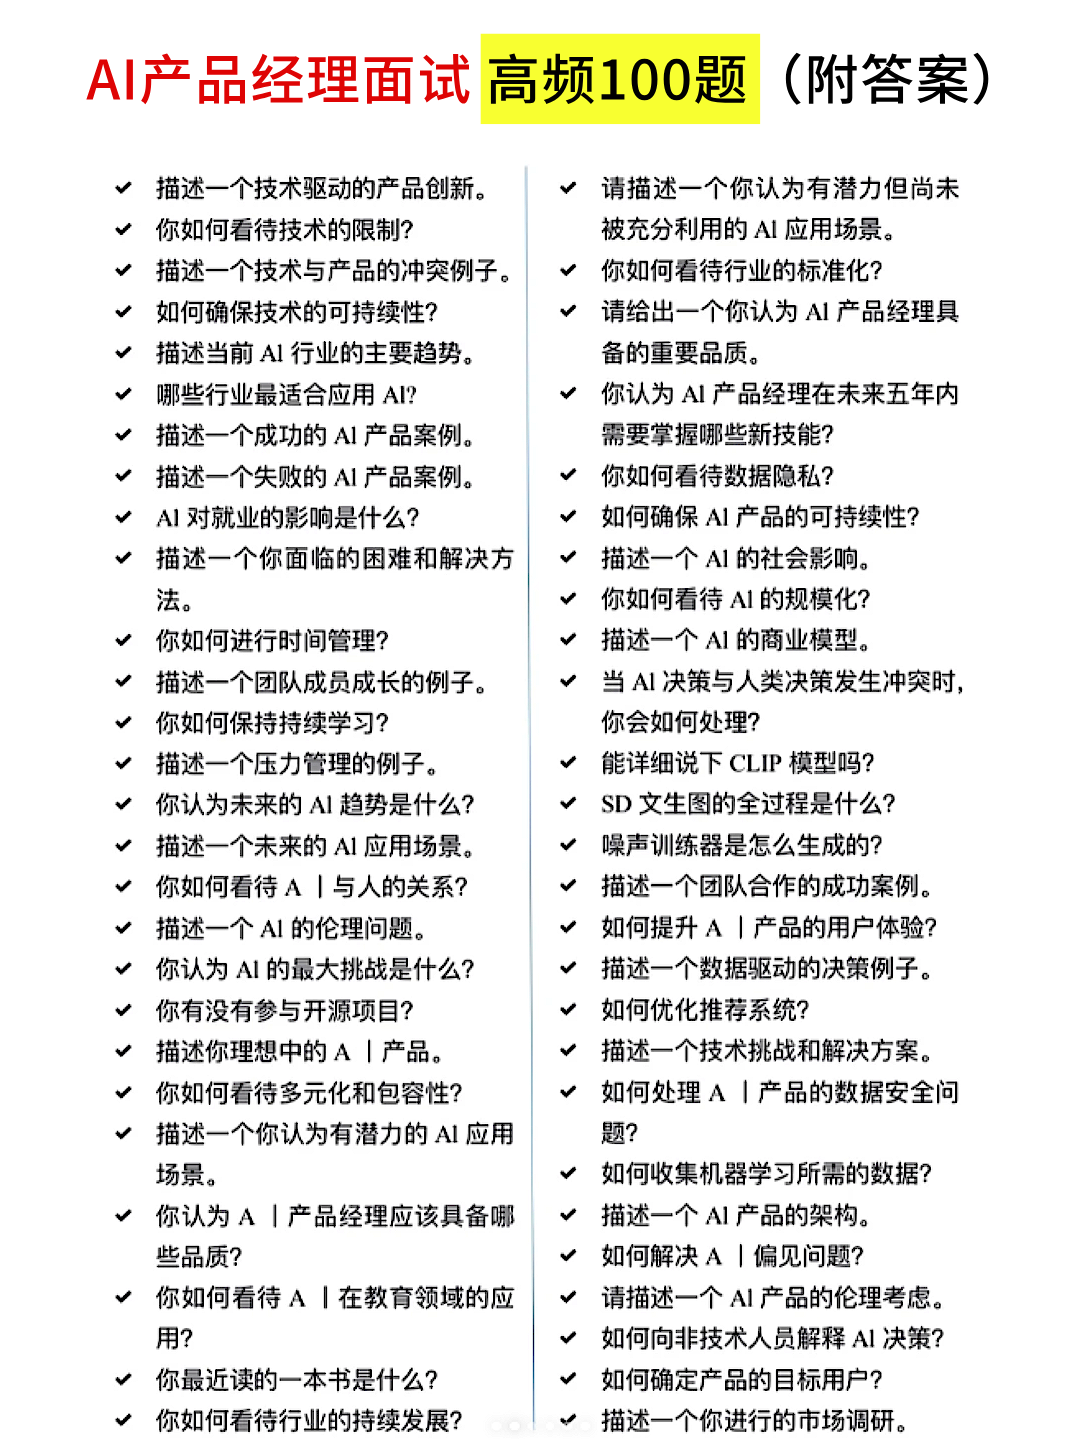
06 90+份面试题/经验
AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)
07 deepseek部署包+技巧大全
由于篇幅有限
只展示部分资料
并且还在持续更新中…
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
 2178


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


