RAG功能需求分析实战案例:如何有效提升检索精确度?

RAG实战案例:如何基于 LangChain 实现智能检索生成系统 检索增强生成 (RAG) 是一种使用来自私有或专有数据源的信息来辅助文本生成的技术。它将检索模型(设计用于搜索大型数据集或知识库)和生成模型(例如大型语言模型 (LLM),此类模型会使用检索到的信息生成可供阅读的文本回复)结合在一起。通过从更多数据源添加背景信息,以及通过训练来补充 LLM 的原始知识库,检索增强生成能够提高搜索体验的相关性。这能够改善大型语言模型的输出,但又无需重新训练模型。 阅读详情

“ RAG系统中,高质量的文档处理才是RAG系统的核心。”

手上有一个基于自然语言对话的系统,其功能就是根据提供的文档,能通过自然语言对话的方式去询问需要的文档和资料;其本质上来说就是一个RAG系统。

在之前一直强调说,RAG开发是一个入门五分钟,但要做好可能要五个月,甚至更久的一项技术;在之前对这句话还没有特别深刻的体会,但经过这个项目算是深有体会了。

在这里插入图片描述

RAG功能优化

刚开始做这个项目的时候,觉得技术比较简单;就是把文档切片,然后通过embedding模型向量化之后,保存到向量数据库中;然后使用同样的embedding模型对用户问题进行向量化,然后使用向量计算的方式,匹配相似度,再通过rerank重排序的方式检索相关的文档。

这一套操作下来,虽然完整的实现了一个RAG功能;但这仅仅只是把这个RAG系统给做了出来,还远远算不上做好。

为什么这么说?

原因就在于经过实际测试之后发现,RAG系统的整体效果还不太满意,有些问题文档里明明有,但召回的时候却召不回来。最后经过检查发现,原因基本上都出在文档处理上。

为什么会出现这种情况?

其实从实际的开发经验来看,目前大模型应用,模型的能力已经可以说是很强了;甚至远远超过我们很多人的预料。但很多时候问题就出在我们的数据处理上,针对RAG系统来说就是文档的前期处理上。

图片

所以,只是把整个RAG流程跑通,这仅仅只是第一步;而比较难得是怎么把RAG做好,有更快更准确的召回效率。

以个人遇到的实际问题为例,针对一个word文档,由于其处理起来比较复杂,因此我们一般采用两种方式进行处理;一种是通过OCR技术,把word文档转换成纯文本的markdown文档,如果word文档中存在大量的图片或架构数据,那么文档的处理质量相对会比较差。

还一种方式更粗暴,更简单,直接找一个开源的文档处理工具,把word文档转换成markdown文档;其图片或架构图数据直接给丢掉。

之后,再整体针对markdown文档进行处理;比如说根据markdown文档标题进行分段,然后每段都带上其上层标题的内容,以此来增加检索召回的准确度。

图片

虽然这种通用的处理方式能够快速处理文档,但由于文档拆分的不够详细,就导致部分内容无法召回。

比如说,一个段落大概在三百到五百个中文字符,但用户的问题可能只有几个字;这样对召回精度来说是远远不够的;但如果拆分的太细,也会导致召回的数据条数太多,最后会被重排序或其它过滤方式给过滤掉。

而且,从实际的开发角度来说,设计向量库表结构时,只会把需要相似度检索的数据放到一两个或两三个字段中,然后根据这些字段进行检索;但实际开发中,我们的文档数据并不都是标准的word或markdown格式,也可能是excel,csv等结构化数据,亦或者是其它类型的数据。

这时怎么把这些数据使用合理的数据格式或结构进行存储,也是一个需要考虑的问题;原因就在于你不可能把不同的数据格式单独建一个字段进行保存,或者单独建一个向量表保存,原因就在于太麻烦,数据太分散。

图片

所以,我们目前的处理方式是不论是word文档,还是excel文档,都把它转化成markdown格式进行存储和向量化;然后再通过相似度检索的方式进行匹配。

总之,在RAG系统中文档处理是重中之重,而且需要根据不同的文档格式和内容进行不同的处理;只有这样才能不断提升RAG的检索准确性,否则RAG就失去了应有的意义。

普通人如何抓住AI大模型的风口?

领取方式在文末

为什么要学习大模型?

目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。

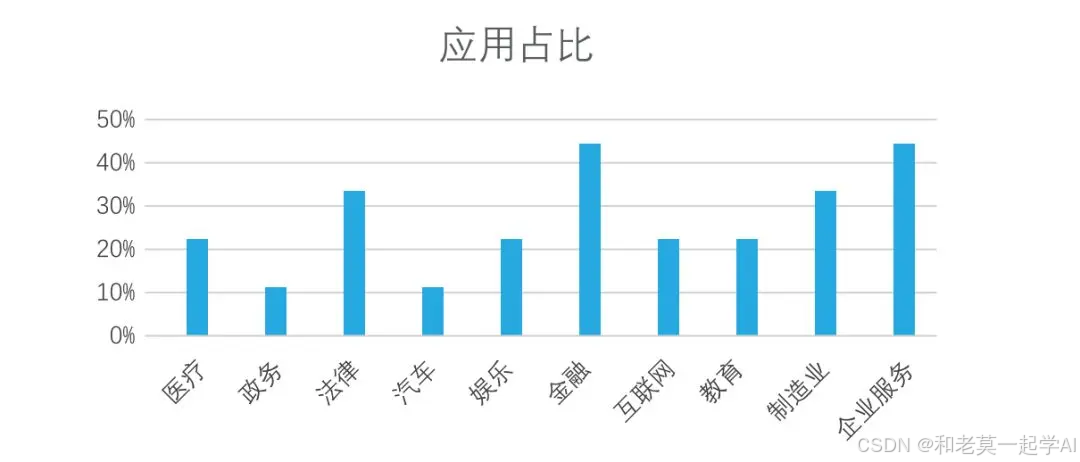
目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。
在这里插入图片描述

随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

在这里插入图片描述

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!

最后

只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!

在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
在这里插入图片描述

大模型全套学习资料展示

自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

图片

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!

01 教学内容
图片

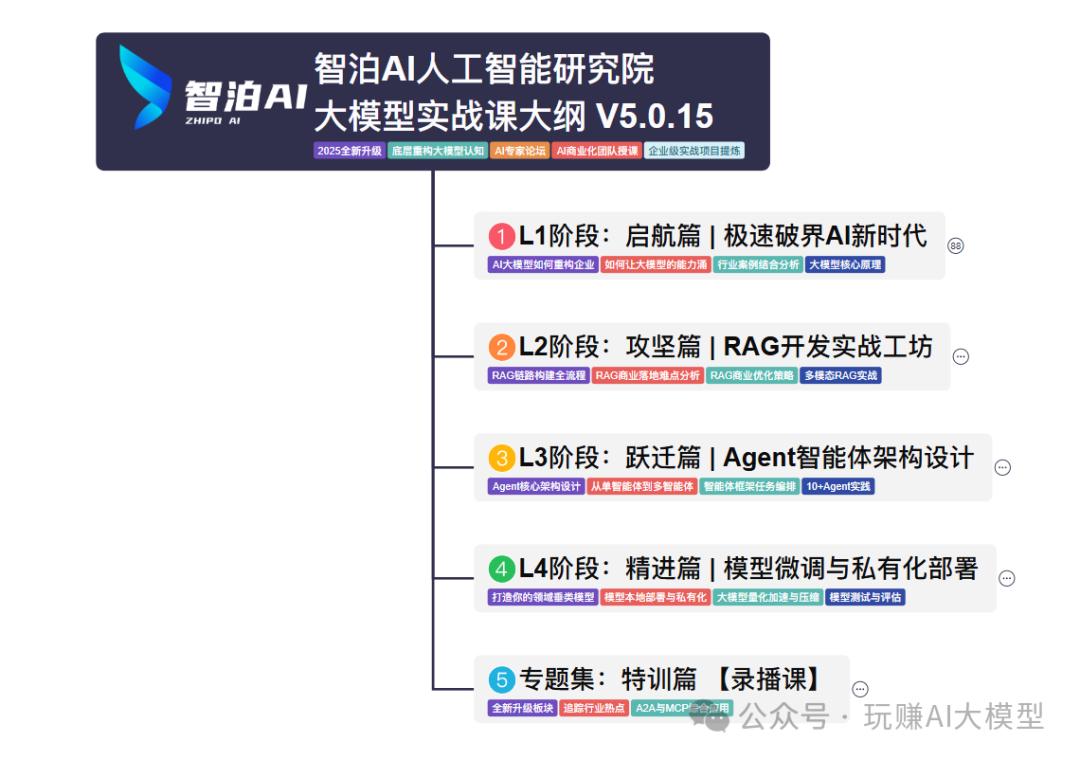
  • 从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!

  • 大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事‌!

02适学人群

应届毕业生‌: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。

零基础转型‌: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界‌。

业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型‌。

image.png

vx扫描下方二维码即可
在这里插入图片描述

本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!

03 入门到进阶学习路线图

大模型学习路线图,整体分为5个大的阶段:

图片

04 视频和书籍PDF合集

图片

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

图片

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

图片

05 行业报告+白皮书合集

收集70+报告与白皮书,了解行业最新动态!
图片

06 90+份面试题/经验

AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)图片

在这里插入图片描述

07 deepseek部署包+技巧大全

在这里插入图片描述

由于篇幅有限

只展示部分资料

并且还在持续更新中…

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

在这里插入图片描述

理解 RAG 第六部分:有效的检索优化 本文探讨了六种旨在提升 RAG 系统检索过程性能的策略。每种技术的复杂程度各不相同,并侧重于不同的优化方面。了解这些策略对于选择适合您特定 RAG 实现的最佳方法(无论是单一技术还是多种技术的组合)至关重要。 阅读详情

相关推荐

一文梳理有效提升RAG效果的方法

RAG 是 “Retrieval-Augmented Generation”(检索增强生成)的缩写,它通过结合检索系统和生成模型来提高语言生成的准确性和相关性。RAG 的优势在于它能够在生成响应时引入外部知识,这使得生成的内容更加准确和信息丰富,对于处理需要专业知识或大量背景信息的问题尤其有效。随着大型语言模型(LLMs)的发展,RAG 技术也在不断进化,以适应更长的上下文和更复杂的查询。目前,大部分公司倾向于使用 RAG方法进行信息检索,因为相比长文本的使用成本,使用向量数据库的成本更低。

weixin_42029738的博客 825

RAG准确率上不去?可能是这5个预处理环节没做好

针对内容冗长的文档,用户无需通读全文,只需一键即可生成核心要点总结。同时,系统支持连续的多轮对话,能够记忆上下文语境,允许用户就一个主题不断深入追问,层层剖析,直至找到问题的最终答案,实现高效的深度信息挖掘。

予非·睿知的博客 842

RAG——RAG检索(混合检索)

本文探讨了RAG(检索增强生成)中的混合检索技术,结合向量检索和关键词检索的优势提升搜索效果。向量检索擅长语义匹配,但在精确匹配、短词搜索等场景表现欠佳;关键词检索则能有效处理产品编号、低频词等特定查询。混合检索通过多路召回策略(如BM25算法+向量检索)综合不同检索结果,并采用重排序技术(如RRF算法)优化结果排序。实验数据表明,混合检索结合重排序能显著提升召回率和准确性。文章还提供了Python实战代码,演示如何集成BM25和jieba分词实现中文混合检索。这种技术组合为RAG系统提供了更全面、精准的检

小志的博客 1143

提升 RAG 检索质量:构建高效可用的知识检索管道

本文系统梳理了提升检索增强生成(RAG)系统质量的核心策略,从知识库构建、文档清洗与解析,到 chunk 切分、句子滑动窗口、自动合并检索,再到 Embedding 与 ReRank 模型优化,以及聚类索引构建,全面阐述了各环节对检索准确性与生成质量的影响。文章强调,高质量的检索是生成可靠答案的前提,并结合中文场景和实际工程实践提供了可操作的方案与模型选型建议,为构建高效、稳健的 RAG 系统提供参考。

曾经“等你生日那天”都遥远得像未来,如今却可欢愉的挥手说“下个十年见” 5万+

基于文档层级架构的RAG系统:提升人工智能检索效率

父节点通常包含从子节点中提取的摘要或关键点。这些摘要在查询处理过程中起到导航辅助的作用,帮助系统快速判断某个节点是否与查询相关,从而提高检索效率。

llm_way的博客 1149

【速通RAG实战:检索】7.RAG混合检索与重排序技术

在 RAG(检索增强生成)系统中,检索环节起着承上启下的关键作用,它需要精准地从知识库中找出与用户查询相关的信息,为后续的生成环节提供有力支撑。混合检索与重排序技术是提升检索效果的重要手段。

2025博客之星Top81。专注AI工程化与架构实战。从分布式思维到模型部署,用工程化视角为你厘清AI落地的真实路径。 1788

提升RAG系统检索效果的关键策略:混合检索与实战优化指南

在实际应用中,我们常常遇到一个令人头疼的问题:**用户提了一个明确的问题,但检索出来的内容却风马牛不相及,导致生成的回答答非所问甚至胡说八道。** 这类现象,归根结底是Retriever阶段出现了问题。那么我们该如何优化RAG中的检索模块,提升整体效果呢?本文将结合实践案例,系统介绍三类主流检索方式的优劣,并重点讲解“混合检索策略”以及其他实战优化技巧,助你构建更精准、更鲁棒的RAG系统。

cooldream2009的博客 1195

orangepi 5 plus ubuntu24.04上安装redroid

OrangePi 5 Plus运行reDroid云手机方案总结 在RK3588+Ubuntu 24.04上部署reDroid(Android容器化方案)的关键步骤: 内核要求:确保启用binderfs(无需ashmem,新版reDroid使用memfd替代); 安装流程: 安装Docker并配置代理加速镜像拉取; 拉取reDroid镜像(推荐Android 12/13 ARM64版本); 通过挂载binderfs启动容器,指定分辨率与DPI参数; 多实例管理: 脚本化创建多个容器(如8个实例),分配独立端口

babytiger的专栏 2298

RAG 技术的下一站:Agentic RAG 和自主检索的未来

2026 年初,某法律 AI 平台对 RAG 系统进行了一次升级:从"固定检索 5 个文档"升级到"Agentic RAG"(Agent 自主决定检索几次、检索什么)。结果:回答准确率从 72% 提升到 89%,但成本也增加了 40%。。本文将深入分析 RAG 技术的未来趋势。

好代码自己会说话,烂代码才需要注释来圆谎 5264

单片机通信总述——理论部分(CAN、串口、SPI、I2C等)

并行通信:传输原理:数据各个位同时传输;优点:速度快; 缺点:占用引脚资源多。是指使用 8、16、32 及 64 根或更多的数据线(有多少信号为就需要多少信号位)进行传输的通讯方式,可以同一时刻传输多个数据位的数据。串行通信: 传输原理:数据按位顺序传输;优点:占用引脚资源少; 缺点:速度相对较慢。是指设备之间通过一根数据信号线,地线以及控制信号线,按数据位形式一位一位地传输数据的通讯方式,同一时刻只能传输一位(bit)数据。 单工: 数据传输只支持数据在一个方向上传输。信息只能单方向传输的工作方式,一

qq_42475191的博客 1万+

Shopee 虾皮API接口:商品详情采集的实践

随着电商行业的蓬勃发展,数据采集和分析在商业决策中扮演着越来越重要的角色。Shopee作为东南亚领先的电商平台,拥有大量的商品数据。通过Shopee的API接口,我们可以方便地获取商品详情,为数据分析和市场研究提供有力支持。本文将介绍如何使用Shopee API接口采集商品详情,并分享一些实践技巧。提供了丰富的数据接口,包括商品详情、店铺信息、订单数据等。通过API接口,开发者可以轻松地获取Shopee平台上的数据,进行进一步的处理和分析。Shopee API接口:商品详情采集的实践与技巧。

An4480的博客 1889

提升RAG检索回答质量: Shortwave的 4 大优化指南

在 Shortwave 的 AI 系统中,它根据查询中特征(如日期或时间)来判断信息的时效性,从而在初步检索后对更近期的内容给予更高的优先级。:利用从问题中提取的特征缩小向量搜索的范围。此外,RAG 的模块化设计使得不同的组织可以根据需求使用专属的知识库,避免了将所有数据混合在一个不可解释的黑箱模型中的问题,从而提高了模型的透明度和可定制性。知识密度 (Density): 在相关性相同的情况下,应优先参考知识密度高的文档,即那些内容质量更高、信息更精炼的文档,例如由专家撰写的主题内容。

2401_85378759的博客 1208

巨量千川M-API实战:5分钟搞定短视频计划数据自动获取(Python版)

本文详细介绍了如何利用巨量千川M-API和Python快速搭建自动化工具,实现短视频计划数据的自动获取。通过实战代码演示了从环境准备、Token管理到核心数据接口调用的完整流程,帮助电商运营和技术开发者告别手动导出,高效完成数据汇总与分析。

weixin_29325515的博客 1367

15种高级RAG技术:从预检索到生成全面提升RAG效果

随着检索增强生成(RAG)系统的快速发展,它为增强对话式 AI 和其他生成式 AI 应用提供了许多机会。信息密度检索准确性用户响应质量如果正确实施,这些技术可以为企业带来更高的成本效益,并改善客户体验。但为了跟上快速涌现的最佳实践,软件工程师和数据科学家需要及时、可信赖的资源作为参考。​。

zhishi0000的博客 1535

把机器学习“搬进”数据库:SAP HANA PAL 快速上手与 ABAP AMDP 实战

摘要:本文探讨了SAP HANA PAL(Predictive Analysis Library)在企业数据分析中的实践应用。PAL通过将机器学习算法下推到数据库内部执行,有效解决了大数据量场景下的数据搬运瓶颈和治理成本问题。文章详细介绍了PAL的核心功能(包括聚类、分类、回归等10类算法)、使用前提(版本、组件和权限要求)以及通过AMDP实现ABAP与PAL集成的技术方案。重点阐述了参数表设计理念和两个典型应用场景:利用PageRank算法分析企业权限网络关系,以及通过PAL_SCALE进行特征预处理。文

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 5740

使用自制的NTC测量模块测试Plecs的热仿真效果

可以测试:您完全可以用这个模型来测试热仿真。NTC 模型是连接电气域和热域的关键桥梁。实现闭环:通过这种方式,您创建了一个高度真实的正反馈闭环系统:负载增加 -> 损耗增加 -> 温度升高 -> NTC 阻值变化 -> 控制电路可能因此调整(如降低频率或电流)-> 损耗变化 -> 温度变化。应用场景:这对于设计过温保护 (OTP) 电路风扇控制系统以及分析热失控条件非常有用。单位:确保热域中使用的单位( Kelvin 或 Celsius )与您的 C-Script 模型输入期望的单位一致。

312

RAG性能优化实战:如何让AI检索准确率从60%提升到95%

什么是RAG?为什么准确率这么低?这篇文章绝对是纯干货,对于正在做RAG项目的开发者来说价值巨大!🎉

沉淀所学,分享所思,让热爱与成长同行。商务记录AI实战经验,助力开发者快速成长。 热爱AI,希望做出有影响力的技术成果。 技术点亮生活,分享连接价值与机会。 专注AI落地实战,陪你走好技术每一步。 1万+

Android系统开发工程师面试指南与参考答案

本文整理了Android系统开发工程师面试常见问题与参考答案。核心内容涵盖:1)Framework层定制方法,如修改HAL和系统服务;2)ANR问题分析工具(systrace)与解决方案;3)性能优化实践,包括开机加速和功耗管理;4)四大组件工作机制与应用案例;5)Native崩溃调试技巧。文章强调通过AOSP源码研究、工具使用和项目案例准备来提升面试表现,重点考察应聘者的系统开发深度和实操能力。参考答案均基于实际开发经验,提供可量化的优化成果说明。

郑伟强dev的专栏 259

【收藏学习】智能体式RAG(Agentic RAG)实战:AI智能体如何提升检索增强生成能力

【收藏学习】智能体式RAG(Agentic RAG)实战:AI智能体如何提升检索增强生成能力

大模型研究中心 2048

Pytorch中安装 torch_geometric 详细图文操作(全)

如果已经安装了pytorch版本,对应跳过步骤一,直接安装步骤二即可注意:依赖包的配置需要根据pytorch版本号以及cuda的版本号,版本号要适配,否则部分函数无法使用。

码农研究僧的博客 3449

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

RAG检索精确度优化实战:5大技巧提升问答系统效果,收藏这一篇就够了!

摘要:本文探讨了RAG(检索增强生成)系统的核心难点——高质量文档处理。虽然RAG系统的基本实现流程(文档切片、向量化、相似度匹配)相对简单,但要实现精准召回却极具挑战。作者通过实践发现,问题往往出在文档预处理阶段,特别是处理复杂格式(如Word、Excel)时。当前解决方案包括转换为Markdown格式、智能分段等方法,但仍面临拆分粒度难以把握、多格式数据统一存储等难题。文章强调,文档处理的质量直接决定RAG系统的检索效果,需要针对不同格式和内容特性进行精细化处理。(149字)

2301_76168381的博客 899

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

提升你的 RAG 的高级检索技术

原文:towardsdatascience.com/advanced-retriever-techniques-to-improve-your-rags-1fac2b86dd61?

龙哥盟 1140

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

全面解析RAG:一文梳理有效提升RAG效果的方法

在RAG系统的实际应用中,需要工程和算法等的多方参与和努力,理论上有很多方法,在实践的过程中我觉得还需要大量的实验对比,不断验证和优化,也可能会遇到许多细节问题,比如可想到的异构数据源的加载和处理啊,知识的展示形态(文本、图片、表格)等是否能一起回答,提升下用户体验,以及建立一套自动化的评估机制,当然还有模型的持续迭代和大小模型的训练支持。那以下这些PDF籍就是非常不错的学习资源。具体来说,设计了一个轻量级的检索评估器来评估检索到的文档的整体质量,并基于评估结果触发不同的知识检索操作。

lyy2017175913的博客 1535

LLM之RAG理论(七)| 高提升RAG检索的四种方法

LoRA是大模型微调的技术之一,它来自论文《LoRA: Low-Rank Adaptation of Large Language Models》[9],基本原理是冻结大模型参数,在原始模型中添加少量的可训练参数AB矩阵来适应特定领域知识,由于微调的参数量较少,比较适合低资源的场景和用户。有时候直接对原问题生成答案效果不佳,这时我们可以通过要求LLM首先将用户的查询分解为子问题,然后,文档检索器可以检索每个较小的问题,这样可以提供更丰富的上下文。对于每个检索到的文档集,都会生成相应子问题的答案。

wshzd的博客 2392
上一篇: AI智能体企业落地真相:90%靠工程架构设计,10%才是大模型技术
下一篇: 超大文档问答解决方案:RAG + Claude技术整合实战解析
不秃头de程序猿
博客等级 码龄5年 4091粉丝 1479原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值