Transformer为何如此强大?一文读懂颠覆AI界的革命性技术

一文读懂人工智能的底层逻辑(文末荐书) 工程师(算法设计师)设计管道布局(模型架构,如神经网络层数、连接方式),并通过训练调整每个阀门的开合程度(优化权重),使得水流(信息)最终能准确到达正确的目的地(输出正确结果)。应用场景: 图像识别(识别照片中的物体)、语音识别(听懂你说的话)、机器翻译(中译英)、内容生成(写文章、作画)、推荐系统(猜你喜欢)、自动驾驶(感知决策)等。核心逻辑: 模型初始化后(参数随机设置),通过“训练”过程,利用数据和优化算法,不断调整内部参数(权重),以最小化预测结果与真实值之间的差距(损失函数)。 阅读详情

如果你问 AI 圈的人:"近 10 年最伟大的算法是什么?"90% 的答案会指向一个名字 ——Transformer。

这个 2017 年由谷歌团队在《Attention Is All You Need》中提出的模型,像一颗投入湖面的巨石,不仅彻底改写了自然语言处理(NLP)的规则,更撑起了 ChatGPT、GPT-4、DALL・E 等现象级 AI 的 “骨架”。

今天,我们不聊玄乎的概念,而是从公式到结构,一步步拆解这个让 AI"变聪明" 的核心框架。看懂它,你就看懂了当前 90% 大模型的底层逻辑。

一、为什么 Transformer 能取代 RNN?先看传统模型的 “致命缺陷”

在 Transformer 出现前,AI 处理语言靠的是RNN(循环神经网络) 和它的升级版 LSTM、GRU。这些模型像人类读书一样,按顺序逐个处理单词:先读 “我”,再读 “爱”,最后读 “你”,才能理解 “我爱你”。

但这种 “串行处理” 有两个致命问题:

  1. 无法并行计算:必须等前一个词处理完才能处理下一个,训练速度极慢(想想看,处理一本百万字的书,要逐个词计算,GPU 再多也没用)。
  2. 长距离依赖丢失:读长句子时,前面的词记不住(比如读到 “他昨天买的那个水果,其实我不爱吃____”,RNN 可能忘了 “水果” 是什么,更填不出 “它”)。

Transformer 的革命性突破在于:彻底抛弃循环结构,用 “注意力机制” 实现并行处理,同时完美捕捉长距离关联。

二、Transformer 的 “灵魂”:自注意力机制(Self-Attention)

自注意力机制的核心思想很朴素:处理一句话时,每个词都要 “回头看” 其他词,计算它们之间的关联程度,然后按重要性加权组合。

比如处理 “猫抓老鼠,它跑得很快” 时:

  • 词 “它” 需要重点关注 “猫” 或 “老鼠”(确定指代对象);
  • 词 “跑” 需要关联 “猫” 或 “老鼠”(确定谁在跑)。

这种 “动态关注” 的过程,靠一套严谨的数学公式实现。

1. 从 “词” 到 “向量”:先把文字变成 AI 能懂的数字

计算机看不懂文字,所以第一步是把每个词转换成向量(比如用 Word2Vec 或 BERT 预训练的词向量)。假设我们有一句话 “我 爱 苹果”,每个词被转换成一个 4 维向量:
“我” →
“爱” →
“苹果” →
2. 核心公式 1:计算 “查询、键、值”(Q, K, V)
自注意力的第一步,是为每个词生成三个向量:

  • 查询(Query, Q):当前词 “想知道什么”(比如 “它” 想查询 “谁是主语”);
  • 键(Key, K): 其他词 “能提供什么信息”(比如 “猫” 的键是 “动物 / 主语”);
  • 值(Value, V): 其他词的 “具体内容”(比如 “猫” 的值是 “一种哺乳动物”)。

这三个向量通过词向量与权重矩阵相乘得到:

其中:
是词向量矩阵(比如 “我 爱 苹果” 的向量组合,形状为 [3, 4]); 是可训练的权重矩阵(比如形状为 [4, 3],让输出向量降为 3 维);输出 形状为 [3, 3](3 个词,每个

3. 核心公式 2:计算 “注意力分数”(谁和谁更相关?)
有了 和 ,就能计算每个词对其他词的 “关注度”。公式很简单:用查询向量点乘键向量,结果越大,关联越强。

比如 “它” 的查询向量与 “猫” 的键向量点乘结果是 8,与 “老鼠” 的点乘结果是 3,说明 “它” 更可能指代 “猫”。为了让分数更稳定(避免数值过大导致 softmax 饱和),通常会除以键向量维度的平方根(比如键向量是 3 维,就除以√3):

其中 (d_k) 是键向量的维度(这里是 3),(K^T) 是 K 的转置矩阵。

  1. 4. 核心公式 3:用 Softmax 归一化分数
    得到原始分数后,用 Softmax 函数把分数转换成概率(所有词的概率和为 1),这样就能直观看出 “关注占比”:
    Softmax 的公式是:

比如原始分数是 [8, 3, 1],经 Softmax 后可能变成 [0.95, 0.04, 0.01],说明 95% 的注意力给了第一个词。
5. 核心公式 4:计算最终注意力输出
最后,用归一化的权重矩阵乘以值向量(),得到每个词的 “加权组合结果”—— 这就是自注意力的输出:

比如 “它” 的输出,就是 “猫” 的值向量 ×0.95 + “老鼠” 的值向量 ×0.04 + 其他词的值向量 ×0.01,完美融合了最相关的信息。
举个具体例子:用数字算一遍自注意力
假设:
词向量矩阵 (3 个词,4 维);
权重矩阵 (4×3 维)。
步骤 1:计算 Q、K、V

步骤 2:计算注意力分数

(这里每个词只和自己相关,因为 X 是单位矩阵,实际场景中会更复杂)
步骤 3:Softmax 归一化后,权重矩阵和 Q 相同(因为对角线值最大)。

三、多头注意力:让 AI 从 “多个角度” 看问题
自注意力已经很强大了,但 Transformer 还加了个 “多头”(Multi-Head) 设计 —— 简单说,就是同时训练多组自注意力,每组关注不同的关联(比如一组看语法,一组看语义),最后把结果拼起来。
多头注意力的公式

其中:

每个(每组头有自己的权重矩阵);
是头的数量(论文中用了 8 头);
是拼接操作(把 8 个头的输出拼在一起);
是最终的线性变换矩阵,把拼接后的向量映射到指定维度。

为什么要多头?
比如处理 “他喜欢苹果,也喜欢编程”:

  • 头 1 可能关注 “他” 和 “苹果” 的关联(知道 “苹果” 是水果);

  • 头 2 可能关注 “他” 和 “编程” 的关联(知道 “编程” 是动作);

  • 拼接后,模型既能理解 “苹果” 的实物属性,也能理解 “编程” 的行为属性,比单头更全面。

四、Transformer 的 “骨架”:编码器 - 解码器结构

自注意力是 Transformer 的 “细胞”,但完整的模型由编码器(Encoder) 和解码器(Decoder) 两部分组成,像一条 “信息流水线”。

1. 编码器:把输入 “翻译” 成 AI 能懂的 “语义向量”

编码器由 N 个相同的 “编码器层” 堆叠而成(论文中用了 6 层),每个编码器层包含两个子层:

  • 子层 1:多头自注意力

    (输入是词向量,输出是每个词融合了上下文的向量);

  • 子层 2:前馈神经网络

    (对每个词的向量做独立的非线性变换,提取更复杂的特征)。

每个子层后面都有两个关键操作:
残差连接:(避免深层网络梯度消失);
层归一化:(让每层输入分布更稳定,加速训练)。

  1. 解码器:根据 “语义向量” 生成输出

解码器也由 个相同的 “解码器层” 堆叠而成(论文中 6 层),每个解码器层比编码器多一个子层:

  • 子层 1:带掩码的多头自注意力(防止 “偷看” 未来的词,比如生成 “我爱” 时,不能提前看 “你”);
  • 子层 2:编码器 - 解码器注意力(用解码器的查询向量,关注编码器输出的语义向量,确保生成内容和输入相关);
  • 子层 3:前馈神经网络(和编码器相同)。

3. 位置编码:告诉模型 “词的顺序”

Transformer 没有循环结构,无法天然理解词的顺序(比如 “我爱你” 和 “你爱我” 对它来说,不看顺序的话向量组合是一样的)。
因此需要手动加入位置编码,公式用了正弦和余弦函数:

其中:
是词在句子中的位置(0, 1, 2, …);
是向量的维度索引(0 到 -1,文中)。
为什么用正弦余弦?因为它们的周期性可以让模型学到 “相对位置”(比如 可以用 的正弦余弦组合表示)。

一个通俗易懂案例

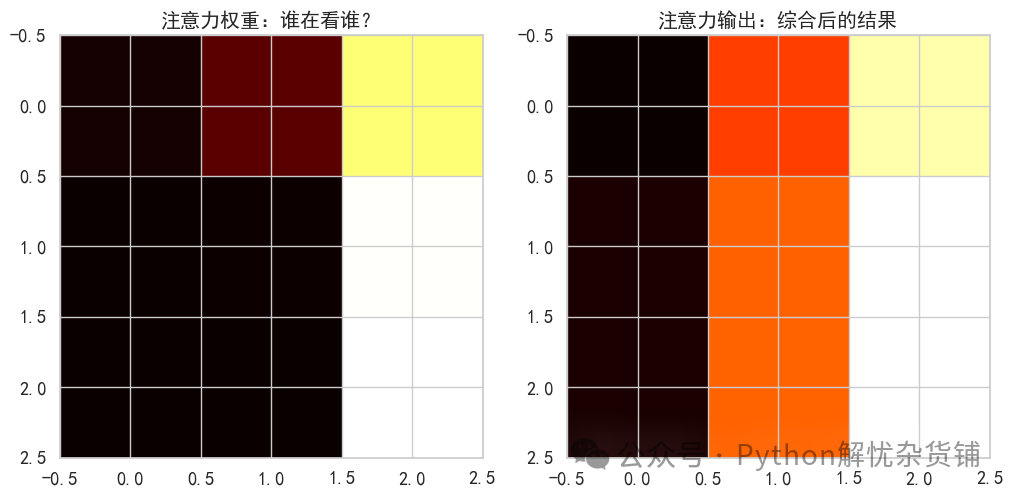
现在,我利用Python的matplotlib库来绘制一个简单的图像,帮助你更好地理解Transformer模型的工作原理。

以一个简化的例子来说明,展示自注意力机制是如何工作的。

import matplotlib.pyplotas plt
import numpy as np

# 假设输入3个词的向量表示
X = np.array([[0.1, 0.2, 0.3, 0.4],  # 第一个词
              [0.5, 0.6, 0.7, 0.8],  # 第二个词
              [0.9, 1.0, 1.1, 1.2]]) # 第三个词

# 计算查询、键、值(简化版)
W = np.array([[0.2, 0.3, 0.4, 0.5],
              [0.6, 0.7, 0.8, 0.9],
              [1.0, 1.1, 1.2, 1.3]])
Q = X.dot(W.T)  # 查询:每个词想找什么信息
K = X.dot(W.T)  # 键:每个词能提供什么信息
V = X.dot(W.T)  # 值:每个词的具体内容

# 计算注意力分数(谁和谁更相关)
A = np.exp(Q.dot(K.T) / np.sqrt(Q.shape[-1])) 
A /= A.sum(axis=-1, keepdims=True)  # 归一化

# 计算输出(加权求和)
Z = A.dot(V)

# 画图直观展示
plt.figure(figsize=(12, 6))
plt.subplot(121)
plt.imshow(A, cmap='hot')  # 红色越浓,注意力越集中
plt.title('注意力权重:谁在看谁?')
plt.subplot(122)
plt.imshow(Z, cmap='hot')
plt.title('注意力输出:综合后的结果')
plt.show()
图片

运行代码后,你会看到左边的图里,颜色越红的地方,说明两个词之间的关联越强;右边的图则是根据这些关联计算出的最终结果。

五、Transformer 的 “超能力”:为什么它能撑起大模型?

  1. 并行计算:
    传统 RNN 必须按顺序处理词(第 2 个词的计算依赖第 1 个),而 Transformer 的注意力机制可以同时处理所有词(矩阵运算支持并行),训练速度比 RNN 快 10 倍以上。
  2. 长距离依赖:
    RNN 处理长句子时,前面的信息会逐渐 “遗忘”(比如 1000 词的句子,第 1000 词几乎记不住第 1 词),而 Transformer 通过注意力机制,每个词可以直接关联任意位置的词,哪怕隔了 1000 个词也能记住。
  3. 通用性:
    不仅能处理文字(翻译、聊天),还能处理任何 “序列数据”:
    • 图像(把像素序列输入编码器,生成图像描述);
    • 音频(把声波序列输入,实现语音识别);
    • 代码(把代码序列输入,生成注释或补全代码)。

六、从公式到落地:Transformer 如何改变我们的生活?

  • ChatGPT

    :靠 Transformer 的注意力机制理解上下文,让对话像人类一样自然;

  • Google 翻译

    :用编码器 - 解码器结构,实现多语言精准互译;

  • DALL·E

    :把文本序列输入编码器,解码器生成对应图像;

  • GitHub Copilot

    :用 Transformer 学习代码序列的规律,自动补全代码。

总结:Transformer 的本质是什么?

说到底,Transformer 是一种 “动态关注” 的学习模式:它不机械地按顺序处理信息,而是像人类一样,会主动筛选重点、忽略杂音,同时从多个角度理解内容。

从公式上看,它是矩阵运算、注意力机制、残差连接的组合;从效果上看,它让 AI 第一次真正 “理解” 了上下文,为大模型的爆发奠定了基础。

下次再用 ChatGPT 时,不妨想想:它每给你一个回复,背后都跑了上万亿次我们今天聊的这些公式 —— 这就是 AI"思考" 的真相。

普通人如何抓住AI大模型的风口?

领取方式在文末

为什么要学习大模型?

目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。

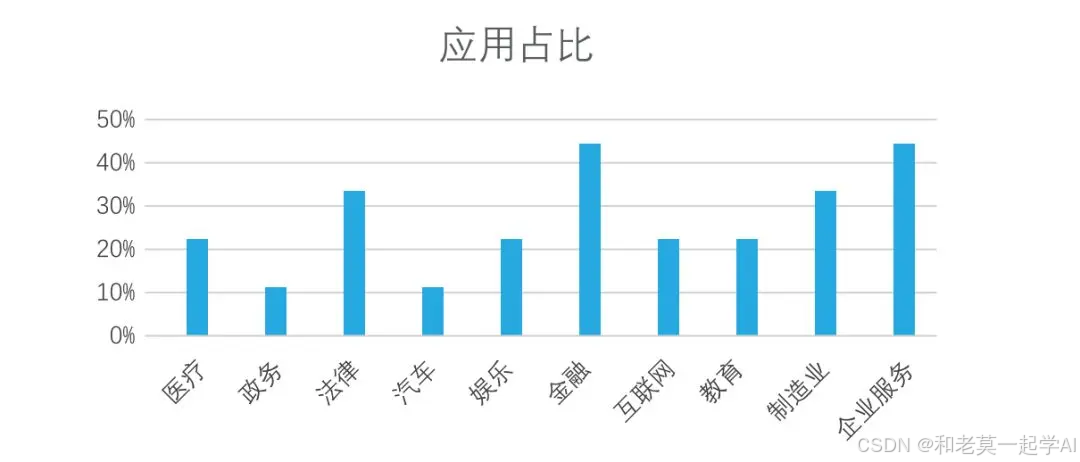
目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。
在这里插入图片描述

随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

在这里插入图片描述

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!

最后

只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!

在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
在这里插入图片描述

大模型全套学习资料展示

自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

图片

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!

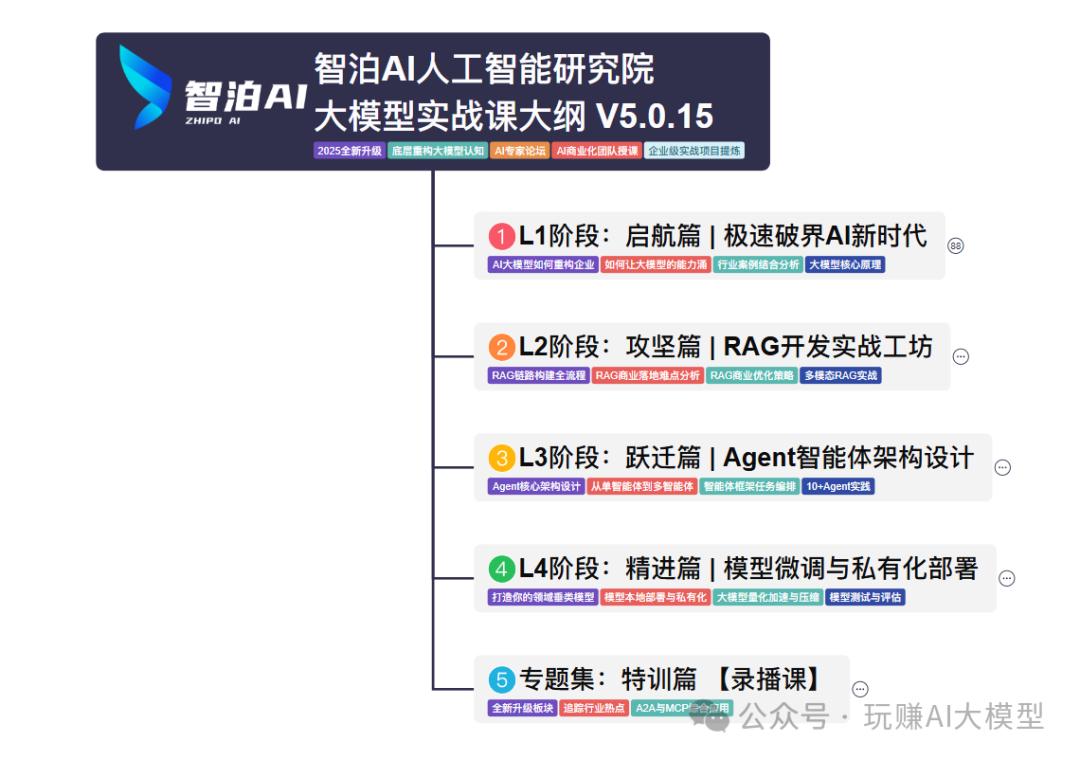
01 教学内容
图片

  • 从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!

  • 大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事‌!

02适学人群

应届毕业生‌: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。

零基础转型‌: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界‌。

业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型‌。

image.png

vx扫描下方二维码即可
在这里插入图片描述

本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!

03 入门到进阶学习路线图

大模型学习路线图,整体分为5个大的阶段:

图片

04 视频和书籍PDF合集

图片

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

图片

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

图片

05 行业报告+白皮书合集

收集70+报告与白皮书,了解行业最新动态!
图片

06 90+份面试题/经验

AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)图片

在这里插入图片描述

07 deepseek部署包+技巧大全

在这里插入图片描述

由于篇幅有限

只展示部分资料

并且还在持续更新中…

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

在这里插入图片描述

【人工智能时代】- 一文读懂 Transformer 神经网络模型 在实际的业务场景中,Transformer 模型通常是通过在大规模数据上进行预训练,然后在特定任务上进行微调来实现高性能,从而使得模型在实际推理过程中对于新领域或特定任务的适应性有限。在某些特定的场景下,由于 Transformer 模型中自注意力机制的特性,其对于长文本的处理存在一定的困难。打个比方,在机器翻译模型中,注意力机制使得 Transformer 能够根据所有相关单词的上下文,将英语中的"it"正确翻译为法语或西班牙语中的性别对应的词汇。上述两个模型的最显著区别在于“规模”和“功能”。 阅读详情

相关推荐

DeepSeek 为 AI 人工智能带来的革命性变化

我们的目的是深入探究 DeepSeek 这个新事物到底给人工智能带来了哪些翻天覆地的变化。范围呢,会涵盖 DeepSeek 的基本原理、在实际中的应用、和其他技术的对比,还有对未来人工智能走向的影响等方面。接下来,我们会先讲一些和 DeepSeek 有关的核心概念,就像给大家介绍新朋友一样;然后说说它的核心算法是怎么回事,还有具体的操作步骤;再用数学模型和公式详细解释;接着通过一个实际的项目案例,看看它在现实中是怎么用的;之后分析一下它都能在哪些场景发挥作用;推荐一些能帮助大家进一步了解它的工具和资源;

AI算力网络与通信的博客 785

以注意力机制为核心的Transformer革命

绪论 为什么Transformer大扫深度学习领域? 五年前Transformer最早提出时,面向的是机器翻译(machine translation)等自然语言处理任务,但到了五年后的今天,它的应用已经遍布自然语言处理、计算机视觉、视频音频处理以及多模态学习,可以毫不夸张地说,Transformer不但一手造就了RNN在自然语言处理领域跌落神坛,如今更是大有取代卷积神经网络在视觉领域霸主地位的势头。Transformer强大的表达能力和通用性来自于其核心结构注意力机制,而随着Transformer的流

hellozhxy的博客 818

一、数学建模层次分析法(AHP)【清风数学建模个人笔记】

层次分析法: 层次分析法主要用于解决评价类问题(例如:选择哪种方案更好、哪位员工、运动员等表现得更优秀) 评价类问题: 分析问题得出评判问题的子标,分别给不同子标赋予权重(权重和要为1) ...

m0_58882109的博客 1万+

什么是Transformer?Transformer综述(说人话版),看这一篇就够了!

本文将用最通俗易懂的语言和生动的比喻,带你轻松揭开Transformer的神秘面纱,即使你没有任何技术背景,也能看明白!

EnjoyEDU的博客 2545

绝对旋转编码器学习笔记(基本原理,与PC通信等,不定期更新中)

前言 最近开始学习编码器相关内容,目的在于搞清楚编码器的原理,与上位机的联系等问题。笔记资料来源为网络,整理的同时也会有一些总结和感悟。由于研究方向需求,主要研究数字旋转编码器。 1.编码器的定义 编码器(encoder)是将信号(如比特流)或数据进行编制、转换为可用以通讯、传输和存储的信号形式的设备。——摘自《百度百科》 通常来说,编码器可以将角度位移、直线位移、转速等物理量转换为电信号。这里的电信号根据不同原理的编码器输出脉冲、二进制数码等不同的类型,下面会提到。 2.编码器的分类 编.

黑化咸鱼的博客 1万+

判断两个多边形是否相交(java实现)

判断两个多边形是否相交 ,当前认为一个点相交也是相交,可针对凹多边形和凸边型等多复杂的多边形进行相交判断,采用java实现,因为网上java实现的比较少,所以这里写下如何实现,适用于碰撞检测,地图等等应用场景

IT_CREATE的博客 5845

爆火的Transformer是什么?一文读懂它的原理与妙用

Transformer是近年来AI领域革命性的神经网络架构,其核心创新在于自注意力机制。相比传统的RNN/CNN模型,Transformer能并行处理整个序列,直接捕捉长距离依赖关系,显著提升了语言理解能力。该架构通过计算词与词之间的关联度(QKV机制),让模型动态关注上下文关键信息。2017年提出后,Transformer迅速成为NLP主流技术,支撑了ChatGPT、BERT等突破性应用,并扩展到图像处理和多模态领域。其优势包括并行计算能力、全局上下文理解和可扩展性,已成为AI发展的重要基石。

m0_62923342的博客 445

麒麟V10(arm)配置本地离线yum源

麒麟V10(arm)配置本地离线yum源

myfm2java的博客 7893

Transformer,看这一篇就够了!

Transformer最初是为了解决序列转导或神经机器翻译的问题而开发的,这意味着它们旨在解决将输入序列转换为输出序列的任何任务。这就是为什么他们被称为“Transformer”。

Java癫疯的博客 822

42、InfiniBand技术详解:QP状态机、操作及错误处理

本文深入解析InfiniBand技术中的核心组件QP(Queue Pair)状态机、工作请求处理机制、支持的操作类型及错误处理策略。详细介绍了QP的创建与状态转换流程,包括INIT、RTR、RTS等关键状态,并提供了状态修改的代码示例。文章还探讨了工作请求的发布、资源使用限制、围栏机制以及重试和RNR流程,帮助开发者理解通信可靠性保障机制。此外,涵盖了多播组的应用场景与API使用方法,并对比了用户空间与内核级RDMA API的调用差异,最后给出了实践建议和常见问题解答,为构建高性能分布式系统提供技术指导。

oauth7security的博客 133

软硬件融合加速技术系列文章

目录 文章目录目录计算机组成原理Linux 操作系统原理处理器进程管理内存管理I/O 系统文件系统网络协议栈资源管理设备管理GPUFPGASmartNIC/DPU 计算机组成原理 《计算机组成原理 — 冯诺依曼体系结构》 《计算机组成原理 — 基本硬件设备》 《计算机组成原理 — CPU 中央处理器》 《计算机组成原理 — 指令系统》 《计算机组成原理 — 总线系统》 《计算机组成原理 — 存储系统》 《计算机组成原理 — 输入输出系统 — 存储控制器接口类型》 《计算机组成原理 — 服务器》 《计算机组成

烟云的计算 6809

Transformer和Diffusion是什么

让我用故事和比喻的方式给你讲解Transformer和Diffusion!这个解释生动形象吗?需要我深入某个细节吗?🤖 Transformer:智能翻译大使。🌈 Diffusion:魔法画家。

weixin_46053950的博客 757

【用unity实现100个游戏之2】复刻实现经典2d平台跳跃游戏《蔚蓝 Celeste》(附工程源码)

蔚蓝》是一款备受好评的独立游戏,由游戏开发工作室开发并由发行。这款游戏于2016年首次发布,并在玩家和评论界收获了广泛赞誉。蔚蓝以其独特的艺术风格和引人入胜的故事而著称。游戏以深海为背景,玩家将扮演一个能够探索水下世界的神秘生物。游戏通过惊人的视觉表现和动态的海洋生态系统为玩家带来了令人难忘的游戏体验。无论是广阔的水下景观还是充满生机的海洋生物,蔚蓝都让玩家感受到深海的神秘和美丽。蔚蓝在玩法上注重探索和解谜。玩家可以在海底环境中自由游动,发现隐藏的地点和秘密,与各种生物互动,并解决环境谜题以继续前进。

向宇的博客,专注php/web全栈 unity游戏开发,欢迎大家评论纠错 4172

【收藏必备】Transformer:大模型的共同底座,一文读懂AI革命性架构

Transformer作为几乎所有大模型的底层架构,通过Attention注意力机制颠覆了RNN的顺序处理方式,实现了全局理解。它使模型能够捕捉词语间语义关系,具备可并行、可扩展、可泛化的特性,成为AI的通用架构。这一技术不仅是计算结构的革新,更是认知方式的变革,让AI从简单分类器进化为能理解与生成的智能体,标志着大模型时代的真正到来。

2401_85154887的博客 981

Python爬虫实战:使用最新技术抓取采购网招标公告信息

本文将详细介绍如何使用Python最新爬虫技术构建一个高效的采购网招标公告信息抓取系统。我们将从爬虫基础概念讲起,逐步深入到高级技巧,包括异步处理、反爬虫对策、数据解析与存储等,并提供完整的代码实现。本文旨在为读者提供一套完整的网络数据采集解决方案,适用于各类政府采购平台和商业招标网站。网络爬虫(Web Crawler)是一种自动抓取互联网信息的程序或脚本,它们按照一定的规则,自动地浏览万维网并提取所需数据。在现代商业环境中,爬虫技术广泛应用于价格监控、竞争情报收集、市场研究等领域。

2201_76125261的博客 1623

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

AI大事记12:Transformer 架构——重塑 NLP 的革命性技术(下)

摘要:Transformer架构已成为现代大语言模型(如GPT、PaLM等)的核心基础,其并行计算、长距离依赖建模和灵活扩展性支撑了模型规模的持续扩大。关键技术突破包括混合专家模型(MoE)、稀疏注意力机制和位置编码改进,显著提升了效率和性能。同时,Transformer正拓展至多模态领域,成功应用于视觉、语音等任务。尽管面临部署挑战,但通过模型压缩、硬件加速和算法优化等方案持续推动应用落地。Transformer不仅是一项技术突破,更开创了AI发展的新范式,奠定了智能时代的基石。

AI新兵博客 2121

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

【科普】【人工智能极简史:一文读懂ChatGPT的前世今生】【转载】

2022年11月30日,OpenAI推出的一款人工智能技术驱动的自然语言处理工具——ChatGPT,迅速在社交媒体上走红,短短5天,注册用户数就超过100万。2023年1月末,ChatGPT的月活用户已突破1亿,一度成为史上增长最快的消费者应用(之后被threads的5天打破)。微软创始人比尔盖茨在他的博客中畅谈ChatGPT,他说:OpenAI发布的大语言模型ChatGPT是他一生中遇到的两项革命性技术之一。另一个是1980年出现的图形用户界面。这款具有革命性意义的产品是如何横空出世的?

j8267643的博客 2972

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

一文读懂 Transformer 神经网络模型

在过去几年中,Transformer 模型已经成为高级深度学习和深度神经网络领域的热门话题。自从其在 2017 年被引入以来,Transformer 深度学习模型架构已经在几乎所有可能的领域中得到了广泛应用和演进。该模型不仅在自然语言处理任务中表现出色,还对于其他领域,尤其是时间序列预测方面,也具有巨大的帮助和潜力。那么,什么是 Transformer 神经网络模型?Transformer 模型是一种深度学习架构,自 2017 年推出以来,彻底改变了自然语言处理 (NLP) 领域。

2401_84494441的博客 2506

读懂大模型核心:Transformer 与 AI 发展的底层逻辑

Transformer神经网络模型是AI领域革命性突破,其核心"自注意力机制"让机器能像人类一样理解上下文语义关联。该技术最初用于机器翻译,现已支撑GPT等大语言模型的多模态处理能力,实现文本生成、图像创作、语音转换等智能应用。通过"预测-拼接-再预测"的自回归模式,Transformer使AI能动态生成逻辑连贯的内容,从被动执行升级为主动理解,重塑人机交互方式。

2402_88700528的博客 1471

一文读懂 Transformer:从核心原理到学习路径

Transformer 的诞生并非偶然,它源于 2017 年谷歌 Brain 团队发表的经典论文 ——(《注意力就是你所需要的一切》)。这篇论文首次提出了 Transformer 网络结构,彻底改变了 AI 处理序列数据的方式。Transformer 的革命性,主要体现在长距离依赖处理和并行计算两大优势上,而这两大优势的核心支撑,正是它提出的 “自注意力机制”。解决长距离依赖问题。

2301_76168381的博客 1129

人工智能极简史:一文读懂ChatGPT的前世今生

2022年11月30日,OpenAI推出的一款人工智能技术驱动的自然语言处理工具——ChatGPT,迅速在社交媒体上走红,短短5天,注册用户数就超过100万。2023年1月末,ChatGPT的月活用户已突破1亿,一度成为史上增长最快的消费者应用(之后被threads的5天打破)。微软创始人比尔盖茨在他的博客中畅谈ChatGPT,他说:OpenAI发布的大语言模型ChatGPT是他一生中遇到的两项革命性技术之一。另一个是1980年出现的图形用户界面。这款具有革命性意义的产品是如何横空出世的?

mate1357的博客 646

Table Transformer:革命性的表格结构识别技术解析

Table Transformer:革命性的表格结构识别技术解析 【免费下载链接】table-transformer-structure-recognition-v1.1-all 项目地址: https://ai.gitcode...

gitblog_00961的博客 1070

AI通识指南:一文说清人工智能

人工智能不会取代人类,但会重塑每个行业的生产力范式。扩展认知边界:帮科学家发现新药、帮教师因材施教;提升创造效率:让设计师、作家、程序员专注创意本身;促进教育公平:为偏远地区学生提供顶级教育资源。最后一句不要神化AI, 也不要恐惧AI,AI只会取代不用AI的人。

生活是一种修炼 1405

从原理到实战:一文读懂BERT、Transformer、ViT与CLIP

从BERT将双向上下文理解带入NLP,成为语言理解的基石。ViT证明了Transformer在视觉领域的通用性,并通过层次化设计(如Swin)成为视觉新基准。CLIP通过对比学习对齐图文模态,开创了强大的零样本学习范式。选型核心思路:明确你的任务和数据形态。纯文本用BERT,纯图像用ViT,图文关联用CLIP。同时,务必考虑数据量、计算预算和部署环境,灵活选择基础模型或轻量化版本。未来,统一的多模态大模型(如OFA、Flamingo)和更高效的架构(如注意力机制优化)将继续推动这一领域前进。

1137

一文读懂生成式人工智能的所有基础知识(下)

在深入探讨了生成式人工智能的各种技术类型之后,不难发现,这些技术已不仅仅是理论上的概念,而是真正进入了商业应用的现实场景中。从生成对抗网络(GANs)的创新性数据生成到变分自编码器(VAEs)在图像处理中的应用,从大模型如Transformer的语言处理能力到递归神经网络(RNNs)在序列数据中的应用,再到大型语言模型(LLMs)在内容创作和自动化编程中的突破,这些技术正在逐步塑造出全新的商业生态和用户体验。

manfukeji的博客 1246

从RNN到Transformer:生成式AI技术演变与未来展望

从RNN到Transformer,生成式AI的自回归模型经历了从线性序列处理到全局并行建模的革命性转变。随着技术的持续创新,生成式AI将在更多领域展现出其强大的潜力,为人类社会带来更深远的影响。

专注AI大模型,软件混淆,授权 1666
上一篇: AI Agent多轮对话记忆难题如何破解?7种关键优化方法深度解析
下一篇: AI智能体工作流变现指南:从小白到赚钱的完整路径(扣子平台实操)
不秃头de程序猿
博客等级 码龄5年 4091粉丝 1479原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值