


在基于大模型的 Agent 中,长期记忆的状态维护至关重要,在 OpenAIAI 应用研究主管 Lilian Weng 的 博客《基于大模型的 Agent 构成》中,将记忆视为关键的组件之一,下面我将结合 LangChain 中的代码,分享7 种不同的Agent记忆维护方式在不同场景中的应用。
获取全量历史对话
在电信公司的客服聊天机器人场景中,如果用户在对话中先是询问了账单问题,接着又谈到了网络连接问 题,ConversationBufferMemory 可以用来记住整个与用户的对话历史,可以帮助 AI 在回答网络问题时还 记得账单问题的相关细节,从而提供更连贯的服务。
from langchain.memory import ConversationBufferMemory
memory = ConversationBufferMemory()
memory.save_context({"input": "你好"}, {"output": "怎么了"})
print(memory.load_memory_variables({}))
滑动窗口获取最近部分对话内容
在一个电商平台上,如果用户询问关于特定产品的问题(如手机的电池续航时间),然后又问到了配送方 式,ConversationBufferWindowMemory 可以帮助AI 只专注于最近的一两个问题(如配送方式),而不是整个对话历史,以提供更快速和专注的答复。
from langchain.memory import ConversationBufferWindowMemory
memory = ConversationBufferWindowMemory(k=1)
memory.save_context({"input": "iphone15续航"}, {"output": "续航一般"})
memory.save_context({"input": "配送"}, {"output": "很快"})
# {'history': 'Human: 配送\nAI: 很快'}
print(memory.load_memory_variables({}))
ConversationBufferWindowMemory 这个类在存储message还是全量存储的,只是在读数据的时候只读k个窗口。
获取历史对话中实体信息
在法律咨询的场景中,客户可能会提到特定的案件名称、相关法律条款或个人信息(如“我在去年的交通 事故中受了伤,想了解关于赔偿的法律建议”)。 ConversationEntityMemory可以帮助 AI 记住这些关键 实体和实体关系细节,从而在整个对话过程中提供更准确、更个性化的法律建议。
llm = ChatOpenAI(temperature=0, model="gpt-4o")


memory = ConversationEntityMemory(
    llm=llm,
    return_messages=True,
)
print(memory.load_memory_variables(inputs={"input": "good!  busy working on Langchain.  lots to do."}))
memory.save_context({"input": "good!  busy working on Langchain.  lots to do."}, {"output": "That sounds like a lot of work!  What kind of things are you doing to make Langchain better?"})
print(memory.load_memory_variables(inputs={"input": "i'm trying to improve Langchain's interfaces, the UX, its integrations with various products the user might want ...  a lot of stuff"}))
memory.save_context(inputs={"input": "i'm trying to improve Langchain's interfaces, the UX, its integrations with various products the user might want ...  a lot of stuff"}, outputs={"output": "that sounds great job"})
print(memory.load_memory_variables(inputs={"input": "what is langchain"}))
在会话过程中,需要从memory load 变量时:
- 根据history和用户的提问(也就是最新一句话)提取实体,注意这里提取的是用户最新提问的query的实体
- 从entity_store这个大字典查询之前是否存在对应实体的描述信息,如果有对应的描述信息,则把对应的实体和描述信息作为entities字段返回
- 如果之前提取了实体,但是最新一句话
当一次会话结束之后,需要save_contexts:
- 保存human message和ai message到 messages列表
- 因为AI message 可能补充了human 提到的实体信息,所以使用LLM更新当前query提到的实体的描述信息
- 如果在当前会话之前提取了实体,但是当前会话只是简单的问候,那么就不会更新实体的描述信息,本质还是因为实体信息是绑定在当前的query的
利用知识图谱获取历史对话中的实体及其联系
在医疗咨询中, 一个病人可能会描述多个症状和过去的医疗历史(如“我有糖尿病史,最近觉得经常口渴 和疲劳”)。 ConversationKGMemory 可以构建一个包含病人症状、疾病历史和可能的健康关联的知识图谱,从而帮助 AI 提供更全面和深入的医疗建议。
from langchain_community.memory.kg import ConversationKGMemory

llm = ChatOpenAI(temperature=0, model="gpt-4o")

memory = ConversationKGMemory(llm=llm)
memory.save_context({"input": "say hi to sam"}, {"output": "who is sam"})
memory.save_context({"input": "sam is a friend"}, {"output": "okay"})
print(memory.load_memory_variables({"input": "who is sam"}))  # {'history': 'On Sam: Sam is a friend.'}
print(memory.get_current_entities("what's Sams favorite color?"))  # ['Sam']
当每次会话结束的时候,会利用LLM从history中抽取知识的三元组,并存储到NetworkxEntityGraph图对象中。
当新的会话开始需要从memory load数据的时候,从当前Query中利用LLM抽取实体,并从NetworkxEntityGraph图对象中获取这个实体的knowledge, 把所有实体的知识信息返回。
对历史对话进行阶段性总结摘要
在一系列的教育辅导对话中,学生可能会提出不同的数学问题或理解难题(如“我不太理解二次方程的求解方法”)。 ConversationSummaryMemory 可以帮助 AI 总结之前的辅导内容和学生的疑问点,以便在随后的辅导中提供更针对性的解释和练习.
llm = ChatOpenAI(temperature=0, model="gpt-4o")
memory = ConversationSummaryMemory(llm=llm)
memory.save_context({"input": "hi"}, {"output": "whats up"})
print(memory.load_memory_variables({}))  # {'history': 'The human greets the AI with "hi," and the AI responds with "what\'s up."'}
ConversationSummaryMemory 有个buffer的属性,存放summary信息。每次会话结束的时候,用新生成的会话和之前的summary生成新的summary存储在buffer属性中。
ConversationSummaryMemory 特点:
- 只存储摘要,不存储原始对话
- 每次对话后都会更新摘要
- 适合长期对话,节省 token
- 可能丢失细节信息
需要获取最新对话,又要兼顾较早历史对话
在处理一个长期的技术问题时(如软件故障排查),用户可能会在多次对话中提供不同的错误信息和反 馈。ConversationSummaryBufferMemory 可以帮助 AI 保留最近几次交互的详细信息,同时提供历史问 题处理的摘要,以便于更有效地识别和解决问题。
llm = ChatOpenAI(temperature=0, model="gpt-4o")
memory = ConversationSummaryBufferMemory(llm=llm, max_token_limit=10)
memory.save_context({"input": "hi"}, {"output": "whats up"})
memory.save_context({"input": "not much you"}, {"output": "not much"})
# {'history': 'System: The human greets with "hi." The AI responds with "what\'s up," and the human replies with "not much, you?"\nAI: not much'}
print(memory.load_memory_variables({}))
ConversationSummaryBufferMemory 会暂存不会超过max_token_limit的会话历史,当历史长度超过这个大小的时候,会截断之前的会话历史以使得会话现存的会话长度不超过max_token_limit,并把截断的之前的会话历史和之前的moving_summary_buffer更新moving_summary_buffer信息。
ConversationSummaryBufferMemory 特点:
- 存储最近的对话 + 早期对话的摘要
- 结合了完整对话和摘要的优势
- 保持最近对话的细节,压缩早期对话
- 适合中等长度的对话
基于向量检索对话信息
用户可能会对特定新闻事件提出问题,如“最近的经济峰会有什么重要决策?ℽ VectorStoreRetrieverMemory 能够快速从大量历史新闻数据中检索出与当前问题最相关的信息,即使这些信息在整个对话历史中不是最新的,也能提供及时准确的背景信息和详细报道。
import faiss

from langchain.docstore import InMemoryDocstore
from langchain.vectorstores import FAISS


embedding_size = 1536 # Dimensions of the OpenAIEmbeddings
index = faiss.IndexFlatL2(embedding_size)
embedding_fn = OpenAIEmbeddings().embed_query
vectorstore = FAISS(embedding_fn, index, InMemoryDocstore({}), {})


# the vector lookup still returns the semantically relevant information
retriever = vectorstore.as_retriever(search_kwargs=dict(k=1))
memory = VectorStoreRetrieverMemory(retriever=retriever)

# When added to an agent, the memory object can save pertinent information from conversations or used tools
memory.save_context({"input": "My favorite food is pizza"}, {"output": "thats good to know"})
memory.save_context({"input": "My favorite sport is soccer"}, {"output": "..."})
memory.save_context({"input": "I don't the Celtics"}, {"output": "ok"})
总结
在实际项目中,记忆方案的选择需要综合考量以下因素:
- 业务场景的信息生命周期要求
- 对话复杂度和上下文依赖程度
- 系统资源与响应延迟限制
在实际项目里,我常跟团队说:"别一上来就整最复杂的,先想清楚你的AI到底需要记住什么。"有时候简单的滑动窗口就够用,非得加个知识图谱反而把简单问题复杂化。最近我在做一个客服系统,就用了混合记忆的方案,效果还不错。
普通人如何抓住AI大模型的风口?
领取方式在文末
为什么要学习大模型?
目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。
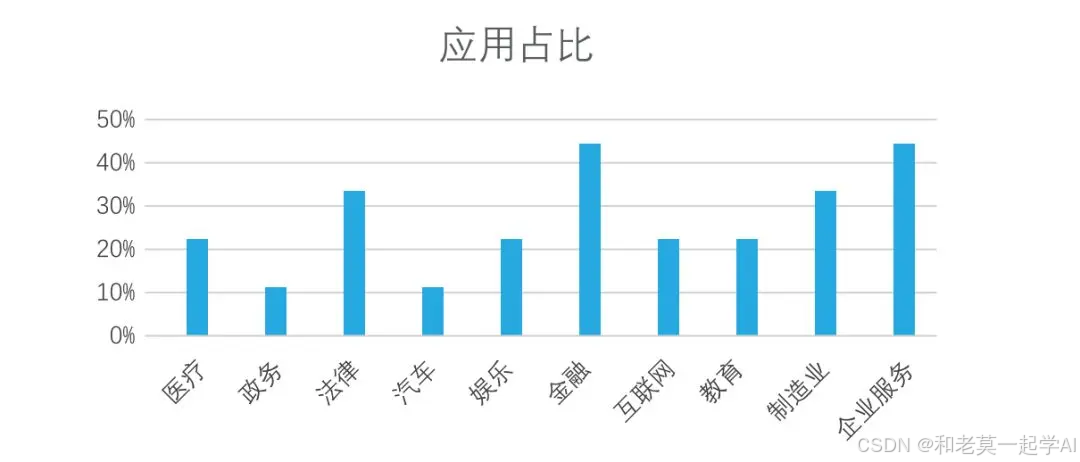
目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。
随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!
最后
只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!
在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
大模型全套学习资料展示
自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!
01 教学内容
-
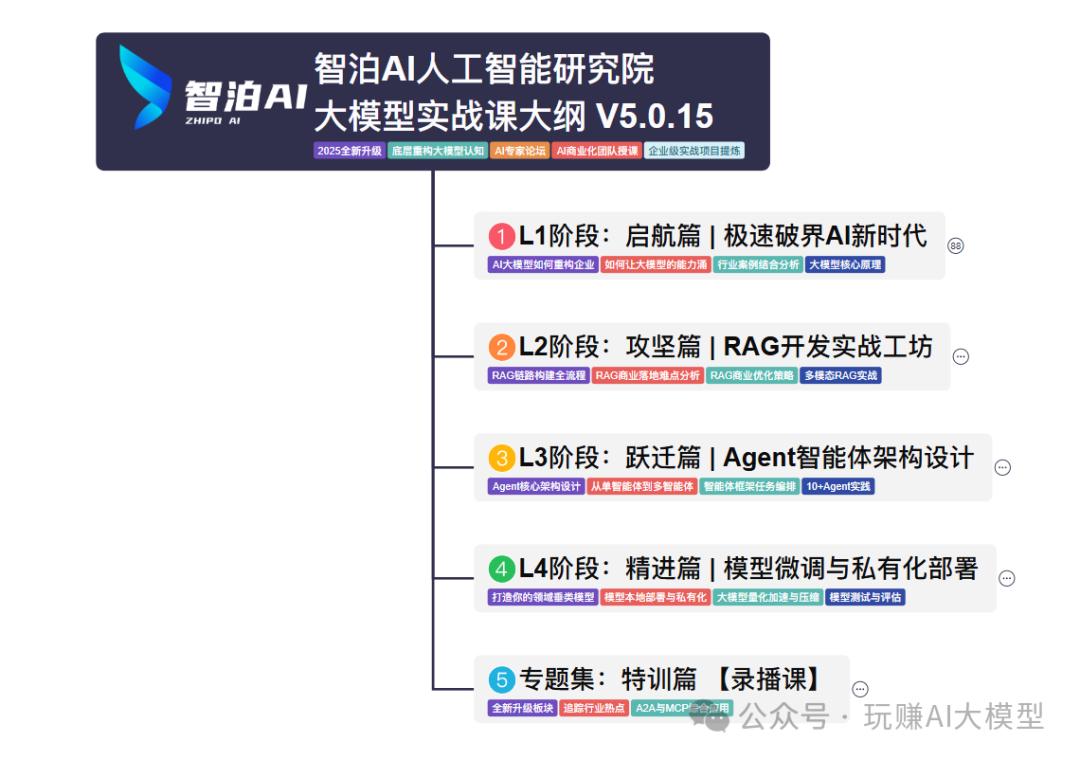
从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!
-
大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
02适学人群
应届毕业生: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。

vx扫描下方二维码即可
本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!
03 入门到进阶学习路线图
大模型学习路线图,整体分为5个大的阶段:

04 视频和书籍PDF合集

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

05 行业报告+白皮书合集
收集70+报告与白皮书,了解行业最新动态!

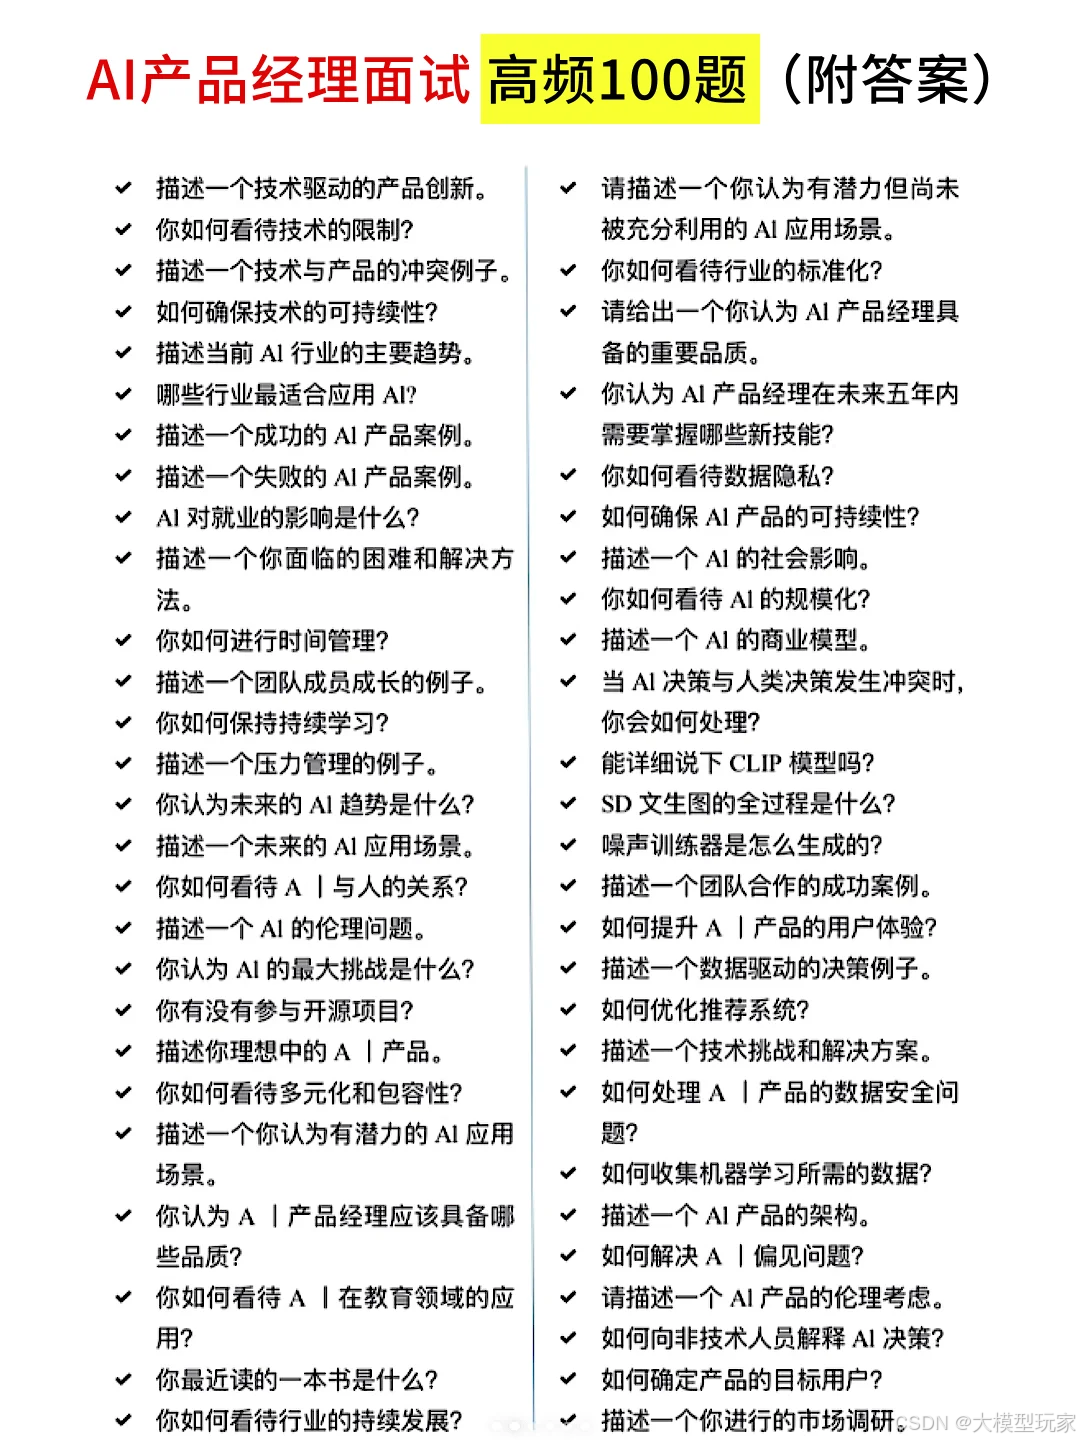
06 90+份面试题/经验
AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)
07 deepseek部署包+技巧大全

由于篇幅有限
只展示部分资料
并且还在持续更新中…
真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
 1440


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


